Ошибочные функции вознаграждения в реальных условиях
Алгоритмы обучения с подкреплением могут давать сбои удивительным и неконтринтуитивным образом. В этой статье мы рассмотрим один из таких режимов сбоя, возникающий при неверном задании функции вознаграждения.
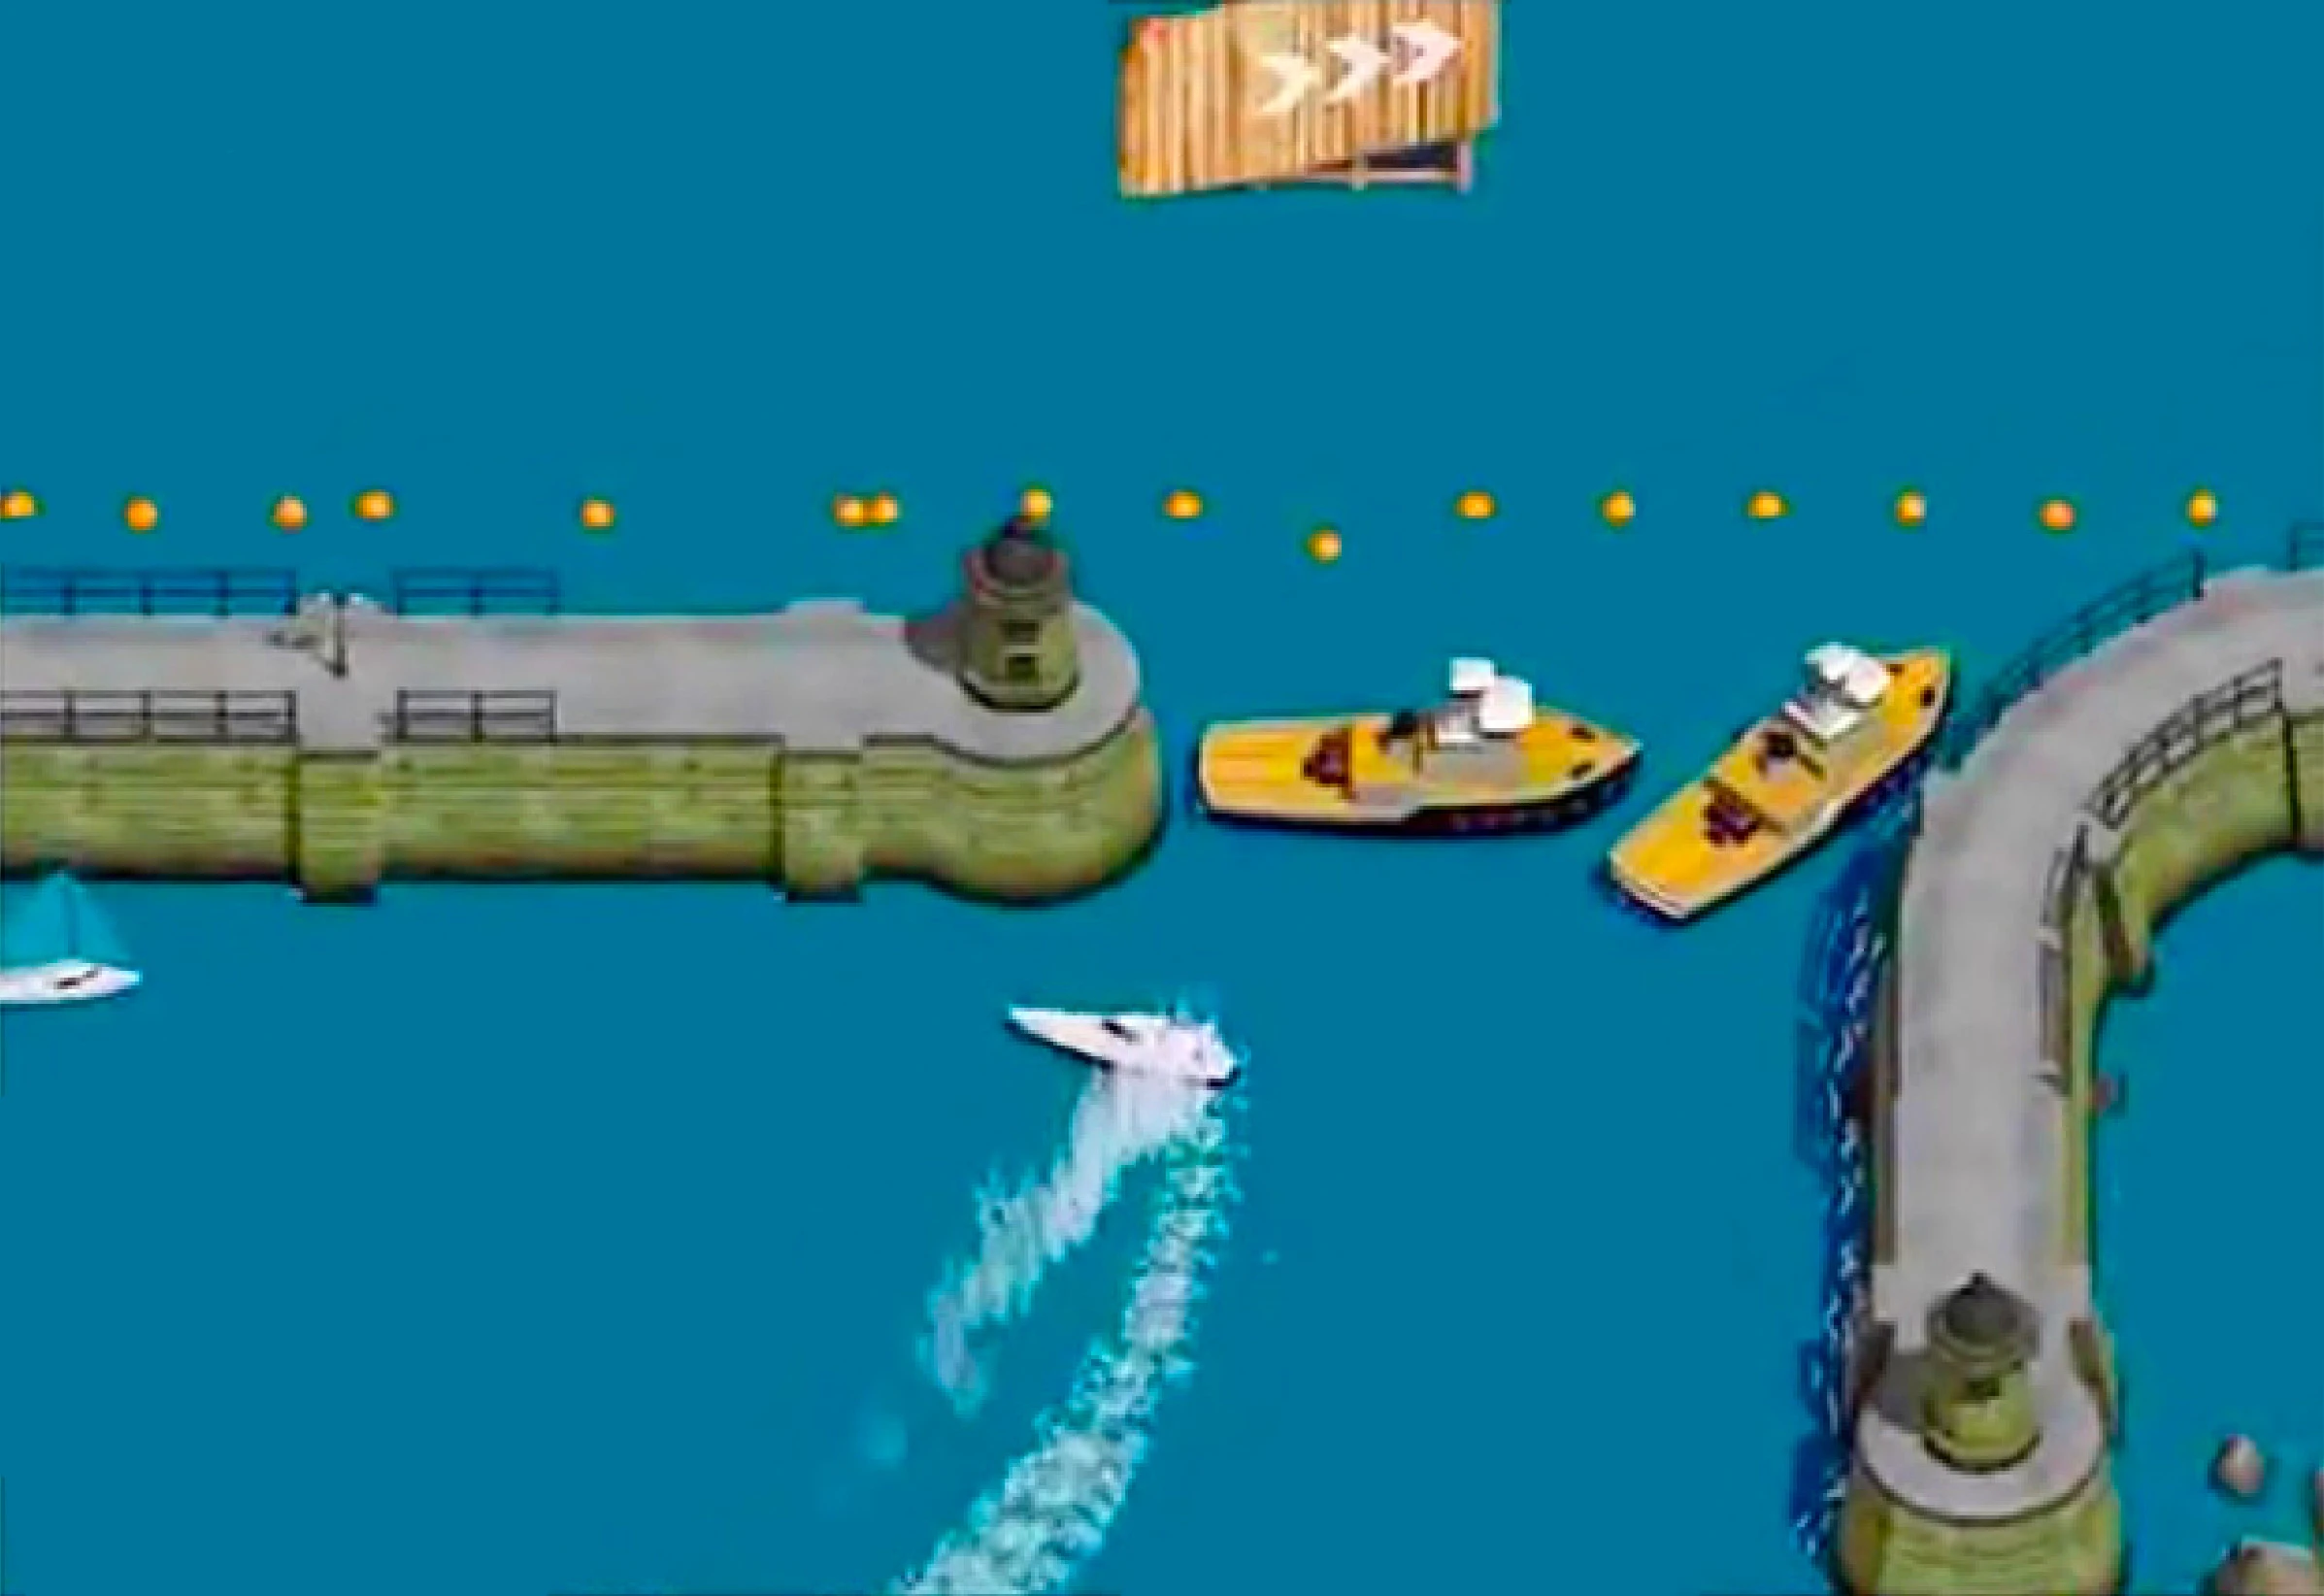
Недавно в OpenAI мы начали использовать Universe — наше программное обеспечение для оценки и обучения агентов искусственного интеллекта, чтобы проводить новые эксперименты по обучению с подкреплением (RL). Иногда эти эксперименты наглядно показывают некоторые проблемы RL в его текущем виде. В следующем примере мы покажем, что происходит, когда неверно спроектированная функция вознаграждения побуждает RL-агента подрывать стабильность своей среды, уделяя приоритетное внимание получению сигналов вознаграждения в ущерб другим критериям успеха.
Создание безопасных систем ИИ потребует от нас разработки алгоритмов, которые не будут пытаться действовать подобным образом, и научит нас формулировать и формировать цели так, чтобы наши ИИ-агенты не могли истолковать их двусмысленно.
Одна из игр, на которых мы проводили обучение — это CoastRunners. Цель игры — в понимании большинства людей — заключается в том, чтобы быстро завершить гонку на лодках и (желательно) обогнать других игроков. CoastRunners не вознаграждает игрока напрямую за продвижение по трассе; вместо этого более высокие очки начисляются за поражение целей, расставленных вдоль маршрута.
Мы предполагали, что зарабатываемые игроком очки будут отражать негласную цель прохождения гонки, поэтому включили эту игру во внутренний бенчмарк, предназначенный для оценки производительности систем обучения с подкреплением в гоночных играх. Однако оказалось, что цели были расставлены таким образом, что RL-агент мог получить высокий результат, даже не завершая трассу. Это привело к неожиданному поведению, когда мы обучили RL-агента играть в эту игру.
RL-агент находит уединенную лагуну, где он может кружиться по большому кругу и многократно сбивать три цели, рассчитывая свои движения так, чтобы сбивать их ровно в момент их возрождения. Несмотря на то, что лодка агента постоянно загорается, врезается в другие суда и движется по трассе не в ту сторону, ему удается достичь с помощью этой стратегии более высокого счета, чем при прохождении трассы обычным способом. Наш агент набирает в среднем на 20 процентов больше очков, чем люди-игроки.
Будучи безвредным и забавным в контексте видеоигры, такое поведение указывает на более общую проблему обучения с подкреплением: зачастую бывает трудно или невозможно точно зафиксировать то, чего мы хотим от агента, в результате чего мы нередко используем несовершенные, но легко измеряемые суррогатные показатели. Часто это работает хорошо, но иногда приводит к нежелательным или даже опасным действиям. В более широком смысле это противоречит базовому инженерному принципу, согласно которому системы должны быть надежными и предсказуемыми. Мы также подробно исследовали эту проблему в нашей научной работе Конкретные проблемы безопасности ИИ.
Как избежать подобных проблем? Помимо аккуратного проектирования функций вознаграждения, снизить количество случаев некорректного задания наград могут помочь несколько исследовательских направлений, изучаемых в OpenAI:
- Обучение на основе демонстраций позволяет избежать прямого задания вознаграждения и вместо этого просто научиться имитировать то, как человек справился бы с задачей. В данном примере, поскольку подавляющее большинство людей стремится пройти гоночную трассу до конца, наши алгоритмы RL делали бы то же самое.
- В дополнение к человеческим демонстрациям (или вместо них) мы также можем использовать человеческую обратную связь, оценивая качество эпизодов или даже разделяя управление с агентом в интерактивном режиме. Вполне возможно, что даже минимальный объем оценочной обратной связи мог бы помешать агенту ходить кругами.
- Возможно применение трансфертного обучения (обучения переносу) для тренировки на множестве похожих игр и вывода «здравомысленной» функции вознаграждения для конкретной игры. Такая функция вознаграждения могла бы ставить в приоритет прохождение гонки на том основании, что типичная игра преследует именно такую цель, а не концентрироваться на особенностях функции вознаграждения данной конкретной игры. Это больше похоже на то, как в игру играл бы человек.
Эти методы могут иметь свои недостатки. Например, трансфертное обучение предполагает экстраполяцию функции вознаграждения для новой среды на основе функций вознаграждения из множества аналогичных сред. Сама эта экстраполяция может оказаться ошибочной — например, агент, обученный на множестве гоночных видеоигр, где выезд за пределы дороги наказывается небольшим штрафом, может ошибочно решить, что выезд за пределы дороги в новых условиях с более высокими ставками не имеет большого значения. Более того, если процесс экстраполяции вознаграждения задействует нейронные сети, состязательные примеры (атакующие примеры) в этой сети могут привести к появлению функции вознаграждения с «неестественными» областями высокого вознаграждения, которые не соответствуют никакой разумной реальной цели.
Решение этих проблем будет сложной задачей. Мы надеемся, что Universe позволит нам быстро выявлять и устранять новые режимы сбоев и в конечном итоге разрабатывать системы, в поведении которых мы сможем быть по-настоящему уверены.
Связаться с авторами этой публикации: Дарио, Джек
Авторы
Полный текст статьи читайте на OpenAI
