Метрики для понимания темпов разработки ИИ в передовых лабораториях
для
понимания темпов
разработки
ИИ в передовых
лабораториях ИИ
ИИ-системы становятся мощнее, и их все чаще используют для создания собственных новых версий.
Мы хотим пролить свет на темпы этого прогресса для широкой общественности.
Для этого мы публикуем три метрики, которые помогут общественности отслеживать развитие ИИ внутри передовых лабораторий: какая часть исследований и разработок в сфере ИИ выполняется самим ИИ, насколько хорошо контролируются действия ИИ-агентов и как распределяются вычислительные мощности.
Метрики для
оценки темпов развития ИИ в передовых лабораториях
Системы искусственного интеллекта становятся экспоненциально мощнее и начинают автоматизировать все большую часть процессов своего собственного создания. В условиях, когда мир обсуждает необходимость замедления темпов разработки передового ИИ, общественности требуется больше информации.
В этой статье мы представляем инструменты измерения, которые могут пролить свет на три критических аспекта разработки ИИ:
- Степень, в которой ИИ создает следующую версию самого себя, по сравнению с созданием людьми
- Наша способность осуществлять надзор за действиями ИИ-агентов в системах Anthropic и вмешиваться в них
- Ресурсы, обеспечивающие разработку более мощных моделей
Мы также приводим срез этих метрик внутри компании Anthropic. Важно отметить, что мы ожидаем изменения этих показателей в случае координации темпов развития передового ИИ, к которой призывал генеральный директор Anthropic Дарио Амодей (Dario Amodei). Мы планируем привлечь независимых сторонних оценщиков из нескольких организаций в Anthropic и предоставить им доступ к внутренним процессам, системам и данным, сопоставимый с тем, которым обладают внутренние группы по оценке рисков. Эти сторонние эксперты будут проверять методы обеспечения безопасности, сообщать об инцидентах и следить за ключевыми метриками, подобными тем, что представлены в данном материале.
Мы публикуем эти измерения, поскольку они дают общественности, независимым сторонам и правительствам лучшую видимость темпов разработки ИИ внутри передовых лабораторий. Для каждого измерения мы описываем, что именно мы измеряли, к каким результатам это привело и что потребуется для регулярной публикации таких данных в формате, который другие смогут проверить. Методологические детали мы приводим в Приложении.
Причины отслеживать эти показатели
Метрики в этом материале сосредоточены на том, как создаются модели. Лучшее понимание производственного процесса моделей дает нам больше шансов установить корреляцию между входными данными (например, вычислительными мощностями) и результатами работы моделей (например, их возможностями). Они дополняют оценки возможностей, которые измеряют то, что модели способны делать. Мы публикуем их отдельно в отчетах о рисках в рамках нашей Политики ответственного масштабирования (RSP), которые содержат свидетельства того, насколько сильно наши модели ускоряют исследования и разработку (R&D) в сфере ИИ. В нашем предложении по политике в отношении передового ИИ — Концепции передового ИИ (AAIF) — мы предлагаем правила игры для выпуска безопасных моделей любой лабораторией, включая обязательства по прозрачности, которых могут требовать правительства (например, отчеты о рисках). В совокупности эти предложенные метрики и правила служат отправной точкой для мониторинга темпов развития ИИ извне лабораторий.
(1) Измерение R&D в сфере ИИ под руководством ИИ
Зачем измерять R&D под руководством ИИ? Передовые ИИ-лаборатории все чаще используют искусственный интеллект для создания будущих моделей ИИ. Этот процесс позволяет лабораториям в демократических странах быстрее разрабатывать более мощные модели, а также проводить больше проверок безопасности и тестирования до их выпуска, чтобы сохранять преимущества ИИ, оставаясь на переднем крае. Тем не менее, ускорение моделями собственного развития может затруднить для людей понимание таких систем или управление ими. Поэтому важно делиться этими метриками, чтобы понимать, насколько близок мир к достижению рекурсивного самосовершенствования (состояния, когда модель полностью автономно создает своего преемника).
Что мы измерили. Мы создали прототип индекса, отражающего долю исследований и разработок Anthropic в области ИИ, выполняемых моделью Claude (он называется индексом автоматизации R&D Anthropic). Он построен путем каталогизации всех видов R&D-работ в сфере ИИ, выполняемых в компании, оценки степени автоматизации каждой задачи в настоящее время и агрегирования этих оценок.
Что мы обнаружили. Чтобы измерить степень участия ИИ в R&D-процессах Anthropic, мы используем шкалу оценки автоматизации, разработанную Epoch AI, которая измеряет «уровень автоматизации» (Automation Level, AL). Она простирается от AL0 (отсутствие участия ИИ) до AL5 (ИИ работает полностью автономно, без участия человека в контуре). На уровне AL3 ИИ «сотрудничает»: он может выполнять большие объемы работы под пристальным руководством человека. На уровне AL4 ИИ «лидирует»: он способен выполнять большую часть задачи от начала до конца на основе высокоуровневой подсказки (промпта), в то время как человек осуществляет надзор1.
По состоянию на август 2026 года:
- Claude не работает полностью автономно ни в одной из измеряемых подзадач R&D в сфере ИИ.
- Claude «лидирует» в 26% R&D-работ Anthropic в области ИИ.
- Доля работы на уровне «ИИ сотрудничает» или выше составляет более 90%.
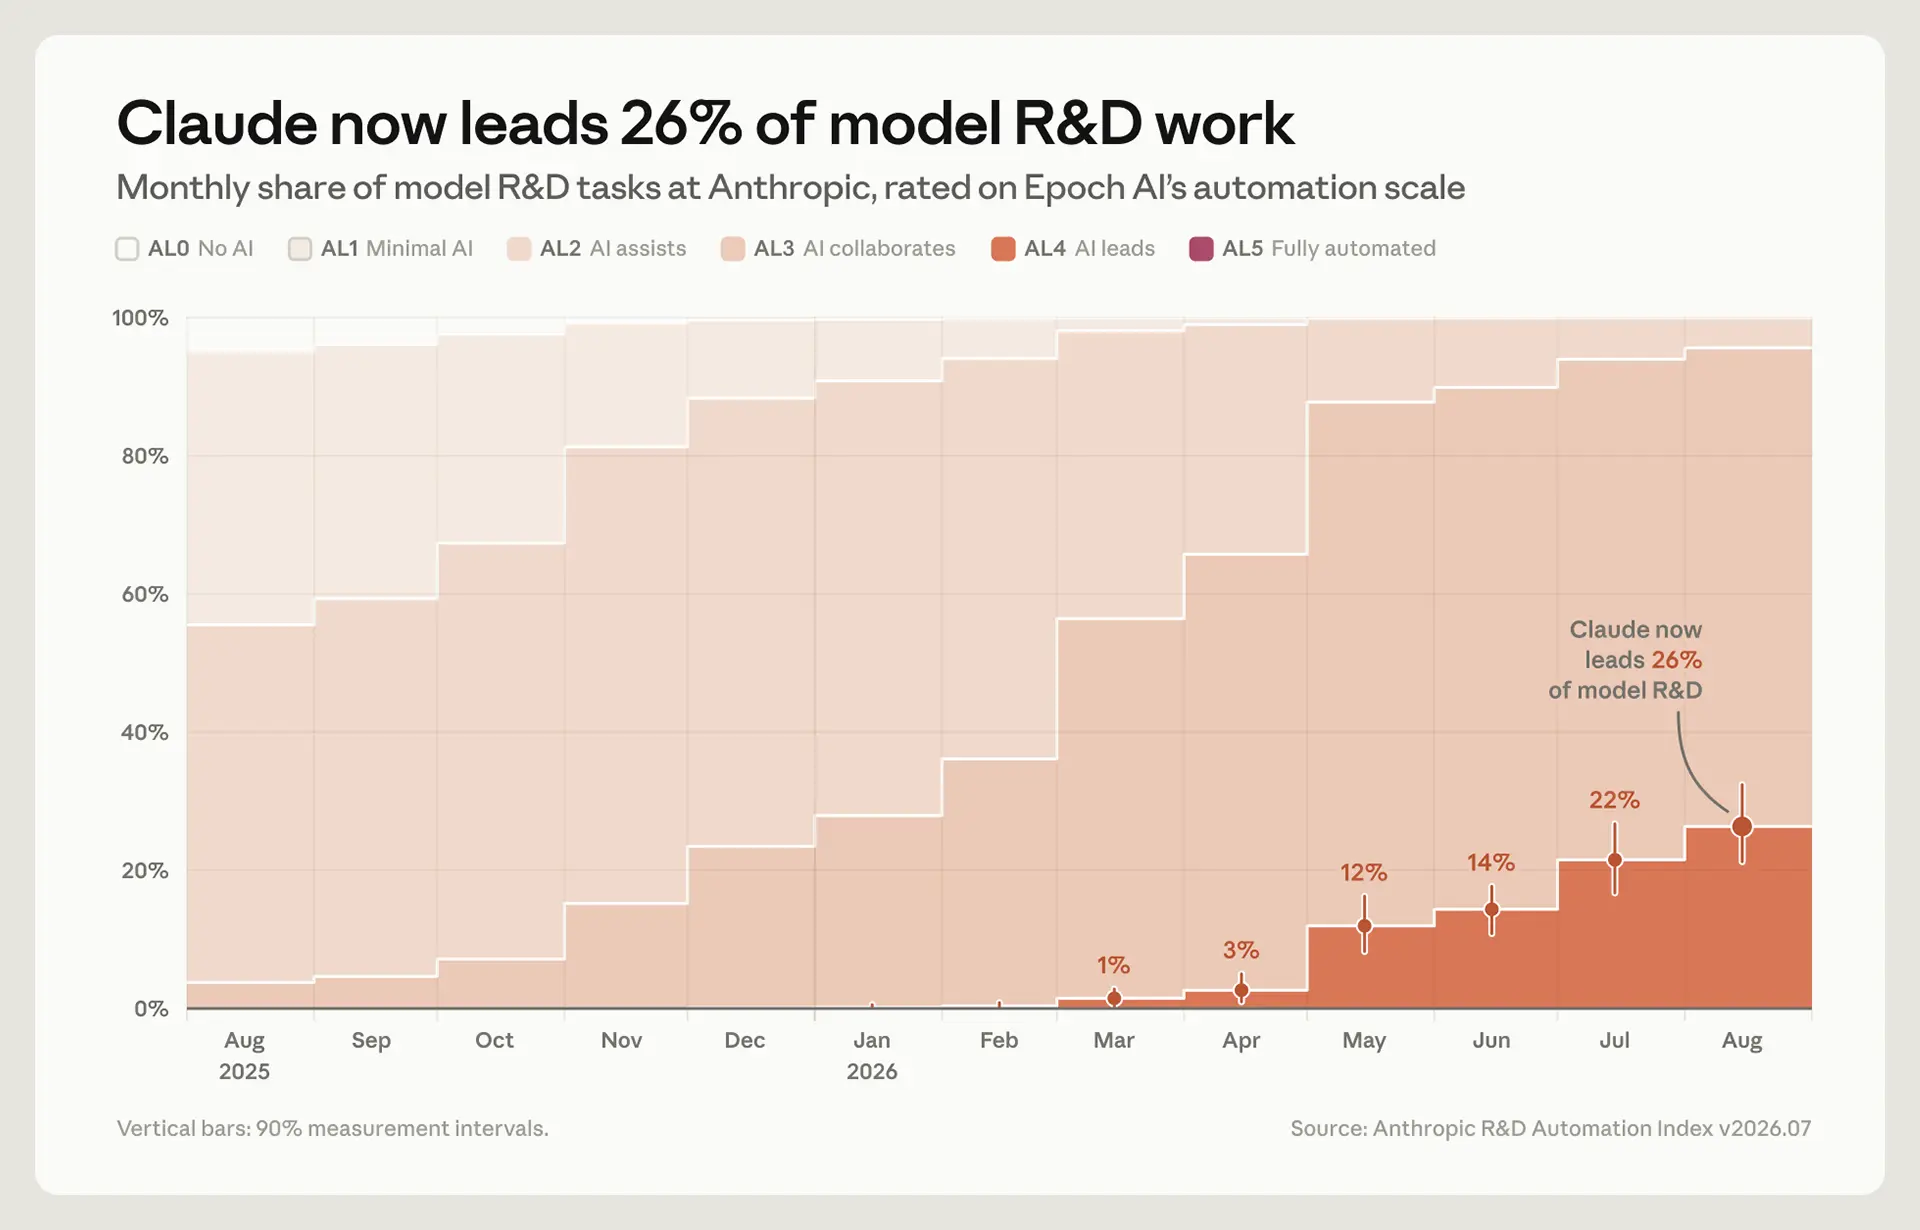
Что любой разработчик ИИ может опубликовать уже сегодня. Любой передовой разработчик может регулярно публиковать такие метрики, используя общедоступную методологию. Это позволило бы сопоставлять показатели с течением времени и, потенциально, между различными лабораториями.
На пути межлабораторного сравнения такого рода отчетности стоят два препятствия. Во-первых, отсутствие единой методологии. во-вторых, мы используем собственные модели для оценки наших систем, что означает: модель-«судья» может совершать те же типы ошибок, что и проверяемая модель. Чтобы преодолеть эти трудности, измерения разработчика могут проверяться третьей стороной или моделями других разработчиков при условии соблюдения мер предосторожности, ограничивающих обмен конфиденциальными данными, составляющими коммерческую тайну. Такие показатели также могут стать триггером для введения более жестких требований, таких как фиксированное окно тестирования перед использованием новой модели для дальнейших R&D в сфере ИИ.
(2) Измерение надзора за ИИ-агентами
Зачем измерять надзор за агентами? Подобно другим передовым разработчикам, сотрудники Anthropic все чаще делегируют задачи агентам, которые работают полуавтономно в течение длительного времени и передают работу друг другу. По мере того как работа становится все более автоматизированной — от уровня «ИИ сотрудничает» к «ИИ лидирует», — агенты смогут принимать более судьбоносные решения, например, какое направление исследований выбрать дальше.
Эти решения нуждаются в мерах предосторожности для пресечения вредоносного поведения отдельного агента, а также в режиме надзора для обнаружения проблем, которые могут проявиться только при взаимодействии множества агентов. Согласно нашим текущим данным мониторинга, отдельные агенты редко ведут себя неподобающим образом. Но когда в экономике функционируют миллионы или миллиарды агентов, даже редкие события могут происходить регулярно.
Что мы измерили. Мы создали систему, которая позволяет нам осуществлять надзор за действиями ИИ-агентов в системах Anthropic и вмешиваться в них. Здесь мы рассматриваем три различные метрики: охват (coverage), описывающий долю действий агента, которые проходят через монитор до или после выполнения; задержку проверки (review latency) — время между совершением действия и его проверкой, сначала автоматизированным монитором, а затем человеком; и уровень эскалации (escalation rate) — долю активности агентов, которая либо блокируется/перенаправляется (в случае онлайн-мониторов), либо помечается для дальнейшего рассмотрения (в случае оффлайн-мониторов).
Что мы обнаружили. По состоянию на август 2026 года на нашей наиболее используемой внутренней платформе одновременно работало примерно 30 000 агентов, выполнявших исследовательские и инженерные задачи. Эти измерения охватывают только данную платформу. Действия этих агентов ограничиваются двумя типами мониторов, описанными ниже:
| Онлайн-мониторы | Оффлайн-мониторы | |
| Описание | Онлайн-мониторы проверяют действия агентов в режиме реального времени и либо блокируют опасные действия, либо автоматически корректируют нежелательное поведение агентов. Они созданы для предотвращения вреда, который происходит быстро и не может быть отменен (например, попытка агента скопировать веса модели из наших систем). | Оффлайн-мониторы анализируют действия агентов постфактум. Они предназначены для устранения опасных моделей поведения, которые развиваются медленно и обратимы (например, признаки расогласования моделей). Мы используем отмеченную активность для улучшения наших средств защиты, таких как классификаторы и детерминированные элементы управления. Если бы ситуация создавала непосредственную и масштабную угрозу, мы бы отключили опасные компоненты развертывания агента. |
| Охват | 100% действий этих агентов проходят через онлайн-монитор перед выполнением, обычно в течение нескольких секунд. | 100% действий этих агентов поступают в монитор после их совершения. |
| Задержка проверки | Автоматизированная проверка происходит до того, как агент совершит действие; люди проверяют любые заблокированные действия в течение недели. | Монитор фиксирует примерно 100 000 стенограмм в неделю, которые затем проверяются несколькими классификаторами на предмет ложноположительных срабатываний и первичного надзорного контроля. Большинство таких сигналов разрешается в ходе этого процесса, а сигналы с наивысшим приоритетом (примерно ~50 в неделю) эскалируются для проверки человеком. |
| Уровень блокировки / эскалации | Мы проанализировали более миллиарда решений наших исследовательских и инженерных агентов за август 2026 года и обнаружили, что 0,002% из них (около 1 из 47 000) были заблокированы этим монитором. | Монитор помечает примерно одну-две стенограммы из тысячи для дальнейшего рассмотрения. |
Что разработчик ИИ может опубликовать уже сегодня. Любой разработчик, запускающий агентов для выполнения собственных исследовательских и инженерных задач, может публиковать те же показатели: охват (долю отслеживаемой активности агентов), задержку проверки (как быстро проверяются помеченные действия) и уровень эскалации (какую долю действий агентов мониторы блокируют или помечают). В совокупности эти метрики позволят общественности увидеть, поспевает ли надзор за растущей ролью ИИ в исследованиях и разработках. Мы опубликовали все эти измерения в нашем недавнем отчете о рисках.
Разработчики должны делиться информацией о том, как часто мониторы фиксируют известное отклоняющееся от нормы поведение агентов, и привлекать третьи стороны для независимого тестирования такого рода. Ранее организация METR уже проводила независимое тестирование на проникновение (red-teaming) нашей оффлайн-платформы мониторинга. Как отмечалось выше, сейчас мы привлекаем внешних сторонних оценщиков в Anthropic.
(3) Измерение распределения вычислительных мощностей
Зачем измерять распределение вычислений? Говоря в общем, разработчики ИИ используют вычислительные мощности для создания более мощных моделей, обслуживания клиентов и работ, ориентированных на безопасность, таких как аудит «мыслей» модели, обучение модельных организмов для изучения расогласования и оценка возможности безопасного развертывания модели. Понимание того, как разработчики ИИ распределяют свои вычислительные ресурсы, может подсказать, на чем именно разработчик фокусирует внимание и как этот фокус меняется со временем.
Кроме того, вычислительные мощности являются одним из наиболее проверяемых ресурсов в процессе R&D в сфере ИИ, что означает их потенциальную роль в качестве важнейшего рычага в будущих мерах по регулированию темпов. Согласованные усилия по регулированию темпов могут побудить компании увеличить долю вычислений, направляемых на безопасность по всей отрасли, и выделить больше ресурсов на проблему согласования (alignment), интерпретируемость, тестирование безопасности и оценку.
Что мы измерили. Мы изучили срез использования всех вычислительных ресурсов Anthropic в период с 13 по 20 июля2. Для этого мы распределили все рабочие нагрузки по небольшому числу категорий, а затем оценили, какая часть вычислительных ресурсов, направленных на R&D в сфере ИИ, пришлась на задачи обеспечения безопасности.
Исследования в области безопасности по своей природе обычно требуют меньше вычислительных мощностей, чем запуски обучения передовых моделей, поэтому объем вычислений является несовершенным показателем того, насколько сильно компания сосредоточена на безопасности. Это связано с тем, что исследования безопасности состоят из разработки экспериментов отдельными исследователями, что требует много времени, даже если сам запуск экспериментов не особенно ресурсоемк. Ценность этой метрики заключается не столько в абсолютных цифрах, сколько в том, что она предоставляет простой механизм для сравнения однородных данных между разработчиками и с течением времени.
Что мы обнаружили. За исследуемую неделю около 6% вычислительных мощностей, направленных на R&D в сфере ИИ, были выделены на обеспечение безопасности, а около 12% вычислений, направленных на R&D под руководством ИИ, были задействованы для тех же целей.
Это заведомо консервативные оценки. Например, если токен использовался для развития возможностей модели в той же степени, что и для обеспечения ее безопасности, он не учитывался в этих метриках. Кроме того, эти метрики не учитывают классификаторы безопасности, на которые уходит сопоставимый объем вычислений, делающий наши модели гораздо более безопасными для мира.
Что разработчик ИИ может опубликовать уже сегодня. Любой передовой разработчик может опубликовать информацию о том, какая доля его вычислительных ресурсов для R&D в сфере ИИ идет на обеспечение безопасности, приложив определения категорий и проверив классификацию с помощью независимой третьей стороны.
Исследования в области безопасности трудно отделить от исследований возможностей, и каждый разработчик будет испытывать искушение провести черту в свою пользу. Бремя доказывания того, что работа связана с безопасностью, должно лежать на разработчике. Разработчикам, правительствам и более широкому исследовательскому сообществу было бы полезно заранее прийти к единому общему определению. Подобный показатель мог бы послужить основой для будущих мер, таких как обязательства лаборатории относительно доли вычислений, направляемых на исследования безопасности, или ограничения на долю вычислений, выделяемых исследовательным агентам на базе ИИ.
Заключение
Поскольку мир рассматривает вопрос о регулировании темпов развития передового ИИ, мы должны сделать все возможное, чтобы минимизировать разрыв между тем, что знают передовые лаборатории, и тем, что известно общественности. Это означает улучшение измерений процесса разработки ИИ, их публичное освещение и предоставление обществу возможности решить, как использовать эту информацию. Мы надеемся подать пример такой прозрачности, выпустив эти измерения, и намерены продолжать эту практику в будущем.
Приложение
Ниже приведены методологические детали всех разработанных нами прототипов измерений.
Измерение R&D под руководством ИИ
Как мы это сделали. Индекс автоматизации требует трех составляющих: полной карты всех задач R&D в сфере ИИ, выполняемых в Anthropic, способа оценки уровня автоматизации и способа взвешивания задач, чтобы важные области работы имели больший вес, чем менее важные. Ни один человек не может вручную перечислить каждую задачу R&D в сфере ИИ в передовой ИИ-компании, по крайней мере, с той степенью детализации, которая нам необходима. Вместо этого мы построили этот список задач снизу вверх на основе рабочих записей, включая Slack и различные источники внутренней документации.
Каждую неделю июля 2026 года мы случайным образом выбирали 20% сотрудников из каждого отдела, формирующего цикл R&D моделей. Исследовательский агент Claude проанализировал неделю каждого выбранного сотрудника с помощью Slack и внутренней документации и перечислил задачи, над которыми они работали. Повторив эту процедуру для каждой недели июля 2026 года, мы получили плоский список из примерно 15 000 детальных задач по R&D моделей. Затем мы использовали Claude для организации этих задач в иерархическое дерево, начиная со всех R&D моделей в корне и разветвляясь на такие области, как обучение и продукт, затем предварительное обучение и обучение с подкреплением, и так далее до все более специфических видов работы. Получившееся дерево содержит 542 узла на разной глубине, из которых 378 являются листьями, такими как «диагностика и исправление дефектов платформы оценки», «сетевая политика и выход из песочницы RL» и «разбор инцидентов обслуживания». Мы фиксируем это дерево, чтобы каждое наше измерение производилось на основе одного и того же набора работ.
Для каждого узла в дереве (категории задач, описывающей всю работу под ним) агент Claude проводит глубокое исследование того, как выполняется данный вид работы по всей компании: кто ее делает, с помощью каких инструментов и какую часть выполняют ИИ-системы. Затем независимый судья Claude изучил полученные данные и присвоил один из шести уровней автоматизации, используя шкалу, предложенную Epoch AI для различения степени использования ИИ: отсутствие участия ИИ, минимальное участие ИИ, помощь ИИ, сотрудничество, лидерство или полная автономность. При оценке уровня автоматизации за конкретный месяц мы разрешаем исследовательским агентам, проводящим оценки, видеть данные только за этот месяц или более ранние периоды.
Чтобы объединить все оценки уровней автоматизации в одно число, мы хотим присвоить каждому узлу дерева вес, соответствующий тому, насколько важна эта работа для общих усилий по R&D моделей. Вместо того чтобы самим решать, какие виды работы важнее других, мы использовали в качестве прокси объем рабочего времени сотрудников, выделенный на эту задачу. Используя нашу выборку, мы поручили Claude исследовать, над чем работал каждый человек в течение каждой недели июля 2026 года. Каждый человек получает одну единицу веса в неделю, разделенную поровну между задачами, над которыми он работал на этой неделе. Если сотрудник А работал над четырьмя задачами, каждая получает по 0,25; если сотрудник Б работал над десятью, каждая получает по 0,10. Вес категории — это сумма всех весов рабочего времени сотрудников, приходящихся на нее. Это грубое приближение, но в среднем схема ведет себя разумно: она присваивает больший вес тем категориям, к которым приписано много людей.
Что это отражает, а что нет. Во-первых, оценки автоматизации зависят от модели-судьи. Чтобы проверить их, мы попросили сотрудников Anthropic, ответственных за соответствующие рабочие области, оценить относительную автоматизацию своих направлений. Для обеспечения беспристрастности сотрудники выставляли оценки, не зная, какие данные собрали модели и как они их оценили. Наша модель-судья соглашалась с людьми примерно так же часто, как люди соглашались друг с другом (точное совпадение оценок модели и человека составило 59%, человека и человека — 35%), а оценки модели и людей расходились не более чем на один уровень в 97% случаев. При этом остается реальное пространство для разногласий в пограничных случаях, например, где именно заканчивается уровень «ИИ сотрудничает» и начинается «ИИ лидирует».
Во-вторых, набор задач зафиксирован. Растущее значение индекса по сравнению с базовым уровнем июля 2026 года говорит нам о том, что работа, которую люди выполняли в то время, автоматизируется; само по себе это не говорит нам о том, появляются ли новые виды работ, на которые переключились люди. Чтобы исследовать это, мы создали альтернативную версию зафиксированного дерева на основе данных за январь 2026 года и сравнили новые задачи, появляющиеся каждый месяц с февраля по июль 2026 года, с январским набором. Мы не обнаружили роста числа «новых» задач между январским и июльским наборами, что свидетельствует о стабильности структуры R&D-работ с ИИ на нашем уровне анализа. Тем не менее, мы планируем периодически пересобирать набор задач и при необходимости обновлять версии наших опубликованных показателей автоматизации.
Надзор за агентами
Как мы это сделали. В нашей наиболее часто используемой внутренней агентской платформе два проектных решения позволяют нам проще обнаруживать неизвестные неизвестные и позволяют агентам следить друг за другом:
- Идентичность. Большинство пользователей ИИ привыкли общаться с единственным «Claude» в рамках множества различных чатов. При работе множества агентов мы сочли важным наделить агентов индивидуальной идентичностью и привязать к ней все данные, которые создает агент. Это позволяет агенту отличать себя от других и относиться к тому, что исходит от другого агента, как к утверждению, требующему проверки, а не как к собственной мысли. Это снижает риск скоординированных действий, позволяя агентам принимать решения на основе своего индивидуального опыта. А поскольку идентичность не привязана к конкретной модели, она сохраняется при обновлениях модели, поэтому история агента остается непрерывной, даже если лежащая в ее основе базовая модель меняется. С точки зрения надзора такой подход гарантирует, что каждое действие может быть подвергнуто аудиту для каждого агента с течением времени, а каждая запись данных может быть соотнесена с конкретным агентом.
- Открытая коммуникация. Агенты общаются через общую открытую систему обмена сообщениями, а не приватно. Каждое сообщение привязано к идентичности отправившего его агента и может ссылаться на другой контент, благодаря чему агенты делятся первоисточниками. Это позволяет агентам избегать эффекта «испорченного телефона» при общении. Поскольку агенты видят сообщения друг друга, они могут исправлять ошибки друг друга и координировать совместную работу. Все сообщения сопоставляются со стенограммами агентов, что позволяет осуществлять поведенческий мониторинг коммуникаций между агентами.
Что это отражает, а что нет. При таком масштабе активности агентов трудно с уверенностью утверждать, что мы имеем полное представление обо всех возможных типах поведения или делаем эти паттерны достаточно доступными для человеческого надзора. Мы практикуем мониторинг такого рода в течение месяцев, а не лет, и ожидаем, что наука об агентном мониторинге в дальнейшем существенно изменится.
Измерение распределения вычислительных мощностей
Как мы это сделали. Мы начали с существующих инструментов мониторинга вычислений; у Anthropic, как и у любого другого передового разработчика, есть несколько созданных для планирования емкостей инструментов мониторинга, которые периодически выборочно опрашивают использование ускорителей и присваивают рабочим нагрузкам метки по принципу «лучших усилий» (например, исследования и разработка моделей, внутреннее использование, инференс для сторонних пользователей и т. д.) на основе метаданных. Использование сторонних облачных вычислений сообщается нам провайдерами и интегрируется в общую систему. Большая часть работы в рамках этой задачи заключалась в объединении этих разрозненных источников.
Затем мы использовали Claude для классификации каждой рабочей нагрузки как связанной с безопасностью или с R&D в сфере ИИ с помощью промпт-классификатора. Работа по безопасности определялась как деятельность, главной целью которой является сделать ИИ-системы более безопасными, понятными или защищенными. Все остальное, включая исследования возможностей, обучение производственных моделей, разработку продуктов и создание инструментов для разработчиков, учитывалось как R&D в сфере ИИ. Работа, которая помогает развитию возможностей в той же степени, что и обеспечению безопасности, также учитывалась как R&D в сфере ИИ, поэтому доля безопасности является консервативной.
Для исследовательских запусков обучения и оценки мы создали классификатор, который считывает метаданные запуска и использованный код, после чего выдает классификацию, обоснование и уровень уверенности. Вместо классификации всех почти 10 000 запусков за неделю мы отобрали около 14% из них, сместив выборку в сторону запусков, потреблявших больше всего вычислений, чтобы результат отражал реальное распределение ресурсов, а не количество запусков. Для инференса исследовательских ИИ-агентов вариант этого же классификатора считывал стенограмму сеанса агента. В случаях, когда стенограммы были недоступны (обычно из-за того, что работа была компартментализирована), мы классифицировали их по команде пользователя или консервативно относили по умолчанию к R&D в сфере ИИ. Мы планируем усовершенствовать этот конвейер, чтобы независимая третья сторона могла перезапустить классификатор на случайной подвыборке заданий и стенограмм и проверить как распределение по категориям, так и итоговые суммы.
You’re helping to perform an internal audit at the frontier AI company Anthropic to track where our research compute goes. The aim of the audit is to produce a public-facing breakdown of the usage of all of our AI accelerator chips into a handful of buckets. One split we particularly care about is the division between compute which was spent on safety research versus other R&D. Your job is to look at one research job at a time, figure out what it was doing, and assign it to one of those two buckets.

[...]

Safety and/or security research is work whose dominant purpose is making AI systems safer, more understandable, or more secure. This work can be broken down into a few main categories:

[...]

On the other hand, the following work falls outside of the scope of safety research:

[...]

Here are some boundary cases, along with how to think about them:

[...]
Что это отражает, а что нет. Главный вывод из этой работы заключается в том, что классификация того, что является и не является работой по безопасности, сложна, но выполнима, поскольку граница между этими категориями не является черно-белой. Например, исследования в области масштабируемого надзора могут сделать будущие модели более согласованными, а текущие — более полезными с коммерческой точки зрения: трудно определить, является ли это в первую очередь продвижением безопасности или возможностей. Мы обнаружили, что подробное письменное определение каждой задачи с четкими пограничными случаями (выдержка приведена выше) позволяет классификатору согласовывать свое мнение с мнением рецензентов-людей с погрешностью в один-два процентных пункта между оценками человека и машины. Тем не менее, некоторые случаи оказались слишком сложными для определения даже после нескольких часов экспертного анализа. Наше определение — лишь один из разумных вариантов среди многих; другой разработчик или регулятор может провести эту грань иначе.
Есть еще три важных ограничения. Во-первых, многие базовые метрики, на которые мы опираемся (например, причины запусков, теги рабочих нагрузок, источники трафика API), задаются автоматическими правилами или, изредка, напрямую пользователями, и они отражают лишь лучшие намерения, а не проверенные данные. В большинстве случаев наши классификации, судя по всему, точны, но иногда использование может быть неверно промаркировано, и наш пайплайн не обязательно это обнаружит. Оценка, которой должны доверять посторонние лица, должна быть полной, точной и обеспечиваться техническими средствами. Во-вторых, измерение охватывает одну неделю, чего достаточно, чтобы показать принципиальную возможность проведения таких измерений, но недостаточно для выявления значимого тренда. В-третьих, и это самое главное, доля вычислительных ресурсов измеряет только то, сколько было потрачено. Более эффективный классификатор безопасности или более быстрый стек инференса для производственных моделей снижают долю затрат на безопасность, но это не значит, что мы выполняем меньше работы по обеспечению безопасности. Накладные расходы наших собственных классификаторов снижались по мере повышения эффективности и росли, когда производственный инференс работал эффективнее самих классификаторов.
Марина Фаваро (Marina Favaro) и Филли Райт (Phillie Wright) выступили соавторами этой статьи при редакторской поддержке Санти Руиса (Santi Ruiz), Адама Фарины (Adam Farina) и Сары Поллак (Sarah Pollack). Джек Кларк (Jack Clark) осуществлял руководство исследованием. Дэн Альтман (Dan Altman), Керри Персен (Kerry Persen), АДЖ Кураби (AJ Kourabi), Джеймс Брэдбери (James Bradbury), Холден Карновски (Holden Karnofsky), Кевин Трой (Kevin Troy) и Авиталь Балвит (Avital Balwit) предоставили отзывы. Технические доказательства концепции были разработаны Джун Шерн Чаном (Jun Shern Chan), Брайаном Калвертом (Brian Calvert), Франческо Москони (Francesco Mosconi), Генри де Валансом (Henry de Valence), Фабьеном Роже (Fabien Roger) и Джо Бентоном (Joe Benton). Шан Картер (Shan Carter), Джонни Гомес (Johnnie Gomez), Мария Гонсалес (Maria Gonzalez), Фаяз Ашраф (Fayaz Ashraf), Моника Туховска (Monika Tuchowska) и Ким Вити (Kim Withee) создали визуальные материалы. Алекс Клауд (Alex Cloud) и Андреа Валлоне (Andrea Vallone) организовали семинар для проверки этих и других предложений по измерениям внешними экспертами.
Спасибо Нейту Рашу (Nate Rush), Эли Лифланду (Eli Lifland) и Питеру Вильдефорду (Peter Wildeford), которые также поделились своими отзывами.
Примечания
- Чтобы сделать эти уровни наглядными, рассмотрим рутинную задачу по обслуживанию инфраструктуры: ночной конвейер данных сломался и требует починки до завтрашнего запуска.
- На уровне AL3 («сотрудничество») инженер обратится к Claude с логами неудачных запусков. Возможно, он уже просмотрел логи и имеет гипотезу о том, что именно сломалось. Claude может расспросить его для уточнения деталей и контекста, и, как только инженер останется доволен, он разрешит Claude приступить к расследованию и исправлению. Если в процессе обнаружится дополнительная проблема, Claude остановится, а инженер решит, стоит ли обходить ее стороной или исправлять должным образом. После успешного прохождения тестов инженер может построчно проверить изменения, самостоятельно перезапустить конвейер и развернуть его.
- На уровне AL4 («руководство») ключевое отличие заключается в том, что инженеру не нужно постоянно оставаться вовлеченным в процесс — например, чтобы разблокировать Claude при появлении новых проблем. В этом конкретном сценарии инженер передает Claude уведомление об ошибке и просит починить конвейер. Claude самостоятельно изучает логи, находит проблемный этап (этапы) конвейера и причину, пишет и тестирует исправление, а также сам разбирается с любыми неожиданностями, документируя дополнительные исправления. Он перезапускает конвейер на копии данных, чтобы убедиться в его завершении, сравнивает результат с последним успешным запуском и описывает, что пошло не так и что было изменено. Claude не развернет исправление самостоятельно. Вместо этого он отметит инженера тегом, и тот прочитает отчет, просмотрит изменения, возможно, задаст пару вопросов и решит, отправлять ли исправление в продакшн сегодня или подождать.
- На уровне AL5 («полная автономность») — уровне, которого мы еще не достигли — инженеру даже не придется привлекать внимание Claude к проблеме. Claude будет доверено самостоятельно отслеживать сбои, определять масштаб расследования, проектировать и внедрять исправление, тестировать его и развертывать в продакшене. Он по-прежнему будет сообщать о том, что он делает и почему, а также принимать отзывы людей, если они предлагаются, но человеку вообще не обязательно вмешиваться, если только он сам этого не захочет.
- Мы управляем вычислительными ресурсами как единым взаимозаменяемым пулом и динамически направляем их туда, где они наиболее эффективны, поэтому это лишь снимок того, как мощности распределялись в течение одной недели, а не фиксированное распределение. Эти инженерные категории не соответствуют тому, как классифицируются расходы.
Полный текст статьи читайте на Anthropic
