Как Claude способствует развитию биомолекулярного моделирования
- Claude оптимизировал более 30 открытых биомолекулярных моделей менее чем за четыре недели, ускорив их в среднем примерно в 4 раза.
- Режим Big точно моделирует системы свыше 10 000 токенов и запускает инференс для систем свыше 70 000 токенов на одном узле NVIDIA B300.
- Вместе с Adaptyv Bio организован конкурс: до $1 млн кредитов Claude, $250 000 вычислительных кредитов Modal и лабораторная проверка более 5 000 разработок.
Почему это важно: Эти модели используют молекулярные биологи, в том числе для поиска и разработки лекарств; их исходный код открыт научному сообществу.
В этой публикации мы рассказываем, как Claude ускорил работу моделей с открытым исходным кодом, которые учёные используют для прогнозирования и проектирования биомолекул, а также снизил потребление ими памяти. Работая в рамках Claude Science, Claude оптимизировал более 30 таких моделей менее чем за четыре недели, в среднем примерно в 4 раза ускорив их работу. Кроме того, он создал режим с низким потреблением памяти, который позволяет точно прогнозировать биомолекулярные системы размером более 10 000 токенов (аминокислот, нуклеотидов, а также атомов малых молекул и ионов) на одном узле с графическим процессором NVIDIA. Мы открываем исходный код всех оптимизированных моделей и объявляем конкурс по проектированию белков, который проводим совместно с Adaptyv Bio. На него выделено до 1 миллиона долларов в виде кредитов Claude, а более 5 000 разработок пройдут экспериментальную проверку в лаборатории.
Недавно мы представили результаты, демонстрирующие, как Claude способен разрабатывать de novo белки-связыватели, координируя модели с открытым исходным кодом для проектирования белков и прогнозирования их структуры на экспертном уровне. Связыватели de novo — это небольшие белки, разработанные вычислительными методами и способные прочно связываться с определённой молекулой-мишенью, чтобы активировать её, блокировать или доставлять к ней что-либо.
Хотя эта демонстрация обнадёжила и показала научный потенциал ИИ, став одним из первых шагов на пути к развитию разработки лекарств, для неё потребовалось больше ресурсов, чем доступно подавляющему большинству специалистов по проектированию белков. Мы разрешили Claude тратить до 10 000 долларов на каждую мишень на платформе ИИ-инфраструктуры Modal — это примерно 2 500 часов работы графических процессоров NVIDIA H100.
Чтобы сделать такие исследования доступнее, мы начали изучать способы оптимизации инференса, позволяющие эффективнее запускать эти модели. Первым результатом этой работы стало то, что Claude Mythos 5.1 ускорил семь биологических моделей с открытым исходным кодом, позволив запускать их до 2,5 раза быстрее.
Здесь мы представляем новые результаты: внутренняя исследовательская модель общего назначения смогла оптимизировать более 30 моделей глубокого обучения, обученных для решения различных биологических задач, например прогнозирования структуры и проектирования белков, а также для геномики и работы с белковыми языковыми моделями. В среднем Claude ускорил выполнение таких задач примерно в 4 раза при минимальной потере точности и почти в 2 раза — без изменения результатов. Claude также улучшил использование памяти этими моделями, благодаря чему стало возможным прогнозировать биомолекулярные системы беспрецедентного размера. Объединив эти результаты с упрощениями нашего прежнего агентного подхода к проектированию белков, мы показываем, что Claude может достигать сопоставимых результатов in silico при использовании на два порядка меньшего количества часов работы графических процессоров.
Помимо проектирования белков, эти специализированные биологические модели широко используются молекулярными биологами, в том числе для поиска и разработки лекарств. Сегодня мы открываем исходный код оптимизированных моделей (здесь), чтобы ими могло воспользоваться широкое научное сообщество. Подробнее об этом читайте в нашем техническом отчёте (здесь).
Чтобы дополнительно поддержать научное сообщество, мы также совместно с Adaptyv Bio проводим конкурс по проектированию белков. Компания Adaptyv Bio стала одним из пионеров открытых конкурсов по проектированию белков. Вместе мы выбрали пять сложных задач, находящихся на переднем крае современных возможностей. При поддержке Adaptyv, а также благодаря щедрым взносам Modal и Twist Bioscience мы выделяем до 1 миллиона долларов в виде кредитов Claude и 250 000 долларов в виде кредитов на вычисления Modal, а также обеспечиваем лабораторную проверку более 5 000 разработок. Дополнительная информация — (здесь), а подать заявку можно (здесь).
Ускоряем модели прогнозирования структуры и проектирования белков
Прогнозирование структуры белка — это определение его трёхмерной структуры только по последовательности аминокислот. Проектирование белка, в свою очередь, — это создание белка с определённой структурой, функцией или набором свойств. Вместе эти вычислительные инструменты позволяют учёным исследовать важнейшие биомолекулярные процессы — например, выяснять, как образуются раковые опухоли, — и создавать полезные молекулы, такие как лекарства, способные воздействовать на эти опухоли.
Современные модели прогнозирования структуры, такие как AlphaFold3, OpenFold3 и Boltz-2, тратят значительную часть вычислительного времени и памяти на две операции: треугольное внимание и треугольное умножение, которые выполняются над тройками токенов. Эти операции позволяют моделировать геометрию биомолекулярных систем, но требуют чрезвычайно больших вычислительных ресурсов, поскольку время выполнения и объём памяти растут кубически: увеличение размера системы вдвое требует в 8 раз больше времени и памяти, а втрое — в 27 раз.
Написание ядер — низкоуровневых программных слоёв, обеспечивающих взаимодействие с ускорителями вычислений, такими как графические процессоры, — является стандартным подходом к снижению этих затрат. Учитывая важность треугольного внимания и умножения, для них уже разрабатывали специализированные ядра: сначала cuEquivariance от NVIDIA (cuEquivariance), а недавно — среду выполнения NVIDIA BioNeMo Inference Runtime (BioNeMo-IR).
Оптимизируя инференс моделей прогнозирования структуры, мы вместе с Claude разработали FlashPairformer — набор специализированных ядер, ускоряющих треугольное внимание и умножение. Это решение устанавливает новый рекорд: в зависимости от конфигурации модели оно в среднем в 2,7–2,9 раза быстрее стандартного решения в этой области для треугольного внимания и в 1,7–3,2 раза быстрее для треугольного умножения.
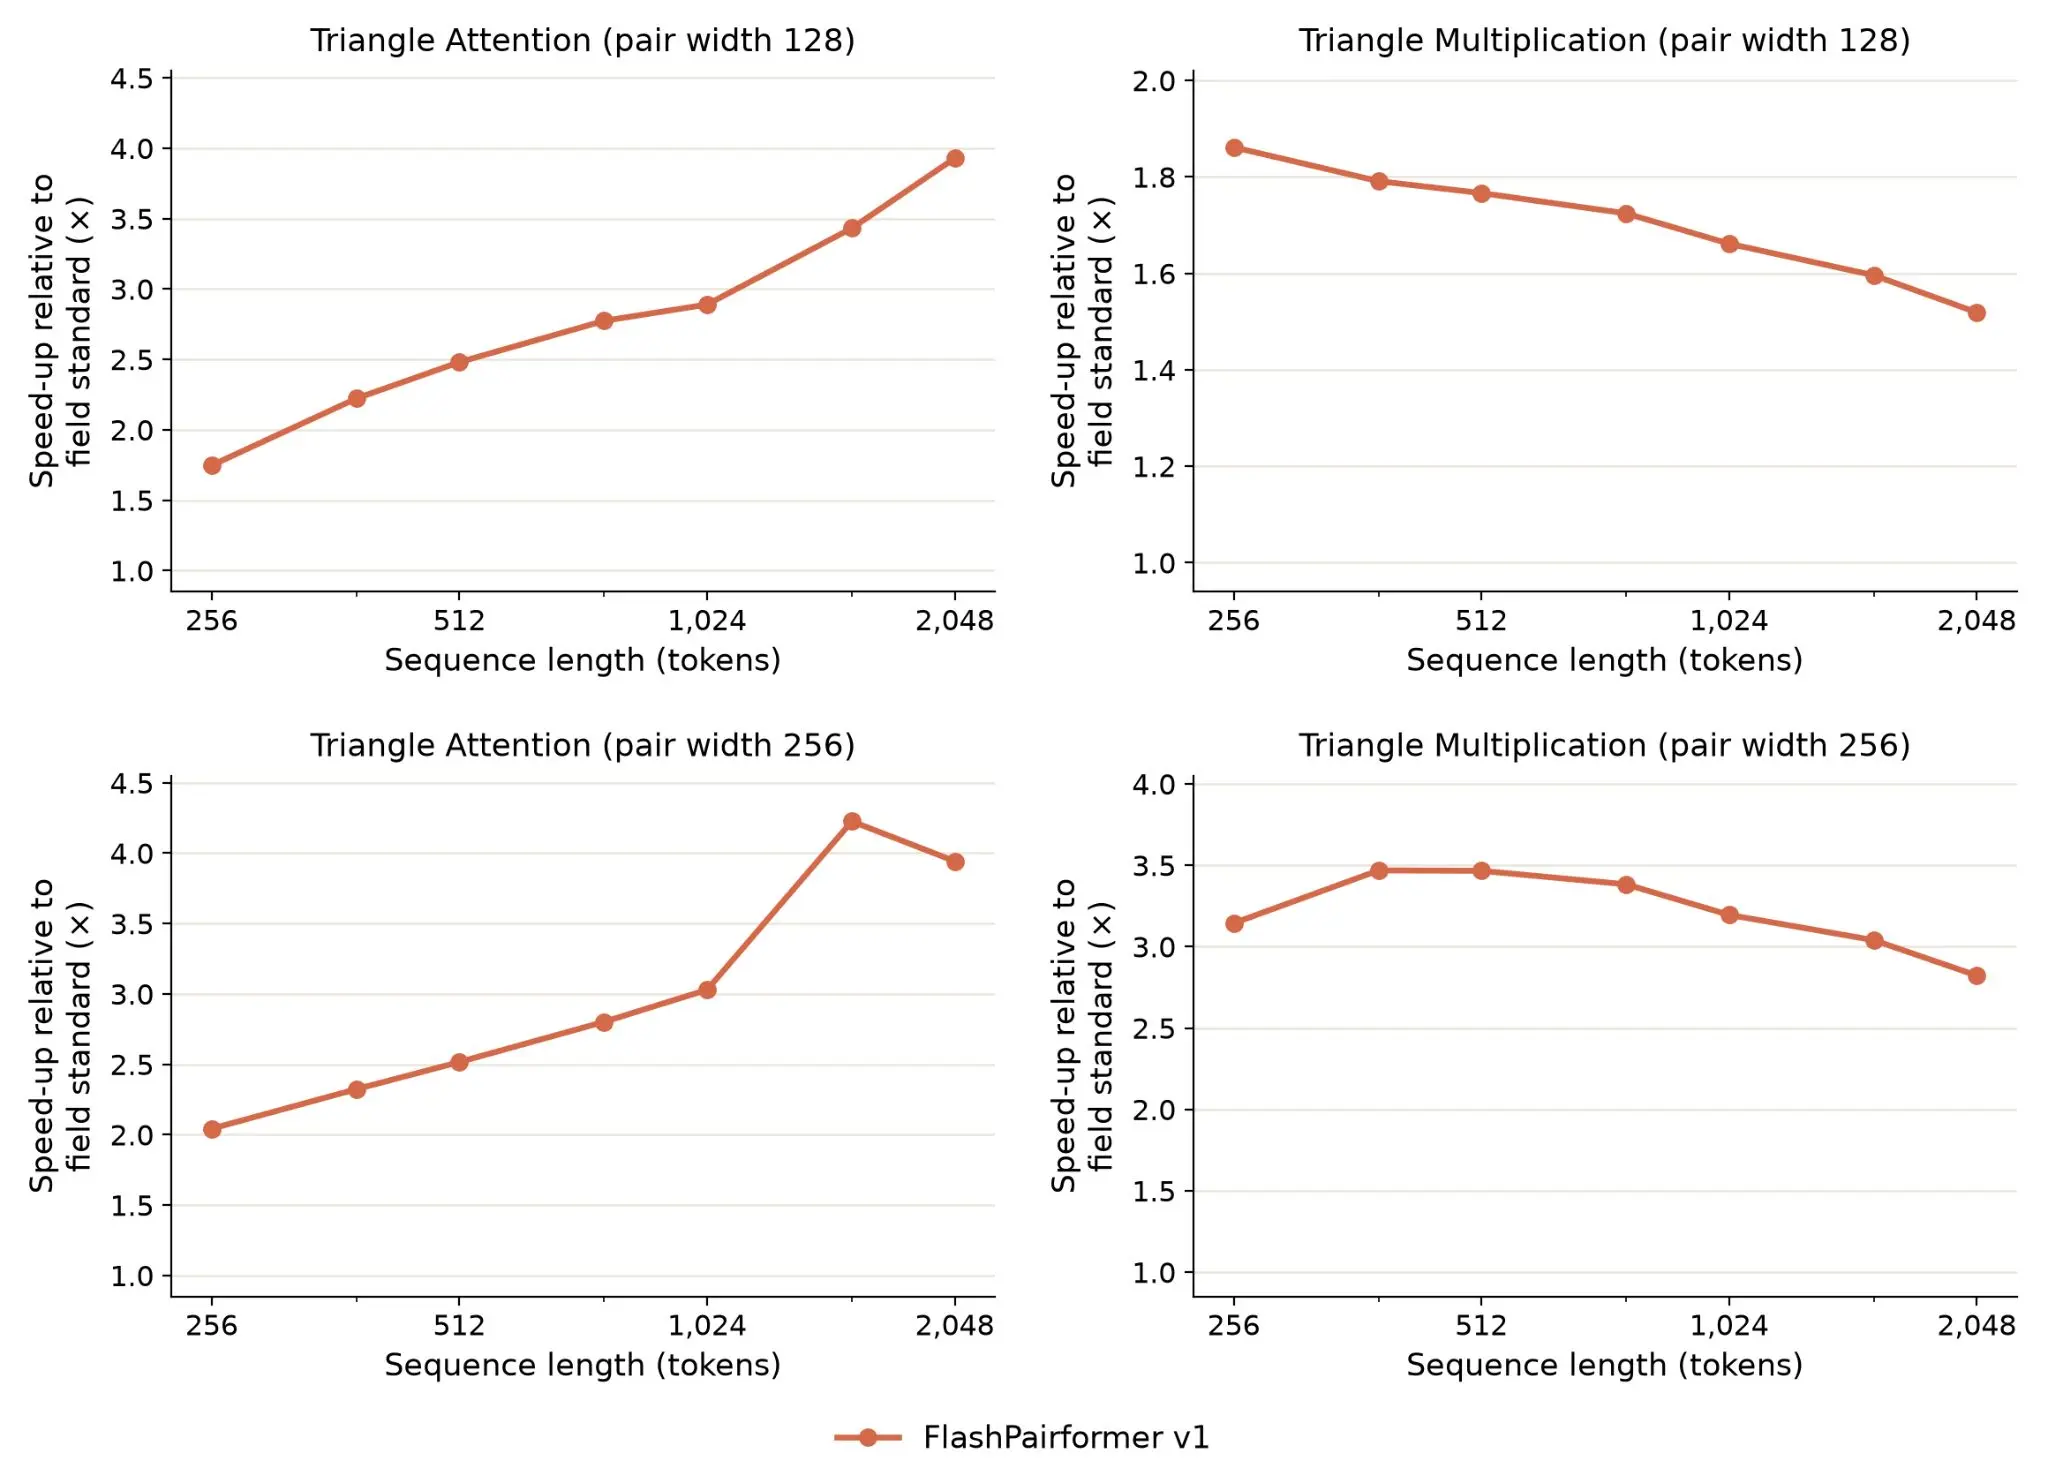 Вместе с Claude мы разработали FlashPairformer — набор специализированных ядер, ускоряющих треугольное внимание и умножение. Это основные компоненты архитектуры Pairformer, лежащей в основе передовых моделей прогнозирования структуры биомолекул. Результаты представлены относительно стандартного решения в этой области.
Помимо разработки переносимых ядер, мы поручили Claude оптимизировать каждую отдельную модель, чтобы добиться более существенного ускорения. Среди внесённых изменений — кэширование повторно вычисляемых данных и упрощение неисполняемых ветвей с заменой их на постоянные выходные значения. В совокупности эти улучшения ускорили модели прогнозирования структуры в среднем в 4 раза. Для каждой модели мы подтвердили, что ускоренные Claude версии не ухудшают результаты последующих задач, например прогнозирования структуры.
Опытной команде инженеров обычно требуется несколько недель, чтобы выполнить такую оптимизацию для каждой модели, причём полученные решения часто нельзя перенести на другие модели. Под руководством двух сотрудников технической команды Anthropic, имеющих опыт работы в области биомолекулярного моделирования, но не занимавшихся ранее оптимизацией инференса или разработкой ядер, Claude менее чем за четыре недели ускорил более 30 моделей с открытым исходным кодом для прогнозирования структуры биомолекул, проектирования белков, моделирования белковых языков и геномики. Наши результаты позволяют предположить, что передовые модели ИИ помогут специалистам этой области быстрее и проще создавать научные инструменты.
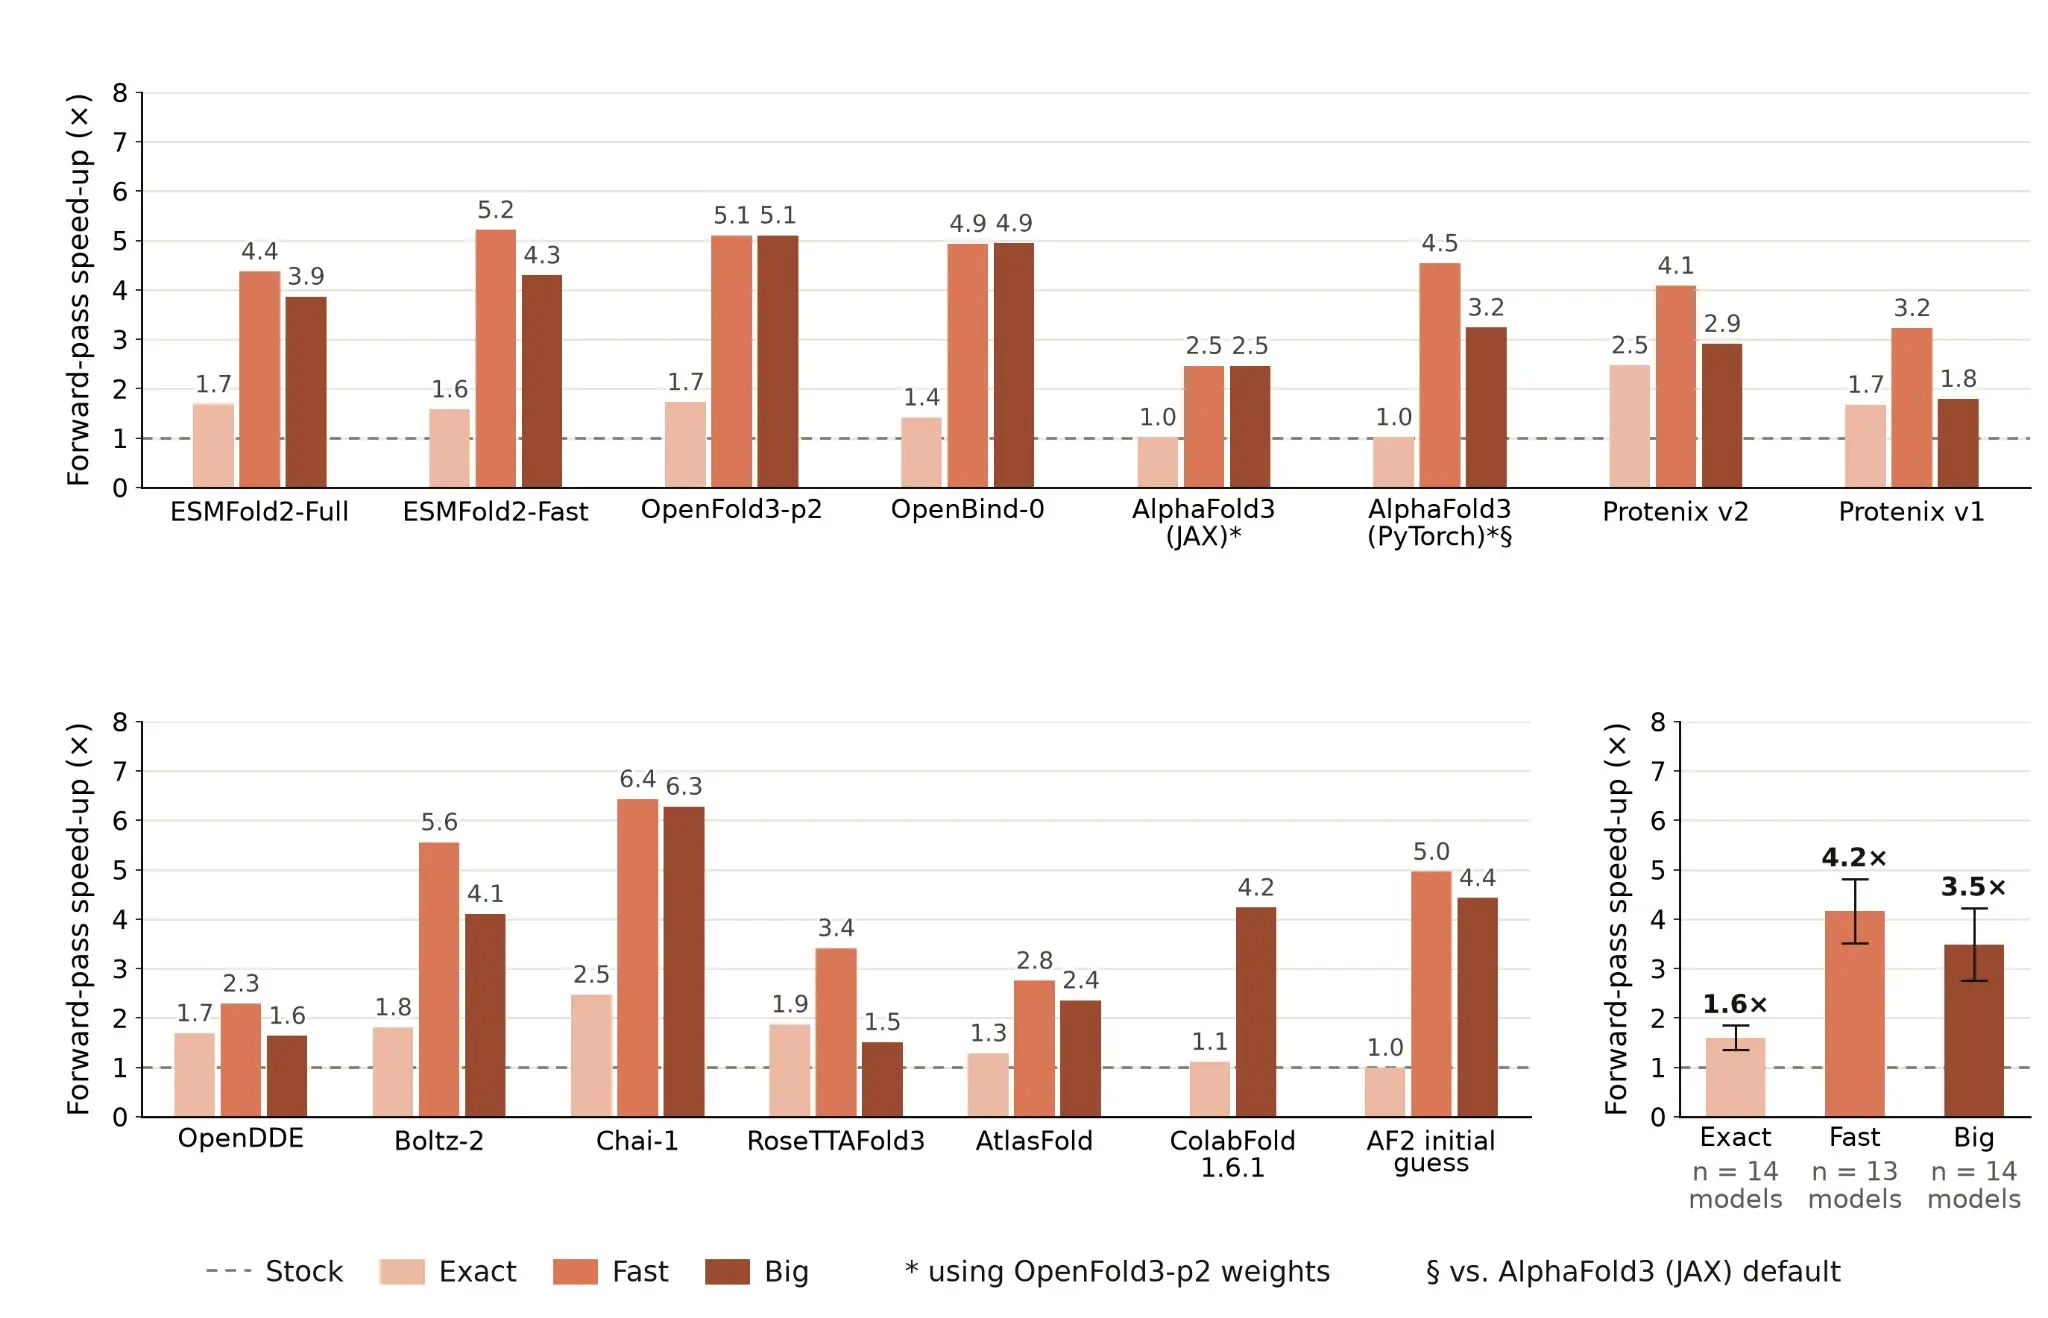 Оптимизации Claude ускорили более десятка моделей прогнозирования структуры биомолекул: в среднем примерно в 4 раза при минимальном снижении точности и примерно в 1,6 раза при неизменных результатах. Примечание: ещё не проведено сравнение с опциональными быстрыми ядрами ColabFold 1.6.3, выпущенными одновременно.
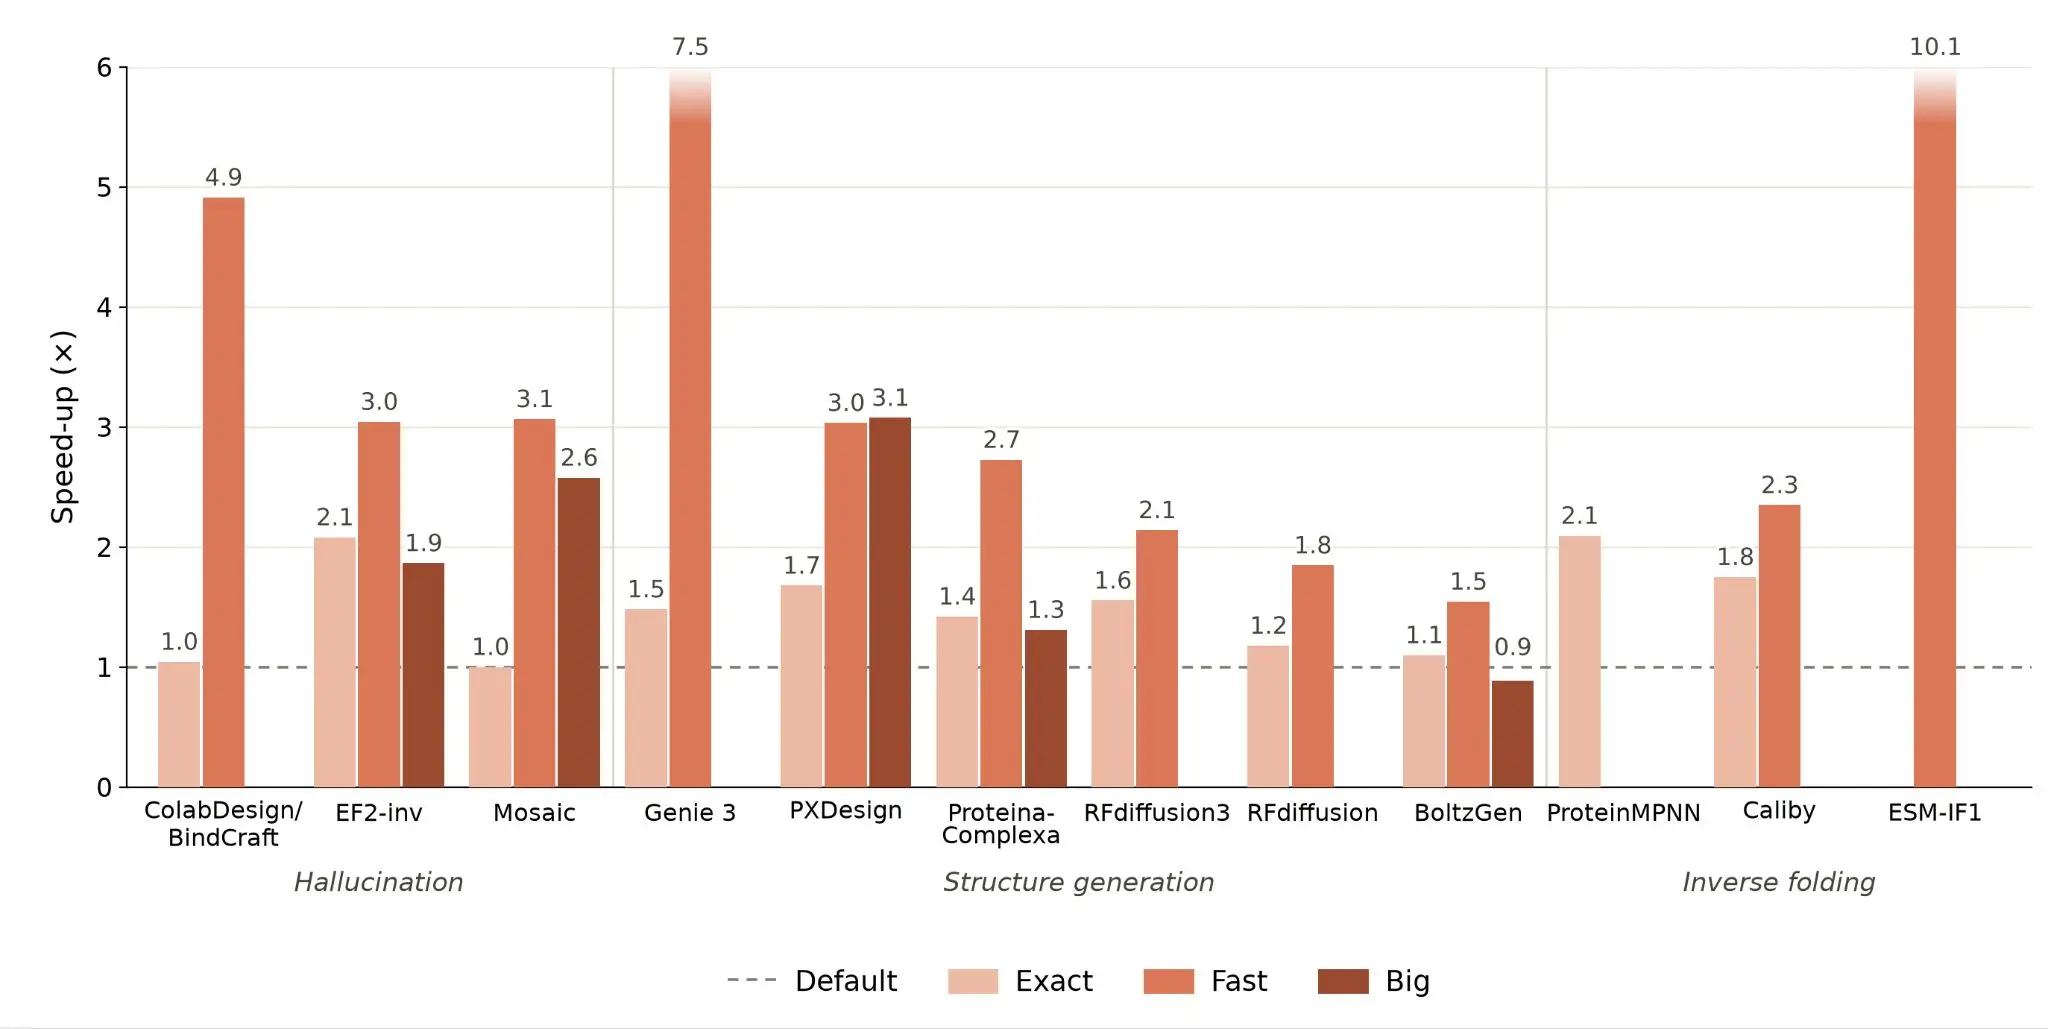 Оптимизации Claude также ускорили несколько моделей проектирования белков, предназначенных для галлюцинации, генерации структур и обратного фолдинга. Эти модели используют различные архитектуры, в том числе структурные трансформеры класса AlphaFold, диффузионные модели, сопоставление потоков и графовые нейронные сети.
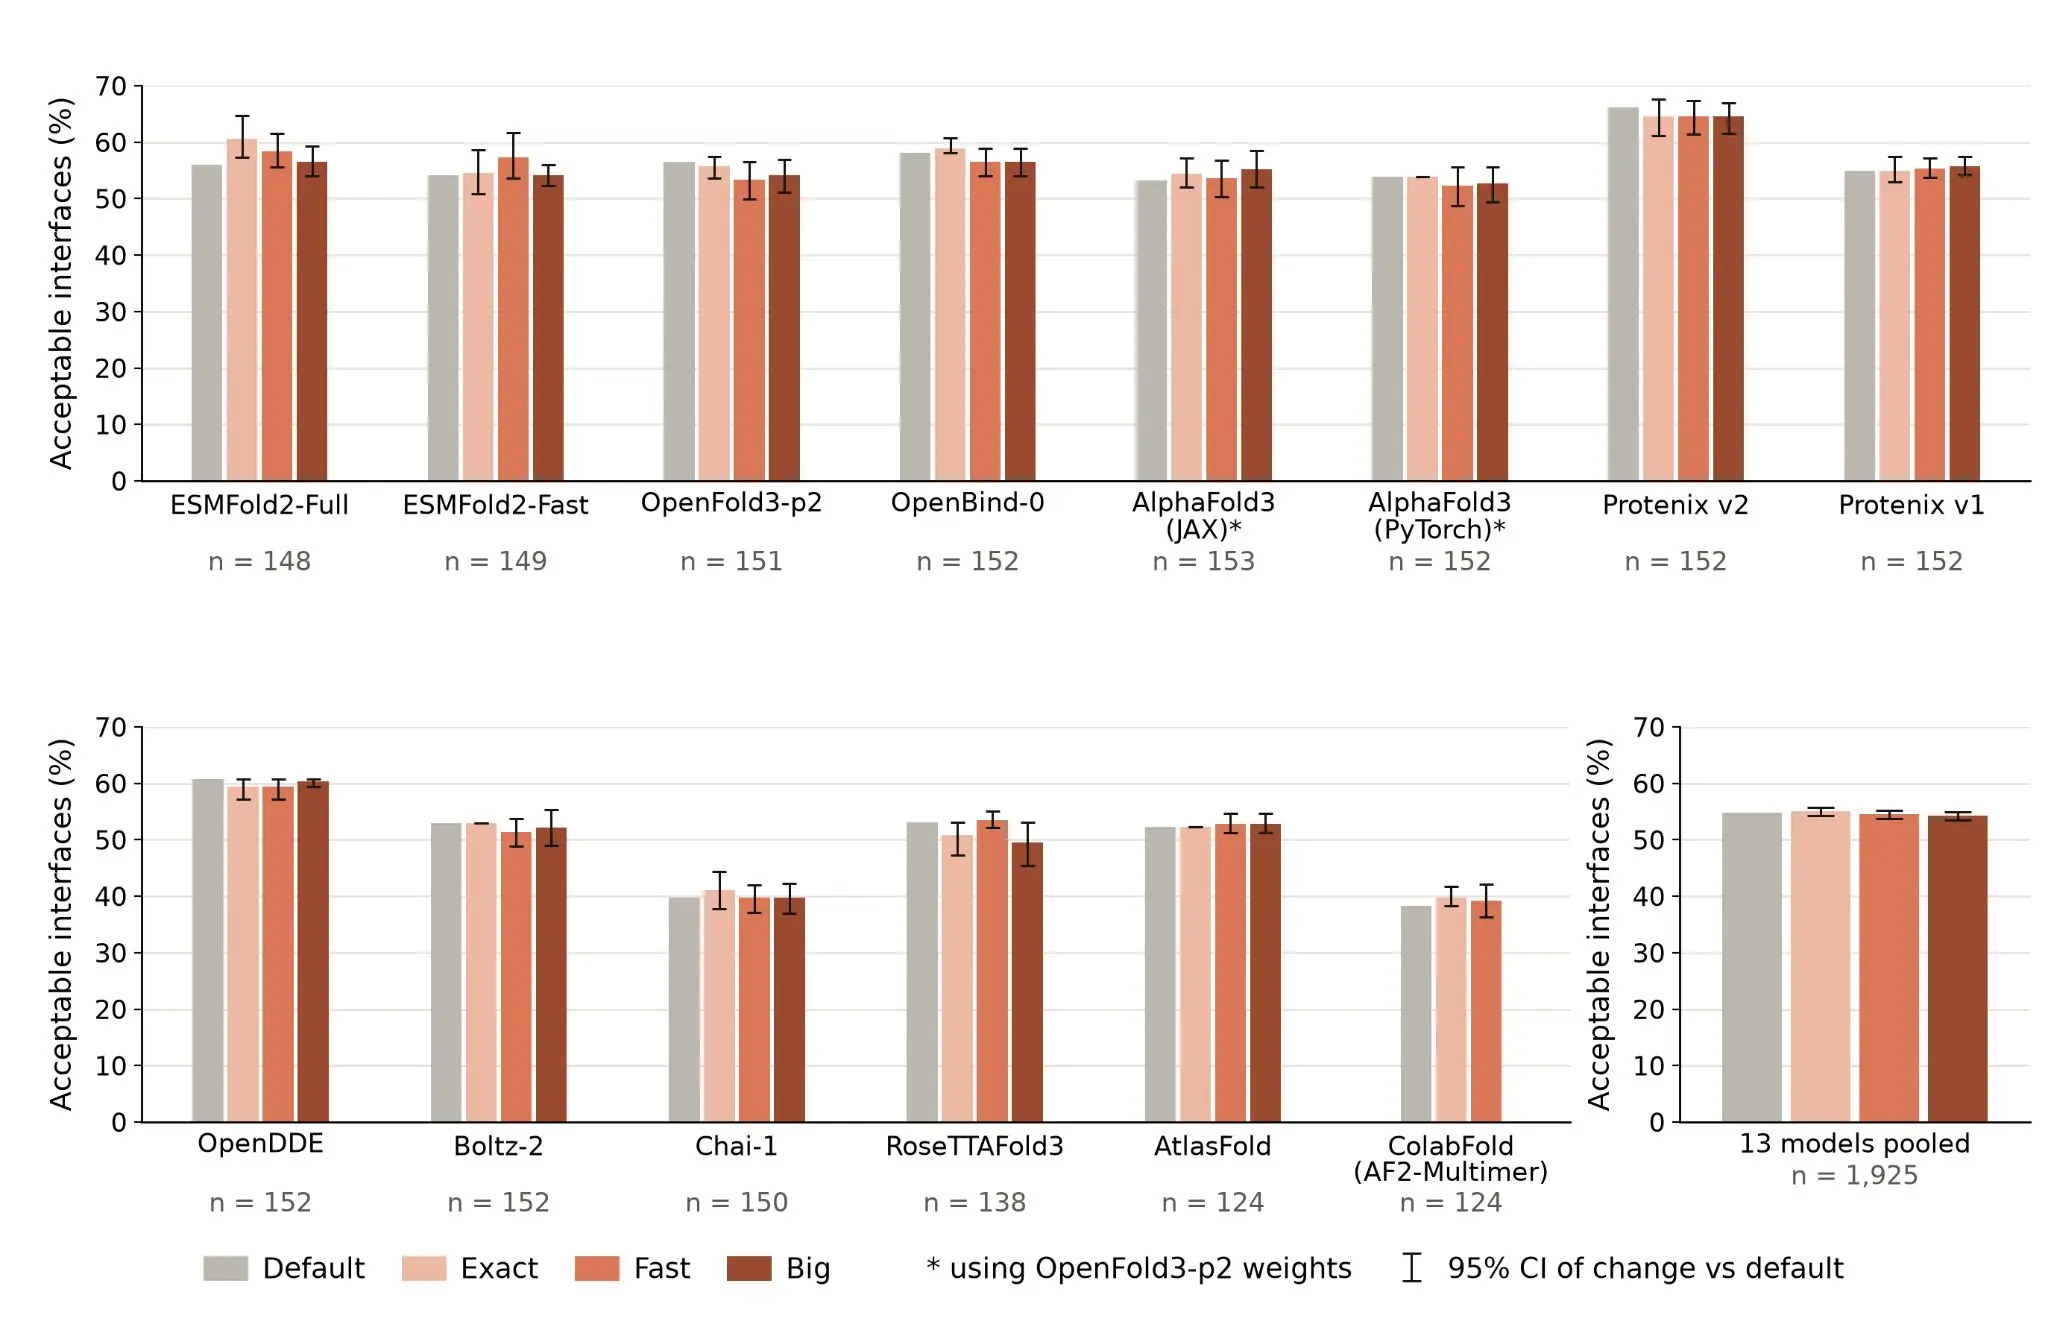 Разработанные нами быстрые режимы прогнозирования структуры статистически неотличимы от настроек по умолчанию на объединённом наборе биомолекулярных интерфейсов. Мы считаем предсказанный интерфейс приемлемым, если его оценка DockQ превышает 0,23.
Моделирование огромных биомолекулярных систем
Помимо ускорения моделей прогнозирования структуры и проектирования белков, мы попросили Claude снизить потребление памяти при моделировании крупных молекулярных комплексов. В клетке многие процессы выполняются именно такими системами: например, рибосома строит белки, дыхательные комплексы снабжают клетку энергией, а шапероны помогают другим белкам сворачиваться. Каждая такая система состоит из десятков компонентов, и её функции зависят от того, как эти компоненты сочетаются и взаимодействуют друг с другом. Прогнозирование структуры столь крупных систем обычно требовало значительных вычислительных ресурсов, недоступных большинству молекулярных биологов, например запуска инференса сразу на нескольких узлах с графическими процессорами.
Claude создал режим «Big» с низким потреблением памяти, который позволяет точно моделировать системы размером более 10 000 токенов и успешно выполнять инференс для систем размером более 70 000 токенов всего на одном узле с графическими процессорами NVIDIA. Ранее такая задача была недостижима. Среди молекулярных комплексов, успешно смоделированных в режиме Big, — митохондриальный комплекс I человека, шапероновый комплекс TRiC, протеасома и бактериальная рибосома. Их структуры близко соответствуют экспериментально установленным. Насколько нам известно, это одни из крупнейших структур, которые удалось точно смоделировать с помощью моделей прогнозирования структуры. Комплекс I и рибосома 70S состоят более чем из 10 000 токенов каждый. Для сравнения: с помощью AlphaFold3 удалось точно предсказать структуру рибосомы 40S, состоящей из 7 663 токенов.
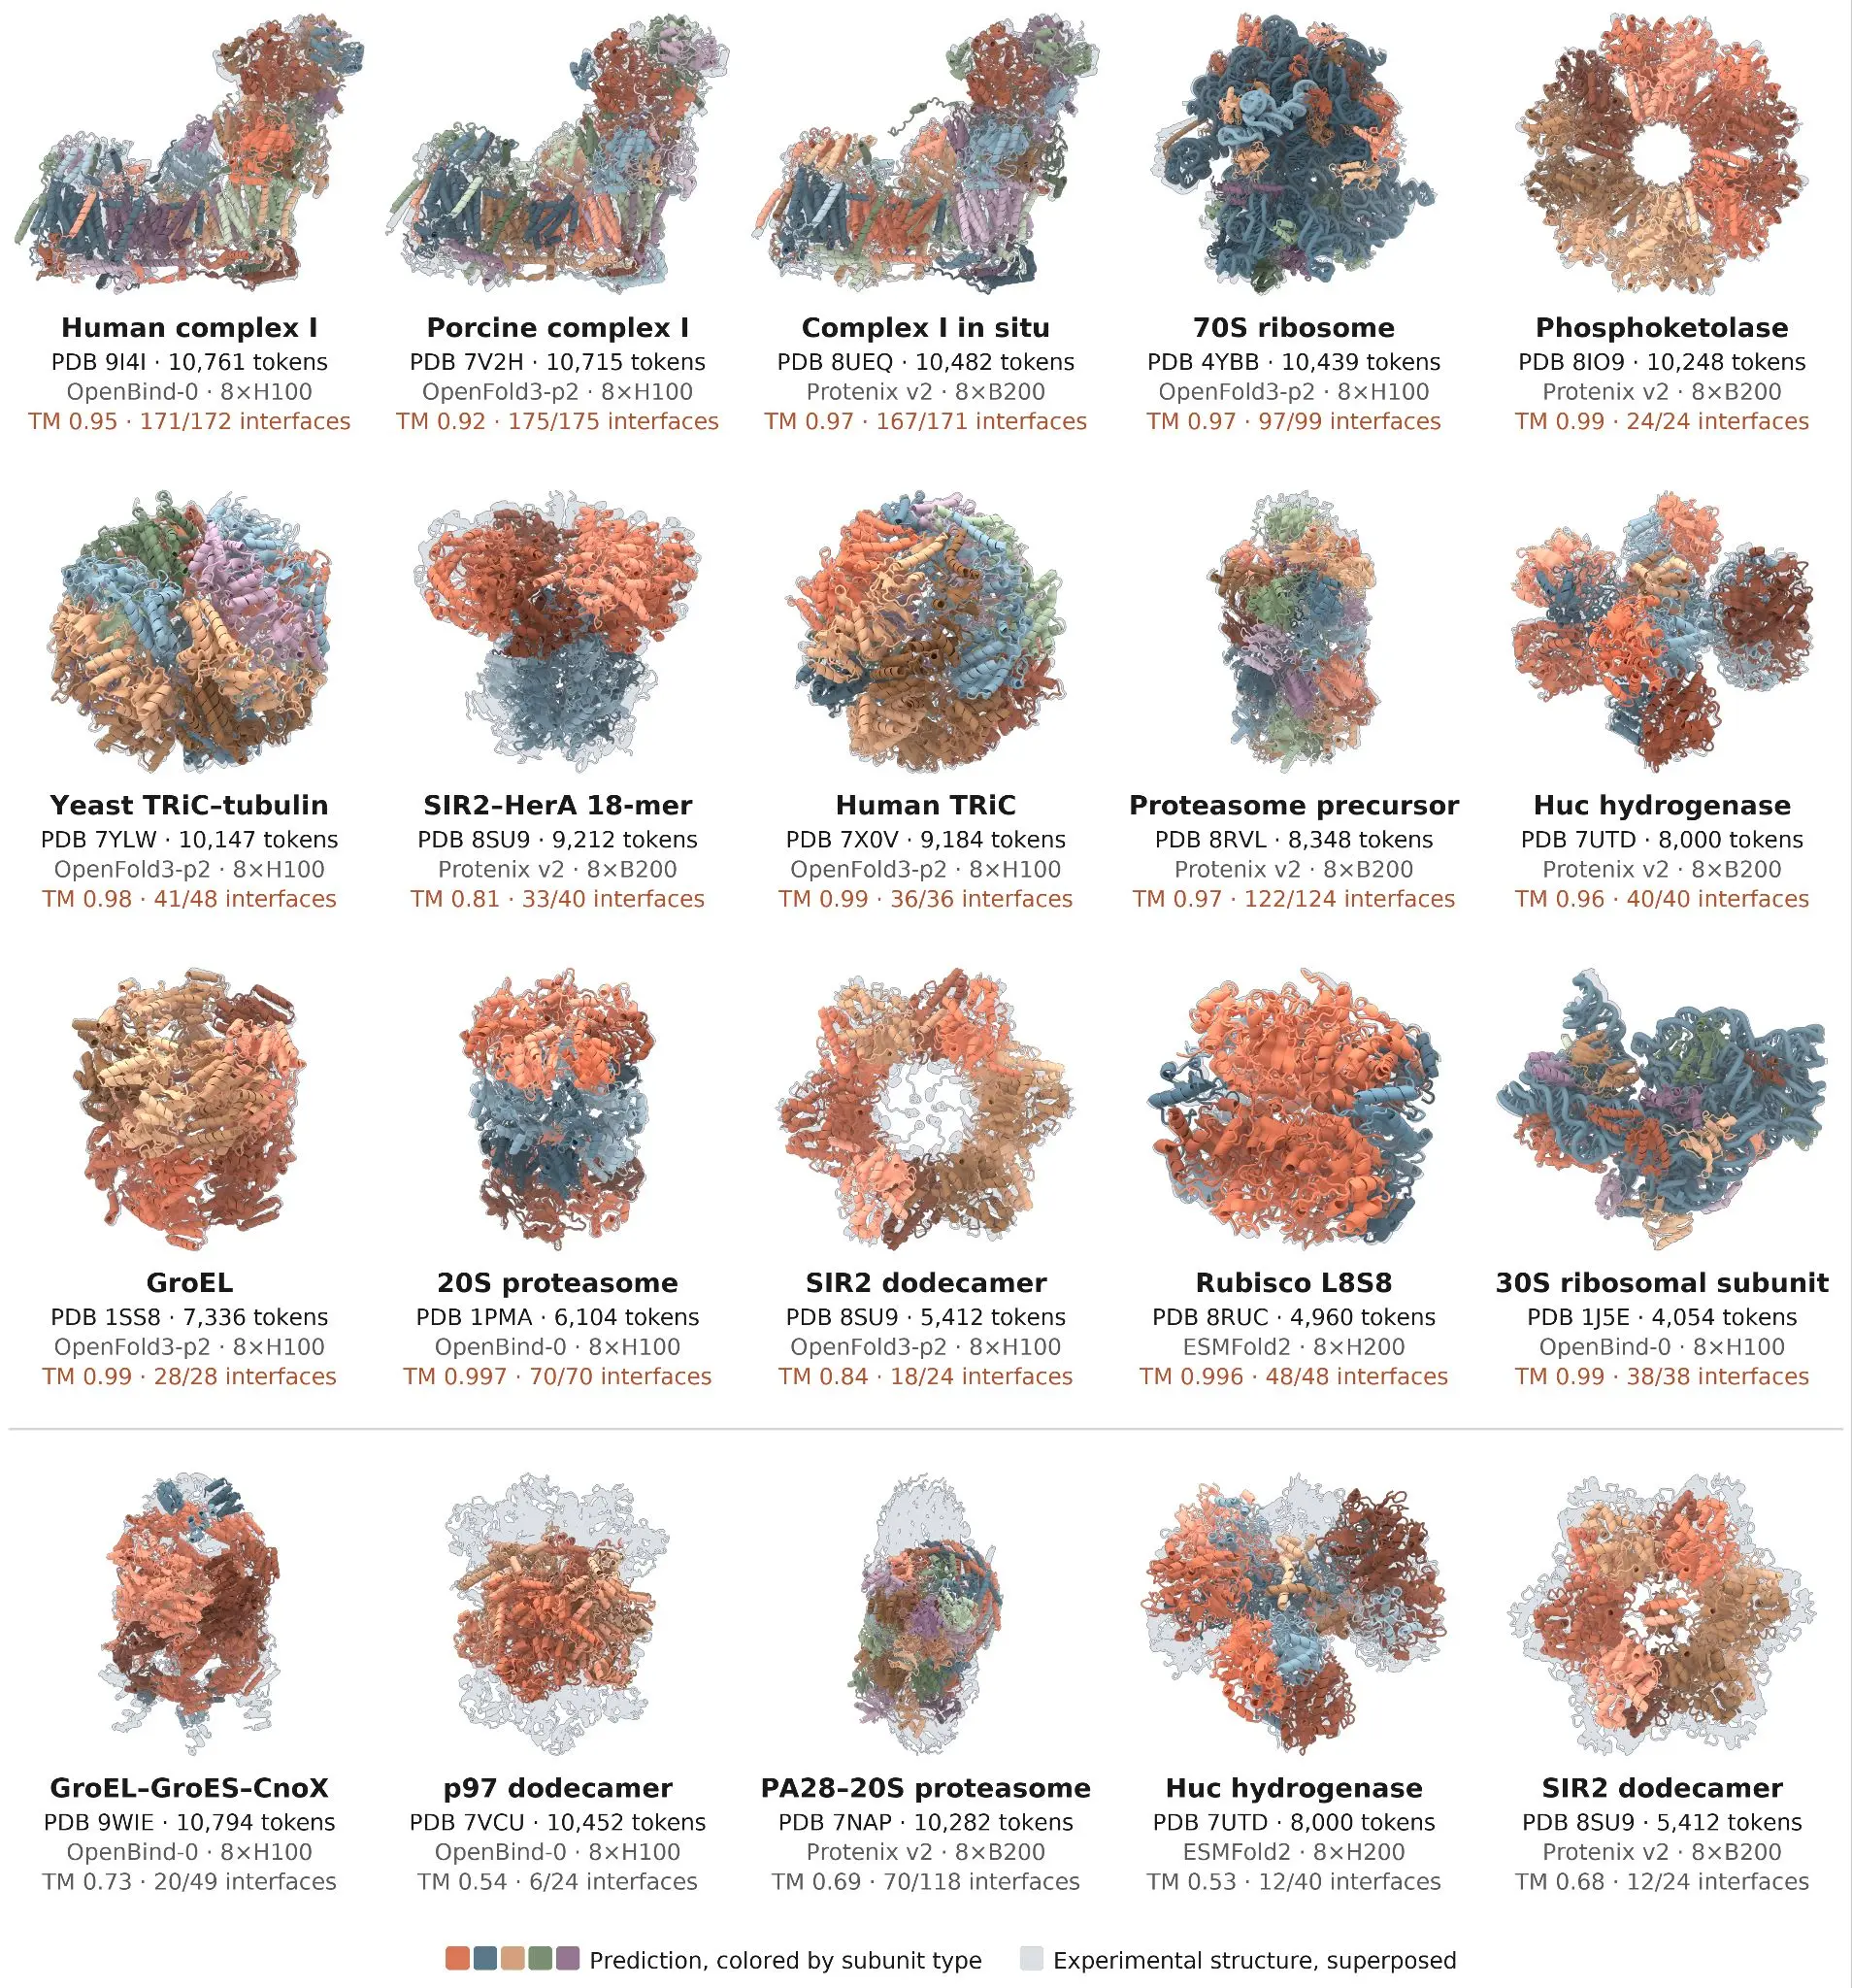 Созданный Claude режим «Big» с низким потреблением памяти позволяет моделям прогнозирования структуры с открытым исходным кодом точно предсказывать биомолекулярные системы размером более 10 000 токенов на одном узле с графическими процессорами NVIDIA. Это показывает, что специализированные модели способны обобщать данные почти на полтора порядка величины за пределами обучающего контекста. В трёх верхних рядах представлены системы, структура которых предсказана точно, в нижнем — системы с неточными предсказаниями. Интерфейсы считаются точными, если их оценка DockQ составляет не менее 0,23.
Чтобы проверить предел возможностей оптимизаций Claude, мы попросили его предсказать структуры крупнее всех, которые удавалось моделировать ранее. Используя один узел с 8 графическими процессорами B300, Claude построил модели целых вирусных капсидов и белковых компартментов размером от более чем 31 000 до более чем 70 000 токенов. Эти системы почти на два порядка превышают обучающий контекст моделей прогнозирования структуры, поэтому, что неудивительно, их структуры предсказаны неверно. Однако порог входа для инференса в таком масштабе значительно снизился: теперь для этого достаточно одного узла NVIDIA B300. Это позволяет предположить, что благодаря улучшенным инструментам исследователи вскоре смогут вычислительными методами моделировать всё более сложные биологические системы.
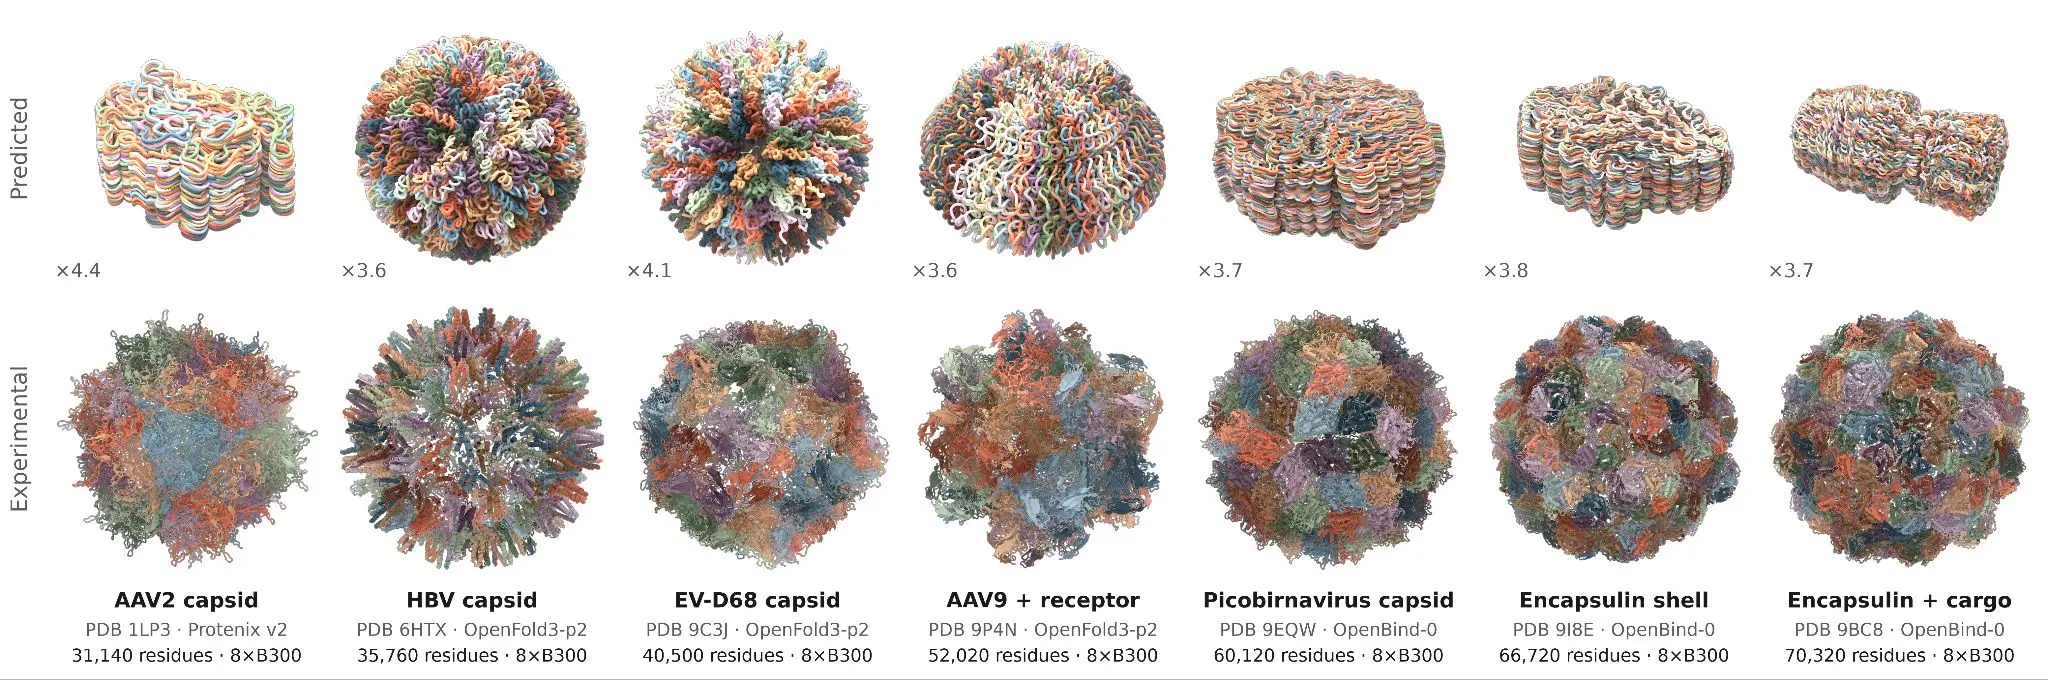 Режим «Big» позволяет моделям прогнозирования структуры с открытым исходным кодом успешно выполнять инференс для систем беспрецедентного размера, используя один узел NVIDIA B300. Проверка возможностей проводилась с одним проходом по основному блоку модели (без повторных циклов) в качестве подтверждения концепции. Предсказанные структуры схлопываются, что указывает на отсутствие обобщения почти на два порядка за пределами обучающего контекста.
Claude эффективно проектирует белки-связыватели de novo
В нашей предыдущей работе по проектированию белков мы предложили Claude промпт объёмом около 16 000 слов, побуждавший его использовать субагентов и тратить до 10 000 долларов на каждую мишень в Modal (примерно 2 500 часов работы графических процессоров NVIDIA H100) в течение 24 часов. В этот раз мы предоставили одной модели Claude доступ к одному графическому процессору NVIDIA H200 и 24 часа реального времени, промпт объёмом около 1 100 слов и справочное руководство по предустановленным инструментам. Субагентов не было, и человек не направлял процесс проектирования.
Мы проверили три модели Claude (Mythos 5.1, Mythos 5 и Opus 5) на 16 мишенях с использованием ускоренных биомолекулярных моделей, описанных в этой публикации. Мы оценивали разработки по показателю ipSAE — вычислительной метрике in silico, которая, как показано, позволяет прогнозировать результаты связывания в лабораторных условиях. Усреднённые по 16 мишеням медианные и максимальные оценки разработок, полученных всеми тремя моделями Claude, примерно совпадают с показателями кампаний Mythos 5.1, о которых мы рассказывали ранее, несмотря на то что теперь потребовалось примерно на два порядка меньше часов работы графических процессоров. Мы также учли расходы на токены Claude и выяснили, что, потратив в общей сложности около 150 долларов на графические процессоры и токены, можно добиться результатов in silico, сопоставимых с результатами наших предыдущих кампаний.
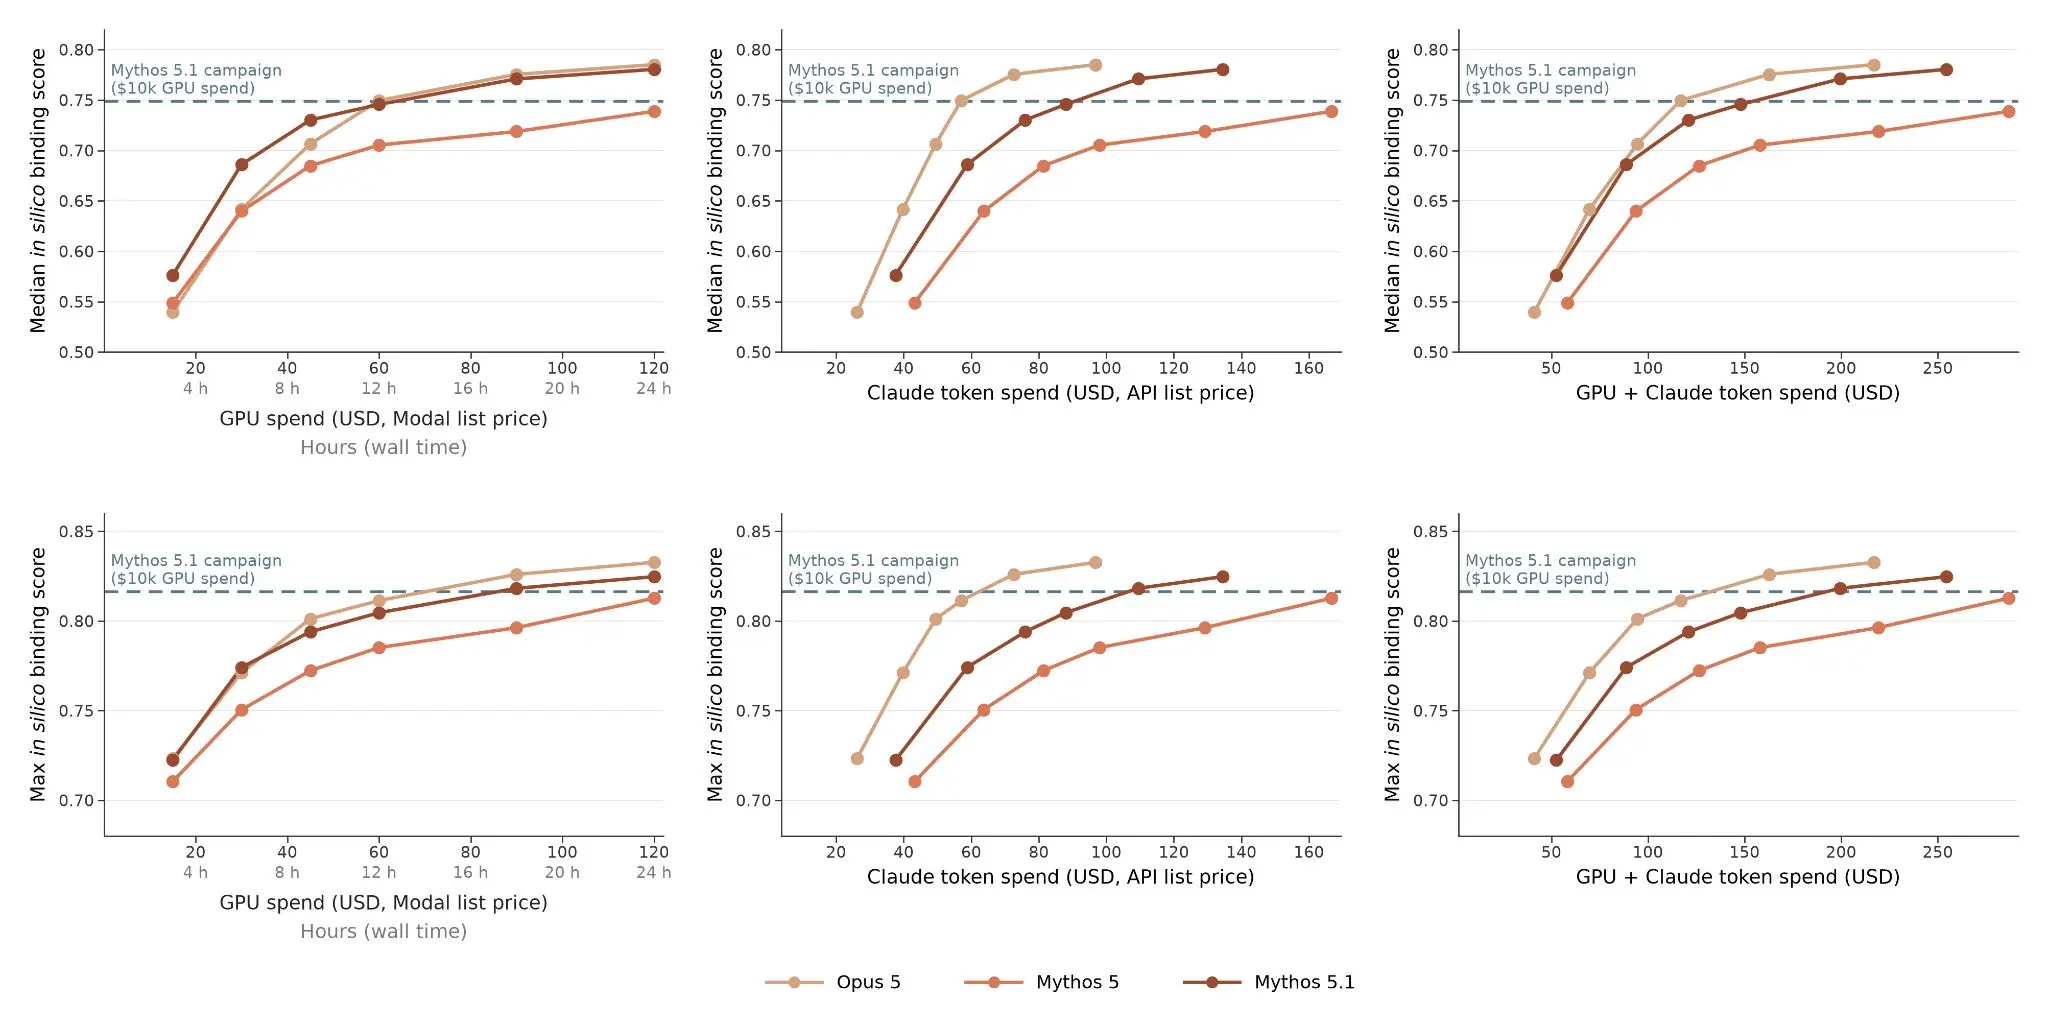 Одна модель Claude, получившая доступ к одному графическому процессору NVIDIA H200 и 24 часам реального времени, спроектировала белки-связыватели de novo с сопоставимыми оценками связывания in silico по сравнению с нашей предыдущей кампанией Mythos 5.1 (пунктирная линия), в которой можно было использовать субагентов и примерно в 100 раз больше часов работы графических процессоров. Каждая кривая показывает медианное (вверху) или максимальное (внизу) значение ipSAE (оценки связывания in silico) для модели Claude, координирующей ускоренные биомолекулярные модели. Слева приведены оценки в зависимости от предполагаемых затрат на графические процессоры, в центре — от затрат на токены, справа — от их общей суммы. Результаты усреднены по 16 мишеням и максимум пяти независимым запускам для каждой мишени.
Совместно с Adaptyv Bio проводим конкурс по проектированию белков
Описанные выше оптимизации помогают нам эффективнее прогнозировать и проектировать молекулы, а также открывают возможности, которые иначе потребовали бы непомерных ресурсов. Чтобы показать, насколько они повышают эффективность и как Claude может повлиять на проектирование молекул в целом, мы совместно с Adaptyv Bio запускаем конкурс по проектированию белков. Мы выбрали пять задач, находящихся на переднем крае современных возможностей проектирования белков, включая межвидовую перекрёстную реактивность, чувствительность к pH и специфичность к комплексу пептид — MHC, а также сложные мишени, такие как GPCR.
Вместе с командой Adaptyv мы экспериментально проверим более 5 000 разработок, представленных участниками для решения этих задач. Участвующим исследователям мы предоставим до 1 миллиона долларов в виде кредитов Claude, а также дополнительные средства на экспериментальную проверку в Adaptyv. Modal предоставит до 250 000 долларов в виде кредитов на вычисления, а Twist Bioscience — ДНК для конкурса. Дополнительная информация, включая критерии участия, доступна (здесь), а подать заявку можно (здесь).
Мы также начали предоставлять специалистам в области биологических наук доступ к возможностям передовых моделей ИИ для решения задач, связанных с биологией, в рамках нашей программы Life Sciences Verification Program. Недавно к ней присоединилась первая группа организаций, а сегодня программа открылась для всех в формате публичной бета-версии. Подробнее — (здесь).
Дополнительные материалы
В следующих материалах подробнее рассматриваются технические аспекты и результаты, описанные выше:
- Страница конкурса по проектированию белков и форма заявки;
- Код специализированных молекулярных моделей;
- Технический отчёт.
Подпишитесь на Anthropic Science
Истории об открытиях с помощью ИИ, практических рабочих процессах и полевых заметках из разных областей науки.
Полный текст статьи читайте на Anthropic
