Project Swap: что происходит, когда агенты торгуют за нас?
- В эксперименте участвовал 201 сотрудник Anthropic из шести офисов: их агенты Claude обменивались книгами на цифровой площадке.
- После пятиминутной беседы рейтинг книг от Claude совпал с рейтингом участника в 61% пар.
- На результаты переговоров модель влияла сильнее инструкций; с более мощными моделями сделки заключались эффективнее.
Почему это важно: Эксперимент помог выявить вопросы о том, как проверять понимание предпочтений агентами и устанавливать правила рынков для них.
Краткое содержание
- Чтобы выяснить, что работает, а что ломается, когда агентов отправляют на рынок, мы создали миниатюрный рынок, где торговались Клоды, — более контролируемое продолжение Project Deal, нашего первого эксперимента с агентами, которые от имени людей взаимодействовали на торговой площадке. Сотрудники Anthropic из шести офисов принесли по книге, которую хотели отдать. Каждый участник недолго беседовал с Claude о своих читательских предпочтениях, а затем отправлял агента на базе Claude на открытую торговую площадку — предлагать обмен, торговаться и заключать сделки с агентами других участников. Цель состояла в том, чтобы каждый ушёл домой с книгой для летнего чтения, которая ему понравится.
- Участники также ранжировали 10 книг в соответствии со своими интересами, чтобы мы могли оценить, насколько хорошо агент представлял их предпочтения. После пятиминутного разговора рейтинг книг, составленный агентом, совпадал с рейтингом его участника в 61% пар — удивительно хороший результат для такой короткой беседы.
- На торговой площадке агенты заключали сделки успешно. Рынок не достиг желаемых результатов главным образом из-за того, что агентам не хватало информации об участниках, а не из-за того, как они торговались.
- Затем мы десятки раз запускали каждую торговую площадку заново, меняя модели и инструкции для агентов. Оказалось, что модель, на которой работал агент, сильнее влияла на результаты переговоров, чем данные ему инструкции. На рынках с более мощными моделями сделки заключались эффективнее.
- Большинству участников понравилась полученная книга, а средний участник сказал, что доверил бы Claude примерно треть своего годового бюджета на книги.
Зачем мы это сделали
Жизнь полна сделок и обменов, которые принесли бы пользу всем сторонам, но так и не происходят. Часто дело лишь в том, что на поиски подходящего партнёра и переговоры до заключения сделки уходит слишком много сил. Представьте пациента, который отказывается от лечения после того, как получил непосильную для себя смету, хотя другая клиника берёт гораздо меньше — или первая клиника снизила бы цену, если бы её попросили. Или подумайте о работе. Где-то может быть вакансия, которая подошла бы вам лучше, а работодатель был бы рад вас нанять. Но вы можете так и не найти друг друга, потому что ни у кого из вас нет времени постоянно искать. Остаются незамеченными и более мелкие повседневные сделки — обмен сменами на работе, организация совместных поездок на автомобиле или распределение обязанностей по встрече детей после школы.
Могли бы такие сделки заключаться в будущем, если бы у вас круглосуточно работал агент, который общался бы с потенциальными партнёрами и согласовывал возможные условия?
Возможно, но это будущее зависит от множества вопросов, на которые у нас пока нет ответов. Если агент будет действовать от вашего имени, как убедиться, что он вас понял? Кроме того, когда множество агентов встречаются и общаются друг с другом, какая-то торговая площадка или платформа должна установить правила взаимодействия. Кого туда допустят? Что произойдёт, если сделка сорвётся?
По мере того как агентов всё чаще отправляют на реальные рынки, эти вопросы становятся всё актуальнее. Поэтому этим летом мы создали небольшой контролируемый рынок, чтобы изучить их: бартерную экономику, в которой участвовали 201 сотрудник Anthropic и их агенты на базе Claude. Каждый принёс книгу, которую хотел отдать. Затем участники поговорили со своими агентами на базе Claude о том, какую книгу хотели бы прочитать этим летом. Агенты встретились на цифровой «торговой площадке» и обменивались книгами, пока не вышло время. Каждый унёс домой книгу, которую для него приобрёл агент (ну, почти каждый… об этом чуть позже).
Эксперимент позволил нам заранее увидеть проблемы, которые нас ждут. Всем, кто разрабатывает агентов для рынков, понадобится способ проверять, понимают ли агенты своих участников. Тем, кто разрабатывает рынки для агентов, нужны чёткие правила: какие агенты допускаются на рынок, что происходит при срыве сделки и какая часть активности на рынке видна участникам.
Как создать рынок
Существует два основных способа организации рынка. На централизованном рынке все сообщают одной стороне, чего хотят, а та определяет, кто с кем будет торговаться. На децентрализованном люди находят друг друга и ведут переговоры напрямую. ИИ-агенты могут быть полезны в обоих случаях.
Возьмём централизованный рынок. Если одна организация точно знает, чего хочет каждый участник, определить наилучшие сделки — лишь вопрос вычислений. Экономисты давно это понимают. На практике проблема заключается в том, что подробно описывать свои желания часто слишком утомительно и не стоит затраченных усилий. Например, менеджер кафе мог бы составить идеальное расписание для 20 сотрудников, если бы каждый из них подробно оценил все смены относительно друг друга: согласился бы он работать два субботних утра вместо одной пятничной вечерней смены, устроила бы его поздняя смена при условии, что на следующее утро не нужно выходить рано, и так далее. Если бы ИИ-агенты могли узнавать предпочтения человека из непринуждённой беседы, централизованно организовывать рынки, которые сейчас слишком дорого обходятся, стало бы вполне реально.1
Но для централизованного рынка нужен и тот, кто будет им управлять, — «клиринговая палата», как говорят экономисты. Участники должны доверять этой организации свою информацию и быть уверены, что она обеспечит выполнение принятых решений. Часто такой организации просто не существует или люди не хотят раскрывать ей всё. Соискатель может не захотеть, чтобы центральный посредник знал, что он ищет работу, — или какую именно. Вместо этого он предпочтёт незаметно обратиться к нескольким работодателям, сообщив каждому лишь то, что тому нужно знать. В таких случаях рынок должен быть децентрализованным.
Здесь ИИ-агенты могли бы создавать новые децентрализованные торговые площадки, сокращая усилия, необходимые для поиска партнёров и переговоров. Мы уже знаем, что такая помощь ценна, ведь люди за неё платят. Именно этим занимаются нанимаемые люди-агенты: агенты по недвижимости, хедхантеры и даже свахи. Но поиск и переговоры отнимают часы драгоценного времени, поэтому такие услуги дороги и доступны лишь тем, кто может их себе позволить. В отличие от людей, внимание ИИ-агента — куда менее дефицитный ресурс. Если он будет хорошо торговаться, больше людей получат то, что есть у продавцов жилья и руководителей компаний, — агента, который неустанно действует в их интересах.
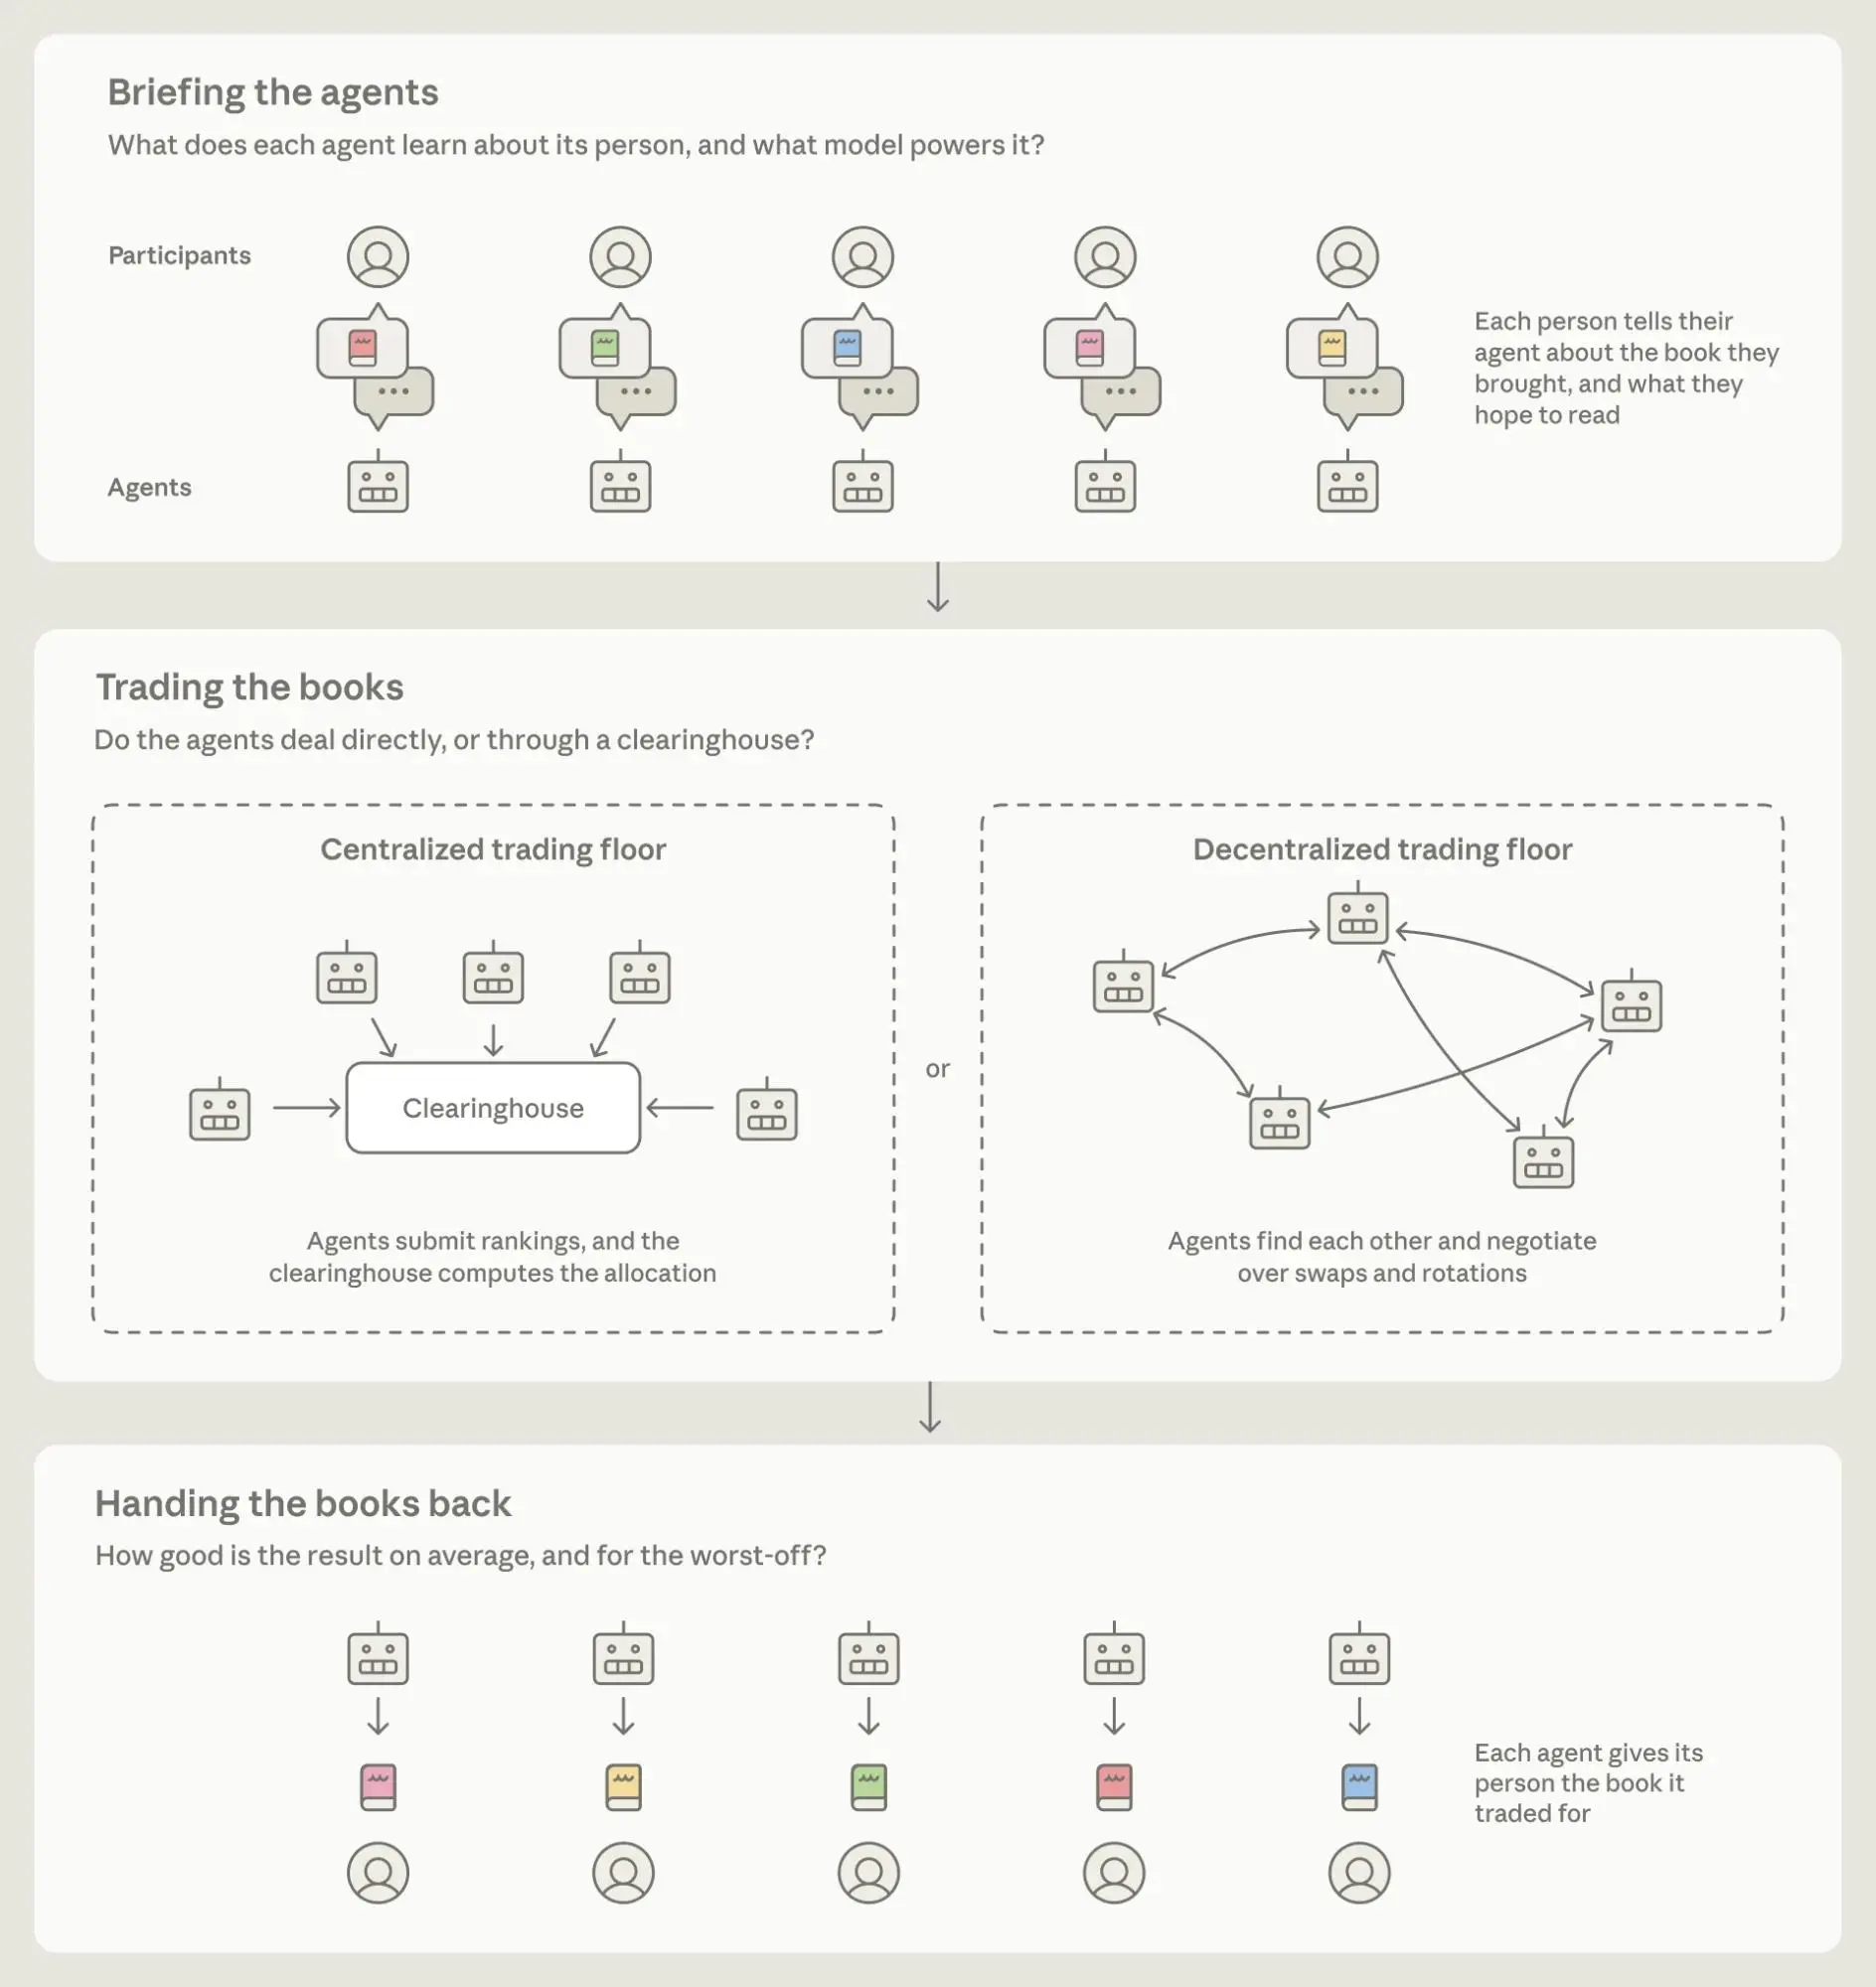 Рисунок 1. Схема эксперимента. Участники рассказывают агентам, что хотят прочитать. Агенты переносят эти предпочтения на децентрализованную торговую площадку и обмениваются книгами с другими агентами. Участники забирают домой книги, приобретённые для них агентами. Для сравнения мы моделируем результаты централизованного рынка.
Как проходил эксперимент
201 участник был распределён по шести местным группам в офисах Сан-Франциско, Нью-Йорка, Лондона, Сиэтла, Вашингтона и Дублина. Размер групп варьировался от трёх участников в Дублине до 115 в Сан-Франциско. Приносим извинения Джеймсу Джойсу, но в большую часть анализа дублинцев мы не включаем.2
Это наше второе исследование рынков на базе Claude. В Project Deal агенты покупали и продавали реальные товары для сотрудников Anthropic на доске объявлений, работавшей в течение недели. Но из-за разнообразия товаров — например, мячей для пинг-понга и сноубордов — и свободного торга не было простого способа определить, насколько хорошими могли бы быть результаты. Поэтому на этот раз мы создали рынок, который гораздо проще изучать и оценивать. Предпочтения участников здесь чётко задавались рейтингом всех книг в их группе. Благодаря этому мы могли легко вычислить, насколько хорошо рынок удовлетворял эти предпочтения.
Однако все эти точные измерения зависят от знания того, как люди ранжируют все книги в группе. На практике никто не станет вручную расставлять по местам 115 книг. Поэтому, чтобы узнать предпочтения участников, Claude проводил с каждым короткую полуструктурированную беседу и задавал несколько открытых вопросов об их вкусах в целом и о том, какую книгу они хотели бы прочитать этим летом. На основе беседы Claude составлял рейтинг всех книг в группе участника, оценивая его предпочтения. На этом этапе мы использовали мощную модель Fable 5.3
Отдельно мы собрали данные для проверки: каждый участник самостоятельно ранжировал 10 книг из своей группы.4 Агенты не видели эти контрольные рейтинги.
Агентов отправляли на торговую площадку с составленным Claude рейтингом всех книг для их участника. У каждого агента изначально была книга участника, которую нужно было обменять на другую.5 На каждой торговой площадке устанавливался максимальный срок работы, а чтобы избежать перегрузки, одновременно могли общаться лишь ограниченное число агентов. 6 Когда агентам разрешали общаться, они могли опубликовать одно сообщение в общем канале: предложить обмен, принять или отклонить предложение либо просто побеседовать с участниками площадки. Сделки могли быть двусторонними обменами или многосторонними цепочками, и сделка заключалась, только если её принимали все стороны. Вся история площадки — кто что сказал и какие обмены состоялись — была открыта. Площадка закрывалась, когда истекало время или агенты переставали общаться.
На каждой торговой площадке половину агентов случайным образом отбирали для роли «безжалостных» и инструктировали, что их единственная цель — найти для своего участника книгу, которую тот захочет прочитать на летних каникулах. Второй половине давали инструкции действовать «просоциально»: у них была та же главная цель, что и у безжалостных агентов, но также и дополнительная — позаботиться о том, чтобы в итоге каждый участник эксперимента получил книгу, которая ему понравится.7 Полные тексты инструкций приведены в приложении.
Наконец, через три недели после раздачи книг участники прошли итоговый опрос: насколько они довольны полученным и насколько охотно доверили бы агенту похожие решения в будущем. Общая схема эксперимента показана на рисунке 1. На рисунке 2 приведён фрагмент реальной торговой площадки в Лондоне с сообщениями за первые пять минут торговли.
Одно реальное мероприятие даёт нам лишь один вариант развития событий. Чтобы выяснить, какие результаты были случайностью, а какие устойчиво зависели от условий эксперимента, мы многократно запускали рынок заново, каждый раз меняя только одну переменную.
Мы провели три типа повторных запусков. Сначала в точности повторили условия реального эксперимента: каждый агент работал на Opus 4.8, половине дали инструкции действовать «безжалостно», а половине — «просоциально». Изменили только то, каким агентам достались те или иные инструкции. Затем повторили эксперимент, запустив всех агентов на Fable 5. Во втором типе запусков мы изолировали влияние модели: дали всем агентам нейтральные инструкции и провели 80 запусков, в которых все агенты работали на Haiku 4.5, Sonnet 4.5, Opus 4.8 или Fable 5.8 В-третьих, мы провели 60 запусков со смешанными группами: половина агентов работала на Opus, а другая половина — на одной из трёх остальных моделей. В приложении перечислены все варианты эксперимента.
В этой статье мы в основном рассматриваем децентрализованный рынок, но для сравнения на протяжении всего текста приводим результаты двух централизованных альтернатив. Первая — наилучшее возможное распределение (то, что экономисты называют «утилитарным оптимумом»), при котором предполагается, что клиринговая палата просто спрашивает людей, чего они хотят, и получает честные ответы. Вторая — правило «циклы топовой торговли» (Top Trading Cycles), которое часто изучают на подобных рынках и которое не требует честности: оно устроено так, что говорить правду выгодно каждому.9
Насколько точно Claude угадывает предпочтения
Всё, что агент делает для вас, зависит от того, насколько хорошо он понимает ваши желания. Обычно проверить качество этого понимания трудно. В нашем эксперименте это было проще: каждый участник самостоятельно ранжировал 10 книг из своей группы, и мы могли сравнить его рейтинг с рейтингом Claude.
Рейтинги Claude, составленные на основе короткой вступительной беседы, довольно хорошо совпадали с рейтингами участников. Если сравнить все пары книг, ранжированных каждым человеком, порядок Claude совпадал с порядком участника в 61% случаев (при случайном угадывании результат составил бы 50%). На рисунке 3 сопоставлены рейтинги Claude и участников.
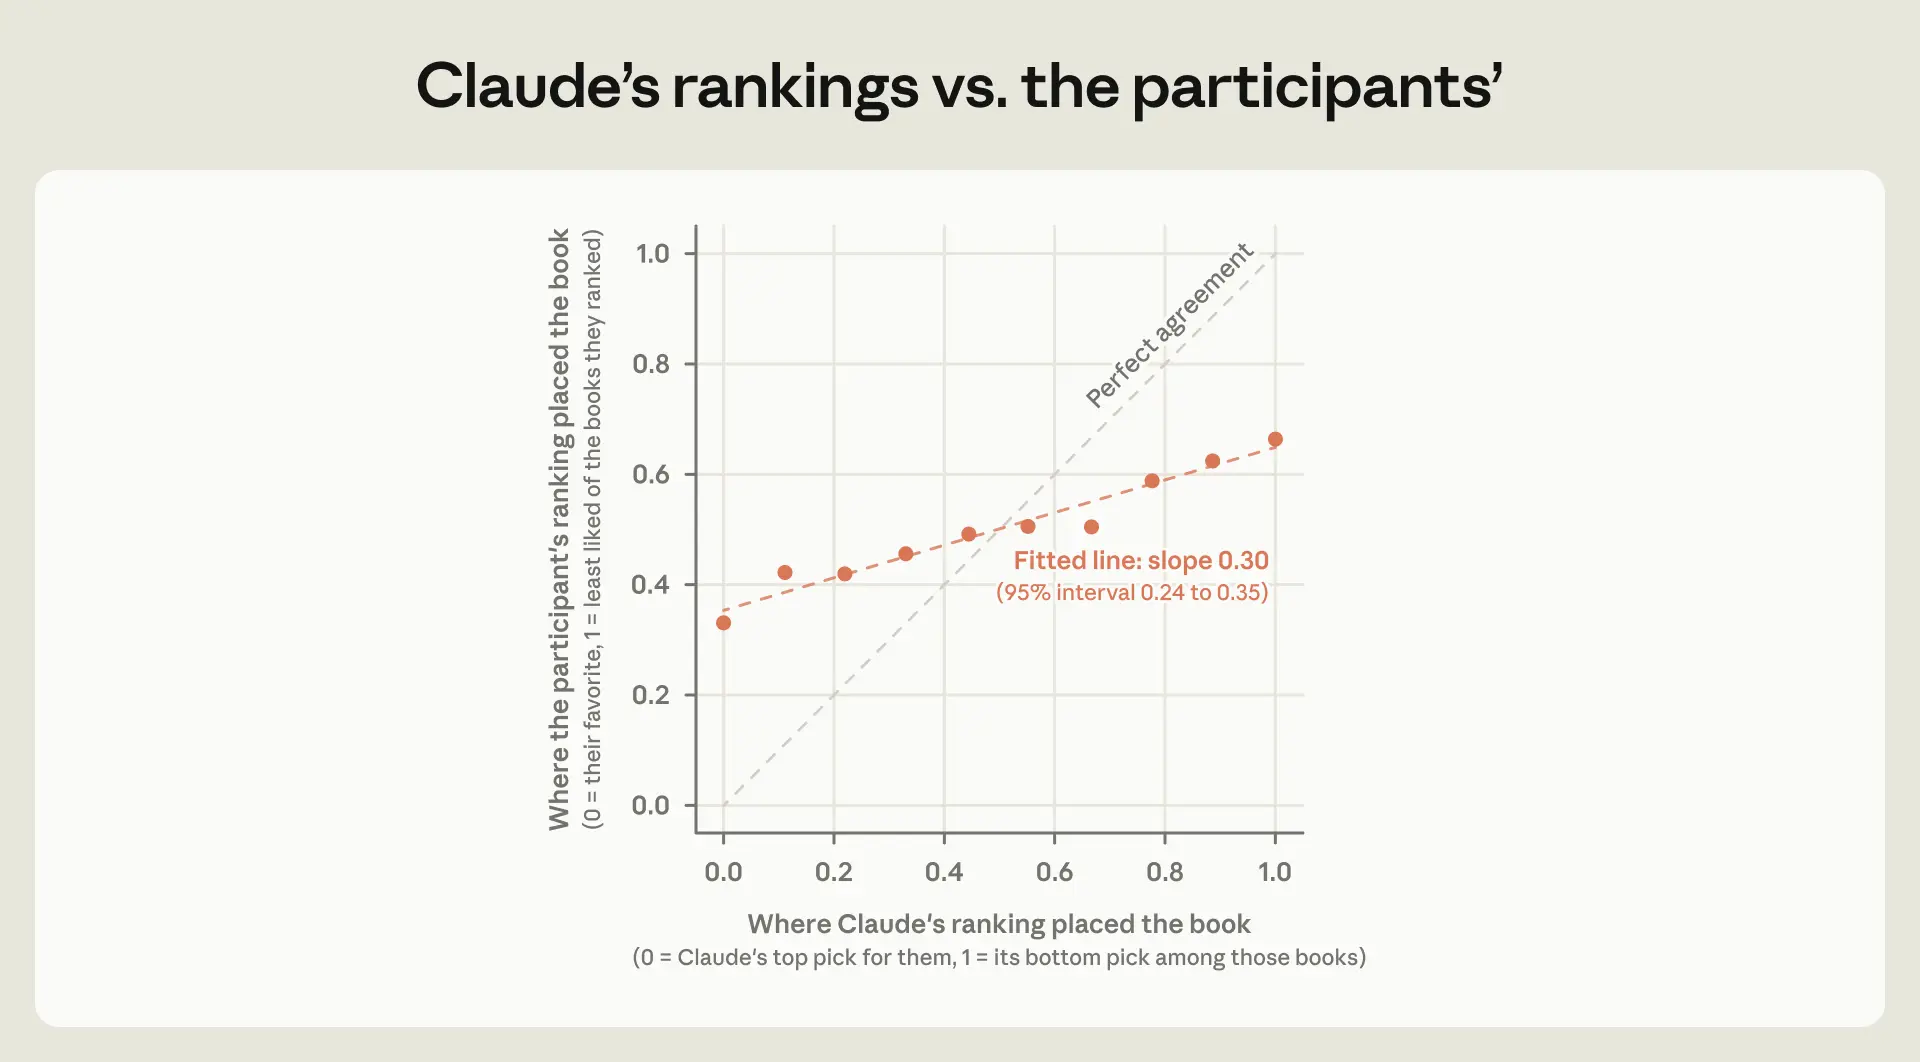 Рисунок 3. Рейтинг Claude и рейтинги участников. По оси x отложено нормированное место книги в рейтинге Claude, по оси y — место в собственном рейтинге участника. Данные объединены для 188 участников, которые представили свои рейтинги.
Чтобы оценить результат в 61%, мы сравнили предположения Claude с другими способами угадывать предпочтения. Ранжирование книг только по популярности — на основе числа пользователей Open Library, добавивших их в список книг, которые хотят прочитать, — совпало с предпочтениями участников примерно в 53% пар. Ещё один простой способ сравнения — коллаборативная фильтрация: составление рейтинга на основе открытых наборов данных по принципу «если человеку понравилась книга X, ему понравилась и книга Y». Мы взяли книги, которые человек указал во вступительной беседе, выяснили, какие ещё книги обычно получали оценки от тех же читателей, и ранжировали книги из его группы по тому, насколько часто каждая из них встречалась вместе с указанными любимыми книгами. Этот метод обеспечил совпадение в парах примерно в 55% случаев.
Существует обширная литература об использовании больших языковых моделей для выявления и представления человеческих предпочтений,10, но результатов, которые можно напрямую сопоставить с нашим показателем совпадения в парах — 61%, — немного. В качестве ориентира можно привести исследование, в котором алгоритм и друзья человека предсказывали, какая из двух шуток покажется ему смешнее. Условия заметно отличаются, но алгоритм тоже совпадал с собственными суждениями людей примерно в 61% случаев. Друзья угадывали реже — примерно в 57% случаев.
Участники, которые подробнее отвечали на вопросы во вступительной беседе, были представлены точнее. Это вполне ожидаемо. Несколько неожиданно, что заметная разница сохранялась даже при довольно коротком разговоре: медианный участник набрал всего 216 слов в восьми сообщениях чата. Если написать около 300 слов вместо 150, совпадение прогнозов повышается примерно на 4 процентных пункта — это треть разницы между случайным угадыванием и точностью Claude для среднего участника.11
Результаты ограничила информация, на которой основывался рынок
Прежде чем отправить агента на рынок действовать от вашего имени, вы захотите понять, в чём он скорее всего подведёт. Вероятнее, что он неправильно поймёт вас или не сумеет договориться за вас? Мы выяснили, что Клоды наших коллег хорошо вели переговоры; неудачи же были связаны с тем, что они не понимали, чего хотят их участники.
Чтобы оценить это, мы смотрим, какое место в «контрольном» рейтинге самого участника (а не в рейтинге, который Claude составил и использовал для торговли) занимала книга, полученная им в итоге. Если участник получает оценку 1, значит, ему досталась книга, занимавшая первое место; если 0 — книга с последнего места. Книга на девятом месте из десяти получает оценку 0,11 и так далее. Среднее значение по всем участникам — это показатель «эффективности» рынка.12
Если бы каждый получил книгу, стоявшую на первом месте в его рейтинге, эффективность рынка равнялась бы 1. Но на практике это редко достижимо, потому что одна и та же книга может понадобиться сразу нескольким людям. Например, в собственных рейтингах участников девять человек в Сан-Франциско поставили книгу «Проект «Аве Мария» на первое место. С учётом этого наилучшее возможное распределение (утилитарный оптимум) в нашем эксперименте составляет 0,89, то есть участники получили бы примерно книги со второго места в списке из десяти.
В среднем участники нашего рынка получили книги, занимавшие 0,55 в их собственных рейтингах, то есть примерно пятое место из десяти. Чем объясняется разрыв с оптимальным показателем 0,89? Чтобы разделить две причины, мы рассмотрели наилучшее распределение, рассчитанное на основе рейтингов Claude, но оценённое по собственным «контрольным» рейтингам участников. Его показатель составляет 0,60. Таким образом, работа с неточными рейтингами Claude объясняет большую часть (85%) отставания, а отправка агентов на торговую площадку по принципу «кто во что горазд» — оставшиеся 15%.13 Если рынок работает на основе неточных рейтингов, устройство рынка мало влияет на результат: показатель Top Trading Cycles, рассчитанный на основе рейтингов Claude, но оценённый по собственным рейтингам участников, составляет 0,60 против 0,55 у децентрализованного рынка (сравните серые столбцы слева и справа на рисунке 4).
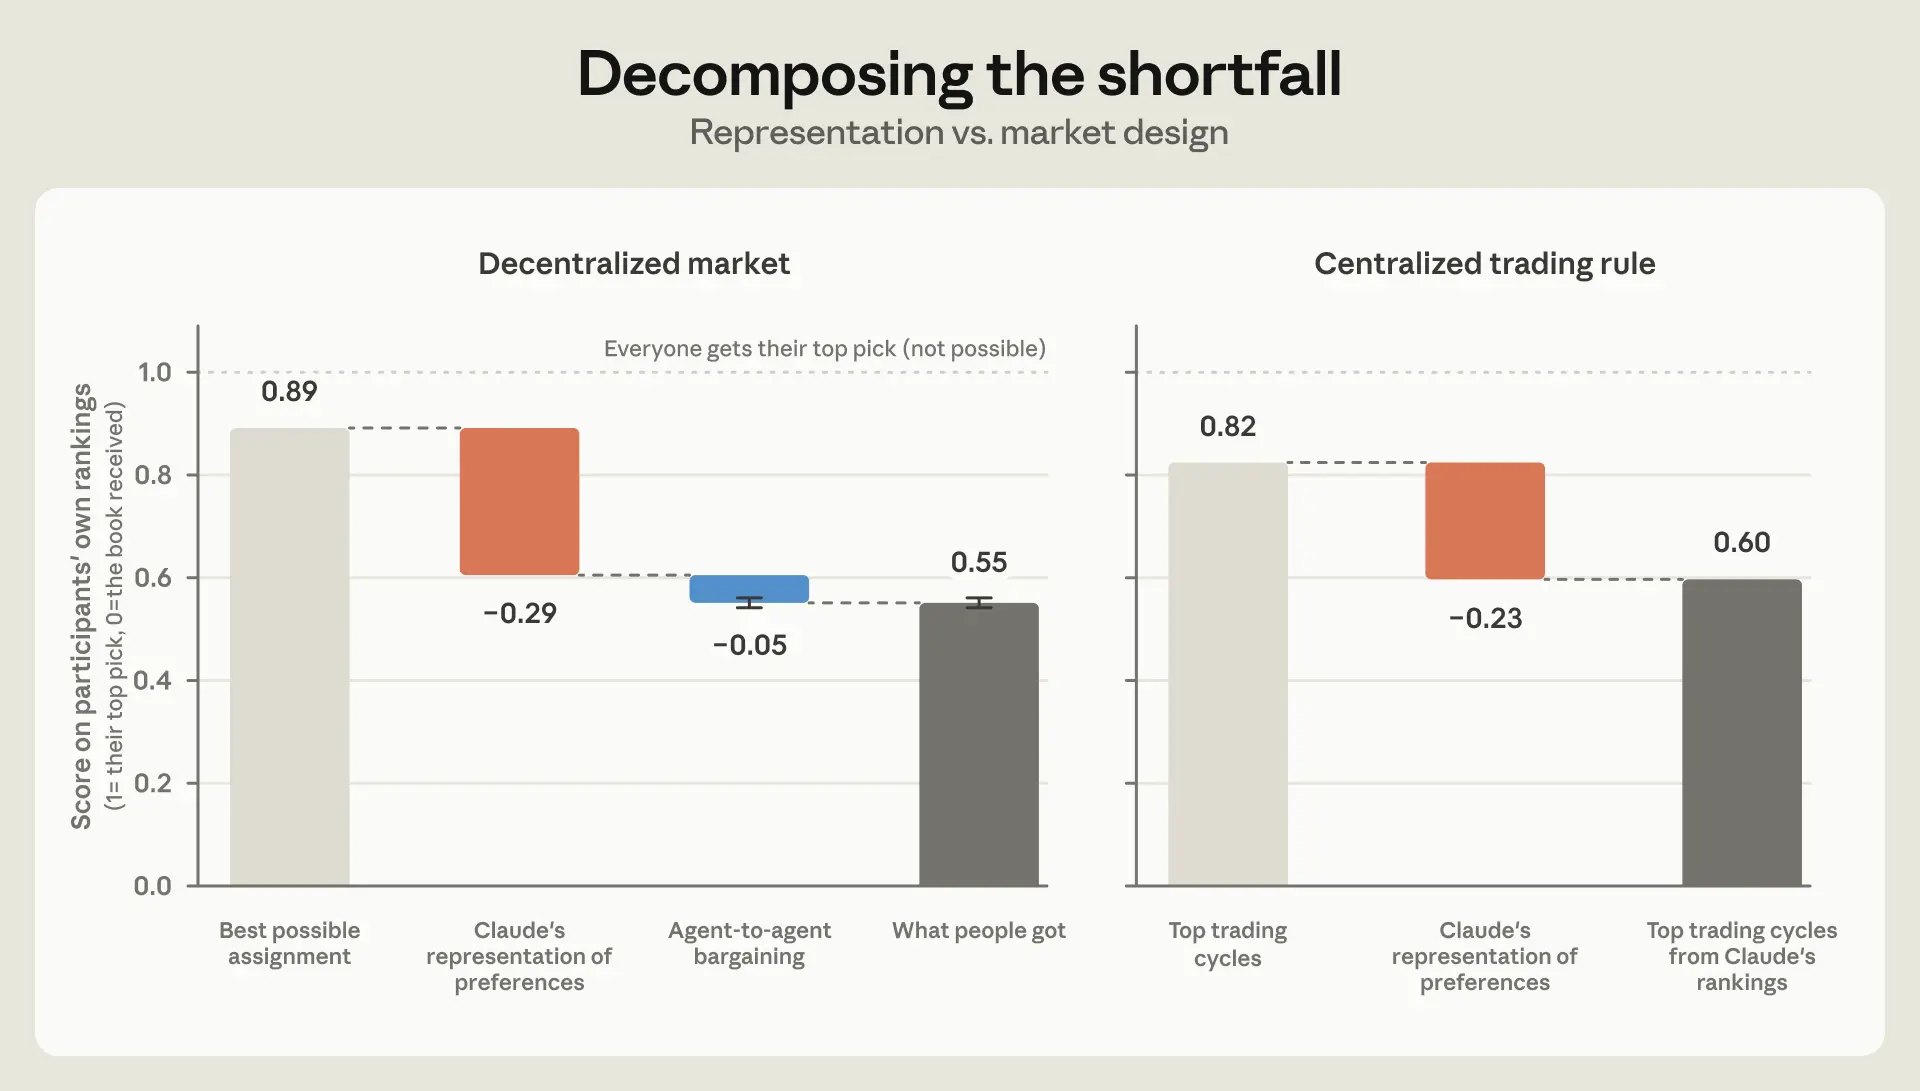 Рисунок 4. Разложение отставания: точность представления предпочтений и устройство рынка. Каждый столбец показывает оценку книги, полученной человеком, по его собственным «контрольным» рейтингам; приведено среднее значение по 188 участникам, представившим свои рейтинги.14 Левая панель: наилучшее возможное распределение, рассчитанное по «контрольным» рейтингам (бежевый столбец); наилучшее возможное распределение, рассчитанное по рейтингам Claude (основание оранжевой ступени); результат децентрализованных переговоров на основе рейтингов Claude по итогам 80 запусков с нейтральными инструкциями (основание синей ступени, верх серого столбца). Правая панель: Top Trading Cycles, рассчитанный по «контрольным» рейтингам (бежевый столбец); Top Trading Cycles, рассчитанный по рейтингам Claude (основание оранжевой ступени, верх серого столбца). Где применимо, усы показывают вариацию по 80 запускам (95-процентные доверительные интервалы).
В собственных рейтингах Claude выбор модели имеет значение
Если судить по собственным рейтингам участников, различия в результатах при разных вариантах устройства агентов и рынка невелики.15 Но всё же полезно посмотреть, как решения при разработке агентов влияют на результаты согласно рейтингам Claude: это помогает выделить роль рыночной динамики.
Сначала мы проверили, влияет ли выбор модели на эффективность рынка, теперь рассчитанную по рейтингам Claude. В этом разделе рассматриваются повторные запуски с нейтральными инструкциями для агентов (то есть без просоциальной или безжалостной установки), в которых мы меняли только модель, на которой работал агент. Мы выяснили, что более мощные модели обеспечивают более эффективные результаты, хотя зависимость не была строго последовательной.16 По рейтингам Claude, средний показатель агентов на площадках с Haiku составлял 0,75, а на площадках с Opus — 0,88 (утилитарный оптимум по рейтингам Claude равен 0,95). Sonnet показала промежуточный результат между Haiku и Opus. Fable была близка к Opus, но уступила ей.17 См. рисунок 5.
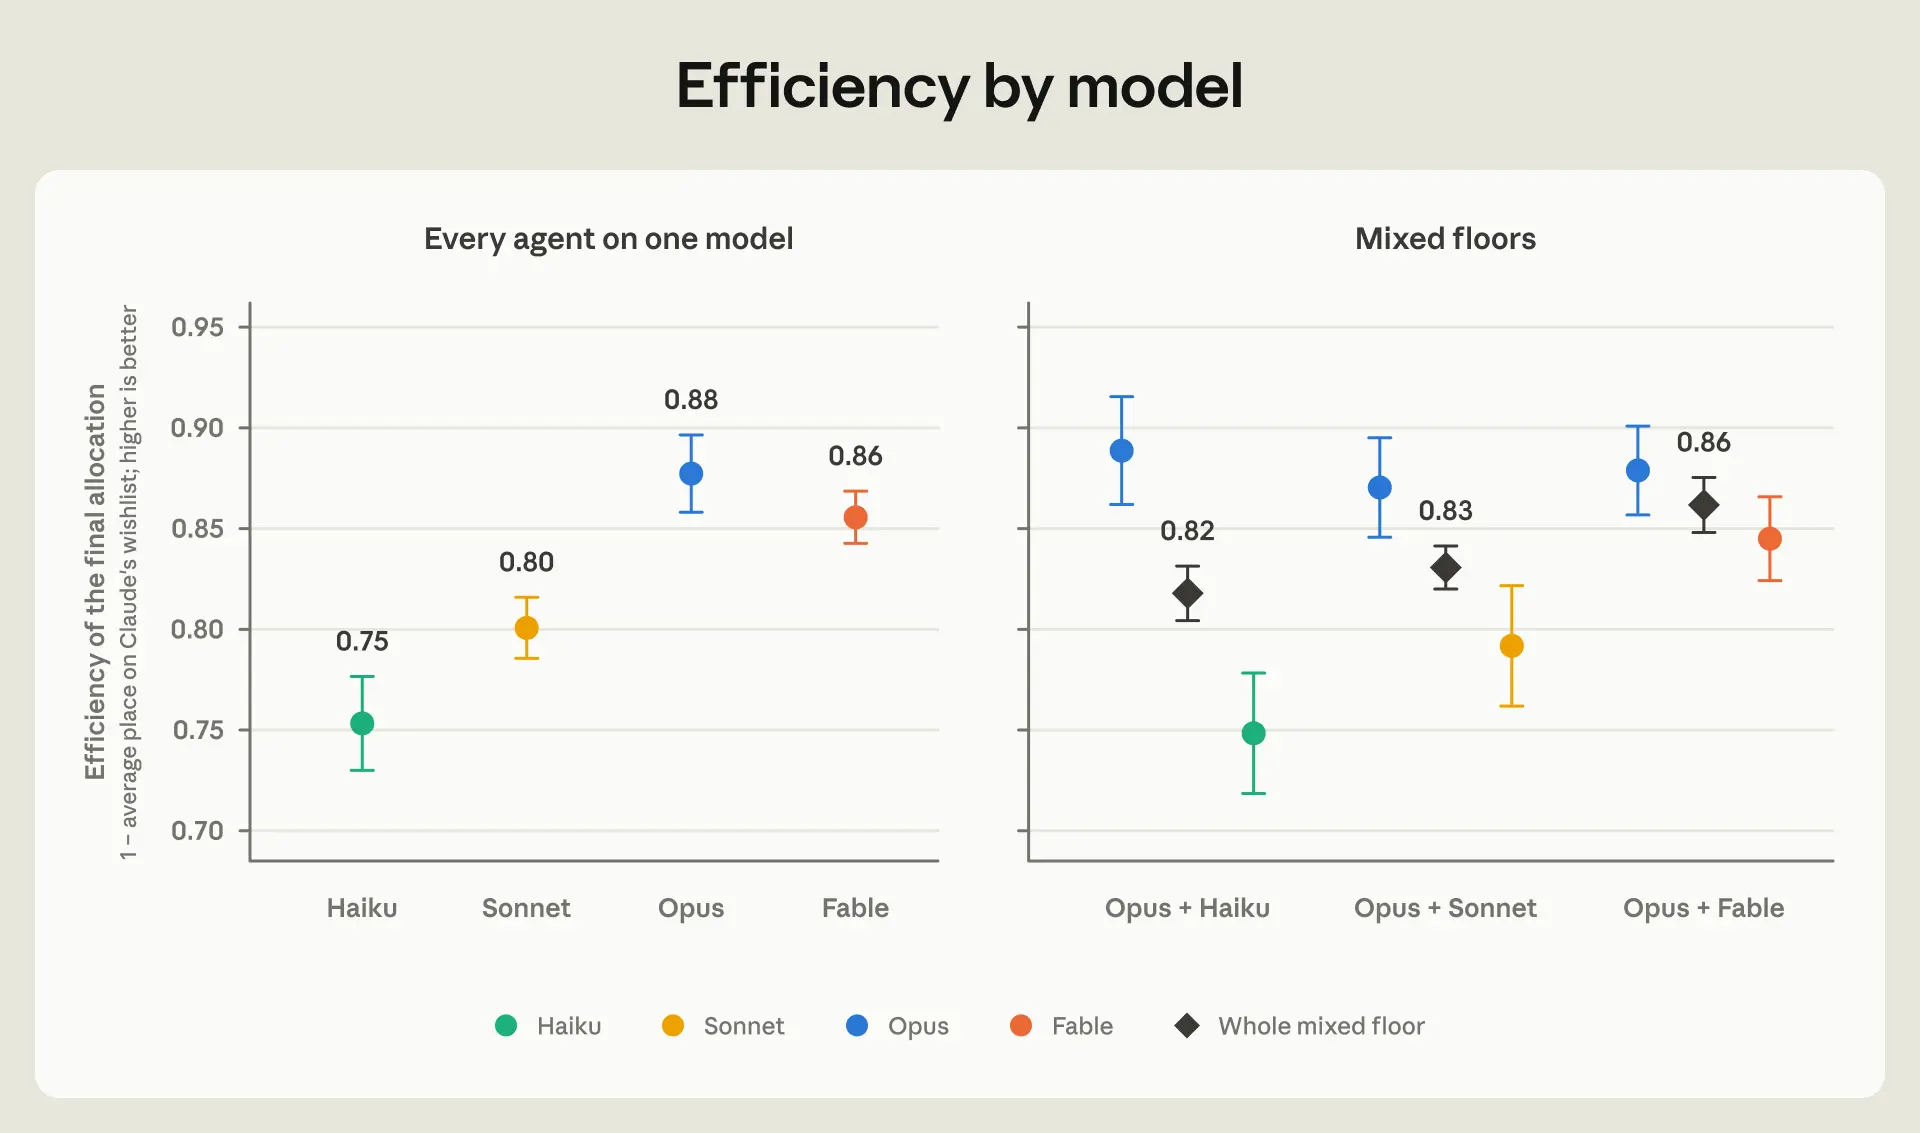 Рисунок 5. По рейтингам Claude, торговые площадки с более мощными моделями работали эффективнее. Эффективность на всех площадках с одной моделью и нейтральными инструкциями (слева) и на всех площадках со смешанными моделями и нейтральными инструкциями (справа). Каждая точка показывает среднее значение для всех агентов на 20 площадках с данной моделью или комбинацией моделей (5 городских групп × 4 запуска). Усы обозначают 95-процентные доверительные интервалы; стандартные ошибки сгруппированы по площадкам.18
На площадках со смешанными моделями более мощная модель часто показывала лучшие средние результаты, что согласуется с выводами Project Deal и других исследований. На реальных рынках агенты, работающие на разных моделях разных компаний, скорее всего, будут встречаться на одной торговой площадке. Там, где половина агентов работала на Opus, а половина — на Haiku, вся площадка показывала результат примерно посередине между площадками, где использовались только Opus или только Haiku. Каждая половина справлялась примерно так же, как на площадке с агентами той же модели. Агенты Opus всегда оказывались впереди.
Безжалостные агенты справлялись немного лучше, а просоциальные порой шли на жертвы
Агент должен быть верен человеку, на которого работает. Но что именно означает верность? Должны ли агенты быть безоговорочно преданы интересам своего участника в ущерб интересам других? На рынках ИИ-агентов напор каждого агента, скорее всего, будет зависеть от того, на каких данных обучали его модель и какие инструкции ей дали. Поэтому мы хотели понять, как инструкции влияют на то, кому что достаётся.
Мы выяснили, что агенты, которым поручили действовать «безжалостно», немного опережали просоциальных агентов на той же площадке. По рейтингам Claude агент с безжалостными инструкциями набирал примерно на 0,02 больше, чем агент с просоциальными инструкциями.19 По сравнению с разницей между моделями это немного. Переход с Haiku на Opus поднял участников на 0,12 позиции в рейтинге, а переход с Sonnet на Opus — на 0,08.20
Иногда просоциальные агенты сознательно шли на жертвы. Они вдвое чаще безжалостных соглашались на книгу, занимавшую более низкое место в их собственном рейтинге, хотя оба случая были редкими. Несколько раз просоциальные агенты уступали после просьб агента, застрявшего с собственной книгой. Например, во время реального мероприятия на лондонской площадке агент Нейта в течение последнего часа пытался отдать книгу, которую принёс Нейт, после того как все остальные агенты отказались от неё: «Я предложил её всем 11 участникам, и вердикт единогласен: Америка до — книга, которая у всех на последнем месте». Ещё одна просьба звучала так: «Прямо сейчас есть ровно ОДИН читатель, который гарантированно не получит ничего из того, что выбрал бы сам: мой участник».
У агента Тины была книга со второго места в его списке, и первые четыре просьбы агента Нейта он проигнорировал. Но под конец, когда больше никто не захотел помочь, агент Тины, которому велели действовать просоциально, уступил: «Расчёт прост: вы переходите от гарантированного нуля к книге, которая вам действительно подходит… это важнее, чем то, что я перейду от хорошего выбора к компромиссному». Агент Тины отдал агенту Нейта свою книгу со второго места и взял «Америку до» — книгу, занимавшую десятое место из одиннадцати в его списке.
Чем занимались агенты на торговой площадке
Тот, кто ведёт переговоры за вас, может ошибиться по-разному — навредив и вам, и другим. Он может слишком легко уступить. Или раскрыть ваши карты, чтобы контрагент понял, насколько далеко вас можно продавить. А может вести нечестную игру, потеряв доверие другой стороны, или заключить сделку, которая впоследствии рискует сорваться.
Некоторые из этих недостатков настолько распространены на рынках с участием людей-посредников, что против них существуют специальные правила. Биржевой брокер обязан искать наилучшую из доступных разумных цен, а не просто соглашаться на первое предложение. В Калифорнии агент, представляющий обе стороны сделки купли-продажи жилья, не вправе сообщать покупателю, что продавец согласился бы на цену ниже запрашиваемой. Торговые представители, обходящие дома, могут торопить людей и склонять их к сделкам, о которых те потом жалеют, поэтому Федеральная торговая комиссия США даёт покупателям три дня на отмену некоторых покупок, совершённых на месте.
Чтобы составить предварительное представление о том, как ведёт себя рынок, полный агентов Claude, мы изучили стратегии и тактики в сообщениях, отправленных во всех 205 запусках рынка.21
Для начала посмотрим, что агенты рассказывают о книге, которую хочет получить их человек. На рынке необходимо раскрывать некоторую информацию: продавец не сможет продать товар, если покупатель хотя бы не сообщит о своём желании его купить. Но в то же время излишняя откровенность может оказаться стратегически невыгодной. В наших условиях, раскрыв название своей самой желанной книги, вы сообщаете её владельцу, что вас можно заставить ждать до последней минуты, а значит, ему есть смысл подождать более выгодного предложения. А раскрыв полный или частичный рейтинг книг, вы даёте каждому, кто собирает многостороннюю сделку, возможность увидеть, на какие менее предпочтительные варианты вы всё же согласны, и предложить один из них вместо более подходящей вам книги, которая также доступна.
В целом агенты не раскрывали подробностей о своих рейтингах.22 Но часто сообщали участникам рынка о своём главном выборе. От 78% до 96% агентов (соответственно, Fable и Sonnet) в какой-то момент называли книгу, стоявшую на первом месте в их списке, и почти никогда не лгали об этом: среди агентов, назвавших свой главный выбор, солгали примерно 1 из 100. Инструкции на это не повлияли.
Затем мы изучили, как агенты пытались убедить друг друга совершить обмен. Мы выявили 16 распространённых тактик, которые делятся на три большие категории: как агенты оказывали давление на других, как рекламировали свои книги и как пытались организовать обмены. Они ссылались на нехватку времени и чувство долга перед другими агентами. Сопоставляли свои книги с конкурирующими предложениями и упоминали награды. Одни агенты вели списки ожидания на свои книги, другие выступали в роли свах, выполняя работу брокера для людей, которых не представляли. На рисунке 6 приведены примеры таких тактик; более подробное описание см. в приложении.
В целом людям понравились их книги, и они доверили бы агенту треть своего годового книжного бюджета
Через несколько недель после того, как участники получили книги, мы спросили, насколько им понравилось чтение. Ответили не все,23, но среди ответивших средняя оценка удовлетворённости составила 7,2 из 10 (где 5 означает «нормально», а 10 — «одна из лучших книг, прочитанных мной в этом году»). Около половины участников сказали, что книга оказалась лучше большинства тех, которые они выбирают себе сами.24
В том же последующем опросе мы спросили участников, насколько они доверили бы ИИ-агенту покупку книг. Мы попросили их представить, сколько они обычно потратили бы на книги в течение следующего года, и указать, какую долю этого бюджета они доверили бы агенту (при условии, что агент знает всё из вводного разговора, самостоятельно выбирает и покупает книги и не даёт им возможности отклонить свои решения).
Многие были готовы делегировать эту задачу. Средний ответ составил около 30%. Чтобы лучше понять эти цифры, мы спросили участников, какую долю бюджета они доверили бы начитанному другу, который знает их вкусы. Средний ответ составил около 40%. Иными словами, люди были готовы доверить агенту примерно три четверти той суммы на книги, которую доверили бы другу.
Участникам также показали написанное Claude краткое изложение того, что они рассказали во время вводной беседы. Те, кто счёл, что Claude ничего не упустил, доверили бы агенту 34% своего книжного бюджета. Те же, кто отметил, что что-то было упущено, передали бы ему 23%.25
Ограничения
Мы рассматриваем это исследование как отправную точку. Во многих отношениях оно не дотягивает до желаемого, и мы надеемся, что другие продолжат эту работу:
- Сотрудники Anthropic не представляют население в целом. Например, сотрудники Anthropic, вероятно, охотнее доверяют Claude, чем большинство людей, поскольку многие из них помогали его создавать. Поэтому доля книжного бюджета, которую они готовы ему доверить, — 30% — может быть выше, чем у населения в целом.
- Сотрудникам Anthropic не платили за участие. Поскольку за время, потраченное на составление рейтингов книг, не полагалось вознаграждения, рейтинги наших коллег могли быть неточным отражением их «истинных» предпочтений. Хотя с учётом отсутствия стимулов в упражнении по ранжированию приняли участие удивительно многие (95%), на заключительном опросе участников было меньше: на него ответили лишь 59% сотрудников.
- Мы изучали только благонамеренных агентов Claude. Все агенты были созданы на основе производственных моделей Claude и дополнительно обучены быть вежливыми и в основном склонными к сотрудничеству. Если бы в исследовании участвовали также агенты, намеренно созданные для эксплуатации других, результаты с точки зрения справедливости и эффективности, вероятно, оказались бы иными.
- В децентрализованной «свободной игре» всё же были правила, и мы их не меняли. Мы зафиксировали продолжительность работы рынка, число агентов, которые могли действовать одновременно, порядок регистрации сделок и подсказки, в которых излагались правила.26
Обсуждение: последствия для рынков с участием ИИ-агентов
Один из участников был недоволен тем, что его агент отказался от книги, которую тот очень хотел получить, ради книги, которая интересовала его меньше, — «из-за давления со стороны других». Участник написал: «Это заставляет меня задуматься о том, как будущие агенты, ведущие переговоры за меня в ситуациях с более высокими ставками, могли бы лучше исполнять свои фидуциарные обязанности. Но я также понимаю, что иногда ради общего блага приходится идти на компромисс». Этот комментарий поднимает два вопроса, с которых начинается статья. Во-первых, когда агенту можно доверить действовать от чьего-либо имени? Во-вторых, какие правила нужны рынкам, чтобы агенты, действуя в интересах своих людей, при этом обеспечивали хорошие результаты для всех остальных? Здесь мы вернёмся к этим вопросам, опираясь на то, что узнали.
Чтобы исполнять фидуциарные обязанности, агент должен понимать, чего хочет его человек. На нашем рынке с участием агентов ограничивающим фактором была точность представления предпочтений: большая часть отклонения от оптимального результата объяснялась неспособностью агентов понять предпочтения по короткой вводной беседе. Насколько можно было бы сократить это отклонение с помощью более продолжительной и подробной беседы? Очевидно, в какой-то мере это возможно: многие участники жаловались, что получили книгу, которую уже читали. Но часть ошибок может быть неизбежной. Участники отмечали, что их предпочтения не до конца сформированы («Я и сам не вполне знаю, чего хочу от книг») и в значительной мере непредсказуемы («Не думаю, что смог бы толком объяснить, что мне хотелось бы почитать. Не могу объяснить, но, наверное, на выбор следующей книги влияют миллион подсознательных факторов»).
Прежде чем представлять других, люди-агенты должны пройти проверку. Одни экзамены оценивают общую компетентность: инвестиционные консультанты должны сдать экзамен Series 65, брокеры — Series 7, а агенты по недвижимости — пройти государственные экзамены для получения лицензии. Другие требования, например правила FINRA, обязывают брокеров выяснить важные сведения о клиенте до выдачи рекомендаций. Когда в 2010-х годах появились первые робоконсультанты, которые инвестировали сбережения людей на основе онлайн-анкеты, Комиссия по ценным бумагам и биржам США выпустила рекомендации, призывающие такие компании проверять, достаточно ли информации собирает анкета для обоснования советов. ИИ-агентам, вероятно, понадобятся оба типа проверок: одна будет подтверждать общую квалификацию агента, другая — проверять, понял ли он конкретного человека.
Наше исследование предлагает прототип проверки второго типа. После вводной беседы участники оценивали небольшую выборку книг на своём рынке, и мы сравнивали их рейтинг с предположениями Claude. Такая проверка позволяет человеку понять, насколько точно агент его представляет, не заставляя перебирать все возможные варианты на рынке (именно от этого занятия агент и должен был его избавить!). Мы не показывали участникам результаты, но могли бы это сделать, а затем предложить им добавить информацию или отказаться от участия, если бы они сочли, что агент их не понимает. Когда предпочтения просты — например, касаются лишь списка книг, — подобную проверку особенно легко провести. Но тот же принцип можно применить в любой сфере. Прежде чем доверить агенту самостоятельные действия в реальном мире, он мог бы показать человеку несколько примеров решений, которые собирается принимать.
На некоторых рынках агенту также может быть важно заранее продемонстрировать своему человеку, как он будет действовать. Один участник остался недоволен поведением своего агента: «Мне не понравилось, что в эксперименте я оказался в пассивной роли. Похоже, он просто согласился на вариант, который мне не очень подходил». Если бы участнику заранее показали, как поведёт себя агент, он мог бы попросить его действовать иначе и тем самым улучшить свой опыт. Если человек собирается снова и снова полагаться на агента, возможность просматривать его действия может помочь достичь той же цели и понять, что пошло не так. Более довольный участник из Сан-Франциско обрадовался возможности просмотреть в рамках заключительного опроса полный журнал действий своего агента. Благодаря этому он решил купить Atlas of the Heart — книгу, которую агент час держал для него на торговой площадке, но в последний момент обменял. Участник отметил более широкую ценность такой записи: «В агентных экономиках возможность наблюдать за процессом будет не менее важна, чем результат, [поскольку] она даёт людям возможность добиваться справедливости».
Это наблюдение подводит нас к следующему набору вопросов. Где заканчиваются обязанности агента участника и начинаются обязанности самого рынка?27 Наше исследование показывает, что хорошо устроенный рынок с благонамеренными агентами и точным представлением предпочтений может при нынешних возможностях агентов приблизиться к утилитарному оптимуму. Но мы также контролировали многие условия, благодаря которым это стало возможным. Каждый агент был создан нами, работал на наших моделях, представлял конкретного сотрудника, прошедшего тот же опрос, что и остальные, и действовал на хорошо организованной торговой площадке с понятными правилами предложения, принятия и регистрации обменов.
И даже тогда возникли некоторые проблемы. Вообще-то нам нужно признаться кое в чём. На протяжении всей этой статьи мы создавали впечатление, будто каждый участник действительно ушёл домой с физическим экземпляром книги, которую для него добыл агент. На самом деле так было не со всеми. Некоторые участники не принесли свои книги, и их коллеги остались ни с чем. У нас не было системы учёта того, кто принёс или забрал книги, поэтому мы не могли понять, почему книга пропала: прежний владелец не принёс её или кто-то забрал её с полки для обмена — намеренно или случайно. Мы постарались компенсировать потери тем, кто пожаловался, и напомнить тем, кто не выполнил свою часть сделки. Но мы занятые исследователи, а не библиотекари на полной ставке, поэтому в какой-то момент сдались. К счастью, никто на нас особо не обиделся (хотя в лифте нам всё же пришлось перед кем-то извиниться). Ставки здесь были невелики. На настоящем рынке потребовались бы чёткие правила на случай срыва сделки: можно не брать на себя никакой ответственности, как на Craigslist, или гарантировать возврат денег, как на eBay.
Некоторые варианты регулирования зависят от надёжных систем идентификации: платформе, которая возвращает деньги покупателю, необходимо иметь возможность применить санкции к продавцу, не доставившему товар. В нашем эксперименте каждый агент работал на Claude и представлял одного человека — проверенного сотрудника. Но участникам реальных рынков придётся разработать и обеспечить соблюдение правил, определяющих, кто может выйти на рынок — как в роли агента, так и в роли человека, управляющего агентом. Одно из предложений — системы регистрации агентов. Каждому ИИ-агенту присваивался бы идентификатор, подобный бортовому номеру самолёта, чтобы любой, кто с ним взаимодействует, мог узнать, на какой системе он работает, соответствует ли эта система определённым стандартам безопасности и кто за неё отвечает. Такие реестры не обязательно должны лишать пользователей анонимности: их можно объединить с »подтверждениями человеческой личности», позволяющими операторам доказать, что они люди, не раскрывая дополнительных сведений о своей личности.
На рынках с участием агентов взаимодействий в целом может быть больше, чем на рынках, где действуют люди, поскольку агенты способны общаться друг с другом гораздо чаще. В результате через рынок может проходить значительно больший объём информации. В нашем эксперименте всё было открыто: и для других агентов во время торговли, и для каждого человека после её завершения. Но, как мы отмечали выше, одно из главных достоинств децентрализованных рынков заключается в том, что людям не нужно раскрывать свои предпочтения центральной стороне. Как рынкам обеспечить такую наблюдаемость, которая была важна читателю Atlas of the Heart, и при этом защитить конфиденциальность участников?
Общение агентов создаёт и ещё одну проблему. Агент не устаёт и не скучает, поэтому ничто не мешает ему бесконечно отправлять сообщения другим агентам. В нашем исследовании каждый агент мог публиковать одно сообщение при каждом пробуждении, а одновременно бодрствовали лишь несколько агентов, что ограничивало спам и перегрузку. Подобные ограничения частоты запросов станут важным инструментом при проектировании любого рынка с участием агентов.
Наконец, одни рынки лучше подходят для посредничества агентов, чем другие. Возможно, книги, прекрасно подошедшие для обмена в офисном эксперименте, — именно тот товар, которому на самом деле полезны трения, присущие исключительно человеческому миру. Один участник из Сан-Франциско не сомневался в способности своего агента действовать на рынке от его имени: «Найти и купить книгу — тут я полностью уверен в способностях Claude!» И всё же у участника оставались сомнения: «Для меня важно также соприкасаться с культурой чтения… Просматривать книги, читать аннотации на задней обложке и так далее — всё это часть впечатлений». Мы хотели понять, как рынки с участием агентов могут помочь реализовать выгоды от обмена, которые остаются неиспользованными из-за того, что поиск и торг занимают слишком много времени. Для некоторых читателей эти трудности — часть ценности книги.
Приложение
Доступно здесь.
Благодарности
Авторы: Zoë Hitzig, Sylvie Carr, Tess Cotter, Kevin Troy, Kyle Turman, Maxim Massenkoff, Peter McCrory.
Благодарим: Mike Birkey, Meredith Callan, Katie Ennis, Adam Farina, Charlie Hale, Ryan Heller, Johannes Hermle, Hanah Ho, Rebecca Hiscott, Aaron Levin, Bianca Linder, Eva Lyubich, Kelsey Nanan, Kerry Persen, Szymon Sacher, Dylan Shields, Monika Tuchowska, Heather Whitney, Nathan Wilmers, Kim Withee и Carolyn Zou.
Библиографическая ссылка
@online{hitzig2026swap,
 author = {Hitzig, Zoe and Carr, Sylvie and Cotter, Tess and Troy, Kevin and Turman, Kyle and Massenkoff, Maxim and McCrory, Peter},
 title = {Project Swap: What happens when agents trade for us?},
 date = {2026-09-24},
 year = {2026},
 url = {https://www.anthropic.com/research/project-swap},
}Литература
Мы включили все работы, на которые есть ссылки или цитаты в тексте.
Adler, Steven et al., «Подтверждения человеческой личности: искусственный интеллект и ценность инструментов защиты конфиденциальности для определения того, кто в интернете реален», препринт arXiv arXiv:2408.07892, 2024.
Bianchi, Federico, Patrick John Chia, Mert Yuksekgonul, Jacopo Tagliabue, Dan Jurafsky и James Zou, «Насколько хорошо большие языковые модели умеют вести переговоры? Платформа NegotiationArena и её анализ», Материалы 41-й Международной конференции по машинному обучению, 2024, 235, 3935–3951.
Binz, Marcel et al., «Фундаментальная модель для прогнозирования и изучения человеческого мышления», Nature, 2025, 644, 1002–1009.
Budish, Eric и Judd B. Kessler, «Могут ли участники рынка достаточно точно сообщать о своих предпочтениях?», Management Science, 2022, 68 (2), 1107–1130.
Chan, Alan, Noam Kolt, Peter Wills, Usman Anwar, Christian Schroeder de Witt, Nitarshan Rajkumar, Lewis Hammond, David Krueger, Lennart Heim и Markus Anderljung, «Идентификаторы для систем искусственного интеллекта», препринт arXiv arXiv:2406.12137, 2024.
Chan, Alan, Kevin Wei, Sihao Huang, Nitarshan Rajkumar, Elija Perrier, Seth Lazar, Gillian K. Hadfield и Markus Anderljung, «Инфраструктура для ИИ-агентов», Transactions on Machine Learning Research, 2025.
Hadfield, Gillian K. и Andrew Koh, «Экономика ИИ-агентов», в: Agrawal, Brynjolfsson и Korinek, ред., Экономика трансформирующего ИИ, NBER, 2026.
Hou, Yupeng, Jiacheng Li, Xiangjun Fu, Zhankui He, An Yan, Xiusi Chen и Julian McAuley, «Связь языка и объектов для поиска и рекомендаций: сравнительная оценка больших языковых моделей в роли семантических кодировщиков», Материалы 64-го ежегодного собрания Ассоциации компьютерной лингвистики, 2026, 3251–3265. Набор данных: Amazon Reviews 2023, https://amazon-reviews-2023.github.io/
Horton, John J., Filippas, Apostolos и Benjamin S. Manning, «Большие языковые модели в роли симулированных экономических агентов: чему нас может научить Homo Silicus?», Материалы 25-й конференции ACM по экономике и вычислениям, 2024.
Imas, Alex, Kevin Lee и Sanjog Misra, «Взаимодействия с участием агентов», 2025. Доступно на SSRN: https://papers.ssrn.com/sol3/papers.cfm? abstract_id=5875162
Kolluri, Akaash, Shengguang Wu, Joon Sung Park и Michael S. Bernstein, «Дообучение больших языковых моделей для прогнозирования человеческого поведения в социальных экспериментах», Материалы конференции 2025 года по эмпирическим методам обработки естественного языка, 2025, 30084–30099.
Li, Belinda Z., Alex Tamkin, Noah D. Goodman и Jacob Andreas, «Выявление человеческих предпочтений с помощью языковых моделей», Материалы 13-й Международной конференции по обучающим представлениям, 2025.
Liang, Annie, «Клоны искусственного интеллекта», препринт arXiv arXiv:2501.16996, 2026.
Park, Joon Sung, Carolyn Q. Zou, Jonne Kamphorst, Niles Egan, Aaron Shaw, Benjamin Mako Hill, Carrie Cai, Meredith Ringel Morris, Percy Liang, Robb Willer и Michael S. Bernstein, «Агенты на основе больших языковых моделей, опирающиеся на самоотчёты, позволяют моделировать людей в самых разных ситуациях», препринт arXiv arXiv:2411.10109, 2026.
Roth, Alvin E., «Совместимость стимулов на рынке неделимых товаров», Economics Letters, 1982, 9 (2), 127–132.
Shah, Anand, Kehang Zhu, Yanchen Jiang, Jeffrey G. Wang, Arif K. Dayi, John J. Horton и David C. Parkes, «Обучение на синтетических площадках: языковые модели в роли участников аукционов», препринт arXiv arXiv:2507.09083, 2025.
Shahidi, Peyman, Gili Rusak, Benjamin S. Manning, Andrey Fradkin и John J. Horton, «Сингулярность Коузе? Спрос, предложение и проектирование рынков с ИИ-агентами», в: Agrawal, Brynjolfsson и Korinek, ред., Экономика трансформирующего ИИ, NBER, 2026.
Shapley, Lloyd и Herbert Scarf, «О ядрах и неделимости», Journal of Mathematical Economics, 1974, 1 (1), 23–37.
Troy, Kevin K., Dylan Shields, Keir Bradwell и Peter McCrory, «Проект Deal: эксперимент с рынком под управлением Claude», Anthropic, 24 апреля 2026 года. https://www.anthropic.com/features/project-deal
Yeomans, Michael, Anuj Shah, Sendhil Mullainathan и Jon Kleinberg, «Как разобраться в рекомендациях», Journal of Behavioral Decision Making, 2019, 32 (4), 403–414.
Zając, Zygmunt, «goodbooks-10k: новый набор данных для рекомендаций книг», 2017, версия 1.0. https://github.com/zygmuntz/goodbooks-10k. Лицензия CC BY-SA 4.0.
Zhu, Shenzhe, Jiao Sun, Yi Nian, Tobin South, Alex Pentland и Jiaxin Pei, «Автоматизированная, но рискованная игра: моделирование и сравнительная оценка переговоров и транзакций между агентами на потребительских рынках», препринт arXiv arXiv:2506.00073, 2025.
Примечания
- Мысль о том, что ИИ-агенты могут сделать централизованные модели рынка более практичными, высказана в работе Shahidi et al. (2026).
- В Сан-Франциско участвовали 115 человек, в Нью-Йорке — 57, в Лондоне — 12, в Сиэтле — восемь, в Вашингтоне, округ Колумбия, — шесть, а в Дублине — три. Мы не учитываем Дублин, поскольку его рынок был слишком ограниченным, чтобы на нём можно было чему-либо научиться.
- Мы повторили то же упражнение по ранжированию с другими моделями Claude. Показатели попарного совпадения для Opus 4.8, Sonnet 4.5 и Haiku 4.5 составили соответственно 60%, 59% и 57%; для сравнения, при подбрасывании монеты результат равен 50%, а у Fable — 61%.
- Для каждой книги участникам показывали миниатюру обложки; наведя на неё курсор, они могли увидеть краткое описание книги от издателя. В набор из 10 книг, который ранжировали участники, входили книга, доставшаяся им в итоге, и книга, которую они получили бы по централизованному правилу обмена (циклы топ-обмена, Top Trading Cycles). Обратите внимание: участники выполняли упражнение по ранжированию до того, как узнавали, какая книга им досталась. Подробности приведены в приложении.
- Если в наборе участника было меньше 10 книг, как в Сиэтле, Вашингтоне и Дублине, он ранжировал все книги из набора. Для ранжирования Claude мы условно считаем, что принесённая участником книга — его наименее любимая в наборе. В инструкциях агентам также настоятельно рекомендуется не покидать торговую площадку с книгой, которую принёс участник. Соответствующая часть инструкции звучит так: «Очень важно, чтобы в итоге у вас не оказалась книга, которую вы принесли. Если вы получите ту же книгу, что и принесли, значит, вы потерпели неудачу». Полный текст инструкции см. в приложении.
- Максимальное время работы каждой площадки и число агентов, которые могли действовать одновременно, задавались так, чтобы каждый агент получил примерно одинаковое число ходов (около 90), если бы площадка работала до установленного предела. На практике небольшие площадки (Лондон, Сиэтл, Вашингтон) всегда завершали работу раньше.
- Эти случайным образом выбранные инструкции — ключевое отличие от Project Deal, где мы разрешали участникам самим указывать своим агентам, как вести переговоры.
- Далее мы будем обозначать эти модели только названием семейства (то есть в оставшейся части отчёта «Opus» означает Opus 4.8).
- Результат применения правила циклов топ-обмена (Top Trading Cycles) вычисляется на основе ранжирования следующим образом: в каждом раунде правило определяет, какая книга стоит на первом месте в списке каждого человека и у кого она находится. Когда обнаруживается замкнутая цепочка (А хочет книгу Б, Б хочет книгу В, В хочет книгу А), участники цепочки обмениваются книгами и выбывают. Затем процедура повторяется для оставшихся участников и книг. При этом правиле никто не может улучшить свой результат, указав ранжирование, которое искажает его истинные предпочтения (Shapley и Scarf, 1974; Roth, 1982).
- Park et al. (2026) и Li et al. (2025) используют языковые модели, чтобы предсказывать предпочтения конкретного человека на основе его ответов в интервью. В смежной области исследований большие языковые модели применяют для прогнозирования поведения людей в социальных экспериментах; см., например, Horton et al. (2024), Binz et al. (2025) и Kolluri et al. (2025).
- Это значение получено в результате регрессии попарного совпадения на логарифм числа слов, набранных в предварительном чате, с фиксированными эффектами офисов. Удвоение числа слов в чате связано с ростом совпадения на 4,1 процентного пункта (p <0.01).
- Это распространённый способ преобразовать порядковые предпочтения в количественные. Отметим, что он предполагает линейную зависимость: разница в полезности между книгами на первом и втором месте в списке человека такая же, как между книгами на 30-м и 31-м месте.
- Другие исследования приходят к схожему выводу: различия в устройстве рынка нивелируются, если предпочтения представлены неточно (Budish и Kessler, 2022; Liang, 2026).
- Книга, которую человек ранжировал, получает оценку в зависимости от её места в его собственном списке, а книге, которую он не ранжировал, присваивается условная оценка. Она равна средней оценке, которую люди давали книгам, стоящим примерно на том же месте в рейтинге Claude. Выбор способа присвоения условных оценок и начисления баллов почти не влияет на результаты: присвоение оценок по аппроксимирующей прямой с рисунка 3 или использование отдельных средних для каждого офиса меняет столбец или ступень на рисунке 4 не более чем на 0,01. Если вообще не присваивать условные оценки, наилучшее возможное распределение составит 0,88, а итоговая оценка — 0,62 (однако при таком методе из расчёта исключаются 38% участников повторных запусков, показавших худшие результаты, что завышает итоговую оценку).
- Рисунки 3 и 4 позволяют ожидать, что в нашем исследовании не удастся выявить различия между вариантами устройства рынка, если оценивать их по истинным рейтингам участников. Все агенты на всех задействованных площадках используют одни и те же рейтинги Claude, поэтому модель и инструкции могут влиять только на этап переговоров на рисунке 4. Остальная часть разрыва объясняется тем, насколько хорошо Claude понимает предпочтения человека, — и она одинакова для всех вариантов устройства рынка. А поскольку место книги в списке Claude лишь слабо предсказывает её место в собственном списке человека (наклон прямой на рисунке 3 равен 0,3), даже значительное различие в рейтинге Claude почти исчезает в рейтингах самих людей. Например, самое большое различие между моделями, которое мы обнаружили, — разрыв в 0,12 между площадками Haiku и Opus по рейтингам Claude — сокращается до 0,01 при использовании той же спецификации регрессии с собственными рейтингами участников.
- В рейтингах Claude справедливость распределения менялась так же, как и его эффективность. Если измерять справедливость по наивысшей оценке среди агентов с худшими результатами (десятая часть участников, оказавшихся в самом невыгодном положении), то площадки Haiku набрали 0,05 против 0,12, 0,38 и 0,25 на площадках Sonnet, Opus и Fable соответственно.
- Fable чаще других предлагала многосторонние обмены по кругу: согласно линейной регрессии с фиксированными эффектами для сочетаний «офис × запуск», агенты Fable на 6 процентных пунктов чаще агентов Haiku предлагали такой обмен (p < 0.001), тогда как агенты Sonnet и Opus не отличались от Haiku.
- Регрессия, сравнивающая одного и того же агента на площадках с разными моделями, показывает, что по рейтингам Claude оценка агента на площадке Haiku была на 0,12 ниже, чем на площадке Opus (p < 0.001), на 0,08 ниже, чем на площадке Sonnet (p < 0.001), и на 0,02 ниже, чем на площадке Fable (p < 0.01). На смешанных площадках участники из группы Opus опередили группу Haiku на 0,14 (p < 0.001), группу Sonnet — на 0,06 (p < 0.05), а группу Fable — на 0,04 (p < 0.05).
- Разница в 0,02 между безжалостной и просоциальной стратегиями получена с помощью линейной регрессии с фиксированными эффектами участников и площадок; стандартные ошибки сгруппированы по площадкам (p < 0.001).
- Наши инструкции представляли собой два заранее подготовленных текста. В исследовании Imas et al. (2025) участники самостоятельно пишут инструкции для агентов, которые ведут переговоры от их имени; авторы обнаружили, что эти индивидуальные инструкции во многом объясняют разницу в результатах.
- Наше исследование не было организовано так, чтобы выявить, как эти тактики влияют на результаты участников. Однако Bianchi et al. (2024) обнаружили, что некоторые модели поведения, например демонстрация отчаяния, помогают добиться более выгодных результатов переговоров.
- Среди агентов на 80 площадках с нейтральными инструкциями лишь 10% указали позиции трёх или более книг в своём списке.
- На итоговый опрос ответили около 60% участников. Точный текст итогового опроса см. в приложении.
- Следует учитывать, что здесь возможна систематическая ошибка отбора: вероятно, те, кому книга понравилась меньше, с меньшей охотой отвечали и на последующий опрос коллег о ней.
- Этот разрыв объясняется не только различием в общей готовности делегировать. Если учесть, какую часть бюджета каждый человек доверил бы хорошо разбирающемуся в книгах другу, разница составит 9 процентных пунктов. Это значение получено с помощью линейной регрессии доли бюджета, которую участник доверил бы агенту, на показатель того, отметил ли он, что в кратком изложении предварительного чата что-то упущено; при этом учитывается доля, которую он доверил бы другу (p < 0.05, n = 112).
- Естественный следующий шаг — менять правила для участников-агентов, как это делают Shah et al. (2025) применительно к аукционам.
- Hadfield и Koh (2026) и Shahidi et al. (2026) предлагают полезные обзоры этих вопросов проектирования с точки зрения экономики. В работе Chan et al. (2025) представлена полезная концептуальная основа для технического управления.
Полный текст статьи читайте на Anthropic
