Представляем Claude Sonnet 4.5

Claude Sonnet 4.5 — лучшая модель для написания кода в мире. Это сильнейшая модель для создания сложных агентов. Это лучшая модель для работы с компьютером. И она демонстрирует существенный прирост в логических рассуждениях и математике.
Код повсюду. На нем работает каждое приложение, электронная таблица и программный инструмент, которым вы пользуетесь. Умение использовать эти инструменты и находить решения для сложных задач — это то, как выполняется современная работа.
Claude Sonnet 4.5 делает это возможным. Мы выпускаем ее вместе с набором крупных обновлений для наших продуктов. В Claude Code мы добавили контрольные точки (checkpoints) — одну из наших самых востребованных функций, — которые сохраняют ваш прогресс и позволяют мгновенно вернуться к предыдущему состоянию. Мы обновили интерфейс терминала и выпустили нативное расширение для VS Code. Мы добавили новую функцию редактирования контекста и инструмент памяти в Claude API, что позволяет агентам работать еще дольше и справляться с еще большей сложностью. В приложениях Claude мы интегрировали выполнение кода и создание файлов (электронных таблиц, презентаций и документов) непосредственно в диалог. А расширение Claude для Chrome стало доступно пользователям тарифного плана Max, которые присоединились к листу ожидания в прошлом месяце.
Мы также предоставляем разработчикам те строительные блоки, которые используем сами для создания Claude Code. Мы называем это Claude Agent SDK. Инфраструктура, которая лежит в основе наших передовых продуктов и позволяет им полностью раскрыть свой потенциал, теперь доступна для создания ваших собственных решений.
Это самая согласованная передовая модель из всех, что мы когда-либо выпускали, демонстрирующая значительные улучшения в различных аспектах безопасности и согласованности по сравнению с предыдущими моделями Claude.
Claude Sonnet 4.5 доступна везде уже сегодня. Если вы разработчик, просто используйте claude-sonnet-4-5 через Claude API. Цены остаются прежними, как у Claude Sonnet 4: $3 / $15 за миллион токенов.
Передовой интеллект
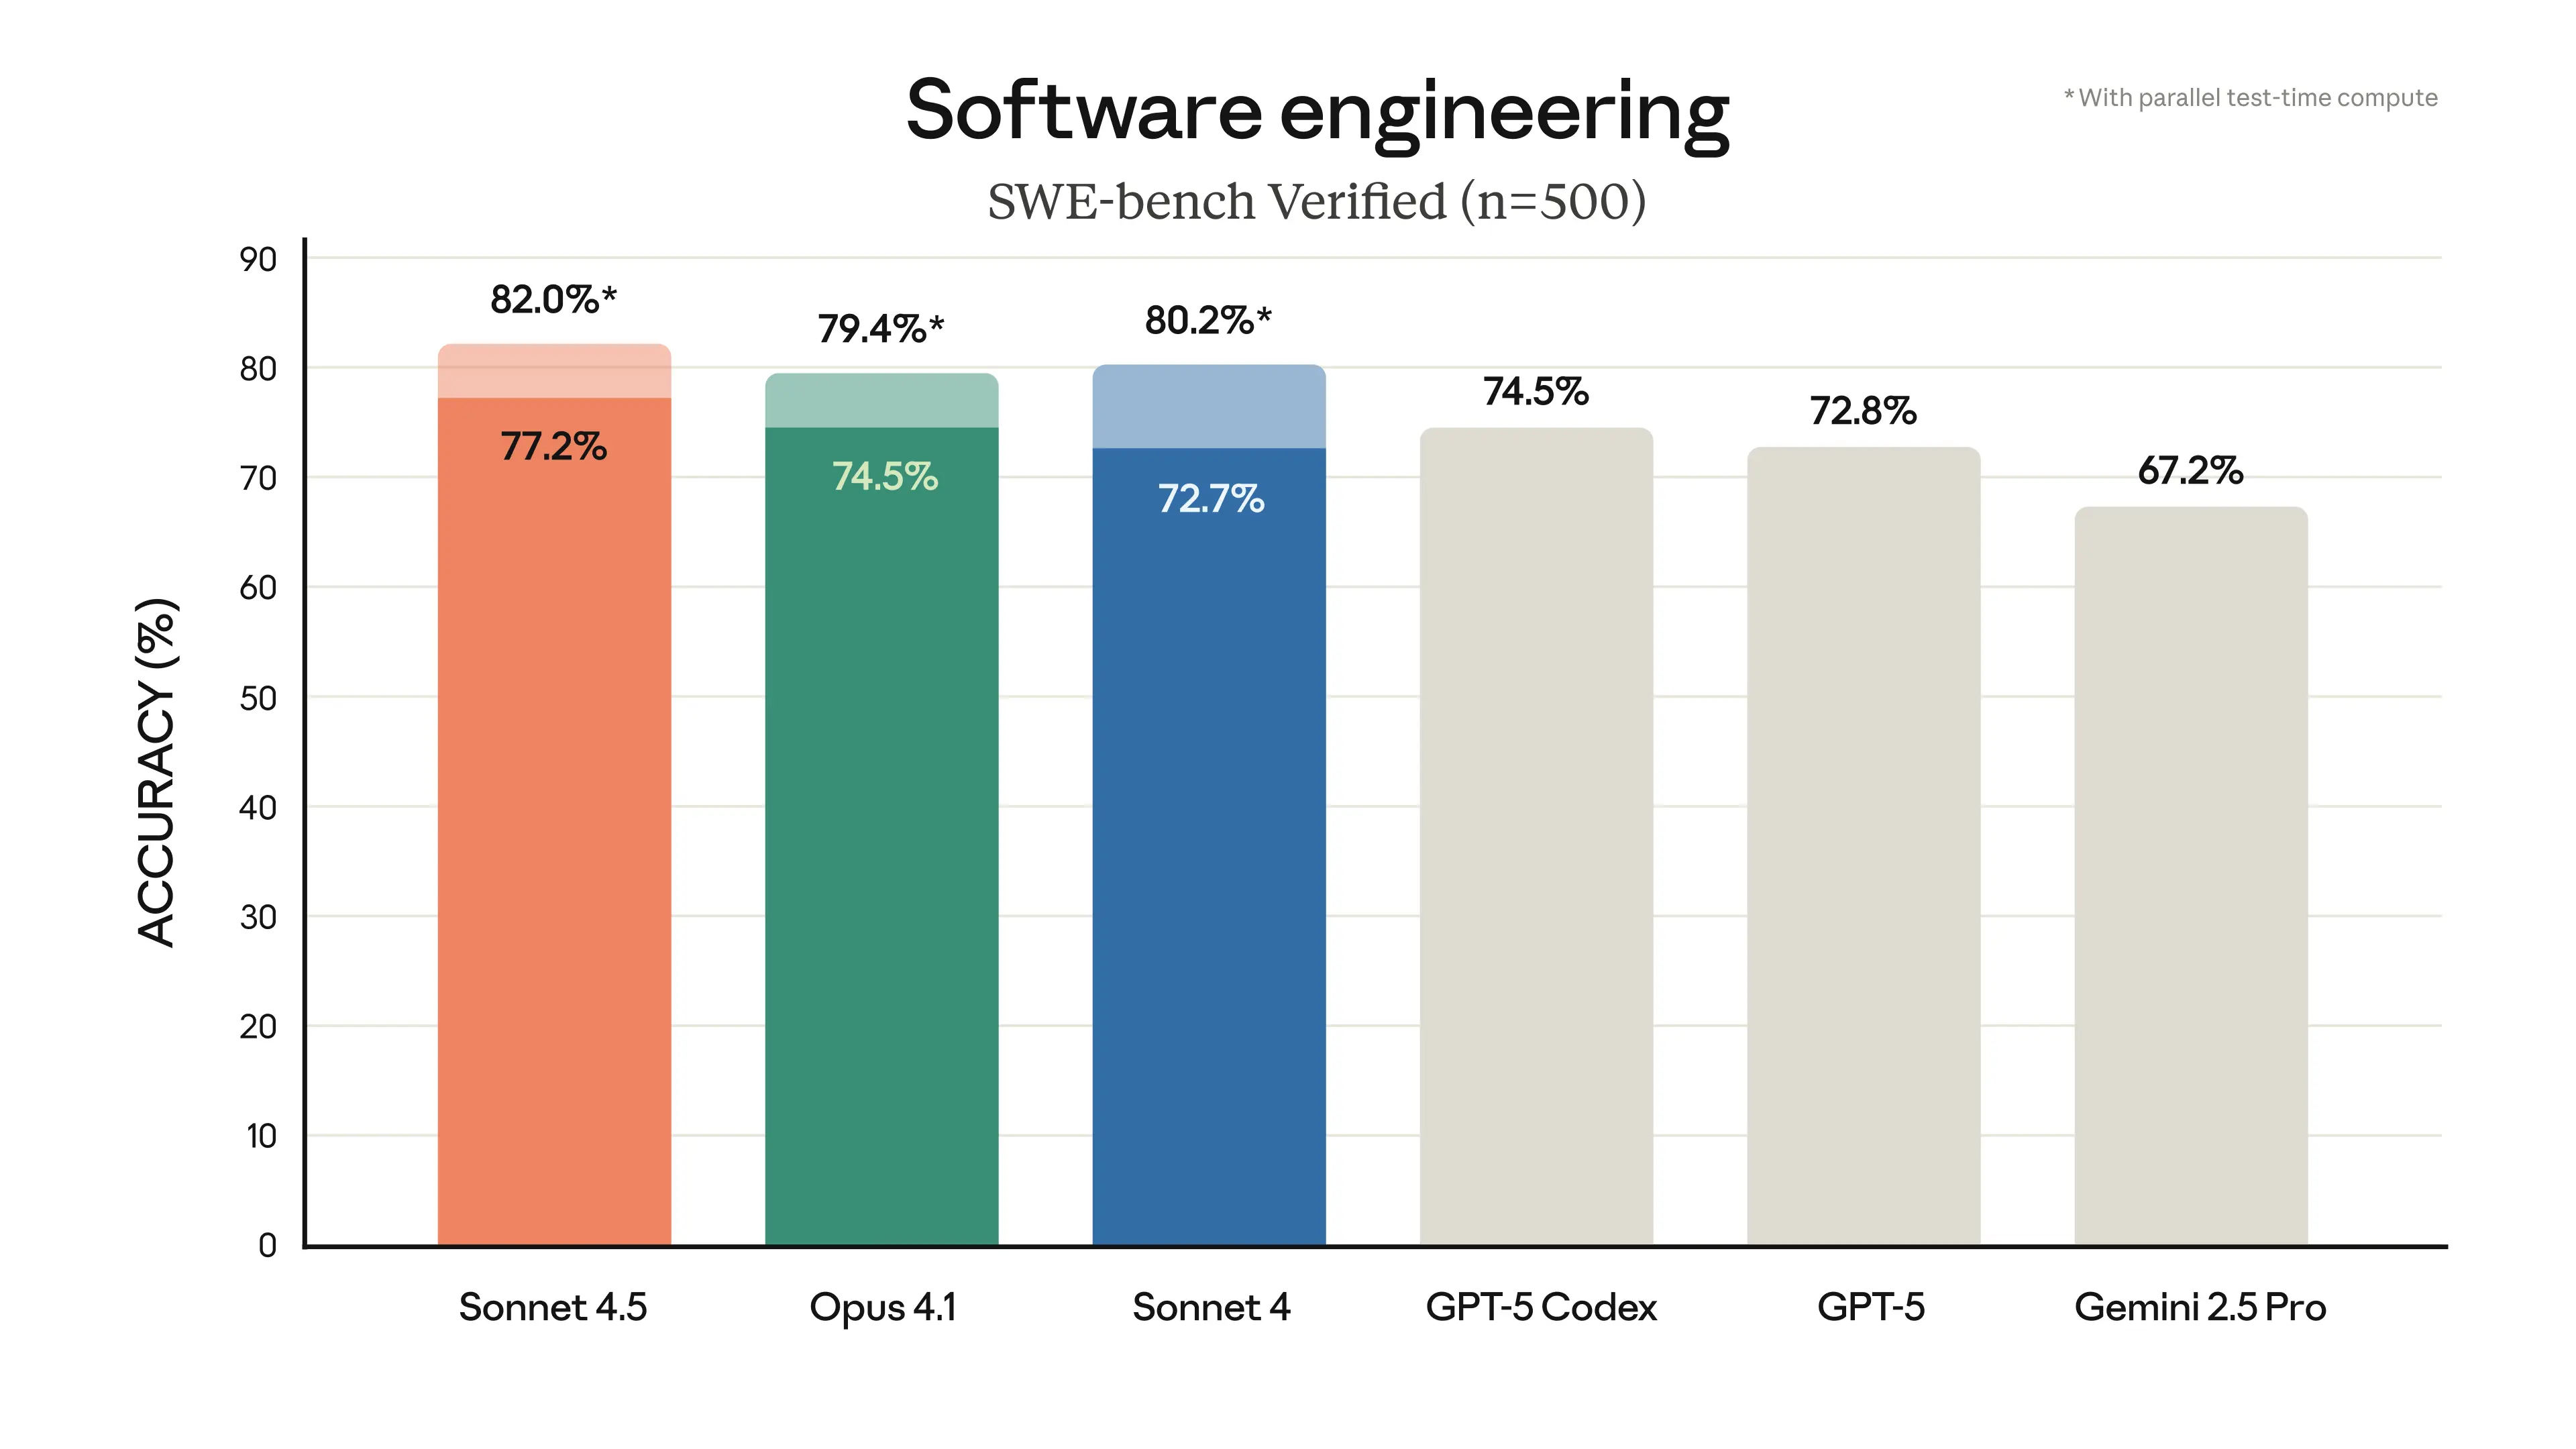
Claude Sonnet 4.5 задает новый стандарт в бенчмарке SWE-bench Verified, который измеряет навыки написания реального программного кода. На практике мы заметили, что она способна сохранять концентрацию более 30 часов при решении сложных многоэтапных задач.
Claude Sonnet 4.5 представляет собой значительный шаг вперед в использовании компьютера. В OSWorld, бенчмарке, который тестирует ИИ-модели на выполнение реальных компьютерных задач, Sonnet 4.5 теперь лидирует с результатом 61.4%. Всего четыре месяца назад лидировала Sonnet 4 с показателем 42.2%. Наше расширение Claude для Chrome задействует эти улучшенные возможности. В демонстрационном ролика ниже мы показываем, как Claude работает прямо в браузере: переходит по сайтам, заполняет таблицы и выполняет задачи.
Модель также демонстрирует улучшенные возможности в широком спектре тестов, включая логические рассуждения и математику:
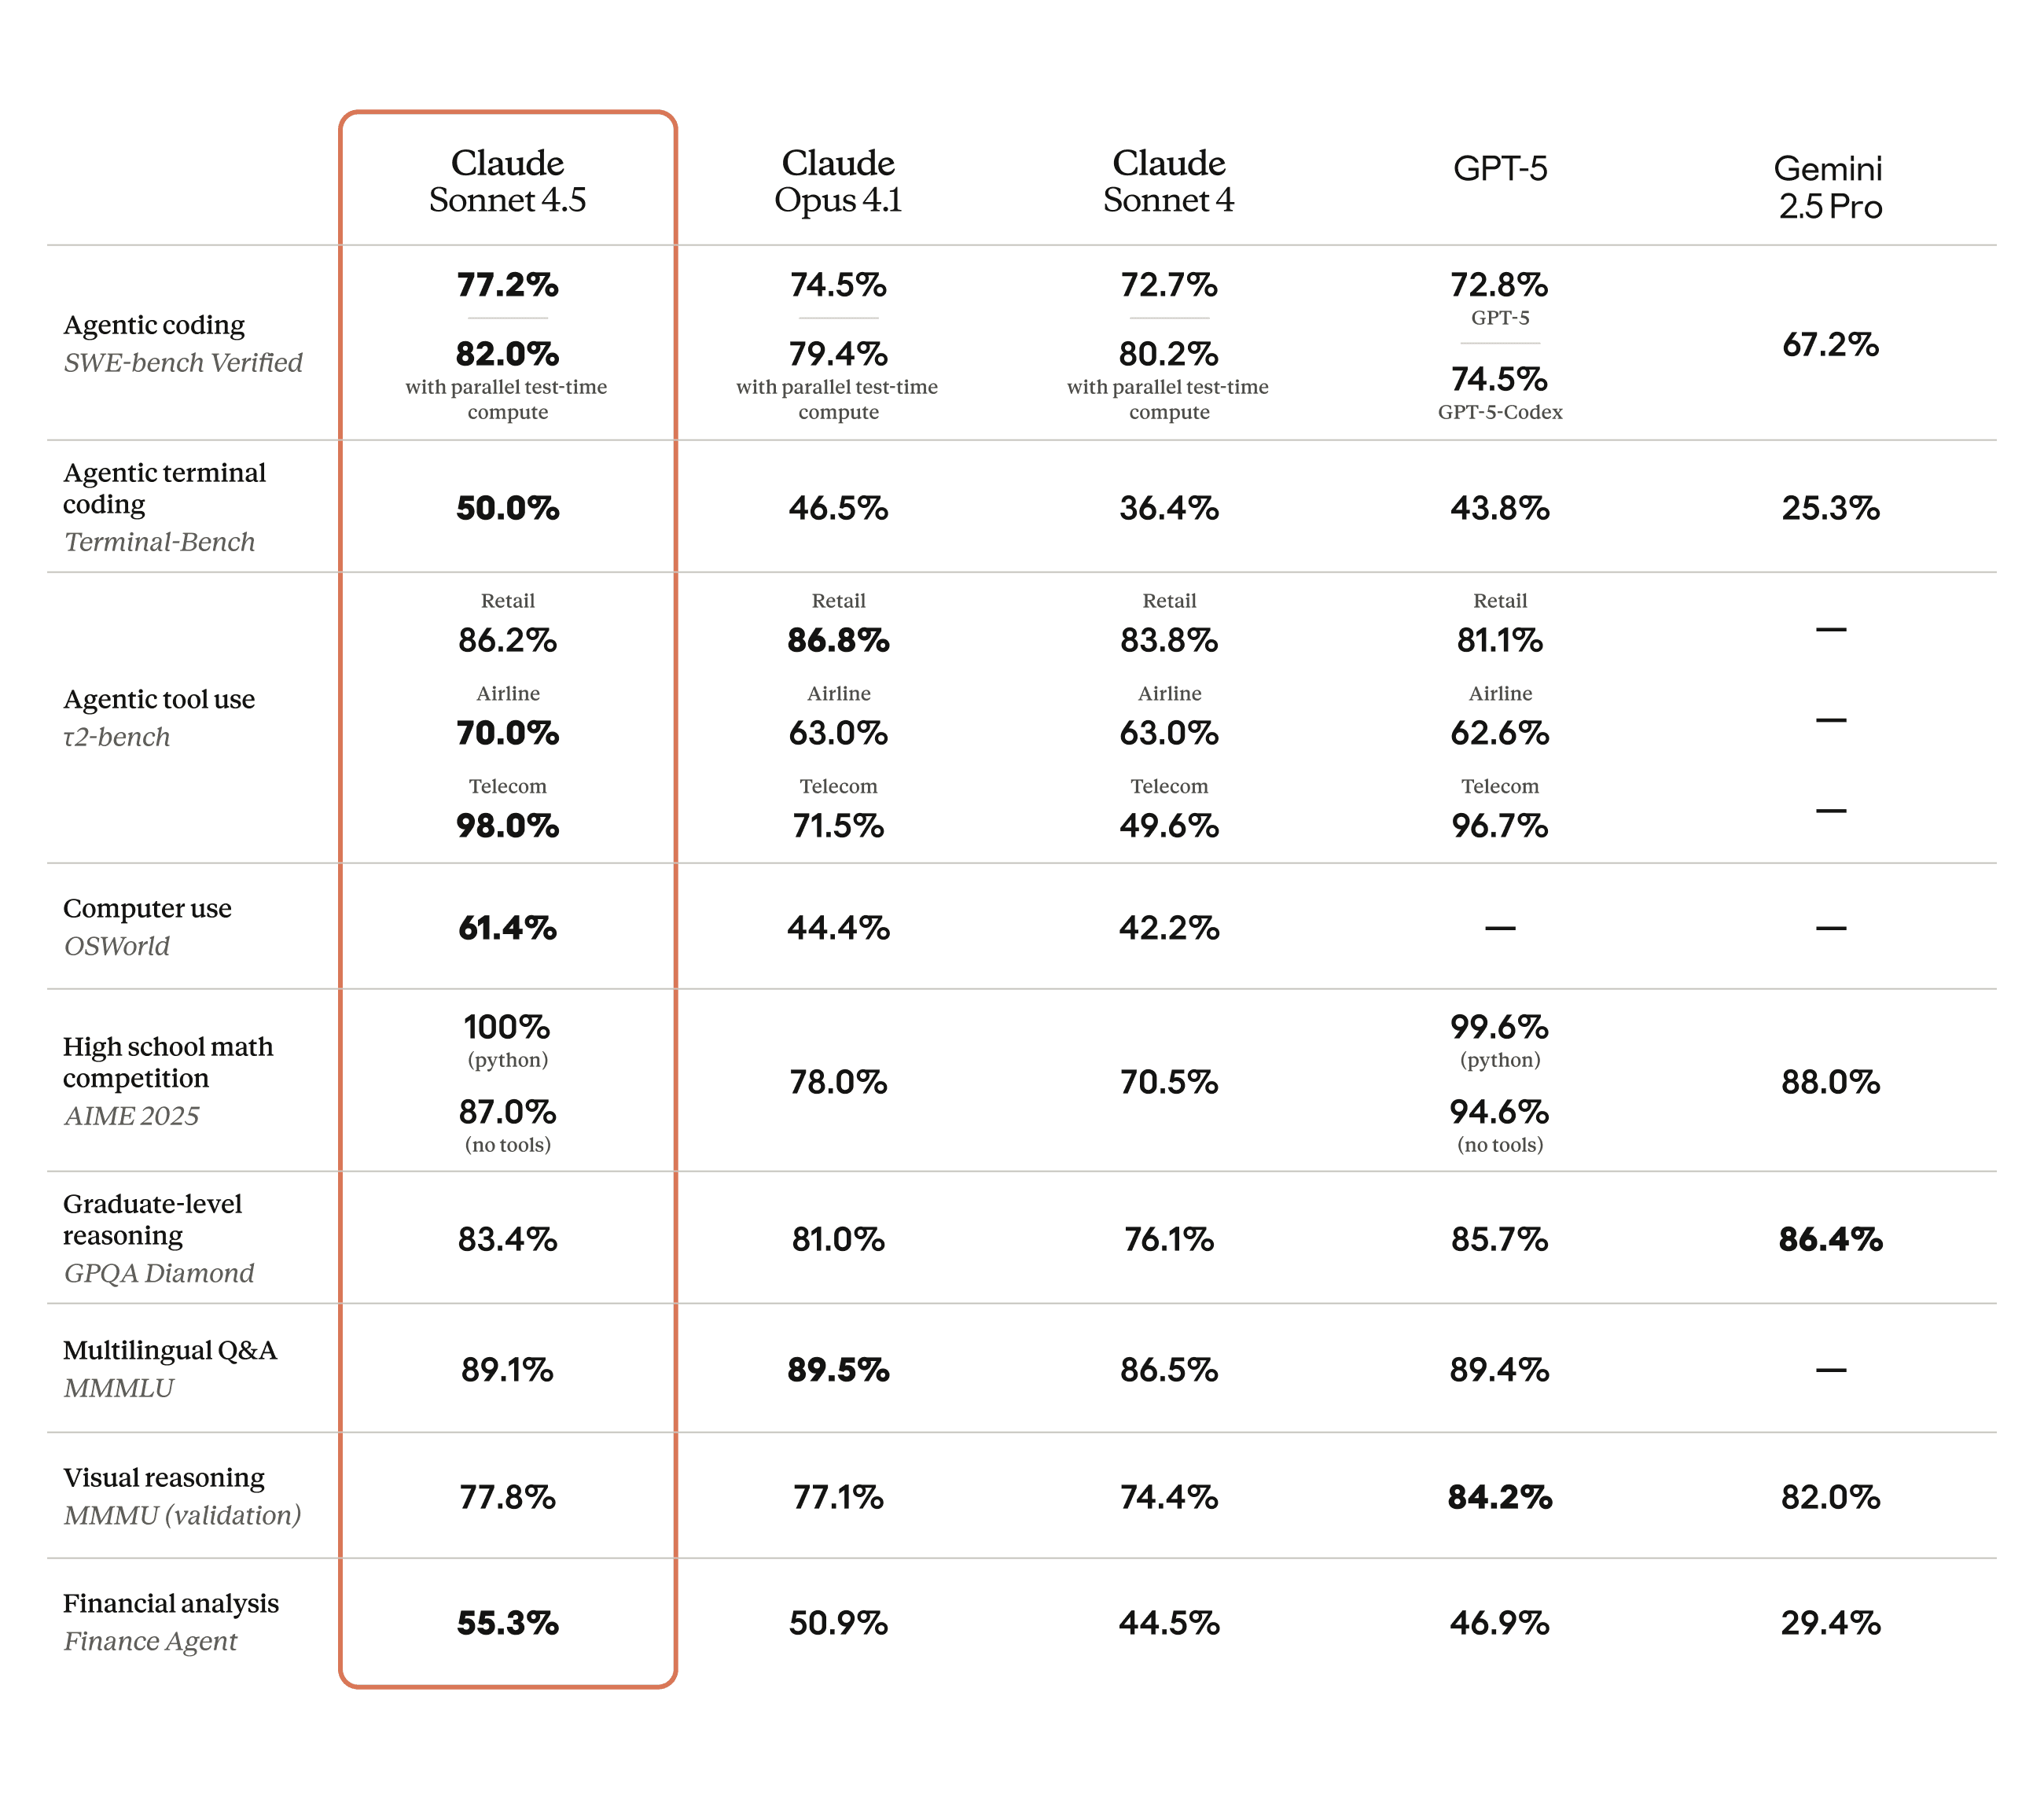 Claude Sonnet 4.5 — наша самая мощная модель на сегодняшний день. Сведения о методологии см. в сносках.
Эксперты в области финансов, права, медицины и точных наук (STEM) отметили, что Sonnet 4.5 демонстрирует значительно более глубокие специализированные знания и навыки рассуждения по сравнению с более старыми моделями, включая Opus 4.1.
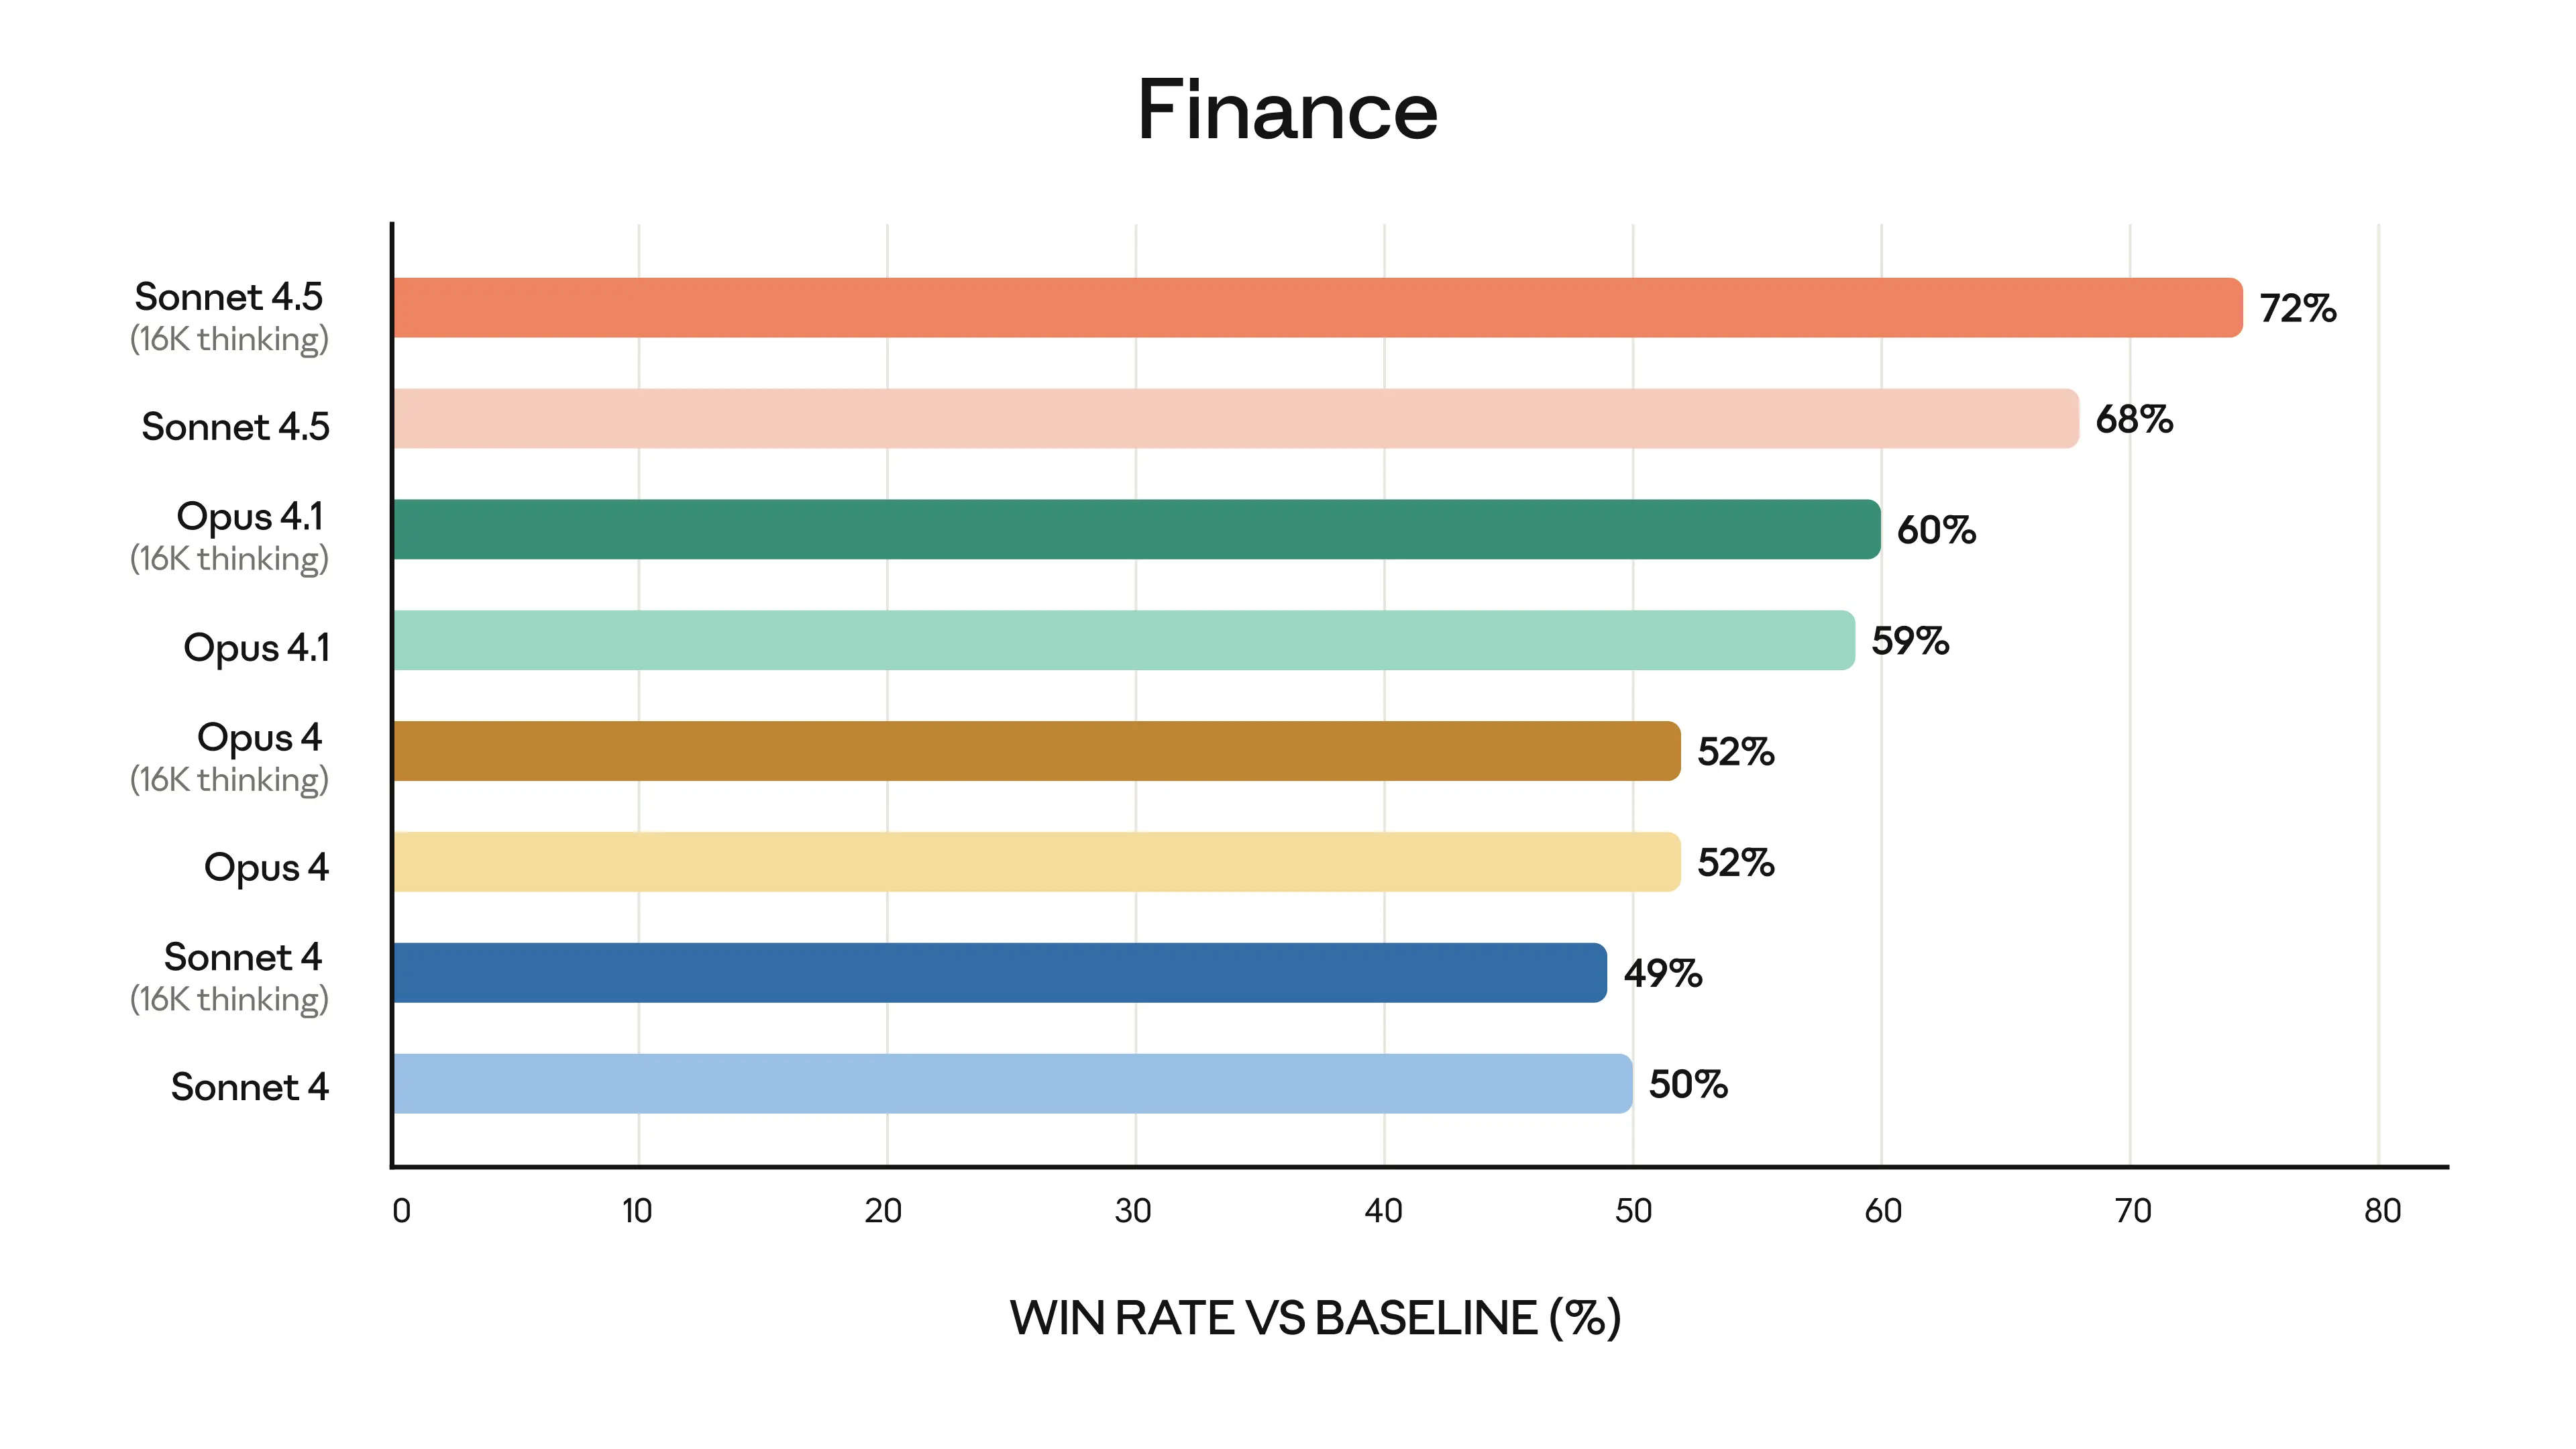
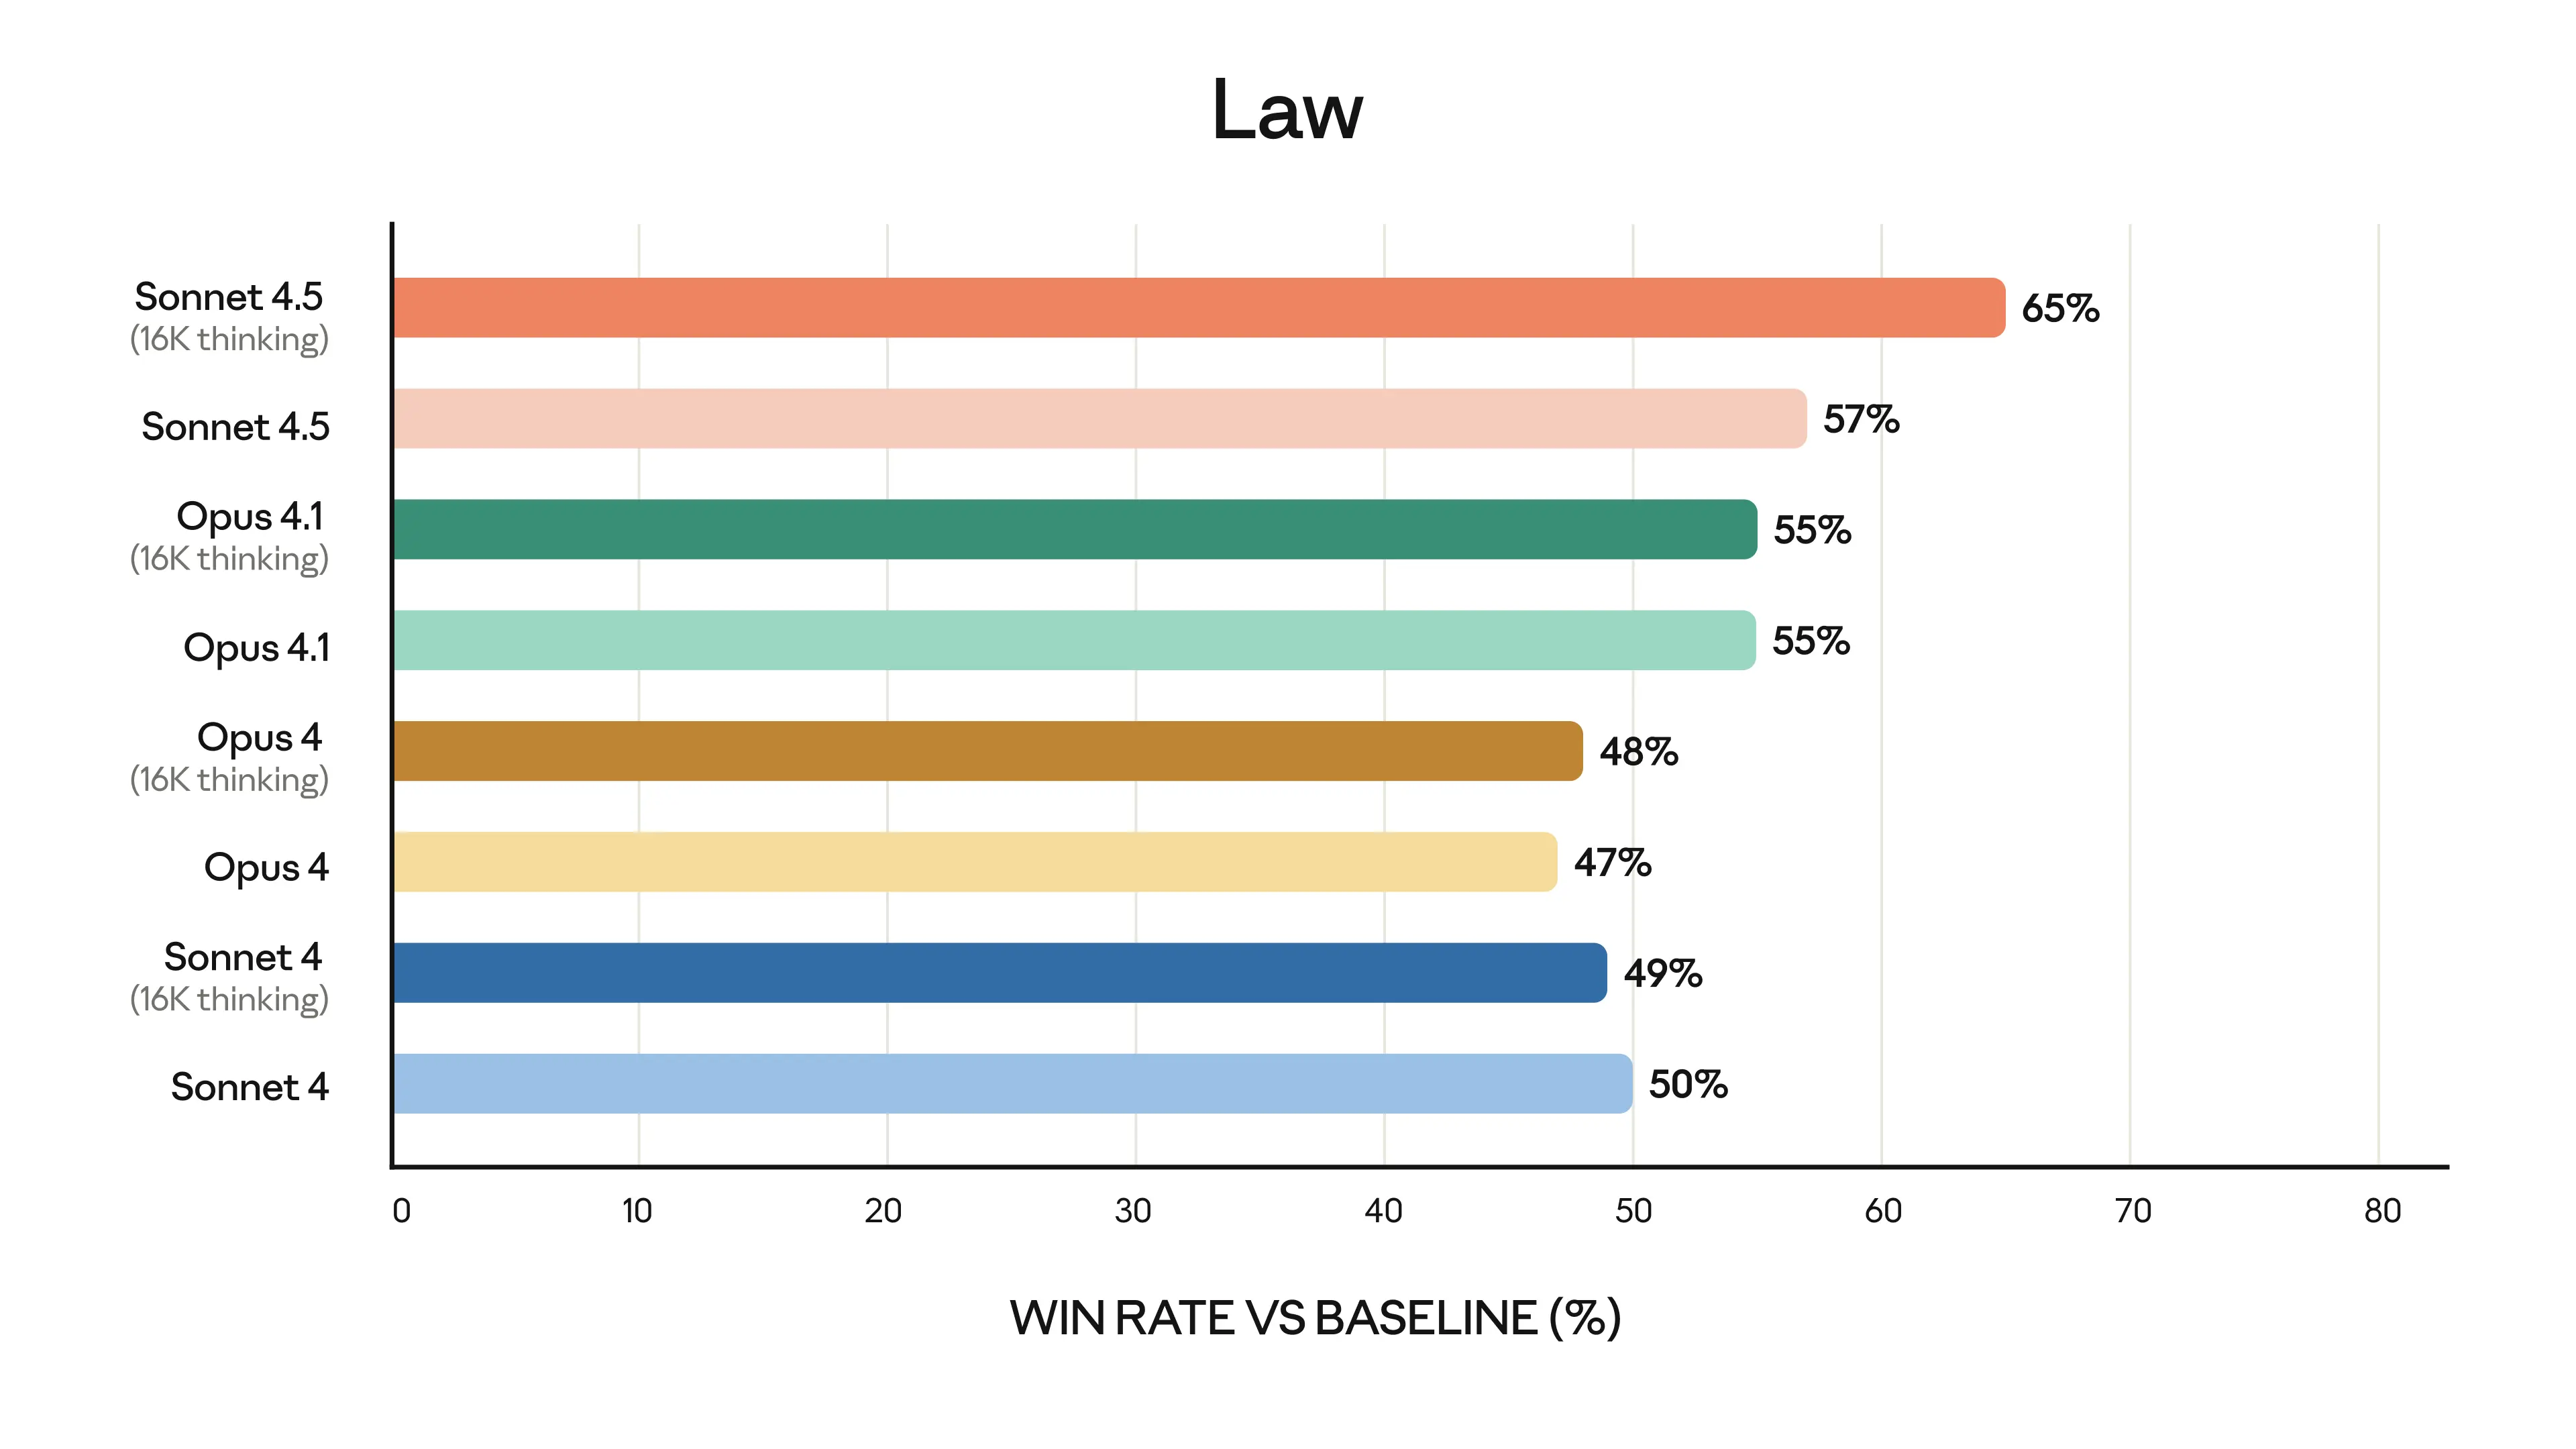
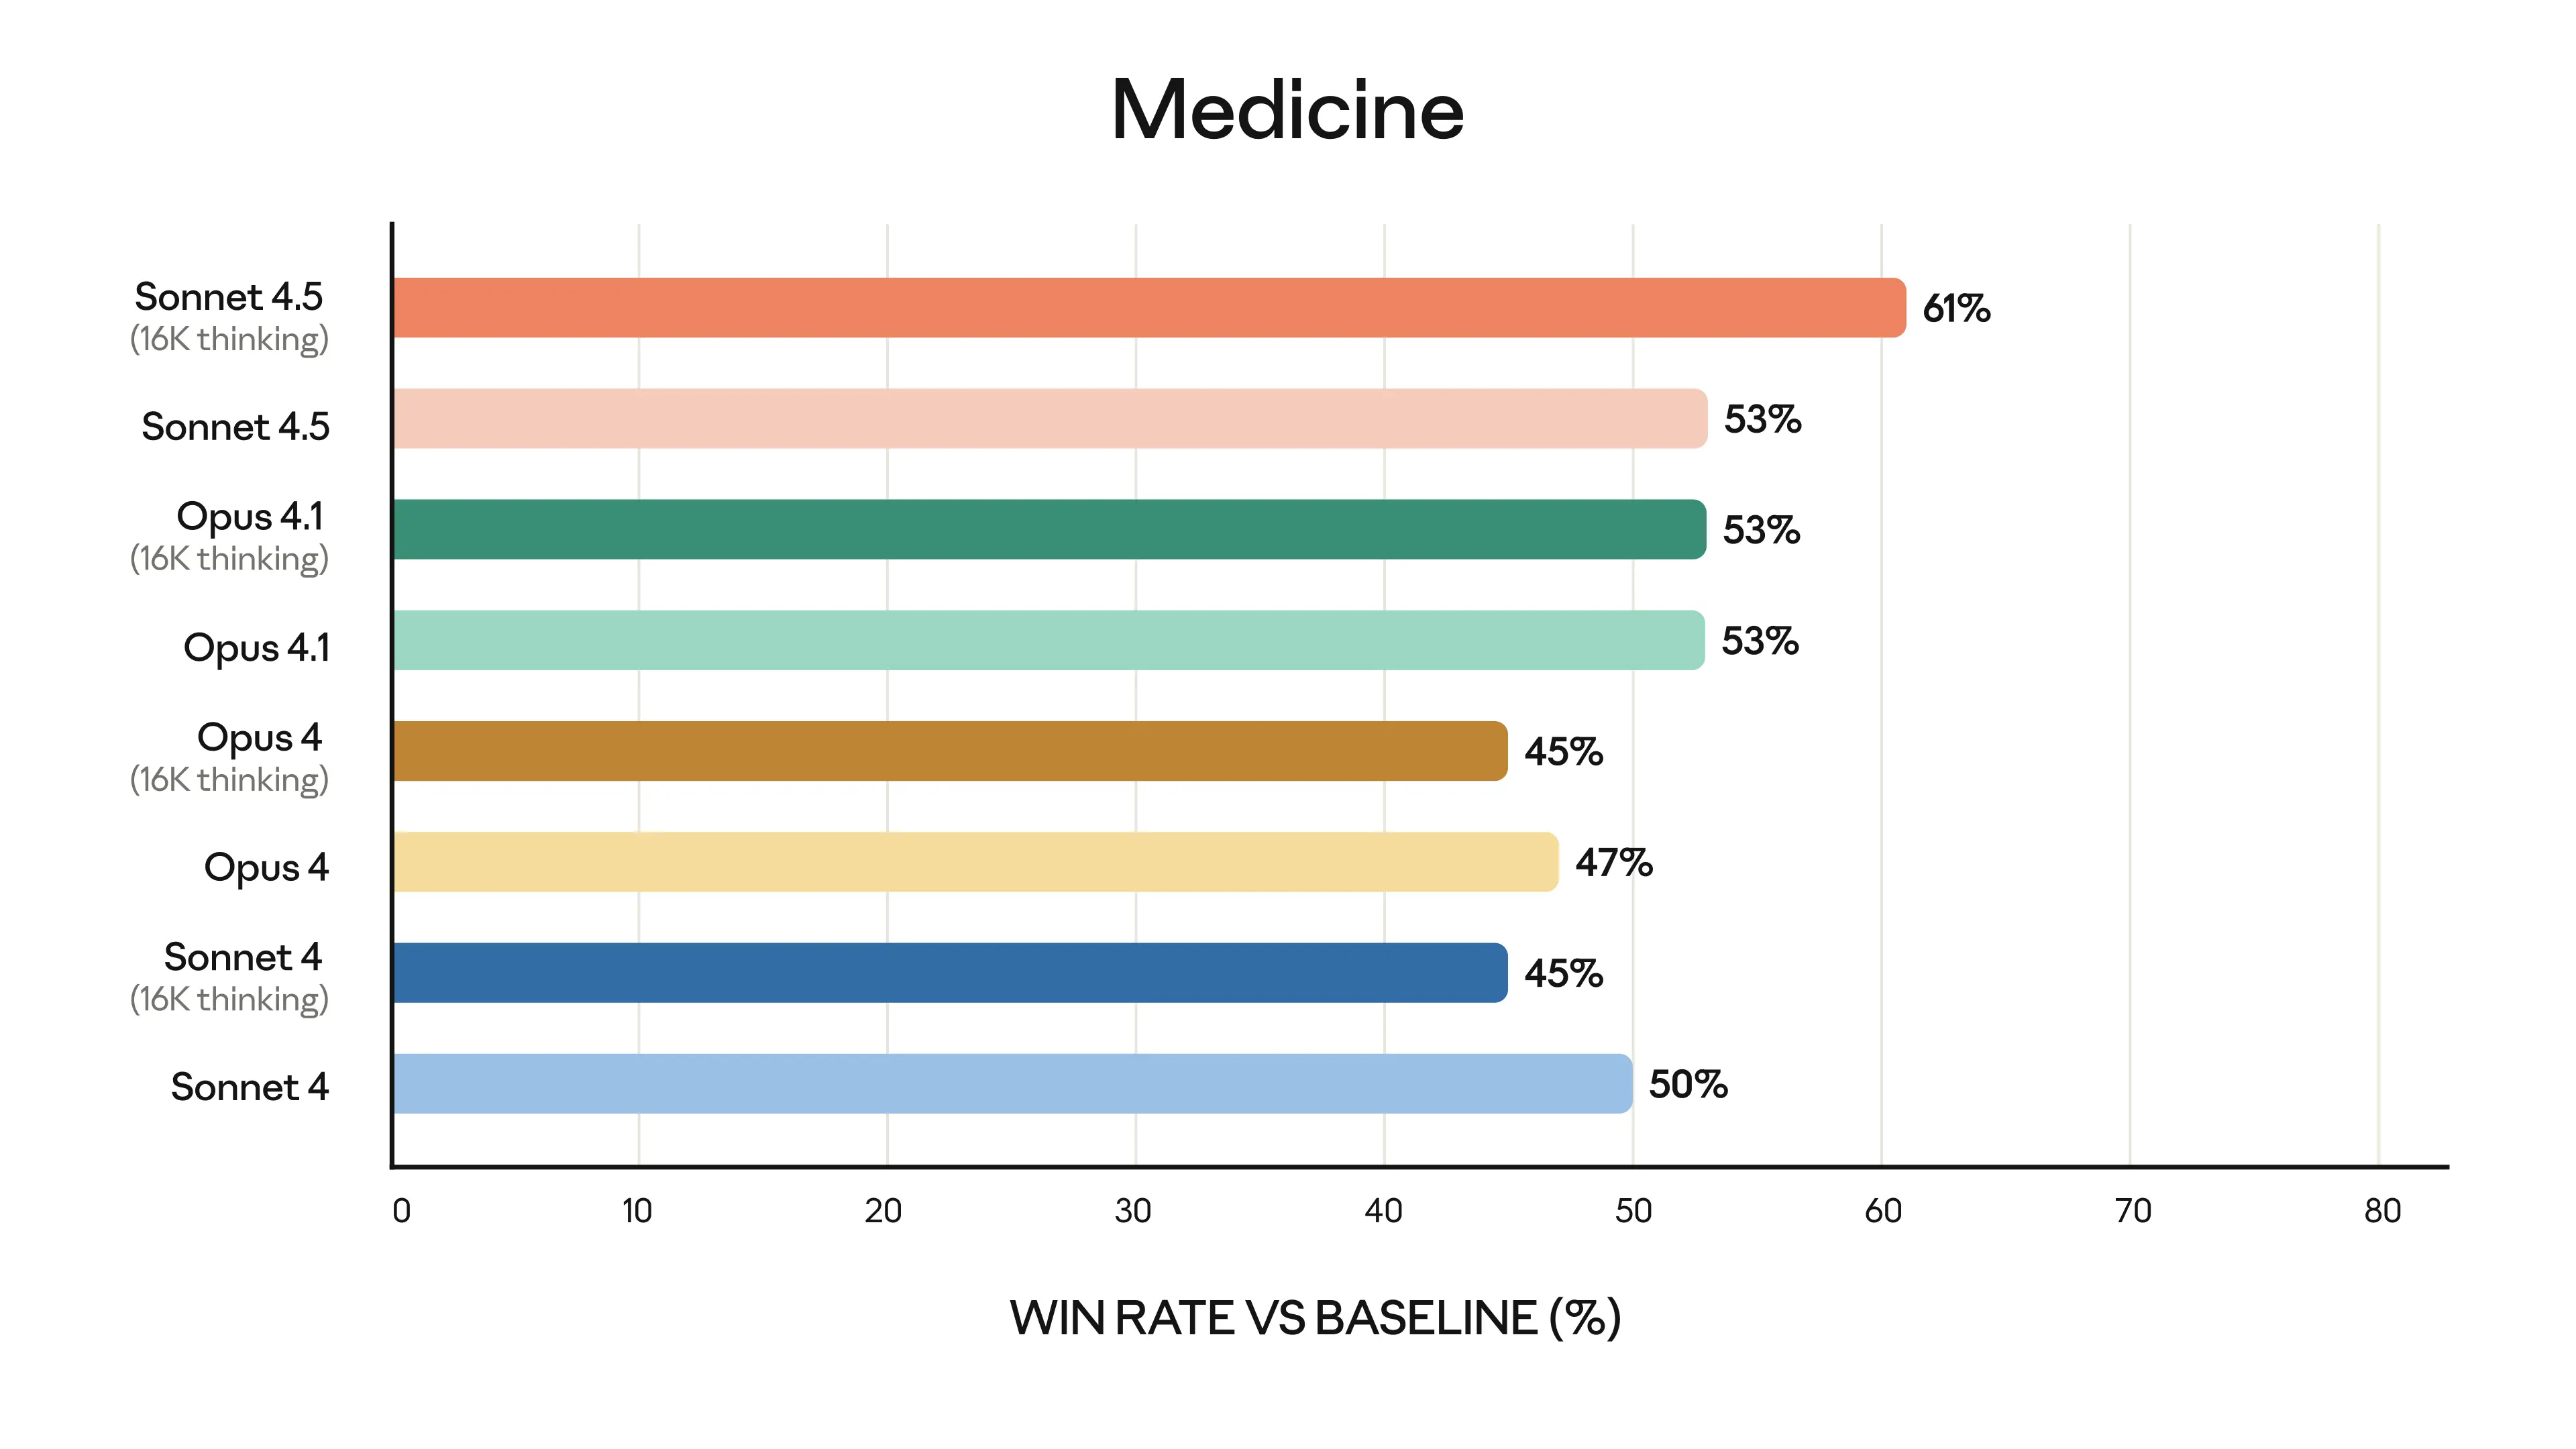
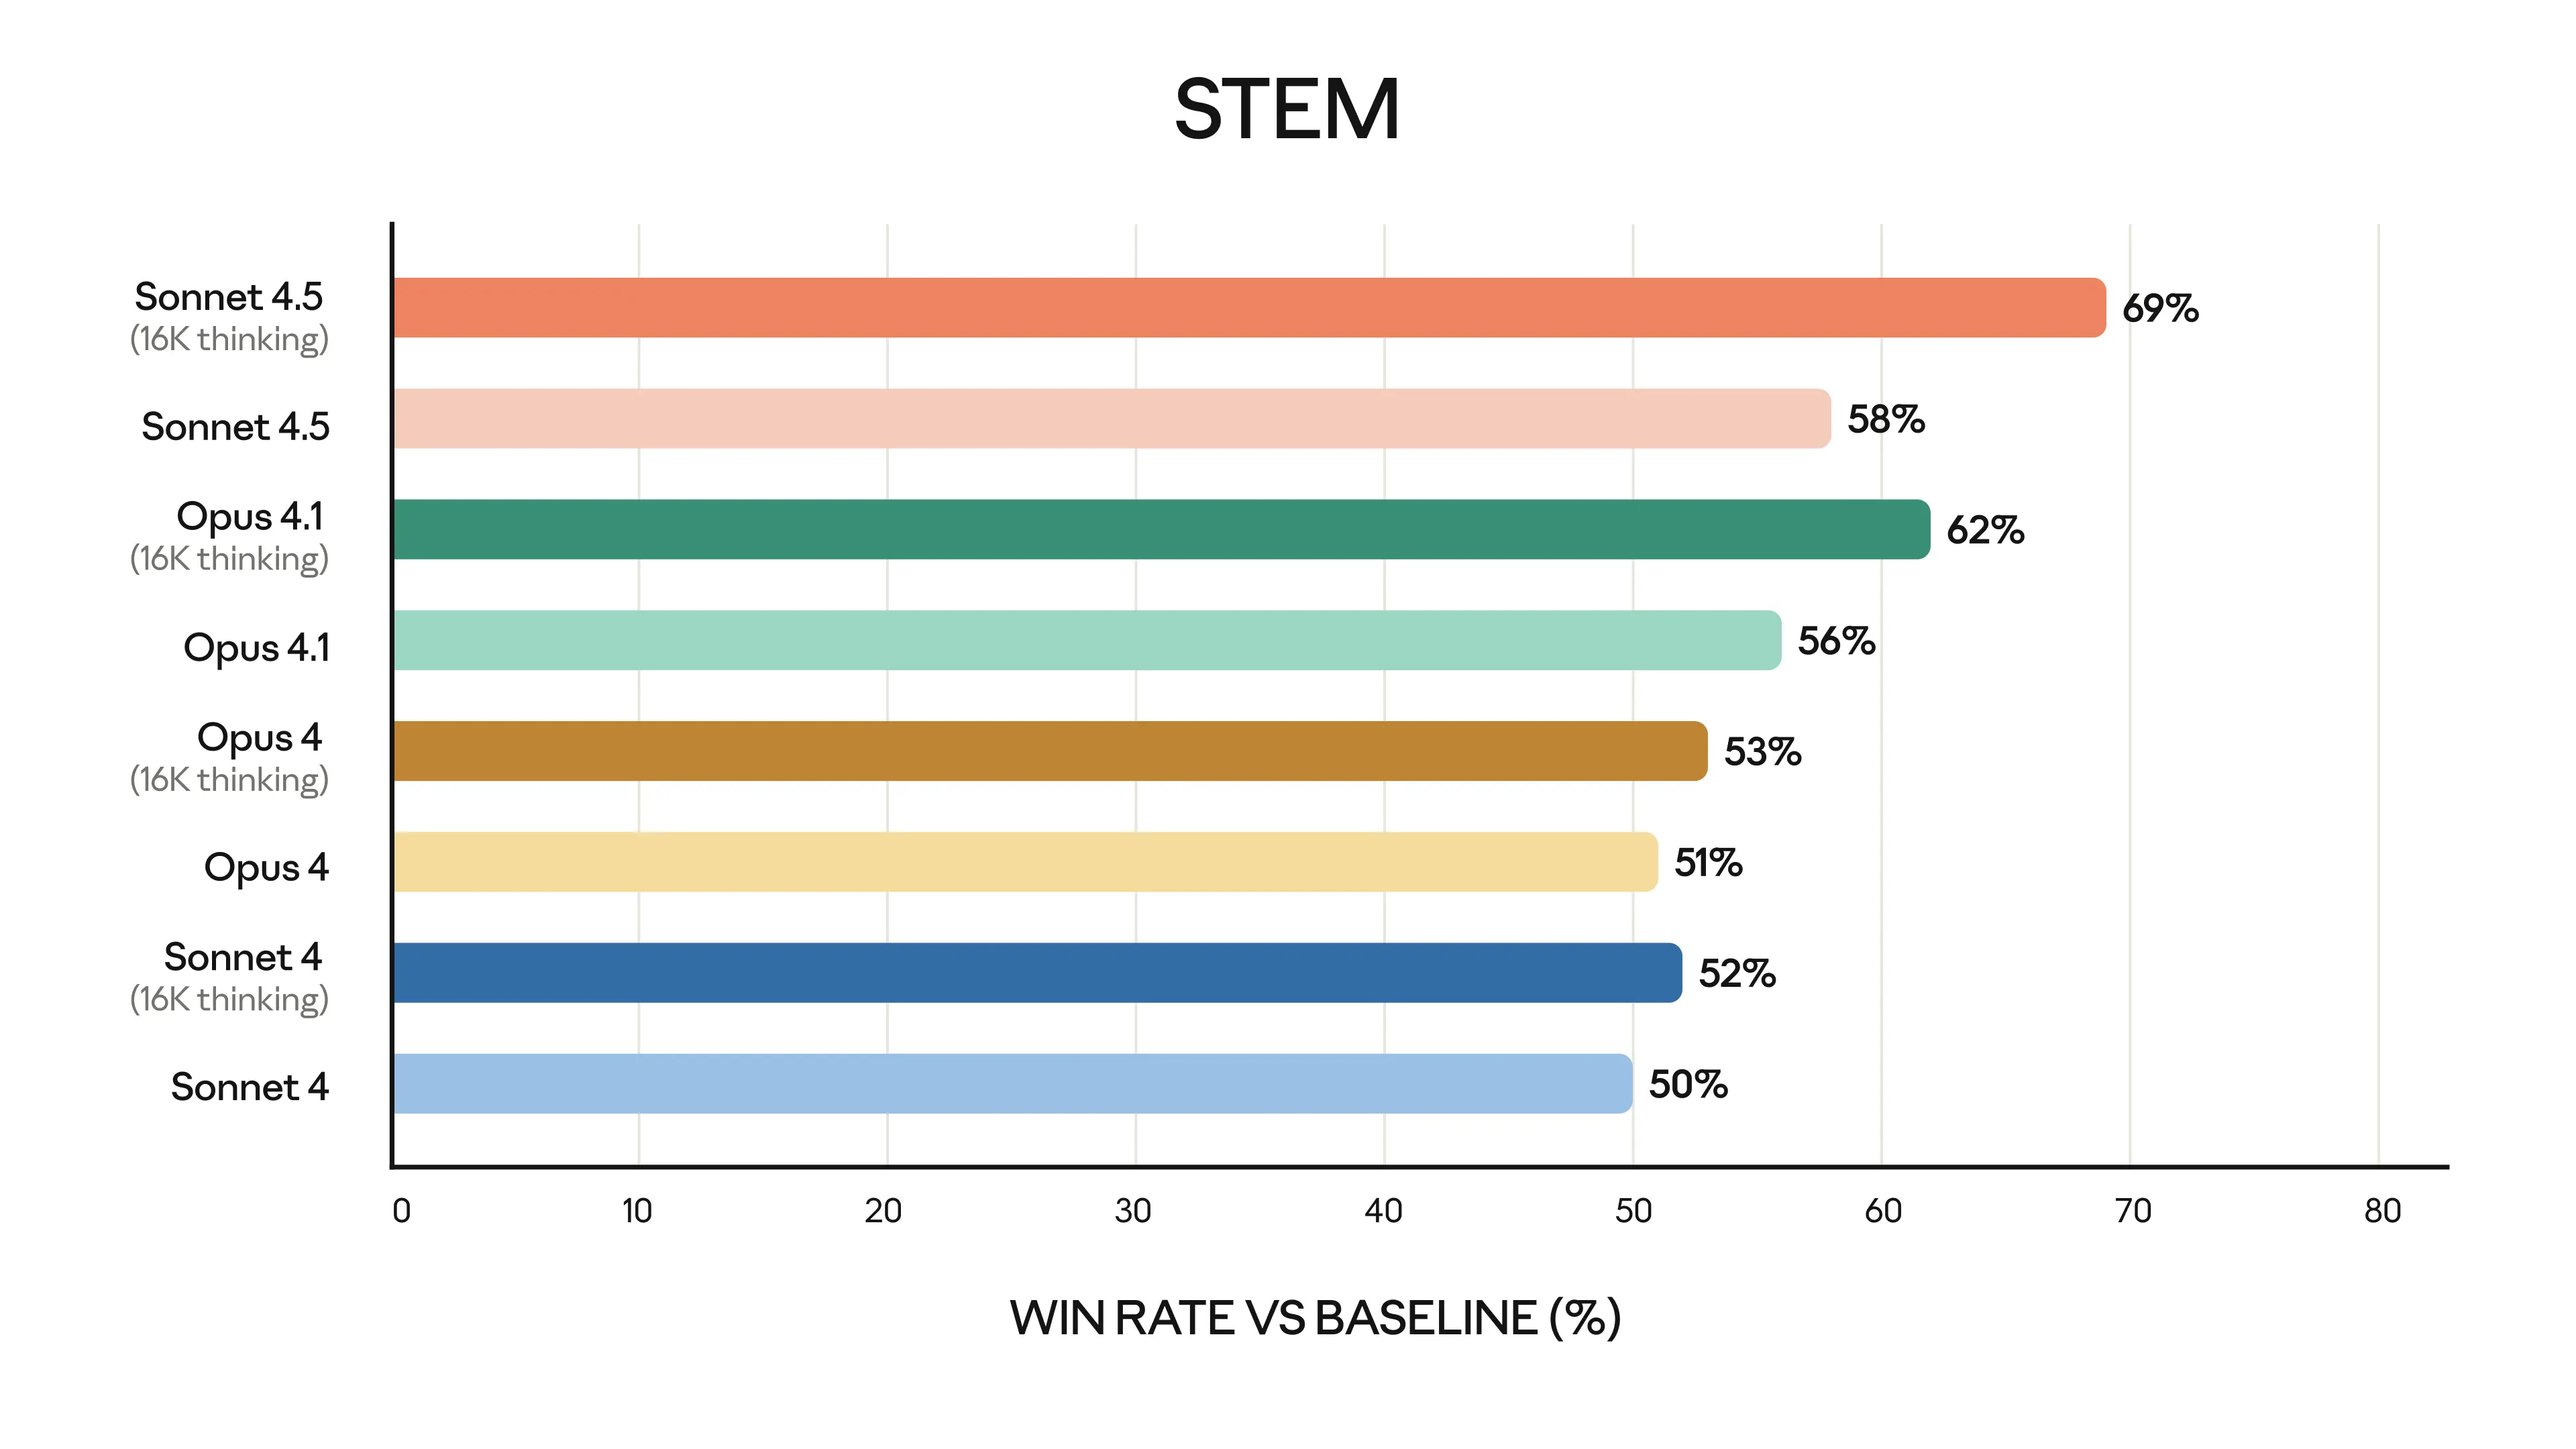
Возможности модели также находят отражение в отзывах первых пользователей:

Мы наблюдаем передовую производительность написания кода у модели Claude Sonnet 4.5 со значительными улучшениями при выполнении задач на долгосрочную перспективу. Это подтверждает, почему многие разработчики, использующие Cursor, выбирают Claude для решения своих самых сложных задач.Майкл Труэлл
Генеральный директор

Claude Sonnet 4.5 усиливает ключевые преимущества GitHub Copilot. Наши первоначальные оценки показывают значительные улучшения в многоэтапных рассуждениях и понимании кода, что позволяет агентным функциям Copilot эффективнее справляться со сложными задачами, охватывающими всю кодовую базу.Марио Родригес
Директор по продукту

Claude Sonnet 4.5 превосходно справляется с задачами разработки программного обеспечения, изучая шаблоны нашей кодовой базы для создания точных реализаций. Модель обрабатывает всё: от отладки до архитектуры с глубоким пониманием контекста, кардинально повышая скорость нашей разработки.Эрик Венделин
Технический руководитель, направление GenAI для продуктивности разработчиков

Claude Sonnet 4.5 сократил среднее время обработки уязвимостей для наших агентов безопасности Hai на 44%, повысив точность на 25%, что помогает нам уверенно снижать риски для бизнеса.Нидхи Аггарвал
Директор по продукту

Claude Sonnet 4.5 задает новый стандарт в решении сложнейших судебных задач. Например, анализ полных циклов брифингов и проведение исследований для подготовки превосходных первых проектов судебных решений или изучение материалов судебных дел для создания детального анализа исковых заявлений.Пабло Арредондо
Вице-президент, CoCounsel

Возможности редактирования у Claude Sonnet 4.5 исключительны — мы перешли от 9% уровня ошибок на Sonnet 4 к 0% в нашем внутреннем бенчмарке редактирования кода. Более высокая успешность использования инструментов при меньшей стоимости — это крупный прорыв в агентном программировании. Claude Sonnet 4.5 идеально балансирует между креативностью и контролем.Микеле Катаста
Президент

Claude Sonnet 4.5 обеспечивает впечатляющий прирост производительности в наших самых сложных задачах с большим контекстом — от разработки в нашей кодовой базе до встроенных функций продукта и исследований. Модель стала заметно умнее, это большой шаг вперёд, который помогает нам расширять возможности дизайна для более чем 240 млн пользователей Canva.Дэнни Ву
Руководитель отдела ИИ-продуктов

Claude Sonnet 4.5 заметно улучшил работу Figma Make во время раннего тестирования, сделав процесс создания промптов и итераций проще. Команды могут исследовать и проверять свои идеи с помощью более функциональных прототипов и плавной интерактивности, сохраняя при этом то качество дизайна, которым славится Figma.Дэвид Коссник
Руководитель отдела ИИ-продуктов

Sonnet 4.5 представляет новое поколение моделей для написания кода. Она удивительно эффективна в максимизации действий на одно окно контекста за счет параллельного выполнения инструментов, например, одновременного запуска нескольких команд bash.Джефф Ван
Генеральный директор

Для Devin модель Claude Sonnet 4.5 повысила производительность планирования на 18%, а итоговые показатели оценок — на 12%: это самый значительный скачок, который мы видели с момента выпуска Claude Sonnet 3.6. Она отлично справляется с тестированием собственного кода, позволяя Devin работать дольше, решать более сложные задачи и выдавать готовый к производству код.Скотт Ву
Соучредитель и генеральный директор

Claude Sonnet 4.5 демонстрирует отличный потенциал для имитации атак (red teaming), генерируя креативные сценарии атак, которые ускоряют изучение методов злоумышленников. Эти идеи усиливают нашу защиту на уровне конечных точек, идентификации, облаков, данных, SaaS и рабочих нагрузок ИИ.Свен Крассер (Sven Krasser)
Старший вице-президент по науке о данных и главный научный сотрудник

Claude Sonnet 4.5 перевертывает наши представления — модель способна выполнять более 30 часов автономного написания кода, позволяя нашим инженерам решать задачи сложнейшей архитектуры за значительно меньшее время и поддерживать согласованность в огромных кодовых базах.Шон Уорд (Sean Ward)
Генеральный директор и соучредитель

Для комплексного финансового анализа — оценки рисков, структурированных продуктов, скрининга портфеля — Claude Sonnet 4.5 с функцией рассуждений обеспечивает аналитические инсайты инвестиционного уровня, требующие меньшего участия человека. Когда глубина важнее скорости, это значительный шаг вперед для институциональных финансов.Стиан Киркеберг (Stian Kirkeberg)
Руководитель отдела искусственного интеллекта и машинного обучения
Наша самая согласованная модель на сегодняшний день
Помимо того, что Claude Sonnet 4.5 — наша самая мощная модель, это еще и наша самая согласованная передовая модель на сегодняшний день. Улучшенные возможности Claude и наше масштабное обучение безопасности позволили нам существенно улучшить поведение модели, уменьшив нежелательные проявления, такие как поддакивание (sycophancy), обман, стремление к власти и склонность поощрять бредовые идеи. Что касается возможностей модели по работе в качестве агента и с компьютером, мы также добились значительного прогресса в защите от атак с внедрением подсказок (prompt injection) — одного из самых серьезных рисков для пользователей этих возможностей.
Подробный набор оценок безопасности и согласованности, который впервые включает в себя тесты с использованием методов механистической интерпретируемости, можно найти в системной карте Claude Sonnet 4.5.
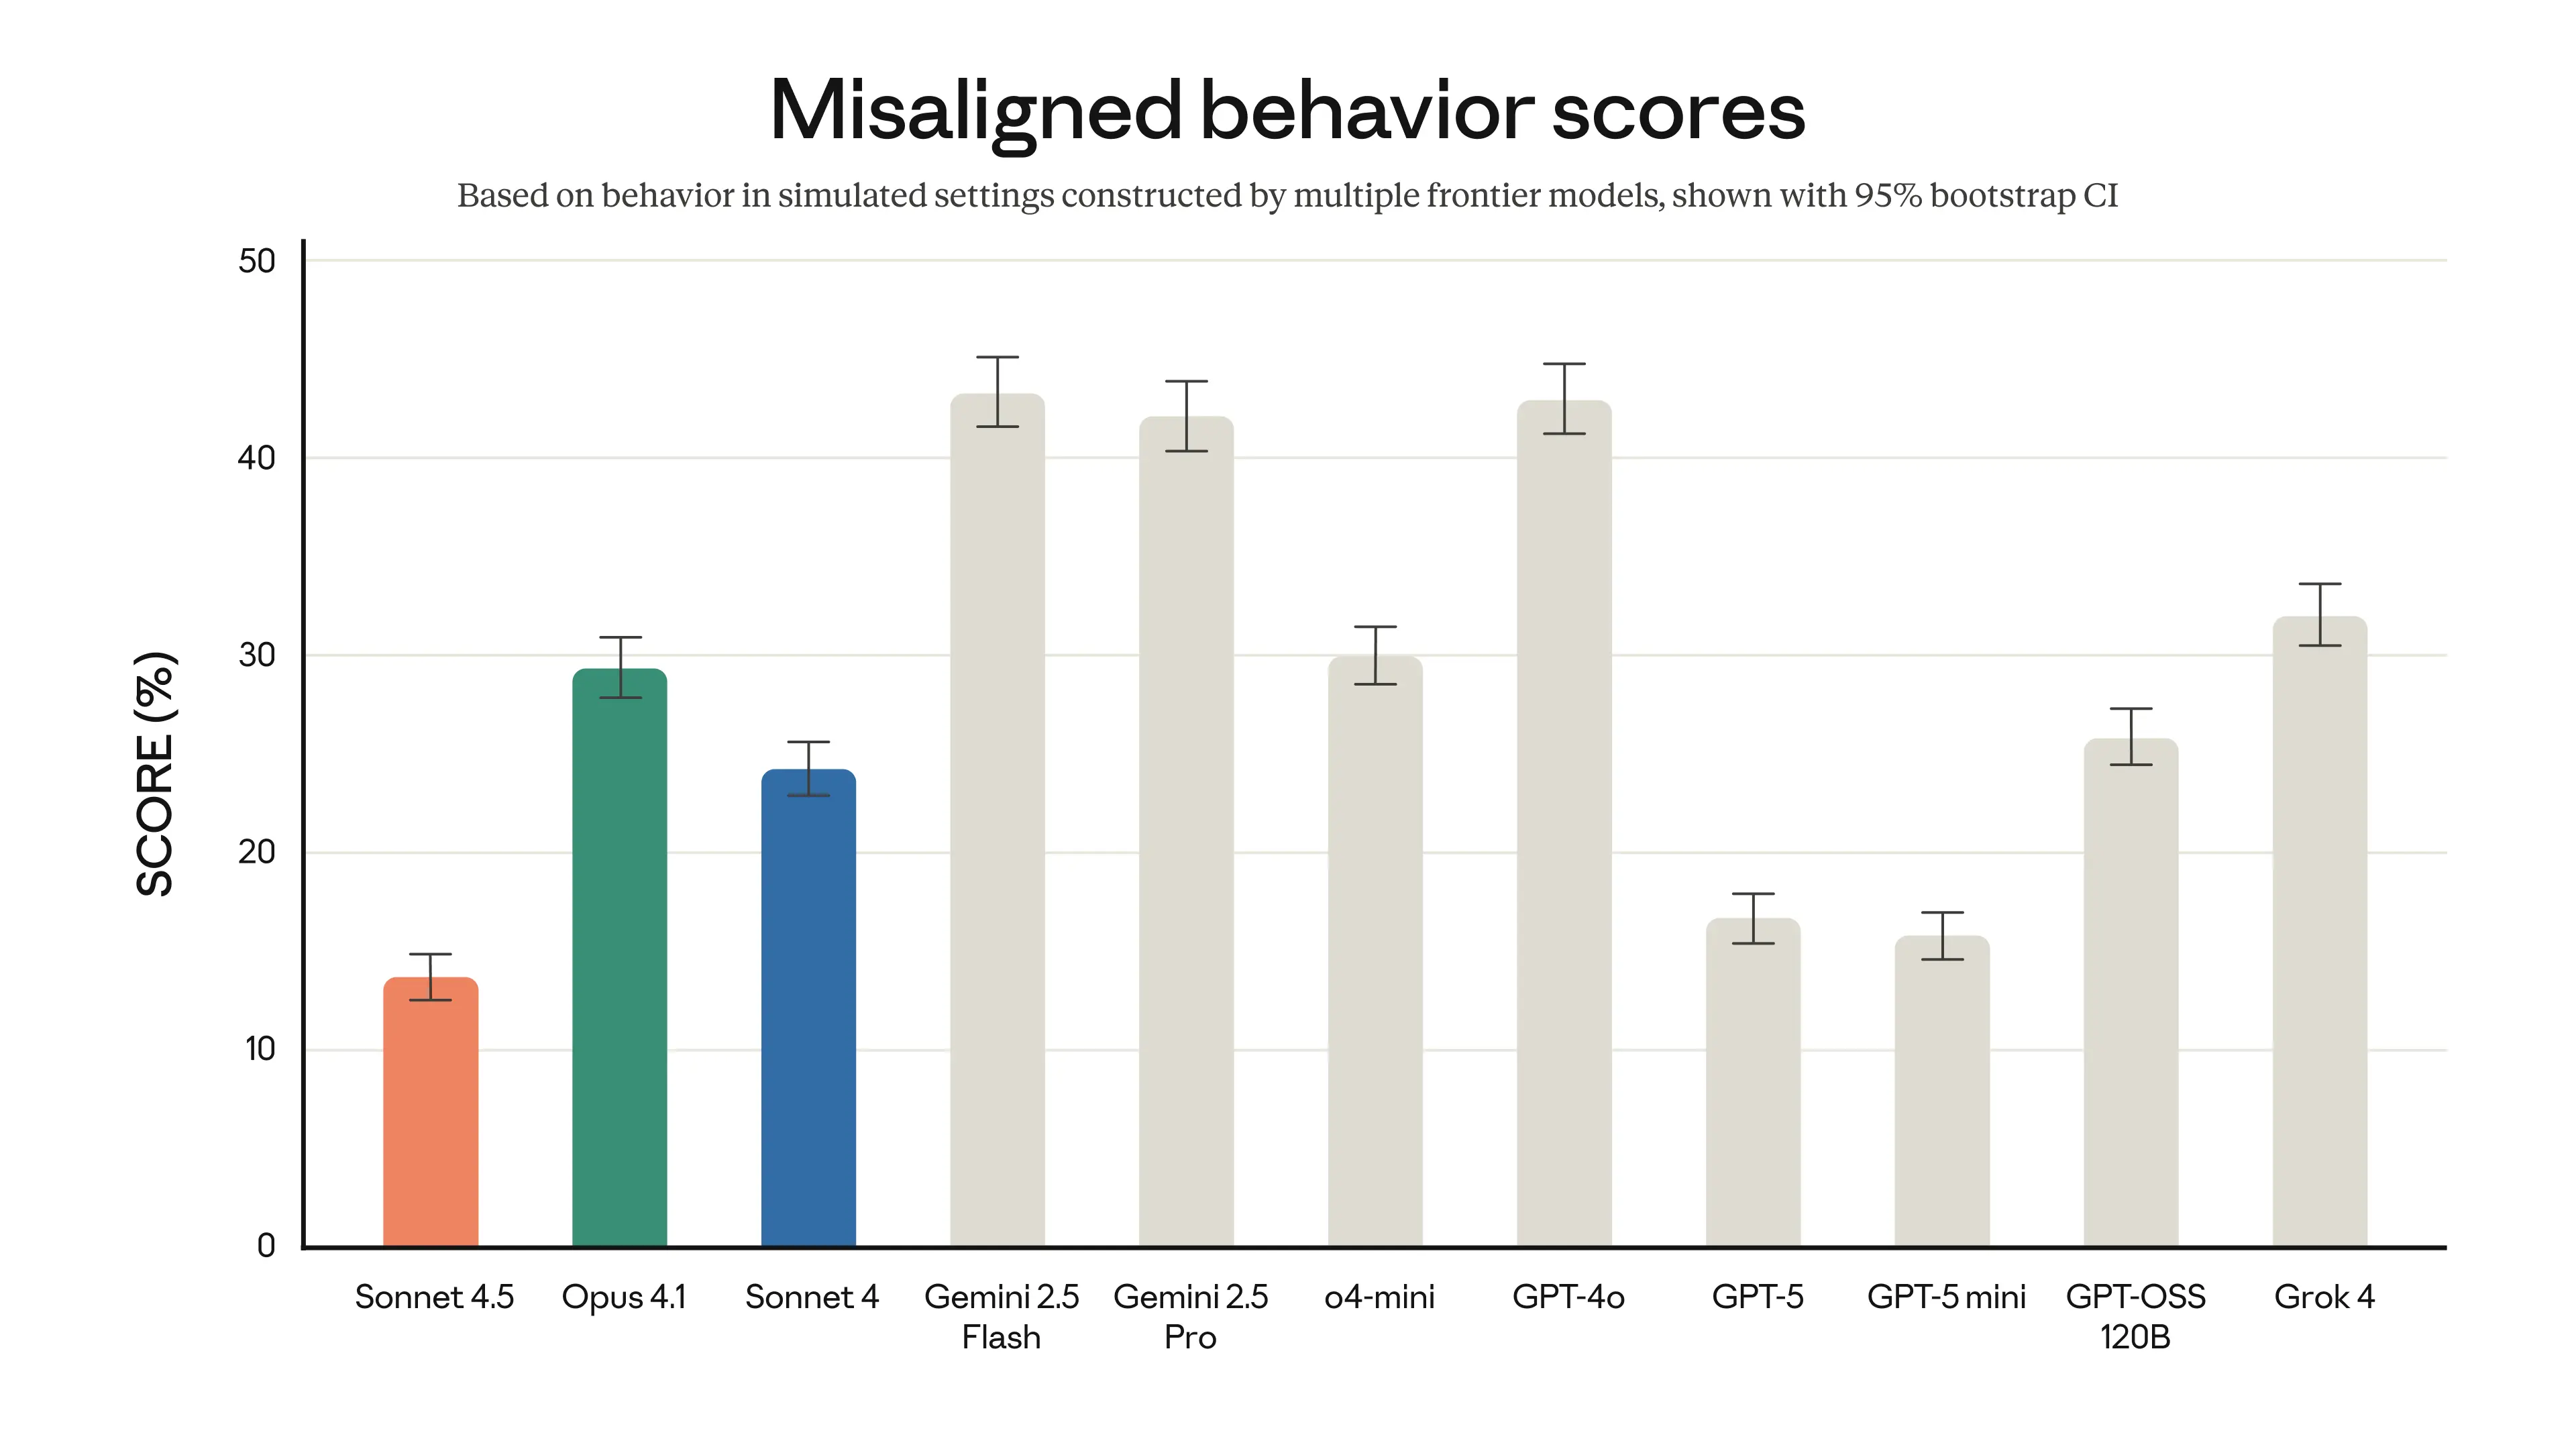 Общие оценки несогласованного поведения от автоматизированного поведенческого аудитора (меньше — значит лучше). К несогласованному поведению относятся (помимо прочего) обман, поддакивание, стремление к власти, поощрение бредовых идей и следование вредоносным системным подсказкам. Более подробную информацию можно найти в системной карте Claude Sonnet 4.5.
Claude Sonnet 4.5 выпускается в рамках наших средств защиты уровня ASL-3 (AI Safety Level 3) в соответствии с нашей концепцией, которая сопоставляет возможности моделей с соответствующими мерами предосторожности. Эти меры включают фильтры, называемые классификаторами, цель которых — обнаруживать потенциально опасные входящие и исходящие данные, в особенности те, которые связаны с химическим, биологическим, радиологическим и ядерным оружием (ХБРЯ).
Эти классификаторы могут иногда непреднамеренно помечать нормальный контент. Мы сделали так, чтобы пользователи могли легко продолжить любые прерванные разговоры с Sonnet 4 — моделью, которая представляет меньший риск, связанный с ХБРЯ. Мы уже добились значительного прогресса в сокращении числа таких ложных срабатываний: их количество уменьшилось в десять раз с тех пор, как мы впервые описали их, и в два раза с момента выпуска Claude Opus 4 в мае. Мы продолжаем работу над тем, чтобы сделать классификаторы более точными1.
Пакет SDK для агентов Claude (Claude Agent SDK)
Мы потратили более шести месяцев на выпуск обновлений для Claude Code, поэтому мы точно знаем, что требуется для создания и проектирования агентов ИИ. Мы решили сложные проблемы: как агенты должны управлять памятью при выполнении долгосрочных задач, как работать с системами разрешений, которые балансируют между автономностью и контролем пользователя, и как координировать субагентов, работающих над общей целью.
Теперь мы делаем все это доступным для вас. Claude Agent SDK — это та же инфраструктура, которая лежит в основе Claude Code, но она демонстрирует впечатляющие преимущества для самых разных задач, а не только для написания кода. Начиная с сегодняшнего дня, вы можете использовать ее для создания собственных агентов.
Мы создали Claude Code, потому что нужного нам инструмента еще не существовало. Agent SDK предоставляет вам ту же основу для создания столь же функционального решения любой стоящей перед вами задачи.
Бонусная исследовательская предварительная версия
Параллельно с Claude Sonnet 4.5 мы выпускаем временную исследовательскую превью-версию под названием «Imagine with Claude».
В этом эксперименте Claude генерирует программное обеспечение на лету. Никакой функционал не предопределен заранее, никакой код не написан заранее. Перед вами Claude, создающий продукт в реальном времени, реагирующий и адаптирующийся к вашим запросам по мере взаимодействия.
Это увлекательная демонстрация возможностей Claude Sonnet 4.5 — способ увидеть, чего можно достичь, объединив мощную модель с правильной инфраструктурой.
Интерфейс «Imagine with Claude» доступен подписчикам тарифа Max в течение следующих пяти дней. Приглашаем вас опробовать его на сайте claude.ai/imagine.
Дополнительная информация
Мы рекомендуем обновиться до Claude Sonnet 4.5 во всех сценариях использования. Независимо от того, используете ли вы Claude через наши приложения, API или Claude Code, Sonnet 4.5 является прямой заменой, обеспечивающей значительно более высокую производительность по той же цене. Обновления Claude Code доступны всем пользователям. Обновления платформы для разработчиков Claude Developer Platform, включая Claude Agent SDK, доступны всем разработчикам. Выполнение кода и создание файлов доступны на всех платных тарифах в приложениях Claude.
Подробные технические сведения и результаты оценки приведены в нашей системной карте, на странице модели и в документации. Дополнительную информацию можно найти в наших инженерных статьях, а также в исследовательской публикации по кибербезопасности.
Сноски
1: Клиенты из индустрий кибербезопасности и биологических исследований могут обратиться к своим командам по работе с клиентами, чтобы тем временем присоединиться к нашему списку разрешенных (allowlist).
Методология
- SWE-bench Verified: Все результаты Claude были получены с использованием простого каркаса (scaffold) с двумя инструментами — bash и редактированием файлов посредством замены строк. Мы заявляем показатель 77,2%, который был усреднен по 10 запускам, без вычислений во время тестирования (test-time compute) и с бюджетом в 200 тыс. токенов на рассуждения (thinking budget) на полном наборе данных из 500 задач SWE-bench Verified.
- В заявленном результате используется небольшое дополнение к подсказке: «Вы должны максимально использовать инструменты, в идеале более 100 раз. Вам также следует сначала реализовать собственные тесты, прежде чем приступать к решению задачи».
- Конфигурация с контекстом в 1 млн токенов обеспечивает 78,2%, но в качестве основного показателя мы указываем результат для 200 тыс., поскольку конфигурация с 1 млн была задействована в наших недавних проблемах с инференсом.
- Для показателей «высоких вычислительных затрат» (high compute) мы применяем дополнительную сложность и параллельные вычисления во время тестирования следующим образом:
- Мы делаем выборку из нескольких параллельных попыток.
- Мы отбраковываем патчи, которые ломают видимые регрессионные тесты в репозитории, аналогично подходу выборочного отсечения (rejection sampling), принятому в Agentless (Xia et al. 2024); обратите внимание, что скрытая информация о тестах не используется.
- Затем мы используем внутреннюю модель оценки для выбора лучшего кандидата из оставшихся попыток.
- Это дает результат 82,0% для Sonnet 4.5.
- Terminal-Bench: Все заявленные баллы получены с использованием стандартного фреймворка агента (Terminus 2) с синтаксическим анализатором XML, при этом усредняются результаты нескольких запусков в разные дни для сглаживания чувствительности оценки к инфраструктуре инференса.
- τ2-bench: Результаты были достигнуты с использованием расширенных рассуждений с применением инструментов и добавлением к подсказке для политики авиа- и телекоммуникационных агентов (Airline and Telecom Agent Policy), предписывающей Claude лучше учитывать известные ему сценарии сбоев при использовании базовой подсказки. Дополнение к подсказке также было добавлено в подсказку пользователя Telecom, чтобы избежать сбоев из-за неправильного завершения взаимодействия пользователем.
- AIME: Результат Sonnet 4.5 заявлен с использованием выборки при температуре 1,0. Модель использовала 64 тыс. токенов рассуждения для конфигурации Python.
- OSWorld: Все заявленные баллы получены с использованием официального фреймворка OSWorld-Verified с максимум 100 шагами, усредненного по 4 запускам.
- MMMLU: Все заявленные баллы представляют собой среднее значение по 5 запускам для 14 языков (не включая английский) с использованием расширенных рассуждений (до 128 тыс.).
- Finance Agent: Все заявленные баллы были получены и опубликованы компанией Vals AI в их публичной таблице лидеров. Все результаты моделей Claude приведены с расширенными рассуждениями (до 64 тыс.), а для Sonnet 4.5 указан режим чередующихся рассуждений (interleaved thinking).
- Все заявленные баллы OpenAI взяты из их публикации о GPT-5, публикации о GPT-5 для разработчиков, системной карты GPT-5 (SWE-bench Verified указан для n=500), таблицы лидеров Terminal Bench (с использованием Terminus 2) и публичной таблицы лидеров Vals AI. Все заявленные баллы Gemini взяты с их веб-страницы модели, из таблицы лидеров Terminal Bench (с использованием Terminus 1) и из публичной таблицы лидеров Vals AI.
Полный текст статьи читайте на Anthropic
