Представляем Claude Fable 5.1 и Claude Mythos 5.1
- Введение
- Новый рубеж производительности
- Научные исследования
- Безопасность
- Claude Mythos 5.1
- Стоимость и доступность
Сентябрь 2026 г.
: Claude: Fable 5.1и Mythos 5.1[1]…Введение[2]…Новый рубеж производительности[3]…Научные исследования[4]…Безопасность, защищенность и согласованность[5]…Claude Mythos 5.1Мы представляем Claude Fable 5.1 и Claude Mythos 5.1. Это самые передовые в мире модели для написания кода и интеллектуальной работы — и их исследовательские возможности дают первое представление о том, как модели ИИ будут способствовать научному прогрессу.
Claude Fable 5.1 и Claude Mythos 5.1 — это одна и та же модель, но с разным уровнем средств защиты. Fable 5.1 доступна широкому кругу пользователей, в то время как Mythos 5.1 доступна только в рамках наших программ доверенного доступа; ее средства защиты специально разработаны для поддержки работы в сфере кибербезопасности и наук о жизни.
Наряду с расширенными возможностями, Fable 5.1 делает важные шаги в ответ на отзывы клиентов о цене, хранении данных и средствах защиты.
Цена. Fable 5.1 будет стоить примерно на 25% дешевле, чем Fable 5 для типичных рабочих нагрузок везде, где использование оплачивается по токенам. Это связано с тем, что мы снижаем цены на чтение из кэша (когда модель считывает входные данные, которые уже были обработаны и сохранены). Для высокоавтономных задач (agentic work) экономия часто будет намного больше — примерно до 45%.
Хранение данных. Наша новая система Enterprise Frontier Safeguards (EFS) предоставляет клиентам полную конфиденциальность (на уровне политики нулевого хранения данных), сохраняя при этом передовые возможности предотвращения неправомерного использования. EFS работает за счет хранения данных в облачной инфраструктуре, полностью контролируемой клиентом, а не Anthropic. Она будет поэтапно предоставляться корпоративным клиентам, начиная с этой осени. До появления EFS подходящие под требования клиенты смогут использовать Fable 5.1 с нулевым хранением данных.
Средства защиты. Мы усовершенствовали наши средства защиты, чтобы сократить количество ложных срабатываний (когда система ошибочно помечает безопасный контент). В сфере кибербезопасности наши новейшие средства защиты блокируют на 60% меньше ложных срабатываний, чем раньше. Отчасти это связано с тем, что Fable 5.1 теперь можно использовать для обнаружения уязвимостей программного обеспечения — хотя и не для разработки эксплойтов к ним. В области биологии мы создали программу доступа, разработанную в партнерстве с правительством США, чтобы обеспечить доступ к расширенным биологическим возможностям Claude Mythos 5.1. Мы планируем открыть набор участников для ученых в ближайшее время.
Новый рубеж производительности
Claude Fable 5.1 устанавливает новый стандарт для программирования, интеллектуальной работы и долгосрочных задач по решению проблем. Приведенные ниже графики показывают, что Fable 5.1 способна демонстрировать гораздо более высокую производительность по сравнению со своим предшественником, Fable 5. При установке уровня усилий «Низкий» (Low) или «Средний» (Medium) Fable 5.1 достигает результатов, аналогичных или превосходящих результаты Fable 5, при значительно меньших затратах. (Обратите внимание, что для Fable 5.1 по умолчанию установлен уровень «Высокий» (High) в Claude Code и «Средний» (Medium) в Claude Cowork и на Claude.ai.)
- Fable 5.1
- Fable 5
Terminal-Bench-Science 0.1: Стандартная ошибка составляет ±3.5–4.5 пункта на модель. В публичной таблице лидеров (3 запуска на задачу, обвязка Claude Code) показатели Claude Opus 5 составляют 30.0%, а Claude Fable 5 — 21.4%; наша установка воспроизводит их на уровне 29.0% и 24.7% соответственно, что находится в пределах погрешности.
- Mythos 5.1
- Fable 5.1
- Mythos 5
Результаты Terminal-Bench 4.0 в зависимости от стоимости (в логарифмической шкале) для каждого уровня усилий. Claude Fable 5.1 и Claude Mythos 5.1 представляют собой одну и ту же базовую модель; разница между ними отражает задачи, в которые вмешивались наши прежние, менее точные средства киберзащиты. Благодаря улучшениям, которые мы вносим в эти защитные механизмы сегодня, мы ожидаем, что разница между моделями станет значительно меньше.
- Fable 5.1 (с инструментами)
- Fable 5.1 (без инструментов)
- Fable 5 (с инструментами)
- Fable 5 (без инструментов)
Оценки теста «Последний экзамен человечества» по стоимости (в логарифмической шкале) для каждого уровня усилий. Оценки CursorBench 3.2.0 по стоимости (в логарифмической шкале) для каждого уровня усилий.
- Fable 5.1
- Fable 5
CursorBench 3.2.0 по стоимости (логарифмическая шкала) при каждом уровне усилий.
Fable 5.1 избегает обходных путей, которые приводят к снижению качества работы, и обладает достаточной интеллектуальностью для устранения первопричин программных сбоев. Например, в ходе тестирования инвестиционной фирмой Millennium модель Fable 5.1 обнаружила причину редкого сбоя в своих внутренних системах, которую никто из ее инженеров (или других моделей) не мог объяснить после нескольких лет попыток.
Здесь вы можете увидеть, как Fable 5.1 выглядит в сравнении на различных бенчмарках:
| Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol | |
|---|---|---|---|---|
| Автономные научные исследованияTerminal-Bench-Science 0.1 [1] | ||||
| Автономные научные исследованияTerminal-Bench-Science 0.1 [1] | 52.6% | 24.7% | 29.0% | 22.4% |
| Автономное программированиеTerminal-Bench 4.0 | ||||
| Автономное программированиеTerminal-Bench 4.0 | 55.8%60.9% (Mythos 5.1) | 42.0% | 52.3% | 37.3% |
| Интеллектуальная работаGDPval-AA v2 | ||||
| Интеллектуальная работаGDPval-AA v2 | 1853 | 1723 | 1824 | 1711 |
| Использование компьютераOSWorld 2.0 [2] | ||||
| Использование компьютераOSWorld 2.0 [2] | 77.9%частично | 72.9%частично | 75.4%частично | —частично |
| Использование компьютераOSWorld 2.0 | ||||
| Использование компьютераOSWorld 2.0 | 41.7%строго | 36.1%строго | 39.6%строго | —строго |
| Междисциплинарные рассужденияHumanity’s Last Exam | ||||
| Междисциплинарные рассужденияHumanity’s Last Exam | 60.9%без инструментов | 57.8%без инструментов | 56.6%без инструментов | —без инструментов |
| 65.0%с инструментами | 63.8%с инструментами | 63.6%с инструментами | —с инструментами | |
| Бизнес-процессыAutomationBench | ||||
| Бизнес-процессыAutomationBench | 31.4% | 17.1% | 26.9% | 19.6% |
| Автономное программированиеCursorBench 3.2.0 | ||||
| Автономное программированиеCursorBench 3.2.0 | 73.4% | 70.5% | 70.0% | 67.2% |
Наши партнеры, получившие ранний доступ к модели, заметили этот прирост производительности, а также обратили внимание на более качественные улучшения в результатах работы модели. Вот что они нам рассказали:
1 из 22
Вперед«По результатам внутренних бенчмарков, Claude Fable 5.1 успешнее справляется с нашими задачами по программированию, чем Fable 5 или Opus 5, и демонстрирует передовые результаты в торговой интуиции. Если предыдущие модели начинали путаться при длительной работе, то Fable 5.1 сохраняет читаемость даже в длинных многошаговых задачах».
«Мы переводим наш трафик Opus 5 в Devin на Claude Fable 5.1 в день запуска. В ходе тестирования она не уступила или даже превзошла Fable 5 при более низкой стоимости за задачу, а благодаря новой цене за чтение кэша модель класса Fable наконец-то стала экономичной для рабочих нагрузок, которые мы раньше оставляли на Opus, начиная с код-ревью».
«В определенном фрагменте кода содержался крайне редкий сбой — примерно один на миллион запусков, — который никто в нашей команде не мог объяснить на протяжении 4–5 лет. Каждая опробованная мной модель, включая Fable 5, упускала его. Claude Fable 5.1 первой обнаружила его. Она декомпилировала библиотеку стороннего производителя, сопоставила ее с дампом памяти и проследила причину сбоя до бага в этой библиотеке. Затраты времени на проведение такого анализа трудно оправдать».
«Claude Fable 5.1 создала сложный прототип примерно за три дня. Она провела первичный анализ кода и документации всех наших сервисов для разработки нового и расширяемого дизайна. Затем она работала в течение нескольких часов без присмотра, используя мощные циклы верификации, чтобы реализовать весь прототип. Я просыпался утром и видел завершенный следующий этап с полным визуальным обзором созданного и четкими доказательствами ее успеха».
«Это дружелюбная Fable. Интеллект уровня Fable, цена уровня Opus, скорость Sonnet. В наших тестах она работала примерно в два раза быстрее Opus 5 и использовала вдвое меньше токенов, так что для любого, кто привык использовать Opus в качестве основной рабочей лошадки, это очевидный апгрейд».
«В нашем наборе исследовательских тестов Claude Fable 5.1 установила новые рекорды. В одной из задач она предложила новое решение в совершенно иной плоскости, чем мы видели от других моделей или человеческих исследователей в прошлом, что вывело ее результаты далеко за пределы предыдущего плато. Она лучше справляется с творческим решением проблем и поиском озарения, необходимого для решения сложной задачи».
«В рамках нашей постоянной оценки моделей ИИ Claude Fable 5.1 показала впечатляющие результаты в тестах. Используя Claude Code, она безошибочно определяла первопричину каждой сломанной сборки, которую мы тестировали, при всех уровнях усилий. Она также коммуницирует эффективнее предыдущих моделей Anthropic, предлагая более лаконичные и понятные обновления».
«Мы попросили Claude Fable 5.1 проанализировать проект клинических исследований для Rakuten Medical, который до этого одобрили три другие передовые модели. Она нашла упущение, которого никто из них не заметил, и настояла на его дополнительном тестировании. Затем она выдвинула совершенно новую гипотезу, превратив заброшенный набор данных в новое направление исследований всего за один полдень. Впервые передовая модель вроде Claude позволила нам исследовать новые направления в таком ключе».
«Claude Fable 5.1 очень умна. В ходе нашего 30-дневного симуляционного тестирования бизнес-процессов, где модель получает полный доступ к симулированным инструментам, клиентам, сотрудникам и поставщикам Square, она оказалась гораздо эффективнее в расчете на один токен, чем Opus 5. Мы планируем использовать ее для работы с нашими самыми сложными сценариями — теми, которые раньше требовали дней обсуждений у белой доски, чтобы наши инженерные команды могли продолжать двигаться быстро».
«Для любых исследовательских, новых или долгосрочных задач я бы определенно использовал Claude Fable 5.1 в качестве оркестратора. 38-часовой автономный запуск над проблемой машинного обучения позволил диагностировать предыдущий результат как артефакт разметки, внести исправления, запустить шесть параллельных экспериментов, работавших всю ночь, и вернуться с результатом и дальнейшими шагами. Получив открытый промпт найти наиболее перспективную проблему, которой никто не занимался, она обнаружила ничейное оповещение, связанное с производственным сбоем, выгрузила логи и предложила исправление».
«Главное достоинство Claude Fable 5.1 — это текст: он более понятный, содержательный и лучше следует нашим рекомендациям по письму. В слепых тестах по сравнению с Fable 5 я предпочел ее тексты и результаты. А в Canva Code она создала ритм-игру с настоящей музыкой и геймплеем под бит, соответствующим сгенерированному уровню, — такого не смогла предоставить ни одна другая протестированная нами модель».
«В нашем тестировании PowerPoint Claude Fable 5.1 создала лучшие презентации среди всех протестированных нами моделей — как с точки зрения дизайна слайдов, так и полноты раскрытия исследовательской темы. Такая же полнота проявилась в нашем тесте Citations, где она показала лучшее извлечение фактов из финансовых документов. А в сложных многосоставных вопросах это первая модель, которая отвечает на каждую часть».
«У нас было изменение, затрагивающее более восьми сервисов в трех кодовых базах. Claude Fable 5.1 сопоставила весь рабочий процесс от начала до конца в мельчайших деталях: от входящего вызова службы до отдельной функции, таблиц и строк базы данных, и все было абсолютно точным. Мы ценим возможность протестировать модель и оставить отзыв, помогая нам подготовиться к новому рубежу, где мы сможем все больше полагаться на эти инструменты для реализации более смелых инициатив».
«Во всех наших оценочных наборах судьи отдавали предпочтение ответам Claude Fable 5.1 примерно 2 к 1 по сравнению с Fable 5 в вопросах повседневных знаний, целенаправленных исследований, составления чертежей и артефактов, причем с улучшенной привязкой ответов к фактам по сравнению с Fable. Благодаря этим результатам Fable 5.1 стала нашей основной рекомендацией везде, где ранее выбиралась Fable 5».
«В решении самых сложных задач Claude Fable 5.1 сильно отрывается от любой другой опробованной нами модели. В задаче уровня грандиозного вызова, которую мы использовали в качестве полигона в течение 18 месяцев, она действительно добилась ощутимого прогресса. Вместо того чтобы застрять в коллекционировании марок, она установила четкие логические связи, которых я еще не видел нигде больше. Она также оптимизировала вычислительный кернел, на котором Fable 5 исчерпала свой потенциал, примерно на 35%».
«В нашем самом сложном бенчмарке для браузерных агентов Claude Fable 5.1 успешно выполнила 82% задач примерно за 10 минут каждая, по сравнению с 74% у Opus 5 и 57% у Fable 5, при этом используя меньше токенов, чем любая из них. Она кажется сильнее Fable 5 во всех тестируемых аспектах. Кроме того, она выполняла ровно тот объем работы, который требовался: ни разу не перешла критическую точку остановки за сотни измеренных задач».
«В нашем внутреннем финансовом бенчмарке Claude Fable 5.1 не уступает Fable 5 по точности, расходуя на 20% меньше токенов. Мы также увидели большой прогресс в генерации слайдов: Fable 5.1 демонстрирует улучшение в объяснении сложных данных простым английским языком и преобразовании их в более качественную визуализацию банковского уровня».
«Claude Fable 5.1 комфортнее справляется с долгой автономной работой, чем Fable 5. Мои рабочие процессы выполнялись в течение долгого времени, не теряя сути: модель ведет собственные записи, перераспределяет приоритеты по мере изменения условий и продолжает работу с того места, где остановилась».
«По сравнению с Fable 5, Claude Fable 5.1 продемонстрировала колоссальный прогресс в RedlineBench — нашем бенчмарке для редактирования договоров, поднявшись с 47,9 до 57,0 балла. Большая часть прироста пришлась на качество с первой итерации, где она удвоила предыдущий результат, а также на существенное повышение уровня принятия контрагентами. Ее правки стали более краткими, а изменения в документах в среднем — меньше».
«Claude Fable 5.1 — ведущая модель для наших тестов по расследованию инцидентов, в которых используются реальные производственные инциденты для оценки эффективности работы нашего агента Bits Investigation при подготовке анализов первопричин. Мы оцениваем результаты работы агента на основе первопричин, выявленных нашими инженерами. В ходе этих тестов модель продемонстрировала более сильные способности к рассуждению, чем Opus 5, и успешно диагностировала самые сложные производственные инциденты из тех, что мы тестировали».
«Claude Fable 5.1 — самая способная модель из всех, что мы запускали на CursorBench 3.2, набрав 73,4% при максимальных усилиях. Мы обнаружили, что она особенно искусна в проверке собственной работы, что позволяет ей решать сложные задачи по программированию от начала до конца».
«Мы оцениваем модели и системы на основе реальных рабочих процессов инвесторов. В FrontierFinance, нашем новейшем финансовом бенчмарке, Claude Fable 5.1 показывает явный прирост по сравнению с Fable 5: оценка по критериям составляет 55.9% против 49.2%. Прирост достигается за счет ее способности глубже погружаться в проверенные, авторитетные источники: по одному из вопросов о доходах она сразу перешла к стенограмме звонка и зафиксировала точные цифры, названные руководством, в то время как другие модели полагались на вторичные обзоры».
Научные исследования
Мы протестировали возможности моделей Claude Fable 5.1 и Claude Mythos 5.1 в области научных исследований в самых разных дисциплинах. Полученные нами результаты, включая первые примеры, представленные ниже, пополняют копилку доказательств того, что модели ИИ вскоре внесут важный вклад в научные открытия.
Молекулярный дизайн. Многие современные лекарства работают за счет связывания с мишенями в организме для их блокирования, активации или доставки к ним определенных веществ. Высокоаффинные связывающие агенты необходимы для того, чтобы препараты работали в более низких дозах; их разработка является первым этапом процесса создания многих распространенных типов лекарств. Чтобы проверить, насколько хорошо Claude Mythos 5.1 справляется с этой задачей, мы предоставили модели доступ к инструментам проектирования и фолдинга белков с открытым исходным кодом и передали ее разработки в две сторонние организации для экспериментальной проверки. Модель Mythos 5.1 продемонстрировала способность создавать высокоаффинные связывающие агенты. Для трех мишеней [3] аффинность связывания оказалась в 10 раз выше, чем у лучших разработок, представленных на конкурсах по дизайну белков компании Adaptyv Bio. Коэффициент успешности модели (то есть доля жизнеспособных связывающих агентов) оказался самым высоким из всех зарегистрированных нами на сегодняшний день: он достиг почти 50% по 12 мишеням. (В настоящее время в сфере дизайна белков типичным считается показатель в 10–15%).
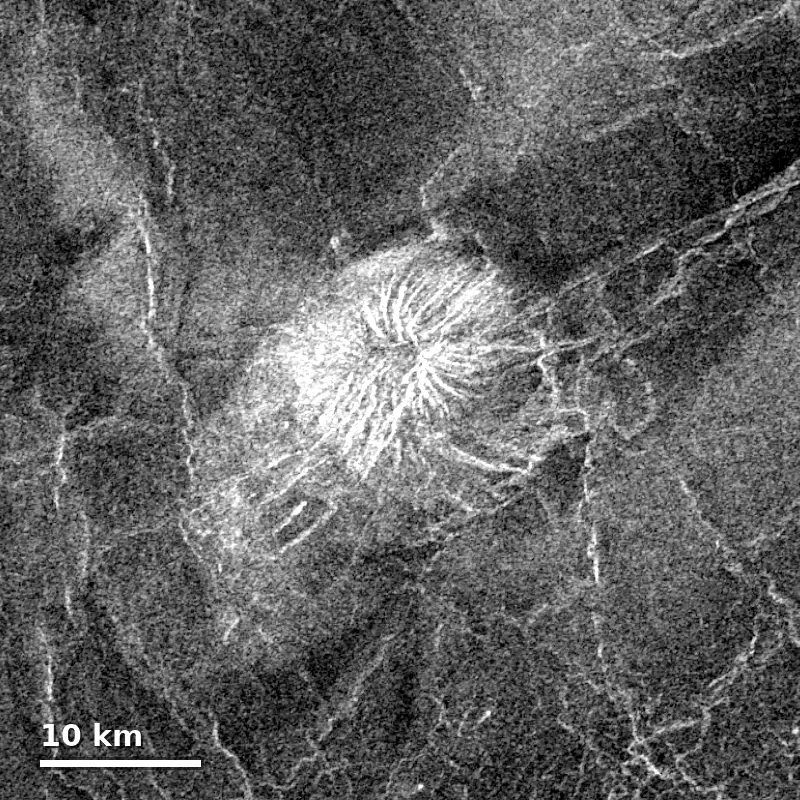
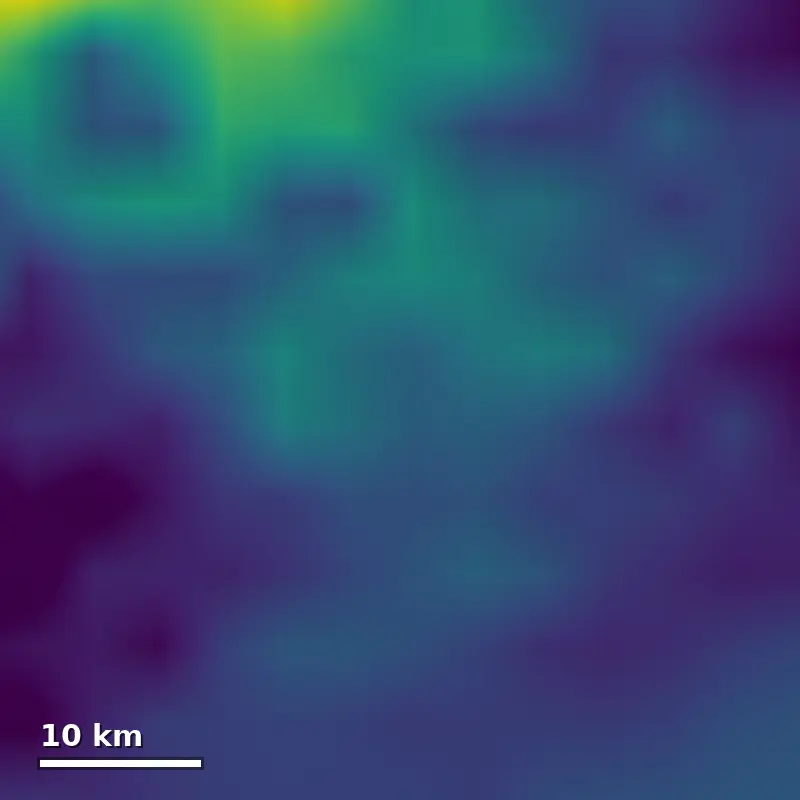
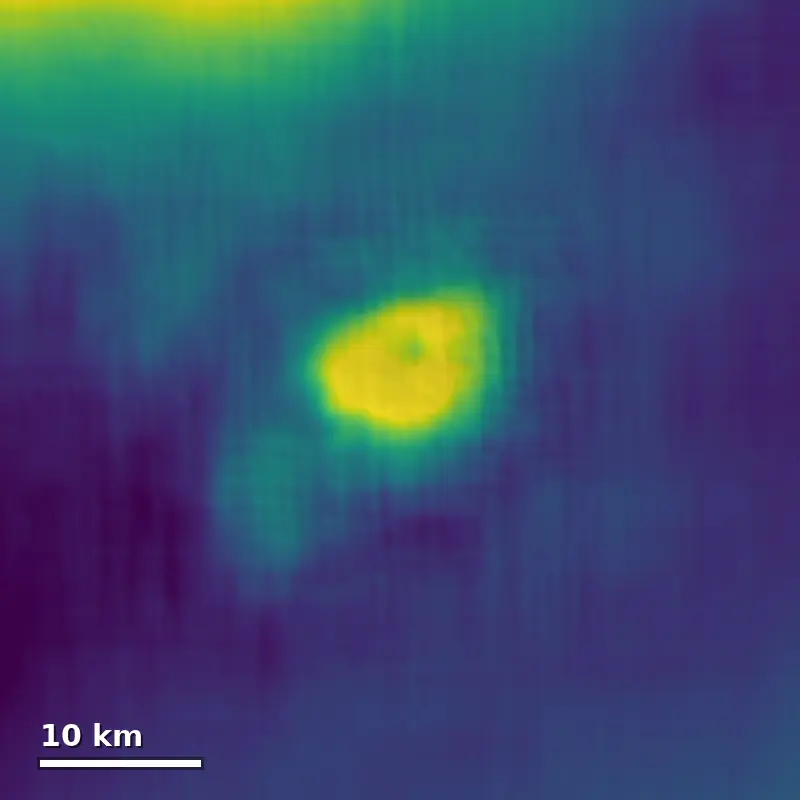
Вычислительный анализ и моделирование. Claude Fable 5.1 обучила нейросеть созданию новой высотной карты высокого разрешения для трети планеты Венера. Работа основывалась на радарных снимках, полученных аппаратом NASA Magellan более 30 лет назад, а также на карте, которая уже охватывала одну пятую часть планеты. Новая карта от Claude детализирует поверхность с точностью до двух-трех километров (вместо прежних 10–20) и отображает высоты на 25% точнее, чем раньше.
Мы публикуем эту карту по лицензии Creative Commons в преддверии грядущих миссий NASA VERITAS и ESA EnVision в надежде, что она поможет ученым определить геологические объекты для дальнейших наблюдений.
Вычислительная биология. В вычислительной биологии принято запускать специализированные модели машинного обучения на графических процессорах (GPU). Из-за этого скорость работы таких моделей становится узким местом для прогресса исследований. Модель Mythos 5.1 предложила решение этой проблемы: написав кастомные ядра для GPU и кэшируя их промежуточные результаты, она ускоривила работу семи моделей глубокого обучения с открытым исходным кодом до 2,5 раз (с сохранением идентичных результатов).
Преимущества такого ускорения накапливаются быстро. В ходе типичного эксперимента биологи могут запускать эти модели тысячи раз (например, тестируя каждую возможную мутацию рядом с каждым геном человека). При подобных анализах оптимизированные модели сокращают расчетные затраты на GPU на 30–60%. Обычно на такой уровень оптимизации у команды инженеров по производительности уходят недели, что часто оказывается не по карману академическим лабораториям. Модель Mythos 5.1 справилась с этой задачей всего за несколько дней, используя лишь общедоступный исходный код. Вскоре мы планируем открыть исходный код этих оптимизаций.
Ускорение инференса для семи моделей белков и геномики с открытым исходным кодом на NVIDIA H100
- Исходная реализация
- Оптимизированная
Оценка затрат на GPU для трех общегеномных анализов до и после оптимизации по прейскурантным ценам в облаке. Модель Evo 2 40B обеспечивает большую экономию на всей задаче в целом (в 2,3 раза), чем за один прямой проход (в 1,4 раза), поскольку некоторые из ее оптимизаций окупаются только при работе с большим количеством последовательностей.
По мере совершенствования научных возможностей наших моделей растут и наши инвестиции в научный прогресс. На прошлой неделе мы представили предварительную версию аппаратного стандарта для моделей (Model Hardware Standard), который позволяет Claude напрямую и безопасно управлять лабораторным оборудованием. Мы также недавно расширили поддержку ученых в рамках нашей программы ИИ для науки (AI for Science), которая предоставляет бесплатные кредиты исследователям, работающим над имеющими важное значение научными проектами, а также предлагаем значительно сниженные цены на использование в рамках нашего нового тарифного плана Claude Team для ученых.
Безопасность, защищенность и согласованность
За последние два года агентные возможности моделей ИИ стали значительно мощнее. Но, как мы уже отмечали, большая автономность сопряжена с новыми рисками. Работа над безопасностью, защищенностью и согласованностью должна идти теми же темпами, что и развитие возможностей ИИ. Вчера мы опубликовали отчет, в котором рассказали о том, как мы совершенствуем собственные методы обеспечения согласованности и безопасности.
Перед выпуском Claude Fable 5.1 и Claude Mythos 5.1 мы (а в некоторых случаях и внешние исследователи) подвергли модели обширному тестированию на предмет рисков в самых разных областях. Мы подробно описываем эту работу в нашей системной карте (System Card); ниже приводится краткая сводка.
Химические и биологические риски. Мы проверили, в какой степени Claude Mythos 5.1 может помочь в создании химического или биологического оружия. Это включало экспертное «красное тестировние» (red-teaming), автоматизированные оценки и командно-штабные учения, в которых биологи с докторской степенью работали в паре с экспертами по ИИ, проверяя, смогут ли модели сравняться по эффективности с людьми-специалистами. Возможности Mythos 5.1 выше, чем у Mythos 5. Однако наши оценки показывают, что модель все еще не дотягивает до следующего уровня риска, определенного в нашей политике ответственного масштабирования (Responsible Scaling Policy). Поэтому мы развертываем Mythos 5.1 с теми же мерами защиты, которые применялись к Mythos 5 и которые ограничивают доступ к возможностям в области исследований живой природы.
Киберриски. Мы провели серию оценок для проверки кибервозможностей Claude Mythos 5.1 (при отключенных средствах защиты от киберугроз). В целом модель демонстрирует самые мощные кибернетические возможности среди всех выпущенных нами моделей, хотя она все же попадает в более низкую категорию риска в рамках нашей платформы обеспечения соответствия передовым требованиям (Frontier Compliance Framework). Мы также провели масштабное стресс-тестирование наших средств защиты от киберугроз для Fable 5.1: в дополнение к собственной динамической оценке их надежности мы заказали независимое тестирование двум организациям, а также провели автоматизированное тестирование с помощью Gray Swan. Как и в случае с Fable 5 и Opus 5, мы не обнаружили признаков критического джейлбрейка для этих защитных механизмов.
Агентная безопасность. Мы оценили то, как Claude Mythos 5.1 реагирует на вредоносные запросы и инъекции промптов (состязательные инструкции, скрытые внутри контента, обрабатываемого моделями ИИ). Модель отказывала в выполнении вредоносных запросов на написание агентного кода и использование компьютера с частотой, сопоставимой с Mythos 5, Sonnet 5 и Opus 5, и на сегодняшний день является нашей наиболее устойчивой моделью по результатам внешнего бенчмарка устойчивости к инъекциям промптов.
Согласованность (Alignment). Мы проверили поведение модели с помощью статических и интерактивных поведенческих оценок, анализа ее внутреннего хода мысли с использованием автоэнкодеров естественного языка, оценок возможностей, связанных с нарушением согласованности, проверки наших обучающих данных и анализа результатов нашего внутреннего пилотного использования. Мы также получили отчеты по результатам внешнего тестирования.
Наш автоматизированный аудит поведения показал, что Claude Mythos 5.1 лучше согласована по большинству метрик, чем ее предшественница, Mythos 5. Модель значительно реже, чем Mythos 5, пытается получить доступ к ресурсам за пределами своей тестовой среды при выполнении в остальном невыполнимой задачи. Она также реже использует мотивационное рассуждение для оправдания своих действий (например, рассуждая о том, что ситуация является симуляцией или проверкой), и с меньшей вероятностью игнорирует явные ограничения ради достижения целей пользователей. Судя по нашему анализу обучающих данных, Mythos 5.1 реже пытается заниматься хакингом наград (или читерством) и реже добивается в этом успеха по сравнению с Mythos 5.
Хотя в целом наши оценки согласованности показали улучшения, тестирование выявило, что модель все же может иногда обходить одобрения и классификаторы авторежима (подробнее об этом мы говорим в нашей системной карте). Кроме того, существуют ограничения в отношении полноты покрытия нашей оценки согласованности. В настоящее время наш автоматизированный поведенческий аудит обеспечивает меньшую видимость при работе с очень длинным контекстом и в условиях множественных агентов. У нас также меньше возможностей для анализа невыполнимых задач (которые могут вызывать более аномальное и несогласованное поведение), чем хотелось бы, хотя недавно мы добились улучшений в этой области и продолжаем активно работать над этим.
Мы также усовершенствовали наши защитные механизмы, чтобы наши модели приносили больше пользы без ущерба для безопасности. Ниже мы описываем эти изменения.
Автоматизированные средства защиты для корпоративных клиентов. Функция Enterprise Frontier Safeguards (EFS) позволяет нам выявлять случаи ненадлежащего использования наших моделей и реагировать на них, обеспечивая при этом нашим корпоративным клиентам конфиденциальность в рамках соглашения об отсутствии хранения данных (zero data retention). С помощью EFS клиенты хранят свои данные на собственной облачной инфраструктуре, а не в системах Anthropic; любая проверка человеком по умолчанию осуществляется самими клиентами, а не компанией Anthropic. Мы разработали EFS в тесном сотрудничестве с более чем 100 клиентами из таких отраслей, как финансовые услуги, здравоохранение, производство, телекоммуникации, юриспруденция, розничная торговля и государственный сектор, а также с нашими облачными партнерами из Amazon Web Services, Google Cloud и Microsoft Azure.
EFS будет поддерживаться в Claude Code, Claude Enterprise, на платформе Claude Platform, в Amazon Bedrock, на платформе Claude Platform в AWS, на платформе Google Agent Platform и в Microsoft Foundry. Функция внедряется поэтапно, начиная с этой осени. Как отмечалось выше, клиенты, имеющие право на использование EFS, могут работать с Fable 5.1 (и Fable 5) без сохранения данных до тех пор, пока EFS не будет готова. Подробнее об EFS можно прочитать здесь; чтобы запросить доступ, пожалуйста, заполните эту форму.
Более точные средства защиты в области биологии и кибербезопасности. За последние несколько месяцев мы добились успехов в повышении точности наших средств защиты для Fable 5.1: мы свели к минимуму вероятность ложного срабатывания на безопасный контент (например, на запросы, касающиеся медицинских проблем, или специалистов по киберзащите, использующих модель для повышения безопасности своих систем), гарантируя при этом надежную защиту от реальных угроз.
Как мы недавно сообщали, наши новейшие средства биологической защиты для Fable 5.1 и Fable 5 срабатывают на 85% реже при обработке безопасных запросов, связанных с базовой биологией и медицинскими вопросами (по сравнению с версиями, выпущенными вместе с Fable 5). Однако запросы, связанные с исследованиями и разработками в области наук о жизни, по-прежнему будут перенаправляться на наши модели Opus. Мы делаем возможности модели в области наук о жизни доступными для профессионалов посредством программы доступа к Claude Mythos 5.1, разработанной в партнерстве с правительством США, о чем мы рассказываем ниже.
В Fable 5.1 мы обновляем средства защиты в сфере кибербезопасности, делая их более точными. Теперь мы также разрешаем использовать Fable 5.1 для выявления уязвимостей программного обеспечения — то есть для проведения той защитной работы, которая повышает безопасность ПО. В результате этих изменений пользователи Claude Code могут рассчитывать в среднем примерно на 60% меньшее количество вмешательств со стороны наших средств киберзащиты за сеанс по сравнению с предыдущими защитными мерами в Fable 5. Тем не менее, наши средства защиты по-прежнему перенаправляют на модели Opus несколько типов задач кибербезопасности двойного назначения (задач, которые могут иметь как полезное, так и вредное применение). Сюда входят тестирование на проникновение, генерация эксплойтов и сканирование уязвимостей на основе бинарного кода.
Механизмы защиты от дистилляции. Дистилляция — это метод, используемый для извлечения возможностей передовых моделей. Он часто применяется в промышленных масштабах с использованием тысяч фальшивых аккаунтов. Дистилляция представляет собой угрозу безопасности, поскольку извлеченные возможности впоследствии могут быть выпущены без надлежащих средств защиты. Fable 5.1 поставляется с усиленными механизмами, которые затрудняют атаки путем дистилляции. Например, новые учетные записи API (созданные с сегодняшнего дня) больше не могут вручную редактировать предыдущий контекст Claude в многораундовом диалоге, сохраняя при этом стенограмму предшествующих рассуждений модели. Это закрывает распространенный, публично задокументированный метод дистилляции, который позволял злоумышленникам нелегально извлекать ход мыслей Claude. Мы внедряем это изменение постепенно, чтобы минимизировать неудобства: существующие учетные записи в настоящее время не затронуты этим изменением, однако оно будет применяться ко всем пользователям при выпуске будущих моделей. После этого изменения коснутся небольшого числа пользовательских интеграций. В нашей статье в Справочном центре подробно описано это изменение и те корректировки, которые могут внести разработчики.
Доверенный доступ к Claude Mythos 5.1
Claude Mythos 5.1 идентичен Fable 5.1, но предлагает более мягкие средства защиты для проверенных специалистов и организаций, чья деятельность подпадает под упомянутые выше ограничения в сферах кибербезопасности и наук о жизни. Он будет доступен через две доверенные программы доступа:
- Программа верификации в области кибербезопасности (CVP): CVP в настоящее время предоставляет доступ к определенным моделям классов Opus и Sonnet со сниженными средствами защиты в сфере кибербезопасности для работ по защитной безопасности. В ближайшем будущем эта программа также будет включать доступ к моделям класса Claude Mythos. Подать заявку на участие в CVP можно здесь.
- Программа верификации в области наук о жизни (LSVP): LSVP разработана таким образом, чтобы специалисты в области наук о жизни могли использовать Claude Mythos 5.1 со средствами защиты, предназначенными для профессиональной научно-исследовательской и опытно-конструкторской деятельности (при сохранении всех остальных средств защиты). В партнерстве с правительством США мы зарегистрировали наших первых участников и планируем расширить доступ к этой программе для более широкого сообщества специалистов в области наук о жизни.
В дополнение к этим программам доверенного доступа, наш продукт Claude Security, который сканирует кодовые базы на наличие уязвимостей и предлагает исправления для проверки человеком, теперь также работает на базе Claude Mythos 5.1.
Соответствие Закону ЕС об искусственном интеллекте
В июле 2026 года компания Anthropic (наряду со 190 другими подписантами, включая несколько других крупных разработчиков моделей ИИ) подписала Кодекс практики ЕС по прозрачности контента, созданного с помощью искусственного интеллекта, в рамках Закона об ИИ.
Это потребовало от нас добавления водяного знака — числового способа определения вероятности того, что Claude участвовал в написании текста — к результатам работы моделей, выпущенных после 2 августа 2026 года. Как мы объясняли ранее, этот водяной знак не виден никому, у кого нет API обнаружения. Он не оказывает практического влияния на качество или содержание ответов Claude и не содержит никакой информации о пользователе, его организации или его диалогах с Claude.
Закон также потребовал от нас предоставить пользователям способ определять, содержит ли текст водяной знак. В связи с этим мы запускаем API обнаружения в режиме частного предварительного просмотра. В настоящее время он доступен для соответствующих критериям организаций (таких как регуляторы, правоохранительные органы, СМИ, фактчекеры, независимые исследователи, образовательные организации и группы гражданского общества ЕС), как того требует законодательство ЕС. Он также доступен для предприятий, у которых есть аналогичные обязательства по проверке водяных знаков для соблюдения требований Закона. Мы планируем со временем расширить доступ к API обнаружения. Вы можете заявить о своем интересе к доступу здесь.
Стоимость и доступность
Claude Fable 5.1 доступен уже сегодня на всех платформах, включая Amazon Web Services, Google Cloud и Microsoft Azure. Разработчики могут начать работу с claude-fable-5-1 в Claude API.
Как упоминалось выше, мы снизили цену на чтение из кэша Fable 5.1 (когда модель повторно использует уже обработанный контекст) везде, где тарификация основана на токенах, например в нашем API. Чтение из кэша теперь стоит на 75% дешевле, то есть $0,25 за миллион токенов.
Это изменение приводит к существенному снижению общей стоимости работы модели. Для типичных рабочих нагрузок затраты снижаются примерно на 25% по сравнению с Fable 5. Для сложных задач программирования и высокоавтономных задач (agentic tasks) экономия может составить до 45%. На приведенном ниже графике показано, почему это изменение имеет столь большое значение:
- Чтение из кэша
- Все остальные токены
Индексированная стоимость выполнения одних и тех же рабочих нагрузок на Fable 5 и Fable 5.1 при ценообразовании на основе использования, измеренном при стандартной нагрузке за четыре недели реального использования в августе 2026 года. Типичная рабочая нагрузка охватывает использование Fable в Claude Enterprise, Claude Code и через API. Высокоавтономная рабочая нагрузка охватывает задачи с интенсивным использованием контекста и инструментов, где чтение из кэша составляет большую часть затрат.
В остальном цены Fable 5.1 такие же, как у Fable 5: $10 за миллион входных токенов и $50 за миллион выходных токенов. Параллельно мы продолжаем работу над тем, чтобы перенести многие улучшения из Fable 5.1 в остальные модели нашего семейства.
Как обсуждалось выше, Claude Mythos 5.1 доступен проверенным специалистам по киберзащите и исследователям в области наук о жизни. В настоящее время он доступен только определенному кругу организаций США, хотя мы координируем свои действия с правительством США, чтобы как можно быстрее расширить доступ для более широкого круга отечественных и международных партнеров. Чтобы выразить заинтересованность в получении доступа к Claude Mythos 5.1 для киберзащиты через программу CVP, перейдите сюда.
Начать работу
Сноски
1 Terminal-Bench-Science 0.1: Стандартная ошибка составляет ±3,5–4,5 пункта на модель. Публичная таблица лидеров (3 попытки/задача, инфраструктура Claude Code) указывает показатели Claude Opus 5 на уровне 30,0% и Claude Fable 5 на уровне 21,4%; наша установка воспроизводит их на уровне 29,0% и 24,7% соответственно, что находится в пределах погрешности.
2 OSWorld 2.0: Оценки приводятся по набору задач авторов бенчмарка от августа 2026 года; Fable 5 и Opus 5 были перезапущены в тех же условиях. Поскольку файлы задач отличаются от предыдущих версий, эти цифры не сопоставимы напрямую с ранее опубликованными результатами OSWorld 2.0, поэтому оценки конкурентов не приводятся.
3 Эти три мишени (EGFR, Nipah G, 15-PGDH) взяты из <соревнований по дизайну белков компании Adaptyv Bio>. Сравнение с Nipah G проводится с de novo-дизайнами, нацеленными на сайт связывания рецептора на головке G (лучший: ~8–12 нм, N1032). De novo-разработка от Ника Бойда (Nick Boyd) / Escalante Bio, нацеленная на другую область (стебель), достигла ~1,4 нм (design_7), что сопоставимо с нашим лучшим связывающим белком.
Дополнительные материалы
1. Системная карта Claude Fable 5.1 и Claude Mythos 5.1. Посмотреть карту
2. Подробнее о наших корпоративных передовых мерах безопасности (Enterprise Frontier Safeguards). Узнать больше
3. Запросить доступ к корпоративным передовым мерам безопасности. Открыть форму
4. Обзор наших улучшений в области биологической безопасности. Узнать больше
5. Поддержка ученых. Читать далее
6. Предыдущие работы Claude в области дизайна белков. Читать далее
7. Предыдущие работы Claude в области математики. Читать далее
8. Подробнее о стандарте аппаратного обеспечения для моделей. Узнать больше
Полный текст статьи читайте на Anthropic
