Блочно-разреженные ядровые функции GPU
Иллюстрация: Бен Барри (Ben Barry)
Мы выпускаем высокооптимизированные ядровые функции GPU (kernels) для малоизученного класса архитектур нейронных сетей: сетей с блочно-разреженными весами. В зависимости от выбранной разреженности эти ядра могут работать на порядки быстрее, чем cuBLAS или cuSPARSE. Мы использовали их для достижения передовых результатов (state-of-the-art) в анализе тональности текста, а также в генеративном моделировании текста и изображений.
Разработка архитектур моделей и алгоритмов в области глубокого обучения во многом ограничена наличием эффективных реализаций элементарных операций на GPU. Одной из проблем было отсутствие эффективной реализации разреженных линейных операций на GPU, которую мы теперь выпускаем вместе с первыми результатами их применения для реализации ряда паттернов разреженности. Эти первоначальные результаты многообещающие, но не окончательные, и мы приглашаем сообщество присоединиться к нам в расширении границ возможностей архитектур, которые открывают эти ядра.
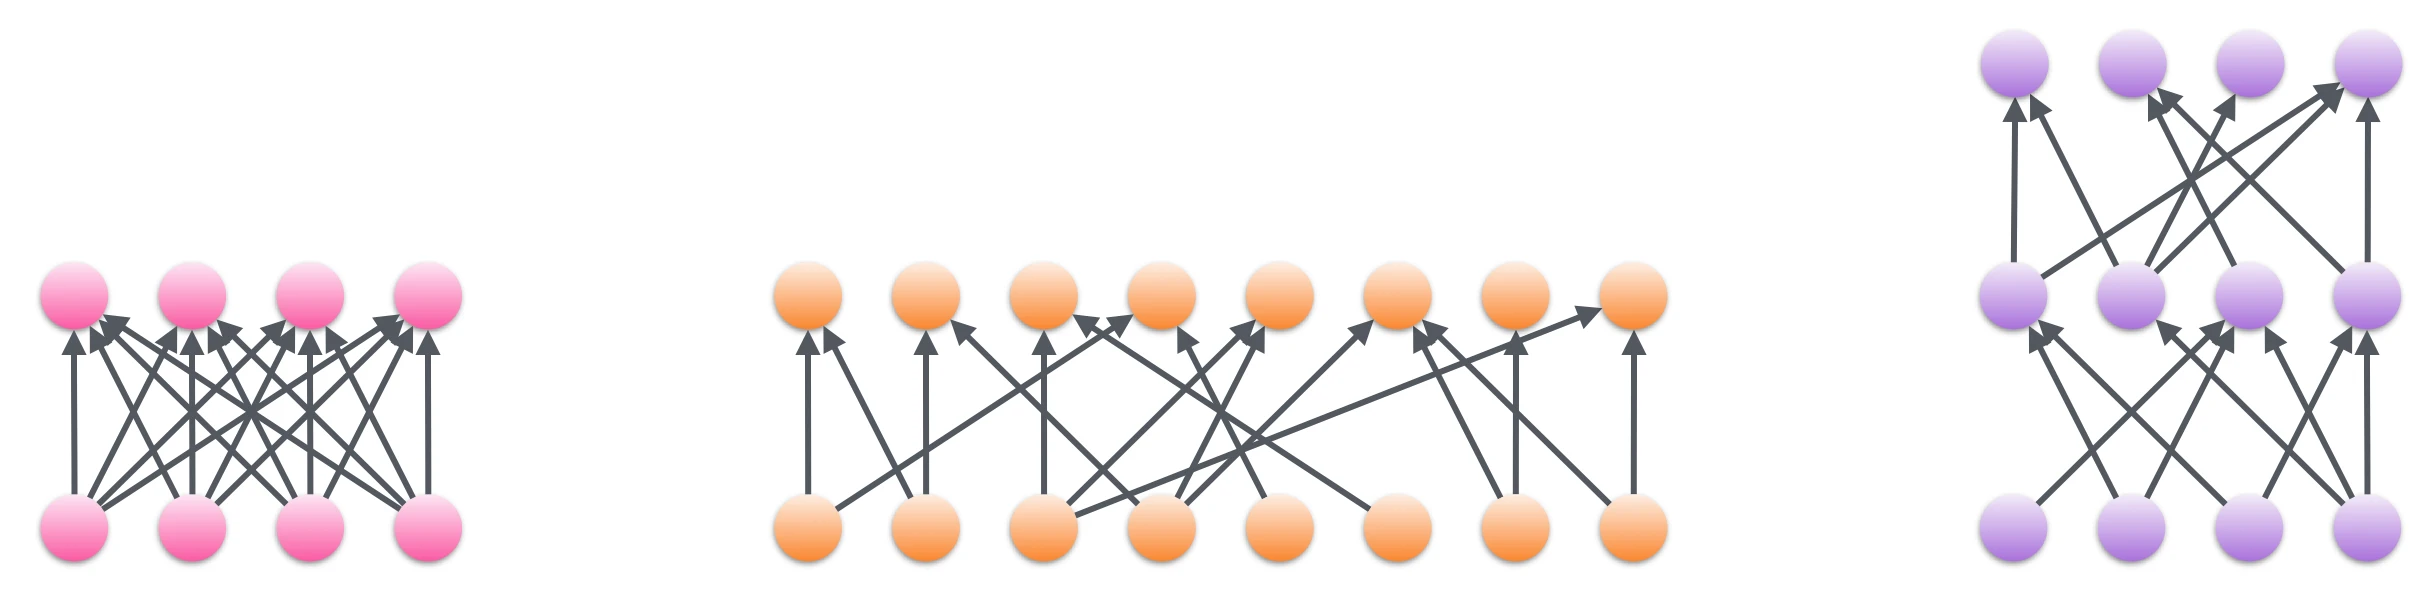
Разреженные весовые матрицы, в отличие от плотных весовых матриц, содержат большое количество элементов со значением строго равным нулю. Разреженные весовые матрицы привлекательны в качестве строительных блоков моделей, поскольку вычислительная стоимость матричного умножения и свёртки с разреженными блоками пропорциональна только количеству ненулевых блоков. Разреженность позволяет, например, обучать нейронные сети, которые гораздо шире и глубже, чем это было бы возможно при заданном бюджете параметров и вычислений, такие как LSTM с десятками тысяч скрытых блоков. (Самые крупные сети LSTM, обучаемые сегодня, имеют лишь тысячи скрытых блоков.)
Ядровые функции
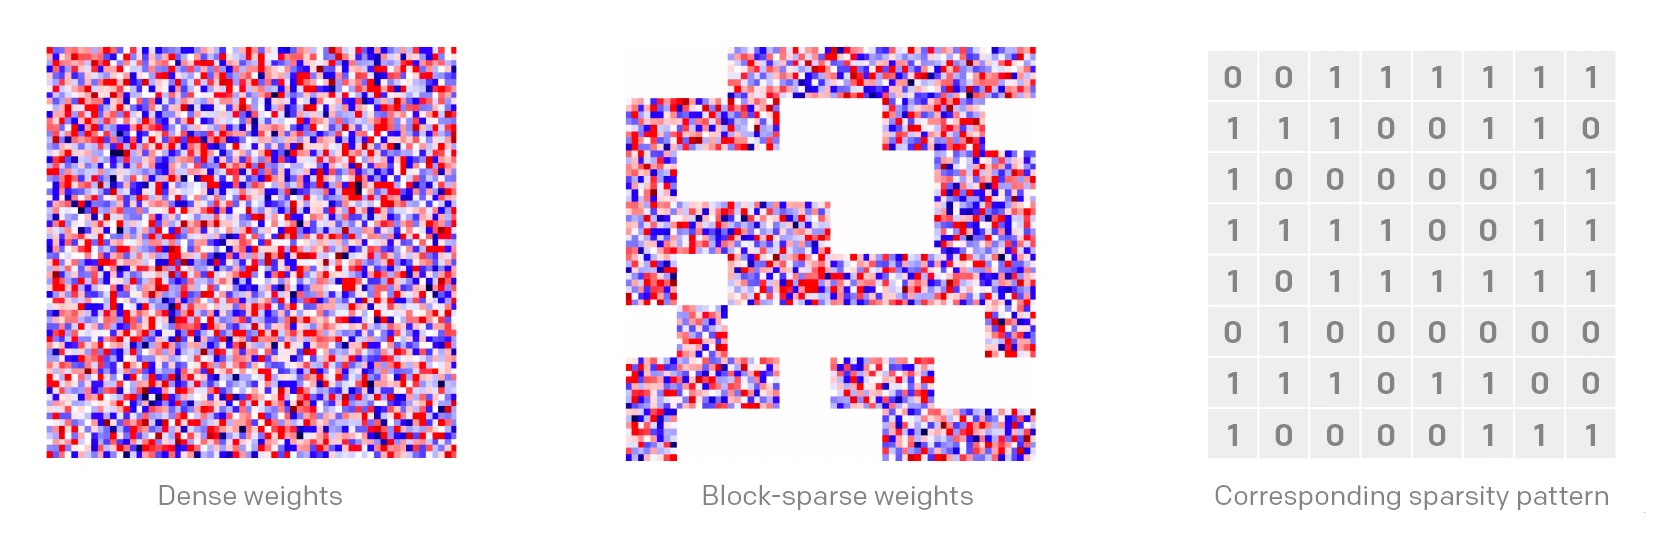
Эти ядра обеспечивают эффективное использование блочно-разреженных весов в полносвязных и свёрточных слоях (показано выше). Для свёрточных слоев ядра обеспечивают разреженность по измерениям входных и выходных признаков; связность в пространственных измерениях не затрагивается. Разреженность определяется на уровне блоков (правый рисунок выше) и оптимизирована для размеров блоков 8×8 (как в этом примере), 16×16 или 32×32. На уровне блоков паттерн разреженности полностью настраивается. Поскольку ядра пропускают вычисления нулевых блоков, вычислительная стоимость пропорциональна только количеству ненулевых весов, а не числу входных/выходных признаков. Затраты на хранение параметров также пропорциональны только количеству ненулевых весов.
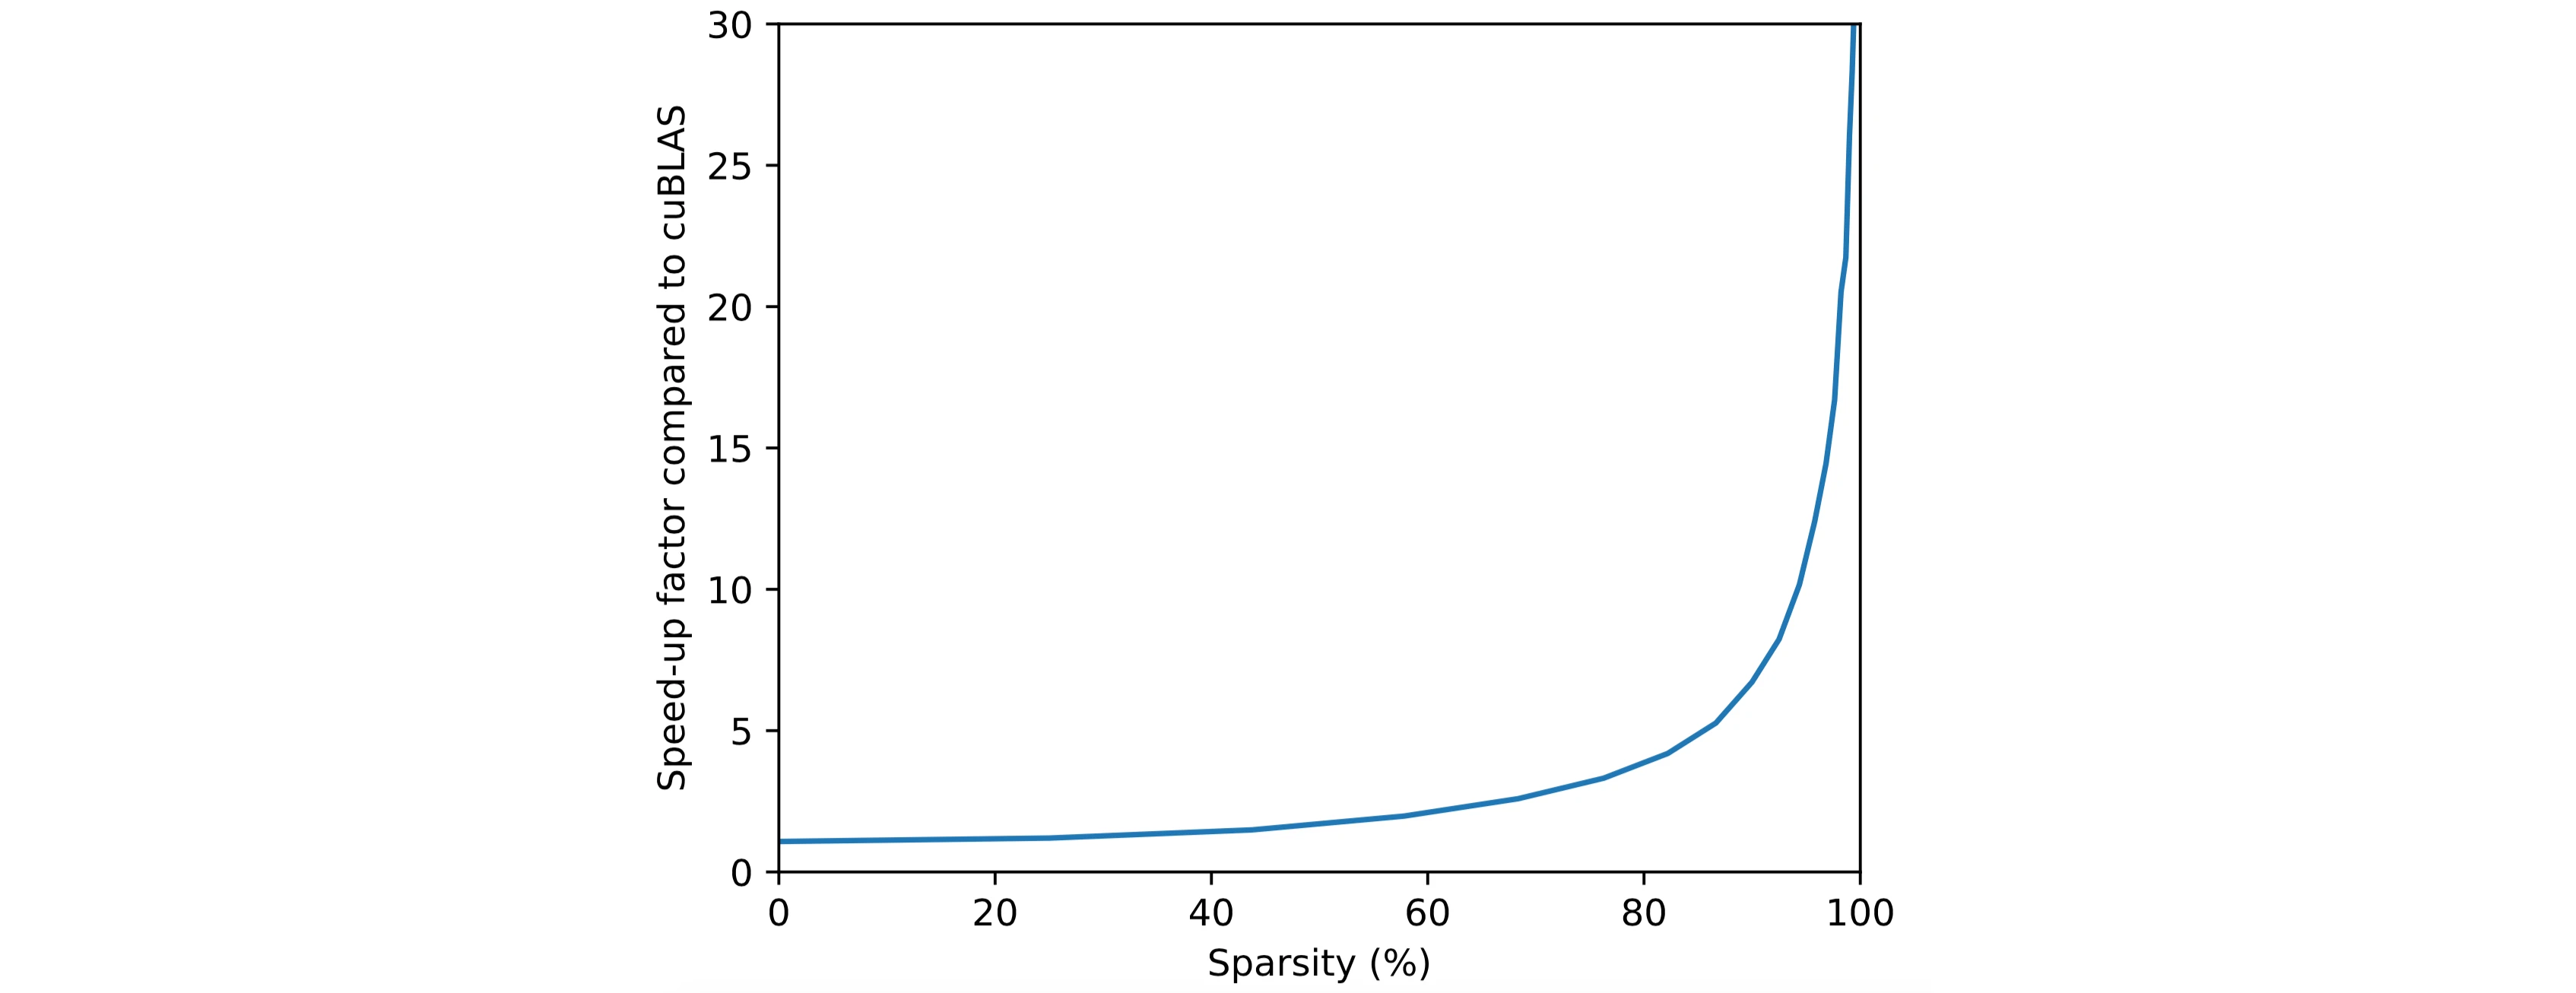
Фактор ускорения для различных уровней разреженности по сравнению с cuBLAS при использовании с широким состоянием (12288 скрытых юнитов), размером блока 32×32 и размером мини-батча 32. Сравнение проводилось на GPU NVIDIA Titan X Pascal с CUDA 8. Ускорение по сравнению с cuSPARSE оказалось еще более значительным для протестированных уровней разреженности.
Использование ядер
Ниже приведен пример кода для выполнения разреженного матричного умножения в Tensorflow.
Python
1from blocksparse.matmul import BlocksparseMatMul2import tensorflow as tf3import numpy as np4
5hidden_size = 40966block_size = 327minibatch_size = 648
9# Create a (random) sparsity pattern10sparsity = np.random.randint(2, size=(hidden_size//block_size,hidden_size//block_size))11
12# Initialize the sparse matrix multiplication object13bsmm = BlocksparseMatMul(sparsity, block_size=block_size)14
15# Input to graph16x = tf.placeholder(tf.float32, shape=[None, hidden_size])17
18# Initialize block-sparse weights19w = tf.get_variable("w", bsmm.w_shape, dtype=tf.float32)20
21# Block-sparse matrix multiplication22y = bsmm(x, w)23
24# Run25sess = tf.InteractiveSession()26sess.run(tf.global_variables_initializer())27result = sess.run([y], feed_dict = {x: np.ones((minibatch_size,hidden_size), dtype='float32')})28print(result)LSTM с эффектом тесного мира (Small-world LSTMs)
Один из наиболее интересных вариантов использования блочно-разреженных ядер — создание с их помощью нейронных сетей с архитектурой «тесного мира». Графы тесного мира соединены таким образом, что любые два узла графа связаны небольшим числом шагов, даже если в графе миллиарды узлов. Наша мотивация для реализации связности по принципу тесного мира заключается в том, чтобы, несмотря на высокую степень разреженности, информация все же быстро распространялась по сети. Мозг демонстрирует паттерны связности тесного мира, что наводит на мысль о том, может ли аналогичное свойство улучшить производительность LSTM. Используя разреженную связность тесного мира, мы эффективно обучили сети LSTM почти с двадцатью тысячами скрытых юнитов — в 5 раз шире плотной сети с сопоставимым количеством параметров, улучшив результаты генеративного моделирования текста и полуконтролируемой классификации тональности; подробнее см. нашу статью.
Обучение представлений тональности
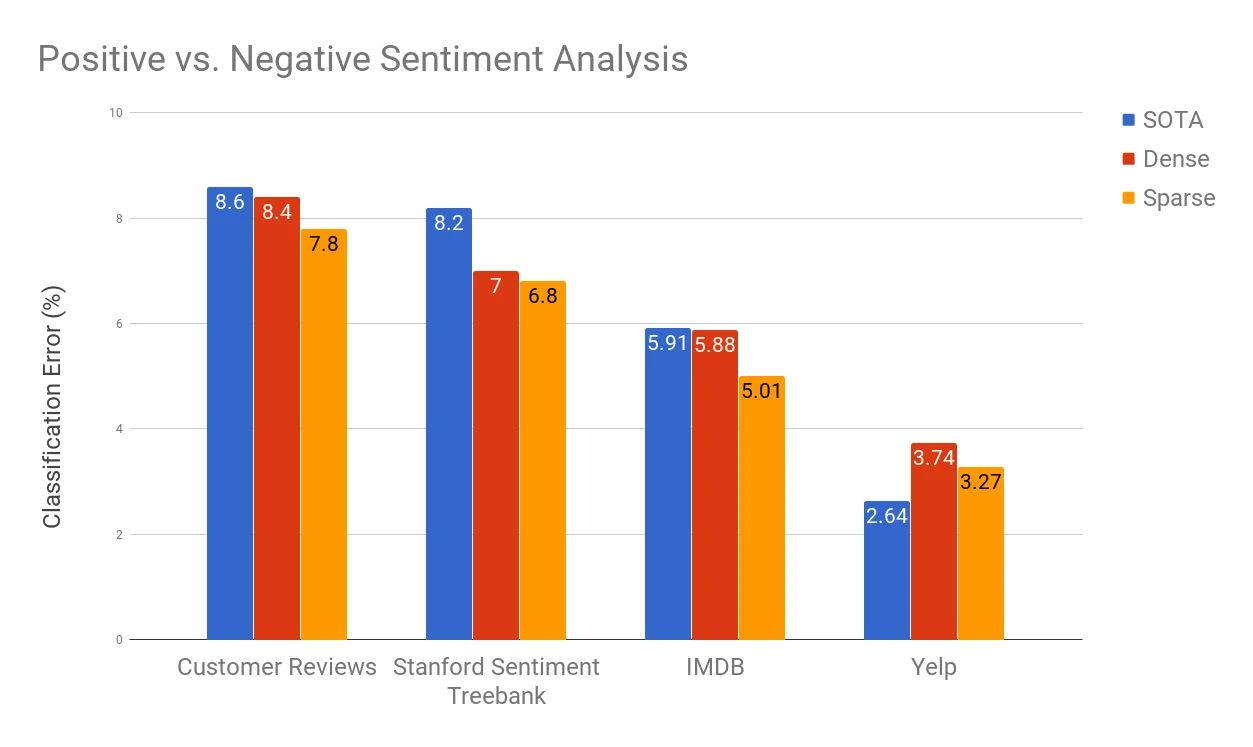
Используя подход из нашего эксперимента с нейроном тональности, мы обучили LSTM с примерно эквивалентным количеством параметров и сравнили модели с плотными весовыми матрицами и блочно-разреженным вариантом. Разреженная модель превосходит плотную на всех наборах данных о тональности. Наша разреженная модель улучшает показатель state-of-the-art на датасете IMDB на уровне документов с 5,91% ошибок (Miyato et al., 2016) до 5,01%. Это многообещающее улучшение по сравнению с нашими предыдущими результатами, которые показывали лучшие результаты только на более коротких датасетах на уровне предложений.
Результаты сжатия
Благодаря использованию разреженных и широких LSTM, показатель бит на символ (bits-per-character) в наших экспериментах снизился с 1,059 до 1,048 при равном количестве параметров (~100 миллионов). Архитектуры с блочно-разреженными линейными слоями также могут улучшить результаты, полученные с помощью плотно связанных линейных слоев. Мы провели простую модификацию модели PixelCNN++ для естественных изображений CIFAR-10. Замена обычных 2D-свёрточных ядер на разреженные при одновременном углублении сети, но сохранении остальных гиперпараметров неизменными, привела к снижению показателя бит на измерение (bits-per-dimension) с 2,92 до 2,90, что на данный момент является лучшим результатом (state-of-the-art) для этого датасета.
Направления исследований
Ниже мы перечисляем некоторые предложения для будущих исследований.
- Большинство весов в нейронных сетях можно подвергнуть прунингу (проредить) после завершения обучения. Какое ускорение процессорного времени возможно во время инференса при использовании прунинга вместе с этими ядрами?
- В биологическом мозге разреженная структура сети частично определяется в ходе развития, помимо силы синаптических связей. Можем ли мы сделать нечто подобное в искусственных нейронных сетях, где градиенты используются не только для обучения весов связей, но и для поиска оптимальной структуры разреженности? В недавней статье был предложен метод обучения блочно-разреженных RNN, а недавно мы предложили алгоритм L0-регуляризации в нейронных сетях, который может быть использован для этой цели.
- Мы обучили LSTM с десятками тысяч скрытых юнитов, что привело к созданию лучших языковых моделей. В более общем плане, разреженные слои позволяют обучать модели с огромными весовыми матрицами, имеющими при этом такое же количество параметров и те же вычислительные затраты, что и их меньшие плотные аналоги. Каковы те области применения, где это сильнее всего повлияет на производительность?
Авторы
Благодарности
Иллюстрация на обложке: Бен Барри (Ben Barry)
Полный текст статьи читайте на OpenAI
