Ваш алгоритм: больше возможностей персонализировать рекомендации Facebook
- Пользователи могут обычным языком добавлять, перемещать и удалять интересы; изменения оперативно применяются к ленте Facebook и Reels.
- Новые интересы получают отдельные источники подбора контента и ограниченную ежедневную долю, чтобы не вытеснять остальные рекомендации.
- LLM формируют исходный профиль, проверяют изменения предпочтений и проводят финальную проверку контента из списка «Не интересует».
Почему это важно: Прежние рекомендации опирались на косвенные сигналы, поэтому медленно адаптировались и учитывали лишь небольшие нюансы.
- «Ваш алгоритм» — это набор инструментов на базе ИИ, который делает рекомендации Facebook более прозрачными и управляемыми: в одном редактируемом разделе собраны интересы, влияющие на ленту и Reels.
- Мы рассказываем, как «Ваш алгоритм» преобразует предпочтения, сформулированные пользователями обычным языком, в адаптивные рекомендации и как большие языковые модели (LLM) настраиваются для выполнения конкретных задач в системе.
Традиционно системы рекомендаций, определяющие, что люди видят на Facebook, обучались на косвенных сигналах взаимодействия. Такой подход хорошо масштабируется, но означает, что системы медленно адаптируются и учитывают лишь небольшие нюансы. Но что, если бы люди могли напрямую взаимодействовать с алгоритмами, которые ранжируют и рекомендуют контент, чтобы мгновенно делать рекомендации более персональными и индивидуальными?
«Ваш алгоритм» — это комплексная система, призванная устранить ограничения рекомендаций в плане адаптивности и учета нюансов. Этот новый набор инструментов на базе ИИ позволяет пользователям Facebook своими словами указывать, что они хотят видеть в ленте и Reels. Поручив группе больших языковых моделей (LLM) понимать, сохранять и отслеживать заявленные пользователями предпочтения наряду с их поведением, мы создали систему рекомендаций, которая учитывает предпочтения людей и корректирует показываемый им контент.
Обзор архитектуры системы «Ваш алгоритм»
Страница «Ваш алгоритм» состоит из трех частей (рис. 1):
- Вверху — краткая сводка о недавней активности, состоящая из одного предложения.
- Ниже расположены два списка:
- «Интересует», предварительно заполненный интересами, определенными на основе прошлой активности.
- «Не интересует», в котором собраны темы, отмеченные пользователем как неинтересные, скрытые или исключенные с помощью кнопки X на Facebook.
Пользователи могут добавлять интересы, формулируя их обычным языком, перемещать из одного списка в другой или удалять. Каждое изменение оперативно применяется и к ленте, и к Reels, а затем обновляется с учетом отзывов пользователя об отдельных публикациях.
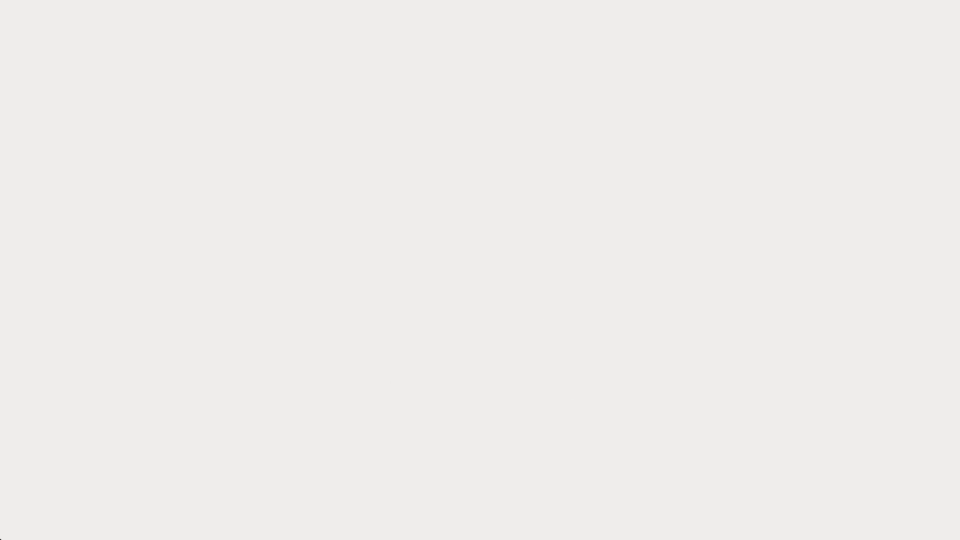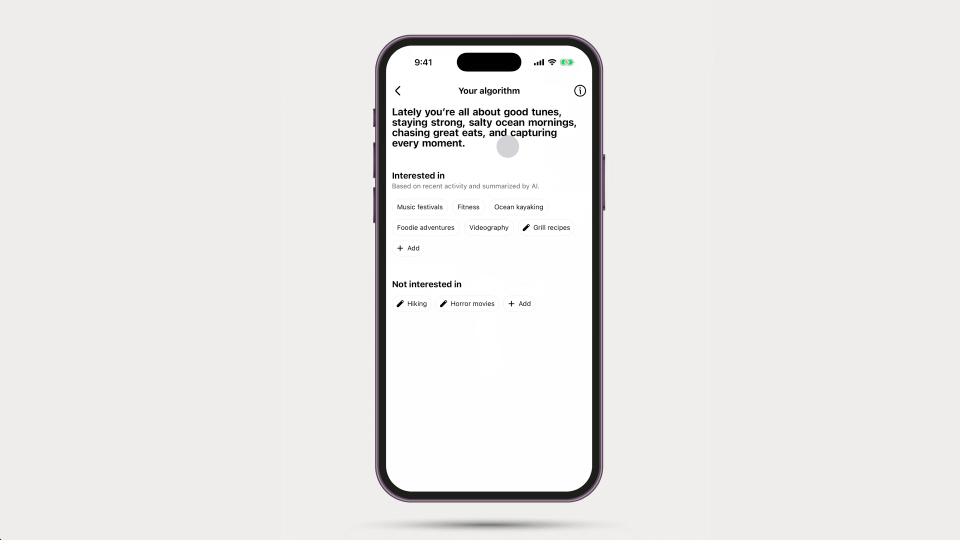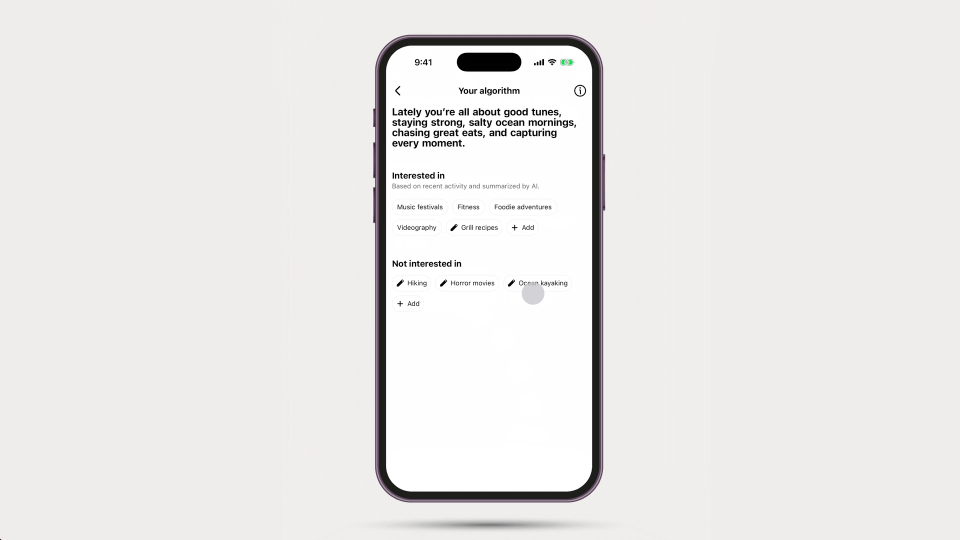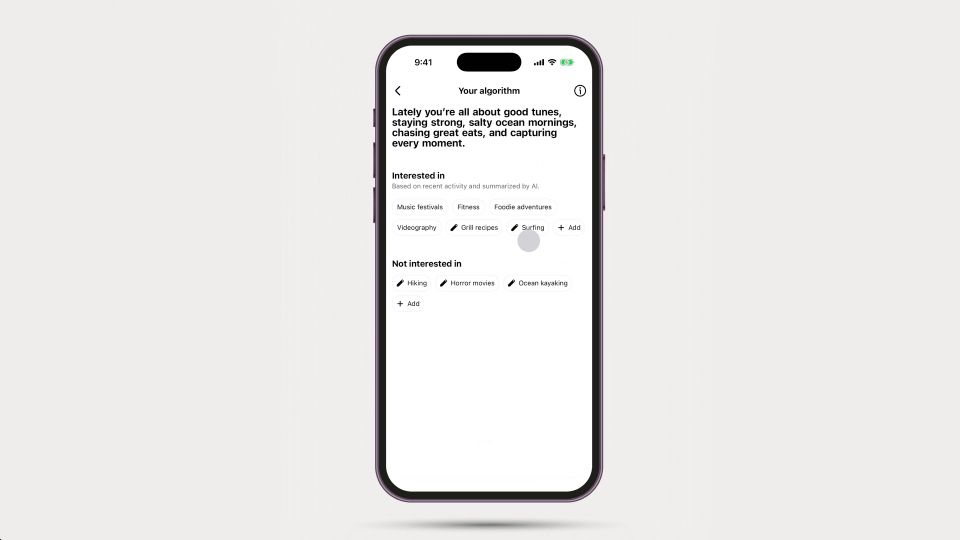 Рис. 1. Страница «Ваш алгоритм».
Система «Ваш алгоритм» включает несколько компонентов, охватывающих весь жизненный цикл предпочтения: от его определения и проверки до применения при ранжировании и показе контента (рис. 2).
- Формирование профиля создает исходный профиль интересов.
- Управление предпочтениями проверяет каждое изменение, дополняет его сигналами, необходимыми для ранжирования, и сохраняет в едином хранилище, к которому обращаются и лента, и Reels. Благодаря этому отображаемые на странице предпочтения совпадают с теми, что используются при ранжировании.
- Ранжирование применяет списки «Интересует» и «Не интересует» на всех этапах воронки.
- Оптимизация показа помогает быстрее применять каждое изменение.
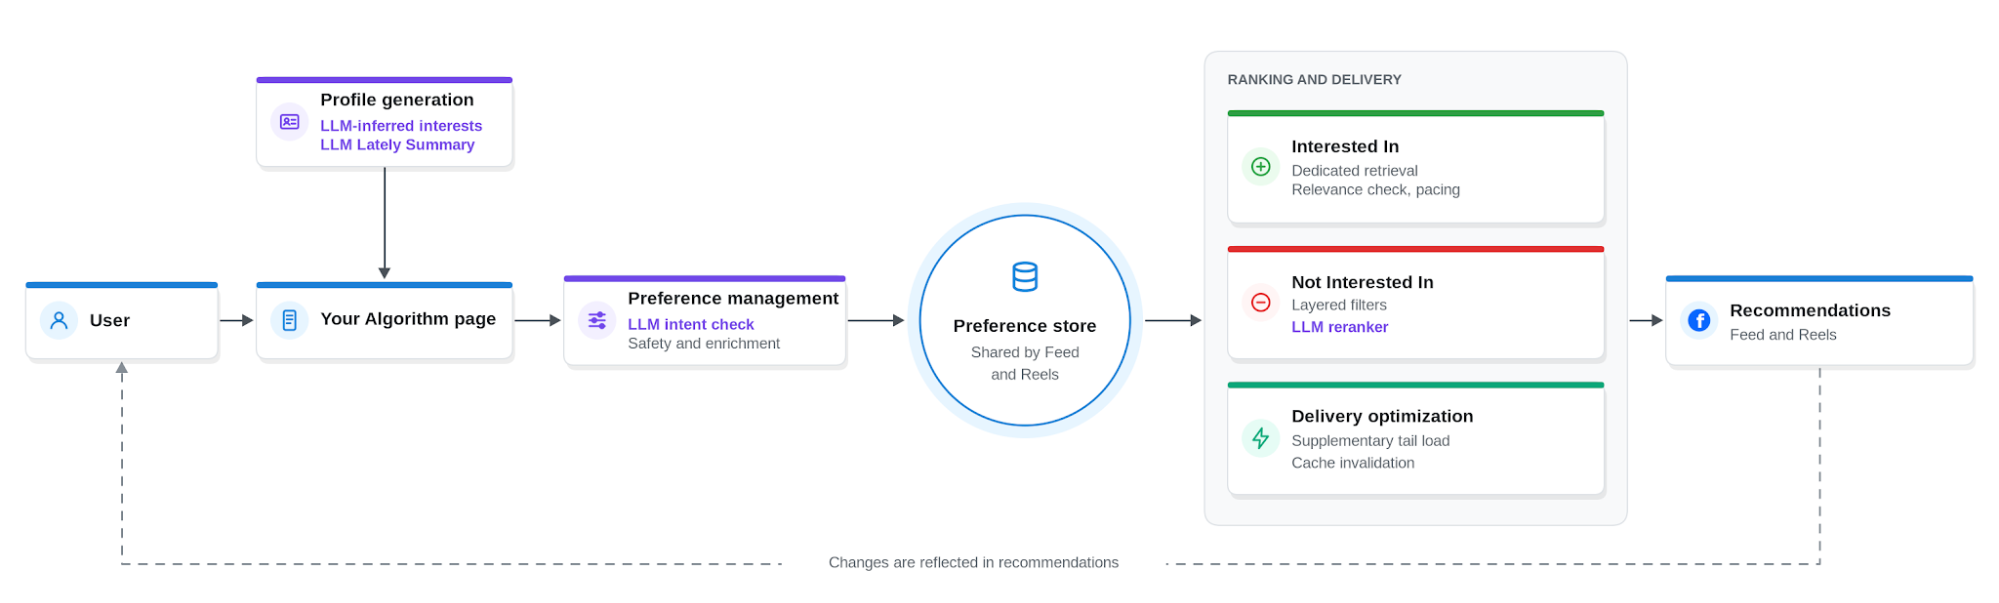 Рис. 2. Обзор системы «Ваш алгоритм».
От предпочтений к рекомендациям
Преобразование заявленного предпочтения в рекомендации сопряжено с тремя отдельными задачами. Интерес, добавленный в список «Интересует», должен быстро обеспечивать показ релевантного контента, не вытесняя при этом все остальное. Интерес из списка «Не интересует» должен надежно учитываться, несмотря на размытые границы тем и то, что любой отдельный фильтр может пропустить некоторые совпадения. Кроме того, оба типа изменений должны применяться оперативно, даже если следующие рекомендации были сохранены в кэше еще до внесения изменений.
«Ваш алгоритм» решает каждую из этих задач с помощью специальной логики на разных этапах воронки рекомендаций — от извлечения контента до повторного ранжирования и показа на устройстве (рис. 3).
«Интересует»: показываем новые интересы, не перегружая ленту
Для каждого интереса из списка «Интересует» задействуются четыре отдельных источника извлечения контента. Два напрямую находят подходящий контент — с помощью поиска и групп тем, тесно связанных между собой, —, а еще два расширяют охват за счет графа контента и сходства между публикациями. Извлечение контента отдельно для каждого интереса позволяет собрать достаточно релевантных вариантов для дальнейшего ранжирования.
Это важно, поскольку без такого подхода контент о совершенно новом интересе может вообще не попасть в процесс ранжирования. Варианты, прошедшие проверку релевантности, при которой значение интереса сравнивается с каждым вариантом, получают приоритет на позднем этапе ранжирования и могут конкурировать с другим контентом. Затем управляющий слой при повторном ранжировании определяет, где именно они появятся.
Важно не просто быстро реагировать. Наш подход ставит баланс выше объема: новый интерес должен появиться, но не захватить всю ленту. Управляющий слой распределяет рекомендации по одному интересу во времени и ограничивает ежедневную долю контента для каждого интереса. При извлечении контента за один запрос собираются варианты только для одного интереса, чтобы очередь дошла до каждого. В течение ограниченного периода новые интересы получают дополнительный вес. Затем система рекомендаций начинает учитывать, как люди взаимодействуют с таким контентом.
«Не интересует»: многоуровневая фильтрация на каждом этапе
Интересы из списка «Не интересует» учитываются на нескольких этапах на основе различных сигналов, что обеспечивает высокую точность и полноту фильтрации. На этапе ранжирования сравнение на основе эмбеддингов, используемое при проверке релевантности, исключает варианты, слишком близкие к интересам из списка «Не интересует», а правила понижения опускают в выдаче похожий контент. После ранжирования большая языковая модель для повторного ранжирования проверяет итоговый список. На устройстве кэширование сбрасывается, как описано ниже, чтобы удалить подходящие варианты, уже поставленные в очередь на показ.
Не все пункты списка «Не интересует» относятся к темам. Запросы, связанные с качеством контента, например просьба сократить количество материалов, созданных ИИ, или контента с сексуальным подтекстом, сопоставляются со специальными сигналами понижения, а не с темами. Если в запросе назван автор, его контент фильтруется напрямую.
Оптимизация скорости реакции
Даже если ранжирование настроено на учет предпочтений, можно повысить оперативность, с которой изменения влияют на показываемый контент. Контент, соответствующий новому предпочтению, не будет отобран до следующего запроса на получение данных, а контент, уже сохраненный в кэше на устройстве, был ранжирован до того, как предпочтение было задано.
Чтобы устранить эти пробелы, мы добавили два механизма показа. Когда новый интерес добавляется в список «Интересует», система отправляет дополнительный запрос на получение данных вне обычного цикла. Он называется дополнительной подгрузкой хвоста и позволяет загрузить свежие рекомендации, чтобы подходящий контент появился быстрее. Когда интерес добавляется в список «Не интересует», сброс кэша позволяет обработать варианты, ранжированные до изменения. Клиент получает кластеры нового интереса и удаляет из кэша совпадающий контент до его показа.
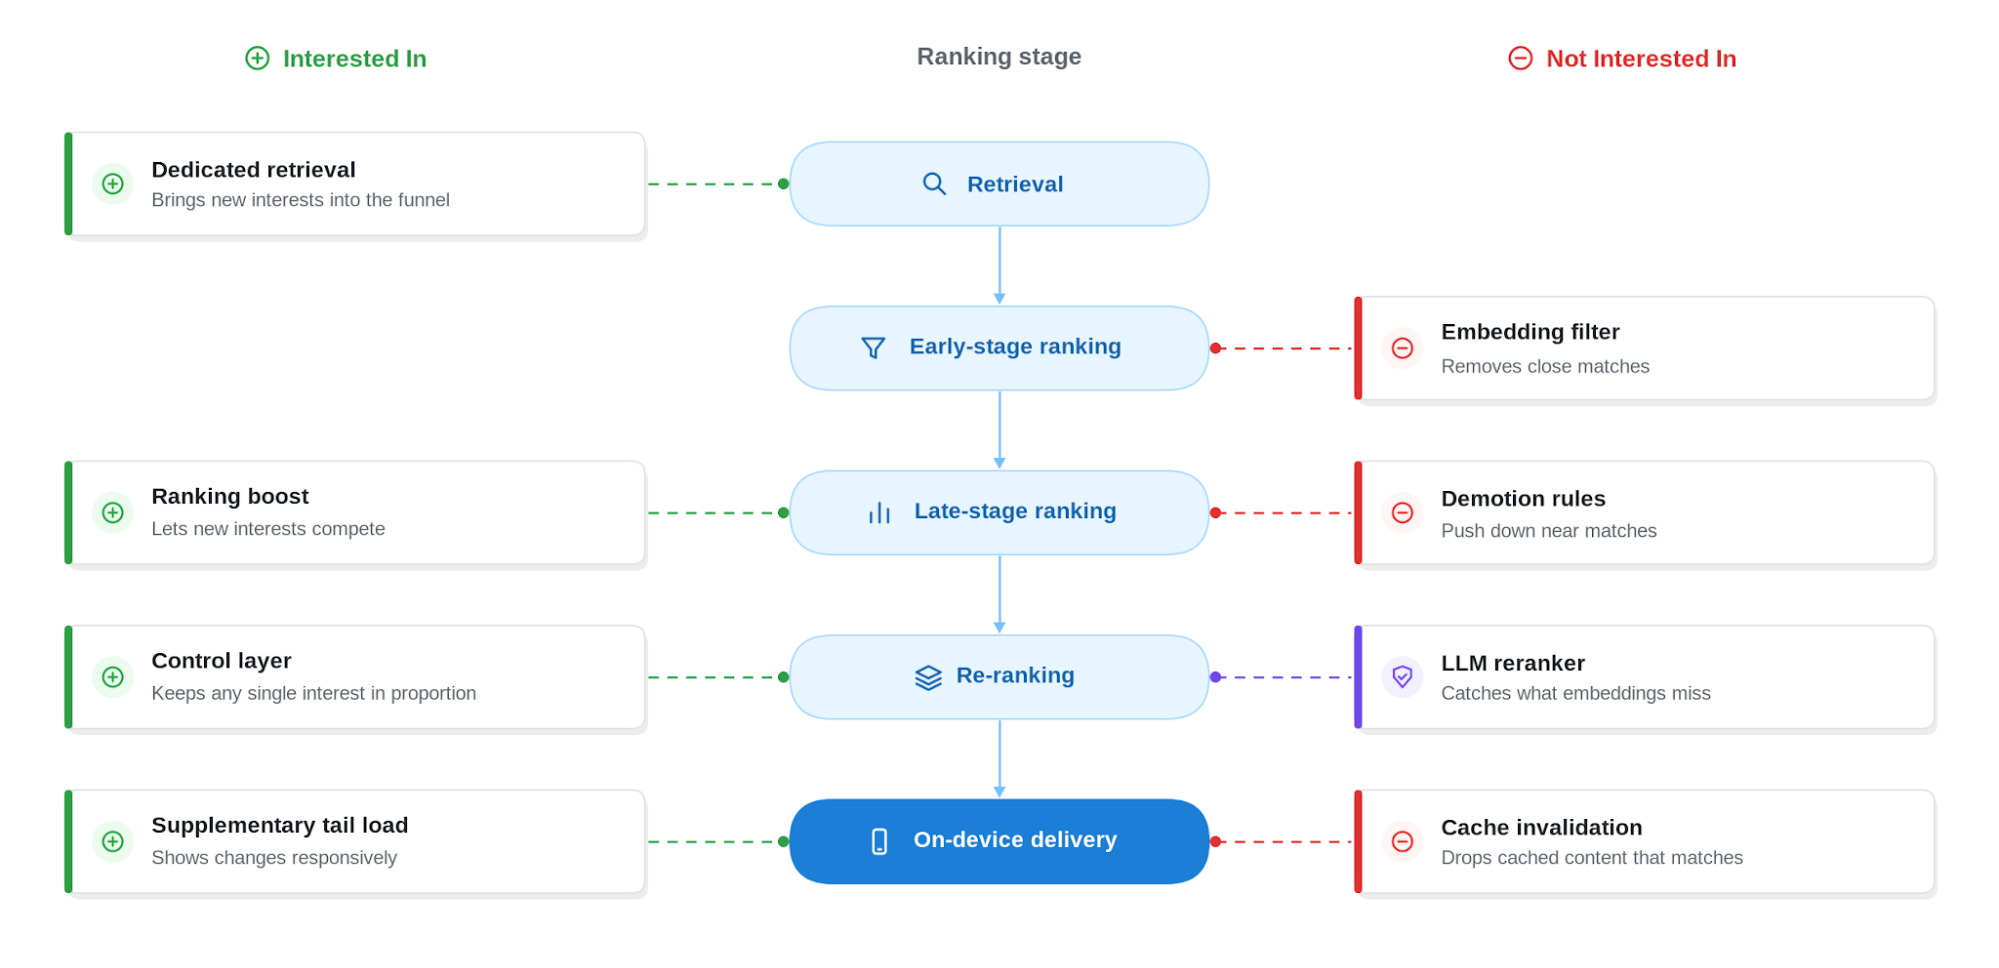 Рис. 3. Этапы воронки ранжирования контента, на которых применяются предпочтения из «Вашего алгоритма».
LLM на всех этапах работы с предпочтениями: от формирования профиля до финальной проверки
Большие языковые модели задействованы на нескольких ключевых этапах жизненного цикла предпочтения в системе «Ваш алгоритм». Они формируют исходный профиль, который пользователи видят при первом посещении, проверяют каждое изменение по мере его внесения и проводят финальную проверку рекомендаций на соответствие интересам из списка «Не интересует» (рис. 2). Для каждого такого применения есть свои ограничения, в том числе по задержке, доступным вычислительным ресурсам и безопасности, поэтому для их оценки также требуется новый подход.
Формирование профиля создает исходный контент для первого посещения: определенные интересы и краткую сводку о недавней активности. Большая языковая модель преобразует сигналы интересов, регулярно обновляемые, в набор определенных интересов с понятными и легко читаемыми названиями тем. Они предварительно добавляются в список «Интересует» и отражают историю просмотров в ленте Facebook и Reels. Модель также составляет краткую сводку о недавней активности — предложение, в котором выделены устойчивые интересы. Вместе они дают пользователю узнаваемую отправную точку, которую легко проверить и скорректировать.
Каждое изменение на странице «Ваш алгоритм» проходит через систему управления предпочтениями. Когда интерес добавляется или перемещается, большая языковая модель проверяет, представляет ли фраза связную тему, обнаруживает дубликаты и сопоставляет ее с подходящим названием темы. Для этого этапа используется модель меньшего размера, которую можно эффективно применять в большом масштабе. Затем проверенный интерес дополняется сигналами, необходимыми для ранжирования, например эмбеддингом и поисковыми ключевыми словами, и сохраняется в общем хранилище предпочтений. Большая языковая модель — лишь один из уровней проверки. В системе также есть отдельный компонент для проверки целостности и безопасности.
После ранжирования рекомендаций повторное ранжирование с помощью большой языковой модели проводит финальную проверку на соответствие интересам из списка «Не интересует». На этапе ранжирования интересы сопоставляются с вариантами с помощью эмбеддингов — это быстро, но дает лишь приблизительный результат. Чтобы обнаружить то, что они пропускают, дообученная большая языковая модель анализирует ранжированный список и удаляет контент, который считает связанным с интересом, недавно добавленным в список «Не интересует». Важным открытием стало то, что небольшая дообученная модель, которая возвращает только элементы для удаления, работает быстрее и надежнее, чем универсальная модель, оценивающая каждый элемент по отдельности.
Для оценки таких обращений к большим языковым моделям потребовался отдельный подход. Стандартные офлайн-метрики не позволяют определить, точна ли краткая сводка о недавней активности или правильные ли варианты удалил модуль повторного ранжирования. Поэтому отдельная большая языковая модель выступает в роли оценщика и проверяет результат каждого вызова на соответствие ожидаемому поведению. Это обеспечивает объективный и воспроизводимый способ сравнивать промпты и модели до запуска.
Будущее «Вашего алгоритма»
«Ваш алгоритм» делает рекомендации более прозрачными и персонализированными, учитывая и поведение пользователей, и их явно заявленные предпочтения. Однако остаются важные возможности для улучшения, например более точная интерпретация неоднозначных запросов и еще более точная настройка рекомендаций с учетом каждого пожелания. Мы также изучаем дополнительные способы взаимодействия, чтобы пользователи могли задавать предпочтения в большем количестве мест.
Благодарности
В эту работу внесли важный вклад участники межфункциональной команды Meta (в алфавитном порядке):
Adi Gupta, Aryan Porwal, Bernabe Soto, Chao Yang, Chen Chen, Chen Kovacs, Chengxi Li, Chih-Wei Chang, Clare Yip, Cuong Nguyen, Dahni Ma, Daniel Thiyagu, Danny Kanoff, David Yuan, Devin Ding, Devon Pan, Eric Landgrebe, Feng Zhang, George Lu, Grace Yang, Hai-Son Dang, Haisen Hong, Hongyi Shi, Hongyi Wu, Howard Lu, Huijun Qian, Igor Vodov, Iordanis Fostiropoulos, Jakara Mato, Jasmine Neisser, Jason Liu, Jason Song, Jean-Pascal Billaud, Jeffrey Lin, Jeffrey Santelli, Jian Chen, Jianyu Wang, Jiaye Pan, Jinho Hwang, Joe Sena, Jordan Reich, Kanghua Wu, Khoi Pham, Kim Trang Leaf, Kris Katsanevas, Kuo-Feng Hsu, Kushal Adhvaryu, Liyu Wang, Manish Khettry, Matthew Miao, Mayoor Rai, Momo Jiao, Nakul Tirumalai, Patrick Boocock, Patrick Cullen, Qi Guo, Qichao Que, Queenie Li, Ratish Nair, Sanyogeeta Lawande, Satvik Eltepu, Sean Chen, Shijie Xie, Shuai Zhang, Shuoyan Yin, Smruthi Gowtham, Tsung-Yi Huang, Tyler Pell, Wanting Jiang, Wanyu Li, Weiwei Jiang, Xiangyu Xu, Xin Wang, Xinyang Feng, Yanchen Wang, Yibo Zhu, Yihao Li, Yihui Saw, Yinjie Huang, Yu-Wei Wu, Yuchen Shao, Yue Wang, Yue Zhang, Yuhan Yang, Yuqi Shen, Zhen Hang Jiang, Zhiyu Liu, Zhongwei Teng, Zijiang Yang, Zoe Zu
Мы также благодарим следующих руководителей за поддержку и активное участие (в алфавитном порядке):
Ashish Gandhe, Helen Kong, Hongjie Bai, Meng Wu, Yaping Zhang, Yisong Song, Zellux Wang, Zhe Wang
