Интеллектуальная доставка: как каждый вычислительный ресурс помогает показывать более эффективную рекламу
- Intelligent Delivery с 2017 года до первой половины 2026-го повысила качество ранжирования рекламы примерно на 10% сверх улучшений моделей и системы.
- В офлайн-тестах на основных площадках новая модель примерно на 20% точнее определяла запросы, которым дополнительные вычисления принесут пользу.
- Ресурсы распределяются между регионами, типами оборудования и запросами; трафик между регионами перенаправляется каждые несколько минут.
Почему это важно: Система помогает запускать передовые модели, эффективнее использовать вычислительные ресурсы и показывать пользователям более подходящую рекламу.
- Модели ранжирования рекламы масштабируются до уровня LLM быстрее, чем успевает развиваться аппаратное обеспечение для их запуска. Дополнительная единица вычислительных ресурсов сильнее влияет на одни рекламные запросы, модели и чипы, чем на другие. Задача — определить, куда направить эти ресурсы, чтобы добиться наилучшего результата для всей системы.
- Мы создали Intelligent Delivery — систему на базе машинного обучения, которая распределяет ресурсы между уровнями обслуживания, стремясь к оптимуму для всей системы. С 2017 года она обеспечивает около 10% дополнительного прироста качества ранжирования сверх улучшений моделей и системы.
- Мы расскажем о некоторых возможностях Intelligent Delivery: о том, как мы создаём модели машинного обучения для прогнозирования предельной полезности вычислительных ресурсов, о многоуровневых механизмах их перераспределения по системе и о том, как мы всё активнее используем агентный ИИ, чтобы постоянно выявлять изменения в системе и реагировать на них.
По мере того как передовые системы ранжирования рекламы переходят к более крупным моделям, более широким наборам кандидатов и более сложным архитектурам доставки, требования к эффективности обслуживания также растут. Вычислительные ресурсы не увеличиваются так же быстро, как модели и сложность систем. Задача заключается не только в том, чтобы создавать более мощные модели, но и в том, чтобы эффективно эксплуатировать их в неоднородной системе с ограниченными возможностями обслуживания и жёстким бюджетом задержки. Недавно мы рассказали, как используем простаивающие мощности для инференса. В этой статье мы расскажем, как определяем, куда направить каждую единицу вычислительных ресурсов, чтобы обеспечить глобально оптимальную эффективность системы.
Intelligent Delivery — наш подход к решению этой задачи. С 2017 года по первую половину 2026 года он обеспечил дополнительное улучшение качества ранжирования рекламы примерно на 10% сверх результатов развития моделей и системы на основных площадках. Это адаптивный оптимизационный слой на базе машинного обучения, который всё больше управляется ИИ и непрерывно направляет ресурсы к запросам, моделям, паркам оборудования и этапам ранжирования с наибольшей предельной полезностью. Благодаря этому мы эффективно запускаем в производственной среде передовые модели ранжирования рекламы, получая больше от каждой единицы вычислительных ресурсов и показывая более подходящую рекламу пользователям наших приложений и сервисов.
Цель и сложности на пути к ней
Одна из наших целей — создать систему доставки, которая непрерывно приближается к глобальному оптимуму независимо от изменений в поведении пользователей, развития моделей и усложнения стека обслуживания.
Этой задаче мешают три фундаментальных свойства систем доставки рекламы:
Предельное влияние вычислительных ресурсов сильно различается и зависит от контекста: Одна и та же дополнительная единица вычислительных ресурсов может приносить совершенно разную отдачу в зависимости от площадки, намерений пользователя, качества кандидатов и состояния системы. Одних сигналов, учитывающих особенности запроса, недостаточно: для эффективного распределения ресурсов нужно оценить отдачу от каждого доступного настраиваемого параметра системы для каждого запроса, причём каждый параметр по-разному действует на разных этапах воронки. Нам нужно за миллисекунды рассчитывать результат для каждого запроса в огромном пространстве решений.
Локальный оптимум не означает глобального оптимума: Оценка результата — лишь первый шаг: стек обслуживания также должен быть динамически управляемым. Доставка рекламы охватывает многоэтапное ранжирование, сотни моделей, несколько поколений оборудования и множество центров обработки данных. Без адаптивных механизмов управления, учитывающих сложные зависимости на всех уровнях стека, невозможно свободно и надёжно перераспределять ресурсы между ними.
Глобальный оптимум постоянно меняется: Ландшафт оптимизации непрерывно сдвигается. Каждая новая модель, поколение оборудования или архитектура меняет его и может сделать ранее оптимальные решения о распределении ресурсов неэффективными. Чтобы сохранять оптимальность, система должна достаточно быстро адаптироваться.
В Intelligent Delivery предусмотрены три возможности, каждая из которых решает одну из этих фундаментальных задач системы.
Возможности Intelligent Delivery
1. Понимание запросов: общий интеллектуальный слой машинного обучения для распределения вычислительных ресурсов
Некоторые рекламные запросы выигрывают от дополнительных вычислений больше, чем другие. Сначала мы учитывали эти различия с помощью грубого сегментирования: запросы группировались по таким признакам, как площадка, контекст и представление рекламного креатива, а инженеры создавали правила распределения ресурсов для каждой группы. Такой подход помог улучшить результаты, но не масштабировался. Каждому новому сигналу соответствовало всё больше правил, и поддерживать их стало невозможно. Кроме того, отдельные сегменты не учитывали нелинейные взаимосвязи между тысячами сигналов, что ограничивало точность.
После того как мы сформулировали эту задачу как две задачи машинного обучения, в офлайн-тестах на основных площадках нам удалось примерно на 20% повысить точность определения рекламных запросов, которые сильнее всего выигрывают от дополнительных вычислительных ресурсов, по сравнению с предыдущей производственной моделью: Для каких рекламных запросов дополнительные вычислительные ресурсы с наибольшей вероятностью принесут пользу? И как разные настройки ресурсов повлияют на результаты и производительность обслуживания?
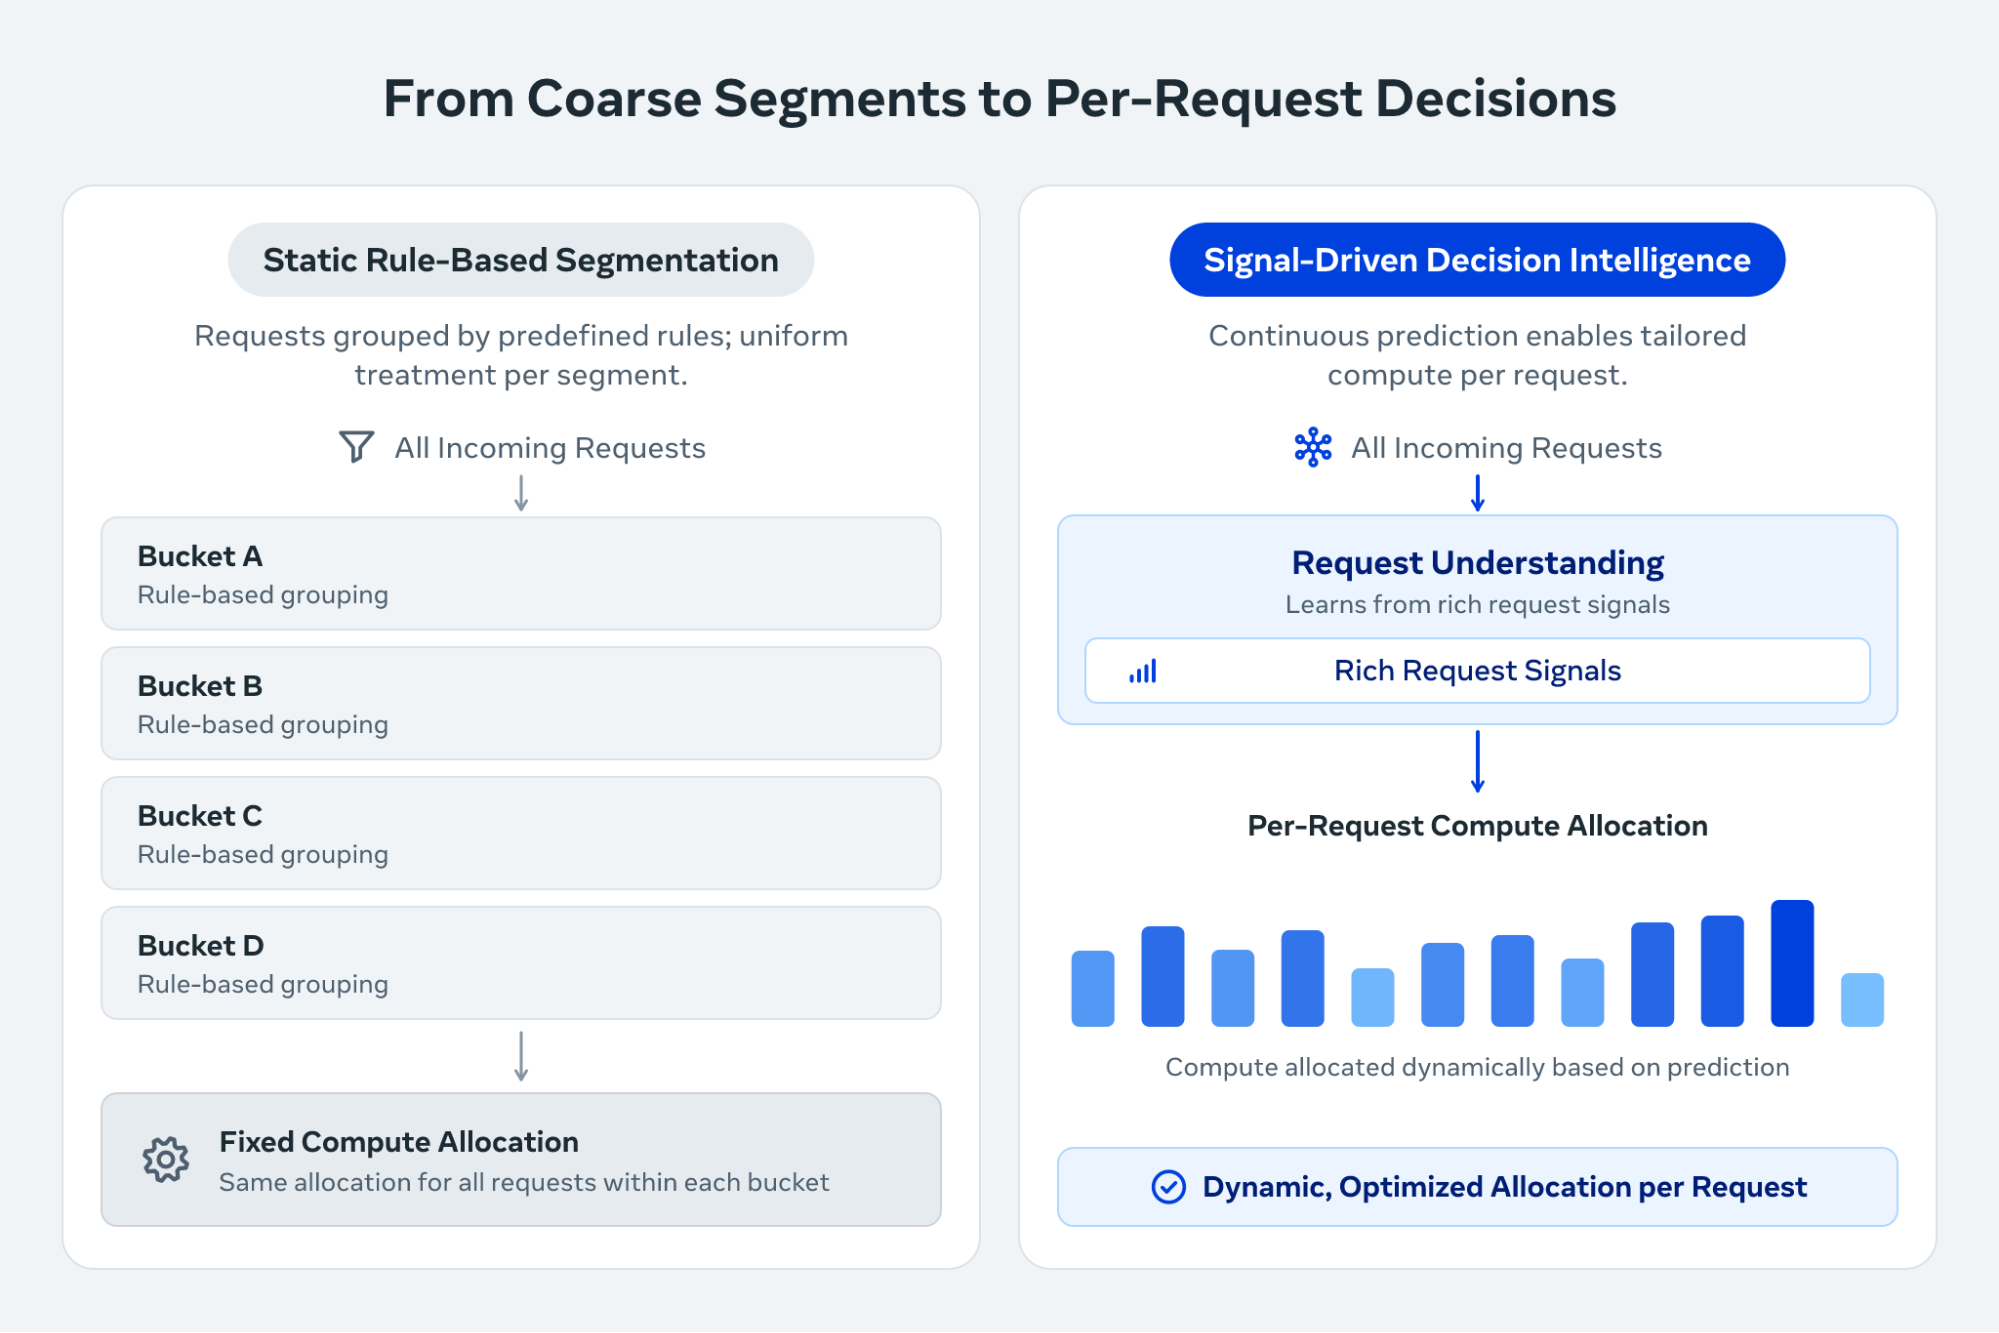 Сравнение бок о бок статического сегментирования по правилам, при котором все запросы в одной группе получают одинаковый объём вычислительных ресурсов, и решений на основе сигналов, где модель машинного обучения определяет нужный объём ресурсов для каждого запроса.
Чтобы ответить на первый вопрос, мы создали Resource Core Model — модели глубокого обучения с 6 млрд разреженных параметров и 20 млн плотных параметров. Они запускаются один раз перед извлечением кандидатов и используются на всех этапах доставки. Обученные эмбеддинги и глубокие взаимодействия признаков позволяют улавливать тонкие закономерности запросов, которые невозможно описать сегментами, заданными вручную.
Затем мы дообучаем Resource Core Model, получая набор специализированных моделей, каждая из которых формирует дополнительные сигналы о результате, потреблении вычислительных ресурсов и влиянии на задержку. Вместе они образуют общий интеллектуальный слой машинного обучения для распределения ресурсов: Resource Core Model анализирует каждый запрос и особенности его обслуживания, а отдельные механизмы определяют, как преобразовать эти прогнозы в действия.
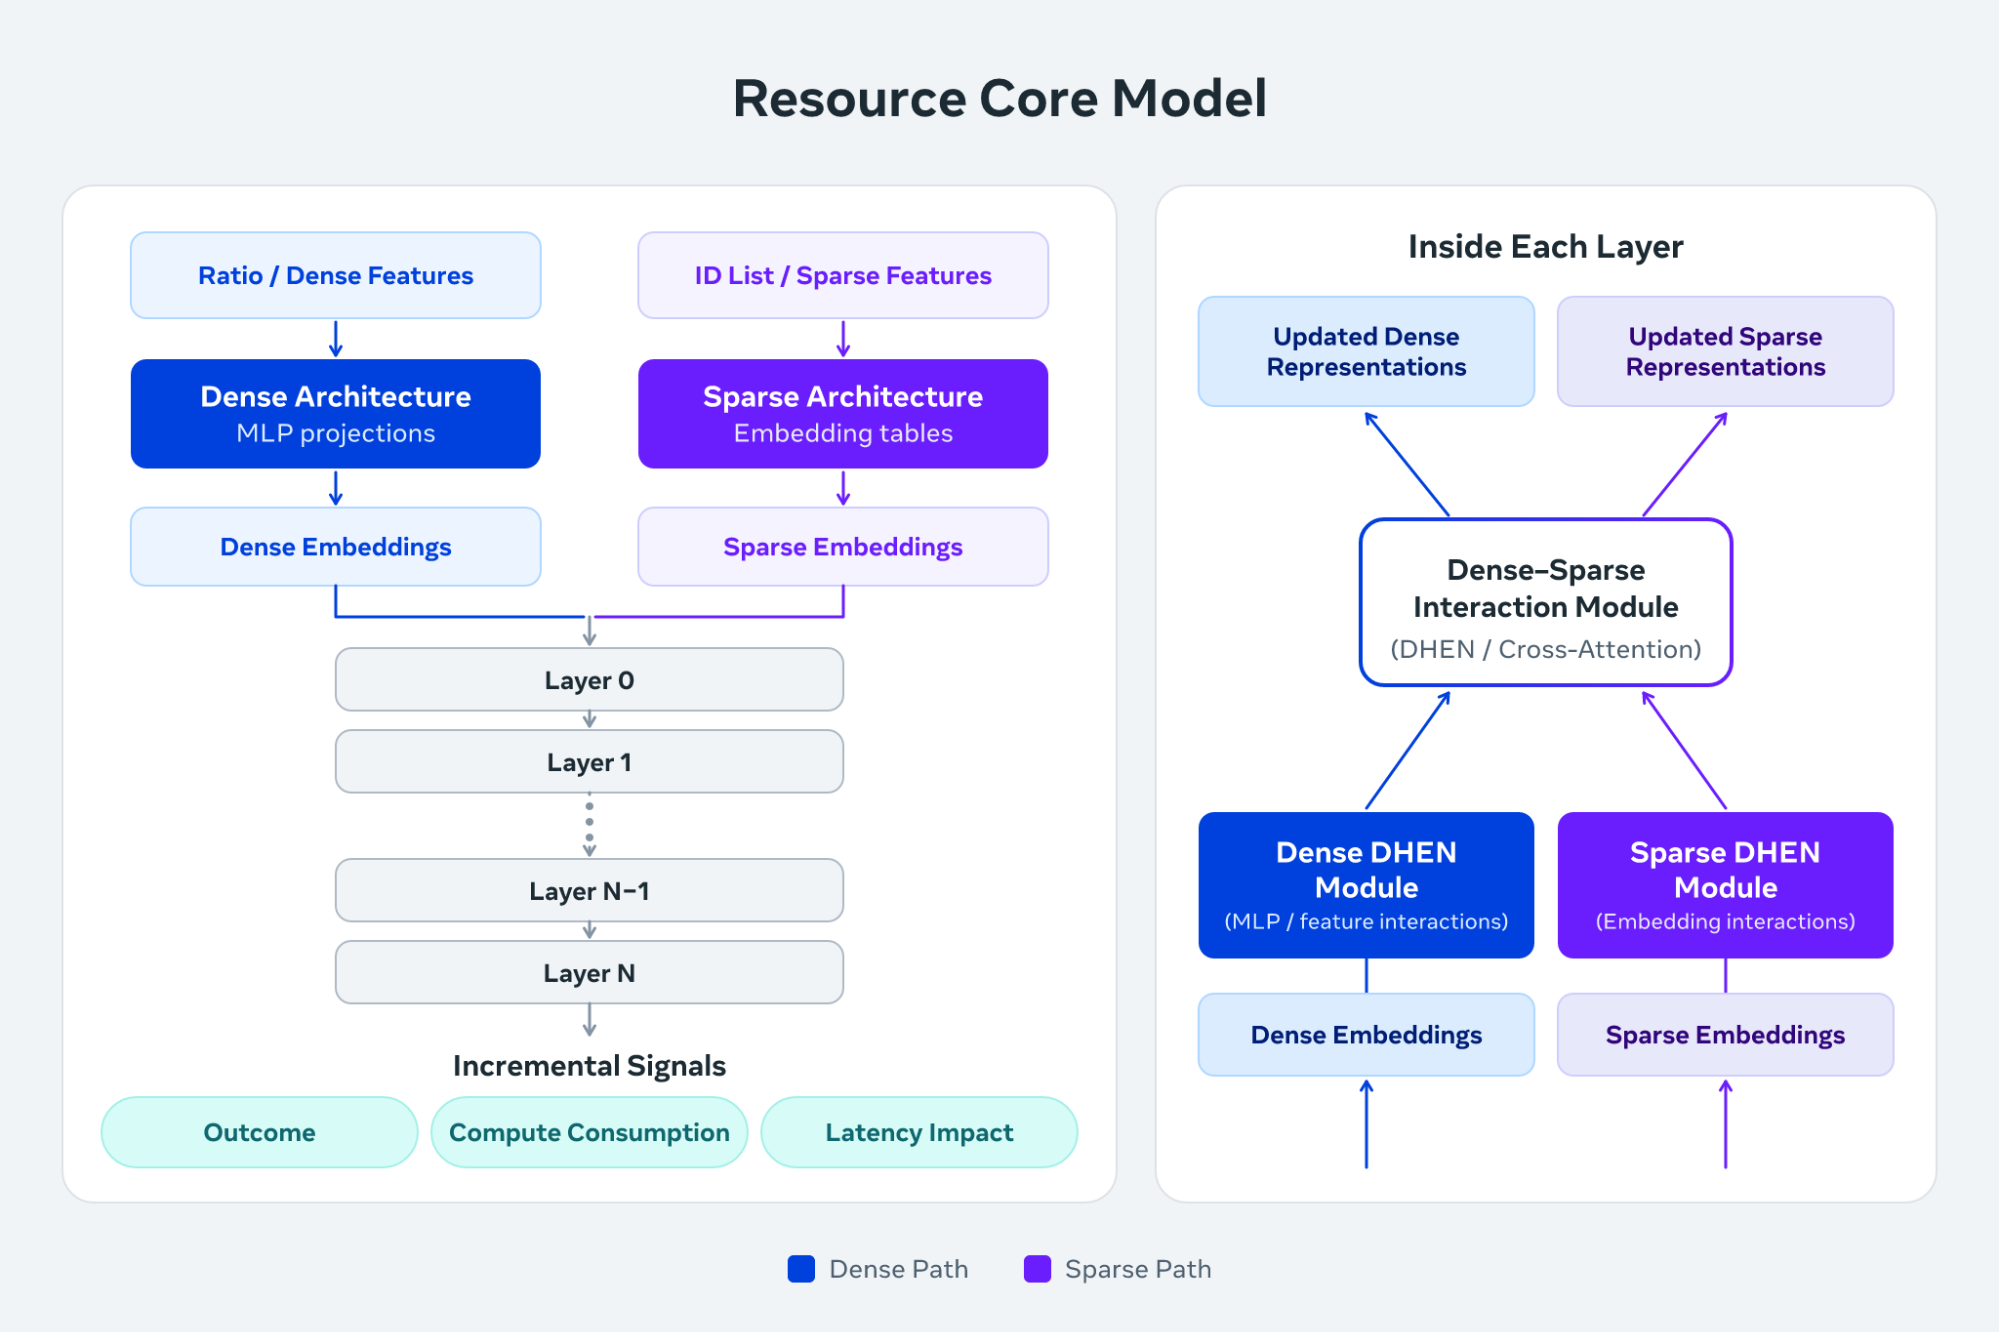 Архитектурная схема Resource Core Model: плотные и разреженные признаки запроса проходят через последовательность слоёв взаимодействия, чтобы предсказать результат для каждого запроса, потребление вычислительных ресурсов и влияние на задержку.
2. Механизмы распределения ресурсов: иерархия механизмов принятия решений
Обслуживание рекламы выполняется на глобально распределённом неоднородном парке оборудования: множество регионов центров обработки данных, несколько поколений оборудования и миллионы хостов, совместно используемых многоуровневым стеком обслуживания. Один механизм распределения не может управлять сложным распределением ресурсов от начала до конца. Поэтому мы разделили задачу на иерархию уровней и создали для каждого отдельный механизм принятия решений. Лучше всего понять эту иерархию, проследив путь одного запроса.
Пользователь открывает ленту. Создаётся рекламный запрос, который в течение следующих нескольких сотен миллисекунд проходит через цепочку решений о распределении ресурсов. Это приводит нас к трём важным вопросам и ответам на них.
Какой регион его обслуживает? Трафик и вычислительные мощности размещены в разных местах, а в каждом регионе свой состав оборудования и запас свободных ресурсов — поэтому одна и та же единица вычислительных ресурсов эффективнее работает в одних регионах, чем в других. Мы создали инфраструктуру реального времени, которая динамически перенаправляет трафик между регионами с интервалом в несколько минут, стремясь к точке, в которой предельная единица мощности работает с одинаковой эффективностью в каждом регионе.
На каком оборудовании он будет обработан? В нашем парке есть процессоры Intel, AMD и Arm, а также ускорители NVIDIA, AMD и собственной разработки — Meta Training and Inference Accelerator (MTIA), причём для каждого типа представлено несколько поколений. Сложность не в разнообразии оборудования, а в том, что его ресурсы не взаимозаменяемы. Разным этапам нужны разные ресурсы: извлечению кандидатов — объём памяти, ранжированию — вычислительная мощность, а инференсу моделей — пропускная способность ускорителей. Поэтому не существует одного самого быстрого SKU — есть лишь оптимальный вариант для каждой рабочей нагрузки. Мы измеряем эффективность каждой пары «рабочая нагрузка — SKU», а затем решаем, как распределить оборудование, чтобы дефицитные ресурсы доставались тем задачам, которые принесут от них наибольшую пользу.
Какая доля ресурсов хоста достанется запросу? Одновременно обрабатываемые запросы отличаются бюджетом задержки и значимостью, при этом действует жёсткое ограничение SLO по хвостовой задержке. С помощью наших передовых моделей глубокого обучения мы в реальном времени прогнозируем ожидаемый результат каждого запроса, а также затраты вычислительных ресурсов и задержки, после чего решаем задачу условной оптимизации, чтобы максимизировать эффект в рамках бюджета задержки хоста. По мере роста нагрузки на хост увеличивается компромисс между производительностью и качеством: в первую очередь сокращается объём ресурсоёмкой работы с небольшим эффектом. Для выполнения этих решений необходимо управлять всем стеком, поэтому инфраструктура охватывает всё — от планировщика на уровне ядра до пулов потоков на уровне приложения.
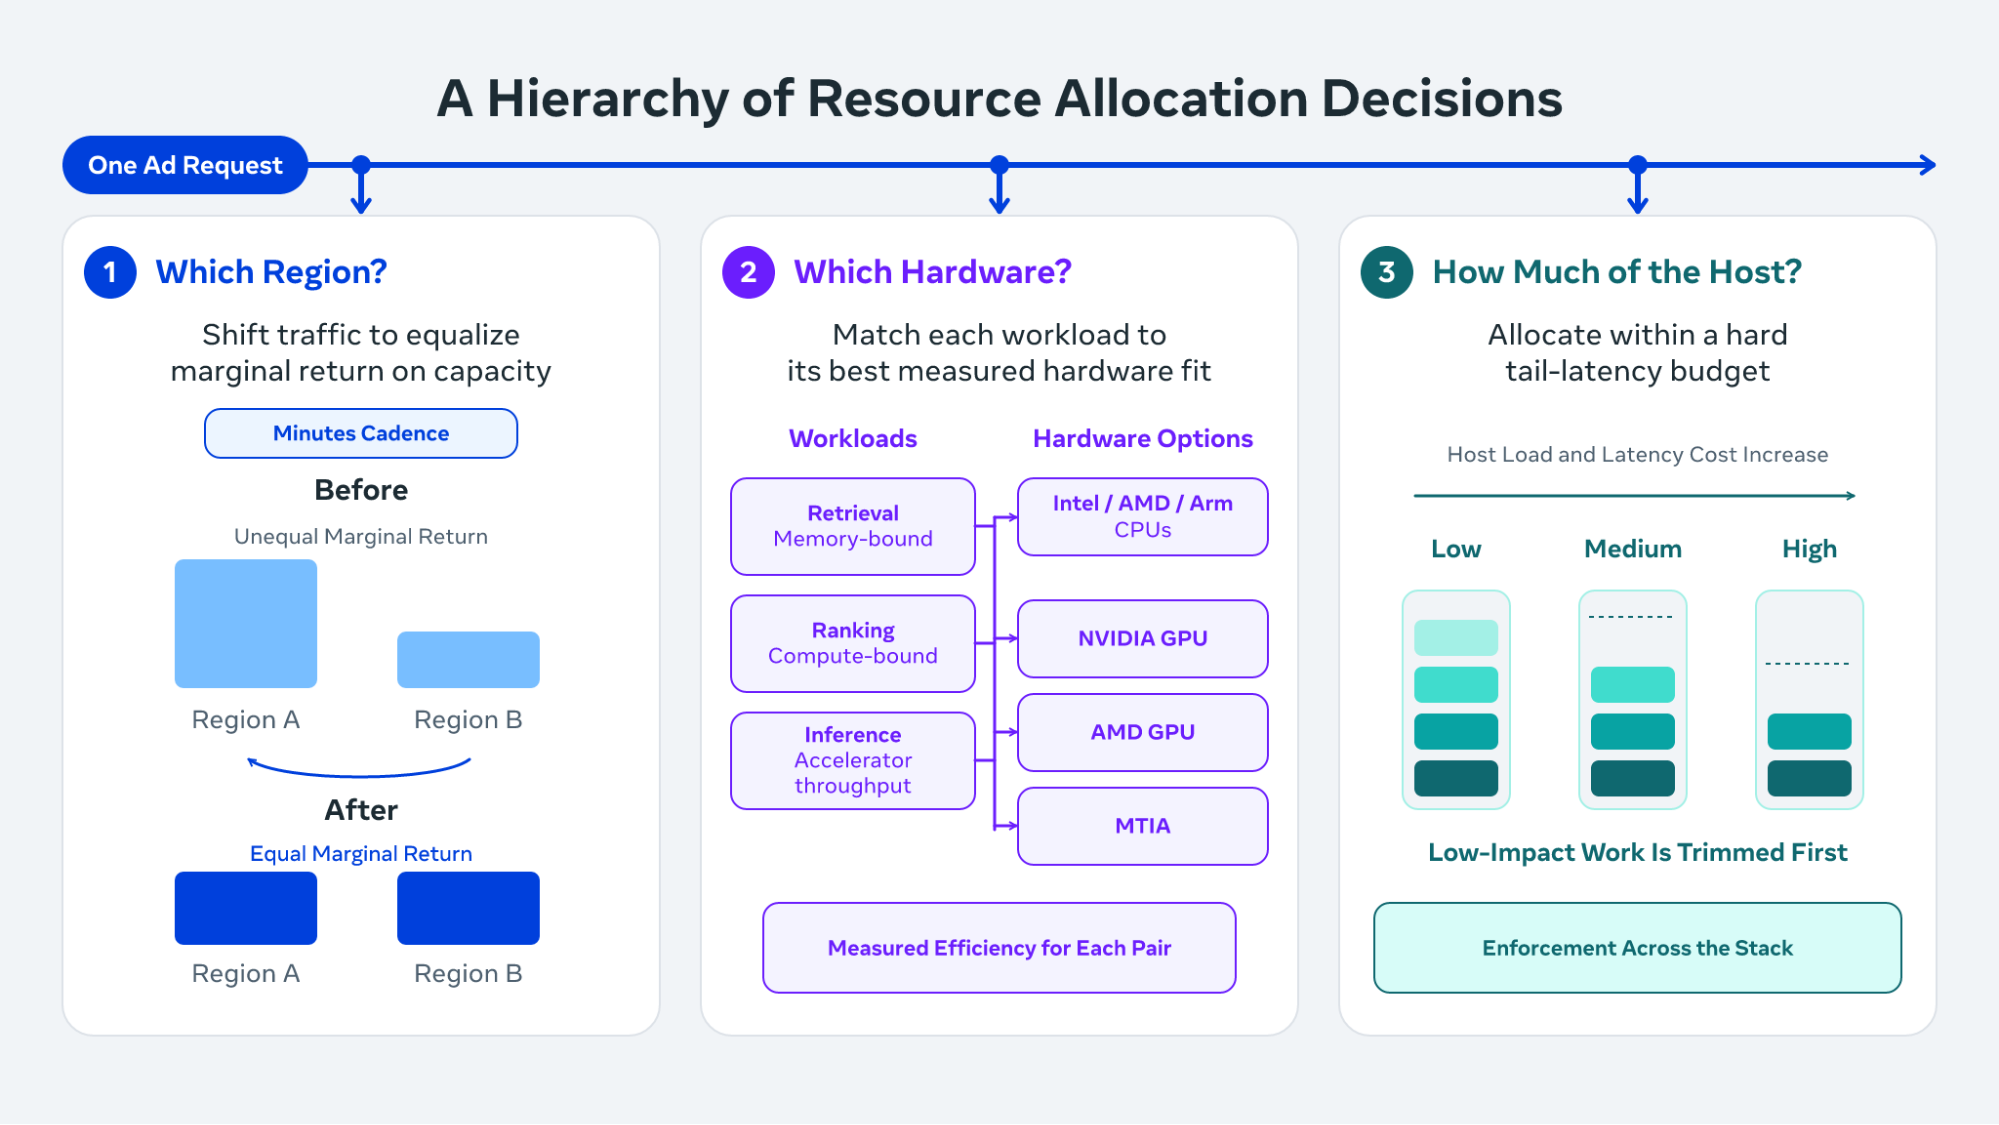 Блок-схема из трёх шагов, показывающая путь одного рекламного запроса через иерархию принятия решений: какой регион его обслуживает, на каком оборудовании он выполняется и какая доля ресурсов хоста ему выделяется.
Эти три шага — лишь часть решений о распределении ресурсов, которые мы принимаем в течение жизненного цикла запроса. Кроме того, мы оптимизируем количество объявлений для ранжирования на каждом этапе для каждого запроса, состав рекламных кандидатов и многое другое.
Эти решения о распределении ресурсов тесно связаны, поэтому изменение в одном из них отражается на всей системе. Перенаправление трафика между регионами меняет нагрузку на отдельные хосты, что влияет на контур обратной связи, определяющий объём работы для каждого запроса. Мы проверяем эти изменения в сквозной замкнутой среде тестирования оборудования, чтобы убедиться, что оптимизируем систему в целом, а не отдельный её участок.
3. Цикл оптимизации: самооптимизирующееся обслуживание с помощью агентного ИИ
По мере развития нашей системы рекламы внедрение в неё новой модели, механизма или оборудования требует значительных усилий для бесшовной интеграции. Мы не можем перебором проверять каждую конфигурацию по миллионам настраиваемых параметров, заложенных в систему, при каждом новом изменении. На это ушло бы слишком много времени и потребовалось бы гораздо больше аппаратных ресурсов, чем у нас есть.
При поиске перспективных конфигураций мы в значительной степени полагались на опыт специалистов и знания, накопленные инженерами. Но такой подход не масштабировался: каждая новая модель, механизм и поколение оборудования расширяли пространство поиска быстрее, чем инженеры могли его исследовать.
Мы попытались автоматизировать этот процесс с помощью условной оптимизации. Она улучшила результаты, но оставалась негибкой и медленной. Выяснилось, что ей не хватает способности к обобщению — она могла учитывать лишь несколько ключевых параметров — и что она не позволяет эффективно использовать интуицию специалистов, основанную на их предыдущем опыте.
Вместо слепого перебора ИИ-агенты непрерывно следят за состоянием всей системы, выявляя изменения и неэффективность, требующие внимания. В контекстном окне большого объёма агент анализирует исходный код механизмов, проектную документацию и журналы экспериментов за десять лет, а затем отбирает несколько изменений, которые стоит проверить. Перед внедрением инженеры изучают и утверждают окончательный вариант.
Уже сейчас агенты могут предлагать хорошо обоснованные изменения, а также разрабатывать и проводить строгие эксперименты. В первой половине 2026 года на долю агентов пришлось около 20% оптимизаций Intelligent Delivery. В рамках нашего наиболее автоматизированного механизма они теперь выполняют около 80% инженерной работы: от анализа системы и выдвижения гипотез до проведения экспериментов и выбора итогового изменения. Благодаря этому цикл оптимизации сокращается с месяцев до недель, а люди сохраняют полный контроль. Кроме того, система постепенно перенимает опыт, который инженеры накапливали годами.
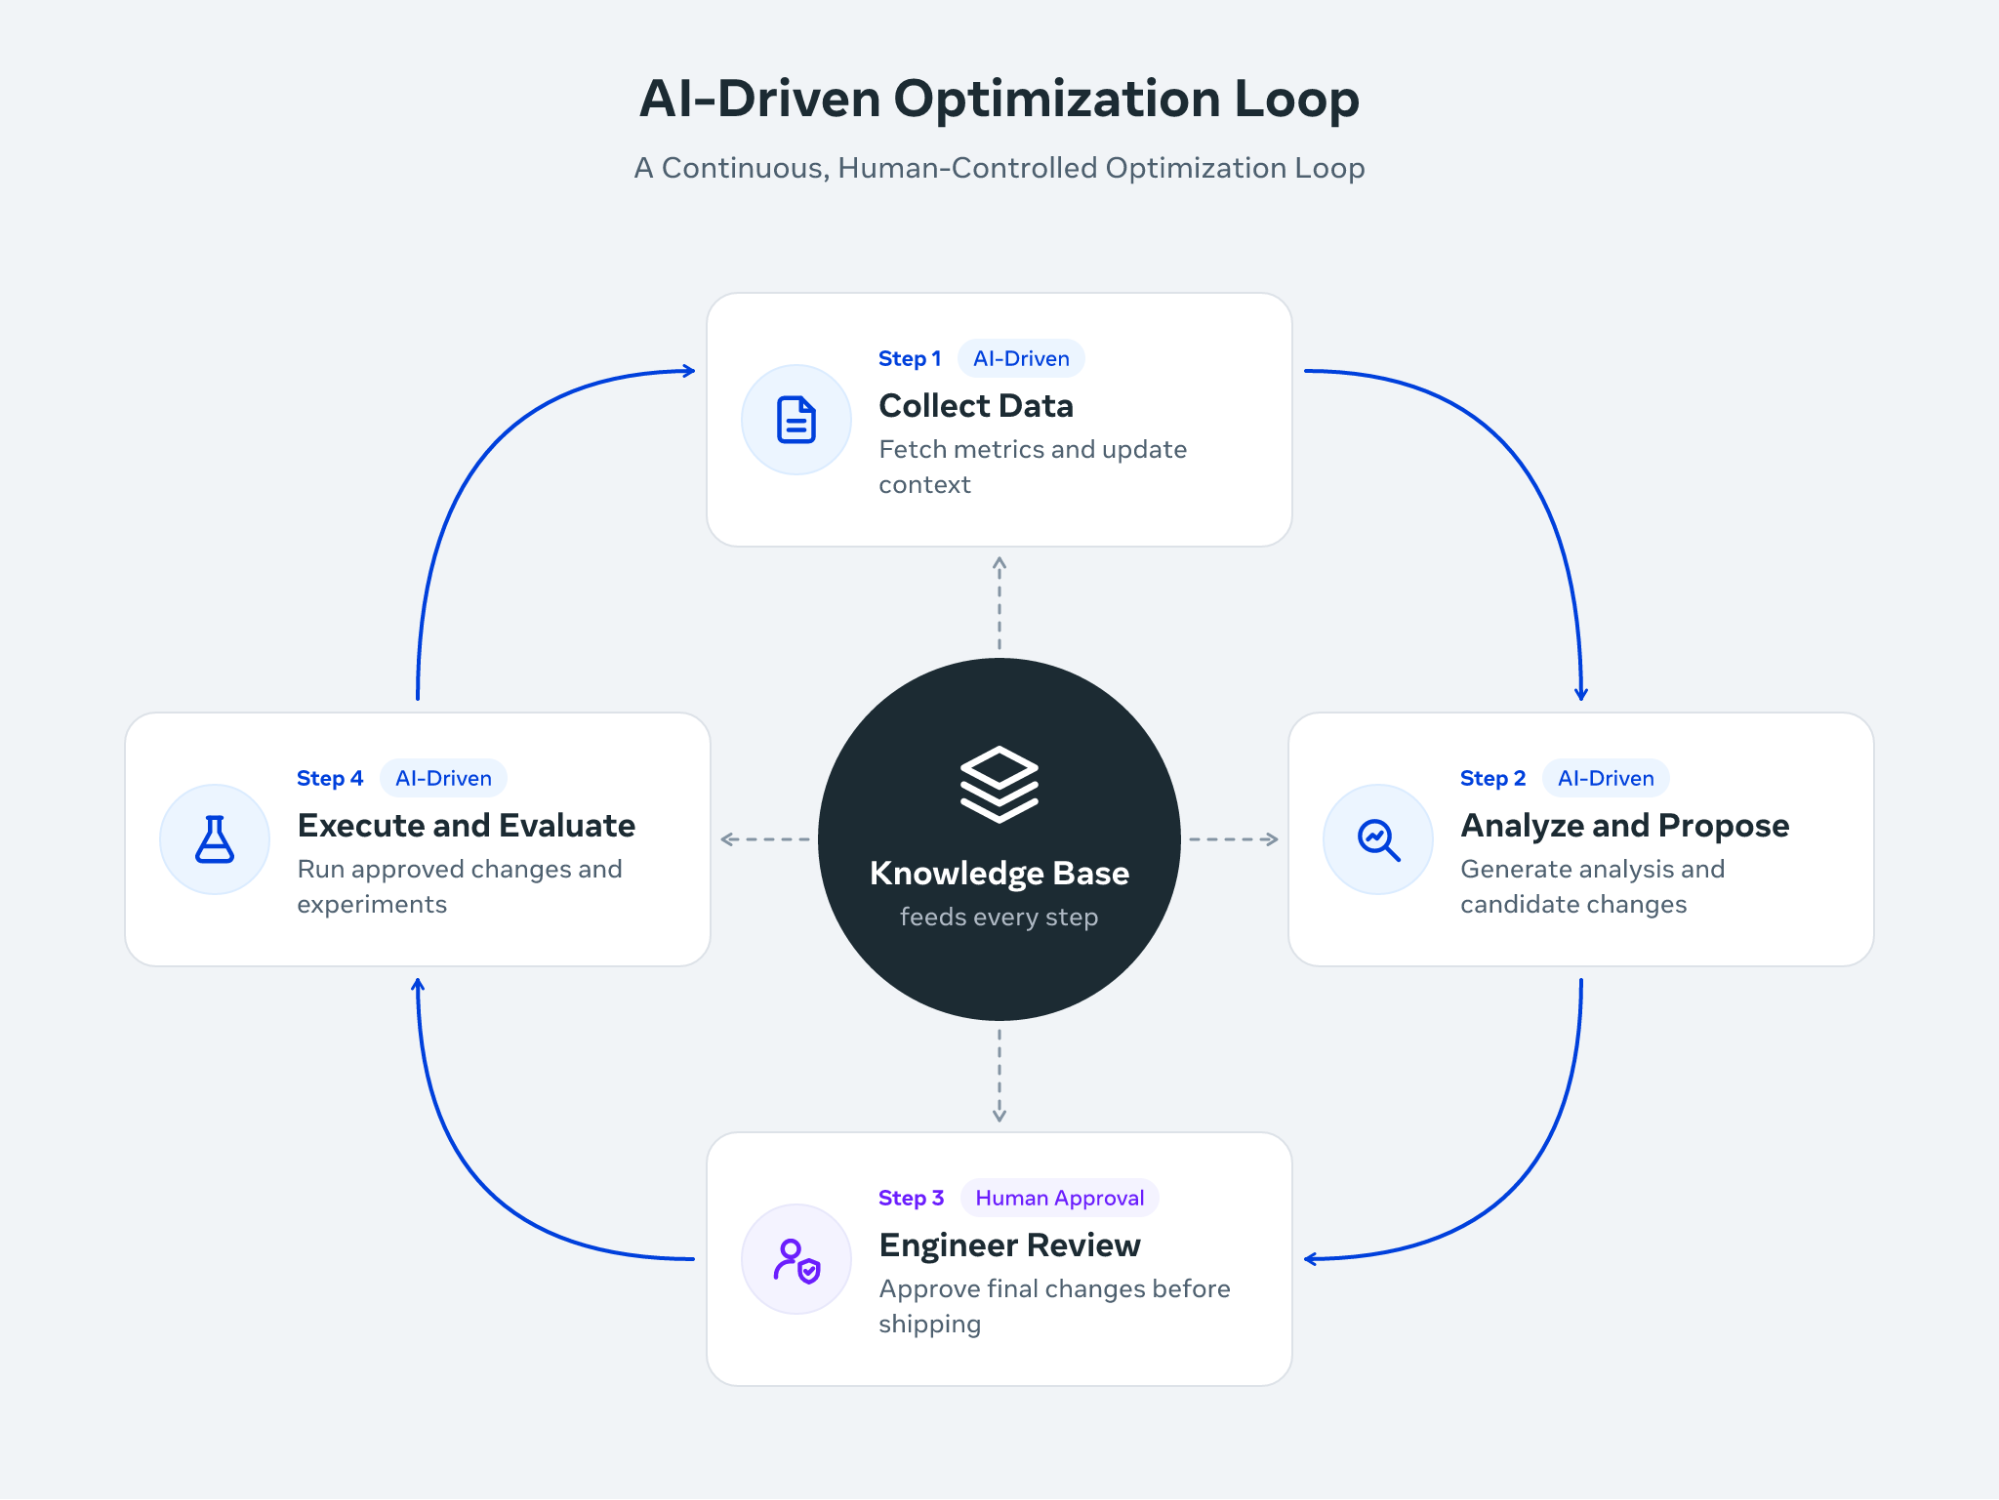 Схема цикла оптимизации на базе ИИ: агенты собирают данные, предлагают изменения и проводят эксперименты, инженер утверждает каждое изменение, а общая база знаний служит источником информации на каждом этапе.
Новые рубежи развития Intelligent Delivery
Сквозная оптимизация в реальном времени: Сегодня анализ запроса и решение о том, как его обслуживать, всё ещё представляют собой два отдельных этапа. Мы стремимся объединить их в одной модели, которая будет анализировать запрос и обслуживать его в реальном времени, без многомесячных экспериментов. Уже существуют наработки по адаптивному выделению вычислительных ресурсов для каждого запроса с помощью методов машинного обучения. Однако совместная оптимизация всех этапов обслуживания одновременно — с учётом меняющегося трафика, жёстких ограничений по мощности и тесной взаимозависимости этапов — остаётся нерешённой задачей, над которой мы и работаем.
Обслуживание передовых моделей на GPU: Крупные модели ранжирования, такие как Meta«s Generative Ads Model (GEM), масштабируются до уровня LLM и всё чаще запускаются на GPU, что открывает новые возможности для оптимизации. Ресурсы GPU не делятся так же, как процессорное время: они выделяются фиксированными блоками, а пропускная способность, пакетная обработка и память работают иначе. Механизмы, созданные для мира CPU, нужно переосмыслить, и сейчас значительная часть нашей работы связана с изучением этих механизмов и поиском новых способов управления ими. Чем больше полезной работы удаётся получить от каждого ускорителя, тем больше людей мы можем обслуживать с помощью мощных моделей при тех же ресурсах.
Благодарности
Sowji Adavi, Karthik Alle, Tao Cai, Olivier Chaine, Jianhao Du, Antonio Frigo, Gayatree Ganu, Chao Li, Chao Ma, Bennet Matazzoni, Riddhi Mehta, Saurabh Pohnerkar, Sudhir Pokhrel, Yuehui Qian, Liang Qiao, Yitao Qiu, Rob Schwartzberg, Sanketh Shetty, Ganlin Song, Samuel Tatipamula, Xueqi Wang, Ye Wang, Wei Wei, Jing Xu, Haomin Yu, Jiayi Yu, Jay Zang, Caijie Zhang, Shengjie Zhang, Tong Zhang и Wei Zheng.
