Расширение LLDB для отладки приложений, работающих на CPU и GPU
- В lldb-server создана независимая от производителей архитектура плагинов для отладки приложений на CPU и GPU.
- CPU и GPU представлены отдельными целями отладки, доступными в одном сеансе LLDB; плагин координирует их работу.
- Meta передала в LLVM большую часть общей платформы, включая интерфейс плагинов, поддержку нескольких адресных пространств и имитационные тесты.
Почему это важно: Цель архитектуры — подключать новое оборудование к LLDB с помощью плагина производителя, а не отдельного отладчика.
- Мы создали в lldb-server нейтральную к производителям архитектуру плагинов-ускорителей для отладки приложений, работающих на CPU и GPU. Она отделяет общую инфраструктуру отладчика от управления устройствами, зависящего от конкретного оборудования.
- В этой архитектуре CPU и GPU представлены как отдельные процессы отладчика, но доступны в рамках одного сеанса отладки.
Современные приложения на базе ИИ редко выполняются в одном месте. Задача может начинаться в высокоуровневом фреймворке, а затем переключаться между нативным кодом CPU и ядрами, выполняющимися на GPU. Когда ошибка пересекает эти границы, разработчикам нужно понимать и приложение на хосте, и устройство.
Это сложнее, чем подключить обычный отладчик к другому процессу. CPU и GPU могут использовать разные наборы инструкций, регистры, адресные пространства и модели выполнения. Кроме того, GPU управляется средой выполнения и драйвером внутри процесса хоста, поэтому для отладки устройства часто требуется тщательно координировать действия с CPU.
Исторически производители GPU создавали специализированные отладчики для своих устройств, в том числе AMD ROCgdb и NVIDIA CUDA-GDB. Эти инструменты обеспечивают глубокую поддержку соответствующих платформ, но общие возможности отладчика часто приходится реализовывать и поддерживать отдельно.
В Meta мы разрабатываем для LLDB другой подход: общую архитектуру плагинов-ускорителей в lldb-server. В этой статье слово «GPU» обозначает конкретные устройства и примеры, а «ускоритель» — более широкую, нейтральную к производителям абстракцию плагинов LLDB. Архитектура развивается благодаря вкладу инженеров Meta и участников экосистемы ускорителей. Она позволяет общему отладчику не зависеть от какого-либо одного GPU и при этом предоставляет производителям оборудования отдельный компонент для реализации специфичного для устройства поведения.
Почему отладка GPU бросает вызов традиционным моделям отладчиков
Традиционный отладчик обычно предполагает, что у одного процесса одна архитектура и единообразное представление потоков, регистров и памяти. Программы для GPU ставят под сомнение каждое из этих предположений.
Процесс хоста может работать на x86–64, тогда как его ядра используют совершенно другой набор инструкций. У потока CPU есть привычный контекст регистров, а GPU может выполнять группы дорожек синхронно. Указатели хоста и устройства могут относиться к разным адресным пространствам. GPU может предоставлять тысячи исполняемых дорожек, которые плохо вписываются в модель потоков большинства консольных и графических отладчиков.
Объединение всего этого состояния в одну искусственную модель процесса усложняет отладчик. Для каждой операции сначала приходится определять, относится ли она к CPU или GPU. Работа с регистрами, чтение памяти, точки останова, пошаговое выполнение и события остановки начинают зависеть от выбранного оборудования. Единая модель процесса также вынуждает объединять CPU и GPU в одну карту памяти, хотя их адресные пространства могут быть независимыми: один и тот же адрес, например 0×1000, может указывать на разные места в процессах CPU и GPU.
Вместо того чтобы скрывать эти различия, архитектура ускорителей LLDB задаёт для них чёткую границу.
Поддержка плагинов в lldb-server для отладки GPU
В LLDB используется вспомогательный процесс под названием lldb-server для запуска программы или подключения к ней, а также для выполнения низкоуровневых операций отладки. Клиент LLDB взаимодействует с сервером по удалённому протоколу GDB — протоколу команд для таких операций, как чтение памяти, проверка регистров, управление выполнением и установка точек останова.
Поскольку lldb-server уже управляет нативным процессом, это также подходящее место для взаимодействия со средой выполнения ускорителя. Новый интерфейс плагинов позволяет специализированному для оборудования бэкенду работать вместе с обычным отладчиком CPU. Бэкенд преобразует API отладки устройства, предоставляемый производителем, в понятия, уже знакомые LLDB: процессы, потоки, регистры, память, модули и причины остановки.
Такое разделение позволяет клиенту LLDB оставаться нейтральным к производителям. Общие улучшения командной строки, удалённого протокола, обработки символов и интеграции со средами разработки могут принести пользу всем ускорителям. При этом каждый производитель отвечает за особенности своего оборудования и стека драйверов.
Поддержка отладки GPU активируется, только если отлаживаемое приложение использует поддерживаемую среду выполнения GPU. Для приложений, работающих только на CPU, LLDB и lldb-serverпродолжают использовать существующий путь нативной отладки, не создавая дополнительных вычислительных накладных расходов во время выполнения.
Две цели отладки — единый процесс
В этой архитектуре CPU и ускоритель представлены как отдельные цели отладки LLDB.
У каждой цели своя архитектура, а также связанный с ней процесс отладчика, который отслеживает потоки, регистры, адресное пространство и состояние выполнения. Для CPU по-прежнему используется проверенный нативный механизм отладки LLDB. Когда становится доступен ускоритель, плагин предоставляет второе подключение, с помощью которого LLDB создаёт цель отладки для устройства.
С технической точки зрения две цели отладки остаются независимыми. Для разработчика же они могут быть доступны в одном сеансе LLDB или IDE. Это позволяет не объединять несовместимые понятия CPU и GPU в одну модель процесса и при этом сохранить единый рабочий процесс.
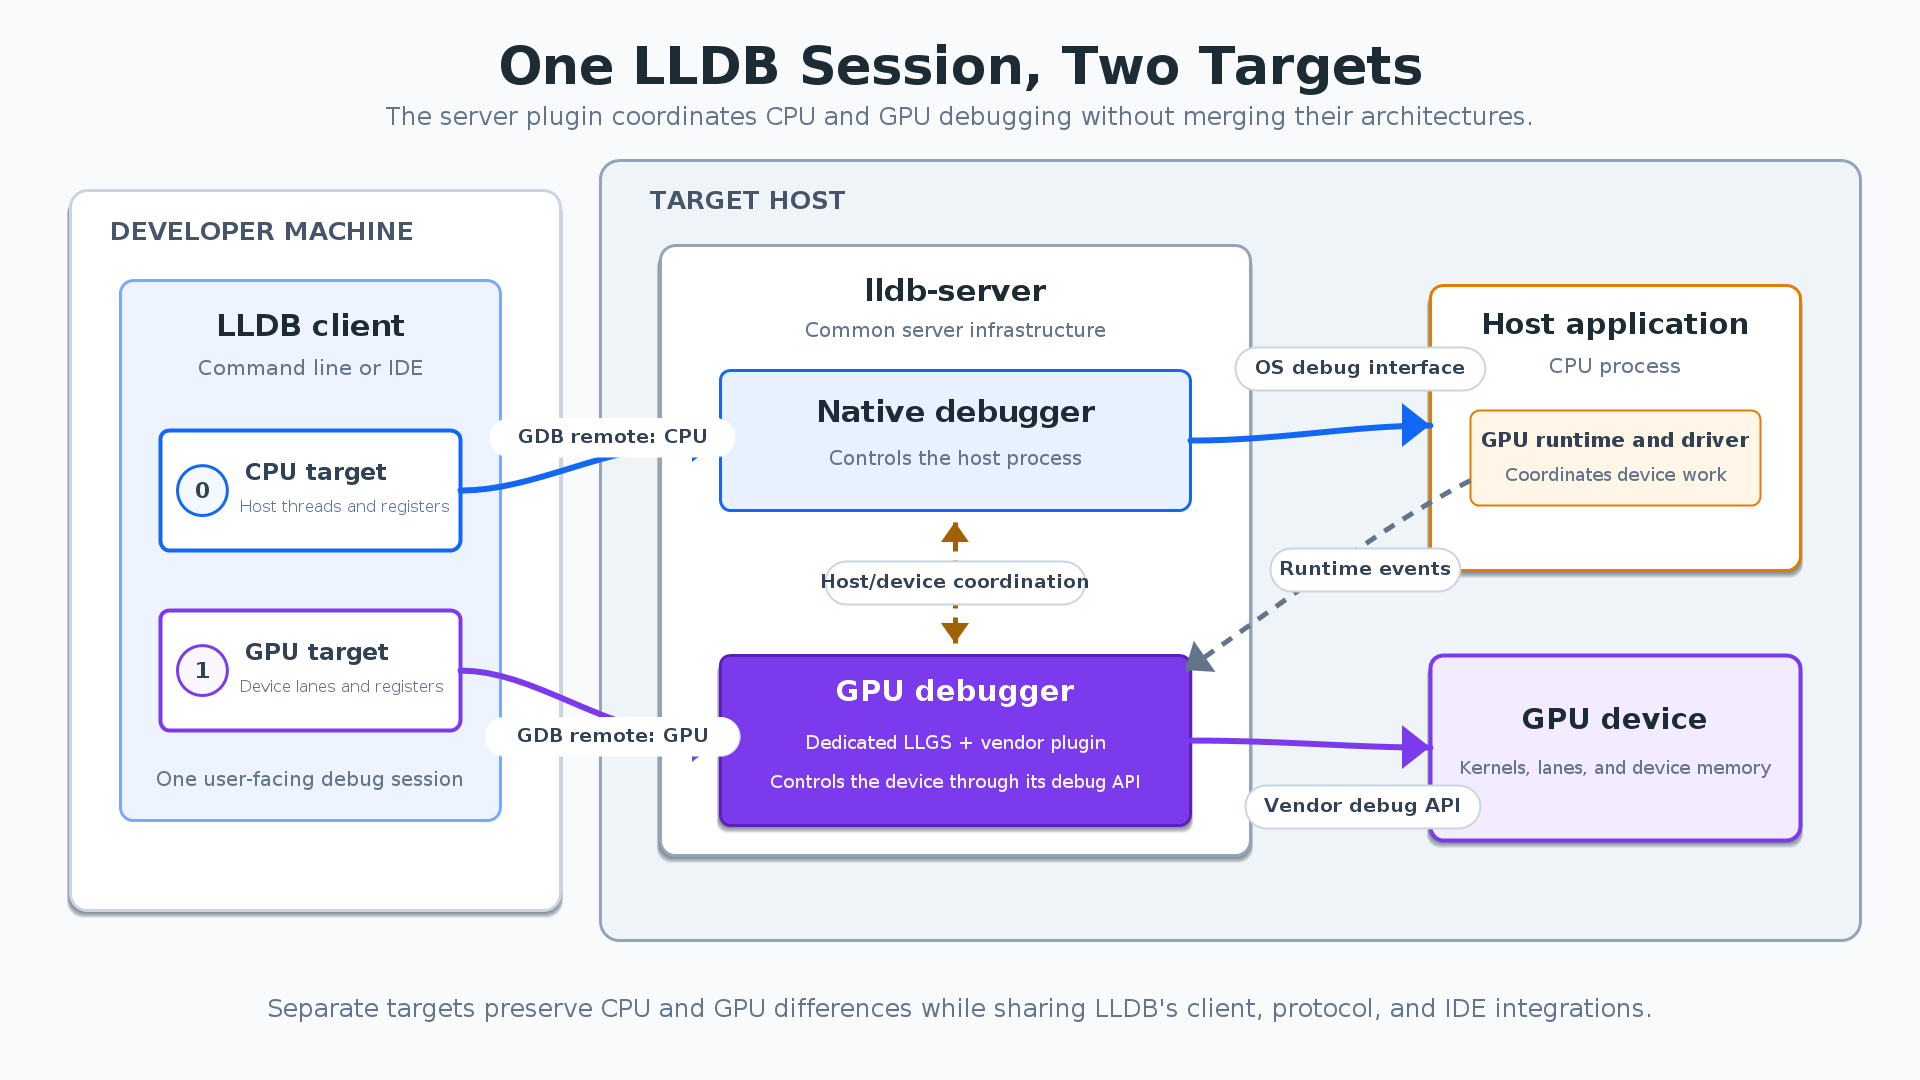 CPU и GPU остаются отдельными целями отладки LLDB, а плагин в lldb-server координирует отладку хоста и устройства.
Координация хоста и устройства
Типичный сеанс отладки состоит из нескольких шагов:
- LLDB подключается к lldb-server и определяет, какие плагины-ускорители доступны.
- Плагин может попросить LLDB установить внутренние точки останова в процессе хоста. Эти точки обозначают важные события среды выполнения, например момент, когда можно начать сеанс отладки GPU.
- Когда хост достигает одной из таких точек, lldb-server уведомляет плагин. Плагин инициализирует API отладки производителя и подготавливает конечную точку для отладки ускорителя.
- LLDB создаёт для ускорителя вторую цель отладки и подключается к ней. После этого для потоков устройства, регистров, памяти, модулей и точек останова можно использовать существующие абстракции LLDB.
Для координации обеих сторон используются структурированные действия. Плагин может запрашивать точки останова на CPU, передавать сведения для подключения, сообщать о модулях устройства и синхронизировать выполнение на хосте и устройстве. Общий протокол описывает необходимые действия отладчика, не раскрывая клиенту LLDB подробности API конкретных производителей.
Мы также создали имитационный плагин-ускоритель, который позволяет проверять этот процесс без специального оборудования. С его помощью набор тестов LLVM проверяет обнаружение плагинов, координацию точек останова, создание подключений и базовое состояние устройства. Это оказалось важным для разработки общей инфраструктуры, которую можно независимо проверять и анализировать без привязки к какому-либо конкретному GPU.
Типичный сценарий отладки GPU
Вот сокращённый сеанс, полученный с помощью примера HIP с вычислением скалярного произведения векторов:
|
| Отложенная точка останова срабатывает при загрузке модуля GPU, а трассировка стека получена из цели отладки GPU. |
Общая платформа плагинов для производителей оборудования
Граница между плагином и отладчиком намеренно определяется операциями отладки, а не понятиями, специфичными для конкретной платформы GPU. Благодаря этому архитектура подходит для устройств с совершенно разными наборами инструкций, API сред выполнения и моделями исполнения.
Платформа поддерживает как посмертную отладку GPU, так и отладку в реальном времени. Плагины дампов ядра GPU используют общий базовый класс для интеграции с LLDB, а реализации производителей предоставляют специфичные для устройства сведения о потоках, регистрах, памяти и модулях.
Команды Meta, работающие над отладкой GPU, уже используют эту архитектуру. Поскольку мы эксплуатируем неоднородный парк GPU с разными аппаратными и программными стеками, тот факт, что эти команды используют одну и ту же модель, служит важным подтверждением правильности архитектуры: общий слой LLDB может оставаться стабильным, а каждый бэкенд — точно описывать своё устройство.
На момент написания статьи мы передали в LLVM большую часть общей платформы. В неё входят интерфейс плагинов lldb-server; пакеты удалённого протокола GDB для обнаружения плагинов, инициализации, координации событий среды выполнения и создания подключений к GPU; поддержка связывания процессов-отладчиков CPU и GPU с сохранением независимых архитектур; поддержка нескольких адресных пространств и аппаратно-независимые имитационные тесты. Оставшиеся компоненты мы планируем передать в LLVM в ближайшее время.
Дальнейшие планы
Далее мы планируем завершить передачу оставшейся общей инфраструктуры в LLVM и расширить построенные на её основе интеграции с производителями. Наша цель — сделать так, чтобы для интеграции нового оборудования с LLDB требовался только плагин производителя, а не отдельный отладчик, который нужно создавать и поддерживать.
Благодарности
Мы благодарны руководящей команде Meta по инфраструктуре разработки, особенно Shane Nay, Todd Fiala и Ale Contenti: их непосредственная поддержка сделала эту работу возможной.
Мы также благодарим коллег из команды отладки и инструментов — Jacob Lalonde, David Young, Alexandre Perez, Zhiyuan Li, Piyush Jaiswal и Philip DePetro — за сотрудничество и поддержку.
Наконец, мы благодарим сообщество открытого кода, особенно Jonas Devlieghere, Jim Ingham, David Spickett и Jason Molenda, за рецензирование RFC и запросов на включение изменений в основную ветку.
