Как устроена новая архитектура хранения Git в GitHub
- Внутренние испытания показали: 5 000 агентов работали с одним репозиторием, принимающим 7 200 пушей в секунду, при низкой задержке чтения.
- В Rubicon объекты Git хранятся в Azure Blob Storage, а ссылки и манифест пакетов — в журнале Ref-CAS.
- Виртуальные реплики обрабатывают чтение и запись, а отдельные узлы компактизации объединяют пакеты и удаляют недостижимые объекты.
Почему это важно: Архитектура станет основой поддержки агентной разработки на GitHub для сотен миллионов разработчиков.
На прошлой неделе на GitHub Universe мы представили новую архитектуру хранения Git, способную обрабатывать тысячи записей в секунду и масштабировать чтение по мере необходимости. В ходе внутренних испытаний мы показали, что система поддерживает работу 5 000 агентов с одним репозиторием одновременно, принимая 7 200 пушей в секунду и при этом обеспечивая стабильно низкую задержку при чтении. Эта новая архитектура станет основой для поддержки агентной разработки на GitHub для сотен миллионов разработчиков. Мы создавали её непосредственно на работающей платформе GitHub, не прерывая её работу.
За последний год агенты изменили представление о том, что значит «загруженный репозиторий» на GitHub. В первой статье этой серии мы изложили два принципа, лежащих в основе нового поколения архитектуры хранения Git: свести координацию к минимуму и отделить хранилище от вычислений. В предыдущей статье мы рассказали о промежуточном этапе: переносе 99,99999% репозиториев в Azure, ограничении кворума записи отдельными ссылками и запуске виртуальных реплик на базе Azure Blob Storage.
Мы также остановились на одном наблюдении: лишь небольшую часть данных при записи нужно упорядочивать. Объекты Git неизменяемы и именуются по своему содержимому, поэтому два писателя могут сохранять их одновременно, ни о чём не договариваясь. Согласование требуется только для обновления ссылки, а это очень небольшая часть пуша. Виртуальные реплики стали первым шагом к созданию архитектуры с учётом этого факта и способом перенести репозитории на новую архитектуру.
Остальная часть архитектуры строится на этом наблюдении: согласовывать нужно только обновления ссылок. Благодаря этому компоненты инфраструктуры Git, которые раньше были тесно связаны (хранение данных, обработка запросов и обслуживание репозиториев), могут масштабироваться независимо друг от друга. Для разработчиков Git остаётся Git: они отправляют изменения, получают данные и создают ветки так же, как раньше, со всеми прежними мерами защиты. Далее мы рассмотрим требования, определившие архитектуру, проследим путь запроса через систему и подробно разберём два её компонента.
Создаём инфраструктуру для масштабирования под агентов
Мы рассматриваем масштаб платформы GitHub по двум направлениям:
- Горизонтальное масштабирование — это возможность для множества разработчиков и агентов работать с множеством репозиториев. Многие существующие подходы GitHub в этом направлении прошли многолетнюю проверку и сохраняются в новой архитектуре: распределение клиентов по инфраструктуре, изоляция трафика клиентов и/или обеспечение справедливого распределения ресурсов, а также маршрутизация с учётом нагрузки — вот лишь некоторые примеры.
- Вертикальное масштабирование — это возможность для множества разработчиков и агентов работать с одним репозиторием. По мере того как агенты будут писать всё больше кода, мы ожидаем, что отдельные репозитории станут крупнее и будут сильнее загружены. Поэтому большинство наших требований связано с вертикальным масштабированием.
Сегодня самые загруженные репозитории на GitHub.com получают не более нескольких десятков запросов на запись в секунду, обычно короткими всплесками. По мере того как всё больше работы будет переходить к агентам, работающим параллельно и круглосуточно, мы ожидаем, что в течение следующего года такие всплески превратятся в устойчивый поток. За каждым пушем следует множество запросов на чтение: запускаются CI-процессы, системы развёртывания получают новый коммит, а другие агенты загружают его для контекста. Такое размножение запросов на чтение значительно увеличивает общий трафик, который растёт вместе с количеством записей.
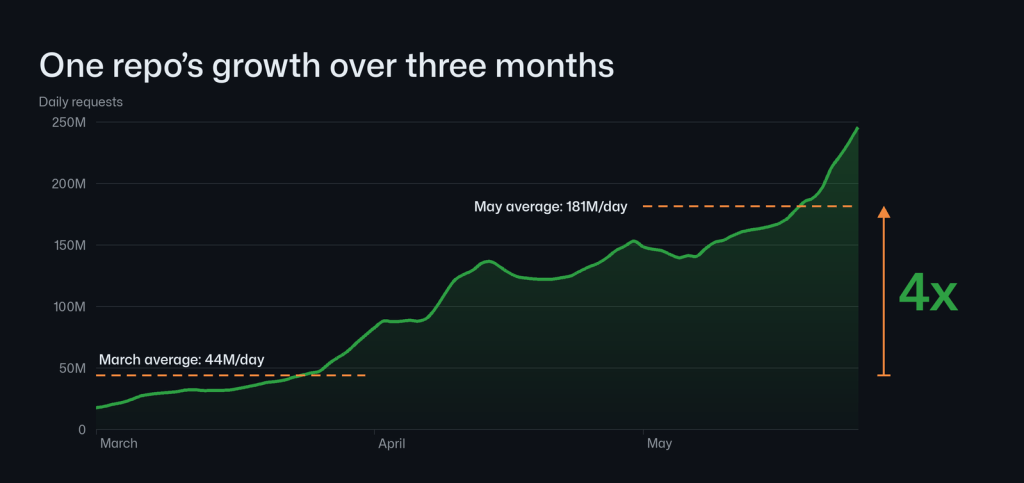
Мы уже видим эту тенденцию в самых активно используемых репозиториях. На графике ниже показано, как менялось число ежедневных запросов к одному репозиторию на GitHub с марта по май: за этот период трафик вырос примерно в четыре раза. С тех пор он продолжает расти по экспоненциальной траектории.
Нам нужно готовиться к миру, где разработка с участием агентов продолжит ускоряться такими темпами. Вместо того чтобы планировать следующий небольшой шаг, мы поставили цель увеличить масштаб как минимум на два порядка. Для отдельного репозитория новая архитектура должна была:
- принимать тысячи записей в секунду;
- поддерживать несколько узлов-писателей. На это есть две причины:
- Опыт показал, что индексация входящих пакетов и проверка связности объектов требуют больше всего процессорных ресурсов при записи. Затраты растут вместе с размером записи, поэтому один узел быстро упрётся в вычислительные ограничения.
- Распределение этой работы между множеством узлов повышает отказоустойчивость и сокращает время восстановления после сбоя узла.
- сводить задержку коммита к минимуму. Агент ждёт завершения каждого пуша, прежде чем перейти к следующему шагу;
- упорядочивать изменения для каждой ссылки и при этом быстро обеспечивать линейный порядок между ссылками. Если виртуальная реплика отстаёт, ей нужно наверстать упущенное, загрузив только данные, необходимые для обработки поступившего запроса;
- обеспечивать низкую стоимость чтения, когда изменений нет: с учётом соотношения чтения и записи это наиболее частый сценарий;
- позволять каждому компоненту масштабироваться независимо.
Кроме того, система должна была повысить общую надёжность и обеспечить глобальное масштабирование.
Представляем Project Rubicon
В мае 2026 года, вскоре после первоначального переноса в Azure, мы начали разрабатывать архитектуру, способную удовлетворить эти требования. Мы испробовали несколько подходов. Во всех случаях данные пакетов хранились в Azure Blob Storage, а в некоторых вариантах мы экспериментировали с хранением там же и состояния ссылок. Ниже мы расскажем о найденных компромиссах, но в итоге остановились на архитектуре, которая, по нашему мнению, обеспечивает максимальную пропускную способность, сохраняя гарантии корректности, долговечности, доступности и задержки, необходимые такой платформе, как GitHub. Мы назвали её Rubicon — в честь точки невозврата, которую индустрия пересекла с появлением агентной разработки.
Давайте рассмотрим Rubicon сверху вниз. Многое осталось без изменений: запросы от Git-клиентов, API и веб-интерфейса поступают в Spokes, который по-прежнему отвечает за маршрутизацию и балансировку нагрузки, а также предоставляет внутренний API, используемый остальными компонентами GitHub для чтения и записи данных репозиториев. Spokes также продолжает выполнять роль сервиса размещения и балансировки, обеспечивая распределение, изоляцию и справедливое распределение ресурсов между клиентами, необходимые для горизонтального масштабирования. А вот уровень обработки данных под Spokes стал новым.
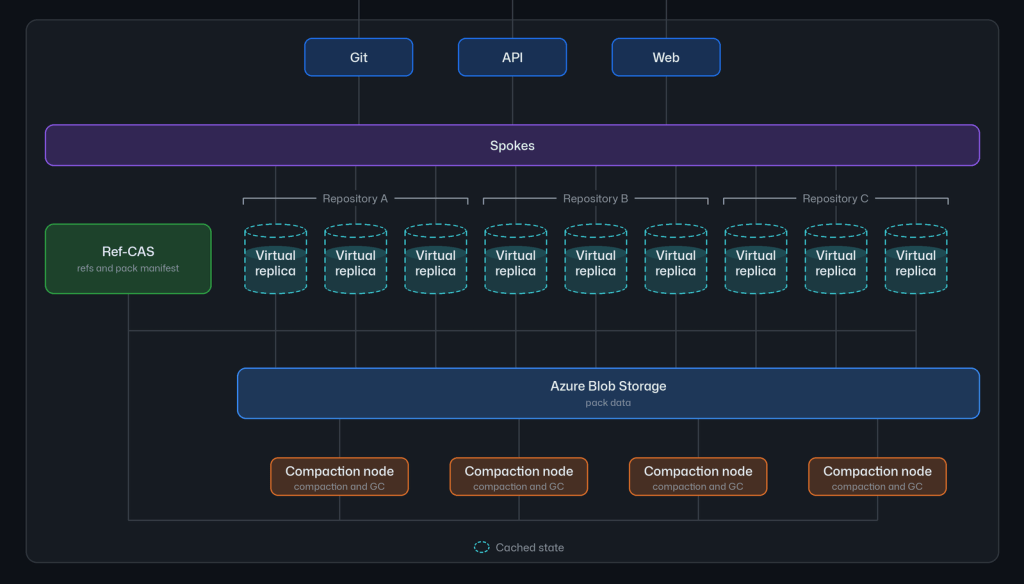
Spokes направляет каждый запрос к одной из нескольких виртуальных реплик, назначенных этому репозиторию. Виртуальные реплики — это единый пул временных вычислительных ресурсов, который обрабатывает запросы на чтение, запись или и то и другое. Локальный диск виртуальной реплики служит кэшем, который можно в любой момент пересоздать.
Когда это возможно, Spokes направляет трафик репозитория к одним и тем же виртуальным репликам, чтобы кэши оставались прогретыми, а задержка — низкой. Однако корректность работы никак не зависит от того, на какую именно виртуальную реплику попадёт запрос. Если виртуальная реплика отключается, остальные продолжают обслуживать запросы, а новая реплика заполняет свой кэш по мере поступления трафика.
Когда нагрузка на репозиторий растёт, мы добавляем виртуальные реплики. Отдельно от них пул узлов компактизации работает в фоновом режиме непосредственно с Blob Storage и Ref-CAS: объединяет пакеты каждого репозитория и удаляет недостижимые объекты. Эта работа никогда не выполняется на виртуальных репликах, поэтому почти все их процессорные ресурсы и память можно выделить на обработку запросов.
Долговечное состояние хранится в двух местах:
- Объекты Git — пакеты и вспомогательные данные для ускорения чтения — хранятся в Azure Blob Storage.
- Ссылки и список пакетов, составляющих репозиторий (манифест пакетов), хранятся в отдельном сервисе реплицируемого журнала под названием Ref-CAS (от Reference Compare-and-Swap — «сравнение и замена ссылки»).
Рассмотрим архитектуру с точки зрения операций записи и чтения:
- Запись: виртуальная реплика индексирует входящий пакет и загружает его в Blob Storage, а затем фиксирует в Ref-CAS одну транзакцию, которая добавляет пакет в манифест и обновляет ссылки. Позднее узел компактизации объединяет этот пакет с другими, чтобы ускорить чтение.
- Чтение: виртуальная реплика сверяет версию ссылок с Ref-CAS, загружает из Blob Storage в свой кэш необходимые пакеты и обрабатывает запрос на чтение.
В новой архитектуре мы применили множество различных подходов: от программного стека виртуальных реплик до настройки маршрутизации трафика и планирования нагрузки для разных сценариев (например, множества небольших репозиториев или одного крупного). Давайте подробно рассмотрим два компонента архитектуры и проследим их развитие через призму двух принципов проектирования.
Минимизация координации: обновление состояния ссылок при высокой пропускной способности
Объектные хранилища, такие как Azure Blob Storage, отлично справляются со своими задачами и хорошо подходят для многих приложений с большим объёмом данных, например для хранения исходного кода. Они надёжны, поддерживают репликацию, вмещают необходимый нам объём данных, обеспечивают сравнительно низкую стоимость хранения байта и чрезвычайно высокую совокупную пропускную способность, если трафик распределён по множеству ключей. Поэтому в Azure Blob Storage хранится почти всё долговечное состояние новой архитектуры хранения Git, в том числе:
- пакеты и индексы, создаваемые при пушах, компактизации и сборке мусора;
- различные средства ускорения чтения (например, индексы нескольких пакетов, битовые карты достижимости и некоторые пользовательские форматы), которые наша система обслуживания формирует на основе этих пакетов;
- записи, позволяющие возобновлять или проверять работу компактизации и сборки мусора, а также аренды, с помощью которых узлы компактизации получают задачи;
- кэшированные ответы на часто повторяющиеся запросы fetch;
- контрольные точки состояния ссылок репозитория, хотя они и не являются авторитетным источником данных для обработки запросов.
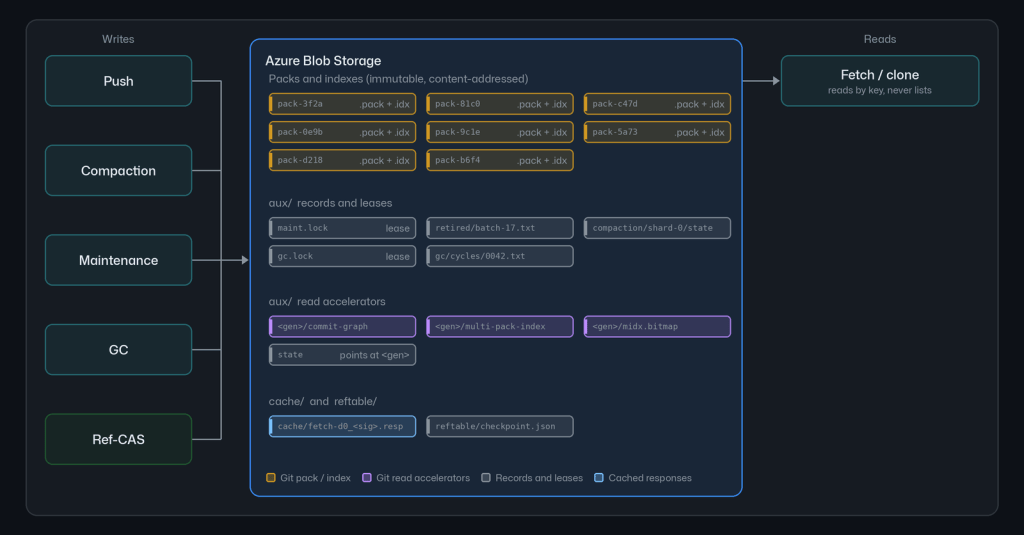
Большая часть этих данных записывается один раз под отдельным ключом и после этого не меняется — именно поэтому Blob Storage так хорошо подходит для их хранения.
Ссылки устроены иначе. Ссылки загруженного репозитория составляют относительно небольшой объём данных, который множество операций записи одновременно пытаются обновить. Blob Storage сложнее справляться с таким сценарием, и первые прототипы показали нам почему. Объектное хранилище — очевидный выбор для такого рода нагрузки, и до определённого масштаба он хорошо работает: условные записи позволяют бесплатно реализовать сравнение и замену, а данные уже надёжно хранятся с репликацией. Однако перед нами встал непростой выбор между несколькими вариантами, два из которых показаны ниже.
В первом варианте мы использовали журнал предварительной записи для всех ссылок репозитория, индексируемый одним блобом. Каждое обновление — это условная запись в этот блоб. Такой подход корректен, а чтение обходится дёшево: виртуальная реплика проверяет, изменился ли блоб, и, если нет, на этом всё. Проблемы возникают при записи. Одновременно может выполняться только одна условная запись в блоб. Поэтому даже если объединять все пуши, поступившие во время записи, в следующую операцию, предел для репозитория — одна запись за время обхода туда и обратно до одного блоба. На практике пропускная способность записи составляла несколько сотен операций в секунду.
Во втором варианте ссылки распределялись между несколькими блобами-сегментами: каждая ссылка по хешу попадала в один из них. Записи ссылок в разных сегментах больше не ждали друг друга, что повышало пропускную способность. Но теперь при чтении нужно было проверять каждый сегмент, чтобы понять, изменилось ли что-нибудь, а скорость определялась самым медленным сегментом. Мы пожертвовали задержкой записи ради задержки чтения, хотя чтений на порядки больше, чем записей. Это можно наглядно показать, сопоставив несколько операций записи с одной операцией чтения:
Ни один из вариантов не удовлетворял всем требованиям, поэтому мы создали другое решение: сервис реплицируемого журнала, предназначенный специально для ссылок, — сервис Ref-CAS. Это та самая небольшая группа консенсуса, о которой мы упоминали в конце предыдущей статьи: она всё ещё находилась где-то в стеке. Вот как она работает.
Каждое обновление ссылки в Ref-CAS — это операция сравнения и замены, фиксируемая кворумом. Транзакция блокирует только те ссылки, которых она касается, проверяет, что каждая из них всё ещё имеет ожидаемое писателем значение, и становится видимой после того, как большинство реплик журнала её запишет. Агенты в основном отправляют изменения в собственные ветки, поэтому большинство обновлений не конкурируют друг с другом и реплицируются параллельно. Если два пуша обновляют одну и ту же ссылку, в журнал будет добавлен только один из них.
Каждый коммит в Ref-CAS получает порядковый номер журнала (LSN), а версией репозитория считается LSN последнего коммита. Чтение начинается с проверки версии. Виртуальная реплика отправляет версию состояния ссылок, которая уже есть у неё. Если эта версия по-прежнему актуальна, ответ не содержит ссылок, и для репозитория без изменений достаточно одного сравнения. Если виртуальная реплика отстаёт, она получает актуальные ссылки и их версию, а также указатели на данные пакетов и другую необходимую информацию — например, о времени последнего цикла сборки мусора.
В отличие от группы консенсуса в прежней архитектуре, Ref-CAS никогда не хранит и не проверяет данные объектов. Он хранит только указатели на них. Виртуальная реплика загружает пакет пуша в Blob Storage до фиксации транзакции со ссылками. Ссылка всегда указывает только на уже надёжно сохранённые объекты.
Эти подходы позволяют нам выполнять десятки тысяч транзакций в секунду только с состоянием ссылок и создают основу для дополнительных пометок в журнале репликации, которые помогают при чтении определить, какие данные нужно загрузить для конкретного запроса.
Но поддержка тысяч операций записи в секунду для одного репозитория создаёт проблему следующего порядка: как сохранить производительность чтения и записи. Для этого нам потребовался новый подход к компактизации.
Отделение хранилища от вычислений: компактизация при тысячах операций записи в секунду
Каждый пуш добавляет пакет в Blob Storage. Git может обслуживать репозиторий, состоящий из множества пакетов, но каждый дополнительный пакет немного увеличивает стоимость поиска, поэтому их число не может расти бесконечно. В прежней архитектуре компактизация выполняется на тех же репликах, которые обслуживают трафик, и должна запускаться на каждой из них. В новой архитектуре она полностью выполняется в фоновом режиме на отдельных узлах непосредственно в долговременном хранилище, а сервис Ref-CAS уведомляет виртуальные реплики об изменении состояния.
Узлы компактизации по аренде получают контроль над отдельными частями данных репозитория, что позволяет масштабировать компактизацию горизонтально. Вот как один такой узел обрабатывает отдельный сегмент пакетов репозитория:
Сначала узел получает аренду на сегмент в Blob Storage, чтобы одновременно его компактизировал только один узел. Тем временем виртуальные реплики продолжают загружать пакеты и перечислять их в манифесте. Узел читает манифест, находит новые пакеты и собирает их в открытый сегмент — своего рода временное хранилище данных, ожидающих компактизации. Когда сегмент достигает заданного предела по количеству пакетов, размеру или возрасту, узел закрывает его, чтобы в него больше нельзя было добавлять пакеты, а затем объединяет их в меньшее число крупных пакетов. Пока идёт компактизация, следующий сегмент может начать собирать входящие пакеты. Перед публикацией узел проверяет, что новые пакеты содержат в точности те же объекты, что и исходные. Затем он загружает новые пакеты и добавляет их в манифест. Вторая транзакция удаляет исходные пакеты из манифеста, а сами они удаляются позднее в ходе очистки.
Для горизонтального масштабирования этот процесс независимо выполняется одновременно для множества сегментов. Хеш каждого пакета определяет его сегмент, поэтому увеличение числа сегментов и узлов повышает пропускную способность компактизации. Скомпактизированный пакет, размер которого не превышает установленный предел, снова попадает в сегмент по собственному хешу и компактизируется ещё раз. Так пакеты постепенно увеличиваются по уровням, пока не достигнут предельного размера. В результате количество пакетов остаётся практически неизменным, даже когда число пушей растёт:
Компактизация объединяет пакеты, но сохраняет все объекты. Сборка мусора удаляет объекты, на которые больше ничто не ссылается, например оставшиеся после удаления веток и принудительных пушей. В новой архитектуре сборка мусора работает почти так же, как компактизация: вычислительно затратные операции выполняют выделенные рабочие узлы. У неё также есть несколько особых механизмов безопасного удаления данных, которые заслуживают отдельного обсуждения.
С помощью этих подходов нам удалось стабильно демонстрировать ровную кривую задержки даже при росте числа операций записи. Кроме того, мы планируем и другие оптимизации, которые повысят производительность самой компактизации и сборки мусора.
Что дальше
Благодаря двум исходным принципам каждый компонент архитектуры может масштабироваться самостоятельно. Мы масштабируем чтение и запись, добавляя виртуальные реплики. Ref-CAS упорядочивает каждую ссылку независимо, а не весь репозиторий целиком. Для масштабирования обслуживания мы добавляем узлы компактизации. Наша цель — чтобы все репозитории, от побочного проекта одного разработчика до самого загруженного монорепозитория, работали на одной архитектуре, без специальных мер для наиболее загруженных. Репозитории не остаются маленькими навсегда. Уже завтра в побочном проекте может появиться целый пул агентов, и для поддержки такой нагрузки ему не должны требоваться перенос или особая настройка с нашей стороны. Единая архитектура также означает, что каждое улучшение сразу распространяется на все репозитории.
Эта основа открывает перед нами множество возможностей. Сейчас мы сосредоточены на трёх направлениях: масштабировании архитектуры далеко за пределы сегодняшних прогнозов, повышении эффективности работы агентов на GitHub и развитии самого Git для агентной разработки.
Совершенствуем архитектуру
Мы планируем развивать эту архитектуру дальше. Каждое из перечисленных улучшений позволит репозиторию справляться с большей нагрузкой, одновременно сокращая объём работы, необходимой для обработки каждого запроса:
- Загружать только необходимое. Получать из Blob Storage один объект вместо целого пакета, в котором он находится.
- Группировать пакеты по типу. Размещать коммиты, деревья и блобы в отдельных пакетах. Тогда многие запросы будут затрагивать меньше данных.
- Частичные реплики. Обрабатывать запросы, не храня на локальном диске каждый пакет.
- Материализованные представления. Хранить данные репозитория в готовых к использованию форматах: например, подготовленные архивы, почти актуальную неглубокую копию основной ветки и контекст сеанса агента рядом с каждым коммитом.
- Глобальные реплики. Размещать реплики в любом регионе, рядом с использующими их нагрузками. Чтение будет отставать от последней записи не более чем на заданный интервал.
- Масштабирование до нуля. Увеличивать и уменьшать пул реплик в соответствии с реальной активностью репозиториев.
Эффективная работа агентов на GitHub
Масштабирование инфраструктуры — лишь одна сторона поддержки агентов. Другая — снижение стоимости каждой операции агента: меньше данных для загрузки, меньше обращений к серверу и меньше ожидания изменений. Каждый из этих пунктов, которые мы планируем реализовать в ближайшее время, опирается на описанную в статье работу над хранилищем:
- Работа без клона. Для многих задач агента не нужно полное рабочее дерево. Ему достаточно нескольких файлов и контекста, необходимого для внесения изменений. Всё это можно получить прямо с сервера.
- API атомарного коммита. Вносить изменения в нескольких файлах одной операцией. Изменения фиксируются целиком либо корректно отклоняются при конфликте.
- Потоки событий. Агенты и окружающие их системы работают эффективнее, получая информацию в реальном времени. Универсальный поток событий позволит им подписываться на изменения и реагировать по мере их появления.
Развиваем Git для агентов
Нам предстоит поработать и над самим Git. GitHub уже давно участвует в развитии проекта Git и не собирается останавливаться. Вот несколько направлений, работу над которыми мы хотим продолжить:
- Облегчённые клоны. Частичный клон, неглубокий клон и разреженная выгрузка позволяют агенту загружать меньше данных. У каждого подхода есть свои недостатки, и вместе они тоже не всегда хорошо работают. Мы хотим улучшить каждый из них и обеспечить их совместимость.
- Устранение скрытых издержек масштабирования. В Git по-прежнему есть участки кода, работа которых замедляется гораздо быстрее, чем растёт репозиторий. В последних версиях мы исправили несколько таких проблем, но ожидаем найти и другие.
- Ускорение обхода истории. Метаданные, например граф коммитов, позволяют отвечать на вопросы о базовом коммите слияния и достижимости, не обходя каждый коммит. Это особенно важно, когда вызов API агентом приводит к выполнению операций Git на сервере.
- Предотвращение типичных ошибок. Агенты совершают те же ошибки, что и разработчики. Git может выявлять больше распространённых ошибок и предупреждать о них до того, как они приведут к проблемам.
Агенты изменили то, как создаётся программное обеспечение. GitHub и Git меняются вместе с этим процессом. Мы рады вывести новую архитектуру на старт. Сейчас она доступна в ограниченной закрытой предварительной версии, а более широкий запуск запланирован на начало следующего года. Нам не терпится увидеть, что создадут команды, когда число агентов, работающих над репозиторием, будет ограничено только их идеями. Мы продолжим развивать Git и GitHub вместе с нашими клиентами и сообществом Git.
