MetaRoCE: Новый RDMA-транспорт, созданный для Ethernet масштаба ИИ
- Обучение и обслуживание передовых моделей ИИ зависят от быстрых и надежных сетей, которые передают данные между графическими процессорами, не растрачивая впустую вычислительные ресурсы.
- Чтобы масштабно справиться с этой задачей, компания Meta разработала MetaRoCE — протокол RDMA-транспорта с чистого листа, специально созданный для рабочих нагрузок ИИ на стандартном Ethernet.
- Мы выпускаем спецификацию MetaRoCE, эталонную реализацию программного обеспечения и набор тестов на соответствие стандартам через инициативу Open Compute Project (OCP), чтобы дать возможность более широкому кругу представителей индустрии внедрять их, использовать и создавать на их основе новые решения.
В Meta мы активно способствуем формированию общего мнения индустрии о том, что именно Ethernet должен стать базовой инфраструктурой для ИИ. Мы уже продемонстрировали, что RoCE способен обеспечивать масштабируемое распределенное обучение ИИ. Теперь мы развиваем эту работу с помощью MetaRoCE — протокола, созданного с нуля для сетей Ethernet масштабом в миллион графических процессоров.
Мы масштабировали кластеры, состоящие из сотен тысяч графических процессоров, которые распределены по нескольким центрам обработки данных и регионам. Независимо от того, обучают ли эти кластеры новую передовую модель или обслуживают инференс в глобальном масштабе, сеть находится на критическом пути.
Коллективные операции, такие как all-reduce и all-to-all, синхронизируют тысячи ускорителей во время обучения, причем самая медленная передача задает темп для всей задачи. При инференсе связь с низкой задержкой между распределенными шардами модели напрямую влияет на время отклика для сотен миллионов пользователей. Даже небольшие задержки в сети напрямую приводят к простаиванию значительных вычислительных мощностей.
Стандартный RoCE ожидает, что сеть будет доставлять каждый кадр в правильном порядке, используя PFC (управление потоком с приоритетом) и препятствуя распределению пакетов (packet spraying), которое обеспечивает производительность в многоплоскостных и крупномасштабных сетях. MetaRoCE создан для того, чтобы обеспечивать высокую пропускную способность, низкие задержки в хвосте распределения (tail latency) и эксплуатационную простоту по мере роста сети в плане количества ускорителей и расстояний между ними.
Как работает MetaRoCE
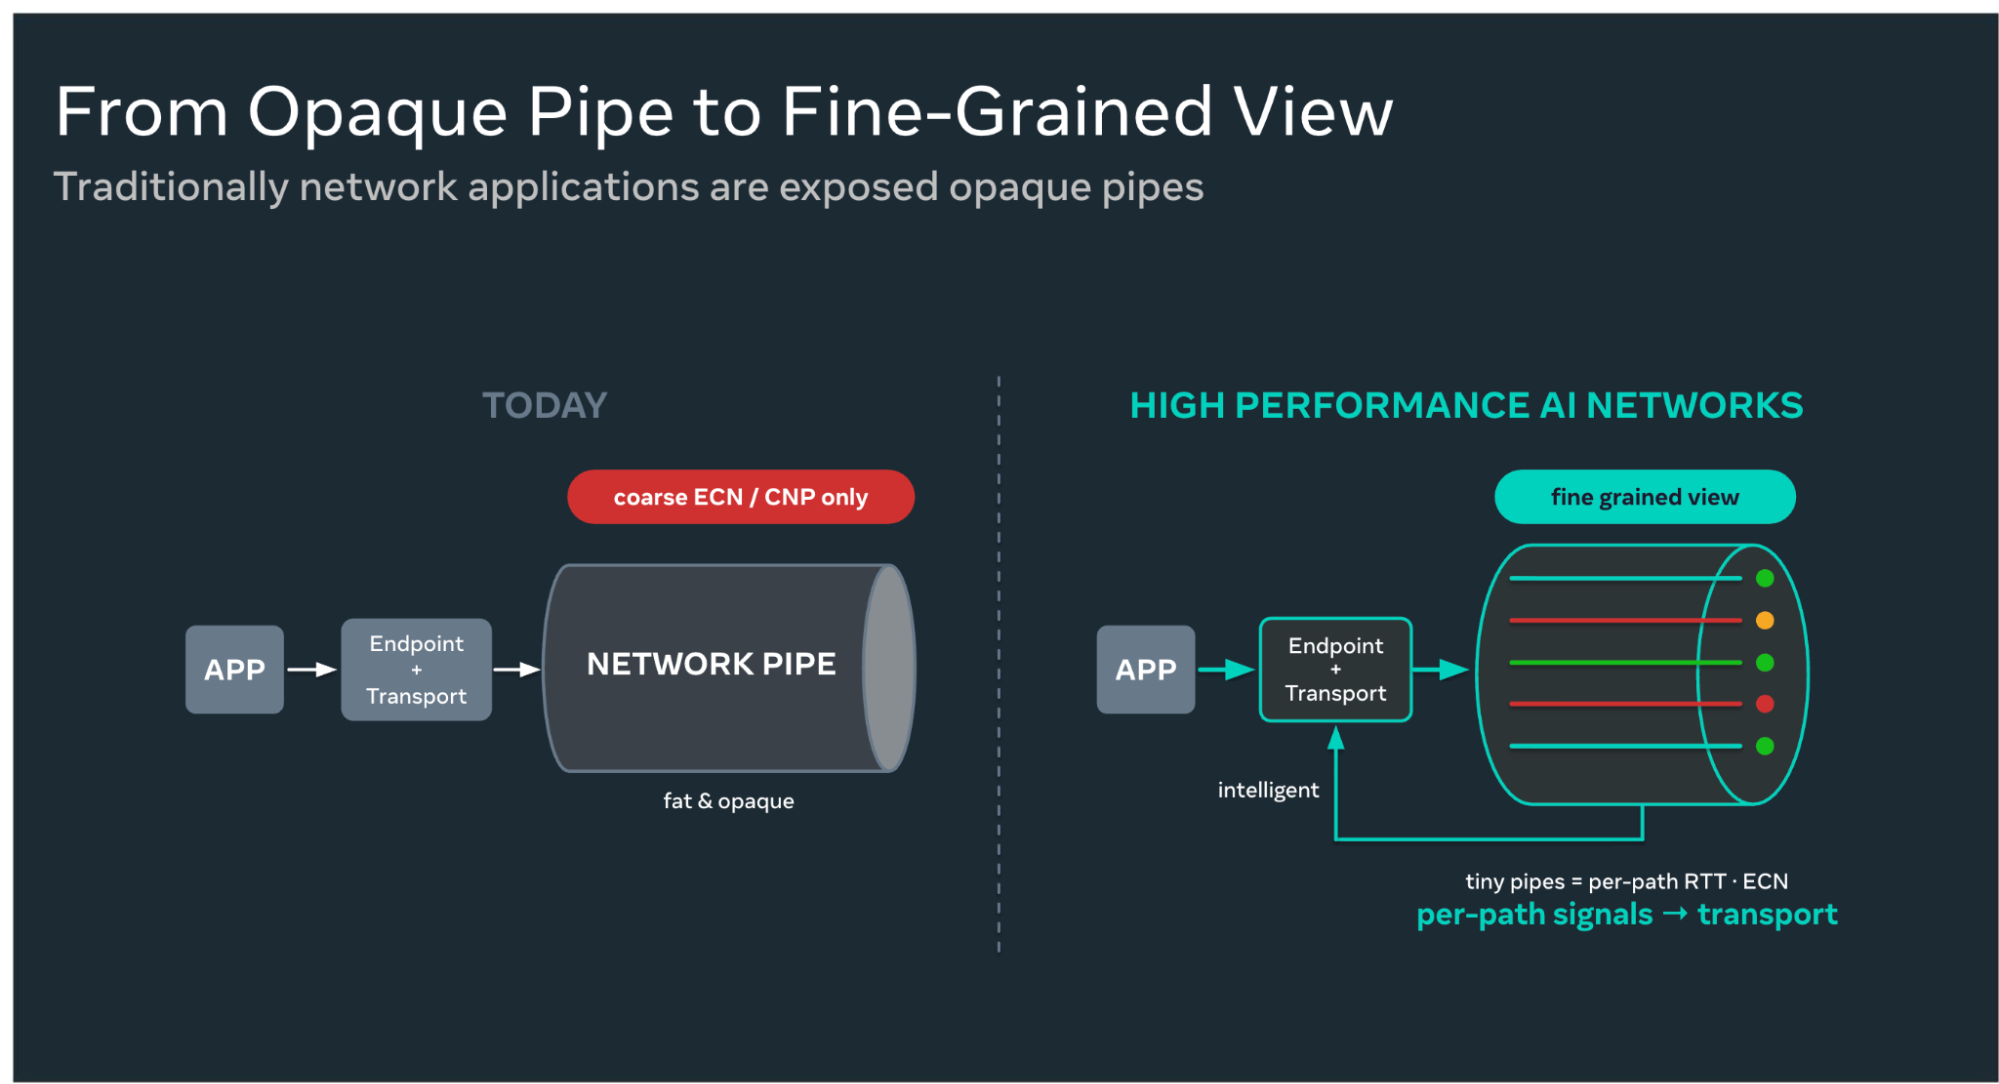
Главная идея MetaRoCE проста: сетевая инфраструктура видит пакеты, но сетевой адаптер (NIC) видит намерения. Традиционные архитектуры сосредоточивают интеллектуальные функции в самой сети, полагаясь на коммутаторы в вопросах обеспечения безпотертости и поддержания порядка.
Перенеся интеллектуальные функции на оконечные устройства, MetaRoCE декомпозирует сеть на множество мелкозернистых логических путей, каждый из которых обладает собственной телеметрией в реальном времени — RTT для каждого пути, статусом ECN и уровнем использования. Такая видимость открывает возможности, которых трудно достичь с помощью традиционного RDMA.
Встроенная доставка с нарушением порядка (Out-of-Order)
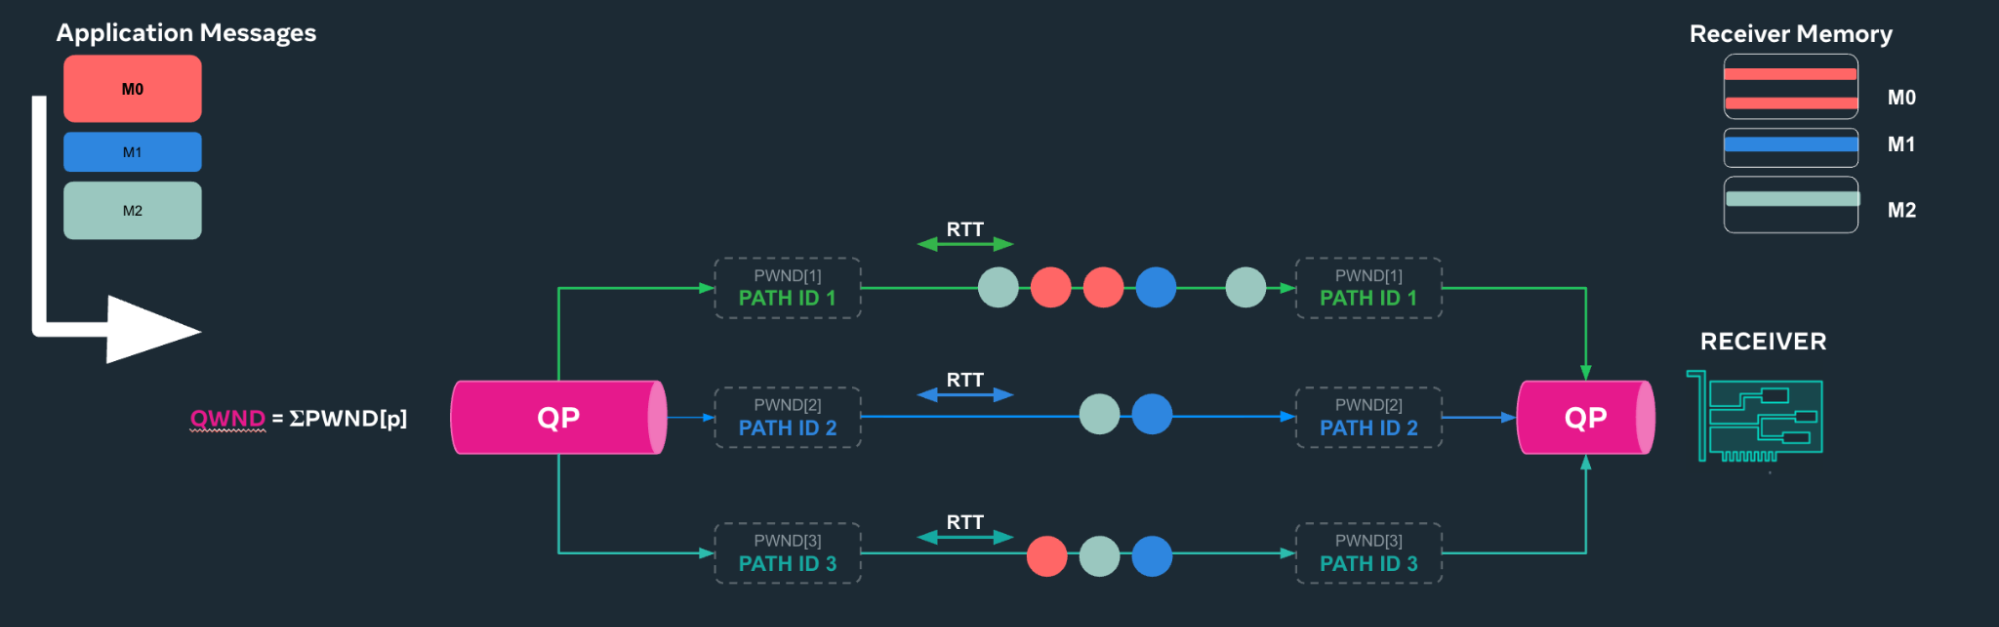
MetaRoce распределяет пакеты по множеству путей, поэтому они по определению прибывают в произвольном порядке. Транспортный уровень рассматривает прибытие с нарушением порядка как нормальное явление. Каждый пакет несет в себе информацию о своем пункте назначения, поэтому данные записываются прямо в их конечную область памяти по мере поступления — без буфера переупорядочивания и без блокировки на головном узле (head-of-line blocking).
Операции записи (Writes) содержат информацию о пункте назначения в каждом пакете. Операции отправки (Sends) несут соответствие с заранее размещенным буфером приема, поэтому Send доставляется правильно даже тогда, когда предшествующие ему сообщения еще не прибыли, и без необходимости совершать круговой обход для выяснения того, куда направляются данные. Библиотеки коллективных операций могут использовать двусторонний обмен сообщениями там, где это удобно, вместо сведения всего к операциям Write.
Встроенная многопутевость (Multipathing)
MetaRoCE предоставляет каждому соединению первоклассные пути и осуществляет распределение трафика по ним пакет за пакетом. Каждый путь имеет свой собственный исходный порт UDP в качестве энтропии ECMP, которую сетевой адаптер может изменить в любой момент, чтобы увести трафик с проблемного маршрута. В многоплоскостных сетях выбор плоскости полностью возлагается на сетевой адаптер, а сама сеть используется ровно настолько эффективно, насколько эффективно адаптер распределяет пакеты. Поскольку каждый путь поддерживает собственное окно и оценку времени кругового пути (RTT), транспорт может отличать перегрузку от сбоя и явно перебалансировать нагрузку, в результате чего перегруженный или неисправный канал замедляет только один путь, а не стопорит все соединение.
Толерантность к потерям по своей конструкции
MetaRoCE рассматривает Ethernet-инфраструктуру как сеть с потерями и не требует от нее обратного — никаких PFC, никаких паузовых кадров. Поскольку каждый путь поддерживает собственную упорядоченную последовательность, пробел в его 256-битном битовом векторе выборочного подтверждения (SACK) является свидетельством потери, а не переупорядочивания. В других протоколах SACK в основном позволяет избежать повторной отправки уже прибывших данных; здесь же он инициирует повторную передачу ровно отсутствующего пакета по тому пути, на котором он был потерян, в тот самый момент, когда появляется разрыв.
Управление перегрузкой с обеих сторон
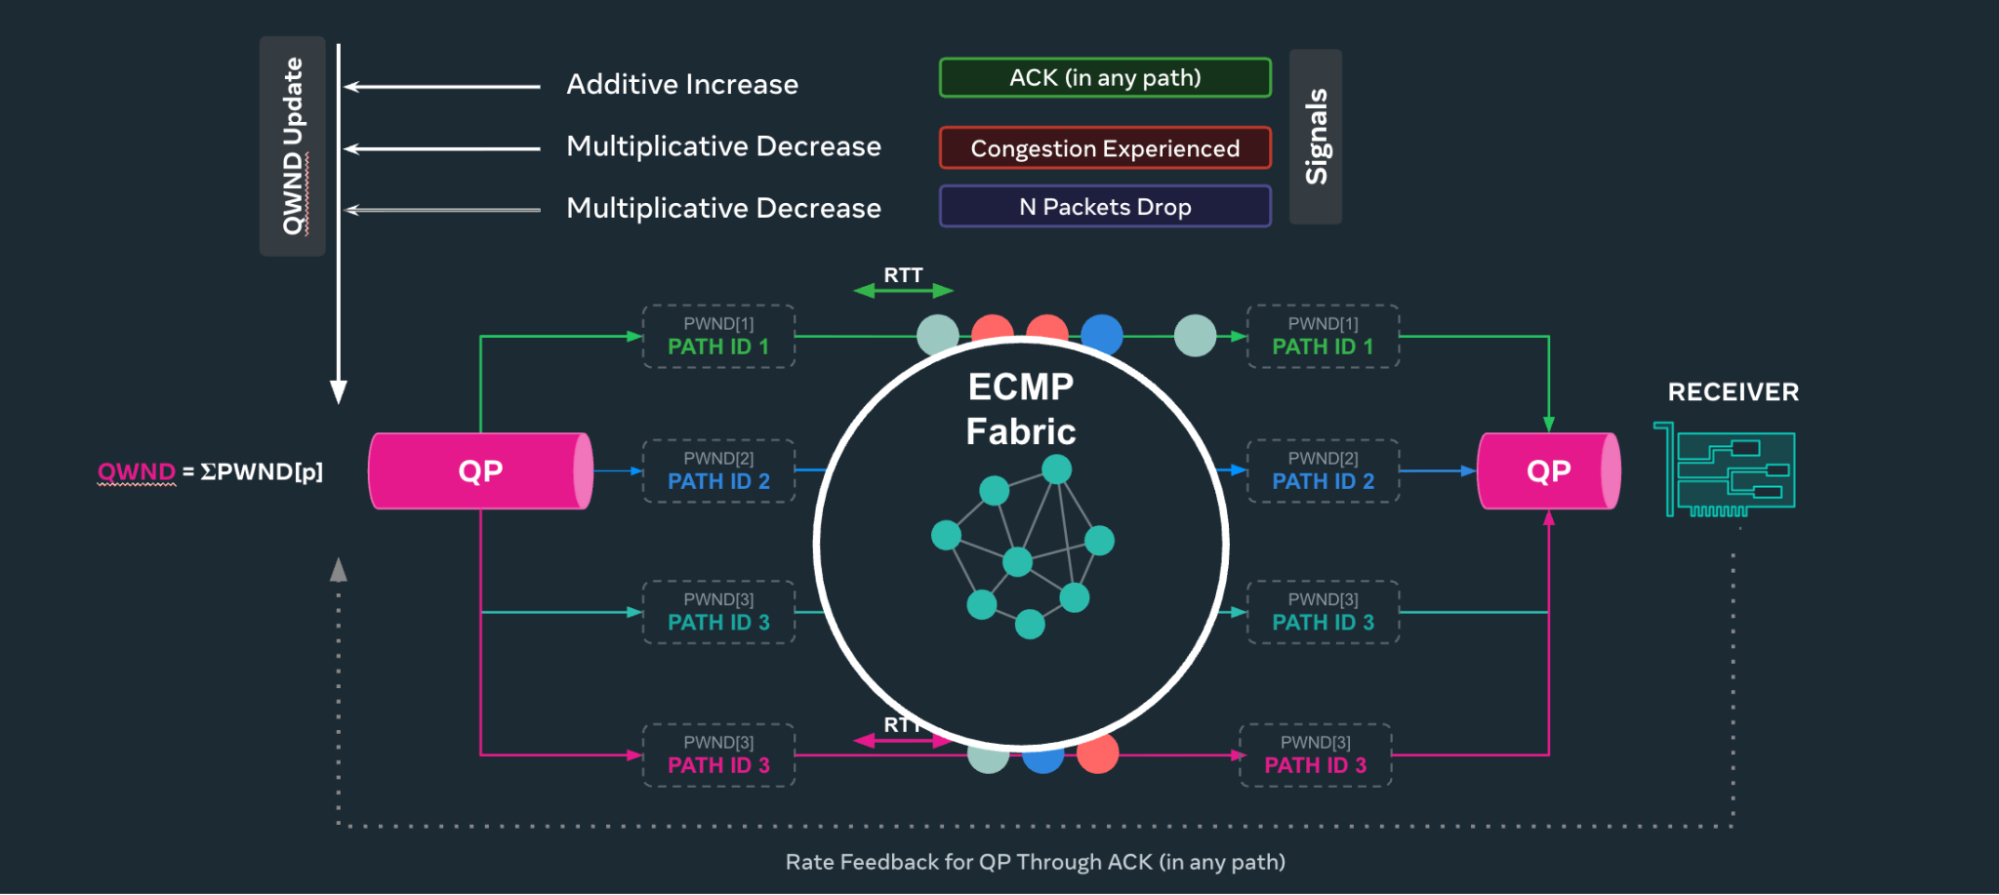
MetaRoCE сочетает в себе традиционное управление перегрузкой AIMD на основе ECN, управляемое источником, с подсказками о справедливом распределении пропускной способности (fair-share rate hints), управляемыми получателем. Окна поддерживаются как для каждого пути, так и для каждого соединения в целом, поэтому метка перегрузки сокращает пропускную способность именно на том пути, где она была зафиксирована, и направляет следующие пакеты по свободным путям. В каждом подтверждении получатель возвращает долю своей входящей пропускной способности, выделенную данному отправителю, благодаря чему отправители сразу выходят на нужную скорость, а не ищут ее путем перебора. Разрешение проблемы инкаста (Incast) происходит за один-два круговых обхода (round trip), обеспечивая лучшую справедливость и меньшую задержку в хвосте распределения.
Независимость от топологии
MetaRoCE требует от сети ровно две вещи, которые уже есть у каждого коммутатора: маркировку ECN и ECMP. Протокол не требует усечения пакетов, внутрисетевой телеметрии, управления потоком на основе кредитов или распределения на стороне коммутаторов, и он не ломается, если сеть все же предоставляет эти возможности. Тот же транспорт работает поверх фабрик с типами топологии «толстое дерево» (fat-tree), многоплоскостных, с глубокими и мелкими буферами, а также в облаках сторонних провайдеров, конфигурацией которых вы не управляете. Здесь нет ничего проприетарного, поэтому инфраструктура остается свободной для оптимизации затрат и кабельной разводки.
Унифицированные соединения в масштабе
Пара очередей (Queue Pair, QP) несет в себе как упорядоченный поток сообщений, так и пропускную способность. Традиционный RDMA получает больше того или другого за счет открытия большего количества QP (девяносто штук на пару узлов), каждая из которых имеет независимое от остальных окно перегрузки и собственное состояние на сетевом адаптере.
MetaRoCE разделяет эти понятия. Одно соединение поддерживает множество независимых упорядоченных потоков на верхнем уровне (по одному на коммуникатор или коллективную операцию) и множество путей на нижнем уровне под управлением единого контроллера перегрузки. Состояние соединения перестает расти пропорционально параллелизму рабочей нагрузки.
Прикладной уровень остается практически нетронутым — существующие API RDMA Verbs и программные стеки работают без каких-либо модификаций. Расширенные функции, такие как поддержка нескольких плоскостей (multiplane), поддерживаются с помощью дополнительных API.
MetaRoCE на практике
Чтобы ускорить валидацию аппаратного обеспечения, мы сотрудничали с компанией AMD для реализации MetaRoCE на их программируемых сетевых адаптерах Pensando.
На 64-узловом кластере графических процессоров AMD, выполняющем коллективные операции RCCL, мы напрямую сравнили MetaRoCE с RoCEv2 для операций all-reduce и all-to-all. Результаты совпали с поставленными целями проектирования:
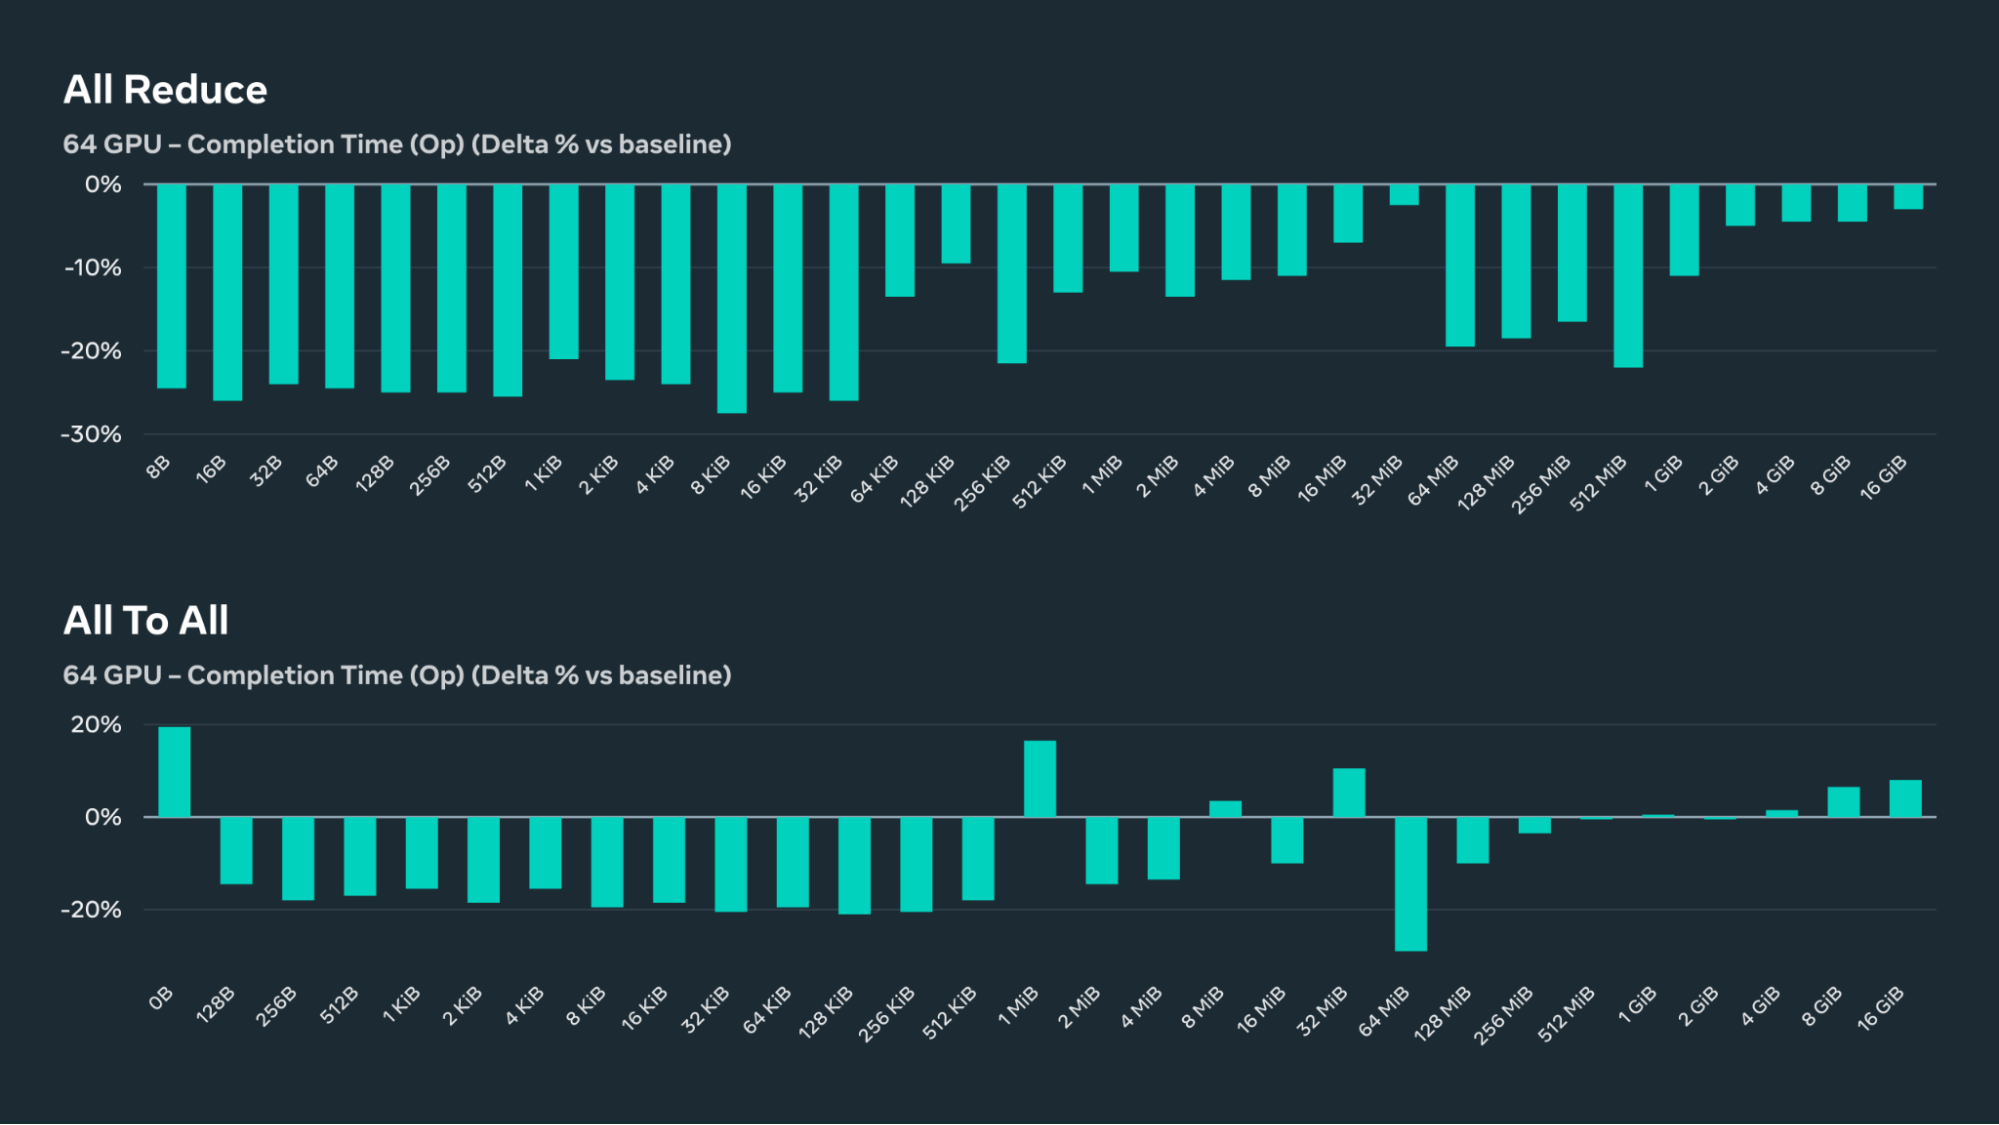
MetaRoCE стабильно обеспечивает более высокую пропускную способность и меньшее время завершения потоков по сравнению с RoCEv2.
В условиях потери пакетов, которые привели бы к деградации RoCEv2, MetaRoCE сохраняет пропускную способность на уровне ~86% при потере пакетов в 1% и продолжает обеспечивать полезную пропускную способность даже при экстремальном уровне потерь в 10%, демонстрируя плавную деградацию вместо полного отказа.
Проверка многоплоскостной работы в 4-плоскостных и 8-плоскостных топологиях с участием до 4000 одновременных соединений подтвердила, что пропускная способность масштабируется линейно с ростом числа плоскостей.
Во время симулированных сбоев плоскостей протокол демонстрирует плавное автономное восстановление — трафик перераспределяется без участия приложений или вмешательства оператора.
Эти результаты подтверждают правильность ключевого архитектурного выбора MetaRoCE. Проектируя систему с расчетом на потери с самого первого дня и перенося интеллектуальные функции на периферию, вы получаете транспорт, который работает лучше в идеальных условиях и плавно деградирует, когда что-то идет не так.
Открытость по дизайну
Инфраструктура ИИ извлекает выгоду из общих стандартов, которые ускоряют инновации во всей экосистеме. MetaRoCE распространяет ту же открытую философию множества производителей, которую инициатива Open Compute Project (OCP) Ethernet Scalable Unified Network (ESUN) установила для сетевой инфраструктуры, также и на транспортный уровень.
Именно поэтому мы открываем MetaRoCE:
Открытая спецификация через OCP: Полная спецификация протокола передается в OCP и доступна любому вендору для реализации и создания взаимозаменяемого оборудования.
Реализации для различных сетевых адаптеров: MetaRoCE разработан для работы с разнообразными архитектурами NIC — как программируемыми, так и с фиксированной функцией. Мы доказали это на оборудовании AMD Pensando, при этом другие вендоры уже занимаются созданием собственных реализаций.
Производственный набор тестов на соответствие: Мы разработали набор тестов соответствия (compliance suite), который дает производителям оборудования инструменты для доказательства того, что их реализации соответствуют спецификации протокола.
Программная эталонная реализация: Наша библиотека libsoftmetaroce предоставляет полный функциональный транспортный стек, который работает на стандартном Linux поверх обычных сокетов UDP без специализированного оборудования. Она служит авторитетной поведенческой моделью для разработки кремниевых микросхем и основой нашего унифицированного фреймворка соответствия.
Дальнейшие шаги
С помощью MetaRoCE мы добились значительного прогресса в масштабируемых сетях (scale-out) — обеспечили высокопроизводительный и отказоустойчивый транспорт внутри дата-центра на базе стандартного Ethernet. Но инфраструктура ИИ охватывает различные диапазоны расстояний и задержек, и каждый из них несет в себе уникальные вызовы, над которыми мы активно работаем:
Масштабирование внутри узла/стойки (Scale-up): Внутри стойки ускорители обмениваются небольшими сообщениями, где важна каждая наносекунда. MetaRoCE устраняет два главных источника задержек: буфер переупорядочивания и PFC. Сейчас мы оптимизируем путь быстрой сигнализации для коротких операций с памятью, инициируемых напрямую от одного вычислительного элемента к другому.
Масштабирование между дата-центрами (Scale-across): Scale-across позволяет объединить единую задачу в зданиях, удаленных друг от друга на тысячи километров. Время кругового пути исчисляется миллисекундами, и небольшие различия между путями суммируются. Рассмотрение путей как первоклассных сущностей позволяет MetaRoCE адаптироваться, отдавая предпочтение несвободным путям и стремясь к справедливости на каждом уровне. Предстоящая работа заключается в справедливом распределении ресурсов на контендированных (соревнующихся за ресурс) магистральных каналах связи.
Сценарии использования хранилищ и KV-кэша: Распределенные хранилища провоцируют инкаст, когда одно чтение рассылается на множество серверов, и все они отвечают одновременно. Подсказки скорости на стороне получателя позволяют принимающей стороне (серверу хранения, принимающему запись, или клиенту, принимающему чтение) модерировать входящую скорость независимо от того, был ли запрос отправлен на десять серверов или на тысячу. Новая задача заключается в поддержании высокой точности этой скорости в сетях с разной скоростью и запросами разного размера.
Помогите нам построить будущее Ethernet для инфраструктуры ИИ
В октябре на саммите OCP Global Summit 2026 мы выпустим спецификацию MetaRoCE, оптимизированную под DPDK программную эталонную реализацию и наш производственный фреймворк для проверки на соответствие стандартам.
Мы создаем это открыто, поскольку предстоящие задачи требуют широкого сотрудничества в масштабах всей индустрии. Если вы разрабатываете сетевые адаптеры, коммутаторы или инфраструктуру ИИ, мы приглашаем вас присоединиться к нам.
