Организационный «второй мозг»: создание ИИ, который учится у экспертов
- Мы создали ИИ-агента, который выступает в роли вспомогательного эксперта в определенной предметной области, делая глубокие специализированные знания легкодоступными и сохраняя их для доступа, обмена и развития любым сотрудником организации.
- Это не типичный доменно-специфичный агент. Его новизна заключается в интеграции двух уровней:
- Структурированная, проверяемая архитектура знаний отделяет то, что агент знает, от того, как он рассуждает.
- Затем цикл самосовершенствования компилирует отзывы экспертов в проверенные обновления, прошедшие регрессионное тестирование, без необходимости дообучения модели.
- Вместе эти два уровня превращают разовые исправления экспертов в постоянную, накапливающуюся институциональную память, а эта схема спроектирована так, чтобы ее можно было распространить и на другие области, управляемые извлекаемым текстом, а не весами модели.
- Эта система экономит массу времени экспертам предметной области (SME) в Meta, позволяя им уделять больше внимания работе, где их знания имеют наибольшее значение.
Многие крупные организации сталкиваются с одной и той же проблемой, когда речь заходит о специализированных знаниях. Хотя часть из них зафиксирована в виде моделей, руководств, чек-листов и фреймворков, самые ценные специализированные знания хранятся в головах людей и редко фиксируются где-либо в долговечном виде. Например, в сфере комплаенса однотипные вопросы могут возникать при сотен экспертных проверок, экспертные оценки требуют дней ручных исследований, а несогласованность между оценками создает реальные организационные риски.
Нередко эксперты тратят больше времени на ответы на рутинные вопросы, чем на по-настоящему новые и неоднозначные задачи, где их суждения имеют наибольшее значение. Нам нужны системы, способные фиксировать ход мыслей экспертов организации и делать эти знания доступными для всех, кто в них нуждается, чтобы экспертизой было проще делиться, развивать ее и сохранять.
Мы приступили к решению этой задачи, кодифицировав институциональный интеллект в ИИ-агента для конкретной области комплаенса. Агент объединяет систему знаний, которая действует как «второй мозг» организации, уровень рассуждений, отражающий то, как на самом деле мыслит эксперт в данной области, и автоматизированный конвейер улучшений, который постоянно приумножает усилия экспертов. Эти шаблоны применимы к любой корпоративной сфере с глубокими специализированными знаниями, будь то финансы, безопасность или инженерия.
Архитектура вкратце
Готовые языковые модели (LLM) обеспечивают прочную основу, но для полноценной эффективности в узкоспециализированных областях им часто не хватает более глубокого институционального контекста. Без такого фундамента модель общего назначения имеет ограниченную ценность, так как она не сможет отличить то, что организация может сделать (обобщение общей информации), от того, что ей следует сделать (на основе прошлых позиций, направления развития компании, бизнес-контекста и т. д.). В критически важных областях для устранения этого разрыва необходимо предоставить модели собственные знания и приоритеты организации, чтобы ее анализ отражал реальные принципы принятия решений в компании.
Созданная нами система состоит из четырех уровней, каждый из которых решает определенную задачу:
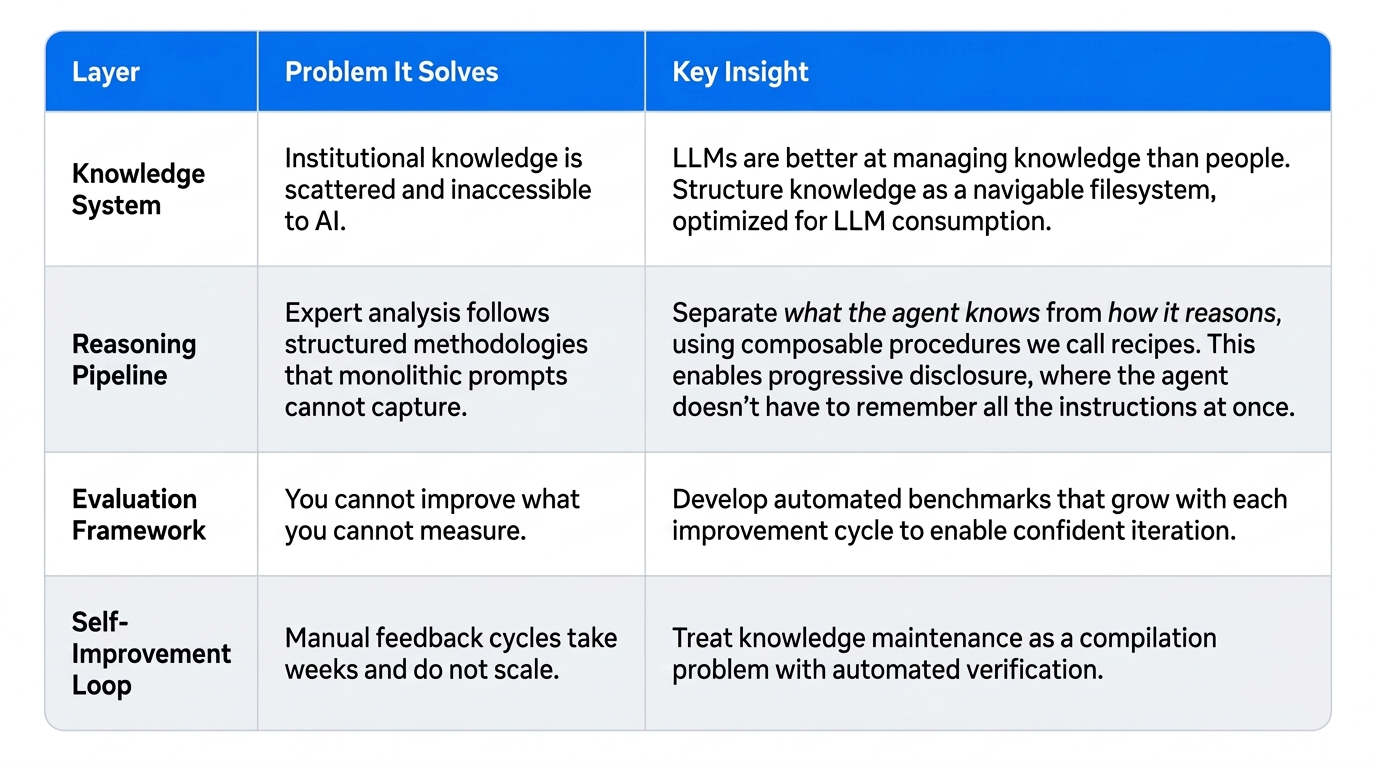
Эти уровни зависят друг от друга. Файловая структура системы знаний делает возможным автоматическое редактирование. Четкие процедуры уровня рассуждений делают поиск причин сбоев понятным. Структура оценки контролирует каждое изменение. А цикл улучшений подпитывает как знания, так и рассуждения. Уберите хотя бы один уровень, и остальные деградируют.
Создание организационного «второго мозга»
Крупные организации могут накапливать тысячи документов как побочный продукт работы экспертов. Возкушается искушение рассматривать эти документы как организационные знания, но настоящие знания неявны: это то, как рассуждают эксперты, чему они отдают приоритет и как разрешают неопределенность. Агенту, который извлекает фрагменты документов во время инференса, приходится заново выстраивать эти рассуждения из необработанных источников при каждом запуске, что работает медленно, чревато ошибками и несогласованно.
Мы делаем эти неявные знания явными заранее. Долгосрочный автономный процесс анализирует исходные документы и преобразует их в структурированные файлы знаний — тщательно отобранные утверждения о том, как организация интерпретирует свою сферу деятельности, с машинно-читаемыми ограничениями, границами и правилами маршрутизации.
Самое главное, что эти знания затем формируют основу цикла обратной связи, который позволяет агенту учиться на отзывах человеческих экспертов и внедрять их без необходимости дообучения базовой модели.
Индустрия пришла к схожей идее. Проект LLM Wiki Андрея Карпаты структурирует знания агента в виде навигационного графа файлов, а стандарт Open Knowledge Format от Google стандартизирует это для обеспечения совместимости между агентами. Общая мысль заключается в том, что знания должны быть предварительно извлечены, явно структурированы и раскрываться постепенно, а не выводиться заново при каждом запросе. Мы расширили эти принципы до системы, в которой точность цитирования и институциональная согласованность являются обязательными, организовав более 200 файлов в строгую таксономию:
- Файлы позиций фиксируют авторитетные организационные позиции: то, как организация решила интерпретировать тот или иной вопрос в своей области, наряду с ее ограничениями, граничными условиями и машинно-реализуемыми последствиями маршрутизации, которые подсказывают уровню рассуждений, когда их применять.
- Файлы таксономии и словаря служат авторитетным глоссарием для терминов, которые организация использует для описания своей сферы деятельности, таких как типы сущностей, категории активности и уровни классификации. Каждый из них поддерживается как единый источник достоверной информации, чтобы агент и организация использовали терминологию единообразно.
- Индексы маршрутизации сопоставляют характеристики входных данных с релевантными позициями и процедурами, определяя, какие файлы применимы, не полагаясь только на сходство эмбеддингов. Это делает поиск детерминированным и проверяемым.
- Шлюзовые файлы определяют пороговые тесты, которые агент должен пройти перед входом в аналитическую область, не позволяя ему применять специализированные знания там, где они неуместны.
Каждый файл объявляет свои зависимости (depends_on) и потребителей (referenced_by) в YAML-шапке (frontmatter), формируя двунаправленный граф зависимостей. Когда один файл изменяется, вы можете точно отследить, что еще может затронуть это изменение, что критически важно, когда цикл самосовершенствования предлагает автоматические правки.
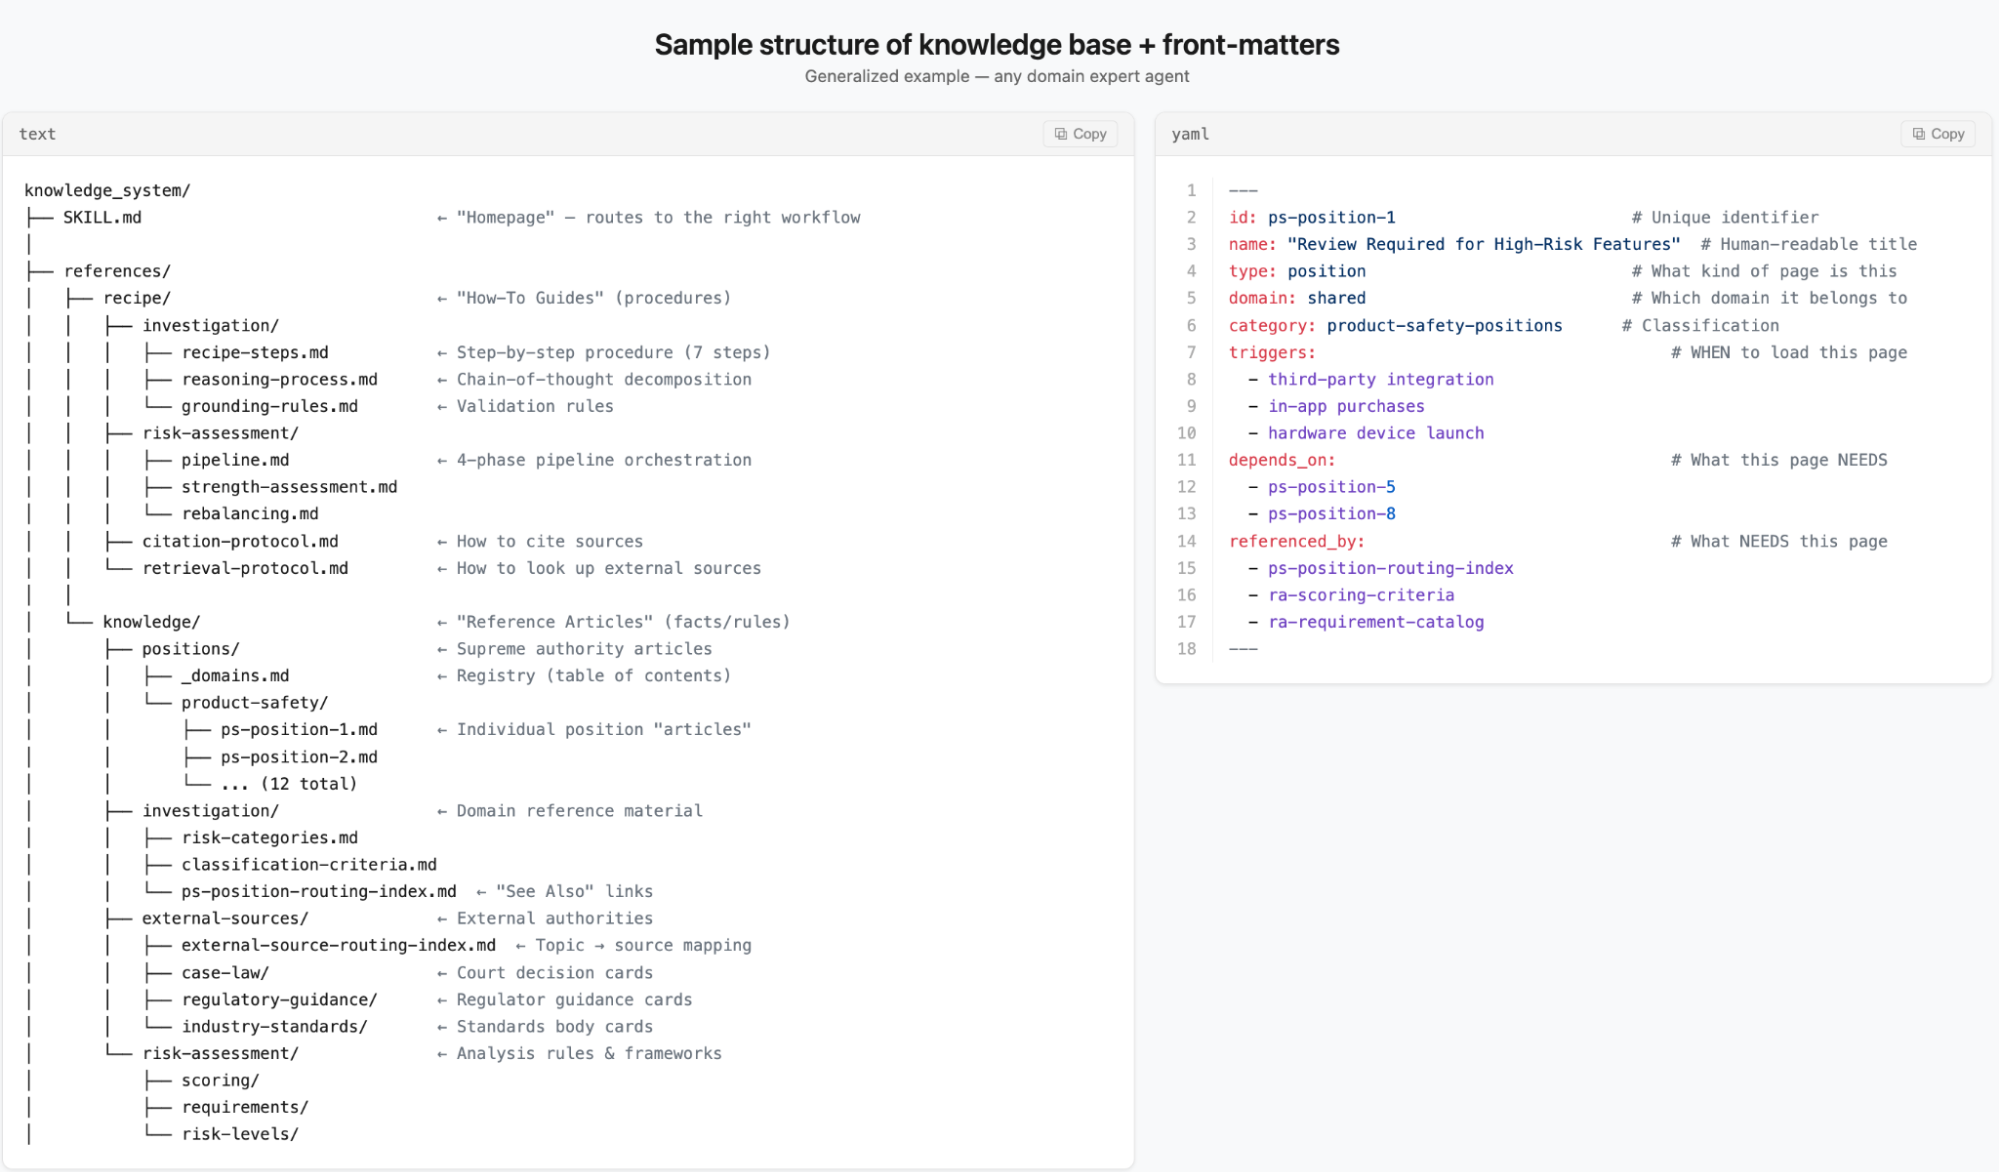 Иллюстрация системы знаний: файлы организованы в виде навигационной файловой системы (слева), а YAML-шапка каждого файла (справа) указывает условия его применения (триггерные сценарии), а также его зависимости и потребителей, образуя двунаправленный граф зависимостей, по которому агент может легко перемещаться и который может легко поддерживать.
Организация знаний по плотности и частоте использования
Ключевое архитектурное решение заключается в том, как разделить знания между курируемой вики и дополнительным поиском (RAG). Мы разделяем их по информационной плотности и ожидаемой частоте использования.
Высокоплотные и часто используемые источники отправляются в вики: дистиллированные файлы, отражающие логику рассуждений организации, такие как позиции, схемы принятия решений, примеры граничных условий и стратегические интерпретации. Агент обращается к ним практически при каждом запросе. Поскольку они кодируют развивающееся мышление организации, они должны оставаться актуальными, а структура вики делает их простыми для обновления, версионирования и валидации.
Разреженные, ситуативно релевантные источники обслуживаются посредством семантического или лексического поиска (RAG): документы, которые чрезвычайно важны при их применении, но не нужны в деталях при большинстве запусков, такие как подробные справочные материалы, индивидуальные спецификации продуктов, исторические протоколы решений и нишевые внешние знания. Загрузка их всех в вики перегрузила бы систему и рассеяла внимание.
В результате основные рассуждения агента всегда опираются на самые отточенные, актуальные организационные знания, и в то же время он может обратиться к вспомогательным данным, когда этого требует ситуация. Эта комбинация создает организационный «второй мозг», который кодирует то, как организация интерпретирует и применяет информацию, а не только то, где ее найти.
Экспертные рассуждения через компонуемые рецепты
Одних знаний недостаточно. Эксперты предметной области не просто извлекают факты из памяти, они следуют структурированным методологиям: финансовый аналитик пошагово работает с моделью оценки, инженер по безопасности следует процедуре моделирования угроз. Задача состоит в том, чтобы зафиксировать эти методологии в форме, которую LLM может надежно выполнить.
Мы решаем эту задачу с помощью компонуемых процедур, которые мы называем рецептами. Если файлы знаний носят декларативный характер, то рецепты — императивный. Каждый из них предписывает многоэтапный аналитический рабочий процесс, определяя, что исследовать в первую очередь, какие знания загружать на каждом шаге, каким процедурам принятия решений следовать и что представляет собой полный анализ.
Ключевой архитектурный выбор — разделение того, что агент знает, и того, как он рассуждает. Рецепты ссылаются на файлы знаний, но не содержат доменных фактов; файлы знаний фиксируют позиции, но не предписывают процедуры. Это означает, что:
- Добавление организационной позиции означает добавление файла знаний и обновление индекса маршрутизации. Никаких изменений в рецептах.
- Исправление ошибки в методологии агента означает редактирование рецепта. Никаких изменений в файлах знаний.
- Ошибки четко локализуются в одном из слоев. Что было неверно: знания или процедура?
Рецепты объединяются в конвейеры, подобно тому как шеф-повар делегирует задачи подрецептам для каждого компонента (соус, белок, гарнир), не содержащим этих деталей внутри самого мастер-рецепта ужина. Наш рецепт маршрутизации верхнего уровня анализирует входные данные и выбирает, какие последующие рецепты запустить, причем каждый из них отвечает за свой этап анализа.
Это также обеспечивает постепенное раскрытие информации (progressive disclosure). Вместо того чтобы перегружать систему монолитным набором инструкций, охватывающих все возможные сценарии, каждый шаг рецепта содержит только те инструкции и знания, которые относятся к данному этапу. Ранние версии использовали один плоский файл инструкций и загружали все источники через семантический поиск, подтягивая в контекстное окно огромное количество файлов смешанной релевантности при каждом запуске. После реструктуризации на этапы, управляемые рецептами, каждый запрос затрагивает лишь небольшую, целенаправленную подмножество, сокращая потребление токенов за один запрос примерно на 80%. Контекстные окна конечны, а внимание снижается с увеличением объема, поэтому доставка нужных инструкций в нужное время напрямую повышает качество рассуждений.
Сохранение контроля за людьми
Человеческие эксперты сохраняют контроль над этой системой на всех этапах. Агент ускоряет и структурирует их работу; он не заменяет их суждения или их авторитет в отношении результатов.
Мы обеспечиваем это с помощью двух механизмов:
Контрольные точки (чекпоинты) — это определенные моменты в анализе, когда агент выводит свои промежуточные рассуждения на экспертную оценку перед продолжением работы, а эксперт может подтвердить их, исправить или перенаправить процесс.
Эскалации срабатывают, когда агент сталкивается с реальной неопределенностью, будь то из-за нечетких входных данных или свидетельств, поддерживающих более чем одну допустимую трактовку. Вместо того чтобы принудительно принимать решение, он передает вопрос эксперту, чей выбор определяет дальнейший путь анализа.
Контрольные точки и эскалации одновременно служат трем целям:
- Контроль качества и направления: эксперты ловят ошибки до того, как они усилятся на последующих этапах, и удерживают анализ на том пути, который считают наиболее приоритетным.
- Сигнал для обучения: каждое исправление и каждая эскалация становятся входными данными для цикла самосовершенствования.
- Калибровка доверия: эксперты постепенно обретают уверенность, наблюдая за ходом рассуждений агента, а не только за его финальным результатом, а также видя, как он сигнализирует о неопределенности, вместо того чтобы маскировать ее.
Чем серьезнее принимаемое решение, тем важнее этот аспект, поэтому мы рекомендуем по умолчанию сохранять человека в контуре принятия решений (human-in-the-loop) в таких областях, как комплаенс, оценка финансовых рисков, проверка безопасности и инженерная безопасность.
Маховик самосовершенствования
Мы считаем маховик самосовершенствования самой отличительной особенностью этой системы. В то время как структурированная система знаний и компонуемые рецепты создают систему, понятную как для людей, так и для агентов, тестируемую и модульную, огромное количество взаимозависимых файлов делает ручное обслуживание невозможным для масштабирования. Когда эксперты предметной области предоставляют агенту обратную связь, эту обратную связь необходимо трансформировать в точечные правки файлов. Этот процесс может занимать недели, так как требует понимания полного графа зависимостей, проверки того, что ничего не сломается, и валидации работоспособности исправления.
Существует большой пласт работ — от систем памяти RAG до редактирования знаний на уровне весов моделей, — посвященный тому, как агенты хранят, извлекают и обновляют знания. Однако гораздо меньше внимания уделяется поддержанию точности базы институциональных знаний на основе документов по мере ее роста и эволюции позиций экспертов. Агенты, которые самостоятельно создают черновики исправлений, становятся все более распространенными;, но мы еще не видели такого уровня строгости валидации, применяемого к структурированной базе знаний без дообучения модели.
Мы рассматриваем такое обслуживание как задачу компиляции и автоматизируем ее. Каждое исправление эксперта проходит через четыре фазы:
- Диагностика отзывов экспертов с выявлением поддающихся решению проблем и их первопричин.
- Компиляция проблем в минимальные проверенные правки.
- Валидация того, что исправления работают без регрессий.
- Экспертная проверка профильными специалистами.
После завершения цикла набор регрессионных тестов пополняется только что устраненной проблемой, чтобы будущие обновления сохраняли это поведение.
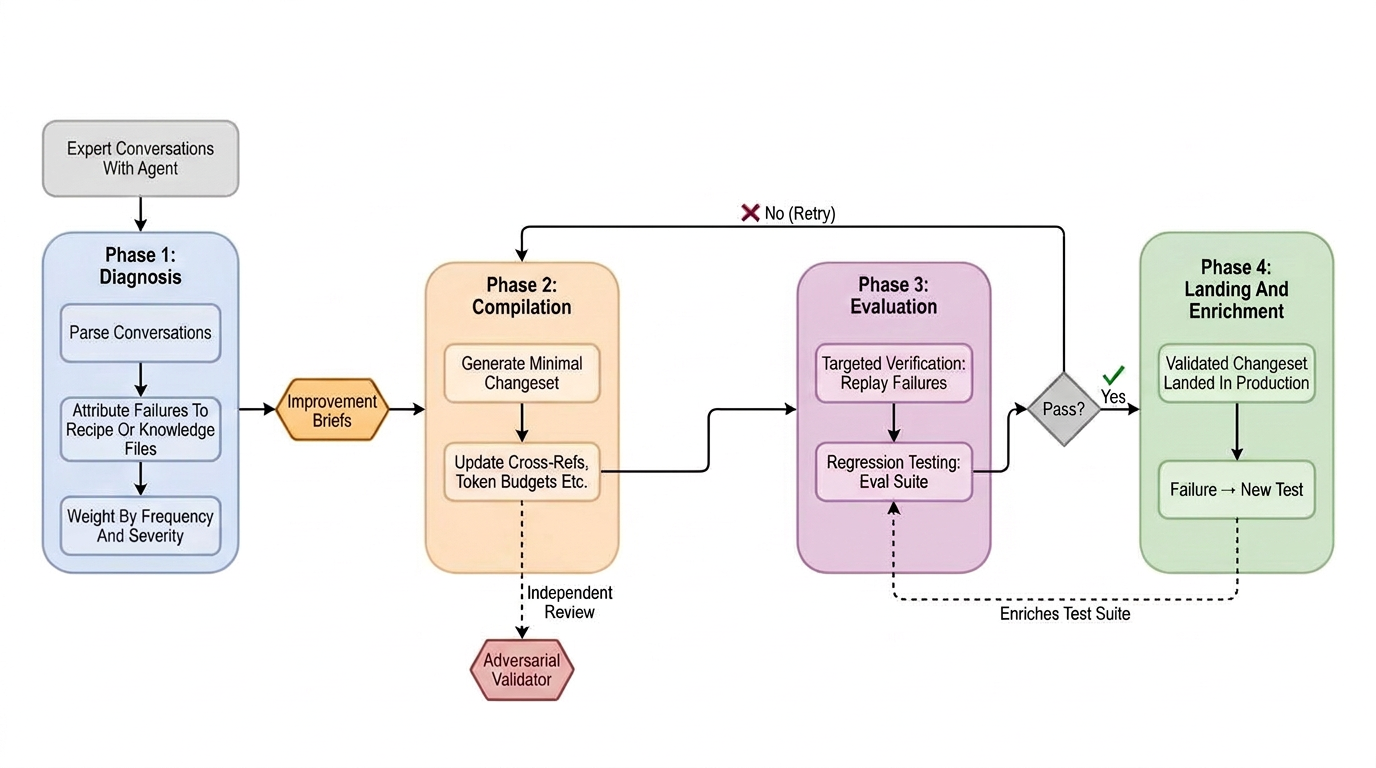 Цикл самосовершенствования. Экспертные исправления диагностируются до их первопричины, компилируются в минимальные проверенные правки и оцениваются с помощью повторного прогона и регрессионных тестов перед тем, как быть рассмотренными и принятыми. Затем каждое исправление интегрируется в набор регрессионных тестов, делая прирост качества перманентным.
Диагностика: отнесение каждого исправления к первопричине
Исходные отзывы экспертов поступают из трассировок диалогов, где SME взаимодействовали с агентом и давали исправления. Фаза диагностики извлекает из этих диалогов структурированные сигналы.
Наш первый подход классифицировал обратную связь по форме диалога. Если эксперт предоставлял информацию — значит, это пробел в знаниях; если он перенаправлял агента — значит, проблема в процедуре. Этот эвристический метод потерпел неудачу, потому что форма диалога плохо отражает первопричину. Эксперт, исправляющий выводы, может обнажить пробел в знаниях, изъян в рецепте или реальную неопределенность.
Рабочий подход разделяет извлечение и классификацию. Сначала извлекается каждый содержательный сигнал от эксперта наряду с полным манифестом знаний агента (какие файлы были загружены, когда и как использовались). Затем читаются фактические файлы знаний и применяется единый тест атрибуции: мог ли агент прийти к правильному выводу на основе своих исходных материалов?
- Если материалы содержали правильный ответ, но агент все равно ошибся — проблема в рецепте.
- Если материалы не содержали правильного ответа — пробел в знаниях.
- Если сами эксперты не согласны с правильным ответом — неопределенность, помеченная для обсуждения с человеком.
Компиляция: точечные правки мультиагентов
Компилятор переводит каждую диагностированную проблему в минимальные изменения файлов. Субагенты анализируют влияние параллельно, изучая перекрестные ссылки, конфликты с существующими позициями, влияние на бюджет токенов, тестовое покрытие и риск дублирования.
Два дизайнерских решения делают этот процесс заслуживающим доверия:
Независимая состязательная проверка. Отдельный агент, работающий в свежем контексте без знания логики улучшений, получает только предложенные диффы к базе знаний. Его задача — найти проблемы, такие как внесенные противоречия, нарушение граничных условий или подрыв позиций. Поскольку у него нет общего контекста с предлагающими агентами, он не может унаследовать их «слепые зоны».
Детерминированная структурная валидация. Линтер программным путем выявляет проблемы: висячие перекрестные ссылки, нарушения лимита размера файлов, коллизии идентификаторов и циклы зависимостей. Этот уровень не является вероятностным. Он либо проходит проверку, либо нет.
Оценка: доказательство работоспособности исправления
Каждое предлагаемое изменение проходит двухэтапную проверку:
Целевой повторный прогон (replay) запускает агента на исходном сценарии, который вызвал обратную связь. Агент не знает, что его тестируют. Независимый судья оценивает новый результат на основе первоначального отзыва эксперта, не зная, что именно было изменено. Такой намеренно слепой подход предотвращает предвзятость подтверждения. Если целевой прогон не удался, компиляция повторяется.
Регрессионное тестирование запускает несколько бенчмарков для данной области, которые обычно представляют собой структурированные тестовые наборы пар «вопрос-ответ». Для аналитических областей, где может существовать несколько правильных ответов, независимый судья на базе LLM выставляет каждому тестовому случаю оценку «пройдено/не пройдено» на основе определенных критериев. Агент запускается в параллельных, независимых сессиях с вопросами бенчмарка, и обнаруживаются регрессии производительности. Если регрессионное тестирование не проходит, компиляция повторяется с обновленным промптом, описывающим, где именно у агента произошла регрессия, а также исходную проблему и попытку исправления.
Внедрение и обогащение: кумулятивный эффект
Результатом работы конвейера является пул-реквест (дифф) с полным журналом аудита. Эксперт-человек проверяет уже проверенное исправление, а не отлаживает первоначальный сбой. Как только исправление одобрено и внедрено (файл знаний или рецепт обновлены), исходный сценарий сбоя и его проверенный правильный ответ автоматически добавляются в набор регрессионных тестов. Это означает, что каждое исправление навсегда поднимает планку качества, и будущие изменения в системе знаний должны сохранять поведение, которое только что было скорректировано.
Результаты
После трех спринтов разработки, занявших в общей сложности шесть недель, система достигла следующих результатов:
- Профильные эксперты оценили результаты работы агента как полезные почти всегда, что стало значительным улучшением по сравнению с ранними версиями, где результаты часто требовали серьезной доработки.
- Сокращение времени индивидуальной оценки с дней до минут.
- Автоматизированное самосовершенствование, создающее проверенные правки знаний с темпом, который ранее требовал полноценных инженерных спринтов.
- Нулевое количество регрессий в ходе циклов улучшений, причем каждое исправление автоматически усиливает набор регрессионных тестов.
- Эксперты предметной области неизменно сообщали, что агент справляется с подавляющим большинством аналитической работы, позволяя им сосредоточиться на по-настоящему неоднозначных случаях, требующих человеческого суждения.
Применение этой архитектуры
Конкретная область, для которой мы создали эту систему, требовала синтеза десятков источников (как внутренних позиций, так и внешних материалов) в оценки с учетом рисков. Но архитектура не зависит от конкретной сферы. Она применима везде, где:
- Специализированные знания существуют в виде неформальных знаний («трайбл-знаний») в головах экспертов.
- Важна согласованность результатов оценок.
- Объем работы превышает доступные экспертные ресурсы.
- Готовые LLM выдают неадекватный анализ.
Конкретные сферы, где применим этот шаблон, включают нормативный комплаенс, соблюдение протоколов, оценку финансовых рисков, проверки безопасности, соответствие инженерным стандартам и оценку закупок. Общая черта заключается в том, что организациям нужны ИИ-системы с подлинной институциональной экспертизой, а не просто общими знаниями.
Требования для внедрения этой архитектуры:
- Структурированная система знаний с четкими границами файлов, перекрестными ссылками и графом зависимостей (организационный «второй мозг» для данной сферы).
- Процедурный уровень, отделяющий доменные знания от аналитической методологии (рецепты).
- Автоматизированный набор тестов для оценки, который растет с каждым циклом улучшений.
- Контрольные точки с участием человека (Human-in-the-loop checkpoints), откалиброванные под толерантность к риску в данной области.
Более глубокий принцип прост: держите сложность в текстовых файлах, читаемых как людьми, так и агентами, а не в настроенных весах моделей. Каждое улучшение представляет собой правку текста, которую эксперт может проверить за 30 секунд. Каждое изменение версионируется, поддается сравнению (диффу) и обратимо. Конвейер компиляции сложен, но его результаты всегда прозрачны.
Цель состоит в создании системы, в которой усилия экспертов постоянно приумножаются. Каждое взаимодействие с экспертом делает систему лучше. Каждое исправление сохраняется как проверенное улучшение. Коллективные знания организации перестают быть заперты в отдельных людях и начинают быть доступными — стабильно и в масштабе — всем, кто в них нуждается.
Благодарности
Авторы хотели бы выразить благодарность за вклад следующим людям, сыгравшим ключевую роль в разработке этой системы. В частности, мы хотели бы выразить особую благодарность (в алфавитном порядке фамилий): Сесилии Бэк (Cecilia Baek), Филиппу Кауфольду (Philipp Kaufold), Кэт Хьюз (Cat Hughes), Сюзанне Лейтен (Suzanne Leijten), Майклу Маркусе (Michael Marcusa), Жорди Моле (Jordi Mola), Тимоти Нео (Timothy Neo), Эллиотту Прентиссу (Elliott Prentiss), Лайе Рейес (Laia Reyes), Джону Россу (John Ross), Хулио Сантилу (Julio Santil), Тейлору Уилсону Томасу (Taylor Wilson Thomas), Манси Трипати (Mansi Tripathi), Нихилу Шанбхагу (Nikhil Shanbhag), Мадлен Вос (Madeleine Vos), , а также Джеки Заяк (Jackie Zajac).
