История о двух автоскейлерах Flink
Сэмюэл Йебоа (Samuel Yeboah), Франческо Ди Кьяра (Francesco Di Chiara) и Минлян Лю (Mingliang Liu)
Сегодня в Netflix работают два автоскейлера Flink. И это ровно на один больше, чем нам хотелось бы. Первый мы создали своими силами много лет назад, когда на рынке не было зрелых решений, подходящих для нашей платформы. Второй появился благодаря сообществу Apache Flink, и он способен масштабировать рабочие нагрузки, для работы с которыми наша собственная система никогда не проектировалась. Сейчас мы используем оба решения в production и постепенно переходим на вариант с открытым исходным кодом. В процессе мы усвоили несколько суровых уроков о метриках, стоимости и реальной цене поддержки собственной инфраструктуры вместо использования готовой. Мы надеемся, что этот опыт окажется полезным независимо от того, запускаете ли вы несколько задач Flink или десятки тысяч.
Почему автоскейлеры при наших масштабах — это необходимость
Netflix занимается потоковой обработкой данных на базе Apache Flink с 2017 года. По состоянию на 2026 год мы управляем более чем 30 000 задач Flink в нескольких регионах AWS. Большинство из них развертываются не вручную, а генерируются нашей управляемой платформой Data Mesh, поэтому подавляющее большинство пользователей никогда не сталкиваются с задачами Flink напрямую. Небольшая, но растущая часть — это пользовательские задачи, создаваемые и управляемые командами по всей компании для таких сценариев, как персональные рекомендации, реклама (Ads) и прямые трансляции (Live events). Они варьируются от простых однооператорных заданий, пересылающих записи между топиками Kafka, до конвейеров с сохранением состояния (stateful), ветвлениями, объединениями и терабайтами состояния, а их нагрузка колеблется в зависимости от суточных циклов, релизов и региональных переключений при сбоях.
Выделение ресурсов под пиковые нагрузки для каждой такой задачи расточительно; выделение под средние показатели приводит к задержкам во всплесков. Кроме того, в нашей платформе процедура масштабирования не бесплатна: по умолчанию она требует создания точки сохранения (savepoint), корректной остановки задачи и ее перезапуска в новом масштабе, что для крупной задачи с состоянием может занять минуты. Это порождает сложную задачу: как предоставить каждой задаче необходимые ресурсы именно тогда, когда они нужны, без участия человека и без сбоев?
Первый автоскейлер: внешний мониторинг
Наш первый ответ, созданный примерно в 2019 году, представлял собой автоскейлер, устроенный по принципу задачи потоковой обработки. Он работал на платформе Mantis и обрабатывал поток метрик уровня кластера в реальном времени из Atlas (нашей платформы телеметрии), включая сигналы ЦП, сети, задержки в Kafka, скорости поступления и потребления для каждой задачи. Скейлер объединял время «догонки», рассчитываемое на основе задержки, пороги использования ЦП/сети, историю наблюдаемой производительности и регрессию по недавней скорости входного потока, чтобы решить, когда нужно увеличить масштаб или сможет ли меньший кластер справиться с окном прогнозирования. Поскольку автоскейлер работает независимо от платформы Flink, на него не влияют проблемы внутри самого Flink. Реализация его в виде потоковой задачи также упростила масштабирование. Каждый узел автоскейлера обрабатывал метрики для подмножества задач Flink, и нам никогда не приходилось писать собственную логику шардинга или координации, чтобы успевать за растущим парком Flink. Это решение надежно снизило потребление ресурсов на 25–45% для тысяч управляемых конвейеров. Подробнее о нем можно узнать из нашего выступления на конференции Flink Forward 2020.
Но у внешнего мониторинга есть свои пределы. Система оценивала весь кластер на основе общих метрик контейнеров и управляла лишь одним параметром — общим количеством TaskManager, из-за чего все операторы внутри задачи масштабировались одновременно. Это подходило для простеньких однооператорных конвейеров, но не для многооператорных графов зависимостей (DAG) с состоянием, которые команды все чаще приносили нам для задач рекламы, рекомендаций и игр. Именно с такими задачами система справляться не могла, и поддержка каждого нового случая требовала добавления специальной логики вместо универсальных возможностей.
Автоскейлер эффективен ровно настолько, насколько качественны метрики, предоставляемые внешними системами под ним. Эти метрики могли не замечать реальных проблем: задача могла быть полностью загружена, но это никак не отражалось на уровне использования ЦП, в результате чего задача застревала в деградировавшем состоянии, которое скейлер не мог зафиксировать. Недавно сетевая миграция незаметно изменила способ передачи данных о некотором трафике, и часть метрик Atlas, на которые полагался скейлер, перестала корректно фиксировать происходящее. Проблема оставалась невидимой до тех пор, пока не проявилась в production гораздо позже.
Пришло время пересмотреть подход создания и покупки готового.
Второй автоскейлер: анализ изнутри
Когда мы только начинали, сообщество Flink не могло предложить зрелых автоскейлеров. К моменту нашего повторного анализа такое решение появилось: автоскейлер Apache Flink. Вместо того чтобы следить за контейнерами извне, он анализирует состояние изнутри задачи.
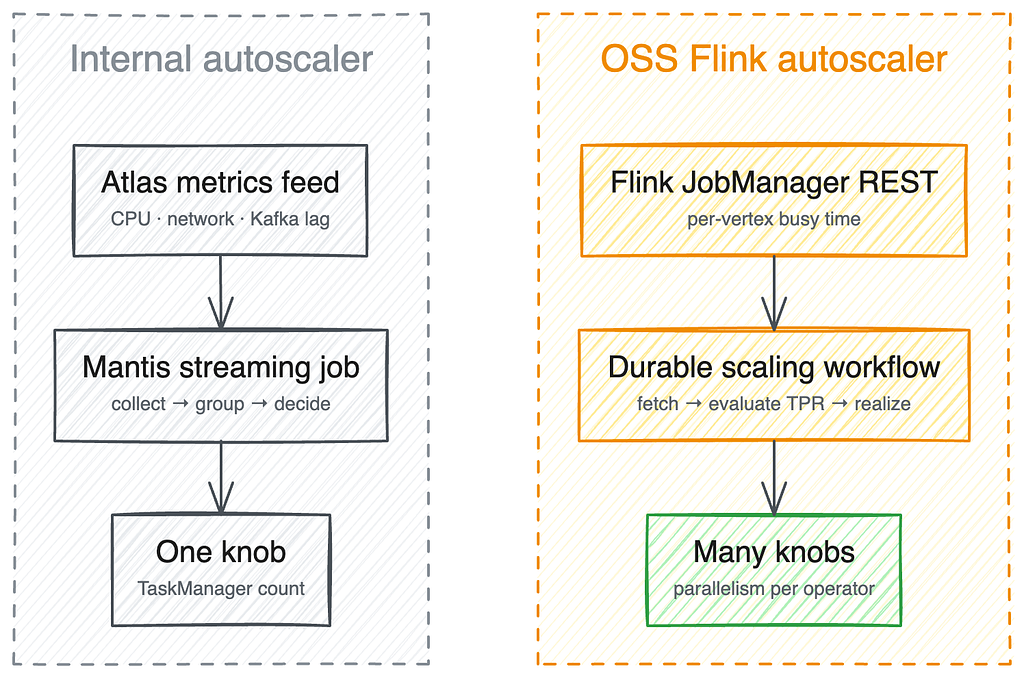 Рисунок 1. Архитектура двух автоскейлеров Flink
Его главная идея заключается в оценке истинной скорости обработки (true processing rate, TPR) каждого оператора: пропускной способности, которую он мог бы поддерживать при полной загрузке. Flink сообщает для каждой подзадачи долю секунды, затраченную на выполнение полезной работы, отдельно от времени ожидания из-за обратного давления (backpressure) или простоя. Деление наблюдаемой пропускной способности на эту долю занятости позволяет экстраполировать производительность до полной загрузки: оператор, обрабатывающий 700 записей/сек при загрузке 70% времени, имеет TPR 700 / 0,7 = 1000 записей/сек. Начиная с источников, автоскейлер обходит граф задачи и использует TPR каждого оператора, коэффициенты его ввода/вывода и целевой уровень загрузки для расчета параллелизма, необходимого каждой вершине, чтобы ни один оператор не стал узким местом, вместо изменения размера всего кластера целиком.
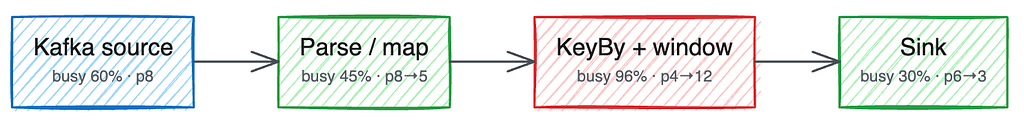 Рисунок 2. Граф Flink: текущий и желаемый параллелизм для каждой вершины на основе загруженности
Эти два подхода предполагают разные условия работы, сведенные в таблицу ниже.
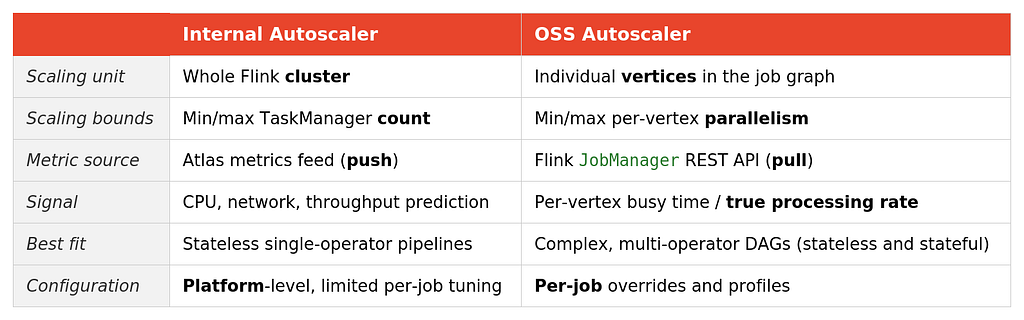 Таблица 1. Сравнение двух автоскейлеров Flink
Решающим различием для нас стали две последние строки: автоскейлер с открытым исходным кодом (OSS) может масштабировать именно те многооператорные задачи с состоянием, с которыми наша собственная система не справлялась, и он позволяет каждой задаче использовать собственную конфигурацию — периоды стабилизации, пороговые значения и другие параметры масштабирования, настроенные под конкретную рабочую нагрузку. Благодаря этому он идеально подошел для пользовательских задач, которые команды раньше масштабировали вручную.
Внедрение в масштабах Netflix
Внедрить сам алгоритм оказалось несложно — сообщество проделало самую тяжелую работу. Нашей задачей было обеспечить его надежную работу для наших собственных заданий, и именно здесь наша система больше всего отличается от стандартного развертывания с открытым исходным кодом.
Во-первых, изначально OSS-автоскейлер проектировался для работы в составе оператора Kubernetes для Flink, но наша платформа Flink работает на собственной плоскости управления (control plane), а не на этом операторе (см. наше прошлое выступление на конференции Current Conference 2024). Позже сообщество приняло отличное решение сохранить основную логику в виде отдельной библиотеки. Они выделили четыре универсальных интерфейса, упростивших интеграцию в нашу внутреннюю экосистему: контекст, содержащий метаданные задачи и информацию о REST API, хранилище состояния, обработчик событий и инструмент реализации (realizer), который применяет решения о масштабировании.
Этот сервис представляет собой приложение Spring Boot, оркестрация которого выполняется на Temporal — движке долгоживущих рабочих процессов. Рабочий процесс-оркестратор опрашивает нашу плоскость управления Flink примерно раз в минуту в поисках задач с включенным автоскейлером и запускает один долгоживущий рабочий процесс для каждой такой задачи. Каждый процесс для конкретной задачи извлекает метрики по ее вершинам из соответствующего менеджера задач (Flink JobManager), выполняет алгоритм оценки OSS и при принятии решения о масштабировании передает его модулю реализации, который выполняет изменения через нашу плоскость управления Flink.
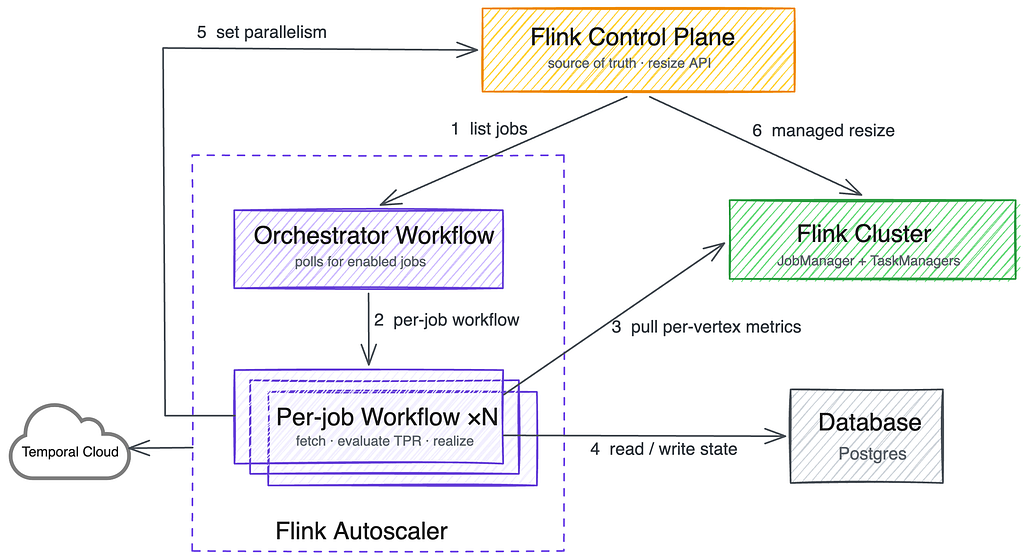 Рисунок 3. Архитектура автоскейлера Flink на базе OSS с использованием процессов Temporal
Архитектура «один рабочий процесс на задачу» стала прямой реакцией на прошлые проблемы. Сначала мы выполняли оценку в рамках единого пакетного цикла для всего набора задач, и это оказалось ненадежным: одна медленная или сбоящая задача могла заблокировать сбор метрик и масштабирование для всех последующих задач. Выделение для каждой задачи собственного долгоживущего рабочего процесса изолировало зону поражения, так что теперь отдельная проблемная задача дает сбой и повторяет попытку автономно, а среда выполнения масштабируется по мере подключения новых задач.
Во-вторых, между формулой «работает в сообществе» и «работает в масштабах Netflix» оставалось три инженерных пробела:
- Сбор метрик при высоком параллелизме. В крупных задачах извлечение метрик из JobManager становилось узким местом, причем отчасти из-за особенностей среды выполнения Flink. Чтобы решить эту проблему, мы изменили JobManager так, чтобы он кэшировал имена временных метрик и очищал их за один раз вместо повторного сканирования при каждом запросе, а также добавили фильтрацию на стороне сервера, чтобы автоскейлер запрашивал только те метрики, которые ему действительно нужны. Это позволило автоскейлеру работать с задачами, имеющими до 3000 подзадач Flink (ранее он с трудом справлялся с объемами примерно от 1000). Часть этих изменений вошла в наш внутренний форк релиза Flink, а некоторые были переданы в основной проект через апстрим, например FLINK-36172.
- Сохранение цепочки перенаправления (forward chaining). Две раздельные вершины, соединенные прямым (forward) соединением, должны работать с одинаковым уровнем параллелизма, поскольку записи передаются в памяти по фиксированному локальному каналу. Если масштабировать только одну из них, Flink не выдает ошибку — он молча преобразует это соединение в сетевое перемешивание (shuffle). Наш форк обнаруживает подграфы с прямым соединением и масштабирует их как единое целое.
- Учет ограничений приемников (sinks). Некоторые приемники имеют ограниченную емкость записи, поэтому мы добавили определение обратного давления для асинхронных приемников (также изменение на уровне форка), чтобы автоскейлер не масштабировал задачу для приемника, который не способен принять больший объем данных.
Перед тем как применить изменения, модуль реализации выполняет ряд проверок безопасности. Например, он отказывается уменьшать масштаб задачи в регионе, из которого выводятся мощности во время общекорпоративного переключения при региональном сбое. Он также проверяет, достаточно ли дискового пространства для нового кластера, чтобы сохранить состояние чекпоинта задачи, и добавляет небольшой резервный буфер для более крупных кластеров.
Путь к единому автоскейлеру
В прошлом году автоскейлер на базе OSS вышел на этап общей доступности (GA) для пользовательских задач в Netflix, продемонстрировав многообещающие первые результаты. Например, наша команда клиентской телеметрии и логирования добилась снижения годовых затрат на вычисления Flink на 58%, сэкономив примерно 1,1 миллиона долларов в год. Эта эффективность обусловлена тремя ключевыми факторами. Во-первых, в то время как статическое выделение ресурсов всегда должно учитывать пиковые нагрузки, автоскейлер динамически адаптируется к суточным циклам, компенсируя падение трафика в ночное время и выходные по сравнению с пиками будней. Во-вторых, вместо того чтобы полагаться на ручную оптимизацию ресурсов командами после улучшений производительности или спадов после праздников, автоскейлер постоянно корректирует емкость. Наконец, использование унифицированных размеров контейнеров обеспечивает оптимальное размещение ресурсов (bin-packing) и более детальные шаги масштабирования.
Кроме того, чрезмерно поспешное уменьшение масштаба таит в себе скрытые опасности. Если сократить ресурсы слишком сильно, загрузка ЦП достигнет предела, задержки резко возрастут, а система не сможет отреагировать мгновенно, поскольку после каждого перезапуска ей приходится заново формировать окно метрик и период стабилизации. Сейчас мы используем целевой показатель загрузки 0.45, что ниже принятого по умолчанию в сообществе значения 0.7, осознанно жертвуя небольшой долей эффективности ради стабильности. Для крупных задач с состоянием редкие и более плавные изменения масштаба стоят небольших дополнительных затрат.
Хотя наш скейлер предоставляет детализированные сигналы и модули принятия решений на уровне вершин для графов с состоянием, быстрое изменение масштаба по-прежнему сильно зависит от производительности восстановления состояния в Flink Core. На сегодняшний день главным источником затрат при масштабировании задач с состоянием является не логика скейлера, а сам процесс перезапуска и восстановления состояния. Flink 2 решает эту проблему с помощью архитектуры дезагрегированного состояния (disaggregated state), которая хранит состояние в удаленном хранилище, а не на локальном диске, что позволяет существенно снизить зависимость времени реконфигурации или восстановления от общего объема состояния. Начав поддержку Flink 2.2 в Netflix, мы планируем поэкспериментировать с этим новым бэкендом состояния, чтобы выяснить, поможет ли он устранить узкие места при восстановлении состояния в процессе масштабирования крупных задач.
В перспективе мы стремимся перенести все внутренние сценарии использования автоскейлеров на новое решение на базе OSS, чтобы упростить нашу инфраструктуру.
Основные выводы
В процессе работы мы выделили три урока, применимых далеко за пределами Flink:
- Выбор метрик важнее сложности алгоритма. Наш самый полезный отладчик редко касался математики масштабирования — речь шла о том, какому сигналу стоит доверять больше всего. Разберитесь в своих метриках, прежде чем настраивать алгоритм.
- Устанавливайте разумные значения по умолчанию, но оставляйте пространство для настройки. Наши управляемые задачи достаточно похожи друг на друга, чтобы одно хорошее значение по умолчанию подходило для большинства из них без изменений, в чем и заключается суть платформы. Но навязывание единой конфигурации для каждой задачи наказывает те из них, которым она не подходит, поэтому мы сочетаем настройки по умолчанию с возможностью переопределения для отдельных задач и намеренно скрываем те рычаги управления, которые требуют глубокой экспертизы. Большинству команд вообще не нужно думать об автоскейлере.
- Применяйте готовое, а затем расширяйте. Мы создавали решения своими силами, потому что в 2019 году на нашей платформе не было ничего подходящего и зрелого. Когда появился сильный проект сообщества, правильным шагом было не защищать наши инвестиции вечно и не выбрасывать их в одночасье, а внедрить его для новых рабочих нагрузок, вернуть исправления обратно в сообщество и спланировать постепенную миграцию.
Благодарим команды Flink и Data Mesh за изменения плоскости управления, от которых зависела эта работа, команду Temporal и наши первые пилотные команды, а также мейнтейнеров автоскейлера Apache Flink, на фундаменте которого мы строили свое решение. От особая благодарность Энди Чангу (Andy Zhang), Кэлвину Чуенгу (Calvin Cheung), Дэниелу Трагеру (Daniel Trager), Гуилу Пиресу (Guil Pires), Марку Чо (Mark Cho), Мэтью Корницкому (Matthew Kornitsky), Нихилу Сулегаону (Nikhil Sulegaon), Суджаю Джаину (Sujay Jain) и Тому Ли (Tom Lee).
История о двух автоскейлерах Flink была изначально опубликована в блоге Netflix TechBlog на платформе Medium, где продолжается ее обсуждение.
