Превратите один гигантский пулл-реквест, созданный ИИ, в проверяемый стек
Вспомните последнюю крупную функцию, которую вы выпустили. Будьте честны: вы впихнули ее в один гигантский пулл-реквест или разбили на несколько более мелких и узконаправленных? Годами вам приходилось молча выбирать между двумя крайностями: либо наблюдать, как пулл-реквест разрастается до таких размеров, что его код превращается в кошмар для ревьюера, либо разбивать его на цепочку мелких пулл-реквестов, за которыми приходится присматривать, синхронизировать вручную и распутывать конфликты каждый раз, когда ниже по цепочке вносятся изменения.
У обоих вариантов есть свои плюсы и минусы. Один трудно проверять, другой трудно поддерживать. И в тот день ваш выбор обычно склонялся в сторону наименее болезненного варианта.
А теперь добавьте агентов кодирования. Они невероятно продуктивны и, по данным Gartner, к 2028 году обеспечат прирост производительности на 50% на каждом этапе жизненного цикла разработки ПО (SDLC). Но они не избавят вас от необходимости решать, как структурировать пулл-реквесты. Напротив, они только усиливают эту необходимость.
В этой статье мы на конкретном примере рассмотрим, как использовать стекированные пулл-реквесты для упрощения ревью.
Допустим, вы задаете промпт на добавление поиска продуктов в помощник по покупкам, отходите от компьютера и буквально через несколько минут возвращаетесь, чтобы провести ревью, внести коррективы и одобрить результат. Но присмотритесь к тому, что обычно попадает в этот единственный пулл-реквест:
- Новая модель данных и ее начальные данные (seed data)
- Маршрут API и его валидация
- Обвязка клиентской части, пользовательский интерфейс, состояния пустоты, резервные варианты и ошибки
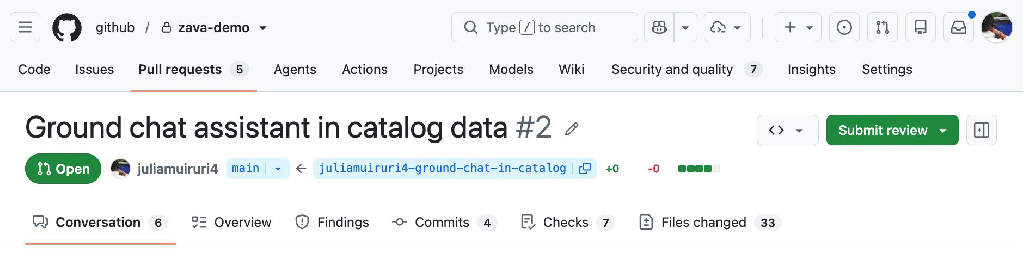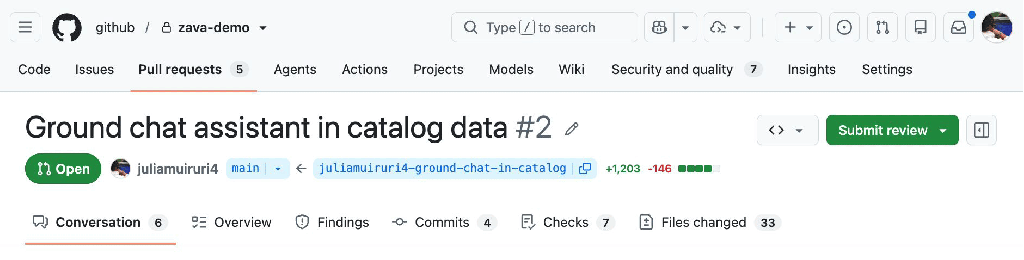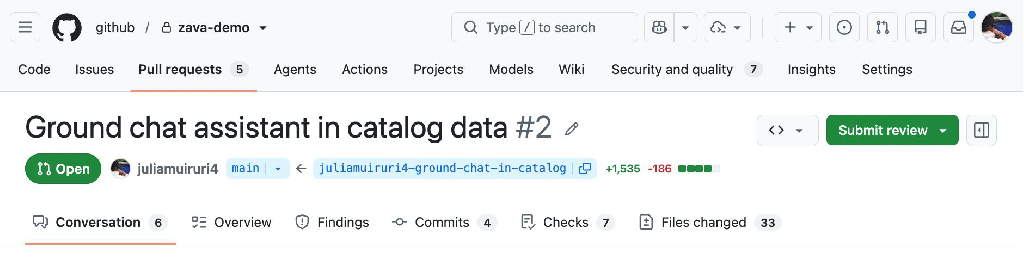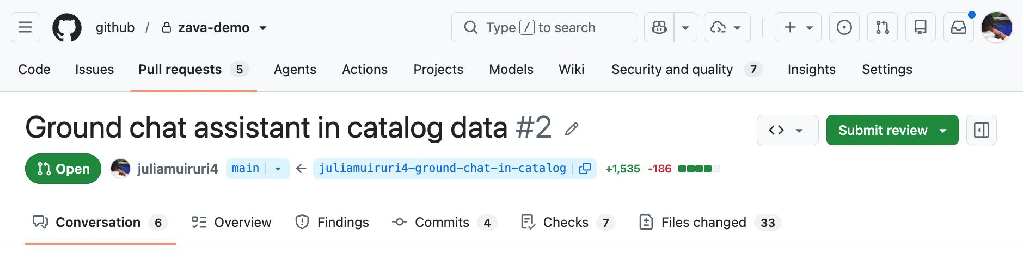
…и все это (и даже больше) — в одном гигантском diff-файле размером более 1000 строк.
Для агентов, которые в основном обучались на том, как код традиционно писался годами, такой паттерн является стандартом по умолчанию. Давайте проиграем этот сценарий.
Вы хотите добавить поиск товаров в существующее веб-приложение, а ваше исходное состояние выглядит так:
- Имитация ИИ-помощника, выдающего ответы из генератора случайных строк
- Неконсистентные данные о товарах, жестко зашитые в код (hardcoded) и разбросанные по компонентам
- Отсутствует модуль каталога, API, уровень данных — вообще ничего нет
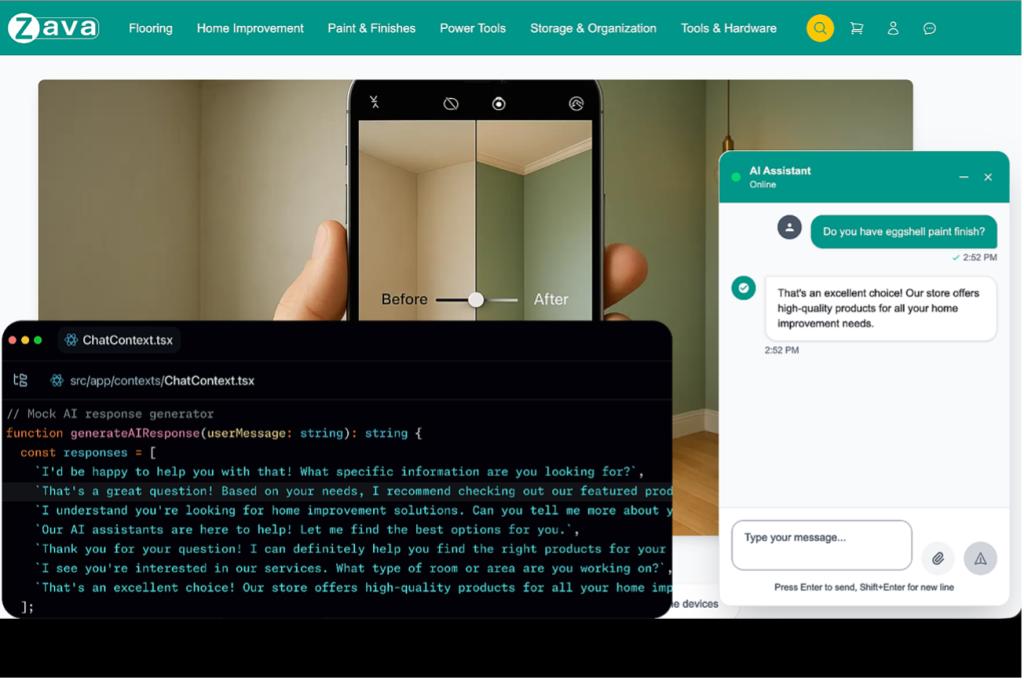
Создается задача на реализацию функции. Типичный рабочий процесс предполагает создание ветки функции, назначение ее агенту кодирования (или нескольким специализированным агентам), получение первого черновика всей реализации кода и обновленных тестов…
…вы читаете код (ну, может быть, читаете код). Затем вам всё равно нужно вручную проверить поведение функции и внести необходимые правки, отправить изменения в репозиторий, открыть пулл-реквест с длинным, но поверхностным описанием от ИИ, убедиться, что CI-проверки зеленые, самостоятельно просмотреть diff и запросить ревьюеров. Вы приступаете к делу…
<надевает шляпу ревьюера>
Ревьюер: Изменено 1721 строка! Описание не особо помогает. Посмотрю как-нибудь потом.
надевает шляпу ревьюера>
Дальше всё идет по знакомому сценарию:
- Большой пулл-реквест сложно проверять — поэтому он просто… висит.
- Ревьюеры теряют контекст, а качество обратной связи падает.
- Процесс слияния (merge) становится еще медленнее.
Это запускает ручной, запутанный, трудоемкий процесс, склонный к конфликтам еще до того, как функция попадет в проект, в результате чего она оказывается недопроверенной.
Стекированные пулл-реквесты в GitHub
Стекированные пулл-реквесты (stacked pull requests) предлагают другую, гораздо более эффективную структуру поставки кода. Принцип прост: декомпозиция. Вместо того чтобы стремиться к созданию единого пулл-реквеста, решающего задачу целиком, вы разбиваете функцию на логические слои и определяете цепочку зависимостей для достижения поставленной цели. Это дает вам и вашим агентам встроенный способ декомпозиции работы, которая в противном случае превратилась бы в гигантский пулл-реквест, преобразуя ее в цепочку небольших, сфокусированных и независимо проверяемых слоев.
Тот самый большой пулл-реквест, который так трудно проверить, превращается в стек более мелких, логически упорядоченных пулл-реквестов. Каждый из них решает одну конкретную задачу, достаточно мал, чтобы ревьюер мог легко удержать его в голове, и содержит ровно столько контекста, сколько естественно вытекает из предыдущего проверенного пулл-реквеста.
Давайте воплотим это в жизнь.
Структура стека
Давайте рассмотрим этапы декомпозиции задачи и организации многоуровневого стека.
Во-первых, и это важно, установите базовую ветку стека (stack base). Это имеет значение, поскольку CI-проверки и правила слияния на протяжении всего жизненного цикла управления стеком оцениваются относительно этой базы.
Затем определите основную фундаментальную единицу работы, поместите ее ближе к основанию (нижняя часть стека), а зависимую работу наслоите поверх нее.
| Слой стека (L#) / Ветка | Что поставляется | Зависит от |
|---|---|---|
| L1 (feat/catalog-data) | Типизированный каталог с начальными данными, валидацией и модулем доступа к данным | main (база стека) |
| L2 (feat/search-api) | Проверенный эндпоинт /api/products/search | feat/catalog-data |
| L3 (feat/chat-grounding) | Чат вызывает API и отвечает на основе реальных данных о товарах | feat/search-api |
| L4 (feat/grounded-ui) | Карточки цитирования товаров + состояние | feat/chat-grounding |
Теперь независимые аспекты четко разделены: данные, API, интеграция, UX. Это позволяет назначить для каждого слоя свою аудиторию ревьюеров: данные проверяет владелец данных, а UX — владелец интерфейса.
Встроенная поддержка стекированных пулл-реквестов в GitHub может быть запущена прямо из интерфейса пулл-реквестов и легко переносится в терминал с помощью CLI-расширения gh stack.
Установка CLI-расширения для стекированных пулл-реквестов
Выполните следующую команду:
gh extension install github/gh-stack
В былые времена на этом можно было бы сразу приступать к работе. Но не сегодня, когда рядом с вами трудятся ИИ-агенты. Эти агенты должны понимать, как работают стеки, уметь создавать их и управлять ими от вашего имени. Навык gh-stack skills обучает их этому.
gh skill install github/gh-stackИли, если вы предпочитаете:
npx skills add github/gh-stack
Для конкретной функции из нашего примера в вашем рабочем процессе разработки задействованы специализированные агенты. У каждого из них определены свои потоки задач, и все они строго соблюдают дисциплину декомпозиции для достижения главной цели — создания небольших пулл-реквестов, решающих единственную задачу.
| Слой / ветка | Агент |
|---|---|
| L1 (feat/catalog-data) | Агент моделирования данных |
| L2 ( feat/search-api) | Бэкенд-агент |
| L3 ( feat/chat-grounding) | Фронтенд-агент |
| L4 ( feat/grounded-ui) | Фронтенд-агент |
Последний шаг настройки — подтвердить наличие CI. Как упоминалось ранее, каждый пулл-реквест будет оцениваться относительно базы стека, и эти проверки будут запускаться для каждого слоя.
Теперь работа начинается.
Первый слой: Основа каталога данных
Большинство современных рабочих процессов с использованием агентов автоматизированы и выполняются автономно в циклах, но для наглядности мы разберем каждый шаг по отдельности.
К этому моменту все агенты уже знакомы с принципом работы стекированных пулл-реквестов, поэтому типичный сценарий на данном этапе выглядит так:
- Вызов агента моделирования данных (Data Modeler) с соответствующим промптом.
- Агент инициализирует новый стек и устанавливает первую ветку —
feat/catalog-dataс базой main с помощьюgh init stack. - Переключает ветку, выполняет работу и запускает валидацию.
(All checks == green) ? commit the layer : Iterate
Заметка ревьюера на будущее: Корректны ли типы? Проверены ли данные? Безопасен ли вспомогательный модуль запросов? И всё.
Второй слой: API поиска товаров
Следуйте аналогичному процессу:
- Вызов бэкенд-агента с соответствующим промптом.
- Агент добавляет следующий слой
feat/search-apiповерх первого слоя, в качестве базы которого используетсяfeat/catalog-data, чтобы импортировать завершенный модуль доступа к данным с помощьюgh stack add. - Переключает ветку, выполняет работу и запускает валидацию.
- Разработчик тестирует API вручную.
(API works && All checks == green) ? commit the layer : Iterate
Заметка ревьюера на будущее: Проверяются ли входные данные? Стабилен ли контракт ответа? Обрабатываются ли состояния ошибки/пустоты здесь или передаются дальше по цепочке? И всё.
Третий слой: Подключение чата к API
На этом следующем слое вы выполняете следующие действия:
- Вызов фронтенд-агента с соответствующим промптом.
- Агент добавляет следующий слой
feat/chat-groundingповерх второго слоя. Его база:feat/search-api, которая создаст ответвление, содержащее как модуль доступа к данным, так и проверенный API. - Переключает ветку, выполняет работу и запускает браузерные тесты с помощью Playwright.
(All checks == green) ? commit the layer : Iterate
Заметка ревьюера на будущее: Каждый ли ответ прослеживается до реального ответа API? Что происходит, когда API дает сбой или не возвращает ничего? И всё.
Четвертый слой: Интерфейс с привязкой к данным и цитированием
Вы заметите, что третий и четвертый слои, несмотря на наличие одного и того же автора (фронтенд-агента), разделены четким образом. Это сделано намеренно. Владельцу пользовательского интерфейса не нужно проверять нижележащий поток данных, и наоборот — такая структура обеспечивает эту независимость.
Таким образом, фронтенд-агент:
- Добавляет следующий слой
feat/grounded-uiповерх третьего слоя, его база:feat/chat-grounding. - Переключает ветку, выполняет работу и запускает браузерные тесты с помощью Playwright.
(All checks == green) ? commit the layer : Iterate
Заметка ревьюера на будущее: Каждая ли ссылка-цитата ведет на реальный товар? Учтены ли состояния загрузки, пустоты и ошибок? И всё.
Отправка стека
Четыре локальные стекированные ветки готовы. Следующий шаг — отправить их на удаленный репозиторий с помощью gh stack push, а затем создать пулл-реквесты, связав их на GitHub с помощью команды gh stack submit.
Карта стека и CI для каждого слоя
Переключившись на GitHub, вы увидите, что все четыре пулл-реквеста открыты, а в верхней части каждого из них отображается карта стека (stack map) — система навигации в один клик между пулл-реквестами внутри стека.
Проведение ревью и обновление стека
Время сменить шляпу и взглянуть на процесс работы ревьюера со стекированными пулл-реквестами.
<надевает шляпу ревьюера>
Карта стека служит компасом для ревьюера — это навигационный инструмент для перемещения между верхом и низом стека на пути к успешному слиянию. Движение имеет четкое направление: читать сверху вниз, проверять снизу вверх.
- Читайте сверху вниз для получения контекста. Это позволяет вам узнать конечную цель в самом начале процесса ревью, чтобы задать правильный ориентир. «Ага, значит, мы хотим отображать карточки товаров в интерфейсе чата».
- Проверяйте снизу вверх, опираясь на заранее определенные контрольные точки. Реализация на каждом отдельном слое становится понятной только после того, как вы разобрались с предыдущим слоем.
Вы больше не смотрите на единственный пулл-реквест размером более 1720 строк, который нужно проверить за один присест (как мы видели в нашем примере). Вместо этого ревью можно распределить по небольшим, автономным задачам внутри стека.
Будучи назначенным человеком-ревьюером в цикле, вы заходите и смотрите на первый слой — пулл-реквест в самом низу стека — и видите, что автоматический инструмент Copilot Code Review (CCR) выявил две проблемы, с необходимостью исправления которых вы согласны.
<снова надевает шляпу разработчика>
В нижней части стека запрошены изменения, поэтому вы:
- Передаете отзыв автору первого слоя — агенту моделирования данных, ответственному за эту ветку.
- Предложения применяются, тестируются, фиксируются (commit) и отправляются в репозиторий (push).
- Как только исправление попадает в ветку feat/catalog-data, возникает логичный вопрос: что это значит для второго, третьего и четвертого слоев?
Поскольку ветка feat/catalog-data была отправлена вне очереди после ревью, GitHub прямо указывает на это: «Некоторые ветки в этом стеке разошлись и должны быть перебазированы (rebased)», сопровождая это предупреждением «Невозможно выполнить слияние как стек», что блокирует операцию слияния.
В интерфейсе пулл-реквеста на GitHub появляется кнопка Rebase stack для выполнения операции в один клик. Прежде чем использовать ее, важно отметить одну деталь. Запуск веб-перебазирования с помощью этой кнопки выполняет процесс на серверах GitHub, что приводит к смене автора коммита на того, кто нажал кнопку; полученные коммиты при этом не подписываются, и если защита ветки требует подписанных коммитов, этот единственный клик незаметно нарушит правило.
Более безопасный и аналогичный шаг в терминале — использовать gh stack rebase для выполнения такого же каскадного ребаза локально по мере интерактивного разрешения конфликтов, но на этот раз с использованием вашей собственной конфигурации Git, а затем выполнить gh stack push.
Наконец, выполните распространение изменений по всему стеку. Остальной стек, как локально, так и на GitHub, теперь должен догнать изменения, и проще всего сделать это с помощью одной команды синхронизации gh stack sync.
Универсальный процесс начинается с получения изменений из источника (fetch), запуска каскадного ребаза каждой ветки поверх feat/catalog-data на новый коммит, отправки перебазированных веток и синхронизации состояния пулл-реквестов с GitHub. Таким образом, изменения распространяются вверх по цепочке автоматически, без необходимости вручную касаться второго, третьего или четвертого слоев.
Вернувшись на GitHub, вы увидите, что все проверки перезапущены, успешно пройдены, а карта стека снова выстроилась в чистую линию с возможностью слияния от main до feat/grounded-ui.
Начните работу со стекированными пулл-реквестами >
