Расширенное мышление Claude
Некоторые вещи даются нам практически мгновенно: «какой сегодня день недели?» На решение других уходит гораздо больше умственных сил, например, на разгадывание сложного кроссворда или отладку запутанного фрагмента кода. Мы можем применять больше или меньше когнитивных усилий в зависимости от поставленной задачи.
Теперь такая же гибкость появилась и у Claude. В новой версии Claude 3.7 Sonnet пользователи могут включать или выключать «режим расширенного мышления», направляя модель на более глубокий анализ сложных вопросов1. Разработчики также могут задавать «бюджет мышления», чтобы точно контролировать, сколько времени Claude тратит на решение проблемы.
Режим расширенного мышления — это не опция переключения на другую модель с отдельной стратегией. Скорее, он позволяет той же самой модели выделить больше времени и приложить больше усилий для поиска ответа.
Новая способность Claude к расширенному мышлению обеспечивает впечатляющий прирост интеллектуальных возможностей. Однако она также поднимает множество важных вопросов для тех, кто интересуется тем, как работают модели ИИ, как их оценивать и как повышать их безопасность. В этой публикации мы делимся некоторыми выводами, к которым мы пришли.
Видимый процесс мышления
Помимо наделения Claude способностью думать дольше и тем самым отвечать на более сложные вопросы, мы решили сделать его мыслительный процесс видимым в исходном виде. Это дает несколько преимуществ:
- Доверие. Возможность наблюдать за тем, как мыслит Claude, облегчает понимание и проверку его ответов, а также может помочь пользователям получать более качественные результаты.
- Согласованность (алаймент). В некоторых из наших предыдущих исследований в области согласования ИИ мы использовали противоречия между тем, что модель думает про себя, и тем, что она говорит вслух, чтобы выявлять случаи возможного нежелательного поведения, например обмана.
- Интерес. Наблюдать за ходом мысли Claude часто бывает увлекательно. Некоторые из наших исследователей с математическим и физическим бэкграундом отмечали пугающее сходство между мыслительным процессом Claude и их собственными методами рассуждения при решении сложных задач: исследованием множества различных точек зрения и ветвей логики, а также двойной и тройной проверкой ответов.
Но у видимого мыслительного процесса есть и свои недостатки. Во-первых, пользователи могут заметить, что обнажаемый ход мыслей выглядит более отстраненным и менее личностно окрашенным, чем стандартные ответы Claude. Это связано с тем, что мы не применяли наше стандартное обучение характеру (персонажу) к мыслительному процессу модели. Мы хотели предоставить Claude максимальную свободу действий, чтобы он мог думать о чем угодно, что необходимо для получения ответа — и, как и в случае с человеческим мышлением, Claude иногда по ходу дела высказывает ошибочные, вводящие в заблуждение или сырые мысли. Многим пользователям это покажется полезным; другие могут счесть это (и менее характерный контент в мыслительном процессе) разочаровывающим.
Другая проблема — так называемая «достоверность» (faithfulness): мы не знаем наверняка, действительно ли то, что содержится в мыслительном процессе, отражает происходящее в «голове» модели (например, слова английского языка, отображаемые в мыслительном процессе, могут просто быть неспособны описать, почему модель демонстрирует то или иное поведение). Проблема достоверности и способы ее обеспечения — одна из наших активных областей исследований. До сих пор наши результаты показывают, что модели очень часто принимают решения на основе факторов, которые они не обсуждают явно в своем мыслительном процессе. Это означает, что мы не можем полагаться на мониторинг мышления текущих моделей для обоснования веских аргументов об их безопасности2.
В-третьих, это создает ряд проблем, связанных с безопасностью и защищенностью. Злоумышленники могут использовать видимый мыслительный процесс для разработки более эффективных стратегий обхода систем защиты (джейлбрейка) Claude. Кроме того, хотя это пока гипотеза, существует вероятность, что если модели в процессе обучения поймут, что их внутренние мысли выставляются напоказ, у них может появиться стимул мыслить иначе, менее предсказуемо, или намеренно скрывать определенные мысли.
Последние опасения будут особенно актуальны для будущих, более мощных версий Claude — версий, которые могут представлять больший риск в случае несогласованности. Мы взвесим все «за» и «против» раскрытия мыслительного процесса для будущих релизов3. А пока видимый мыслительный процесс в Claude 3.7 Sonnet следует рассматривать как исследовательскую предварительную версию.
Новые тесты мыслительных способностей Claude
Claude в роли агента
Claude 3.7 Sonnet извлекает выгоду из того, что мы могли бы назвать «масштабированием действий» (action scaling) — усовершенствованной возможности, которая позволяет ему итеративно вызывать функции, реагировать на изменения в окружающей среде и продолжать работу до завершения открытой задачи. Примером такой задачи является использование компьютера: Claude может имитировать клики мыши и нажатия клавиш на клавиатуре для решения задач от имени пользователя. По сравнению со своим предшественником, Claude 3.7 Sonnet может выделять больше шагов (итераций), а также больше времени и вычислительной мощности для задач по использованию компьютера, и его результаты часто оказываются лучше.
Мы можем видеть это на примере того, как Claude 3.7 Sonnet улучшил свои показатели в OSWorld — бенчмарке, который измеряет возможности мультимодальных агентов ИИ. Claude 3.7 Sonnet начинает несколько лучше, но разница в производительности увеличивается со временем, по мере того как модель продолжает взаимодействовать с виртуальным компьютером.
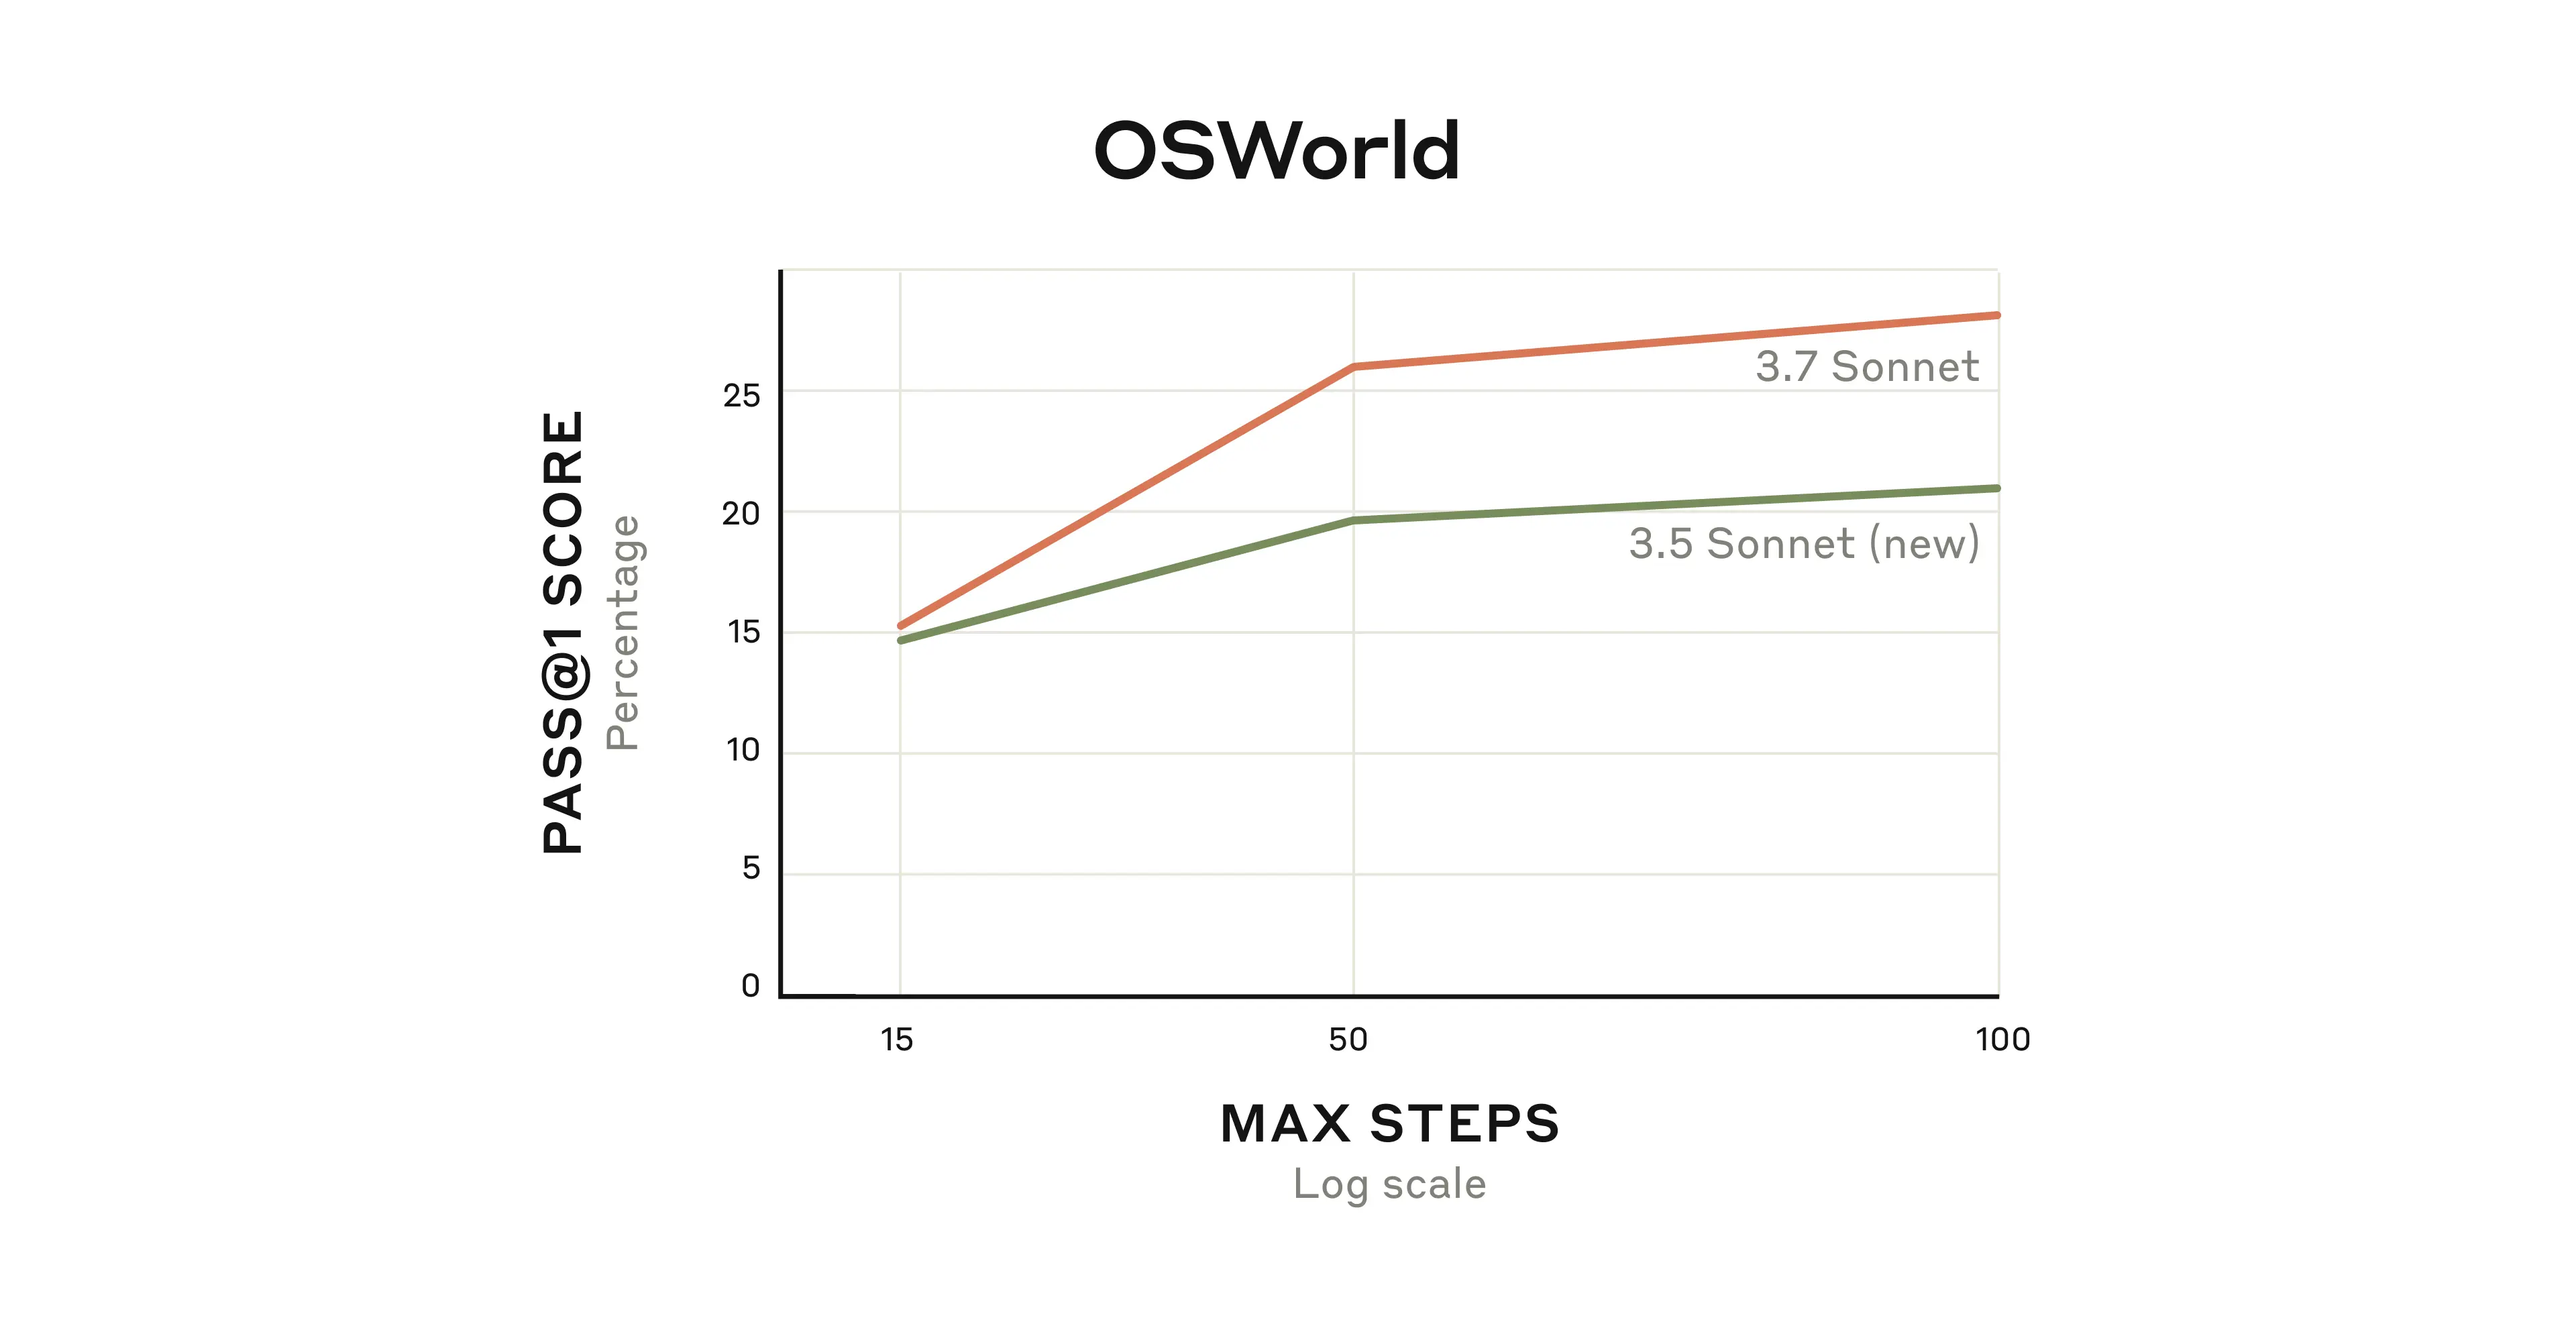 Производительность Claude 3.7 Sonnet по сравнению с предшествующей моделью в бенчмарке OSWorld, тестирующем навыки мультимодального использования компьютера. «Pass @ 1»: модель имеет лишь одну попытку решить конкретную задачу, чтобы это засчитывалось как успех.
Claude играет в Pokémon
В совокупности расширенное мышление и обучение агентов помогают Claude успешнее справляться со многими стандартными бенчмарками, такими как OSWorld. Но они также дают ему мощный толчок в выполнении других, возможно, более неожиданных задач.
Игра в Pokémon —, а именно в классическую игру для Game Boy Pokémon Red — как раз является такой задачей. Мы наделили Claude базовой памятью, возможностью ввода пикселей с экрана и вызова функций для нажатия кнопок и навигации по экрану, что позволило ему играть в Pokémon непрерывно за пределами обычных лимитов контекста, поддерживая игровой процесс на протяжении десятков тысяч взаимодействий.
На графике ниже мы отобразили прогресс прохождения Pokémon для Claude 3.7 Sonnet рядом с результатами предыдущих версий Claude Sonnet, у которых не было опции расширенного мышления. Как видите, предыдущие версии застревали в самом начале игры, причем Claude 3.0 Sonnet не смог даже выйти из дома в Паллет-Тауне, где начинается история.
Но усовершенствованные агентские возможности Claude 3.7 Sonnet помогли ему продвинуться гораздо дальше: успешно победить трех лидеров стадионов Pokémon (боссов игры) и завоевать их значки. Claude 3.7 Sonnet демонстрирует высочайшую эффективность в опробовании множества стратегий и пересмотре прежних предположений, что позволяет ему улучшать собственные навыки по ходу продвижения.
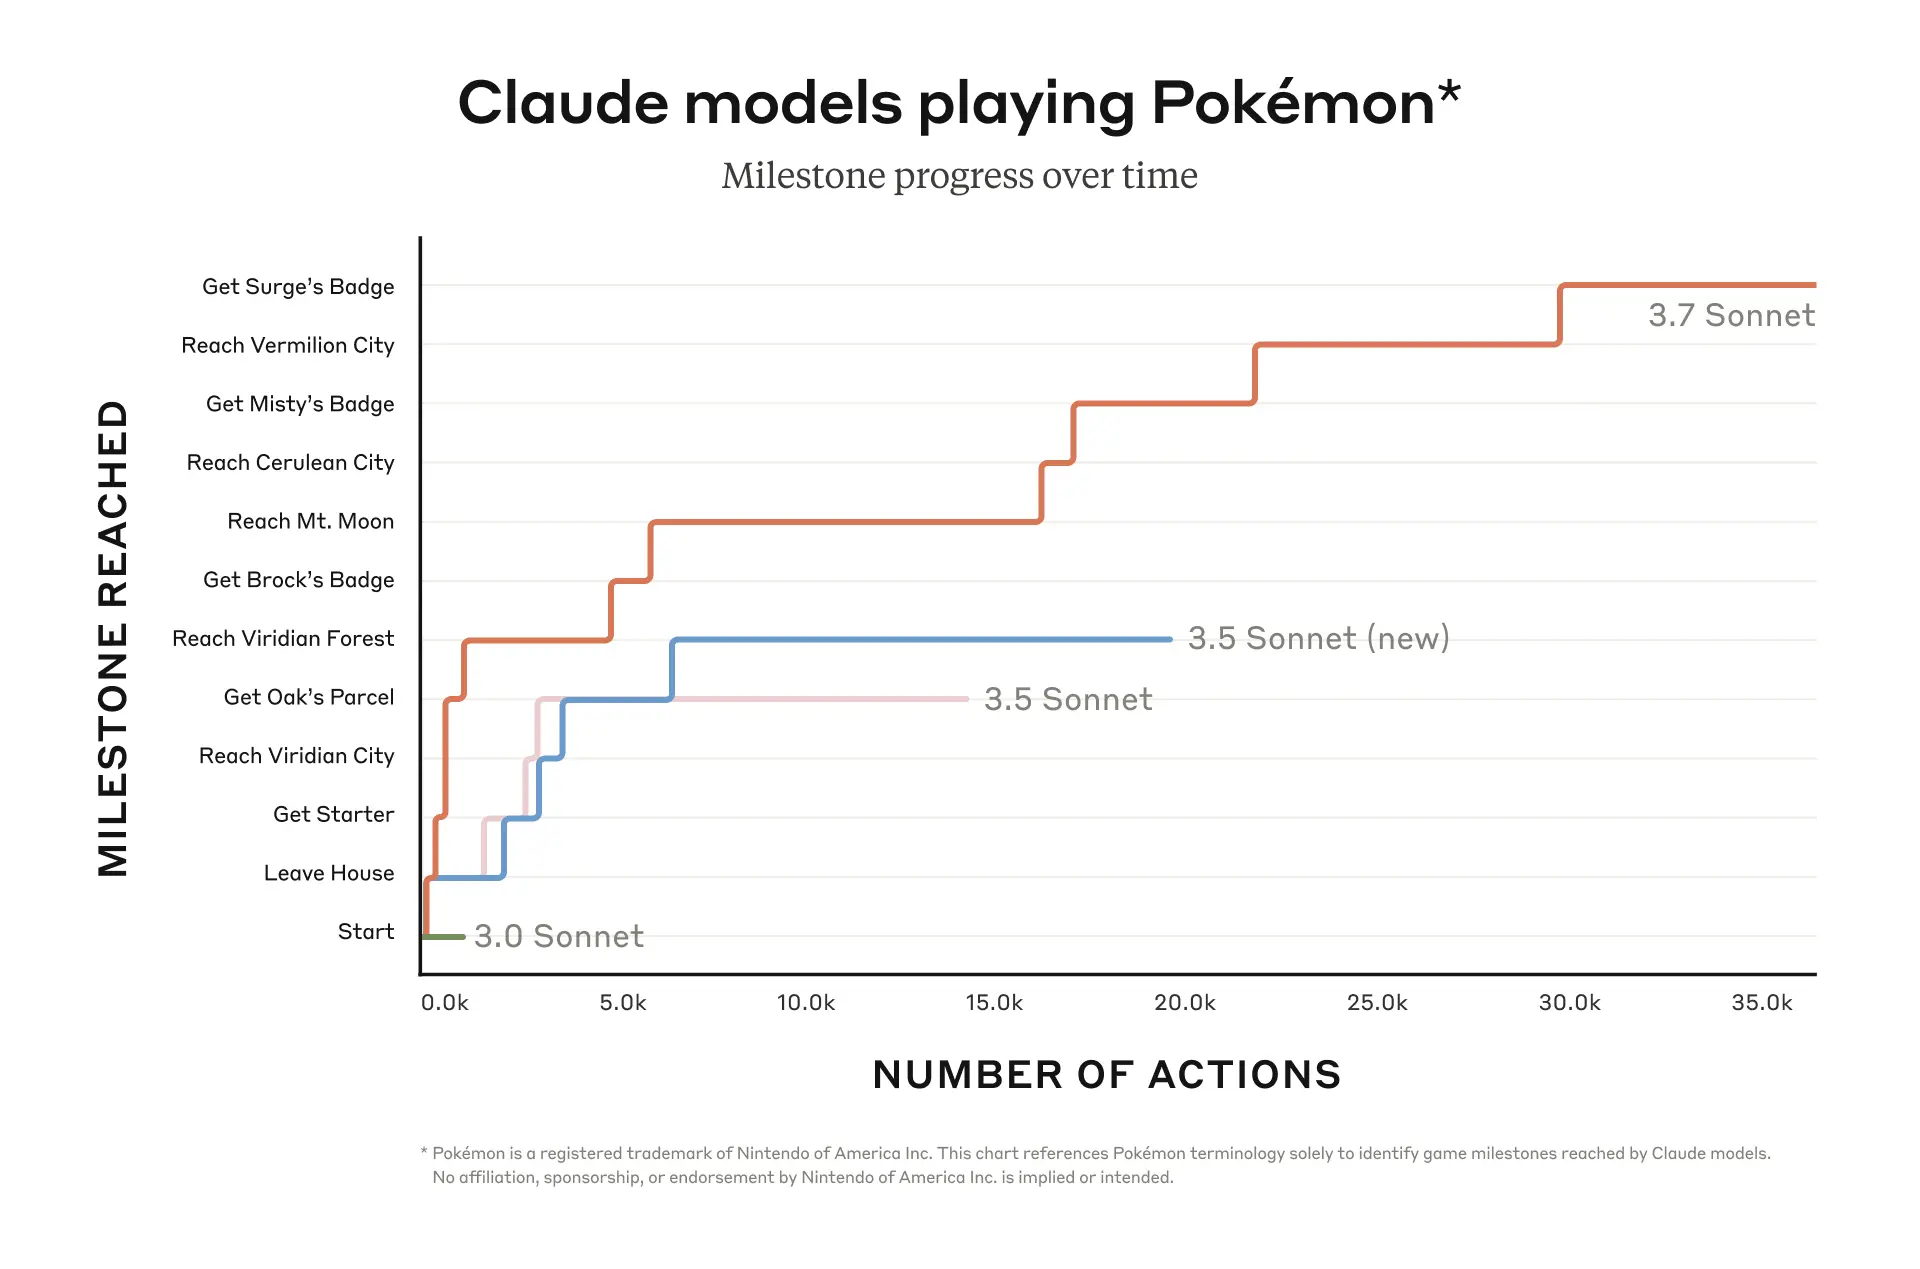 Claude 3.7 Sonnet доказывает, что он лучше всех остальных моделей Sonnet справляется с игрой Pokémon Red. По оси x отложено количество взаимодействий, которые совершает Claude в процессе игры; по оси y — важные вехи в игре, включающие сбор определенных предметов, перемещение в определенные зоны и победу над определенными боссами.
Pokémon — это увлекательный способ оценить возможности Claude 3.7 Sonnet, однако мы ожидаем, что эти возможности окажут реальное влияние далеко за пределами видеоигр. Способность модели сохранять концентрацию и достигать целей с открытым финалом поможет разработчикам создавать широкий спектр передовых ИИ-агентов.
Последовательное (serial) и параллельное масштабирование вычислений во время тестирования
Когда Claude 3.7 Sonnet задействует свой функционал расширенного мышления, можно сказать, что он использует «последовательные вычисления на этапе тестирования» (serial test-time compute). Это означает, что он выполняет множество последовательных шагов рассуждения перед выдачей окончательного результата, выделяя по ходу дела все больше вычислительных ресурсов. В целом это предсказуемо улучшает его производительность: например, его точность в решении математических задач улучшается логарифмически в зависимости от количества «токенов мышления», которые ему разрешено сэмплировать.
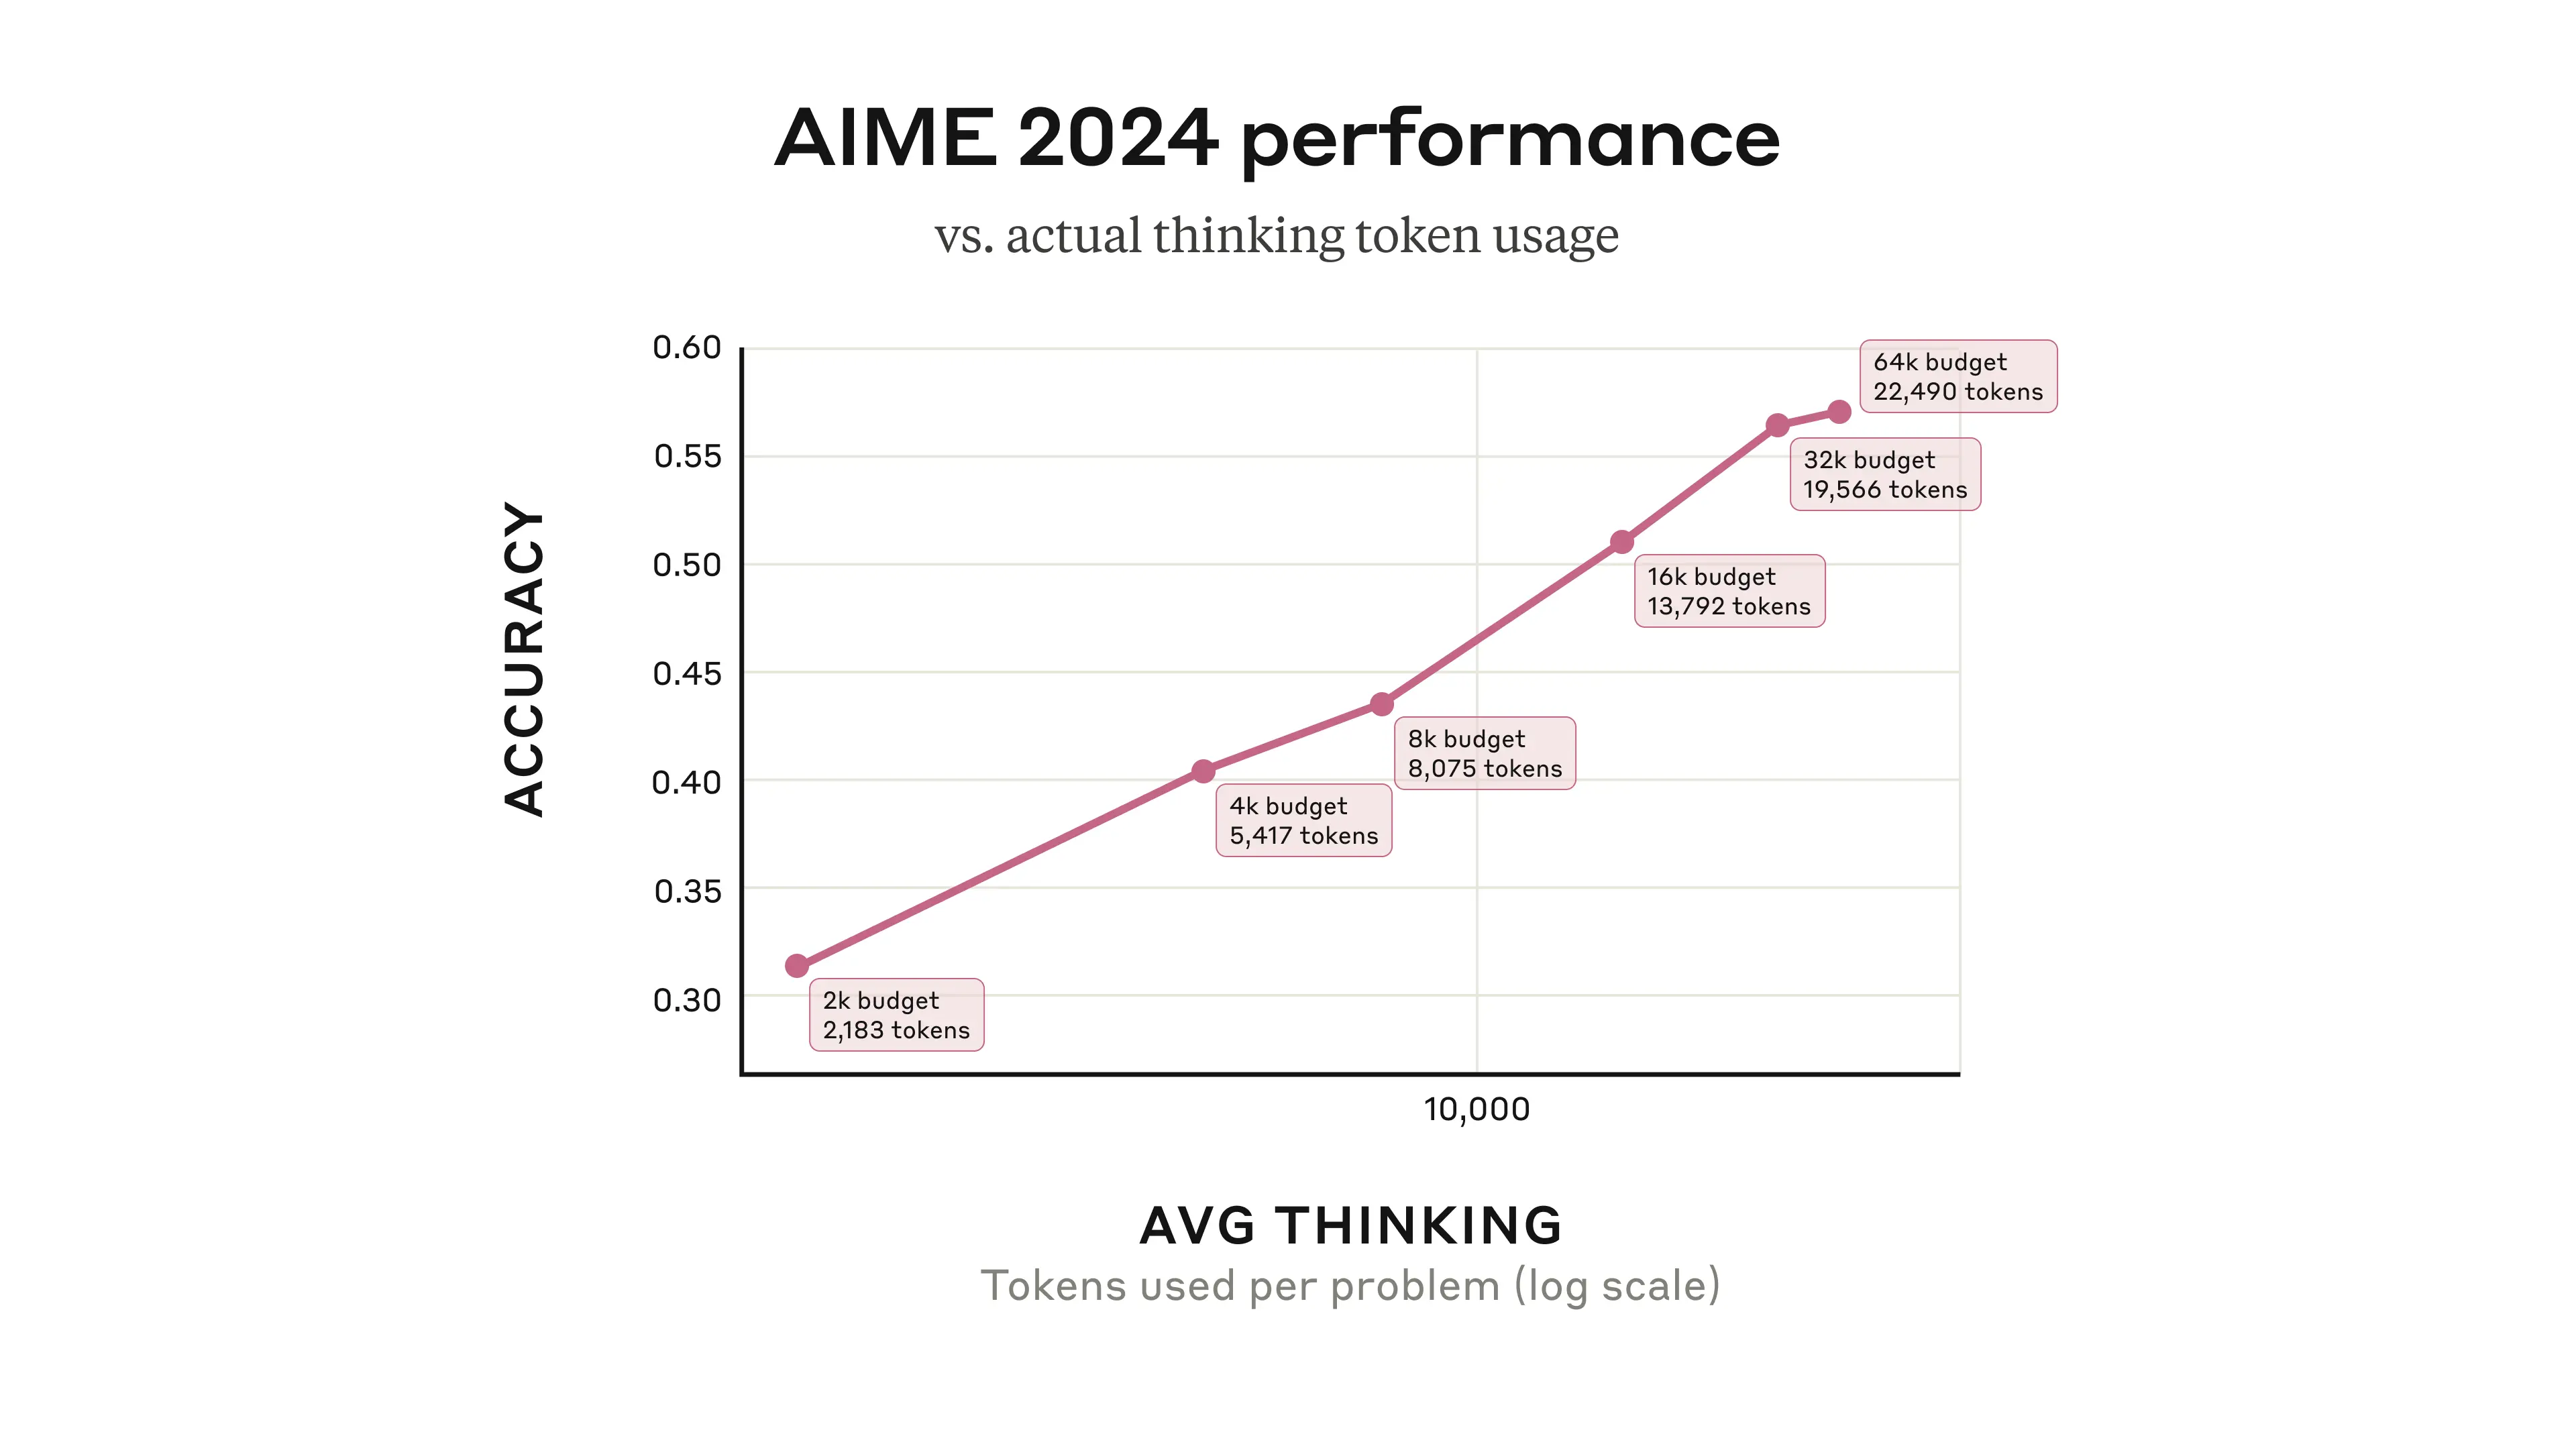 Производительность Claude 3.7 Sonnet на вопросах Американской национальной математической олимпиады (AIME) 2024 года в зависимости от количества токенов мышления, выделенных на каждую задачу. Обратите внимание, что даже когда мы позволяем Claude использовать весь лимит бюджета мышления, он обычно останавливается раньше. На графике также учтены токены сэмплирования, используемые для суммирования окончательного ответа.
Наши исследователи также экспериментировали с повышением производительности модели с помощью параллельных вычислений на этапе тестирования (parallel test-time compute). Для этого они генерируют несколько независимых цепочек рассуждений и выбирают лучшую из них, не зная правильного ответа заранее. Один из способов сделать это — использовать голосование большинством или консенсус, выбирая ответ, который чаще всего оказывается «лучшим». Другой способ — задействовать другую языковую модель (например, вторую копию Claude), попросив ее проверить свою работу, либо применить обученную функцию оценки (scoring function), чтобы выбрать то, что она считает наилучшим вариантом. Подобные стратегии (и аналогичные разработки) упоминаются в отчетах о результатах оценки целого ряда других моделей ИИ.
Мы добились впечатляющих улучшений, используя параллельное масштабирование вычислений на этапе тестирования в бенчмарке GPQA — популярном наборе сложных вопросов по биологии, химии и физике. Задействовав эквивалент вычислений 256 независимых сэмплов, обученную модель оценки и максимальный бюджет мышления в 64 тыс. токенов, Claude 3.7 Sonnet набрал 84,8% в GPQA (включая 96,5% по подразделу физики), продемонстрировав выгоду от дальнейшего масштабирования за пределами ограничений метода большинства. Ниже мы публикуем наши результаты как для методов со вспомогательной моделью оценки, так и для метода голосования большинством.
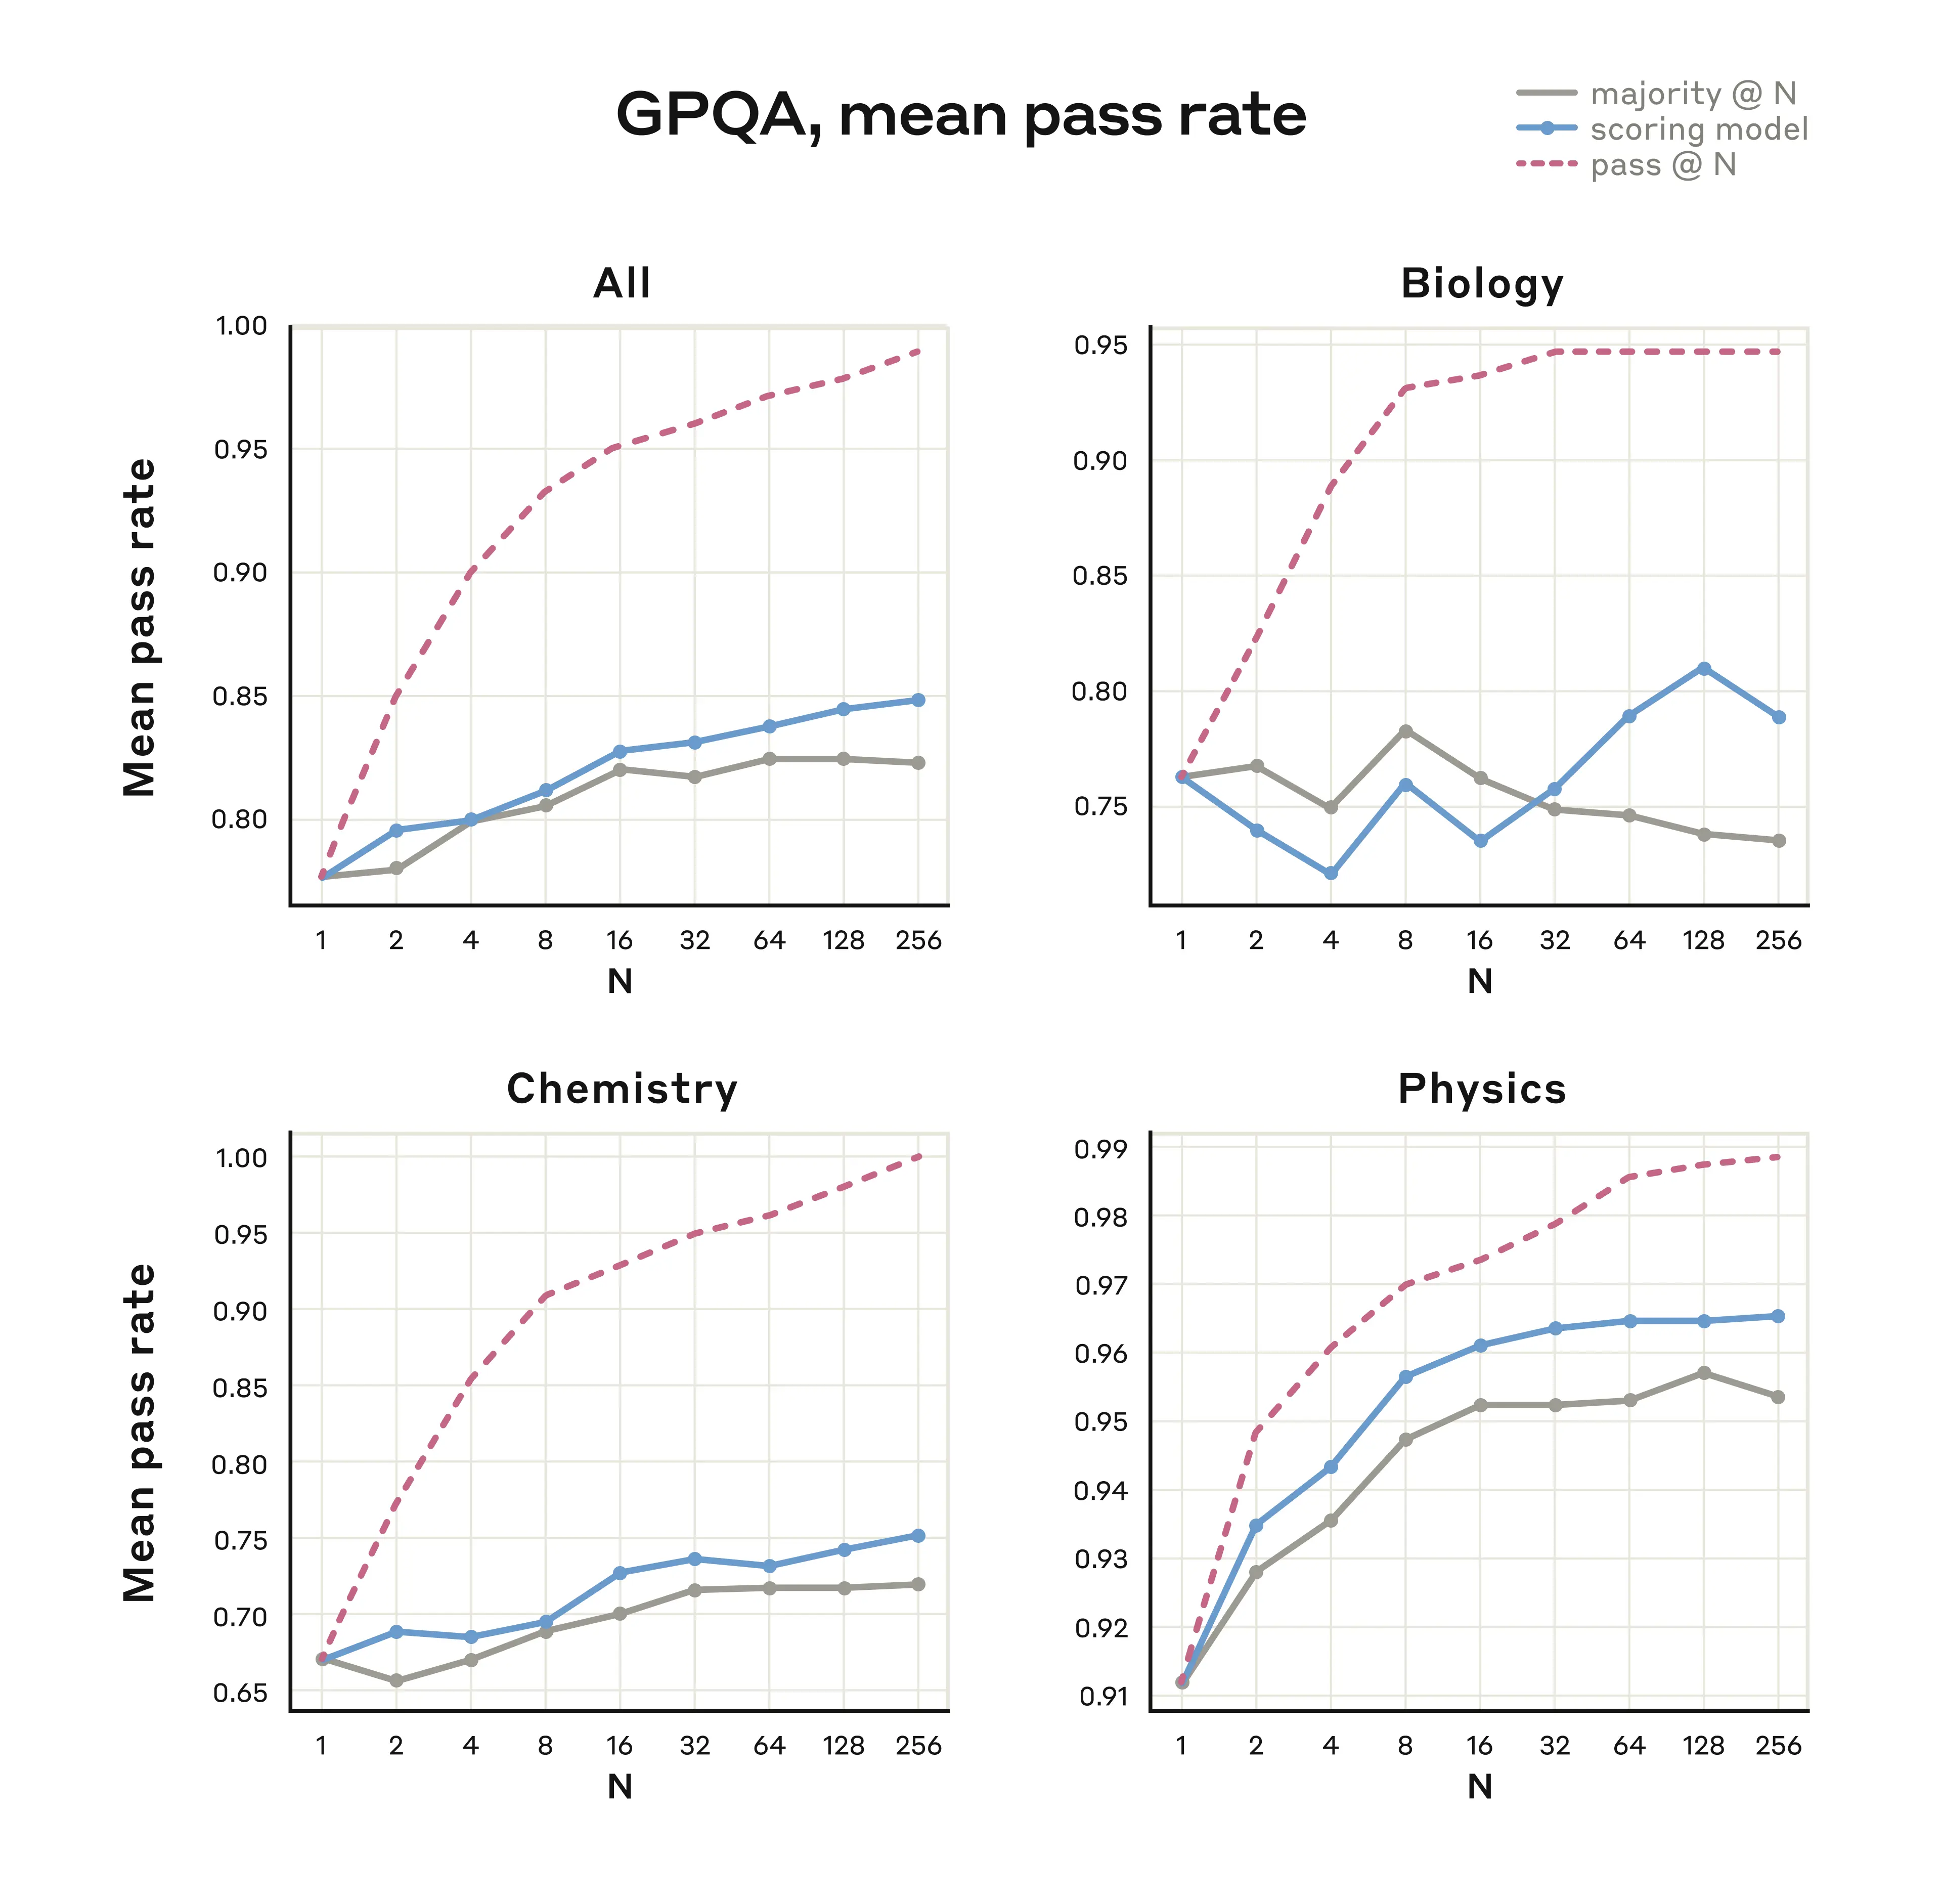 Экспериментальные результаты использования параллельного масштабирования вычислений на этапе тестирования для повышения эффективности Claude 3.7 Sonnet в бенчмарке GPQA. Различные линии соответствуют разным методам оценки производительности. «Majority @ N»: генерируется несколько вариантов ответа модели на один и тот же промпт, а в качестве окончательного ответа берется тот, который набрал большинство голосов; «scoring model»: отдельная модель, используемая для оценки работы тестируемой модели; «pass @ N»: тест считается «пройдённым», если хотя бы одна попытка из заданного числа оказалась успешной.
Подобные методы позволяют нам повышать качество ответов Claude, как правило, не дожидаясь окончания его размышлений. Claude может параллельно запускать несколько различных процессов расширенного мышления, что позволяет ему рассматривать больше подходов к проблеме и в конечном итоге гораздо чаще находить правильное решение. Параллельное масштабирование вычислений на этапе тестирования пока недоступно в нашей новой развернутой модели, но мы продолжаем исследовать эти методы на будущее.
Механизмы безопасности Claude 3.7 Sonnet
Уровень безопасности ИИ (AI Safety Level). Политика ответственного масштабирования Anthropic обязывает нас не обучать и не внедрять модели без реализации соответствующих мер безопасности и защиты. Наша команда Frontier Red Team и команда стресс-тестирования согласованности провели масштабное тестирование Claude 3.7 Sonnet, чтобы определить, требует ли она такого же уровня мер безопасности при развертывании, как наши предыдущие модели (стандарт AI Safety Level (ASL) 2), или более строгих мер.
Наша комплексная оценка Claude 3.7 Sonnet подтвердила, что текущий стандарт безопасности ASL-2 остается подходящим. В то же время модель продемонстрировала возросшую изощренность и расширенные возможности во всех областях. В ходе контролируемых исследований, изучавших задачи, связанные с производством химического, биологического, радиологического и ядерного (ХБРЯ) оружия, мы зафиксировали некоторый «рост производительности» у участников, пользовавшихся помощью модели, по сравнению с участниками, работавшими без нее. Иными словами, участники смогли продвинуться ближе к успеху, чем если бы они использовали только информацию, доступную в сети Интернет. Тем не менее, все попытки выполнить эти задачи содержали критические сбои, полностью исключающие успех.
Независимое экспертное тестирование модели (red-teaming) принесло неоднозначные отзывы. Хотя некоторые эксперты отметили улучшение знаний модели в определенных областях процессов производства ХБРЯ, они также обнаружили, что частота критических сбоев слишком высока для успешного завершения задач от начала до конца. Мы упреждающе совершенствуем наши меры в рамках ASL-2, ускоряя разработку и внедрение целевых классификаторов и систем мониторинга.
Кроме того, возможности наших будущих моделей могут потребовать перехода к следующему этапу — мерам защиты ASL-3. Наша недавняя работа над конституционными классификаторами для предотвращения джейлбрейков, наряду с другими инициативами, создает прочную основу для внедрения требований стандарта ASL-3 в ближайшем будущем.
Видимый мыслительный процесс. Даже при уровне ASL-2 функция видимого расширенного мышления в Claude 3.7 Sonnet является новой, а потому требует новых и соответствующих мер защиты. В редких случаях мыслительный процесс Claude может содержать потенциально опасный контент (включая темы безопасности детей, кибератак и опасного оружия). В таких случаях мы будем шифровать мыслительный процесс: это не помешает Claude включать данный контент в свои размышления (что по-прежнему может быть важно для формирования в итоге совершенно безобидных ответов), но соответствующая часть хода мыслей не будет видна пользователям. Вместо этого они увидят сообщение: «остальная часть мыслительного процесса недоступна для данного ответа». Мы стремимся к тому, чтобы такое шифрование происходило редко и только в тех случаях, когда потенциальный вред высок.
Использование компьютера. Наконец, мы усовершенствовали меры безопасности для функции использования компьютера Claude (о которой мы говорили выше: она позволяет Claude видеть экран компьютера пользователя и совершать действия от его имени). Мы добились существенного прогресса в защите от атак типа «промпт-инъекция» (prompt injection), когда злоумышленник скрывает секретное сообщение где-нибудь, где Claude может его увидеть при использовании компьютера, потенциально пытаясь обмануть модель и заставить ее совершить действия, которые пользователь не планировал. Благодаря новому обучению противодействию инъекциям промптов, новому системному промпту, содержащему инструкции игнорировать такие атаки, и классификатору, срабатывающему при обнаружении моделью потенциальной инъекции, теперь мы предотвращаем подобные атаки в 88% случаев4 по сравнению с 74% до применения этих мер.
Выше приведена лишь краткая сводка нашей масштабной работы по обеспечению безопасности Claude 3.7 Sonnet. Подробную информацию, результаты аналитики и примеры работы защитных механизмов можно найти в нашей полной системной карте (System Card).
Как использовать Claude
Вы можете воспользоваться Claude 3.7 Sonnet прямо сейчас на сайте Claude.ai или через наш API. И точно так же, как Claude теперь может поделиться с вами своими мыслями, мы надеемся, что вы поделитесь своими впечатлениями с нами. Пожалуйста, отправляйте свои отзывы о новой модели по адресу feedback@anthropic.com.
Сноски
1. В частности, это доступно для пользователей Claude Pro, Team, Enterprise и API.
2. Наши исследования в области достоверности подробнее описаны в нашей системной карте. Мы также надеемся, что полное понимание причин поведения модели на уровне активаций в ее нейронной сети может быть достигнуто благодаря будущим достижениям в области механистической интерпретируемости.
3. Не исключено, что существует золотая середина между раскрытием мыслительного процесса во всей полноте и его полным сокрытием. Например, может оказаться предпочтительным обучить модель всегда говорить правду при запросе о ее внутренних мыслях, но не раскрывать эти мысли по умолчанию (и, возможно, иметь возможность отклонять определенные запросы).
4. При этом частота ложноположительных срабатываний составляет 0,5% (когда защитные механизмы активируются, несмотря на отсутствие атаки типа «промпт-инъекция»). Мы работаем над снижением этого показателя по мере совершенствования наших механизмов безопасности.
Полный текст статьи читайте на Anthropic
