Claude 3.7 Sonnet и Claude Code
Сегодня мы анонсируем Claude 3.7 Sonnet1 — нашу самую интеллектуальную модель на сегодняшний день и первую гибридную модель рассуждения на рынке. Claude 3.7 Sonnet способна выдавать ответы практически мгновенно или осуществлять глубокий пошаговый процесс мышления, который становится видимым для пользователя. Пользователи API также имеют возможность детально контролировать продолжительность мыслительного процесса модели.
Claude 3.7 Sonnet демонстрирует особенно сильные улучшения в написании кода и фронтенд-веб-разработке. Вместе с моделью мы также представляем инструмент командной строки для агентного программирования — Claude Code. Claude Code доступен в режиме ограниченной исследовательской предварительной версии и позволяет разработчикам делегировать масштабные инженерные задачи Claude прямо из терминала.
Claude 3.7 Sonnet теперь доступна во всех тарифных планах Claude (включая Free, Pro, Team и Enterprise), а также на платформе для разработчиков Claude, в Amazon Bedrock и Google Cloud Vertex AI. Режим расширенного мышления доступен на всех интерфейсах, кроме бесплатного тарифного плана Claude.
Как в стандартном режиме, так и в режиме расширенного мышления стоимость Claude 3.7 Sonnet остается такой же, как у ее предшественниц: 3 доллара за миллион входных токенов и 15 долларов за миллион выходных токенов (включая токены рассуждений).
Claude 3.7 Sonnet: передовые рассуждения на практике
Мы разрабатывали Claude 3.7 Sonnet с иной философией по сравнению с другими моделями рассуждения на рынке. Подобно тому как люди используют единый мозг как для быстрых ответов, так и для глубоких размышлений, мы считаем, что рассуждения должны быть интегрированной возможностью передовых моделей, а не отдельной моделью целиком. Такой унифицированный подход также обеспечивает более бесшовный пользовательский опыт.
Claude 3.7 Sonnet воплощает эту философию несколькими способами. Во-первых, Claude 3.7 Sonnet объединяет в себе свойства обычной LLM и модели рассуждения: вы можете выбирать, когда модель должна ответить в обычном режиме, а когда — подумать дольше перед ответом. В стандартном режиме Claude 3.7 Sonnet представляет собой усовершенствованную версию Claude 3.5 Sonnet. В режиме расширенного мышления она анализирует свои действия перед ответом, что повышает ее эффективность в решении задач по математике, физике, следованию инструкциям, программированию и во многих других областях. Мы обычно замечаем, что промпптинг для модели работает схожим образом в обоих режимах.
Во-вторых, при использовании Claude 3.7 Sonnet через API пользователи могут также контролировать бюджет на мышление: вы можете указать Claude думать не более чем N токенов, где N может принимать любые значения вплоть до ограничения вывода в 128 тыс. токенов. Это позволяет находить баланс между скоростью (и стоимостью) и качеством ответа.
В-третьих, при разработке наших моделей рассуждения мы в меньшей степени оптимизировали их под задачи олимпиад по математике и информатике, сместив фокус в сторону реальных задач, которые лучше отражают то, как компании на самом деле используют LLM.
Раннее тестирование продемонстрировало лидерство Claude в сфере программирования по всем направлениям: в Cursor отметили, что Claude снова стала лучшей в своем классе для реальных задач программирования со значительными улучшениями в таких областях, как работа со сложными кодовыми базами и расширенное использование инструментов. В Cognition пришли к выводу, что она справляется с планированием изменений кода и полным обновлением стека (full-stack) намного лучше любой другой модели. Vercel подчеркнула исключительную точность Claude при работе со сложными агентными рабочими процессами, в то время как Replit успешно задействовала Claude для создания сложных веб-приложений и панелей управления с нуля там, где другие модели пасуют. По оценкам Canva, Claude стабильно выдает готовый к продакшену код с превосходным дизайнерским вкусом и значительно сокращает количество ошибок.
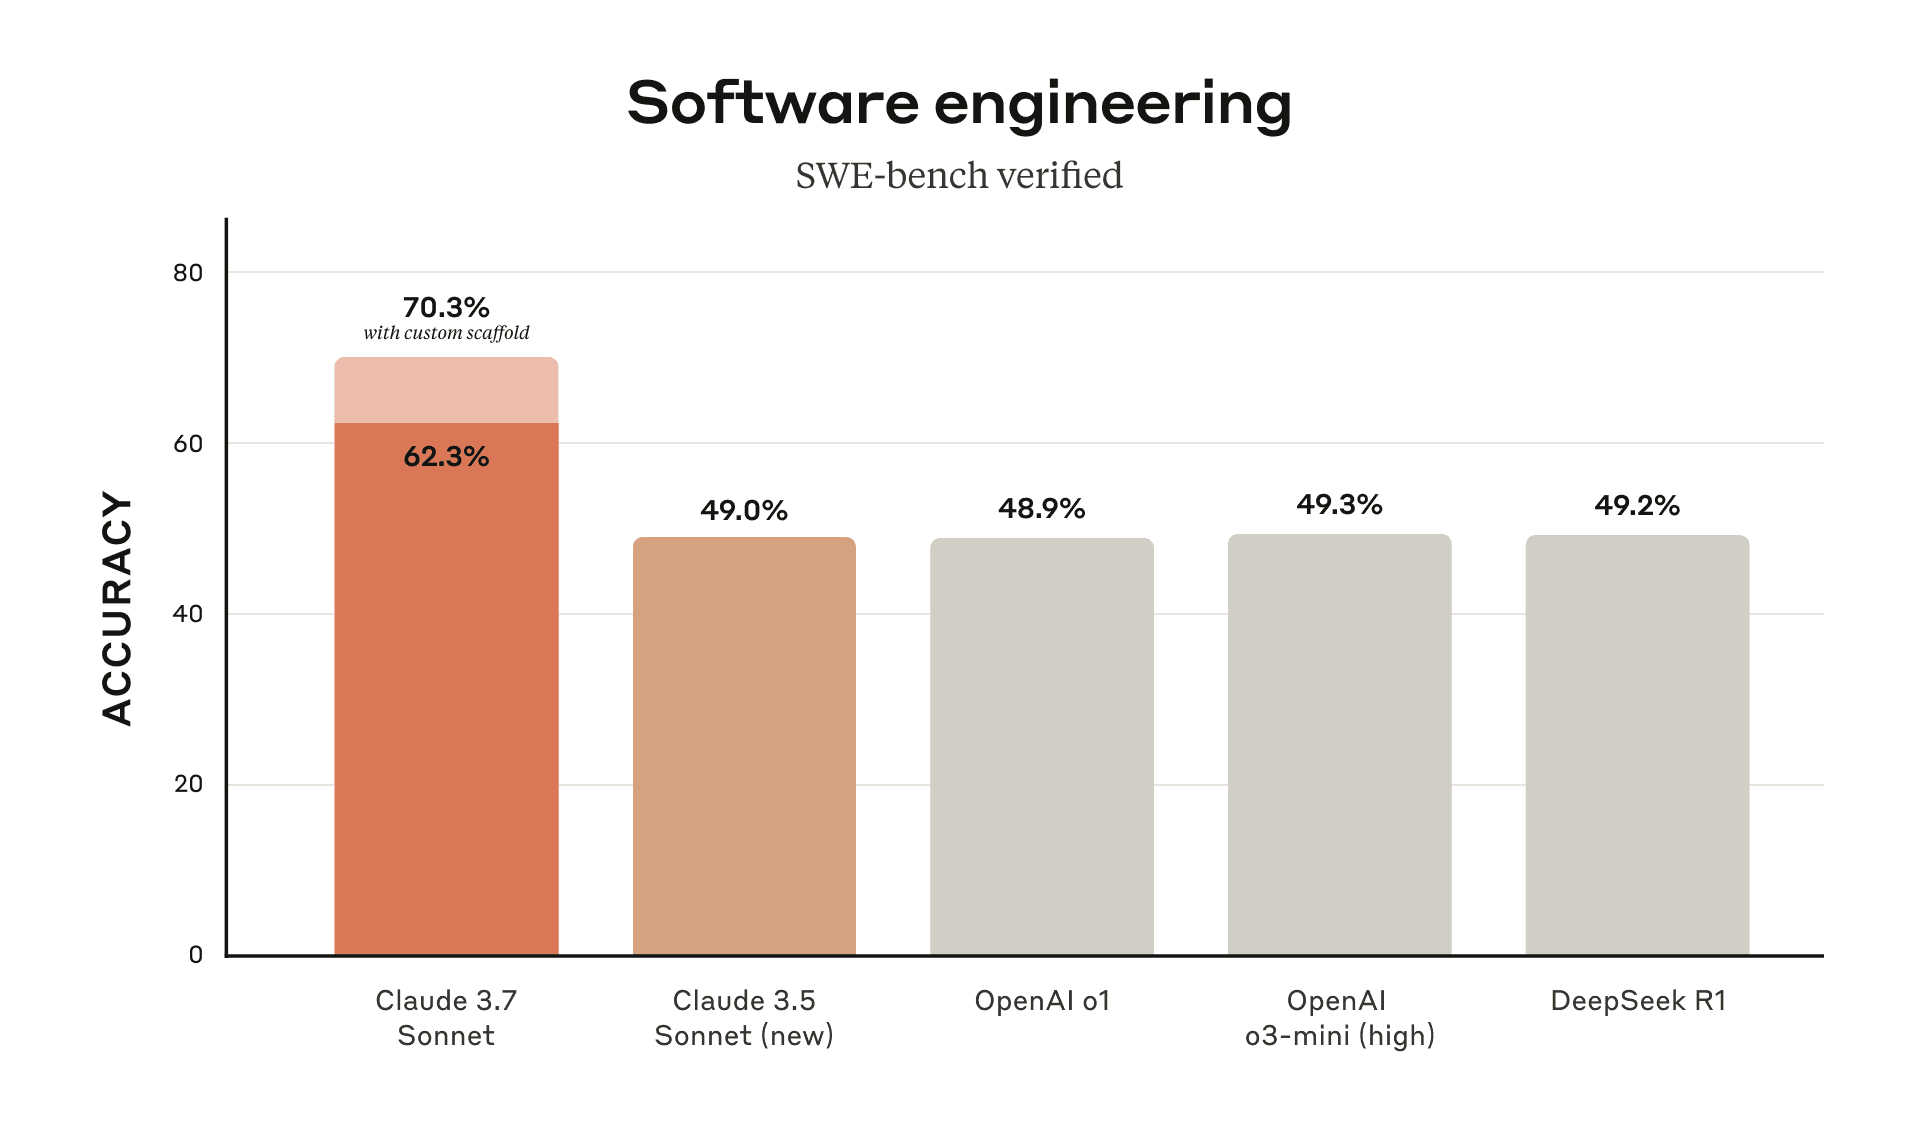 Claude 3.7 Sonnet демонстрирует передовую производительность на бенчмарке SWE-bench Verified, который оценивает способность ИИ-моделей решать реальные проблемы в области разработки ПО. Дополнительную информацию о вспомогательных структурах (scaffolding) см. в приложении.
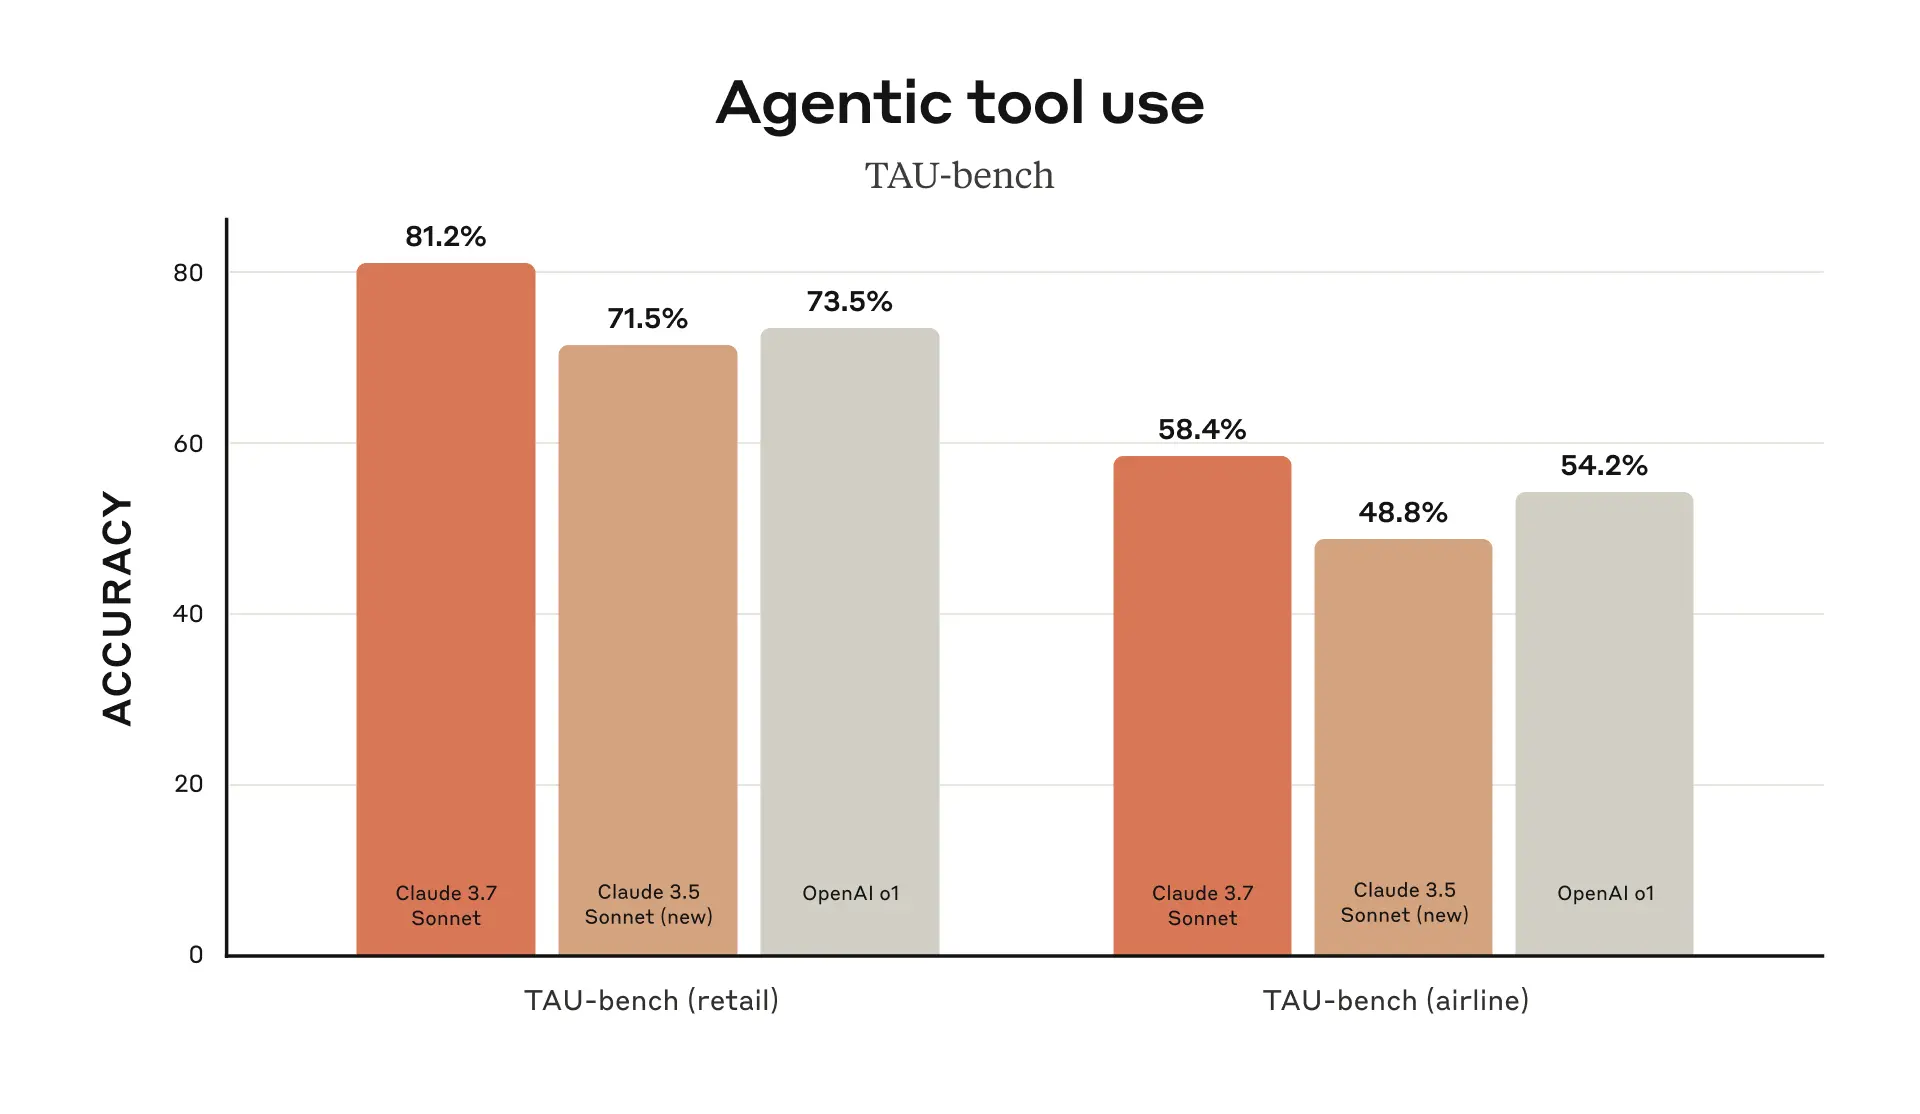 Claude 3.7 Sonnet достигает передовых результатов на TAU-bench — фреймворке, который тестирует ИИ-агентов на сложных реальных задачах с участием пользователей и инструментов. Дополнительную информацию о вспомогательных структурах см. в приложении.
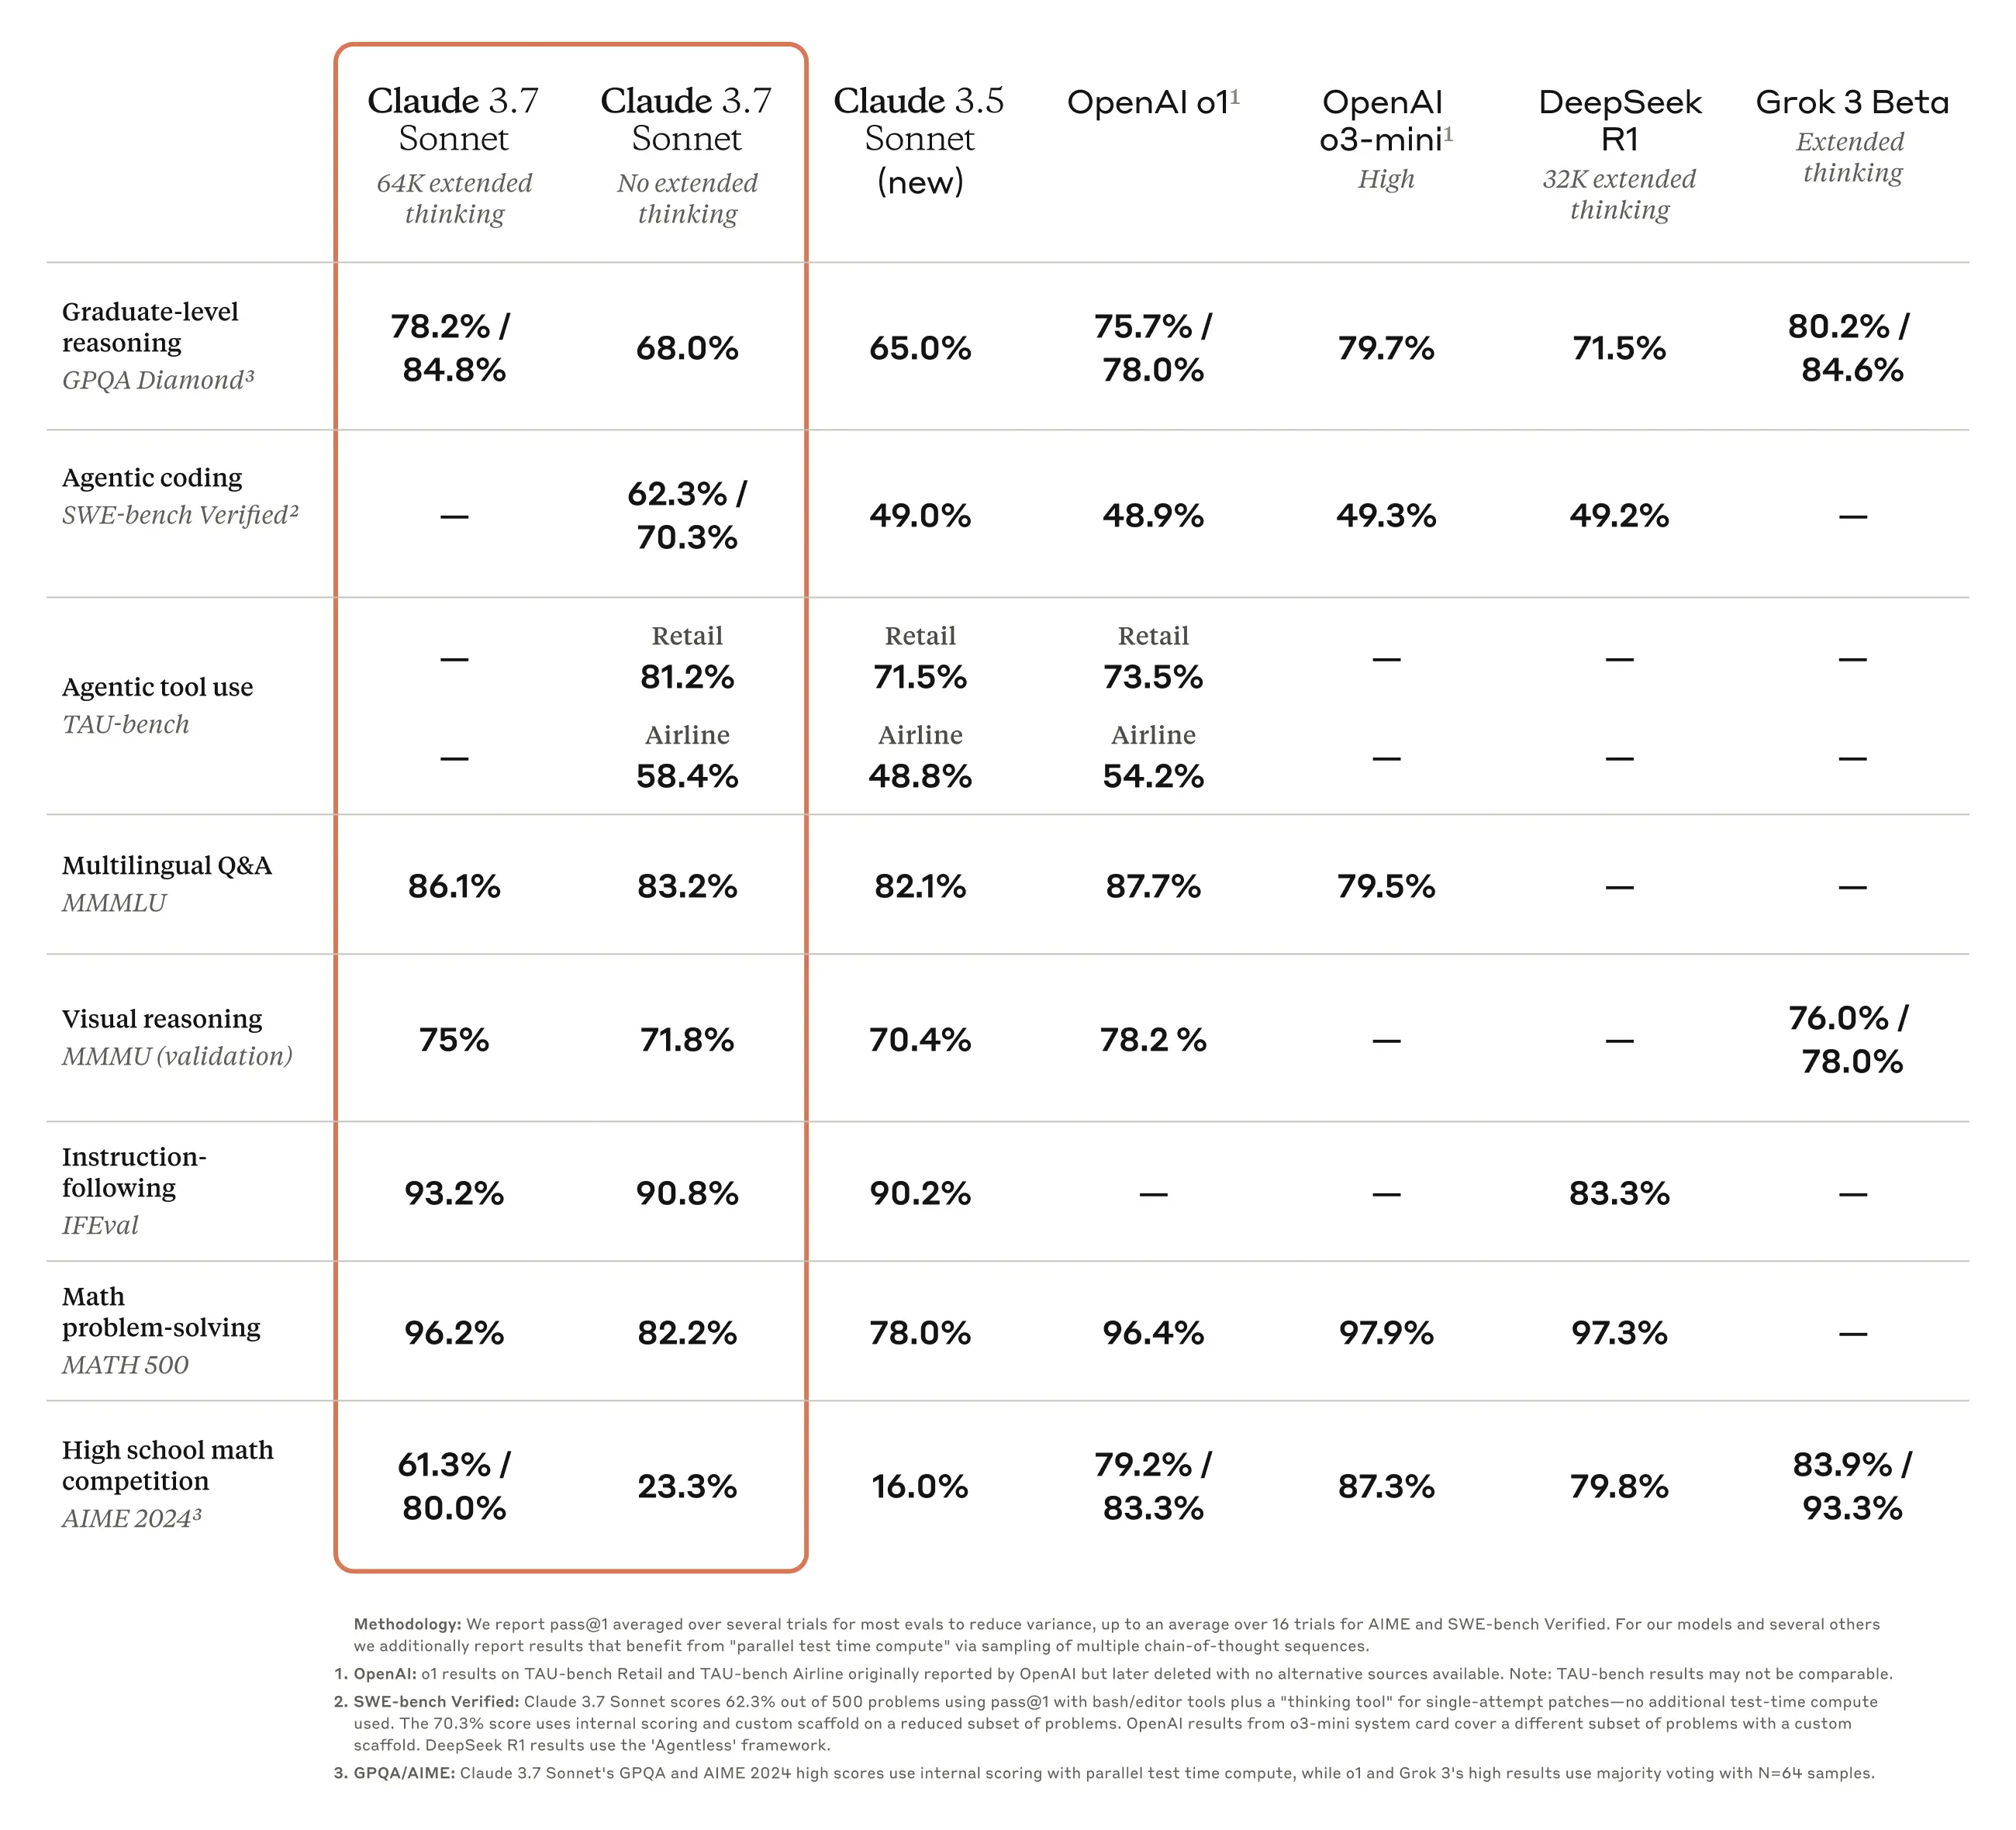 Claude 3.7 Sonnet превосходно справляется с соблюдением инструкций, общими рассуждениями, мультимодальными задачами и агентным программированием, причем режим расширенного мышления обеспечивает заметный прирост в математике и естественных науках. Помимо традиционных бенчмарков, она даже превзошла все предыдущие модели в наших тестах по прохождению игры Pokémon.
Claude Code
С июня 2024 года Sonnet была излюбленной моделью разработчиков по всему миру. Сегодня мы даем разработчикам еще больше возможностей, представив Claude Code — наш первый инструмент для агентного программирования — в рамках ограниченной исследовательской предварительной версии.
Claude Code — это активный помощник, способный искать и читать код, редактировать файлы, писать и запускать тесты, делать коммиты и отправлять код в GitHub, а также использовать инструменты командной строки, держа вас в курсе на каждом этапе.
Claude Code является ранним продуктом, но уже стал незаменимым для нашей команды, особенно при разработке через тестирование (TDD), отладке сложных проблем и масштабном рефакторинге. В ходе раннего тестирования Claude Code выполняла за один проход задачи, на которые обычно уходило более 45 минут ручной работы, что сократило время разработки и издержки.
В ближайшие недели мы планируем непрерывно улучшать инструмент на основе опыта его использования: повышать надежность вызова функций, добавлять поддержку долго выполняющихся команд, улучшать отрисовку в приложении и расширять собственное понимание возможностей Claude.
Наша цель при создании Claude Code — лучше понять, как разработчики используют Claude для программирования, чтобы учитывать это при будущих улучшениях модели. Присоединившись к этому превью, вы получите доступ к тем же мощным инструментам, которые мы используем для создания и совершенствования Claude, а ваши отзывы напрямую повлияют на ее будущее.
Работа с Claude над вашей кодовой базой
Мы также улучшили опыт разработки с использованием Claude.ai. Наша интеграция с GitHub теперь доступна на всех тарифных планах Claude, позволяя разработчикам напрямую подключать свои репозитории кода к Claude.
Claude 3.7 Sonnet — наша лучшая модель для программирования на сегодняшний день. Обладая более глубоким пониманием ваших личных, рабочих и проектов с открытым исходнымходным кодом, она становится более мощным партнером для исправления багов, разработки функций и создания документации во всех ваших ключевых проектах на GitHub.
Ответственная разработка
Мы провели масштабное тестирование и оценку Claude 3.7 Sonnet, сотрудничая со сторонними экспертами, чтобы убедиться в ее соответствии нашим стандартам безопасности, надежности и защищенности. Claude 3.7 Sonnet также более тонко различает вредоносные и безопасные запросы, сократив количество ненужных отказов на 45% по сравнению с предшественницей.
Системная карта (system card) для этого релиза охватывает новые результаты в области безопасности в нескольких категориях, предоставляя детальный разбор оценок в рамках нашей Политики ответственного масштабирования (Responsible Scaling Policy), который другие ИИ-лаборатории и исследователи могут применять в своей работе. В карте также рассматриваются возникающие риски, сопряженные с использованием компьютеров, в частности атаки путем внедрения промптов (prompt injection), а также объясняется, как мы оцениваем эти уязвимости и обучаем Claude противостоять им и снижать их последствия. Кроме того, в ней изучаются потенциальные преимущества моделей рассуждений с точки зрения безопасности: возможность понимать, как модели принимают решения, и являются ли рассуждения моделей подлинно заслуживающими доверия и надежными. Прочитайте полную системную карту, чтобы узнать больше.
Взгляд в будущее
Claude 3.7 Sonnet и Claude Code знаменуют собой важный шаг на пути к ИИ-системам, способным по-настоящему расширять человеческие возможности. Благодаря способности глубоко мыслить, действовать автономно и эффективно сотрудничать они приближают нас к будущему, в котором искусственный интеллект обогащает и приумножает то, чего могут достичь люди.
Мы рады, что вы сможете опробовать эти новые возможности и увидеть, что именно вы создадите с их помощью. Как всегда, мы приветствуем ваши отзывы по мере того, как мы продолжаем совершенствовать и развивать наши модели.
Приложение
1 Урок, извлеченный из опыта именования.
Источники данных для оценки
- Grok
- Gemini 2 Pro
- o1 и o3-mini
- Дополнительные материалы по o1
- o1 TAU-bench
- Дополнительные материалы по o3-mini
- Deepseek R1
TAU-bench
Информация о вспомогательных структурах (scaffolding)
Баллы были получены с помощью добавления к промпту для политики агента авиакомпании (Airline Agent Policy) инструкций, предписывающих Claude лучше использовать инструмент «планирования» (planning), в рамках которого модель поощряется записывать свои мысли по мере решения задачи отдельно от нашего обычного режима мышления в ходе многошаговых траекторий для наилучшего использования ее способностей к рассуждению. Чтобы компенсировать дополнительные шаги, которые совершает Claude при задействовании большего объема мышления, максимальное количество шагов (подсчитываемых по завершениям модели) было увеличено с 30 до 100 (большинство траекторий завершалось менее чем за 30 шагов, и лишь одна траектория превысила 50 шагов).
Кроме того, показатель TAU-bench для Claude 3.5 Sonnet (новая) отличается от того, о котором мы изначально заявляли при релизе, из-за небольших улучшений набора данных, внедренных с тех пор. Мы провели повторный запуск на обновленном наборе данных для более точного сравнения с Claude 3.7 Sonnet.
SWE-bench Verified
Информация о вспомогательных структурах (scaffolding)
Существует множество подходов к решению задач открытого агентного типа, таких как SWE-bench. Некоторые подходы перекладывают большую часть сложности определения того, какие файлы исследовать или редактировать и какие тесты запускать, на более традиционное программное обеспечение, оставляя базовой языковой модели задачу генерации кода в заранее определенных местах или выбор из более ограниченного набора действий. Agentless (Xia et al., 2024) — это популярный фреймворк, используемый при оценке модели R1 от Deepseek и других моделей, который дополняет агента механизмами поиска файлов на основе промптов и эмбеддингов, локализации патчей и выборки с отклонением best-of-40 против регрессионных тестов. Другие каркасы (например, Aide) дополнительно наделяют модели вычислительными ресурсами во время тестирования в виде повторных попыток (retries), best-of-N или поиска по дереву Монте-Карло (MCTS).
Для Claude 3.7 Sonnet и Claude 3.5 Sonnet (новая) мы используем гораздо более простой подход с минимальным каркасом, при котором модель сама решает, какие команды запускать и какие файлы редактировать в рамках одной сессии. Наш основной результат pass@1 в режиме «без расширенного мышления» просто наделяет модель двумя описанными здесь инструментами — инструментом bash и инструментом редактирования файлов, работающим через замену строк, а также упомянутым выше «инструментом планирования» из наших результатов TAU-bench. Из-за инфраструктурных ограничений на нашей внутренней инфраструктуре фактически решаемы лишь 489 задач из 500 (то есть эталонное решение проходит тесты). Для нашего стандартного показателя pass@1 мы учитываем 11 неразрешимых проблем как неудачи для поддержания паритета с официальной таблицей лидеров. Для прозрачности мы отдельно публикуем тестовые случаи, которые не сработали на нашей инфраструктуре.
Для нашего показателя «высоких вычислительных затрат» (high compute) мы используем дополнительную сложность и параллельные вычисления во время тестирования следующим образом:
- Мы делаем выборку из нескольких параллельных попыток с использованием каркаса, описанного выше.
- Мы отбраковываем патчи, которые ломают видимые регрессионные тесты в репозитории, аналогично подходу выборки с отклонением, принятому в Agentless; обратите внимание, что информация о скрытых тестах не используется.
- Затем мы ранжируем оставшиеся попытки с помощью модели оценки, похожей на наши результаты по GPQA и AIME, описанные в нашем исследовательском посте, и выбираем лучший вариант для отправки.
Это дает результат в 70,3% на подмножестве из n=489 проверенных задач, которые работают на нашей инфраструктуре. Без этого каркаса Claude 3.7 Sonnet достигает 63,7% на SWE-bench Verified на том же подмножестве. Исключенные 11 тестовых случаев, которые оказались несовместимы с нашей внутренней инфраструктурой:
- scikit-learn__scikit-learn-14710
- django__django-10097
- psf__requests-2317
- sphinx-doc__sphinx-10435
- sphinx-doc__sphinx-7985
- sphinx-doc__sphinx-8475
- matplotlib__matplotlib-20488
- astropy__astropy-8707
- astropy__astropy-8872
- sphinx-doc__sphinx-8595
- sphinx-doc__sphinx-9711
Полный текст статьи читайте на Anthropic
