Представляем Политику ответственного масштабирования Anthropic
Сегодня мы публикуем нашу Политику ответственного масштабирования (RSP) — серию технических и организационных протоколов, которые мы внедряем для помощи в управлении рисками при разработке все более мощных систем ИИ.
По мере того как модели ИИ становятся все более способными, мы верим, что они будут создавать огромную экономическую и социальную ценность, но также будут нести все более серьезные риски. Наша RSP сосредоточена на катастрофических рисках — тех, при которых модель ИИ напрямую вызывает масштабные разрушения. Такие риски могут исходить из преднамеренного злоупотребления моделями (например, их использования террористами или государственными акторами для создания биологического оружия) или от моделей, которые вызывают разрушения, действуя автономно способами, противоречащими намерениям их разработчиков.
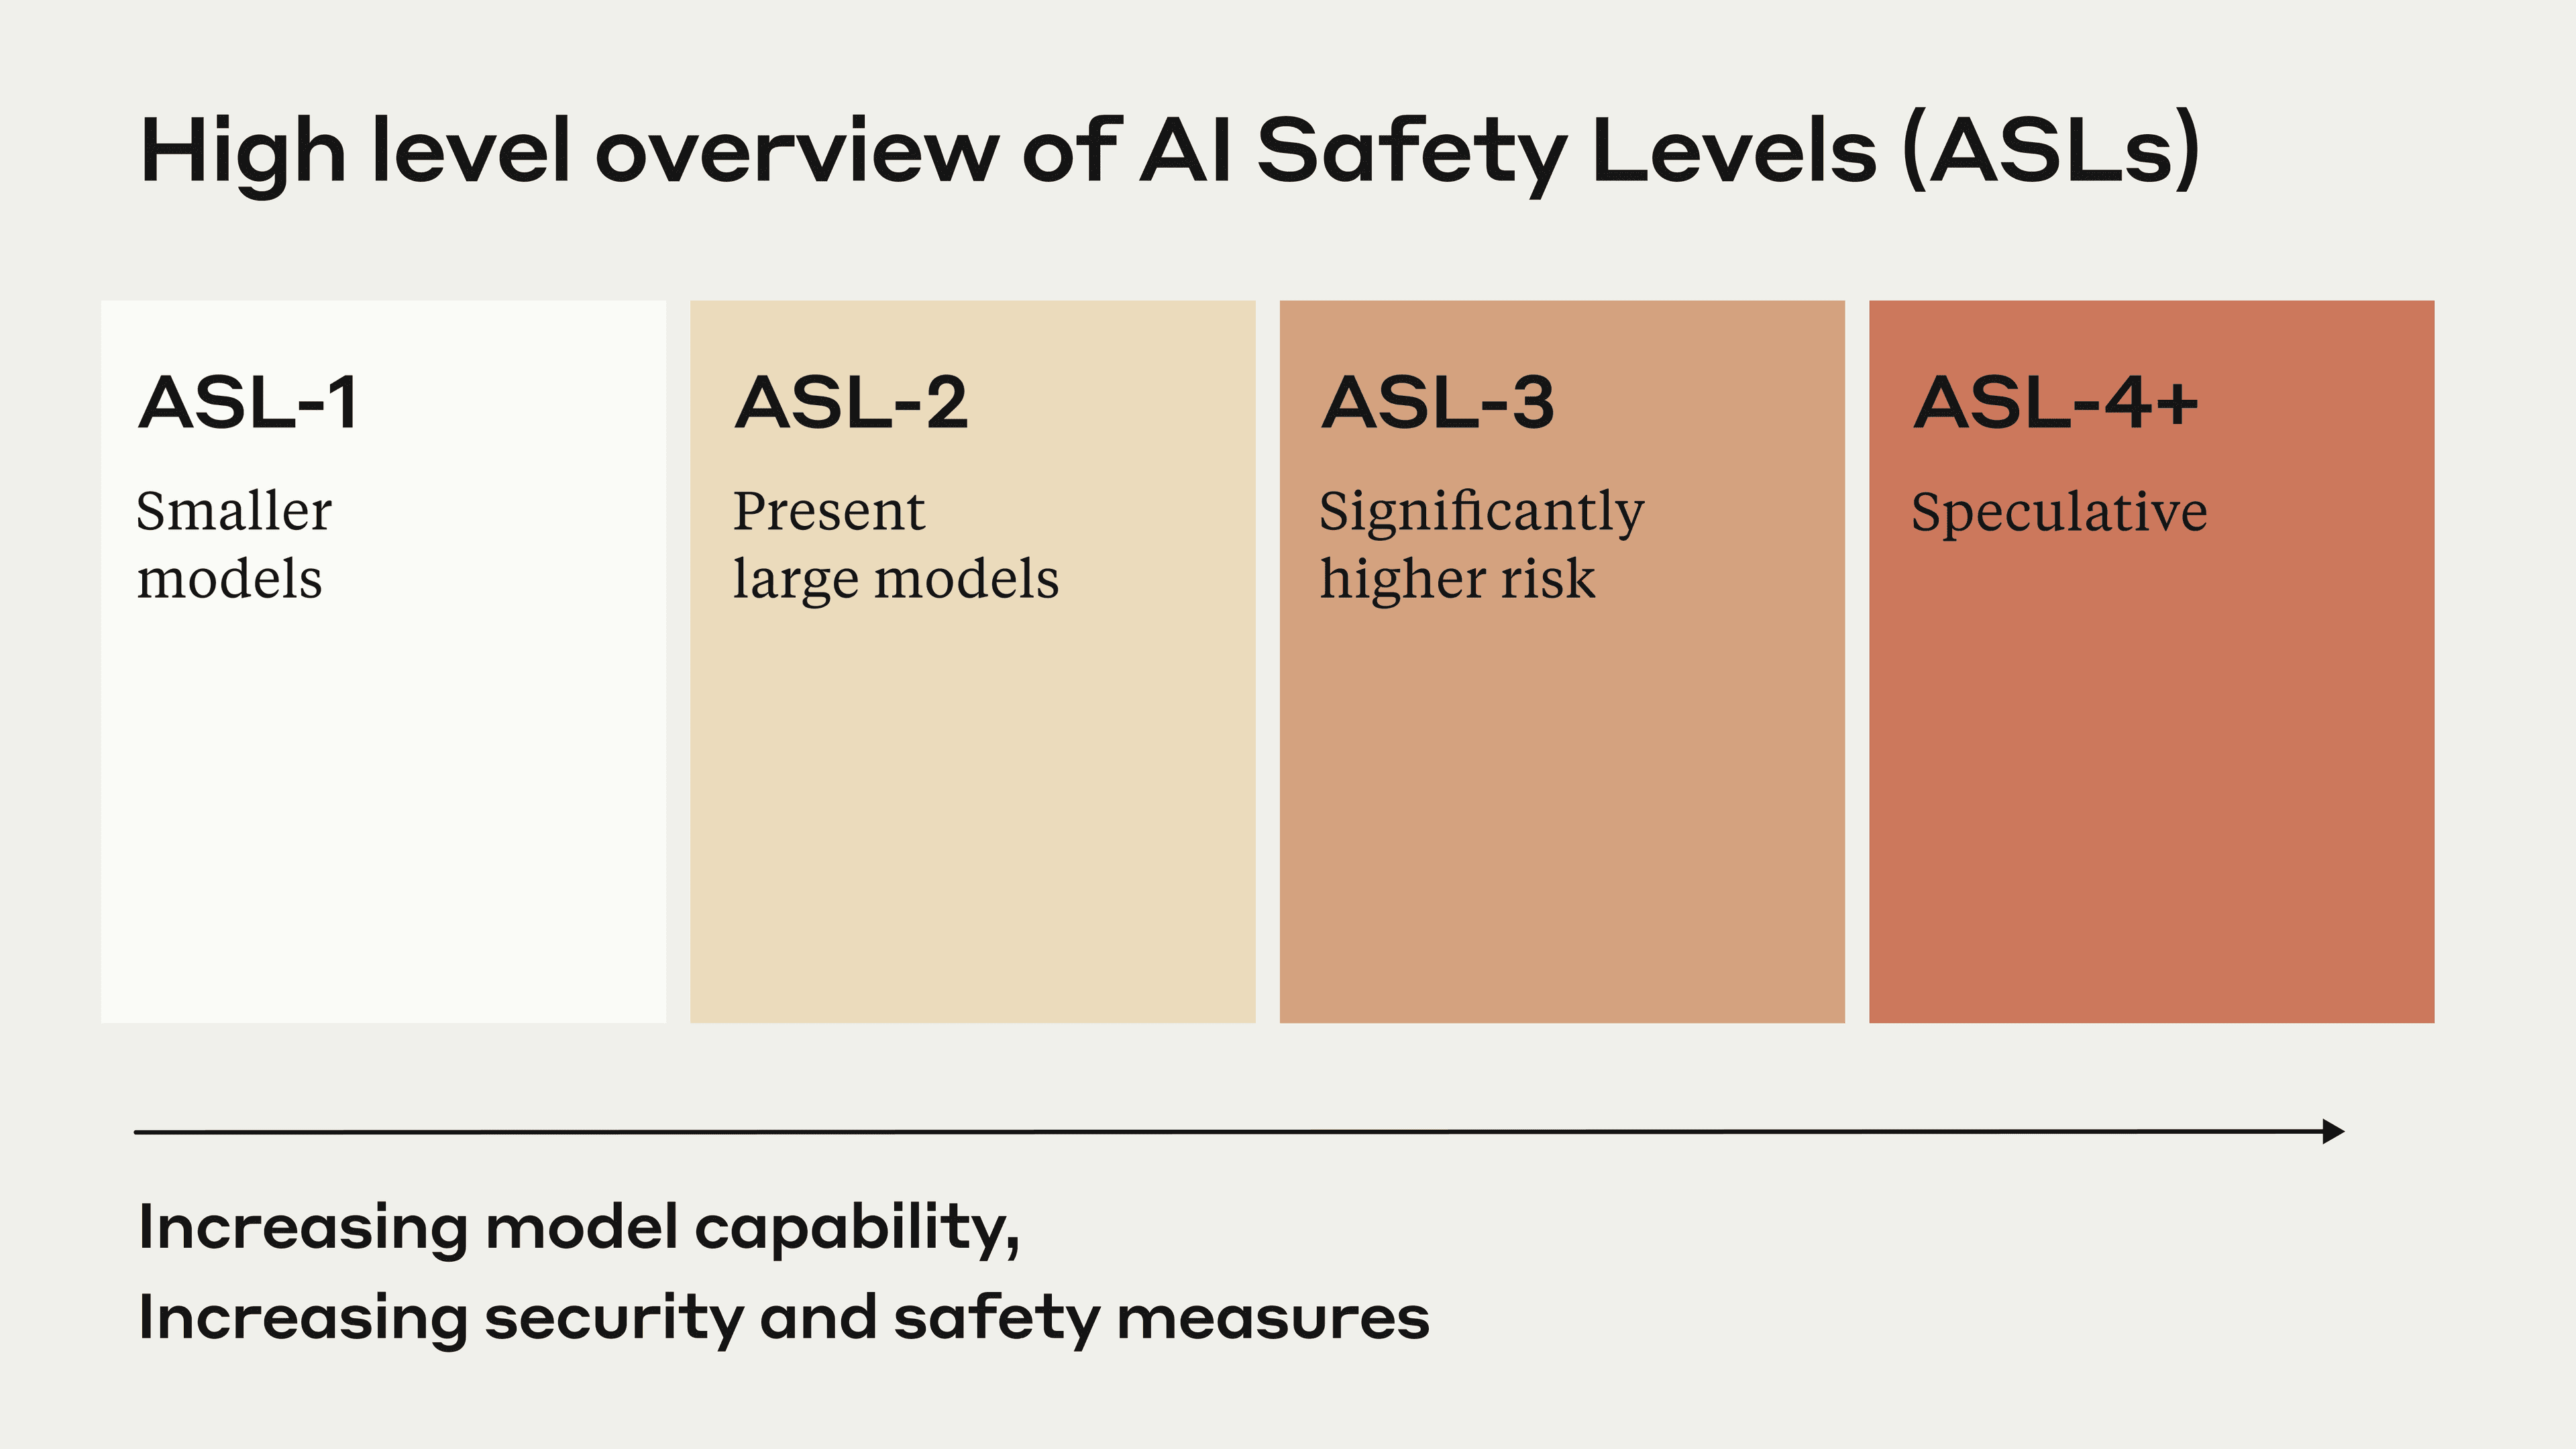
Наша RSP определяет структуру под названием «Уровни безопасности ИИ» (ASL) для противодействия катастрофическим рискам, смоделированную по аналогии со стандартами уровней биобезопасности (BSL) правительства США для работы с опасными биологическими материалами. Основная идея заключается в требовании стандартов безопасности, защищенности и операционной деятельности, соответствующих потенциалу модели в отношении катастрофических рисков, причем более высокие уровни ASL требуют все более строгих демонстраций безопасности.
Очень краткое резюме системы ASL выглядит следующим образом:
- ASL-1 относится к системам, которые не представляют значимых катастрофических рисков, например к языковой модели 2018 года или системе ИИ, которая только играет в шахматы.
- ASL-2 относится к системам, которые демонстрируют первые признаки опасных возможностей — например, способность давать инструкции по созданию биологического оружия, —, но где информация еще не полезна из-за недостаточной надежности или непредоставления информации, которую, например, не могла бы выдать поисковая система. Текущие языковые модели, включая Claude, судя по всему, соответствуют ASL-2.
- ASL-3 относится к системам, которые существенно увеличивают риск катастрофического злоупотребления по сравнению с базовыми показателями без ИИ (например, поисковыми системами или учебниками) ИЛИ демонстрируют низкоуровневые автономные возможности.
- ASL-4 и выше (ASL-5+) пока не определены, так как находятся слишком далеко от современных систем, но, вероятно, будут включать качественные эскалации потенциала катастрофического злоупотребления и автономии.
Определение, критерии и меры безопасности для каждого уровня ASL подробно описаны в основном документе, но на высоком уровне меры ASL-2 представляют собой наши текущие стандарты безопасности и защиты и существенно пересекаются с нашими недавними обязательствами перед Белым домом. Меры ASL-3 включают более строгие стандарты, для соблюдения которых в срок потребуются интенсивные исследования и инженерные усилия, такие как необычайно строгие требования к безопасности и обязательство не развертывать модели ASL-3, если они демонстрируют какой-либо значимый риск катастрофического злоупотребления при состязательном тестировании (red-teaming) командами мирового класса (в отличие от простого обязательства проводить такое тестирование). Наши меры ASL-4 еще не написаны (наше обязательство заключается в том, чтобы написать их до того, как мы достигнем ASL-3), но могут потребовать методов гарантии безопасности, которые на сегодняшний день являются нерешенными исследовательскими задачами, таких как использование методов интерпретируемости для механистической демонстрации того, что модель вряд ли совершит определенные катастрофические действия.
Мы разработали систему ASL так, чтобы соблюсти баланс между эффективным противодействием катастрофическим рискам и стимулированием полезных приложений и прогресса в области безопасности. С одной стороны, система ASL неявно требует от нас временной приостановки обучения более мощных моделей, если наше масштабирование ИИ опережает нашу способность соблюдать необходимые процедуры безопасности. Но она делает это таким образом, который напрямую стимулирует нас решать необходимые проблемы безопасности как способ разблокировать дальнейшее масштабирование, и позволяет нам использовать самые мощные модели предыдущего уровня ASL в качестве инструмента для разработки функций безопасности для следующего уровня.1 Если эта система будет принята в качестве стандарта во всех передовых лабораториях, мы надеемся, что это создаст динамику «гонки к вершине», где конкурентные стимулы будут напрямую направлены на решение проблем безопасности.
С точки зрения бизнеса мы хотим внести ясность: наша RSP не изменит текущие варианты использования Claude и не нарушит доступность наших продуктов. Скорее, ее следует рассматривать как аналогичную дорыночному тестированию и проектированию функций безопасности, проводимым в автомобильной или авиационной промышленности, где целью является строгая демонстрация безопасности продукта до его выхода на рынок, что в конечном итоге идет на пользу клиентам.
Политика RSP компании Anthropic была официально одобрена ее советом директоров, и любые изменения должны утверждаться советом директоров после консультаций с Трастом долгосрочной выгоды (Long Term Benefit Trust). В полном документе мы описываем ряд процедурных гарантий для обеспечения целостности процесса оценки.
Тем не менее, мы хотим подчеркнуть, что эти обязательства являются нашим текущим лучшим предположением и ранней итерацией, на которую мы будем опираться. Высокий темп и множество неопределенностей в области ИИ означают, что, в отличие от относительно стабильной системы BSL, быстрая итерация и корректировка курса практически наверняка будут необходимы.
С полным документом можно ознакомиться здесь. Мы надеемся, что он послужит полезным источником вдохновения для директивных органов, сторонних некоммерческих организаций и других компаний, сталкивающихся с аналогичными решениями о развертывании.
Мы благодарим ARC Evals за их ключевые идеи и экспертную поддержку в разработке наших обязательств по RSP, особенно в отношении оценки автономных возможностей. Мы обнаружили, что их опыт в оценке рисков ИИ сыграл ключевую роль при разработке наших процедур оценки. Мы также признаем лидерство ARC Evals в создании и продвижении их более широкой структуры Политики ответственного масштабирования ARC, которая вдохновила наш подход.
Сноски
- В целом Anthropic неизменно обнаруживает, что работа с передовыми моделями ИИ является важнейшим компонентом в разработке новых методов смягчения рисков, связанных с ИИ.
Полный текст статьи читайте на Anthropic
