Представляем Claude Haiku 4.5

Claude Haiku 4.5, наша новейшая компактная модель, сегодня стала доступна всем пользователям.
То, что совсем недавно находилось на переднем крае технологий, теперь стало дешевле и быстрее. Пять месяцев назад Claude Sonnet 4 была передовой моделью. Сегодня Claude Haiku 4.5 обеспечивает аналогичный уровень производительности при написании кода, но при этом обходится втрое дешевле и работает более чем в два раза быстрее.
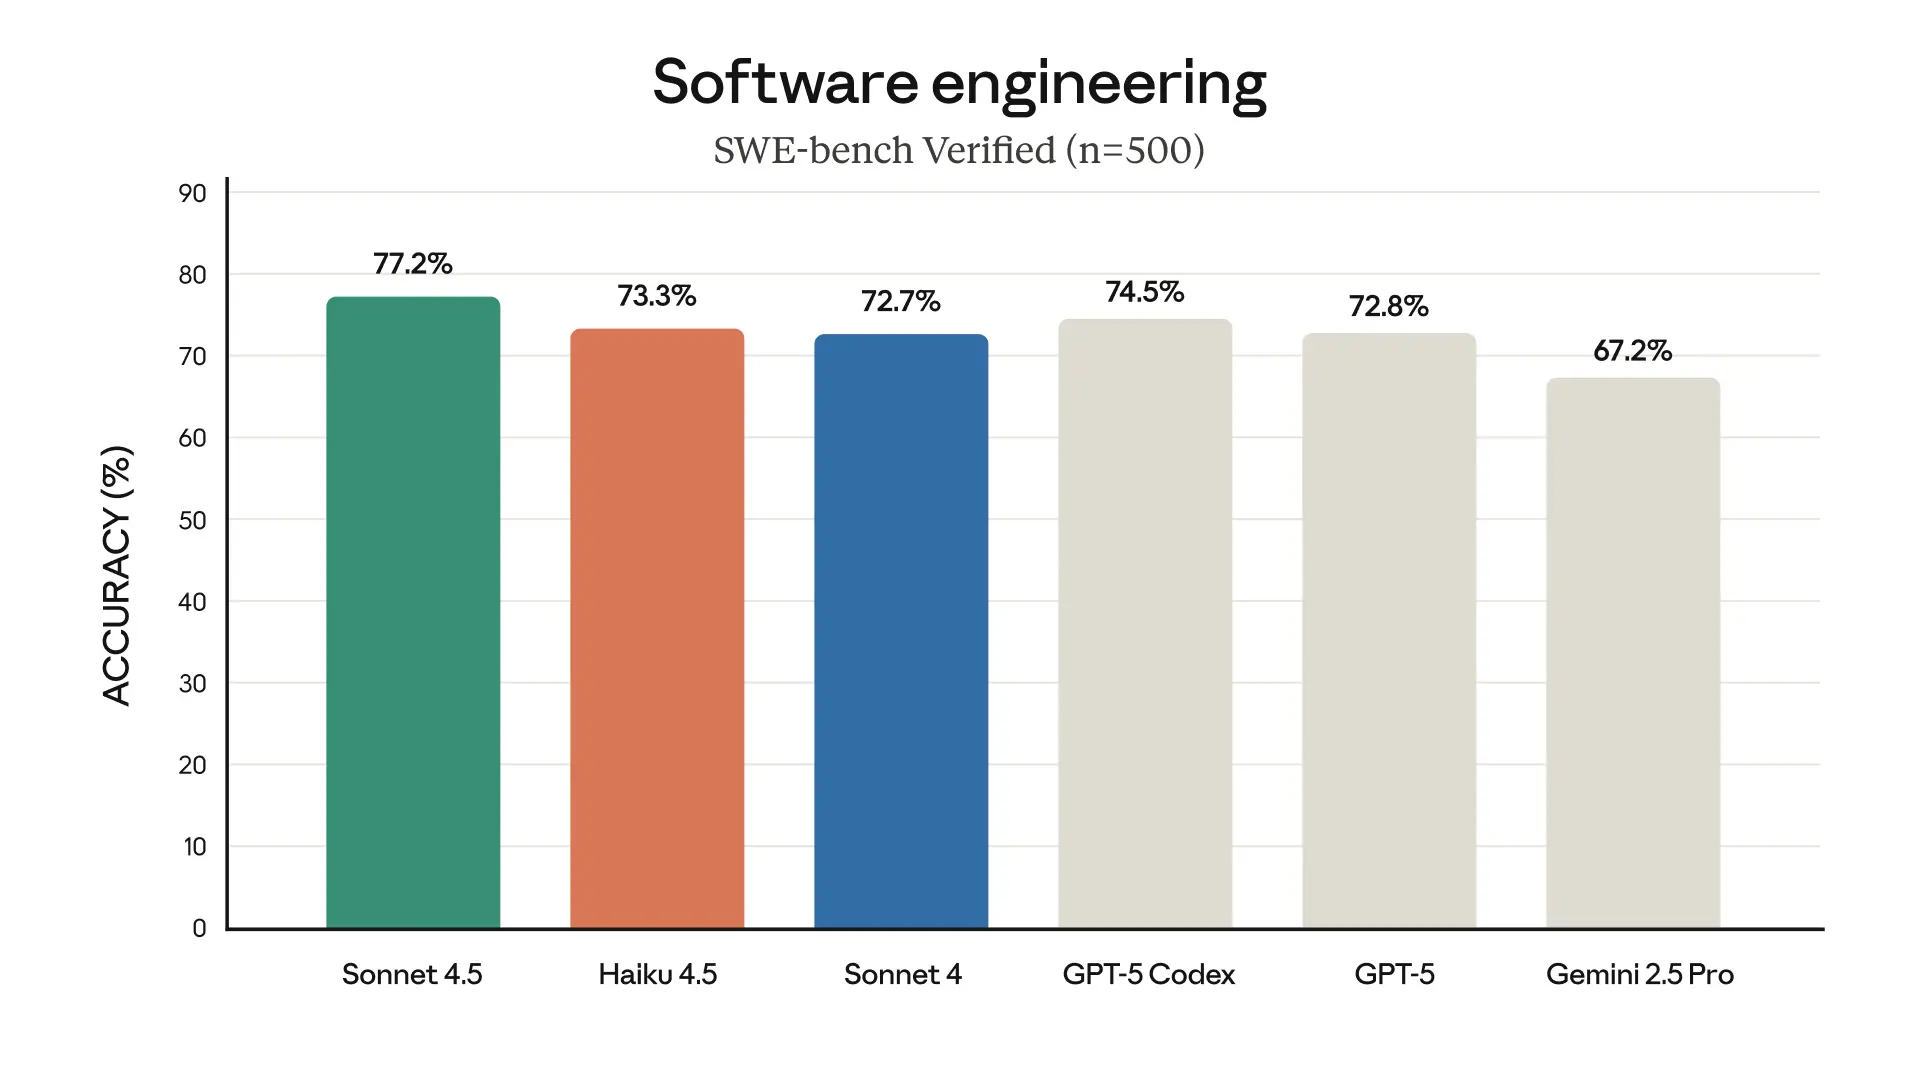
Claude Haiku 4.5 даже превосходит Claude Sonnet 4 в определенных задачах, например в управлении компьютером. Эти достижения делают такие приложения, как Claude для Chrome, быстрее и полезнее, чем когда-либо прежде.
Пользователи, которым требуется ИИ для задач в реальном времени с низкой задержкой — таких как чат-ассистенты, агенты службы поддержки или парное программирование, — оценят сочетание высокого уровня интеллекта и невероятной скорости Haiku 4.5. А пользователи Claude Code обнаружат, что Haiku 4.5 делает процесс разработки (от проектов с несколькими агентами до быстрого прототипирования) значительно более отзывчивым.
Claude Sonnet 4.5, выпущенная две недели назад, остается нашей флагманской моделью и лучшей моделью для программирования в мире. Claude Haiku 4.5 предоставляет пользователям новый вариант, когда им требуется производительность близкого к топовому уровня при гораздо большей экономичности. Она также открывает новые возможности совместного использования наших моделей. Например, Sonnet 4.5 может разбить сложную проблему на многоэтапный план, а затем скоординировать команду из нескольких моделей Haiku 4.5 для параллельного выполнения подзадач.
Claude Haiku 4.5 доступна везде уже сегодня. Если вы разработчик, просто используйте claude-haiku-4–5 через Claude API. Стоимость теперь составляет $1/$5 за миллион токенов ввода и вывода.
Бенчмарки
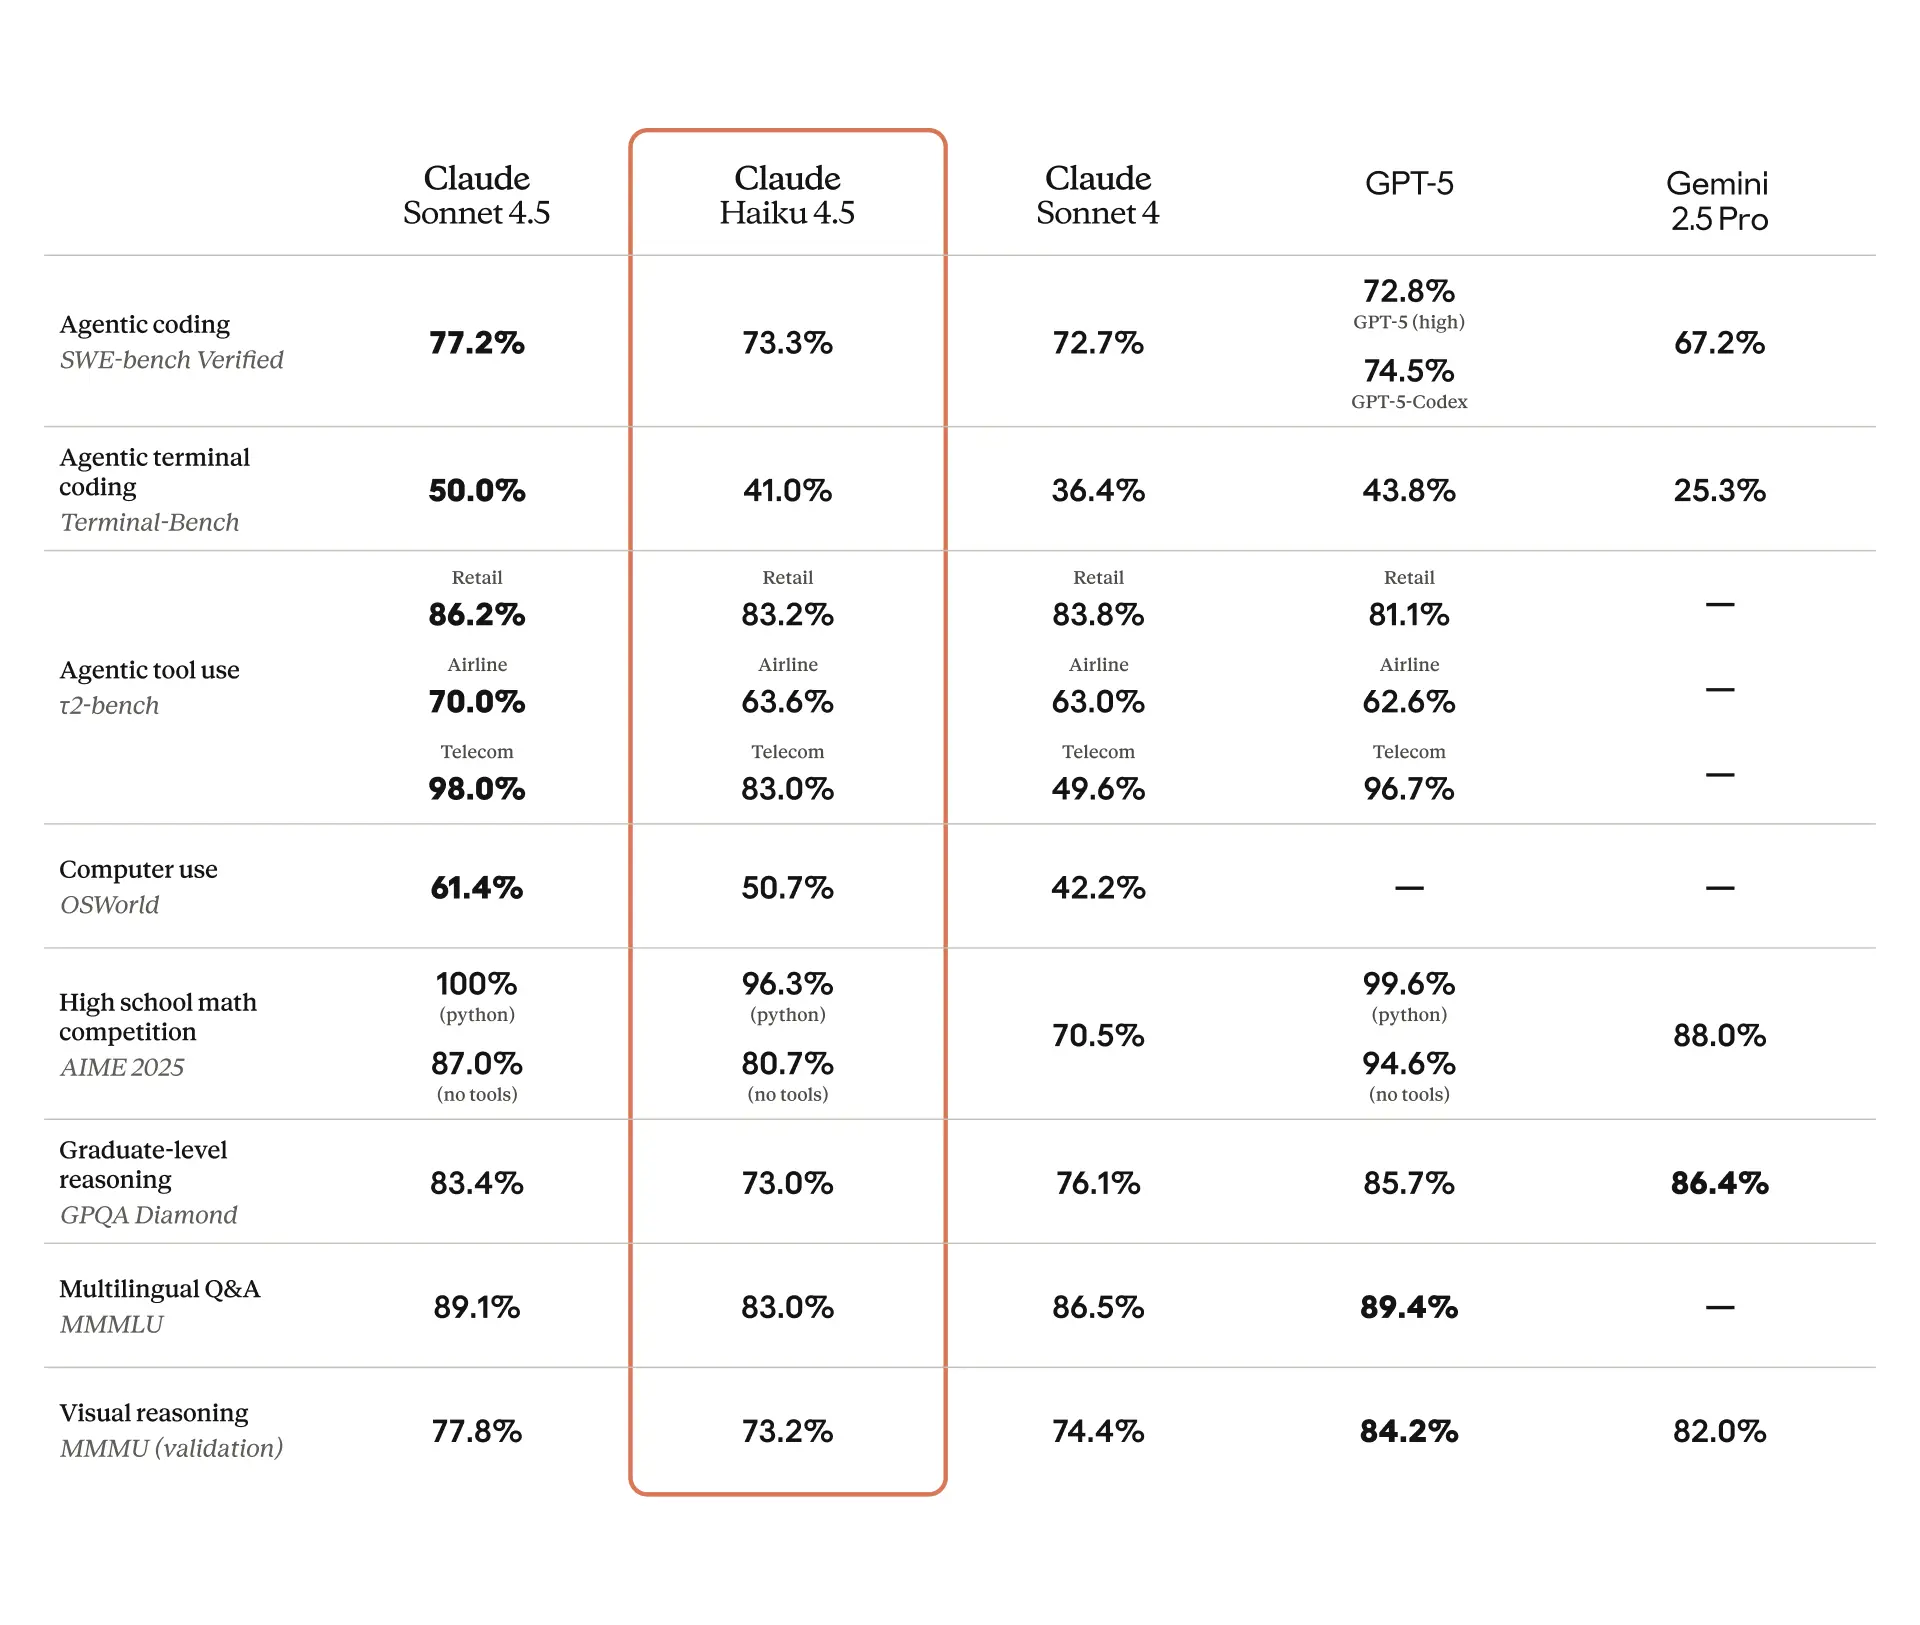 Claude Haiku 4.5 — одна из наших самых мощных моделей на сегодняшний день. Методологию см. в сносках.

Claude Haiku 4.5 попала в «золотую середину», которую мы не считали возможной: качество написания кода на уровне моделей передового края при потрясающей скорости и экономической эффективности. В оценке агентского кодинга от Augment она достигает 90% производительности Sonnet 4.5, не уступая гораздо более крупным моделям. Мы рады предложить ее нашим пользователям.Гай Гур-Ари
Сооснователь

Claude Haiku 4.5 — это качественный скачок в агентском кодинге, особенно в задачах оркестрации субагентов и управления компьютером. Скорость отклика делает разработку с помощью ИИ в Warp мгновенной.Зак Ллойд
Основатель и генеральный директор

Исторически модели жертвовали скоростью и стоимостью ради качества. Claude Haiku 4.5 стирает границы в этом компромиссе: это быстрая передовая модель, сохраняющая высокую экономичность и задающая вектор развития для данного класса моделей.Джефф Ван
Генеральный директор

Claude Haiku 4.5 обеспечивает высокий интеллект без ущерба для скорости, позволяя нам создавать ИИ-приложения, использующие как глубокие рассуждения, так и мгновенный отклик.Бен Лафферти
Ведущий инженер

Claude Haiku 4.5 удивительно способна — всего шесть месяцев назад такой уровень производительности считался бы передовым по результатам наших внутренних бенчмарков. Теперь она работает в 4–5 раз быстрее Sonnet 4.5 при лишь малой доле затрат, открывая совершенно новый спектр сценариев применения.Андрей Филев
Генеральный директор

Скорость — это новый рубеж для ИИ-агентов, работающих в циклах обратной связи. Haiku 4.5 доказывает, что можно совместить высокий интеллект и молниеносную генерацию. Она надежно справляется со сложными рабочими процессами, исправляет ошибки в режиме реального времени и поддерживает динамику без задержек. Для большинства задач разработки это идеальный баланс производительности.Брэд Эксен
Технический руководитель по ИИ

Claude Haiku 4.5 превзошла наши текущие модели по точности следования инструкциям при генерации текста для слайдов, достигнув 65% точности против 44% у модели из нашего премиального сегмента — это кардинально меняет нашу экономику единицы продукции.Джон Норонья
Сооснователь, Gamma

Наше первичное тестирование показывает, что Claude Haiku 4.5 обеспечивает эффективную генерацию кода в GitHub Copilot с качеством, сопоставимым с Sonnet 4, но при более высокой скорости. Мы уже видим, что это отличный выбор для пользователей Copilot, которые ценят скорость и отзывчивость в своих рабочих процессах разработки на базе ИИ.Мэтью Изабель
Выдающийся менеджер по продукту
Оценки безопасности
Мы провели подробную серию оценок безопасности и выравнивания (alignment) для Claude Haiku 4.5. Модель продемонстрировала низкие показатели проблемного поведения и оказалась существенно более выровненной по сравнению со своим предшественником, Claude Haiku 3.5. В нашей автоматизированной оценке выравнивания Claude Haiku 4.5 также показала статистически значимо более низкий общий уровень отклоняющегося от норм поведения по сравнению как с Claude Sonnet 4.5, так и с Claude Opus 4.1, что делает Claude Haiku 4.5, судя по этой метрике, нашей самой безопасной моделью на сегодняшний день.
Наше тестирование безопасности также показало, что Claude Haiku 4.5 представляет лишь ограниченные риски с точки зрения производства химического, биологического, радиологического и ядерного оружия (ХБРЯ). По этой причине мы выпустили ее в соответствии со стандартом уровня безопасности ИИ 2 (AI Safety Level 2, ASL-2) по сравнению с более строгим ASL-3 для Sonnet 4.5 и Opus 4.1. С полным обоснованием классификации модели по стандарту ASL-2, а также с подробной информацией о всех других наших тестах безопасности можно ознакомиться в системной карте Claude Haiku 4.5.
Дополнительная информация
Claude Haiku 4.5 уже доступна в Claude Code и в наших приложениях. Ее эффективность означает, что вы можете сделать больше в рамках своих лимитов использования, сохранив при этом производительность премиальной модели.
Разработчики могут использовать Claude Haiku 4.5 через наш API, Amazon Bedrock и Google Cloud Vertex AI, где она выступает в качестве прямой замены как Haiku 3.5, так и Sonnet 4 по нашей самой выгодной цене.
Для получения полных технических деталей и результатов оценки ознакомьтесь с нашей системной картой, страницей модели и документацией.
Методология
- SWE-bench Verified: Все результаты Claude были получены с использованием простой оболочки (scaffold) с двумя инструментами — bash и редактированием файлов посредством замены строк. Мы сообщаем о показателе 73,3%, который усреднен по 50 попыткам без вычислений во время тестирования (test-time compute), с бюджетом размышлений 128K и стандартными параметрами семплирования (temperature, top_p) на всем наборе данных SWE-bench Verified, состоящем из 500 задач.
- В заявленном балле используется небольшое дополнение к промпту: «Вы должны использовать инструменты как можно чаще, в идеале более 100 раз. Вам также следует сначала реализовать собственные тесты, прежде чем приступать к решению проблемы».
- Terminal-Bench: Все заявленные баллы получены с использованием стандартного фреймворка агента (Terminus 2) с XML-парсером, в среднем по 11 запускам (6 без режима размышлений (балл 40,21%), 5 с бюджетом размышлений 32K (балл 41,75%)) при n-попыток = 1.
- τ2-bench: Баллы были получены в результате усреднения по 10 запускам с использованием расширенного режима размышлений (бюджет размышлений 128k) и стандартных параметров семплирования (temperature, top_p) с использованием инструментов и добавлением к промпту для политики агентов авиакомпаний и телекоммуникаций инструкций, помогающих Claude лучше учитывать известные сценарии сбоев при использовании стандартного промпта. Дополнение к промпту также было добавлено для пользователя телекоммуникационных услуг во избежание сбоев из-за некорректного завершения взаимодействия пользователем.
- AIME: Балл Haiku 4.5 указан как среднее значение по 10 независимым запускам, каждый из которых вычисляет pass@1 по 16 испытаниям со стандартными параметрами семплирования (temperature, top_p) и бюджетом размышлений 128K.
- OSWorld: Все заявленные баллы получены с использованием официального фреймворка OSWorld-Verified с максимальным количеством шагов 100, в среднем по 4 запускам с общим бюджетом размышлений 128K и настроенным бюджетом размышлений 2K на один шаг.
- MMMLU: Все заявленные баллы представляют собой среднее значение по 10 запускам на 14 языках (кроме английского) с бюджетом размышлений 128K.
- Все остальные баллы были усреднены по 10 запускам со стандартными параметрами семплирования (temperature, top_p) и бюджетом размышлений 128K.
Все баллы OpenAI взяты из их <публикации о GPT-5, публикации о GPT-5 для разработчиков, системной карты GPT-5 (SWE-bench Verified указан при использовании n=500) и таблицы лидеров Terminal Bench (с использованием Terminus 2). Все баллы Gemini взяты с их веб-страницы модели и таблицы лидеров Terminal Bench (с использованием Terminus 1).
Полный текст статьи читайте на Anthropic
