Почему Markdown становится стандартным языком между поисковыми данными и ИИ-моделями
- OpenAI рекомендует форматировать промпты заголовками, списками и таблицами Markdown для повышения точности выполнения инструкций моделью.
- Компания SerpApi бесплатно внедрила вывод данных в Markdown во все свои более 100 API для ИИ-агентов.
- Переход с JSON на Markdown сокращает объем токенов в среднем на 50%, а в поисковом тесте SerpApi — на 74%.
Почему это важно: Экономия токенов снижает затраты на запросы к моделям и позволяет передавать больше полезного контекста в рамках лимитов памяти.
В инфраструктурном слое, который обеспечивает работу ИИ-приложений, Markdown постепенно становится новым стандартом. Все больше провайдеров выбирают его в качестве формата по умолчанию для всего, что необходимо прочитать модели, отходя от JavaScript Object Notation (JSON) как универсального решения на все случаи жизни.
Этот реальный и непрерывный сдвиг отражает то, как обучаются большие языковые модели, как чат-интерфейсы выводят ответы и как разработчики на самом деле создают продукты с учетом токенов, контекстных окон и затрат. И для такого перехода есть веские причины.
Markdown соответствует принципам работы моделей
Большие языковые модели обучались на колоссальных объемах данных в формате Markdown. Вспомните сайты документации, файлы README, технические блоги, ветки форумов, базы знаний и так далее. Благодаря такому опыту модели уже свободно «говорят» на Markdown: они умеют анализировать его заголовки, списки, таблицы и блоки кода, воспринимая их как смысловые сигналы, а не как шум.
В то же время пользовательские чат-интерфейсы уже способны отображать ответы из Markdown. Когда модель выдает Markdown, фронтенд может отобразить его в чистом виде без дополнительных преобразований. Когда та же модель принимает Markdown, она получает информацию в форме, которая отражает распределение данных при ее обучении и ожидаемый формат ответа. В результате получается более естественный цикл «вход-выход», чем при отправке моделям громоздкого вложенного JSON, который перед использованием приходится мысленно распаковывать.
Если посмотреть на ситуацию с точки зрения токенов, Markdown также оказывается более экономным подходом. Он убирает структурные накладные расходы и сохраняет информационную полезную нагрузку. Для ИИ-агентов, которым необходимо уместить огромные объемы контекста в ограниченное окно, эта эффективность напрямую трансформируется в более релевантный контент на один запрос и более низкую стоимость одного вывода.
Заметный тренд
Переход на Markdown не является спекулятивным. Он уже закладывается в рекомендации по передовой практике от ведущих разработчиков моделей. В документации OpenAI по промпт-инжинирингу прямо рекомендуется структурировать сообщения для разработчиков с помощью заголовков Markdown, маркированных списков и таблиц, где это уместно. В руководстве советуют использовать »##» для основных разделов, обратные апострофы (backticks) для кода и четкое иерархическое форматирование для повышения точности следования инструкциям модели и удобочитаемости.
Сторонние руководства по составлению промптов повторяют этот паттерн. В них используются заголовки Markdown для разделения на секции, списки для перечислений и таблицы для сравнения. Ряд аналитических материалов отмечает, что Markdown более эффективен с точки зрения токенов и лучше понимается моделями, обученными на документации, что делает его предпочтительным инструментом форматирования для сложных промптов, особенно в моделях новой серии GPT-5.
Поставщики инфраструктуры согласны с этим
Провайдеры API и данных также перешли на сторону Markdown. Там, где раньше JSON царил как универсальный формат обмена, многие теперь предлагают варианты в формате Markdown, оптимизированные для потребления LLM. Логика ровно та же: они хотят снизить раздувание токенов (token bloat), упростить синтаксический анализ для агентов и привести всё в соответствие с тем, как для моделей пишутся промпты и как отображаются ответы.
SerpApi, девятилетняя компания — поставщик API поисковых данных, недавно запустила поддержку вывода в формате Markdown во всех своих более чем 100 API без дополнительной платы. SerpApi предоставляет разработчикам, исследователям и компаниям из списка Fortune 500 структурированные данные из Google, Bing, YouTube и других источников. Эта функция позволяет разработчикам запрашивать результаты поиска в легком формате Markdown вместо JSON, что ориентировано конкретно на ИИ-агентов и приложения на базе LLM. Никакой новый эндпоинт не требуется, а формат запрашивается через параметр запроса, расширение маршрута или заголовок в существующих интеграциях.
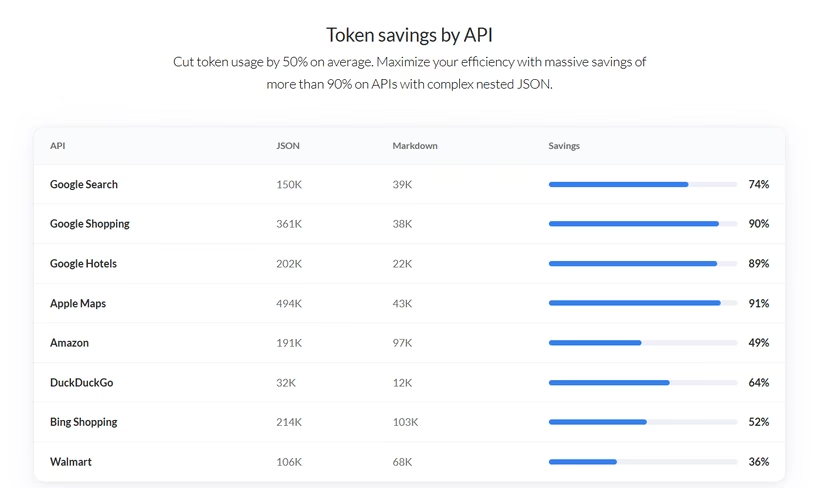
В реальном примере из бенчмарков самой SerpApi один поисковый запрос в Google по слову «coffee» стоит 24 723 токена в формате JSON и 6 435 токенов в формате Markdown, что в сумме дает сокращение на 74%. В сочетании с фильтрацией по полям этот же ответ уменьшился еще сильнее — до 1 298 токенов. По данным SerpApi, в среднем по всем API экономия токенов составляет около 50%, а на некоторых эндпоинтах сокращение достигает 90%.
Экономия токенов по восьми API согласно данным, опубликованным SerpApi. — Источник: SerpApi
Эти цифры имеют значение, потому что результаты поиска — это одни из самых зашумленных и глубоко вложенных массивов данных, с которыми работают агенты. Ответы в JSON содержат ссылки перенаправления, иконки (favicons), параметры отслеживания и глубоко вложенные метаданные, над которыми моделям не нужно производить логические операции. Вывод в формате Markdown, напротив, сохраняет ключевую информацию (такую как заголовки, сниппеты, ссылки, цены и рейтинги в таблицах и списках), автоматически отсеивая большую часть внутреннего мусора трекинга и дублирующиеся поля.
Разработчики могут получить доступ к новому формату Markdown, добавив «output=md» к строке запроса, вызвав маршрут »/search.md» или установив заголовок «Accept: text/markdown». Ответы включают фронтматтер (YAML frontmatter) для метаданных, структурированные таблицы Markdown для наборов результатов и нативные встроенные ссылки — всё это предназначено для того, чтобы сразу передавать данные в промпты или оперативную память агента.
Что всё это значит
Поскольку все большая часть интернета начинает потребляться агентами, а не людьми, инфраструктурный слой будет все больше оптимизироваться в сторону машиночитаемости, а не удобной для людей вложенности. JSON остается незаменимым для программной манипуляции и строгого контроля схем, но для фазы поглощения контекста в ИИ-рабочих процессах Markdown становится новым стандартом по умолчанию.
В ближайшие месяцы следует ожидать, что все больше поставщиков данных будут предлагать варианты ответов в формате Markdown, особенно для поиска, электронной коммерции, карт и контентных API, где эффективность использования токенов напрямую влияет на стоимость и производительность. Шаблоны промптов и агентские фреймворки также, вероятнее всего, стандартизируют использование разделов, таблиц и списков Markdown в качестве канонического способа представления извлеченного контекста для моделей. Инструментарий также должен развиваться в направлении измерения и минимизации объема токенов, где Markdown станет основным рычагом.
Для разработчиков, создающих продукты с использованием LLM сегодня, все очевидно. При передаче внешних данных в модели следует отдавать предпочтение форматам, которые соответствуют тому, как модели обучаются и как они выводят информацию. Markdown больше не просто инструмент для документации. Он становится новым лингва франка между поисковыми данными и ИИ-моделями.
Полный текст статьи читайте на TheNextWeb.ru
