Обобщение со слабого на сильное
Justin Jay Wang × DALL·E
Мы представляем новое направление исследований в области супералаймента, а также многообещающие первые результаты: можем ли мы использовать свойства обобщения глубокого обучения для управления сильными моделями с помощью слабых супервизоров?
Главная проблема выравнивания будущих сверхчеловеческих систем ИИ (супералаймента) заключается в том, что людям придется осуществлять надзор за системами ИИ, которые намного умнее их. Мы изучаем простую аналогию: могут ли небольшие модели контролировать крупные модели? Мы показываем, что можем использовать модель уровня GPT-2 для извлечения большей части возможностей GPT-4 (производительность близка к уровню GPT-3.5), при этом модель корректно обобщает данные даже на сложных задачах, с которыми не справилась маленькая модель. Это открывает новое направление исследований, позволяющее напрямую решать центральную задачу выравнивания будущих сверхчеловеческих моделей и одновременно добиваться итеративного эмпирического прогресса уже сегодня.
Проблема супералаймента
Мы верим, что суперинтеллект — ИИ, значительно превосходящий по уму человека, — может быть создан в течение ближайших десяти лет. Тем не менее, мы до сих пор не знаем, как надежно направлять и контролировать сверхчеловеческие системы ИИ. Решение этой проблемы имеет решающее значение для того, чтобы даже самые передовые системы ИИ в будущем оставались безопасными и приносили пользу человечеству.
Ранее в этом году мы сформировали команду по супералайменту для решения проблемы выравнивания суперинтеллекта. Сегодня мы выпускаем первую научную работу команды, в которой представлено новое направление исследований по эмпирическому выравниванию сверхчеловеческих моделей.
Существующие методы выравнивания, такие как обучение с подкреплением на основе отзывов людей (RLHF), опираются на человеческий надзор. Однако будущие системы ИИ будут способны на чрезвычайно сложное и творческое поведение, из-за чего людям будет трудно надежно их контролировать. Например, сверхчеловеческие модели смогут писать миллионы строк нового — и потенциально опасного — компьютерного кода, который будет очень сложно понять даже экспертам-людям.
По сравнению со сверхчеловеческими моделями ИИ люди будут «слабыми супервизорами». Это главная проблема выравнивания ОИИ (AGI): как слабые супервизоры могут доверять существенно более сильным моделям и контролировать их?
Наш подход
Чтобы добиться прогресса в решении этой ключевой задачи, мы предлагаем аналогию, которую можем изучить эмпирически уже сегодня: можем ли мы использовать меньшую (менее способную) модель для надзора за более крупной (более способной) моделью?
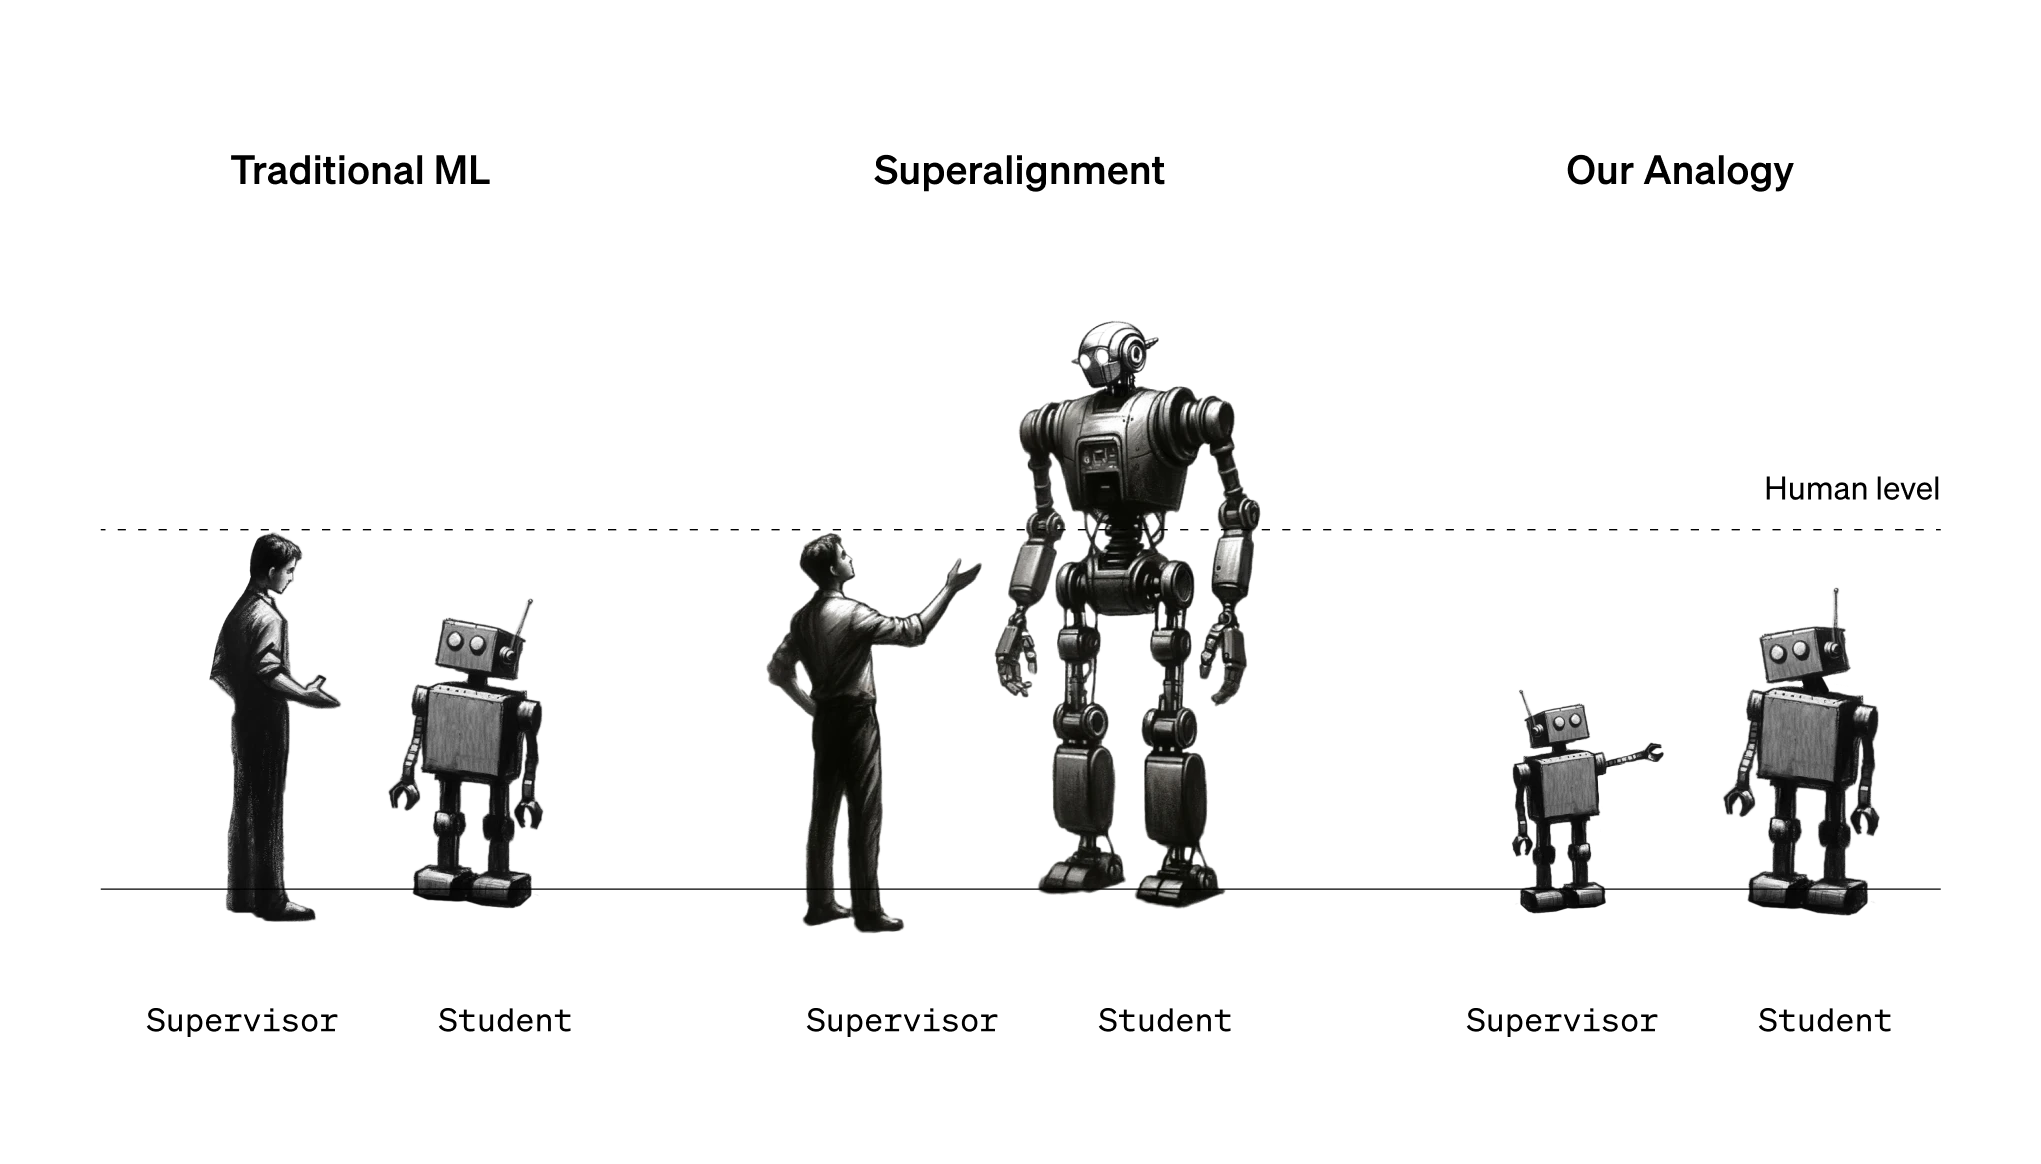
Простая аналогия для супералаймента: В традиционном машинном обучении (МО) люди контролируют системы ИИ, которые слабее их самих (слева). Для выравнивания суперинтеллекта людям, напротив, потребуется контролировать системы ИИ, которые умнее их (в центре). Мы не можем напрямую изучать эту проблему сегодня, но мы можем изучить простую аналогию: могут ли небольшие модели контролировать более крупные модели (справа)?
Наивно полагать, что сильная модель будет работать лучше слабого супервизора, который предоставляет сигнал для ее обучения — она может просто научиться имитировать все ошибки, совершаемые слабым супервизором. С другой стороны, сильные предобученные модели обладают превосходными базовыми возможностями — нам не нужно обучать их новым задачам с нуля, нам нужно лишь извлечь их скрытые знания. Критически важным тогда является вопрос: будет ли сильная модель обобщать данные в соответствии с глубинным замыслом слабого супервизора, используя весь свой потенциал для решения задачи даже в сложных случаях, когда слабый супервизор может предоставить лишь неполные или несовершенные обучающие метки?
Наши результаты
Мы можем значительно улучшить обобщение в самых разных сценариях. Мы используем простой метод, который побуждает сильную модель быть более уверенной в себе, включая уверенное несогласие со слабым супервизором, если это необходимо. Когда мы контролируем GPT-4 с помощью модели уровня GPT-2, используя этот метод на задачах обработки естественного языка (NLP), полученная модель обычно демонстрирует производительность где-то между GPT-3 и GPT-3.5. Нам удается восстановить большую часть возможностей GPT-4, используя лишь гораздо более слабый надзор.
Этот метод является концептуальной проверкой с важными ограничениями; например, он по-прежнему не работает на данных предпочтений ChatGPT. Тем не менее, мы также наблюдаем положительные сдвиги при использовании других подходов, таких как оптимальная раннее прекращение обучения (early stopping) и бутстрапинг от маленьких моделей к промежуточным и крупным.
В совокупности наши результаты показывают, что (1) наивный человеческий надзор — такой как обучение с подкреплением на основе отзывов людей (RLHF) — может оказаться малоэффективным для масштабирования на сверхчеловеческие модели без дополнительной работы, но при этом (2) вполне возможно существенно улучшить обобщение со слабого на сильное.
Возможности для исследований
Между нашей текущей эмпирической установкой и конечной задачей выравнивания сверхчеловеческих моделей по-прежнему существуют важные различия. Например, будущим моделям может быть проще имитировать слабые ошибки человека, чем нынешним сильным моделям — ошибки нынешних слабых моделей, что может усложнить обобщение в будущем.
Тем не менее, мы верим, что наша установка отражает некоторые ключевые трудности выравнивания будущих сверхчеловеческих моделей, позволяя нам уже сегодня начать эмпирический прогресс в решении этой проблемы. Существует множество перспективных направлений для будущей работы, включая устранение несоответствий в нашей установке, разработку более масштабируемых методов и углубление нашего научного понимания того, когда и как нам следует ожидать хорошего обобщения со слабого на сильное.
Мы считаем это прекрасной возможностью для исследовательского сообщества по машинному обучению добиться прогресса в области выравнивания. Чтобы дать толчок дальнейшим исследованиям в этой области:
- Мы публикуем исходный код с открытым исходным кодом, чтобы упростить начало экспериментов по обобщению со слабого на сильное уже сегодня.
- Мы запускаем грантовую программу на сумму 10 миллионов долларов для аспирантов, ученых и других исследователей, занимающихся общими вопросами выравнивания сверхчеловеческого ИИ. Мы особенно рады поддержать исследования, связанные с обобщением со слабого на сильное.
Выяснение того, как выровнять будущие сверхчеловеческие системы ИИ ради безопасности, никогда не было столь важным, и теперь добиваться эмпирического прогресса в решении этой проблемы проще, чем когда-либо. Мы с нетерпением ждем прорывов, которые совершат исследователи.
Авторы
Участники
Yining Chen, Adrien Ecoffet, Manas Joglekar, Ilya Sutskever, Greg Brockman, Hannah Wong, Kendra Rimbach, Elie Georges, Thomas Degry, Casey Martin, Lindsay McMenamin, Owen Cramp, Marc Hill
Полный текст статьи читайте на OpenAI
