ИИ для научных открытий: как исследователи используют Claude
- Авторы проанализировали 207 049 научных сессий Claude и Claude Code за период со 2 августа по 30 сентября 2026 года.
- Анализ данных занимает около трети сессий Claude и почти половину Claude Code; относительно числа исследователей сервис чаще используют в формальных науках.
- По модели, широкое внедрение нынешних возможностей ИИ может удвоить объём исследований в некоторых областях, а автоматизация нефизической работы — увеличить его в 15 раз в информатике и статистике.
Почему это важно: Отчёт призван помочь понять нынешнее применение ИИ в науке и оценить его возможное влияние на будущие открытия.
Глава 01: Краткое содержание
Johannes Hermle*, Ben Jones*, Lukas Althoff*, Ryan Heller, Thomas Lyttelton, Carolyn Stein, Nathan Wilmers, Maxim Massenkoff, Peter McCrory
*Основные авторы отчёта
Краткое содержание
- Что мы измеряем. ИИ может ускорить научные открытия, но степень ускорения зависит от возможностей ИИ и того, как им пользуются учёные. Используя методы, обеспечивающие конфиденциальность, мы изучаем 207 000 исследовательских сессий в Claude и Claude Code, чтобы понять, как Claude применяется в разных научных областях и исследовательских задачах. Мы проводим это исследование, чтобы помочь общественности лучше понять нынешнее состояние ИИ в науке и оценить его возможное влияние на научные открытия в будущем.
- Где учёные используют Claude. В пересчёте на число исследователей в каждой области Claude чаще используют в формальных науках — например, в информатике, математике и статистике, — и реже в здравоохранении и лабораторных физических науках. Учёные используют Claude преимущественно для анализа данных и написания текстов. На один только анализ данных приходится около трети сессий в Claude и почти половина сессий в Claude Code. Для генерации идей и сбора данных его используют реже, хотя в сопутствующем опросе учёные назвали эти задачи наиболее важными для научных открытий. Впрочем, специализированные инструменты ИИ, разработанные для научной работы, могут сократить разрыв между исследовательскими задачами, для которых учёные используют ИИ, и теми, которые считают наиболее важными. Например, в Claude Science на генерацию идей приходится примерно вдвое большая доля использования, чем в Claude.
- Как использование Claude соотносится с возможностями ИИ. Мы разработали показатель, отражающий, насколько хорошо ИИ теоретически способен выполнять каждую исследовательскую задачу. Задачи, для которых ИИ подходит лучше всего (верхние 20% по этому показателю), получают в два-четыре раза больше использования Claude, чем можно было бы ожидать, исходя из времени, которое на них тратят исследователи. Задачи, для которых ИИ подходит хуже всего (нижние 20%), включая большинство видов физической работы, используются совсем мало. Мы наблюдаем ту же закономерность и при сравнении областей: Claude чаще используют в тех областях, где ИИ способен хорошо выполнять многие задачи, например в информатике и статистике.
- Что это может означать для скорости научных открытий. С помощью простой модели мы рассматриваем сценарии того, насколько ИИ может ускорить исследования. При широком внедрении существующих возможностей ИИ объём исследований в некоторых областях может удвоиться. Если ИИ сможет выполнять всю нефизическую исследовательскую работу, объём исследований в таких областях, как информатика и статистика, может вырасти в 15 раз, тогда как в экспериментальных науках, таких как химия и биология, где прогресс сдерживают физические ограничения, — в три-четыре раза. В нашем опросе исследователей, активно использующих ИИ, около 40% ожидают, что к 2030 году модели ИИ смогут самостоятельно выполнять полноценные исследовательские проекты.
Введение
Науку описывали как «бесконечный рубеж» (Bush, 1945). Однако скорость освоения этого рубежа исторически ограничивалась дефицитным ресурсом — временем и талантом исследователей. Искусственный интеллект может ослабить это ограничение, расширив возможности исследователей и преобразив как сам процесс открытий, так и темпы научного поиска (Wang et al., 2023; Amodei, 2024). Мало какие применения ИИ могли бы иметь большее значение для благополучия человечества. Поскольку исследования по своей природе требуют значительно более интенсивной интеллектуальной деятельности, чем большинство отраслей экономики, влияние ИИ в этой сфере может быть особенно значительным и проявиться раньше.
Последние примеры показывают, что роль ИИ в научных открытиях растёт. В структурной биологии AlphaFold предсказала трёхмерные структуры более 200 миллионов белков (Jumper et al., 2021; Varadi et al., 2024), а её создатели разделили Нобелевскую премию по химии за 2024 год. В материаловедении GNoME предсказала 380 000 новых стабильных кристаллов (Merchant et al., 2023). В математике исследователи использовали системы ИИ, чтобы помочь решить задачи Эрдёша, остававшиеся открытыми десятилетиями, предложить возможное доказательство задачи тысячелетия и добиться прогресса в решении других крупных проблем — от открытых гипотез до проверки знаковых доказательств (Anthropic, 2026a, 2026b; OpenAI, 2026a, 2026b; Tsoukalas et al., 2026).
Помимо этих достижений, большая часть научного прогресса складывается из множества специализированных взаимосвязанных исследовательских задач, которые могут существенно различаться в разных областях. Насколько ИИ ускорит научные открытия, зависит не только от его возможностей, но и от того, как он будет применяться для решения этих задач. В этом отчёте мы используем инфраструктуру, обеспечивающую конфиденциальность, чтобы изучить применение Claude, Claude Code и Claude Science в научной работе. Мы описываем различия в использовании между областями и задачами, определяем причины этих закономерностей и рассматриваем сценарии того, как ИИ может ускорить исследования.
Использование Claude в науке различается по областям. В пересчёте на число исследователей Claude чаще применяют в формальных науках, таких как информатика, математика и статистика, и реже — в здравоохранении и лабораторных физических науках. В рамках исследовательских задач учёные чаще используют Claude для анализа данных и написания текстов, а реже — для сбора данных и генерации идей и гипотез. Это согласуется с самооценкой использования ИИ, полученной в сопутствующем опросе учёных.
Чтобы понять эти различия, мы разработали показатель теоретических возможностей ИИ. Claude чаще используют для задач и в областях, получивших более высокий балл по этому показателю. Такие задачи и области, как правило, требуют более интенсивной интеллектуальной работы и лучше подходят для обучения с подкреплением, при котором ИИ учится на обратной связи после многократных попыток. Иными словами, похоже, учёные используют ИИ там, где он работает лучше всего.
Опираясь на эти результаты, мы рассматриваем сценарии того, как ИИ может ускорить научный прогресс. При нынешних возможностях объём исследований в некоторых областях может вырасти вдвое — главным образом благодаря помощи ИИ в выполнении отдельных задач. Исследователи, участвовавшие в нашем опросе, ожидают появления гораздо более широких возможностей. В гипотетическом сценарии, где ИИ полностью автоматизирует всю нефизическую работу, объём исследований в интеллектуально насыщенных областях, таких как информатика и статистика, может вырасти в 15 раз. Поскольку области с наибольшим потенциалом ускорения включают и те, в которых создают сам ИИ, такой рост может запустить дополнительный цикл обратной связи: более быстрые исследования в сфере ИИ приведут к появлению более мощного ИИ, который, в свою очередь, сможет ещё сильнее ускорить исследования.
Хотя ускорение научных открытий может принести человечеству значительную пользу, исследования с применением ИИ сопряжены также с рисками и неопределённостью. Сокращение человеческого надзора может привести к тому, что исследователи займутся опасными или неэтичными темами. ИИ также может изменить карьеру исследователей, сделав исследовательскую работу более или менее привлекательной, и повлиять на ощущение цели, которое сопровождает стремление людей к знаниям.
Как мы проводили это исследование
Цель нашего исследования — измерить, как именно учёные используют Claude, не раскрывая подробностей их работы. Для этого мы применяем инфраструктуру, обеспечивающую конфиденциальность, чтобы анализировать использование Claude в научной работе на потребительских тарифах. Языковая модель, выступающая здесь в роли «классификатора», анализирует расшифровку каждой сессии и присваивает ей метки из фиксированного набора категорий — например, указывает научную область и исследовательскую задачу — в соответствии с заранее определённой таксономией (таксономия SciNet, разработанная Alamos и Althoff, 2026). Присвоенные метки, например «химия» или «очистка данных», — единственная информация из этих разговоров, которую исследовательская группа сохраняет и анализирует для этого отчёта. Ни один классификатор, использованный в исследовании, не извлекает и не хранит информацию в свободной форме или подробности о содержании исследований, например исследовательские наборы данных, гипотезы, экспериментальные методы, предварительные результаты или неопубликованные статьи. Результаты приводятся только в сводном виде и только для групп, включающих минимальное число отдельных аккаунтов. Все классификаторы, использованные в исследовании, перечислены в приложении.
Наши измерения состоят из двух этапов. Сначала классификатор определяет, связана ли расшифровка сессии с научной работой. Затем второй классификатор относит каждую такую расшифровку к области, подобласти и задаче из таксономии SciNet. SciNet включает 7 262 задачи, охватывающие 34 области и 318 подобластей. Некоторые задачи из таксономии, например подготовка рукописей, универсальны для всех областей. Другие относятся к отдельным областям или подобластям. Например, в таксономии задача предсказания спектров оптического поглощения и излучения относится исключительно к материаловедению. В совокупности эти задачи охватывают весь процесс получения новых научных результатов.
Основная выборка включает 207 049 сессий на потребительских тарифах за период со 2 августа по 30 сентября 2026 года, которым были присвоены научная область и исследовательская задача: 128 914 сессий в Chat и Cowork — двух универсальных интерфейсах для общения и интеллектуальной работы, далее обозначаемых как «Claude», — и 78 135 сессий в Claude Code, агентном инструменте для программирования, который напрямую работает с файлами пользователя, пишет и запускает код. Мы также изучаем дополнительную выборку сессий в Claude Science. Подробное описание формирования выборки см. в приложении.
Сочетание данных об использовании со структурированной таксономией исследовательских задач позволяет нам изучить, какие области применяют Claude и на каких этапах исследовательского процесса. Это исследование вносит вклад в растущий массив работ, посвящённых измерению внедрения технологий ИИ для научных открытий (Kobak et al., 2025; Liang et al., 2025; Hao et al., 2026; Codreanu et al., 2026).
Как использование Claude различается в разных научных областях
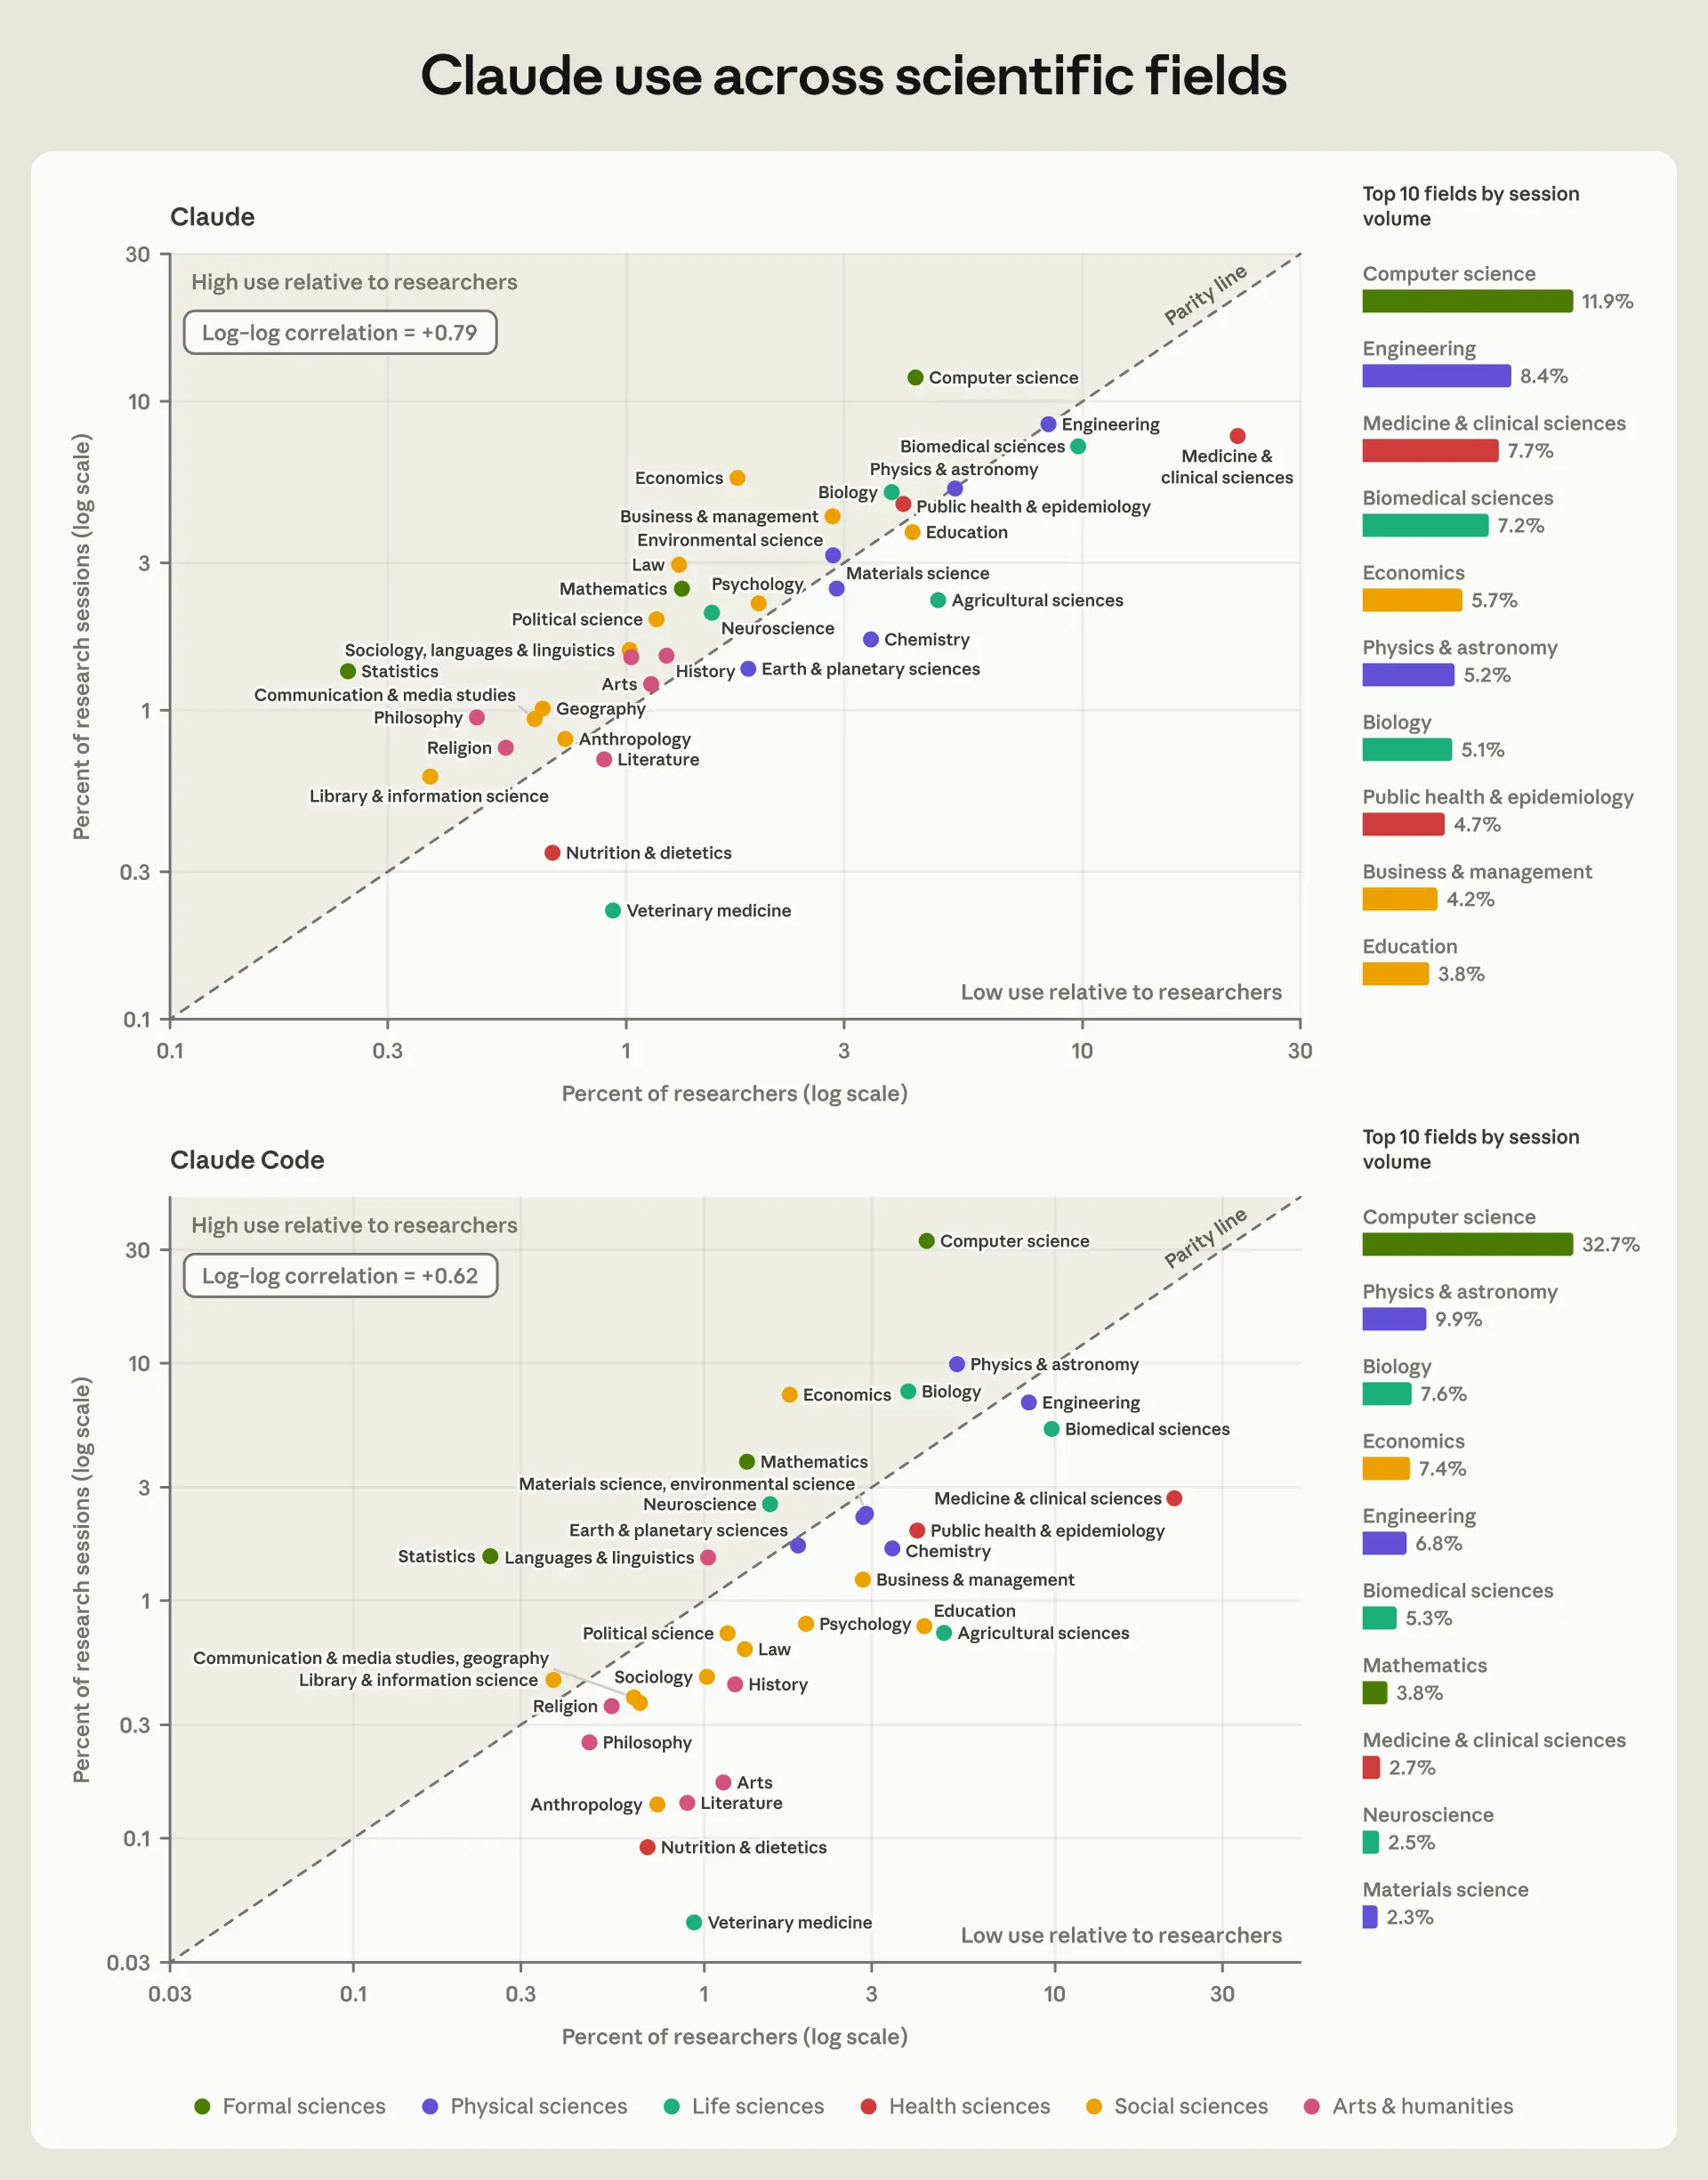
Начнём с описания различий в использовании Claude между научными областями. На рисунке 1 доля сессий в каждой области сопоставляется с долей мировых исследователей, работающих в этой области, что позволяет оценить относительный уровень использования по научным областям.1 В Claude три крупнейшие области по доле сессий — информатика (11,9%), инженерное дело (8,4%) и медицина (7,7%); все они также входят в число крупнейших областей по числу исследователей в мире.2 В целом в областях с большей долей исследователей обычно приходится и большая доля сессий в Claude (логарифмическая корреляция составляет 0,79).
Однако число исследователей само по себе не объясняет интенсивность использования Claude в каждой области. На рисунке 1 области выше линии под углом 45 градусов показывают более высокий уровень использования относительно своего размера, а области ниже линии — более низкий. Особенно высок относительный уровень использования в формальных науках, включая информатику, математику и статистику. Он также высок в социальных науках. Напротив, в физических науках, например химии, где работа часто проходит в лаборатории, относительный уровень использования, как правило, ниже. То же относится к медицине — третьей по числу сессий области, где исследователи проводят много времени с пациентами.
В Claude Code связь использования с размером области выражена слабее (логарифмическая корреляция с числом исследователей составляет 0,62), а само использование сосредоточено в более количественных областях. Хотя на информатику приходится лишь 4,3% исследователей мира, она одна составляет 32,7% сессий Claude Code.3 Другие формальные науки, такие как математика и статистика, также демонстрируют высокий относительный уровень использования. В искусстве и гуманитарных, а также в социальных науках он низок; исключение составляет экономика — сравнительно количественная область.
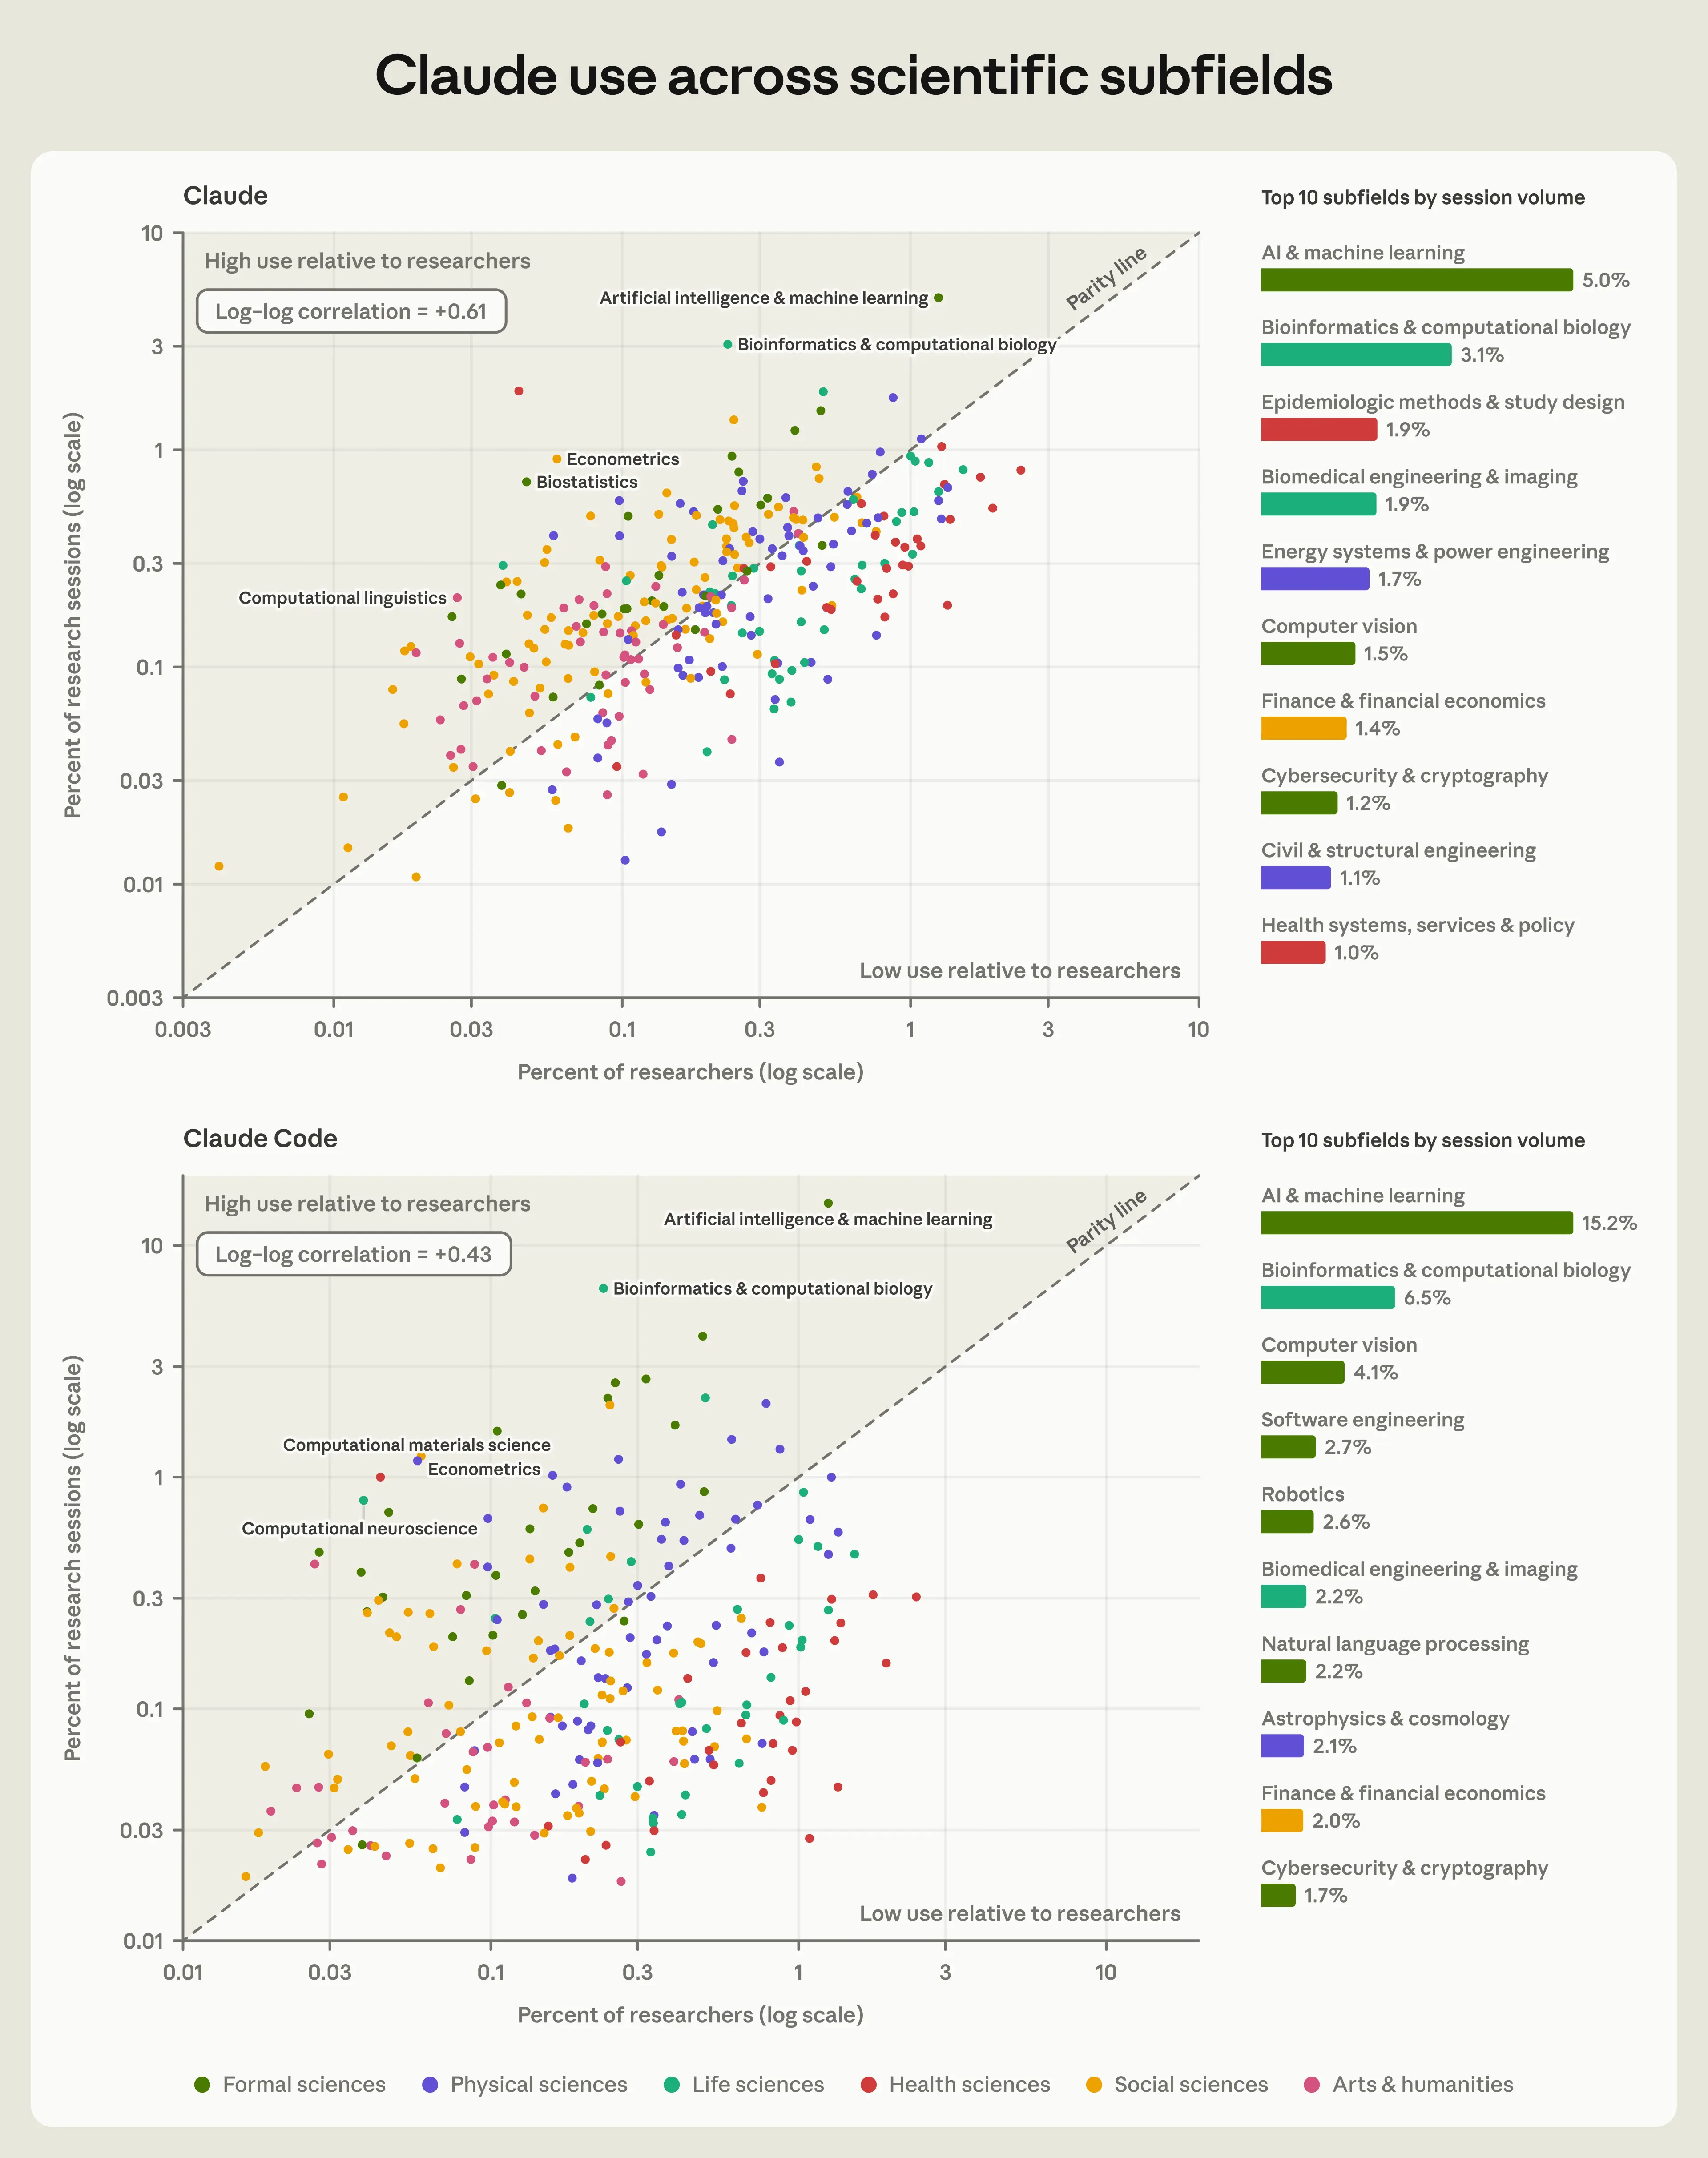
При сравнении использования в 318 подобластях, входящих в эти 34 области, мы наблюдаем похожие закономерности (рисунок 2).4 Более детальный анализ подобластей показывает, что особенно выделяются искусственный интеллект и машинное обучение: на них приходится 5,0% сессий Claude и 15,2% сессий Claude Code, хотя в них работают лишь 1,2% исследователей мира. В целом вычислительные подобласти относятся к числу наиболее активных пользователей независимо от широкой научной сферы. К ним относятся вычислительная биология, вычислительная лингвистика и вычислительная нейронаука. Высокий относительный уровень использования наблюдается и в робототехнике — вероятно, потому, что она в значительной степени опирается на вычислительные методы, несмотря на свою сосредоточенность на физических системах.
Как использование Claude различается в разных исследовательских задачах
Помимо того, чтобы выяснить, какие области используют Claude, мы хотим понять, для чего учёные его применяют. Исследовательская работа включает множество разных задач: от выдвижения гипотез и анализа данных до изложения результатов в научной статье. Чтобы точнее определить, как Claude помогает научным открытиям, мы изучаем различия в его использовании для выполнения этих задач. Для этого мы относим каждую сессию к одной из 7 262 задач SciNet. Некоторые задачи, например подготовка рукописей, универсальны для всех областей; другие относятся к отдельным областям или подобластям. Так, задача проведения анализа дифференциальной экспрессии генов для сравнения подтипов опухолей связана с биологией рака. Таксономия различает исследовательские задачи, которые учёные выполняют для получения новых научных результатов, и неисследовательские задачи, такие как преподавание, экспертная оценка и работа на благо кафедры или научной области.5 Мы ограничиваем анализ исследовательскими задачами, относящимися к восьми категориям: (1) анализ данных, (2) написание текстов и коммуникация, (3) сбор данных, (4) чтение и получение знаний, (5) теоретический анализ, (6) проектирование и разработка (программного обеспечения, материалов и творческих работ), (7) генерация идей и гипотез и (8) прочее, например административная работа, связанная с исследованиями.
Для каждой категории задач мы отдельно рассчитываем её долю в сессиях Claude и Claude Code. Чтобы оценить, высок или низок уровень использования в той или иной категории, мы учитываем, какую долю своего времени исследователи обычно на неё тратят, согласно оценкам SciNet. Эти оценки времени основаны на классификаторе LLM и проверены с помощью протоколов лабораторных исследований, в которых фиксируется время исследователей на каждую задачу, а также анализа частоты задач в тысячах научных статей (см. приложение). Это даёт нам ориентир для оценки того, соответствует ли доля использования Claude в разных категориях задач тому, сколько времени исследователи тратят на эти задачи, или отличается от неё.
Использование по категориям задач. Задачи по анализу данных лидируют по абсолютному уровню использования и представлены чаще, чем можно было бы ожидать, исходя из времени исследователей. На анализ данных приходится 33,7% сессий в Claude и 48,1% в Claude Code против 27,6% времени исследователей. Высокий уровень использования наблюдается и для задач, связанных с написанием текстов и коммуникацией, особенно в Claude (32,0% против 16,0% времени исследователей).6 Задачи по сбору данных используются относительно редко: на них приходится 28,6% времени исследователей, но лишь 11,5% сессий в Claude и 11,9% в Claude Code. Особенно заметно представлены в меньшей степени задачи сбора данных, сопряжённые с физическими ограничениями, например сбор клинических или биохимических данных. Задачи по сбору данных, которые в большей степени опираются на цифровые процессы, — например, поиск архивных документов или текстов, — представлены в меньшей степени не так заметно, а задачи, связанные исключительно с цифровым сбором данных, например сбором информации в интернете, могут быть представлены чаще. Низкий уровень использования характерен и для задач по генерации идей и гипотез: на них приходится 4,2% сессий Claude и 2,1% сессий Claude Code против 7,1% времени исследователей.
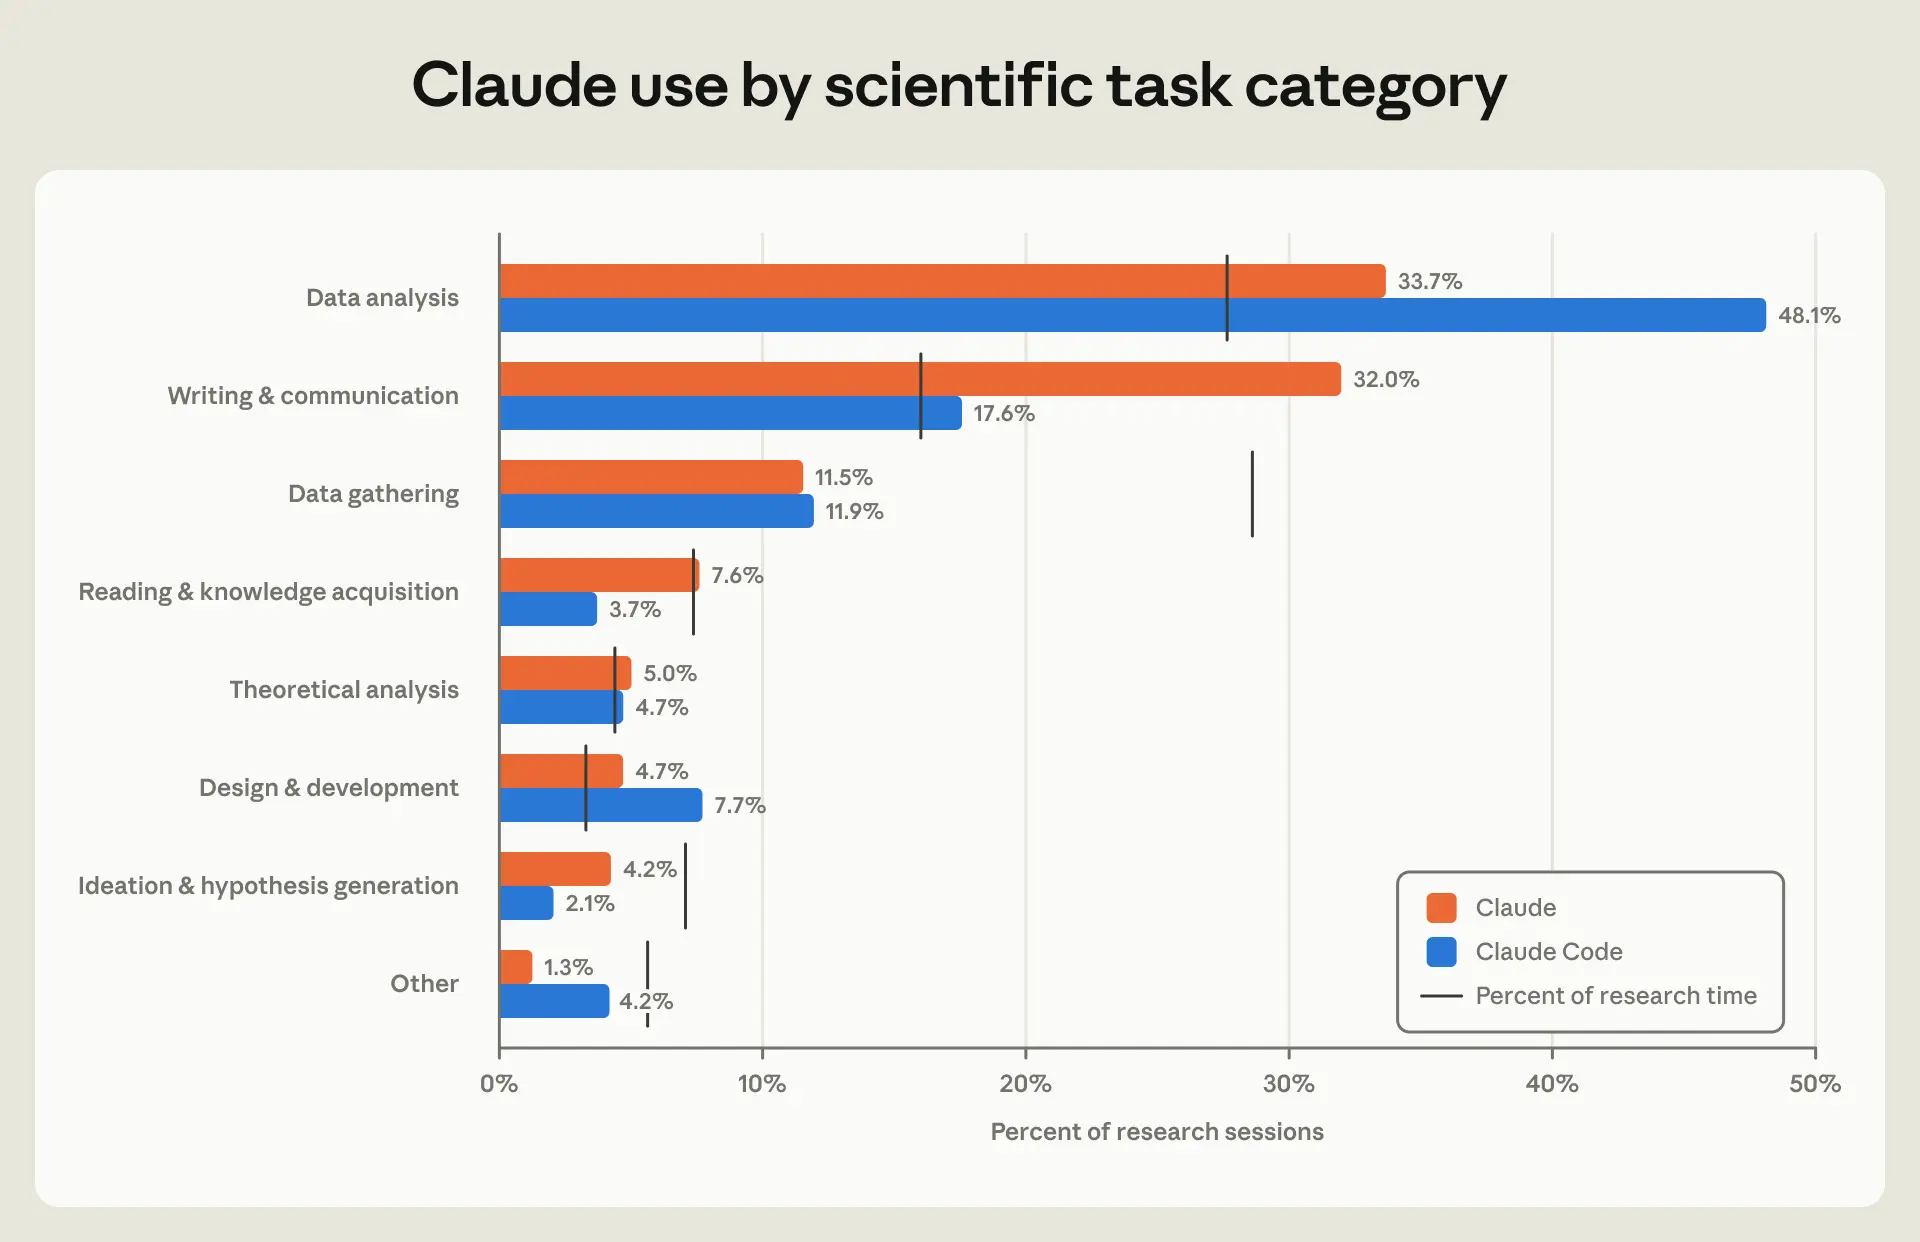
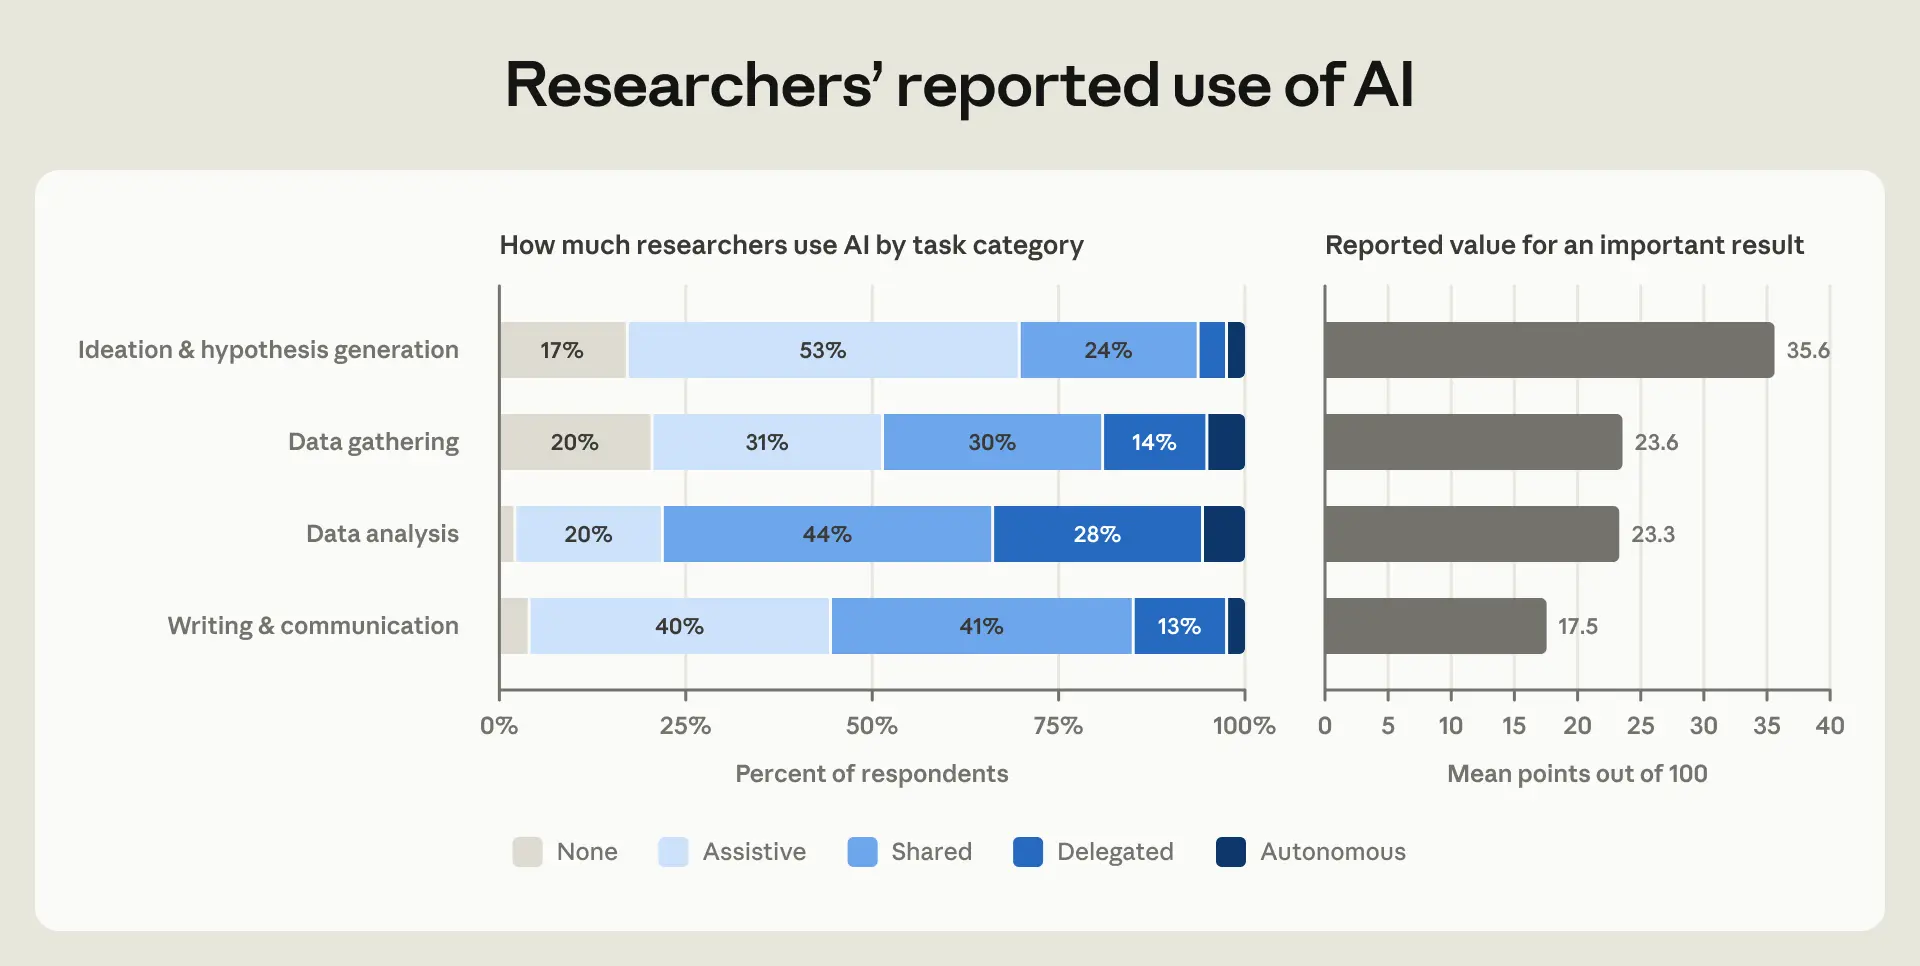
Сопоставление наблюдаемого использования с данными опроса. Помимо анализа сессий Claude и Claude Code, мы провели опрос 528 учёных. Их самооценка использования ИИ соответствует закономерностям, выявленным нами при анализе сессий. В выборку вошли преимущественно исследователи в области наук о жизни и здравоохранения, активно внедряющие ИИ.7 Как и в данных об использовании Claude на рисунке 3, участники опроса чаще всего сообщают об использовании ИИ для анализа данных, написания текстов и коммуникации, и реже — для генерации идей и гипотез и сбора данных. Участники также сообщают, что чаще делят с ИИ или передают ему задачи по анализу данных, написанию текстов и коммуникации (рисунок 4).
В опросе также спрашивали, какие категории задач важнее всего для получения значимых научных результатов. Респонденты поставили на первое место генерацию идей и гипотез, а на второе — сбор данных. Примечательно, что эти категории представлены в меньшей степени как в самооценках использования ИИ, так и в данных о сессиях Claude. Причины такого положения, вероятно, различаются. Значительная часть сбора данных связана с физической работой, тогда как генерация идей — нет. При работе над идеями учёные могут предпочитать генерировать их самостоятельно или считать возможности ИИ ограниченными. Кроме того, наши данные могут недооценивать использование ИИ для генерации идей, поскольку эта задача часто встроена в другие исследовательские задачи, и её трудно классифицировать. Но возможно также, что ИИ действительно хуже справляется с генерацией идей высокого уровня — например, с выбором исследовательского вопроса и разработкой исследования для поиска ответа.
Использование Claude Science в биологии и биомедицинских науках. Claude и Claude Code — универсальные интерфейсы, однако специализированные инструменты ИИ для научной работы становятся всё доступнее. Чтобы выяснить, помогают ли такие инструменты выполнять более специализированные и сложные исследования, мы используем нашу инфраструктуру конфиденциального анализа и сравниваем биологические и биомедицинские задачи в Claude Science с задачами в Claude и Claude Code.
Claude Science связывает Claude с множеством исследовательских инструментов и баз данных, которые в противном случае разрознены, и помогает объединять и ускорять научные рабочие процессы. Чтобы сочетать разные инструменты и базы данных в исследованиях, учёным часто приходится работать на разных платформах, каждая из которых имеет собственные структуры данных или языки запросов. Например, биологам, изучающим, могут ли существующие лекарства воздействовать на определённый белок, обычно приходится обращаться к отдельным базам данных о функции и структуре этого белка, соединениях, которые уже проверяли на нём, а также связанных клинических испытаниях лекарств и научных статьях. Claude Science объединяет все эти этапы в один рабочий процесс.
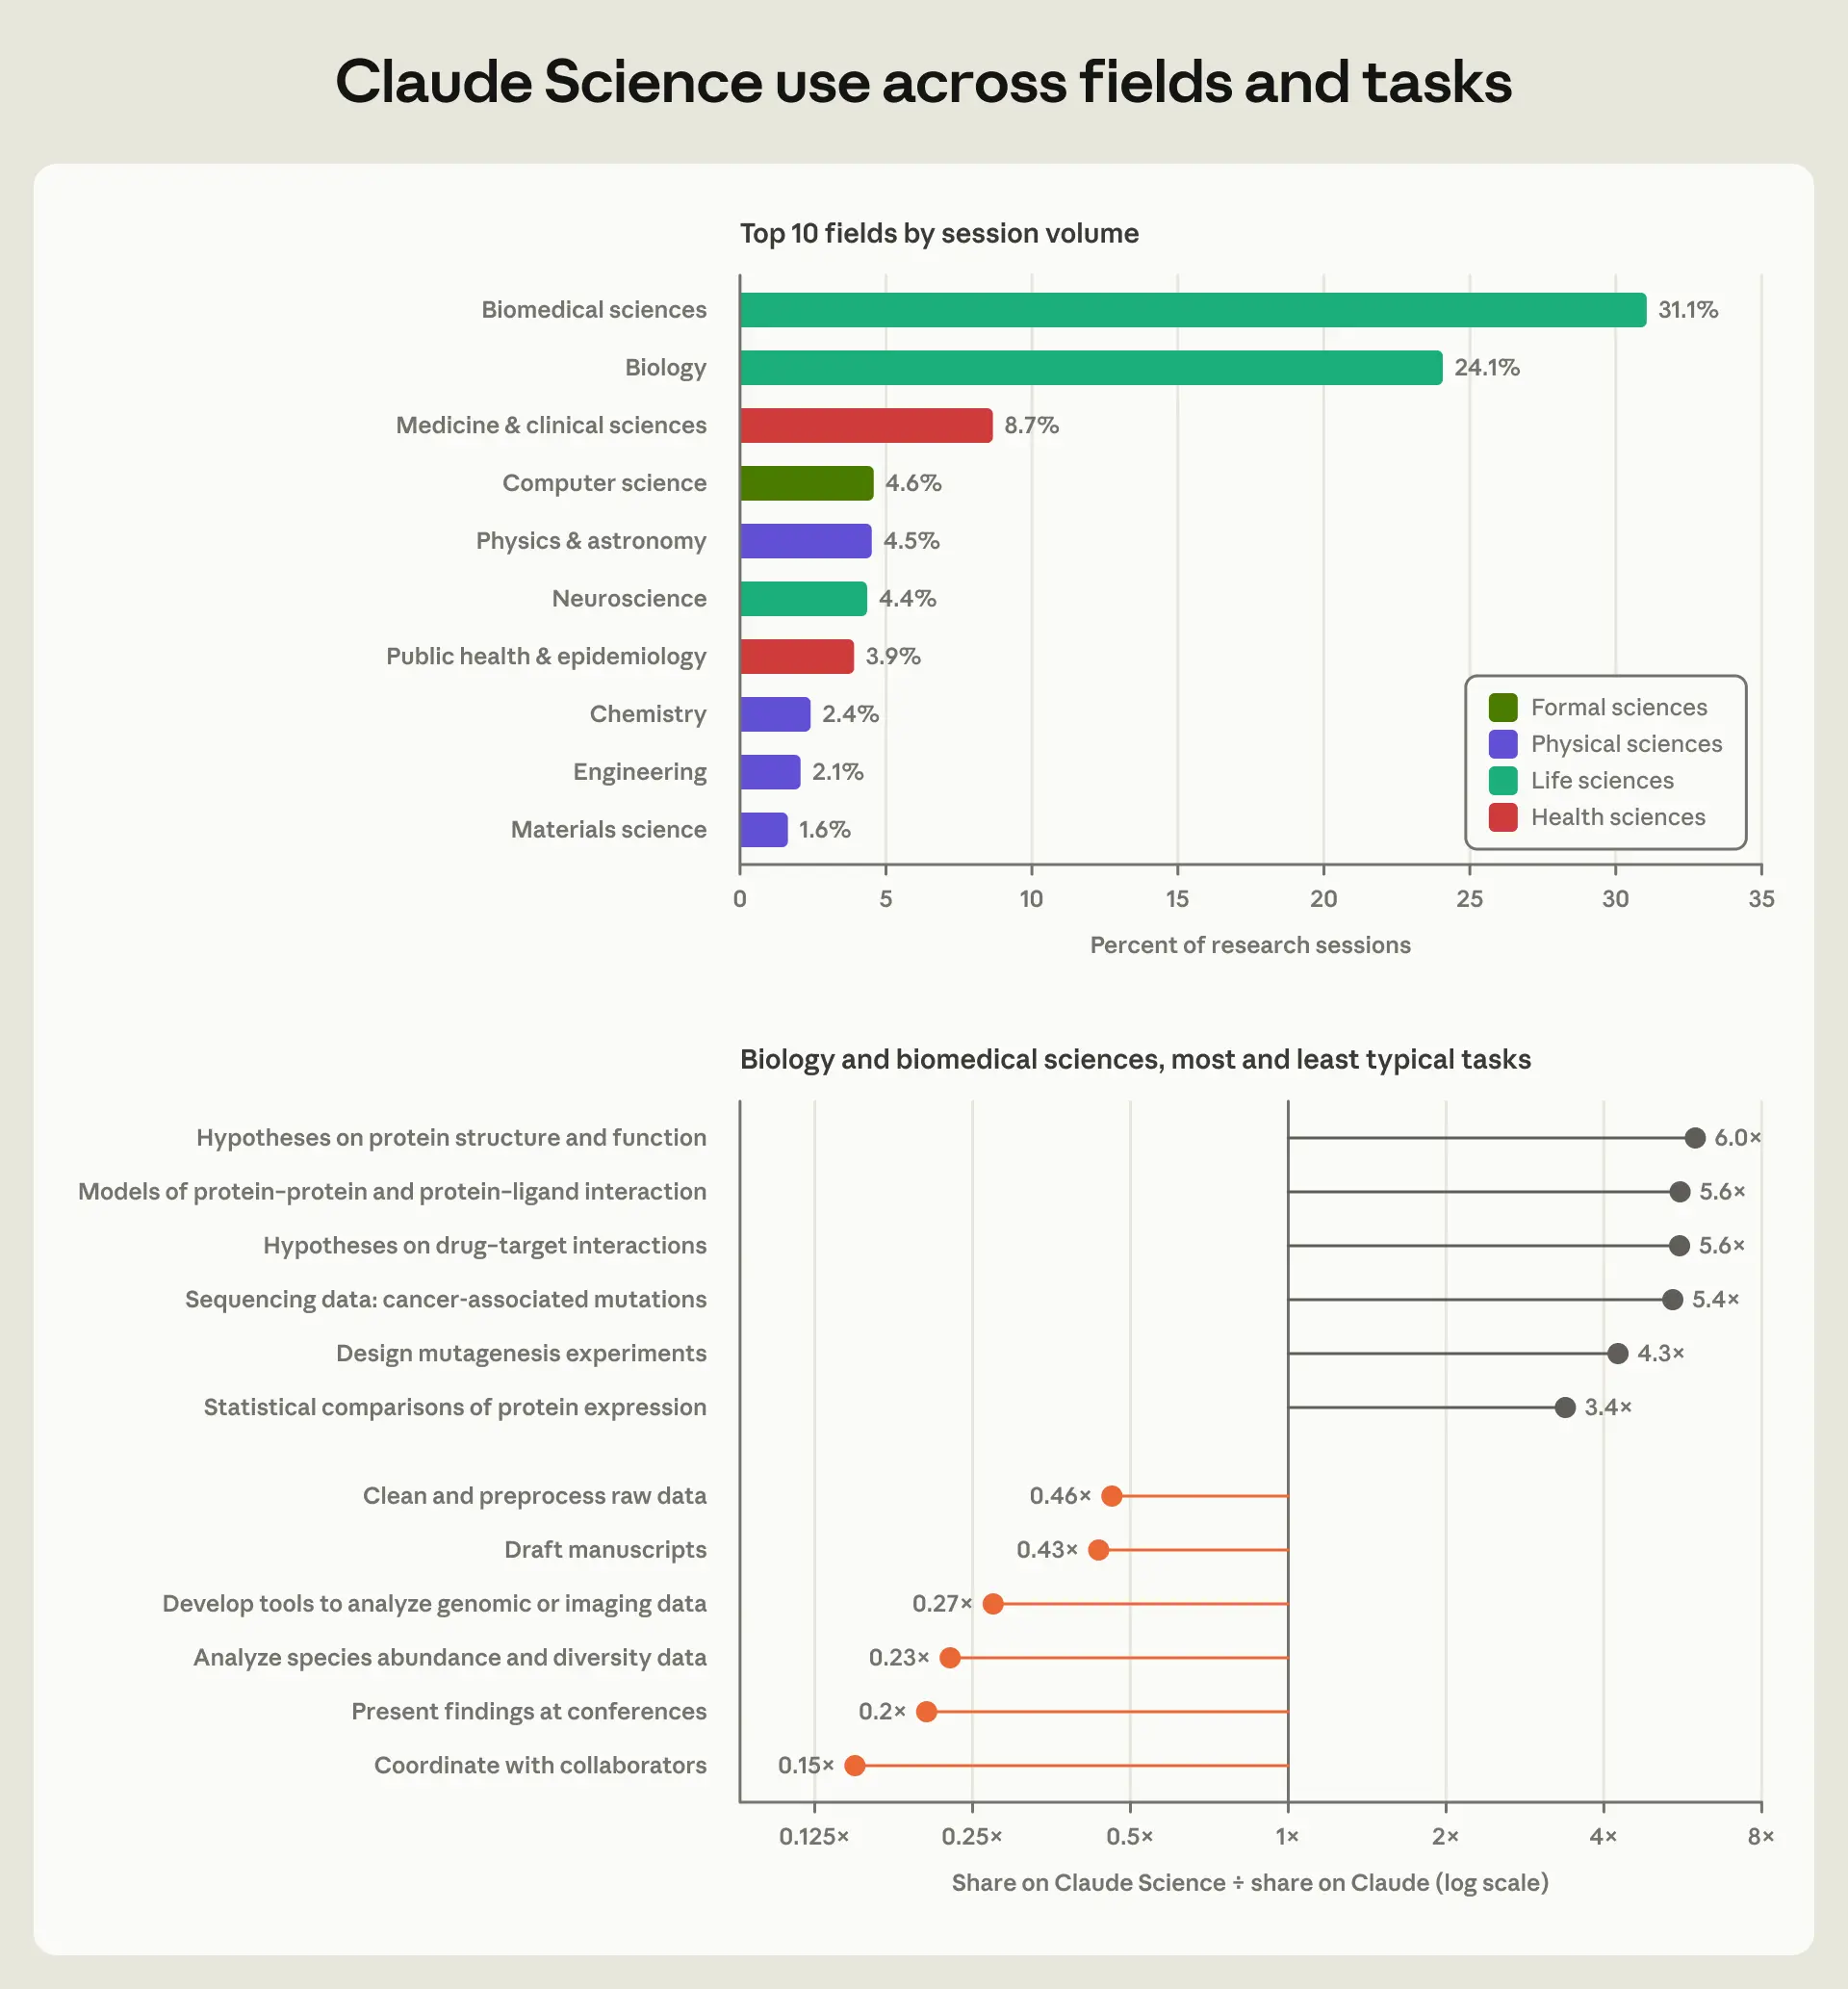
Использование Claude Science сосредоточено в науках о жизни. Две ведущие области — биомедицинские науки и биология; вместе на них приходится более 50% сессий. В рамках этих областей мы оцениваем, какие задачи представлены чаще всего по сравнению с задачами, выполняемыми в Claude.
Мы обнаружили, что исследователи используют Claude Science для более специализированных задач, чем Claude (рисунок 5). Например, задача «Предложить механистические модели взаимодействий белок — белок или белок — лиганд» в Claude Science встречается в 5,6 раза чаще, чем в Claude. Эта задача заключается в объяснении на уровне отдельных молекулярных контактов того, как белок связывается с другим белком или небольшой молекулой, например лекарством. Claude Science хорошо подходит для этой задачи: он может собирать сведения о структурах белков и связывании из нескольких подключённых баз данных и объединять их в проверяемую модель взаимодействия. Напротив, Claude Science относительно реже используют для общих задач, таких как подготовка рукописей или координация работы с коллегами. Кроме того, мы обнаружили, что на генерацию идей и гипотез приходится 8% сессий в Claude Science — примерно столько же, сколько времени исследователи тратят на эти задачи. Это говорит о том, что специализированные научные инструменты ИИ могут помогать выполнять более сложную и творческую работу.
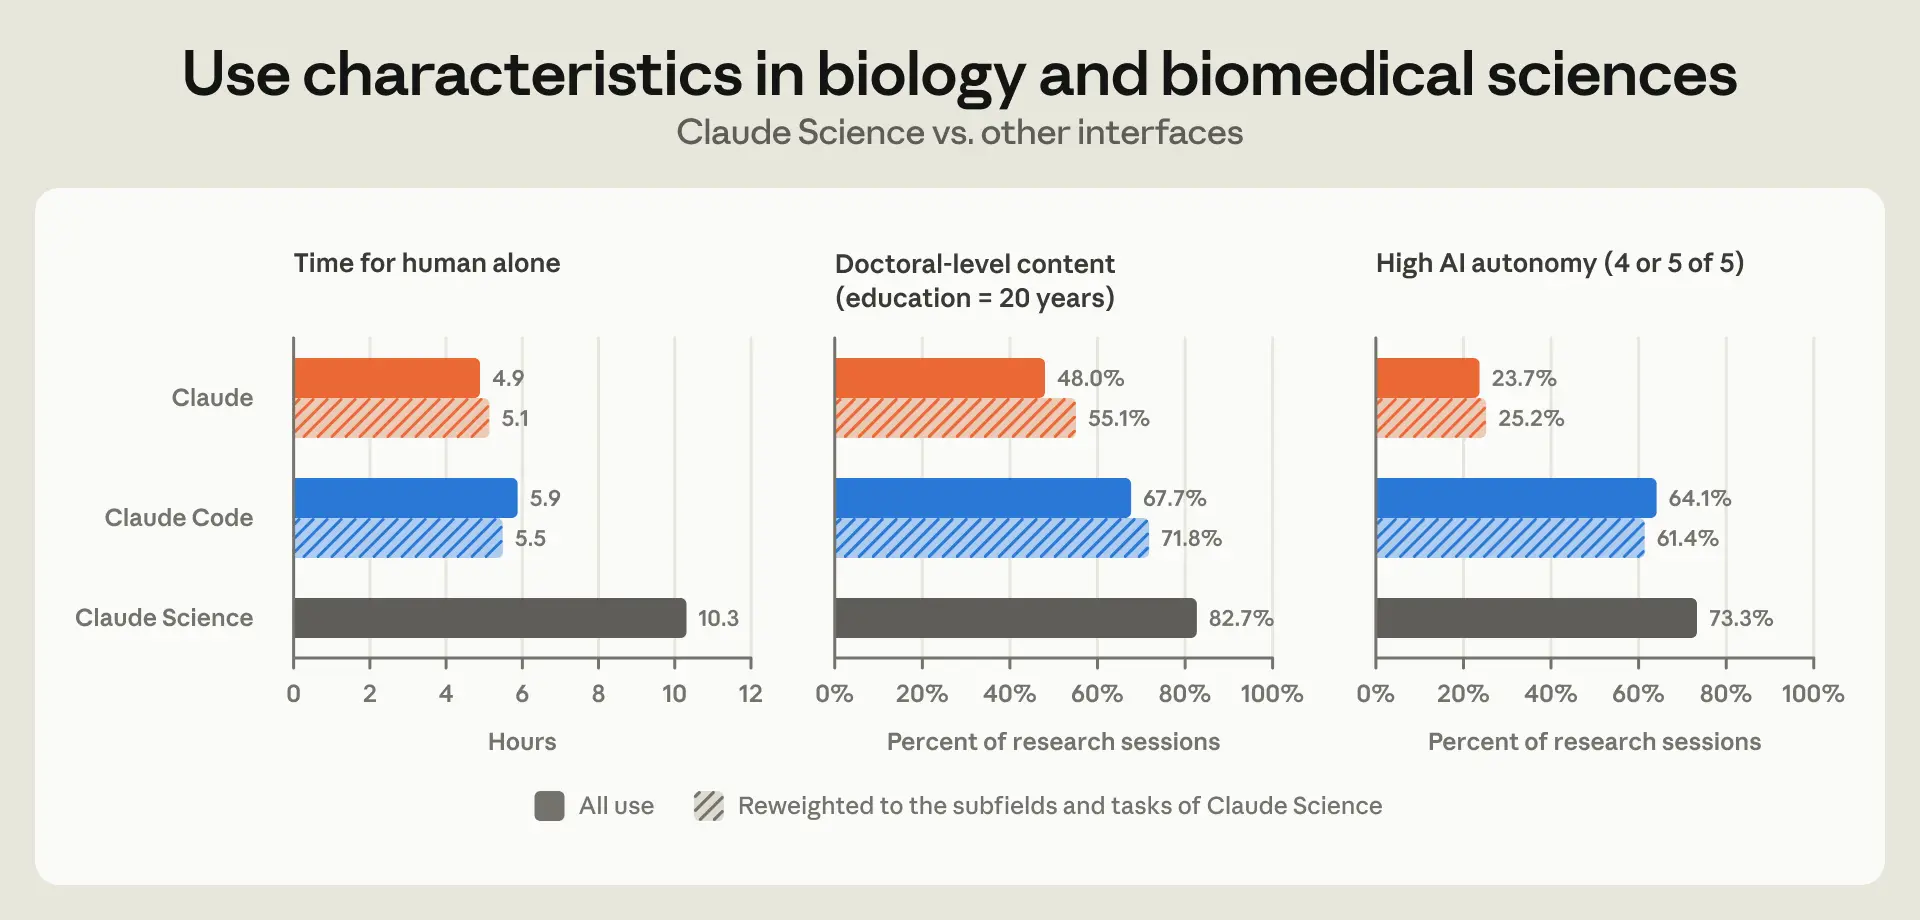
Сосредоточившись на биомедицинских науках и биологии и применив показатели из нашей системы базовых экономических параметров, представленной в предыдущей работе (Appel et al., 2026), мы обнаружили, что задачи в Claude Science длятся дольше, отличаются большей сложностью и выполняются автономнее, чем задачи в Claude и Claude Code (рисунок 6). Это согласуется с тем, что специализированные инструменты ИИ используют для решения более сложных задач.8 Без ИИ выполнение задач из сессий Claude Science потребовало бы почти вдвое больше человеческого времени, чем задач в Claude и Claude Code. Содержание этих сессий также сложнее. По оценкам, более 80% задач в Claude Science требуют подготовки на уровне докторантуры (20 лет обучения), тогда как в других интерфейсах этот показатель составляет около 50–70%. Более 70% сессий Claude Science выполняются при высокой степени автономности ИИ — значительно чаще, чем в Claude (23,7%), и несколько чаще, чем в Claude Code (64,1%).
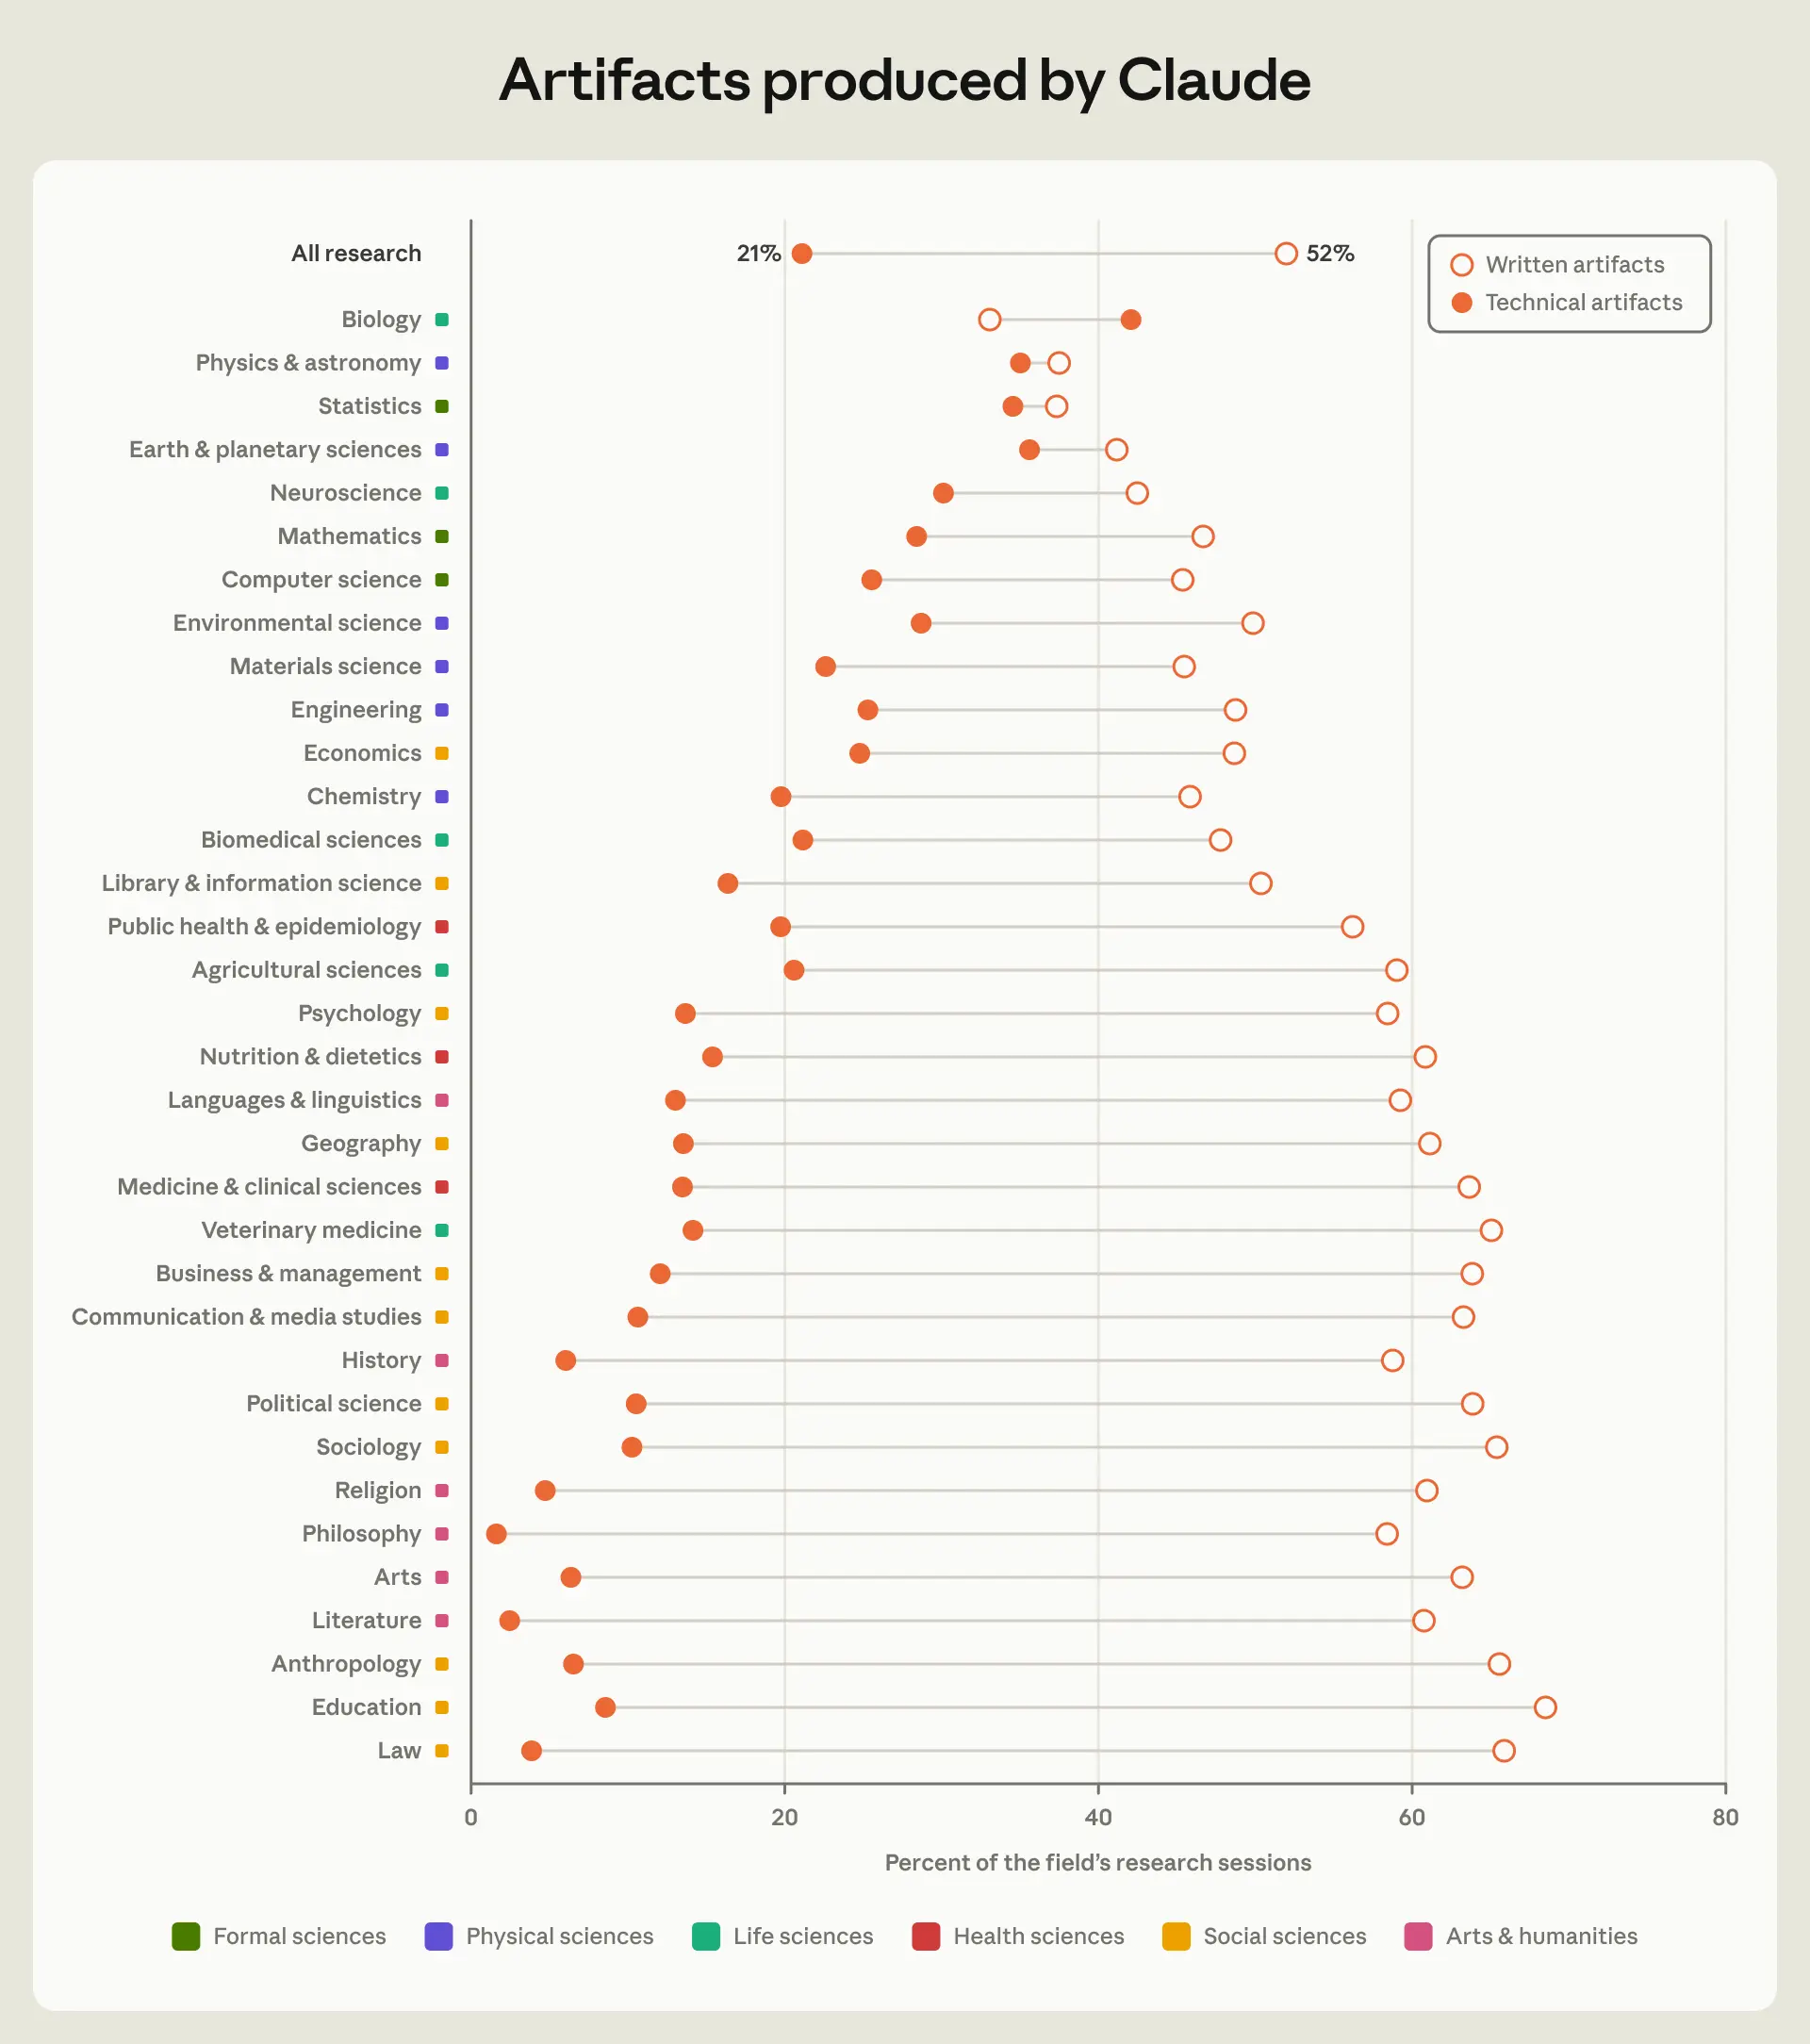
Результаты использования Claude. Наконец, результаты работы с Claude заметно различаются в разных областях (рисунок 7).9 Письменные материалы — документы, отчёты или научные статьи — чаще встречаются в социальных и гуманитарных науках, чем в естественных и формальных. И наоборот, технические результаты, такие как код, результаты работы программного обеспечения и данные, чаще встречаются в естественных и формальных науках. По типам получаемых результатов науки о здоровье в целом больше похожи на социальные науки. В Claude Code технические результаты встречаются примерно вдвое чаще, чем в Claude, но общая закономерность по областям остаётся схожей (см. приложение).
Как использование соотносится с возможностями
Соответствует ли использование ИИ его возможностям? Размер области исследований объясняет лишь часть различий в использовании Claude. Например, специалисты по информатике используют Claude значительно чаще, чем можно было бы ожидать исходя из размера этой области, а специалисты по питанию — значительно реже. Аналогично, распределение времени исследователей по задачам не позволяет полностью предсказать, для каких из них они чаще всего используют Claude. На некоторые широкие категории задач, например анализ данных и написание текстов, приходится гораздо большая доля использования, чем доля исследовательского времени, тогда как на другие — например сбор данных, генерацию идей и выдвижение гипотез — гораздо меньшая. Здесь мы проверяем, отражают ли эти различия в использовании реальные возможности ИИ.
Чтобы оценить возможности ИИ применительно к конкретным задачам, мы сначала составили оценки с помощью классификатора на основе большой языковой модели (LLM). Для каждой задачи SciNet приводит список отдельных шагов, которые должен выполнить учёный. Например, одна из задач в химии — очистка реакционных смесей, а один из её шагов — заполнение хроматографической колонки. Классификатору показывают пары шагов из разных разделов таксономии и предлагают определить, какой из них ИИ способен выполнить лучше. Затем мы сводим результаты этих сравнений с помощью модели Брэдли — Терри — той же модели, которая лежит в основе рейтингов Эло, позволяющих ранжировать шахматистов по итогам очных партий. Оценка шага повышается, если он выигрывает сравнения, и снижается, если проигрывает. Затем мы усредняем оценки шагов каждой задачи, чтобы получить оценку на уровне задачи (подробности см. в Приложении). Эту меру мы называем теоретическими возможностями ИИ. Конкретную оценку задачи мы называем её оценкой возможностей ИИ.
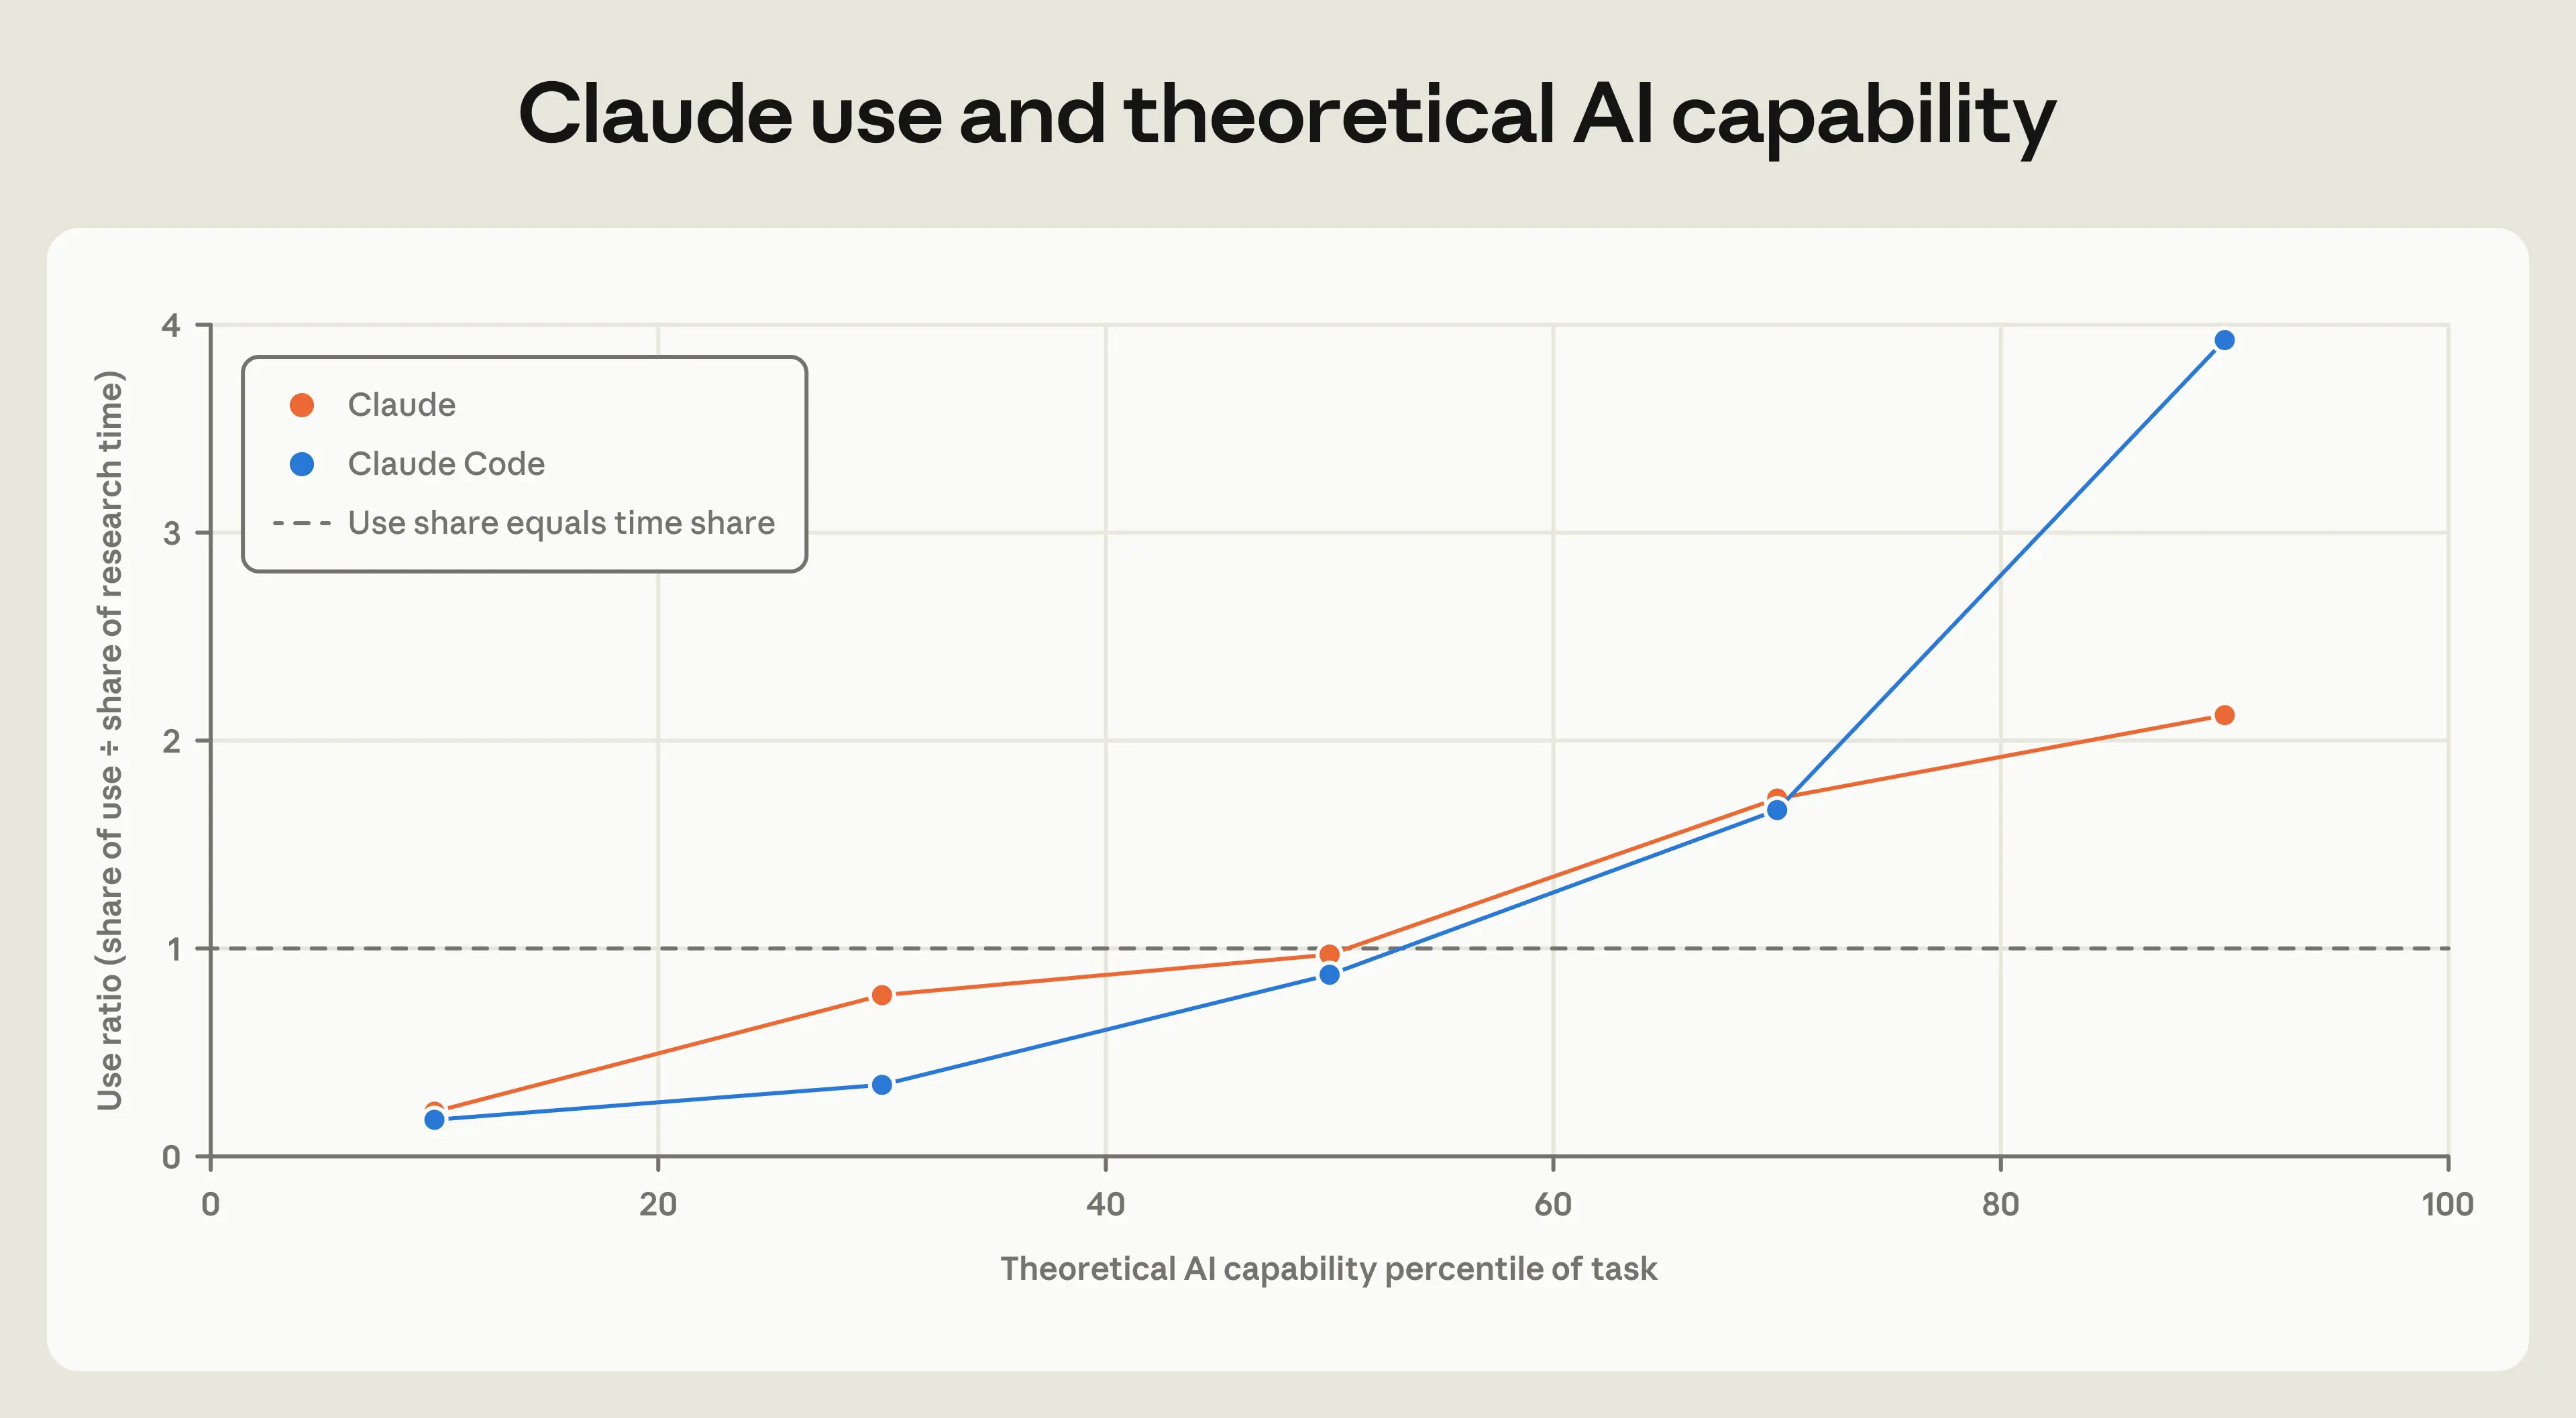
Чтобы сравнить использование Claude в разных задачах, мы оцениваем, чаще или реже его применяют для той или иной задачи относительно времени, которое исследователи на неё тратят. Например, если задача занимает 5% времени исследователей, но на неё приходится 10% сеансов Claude, то использование вдвое превышает ожидаемое — соотношение составляет 2. Соотношение 1 означает, что использование Claude соответствует времени, которое исследователи тратят на задачу. Значение ниже 1 указывает на то, что Claude используют реже, чем можно было бы ожидать исходя из затрат времени исследователей.
На рисунке 8 видно, что это соотношение резко возрастает вместе с оценкой возможностей ИИ для задачи. Для задач из нижних 20% по оценкам возможностей, таких как очистка реакционных смесей и включённое наблюдение, Claude почти не используют. При медианных оценках соотношение составляет примерно 1, то есть использование соответствует времени исследователей. Для задач из верхних 20% по оценкам возможностей, таких как визуализация данных и применение статистических тестов, Claude используют примерно вдвое, а Claude Code — примерно вчетверо чаще, чем можно было бы ожидать исходя из обычных затрат времени исследователей на эти задачи. Эти закономерности позволяют предположить, что использование Claude учёными тесно связано с оценками возможностей ИИ. Более крутой градиент для Claude Code отражает его ориентацию на вычислительные задачи, для которых оценки возможностей выше.
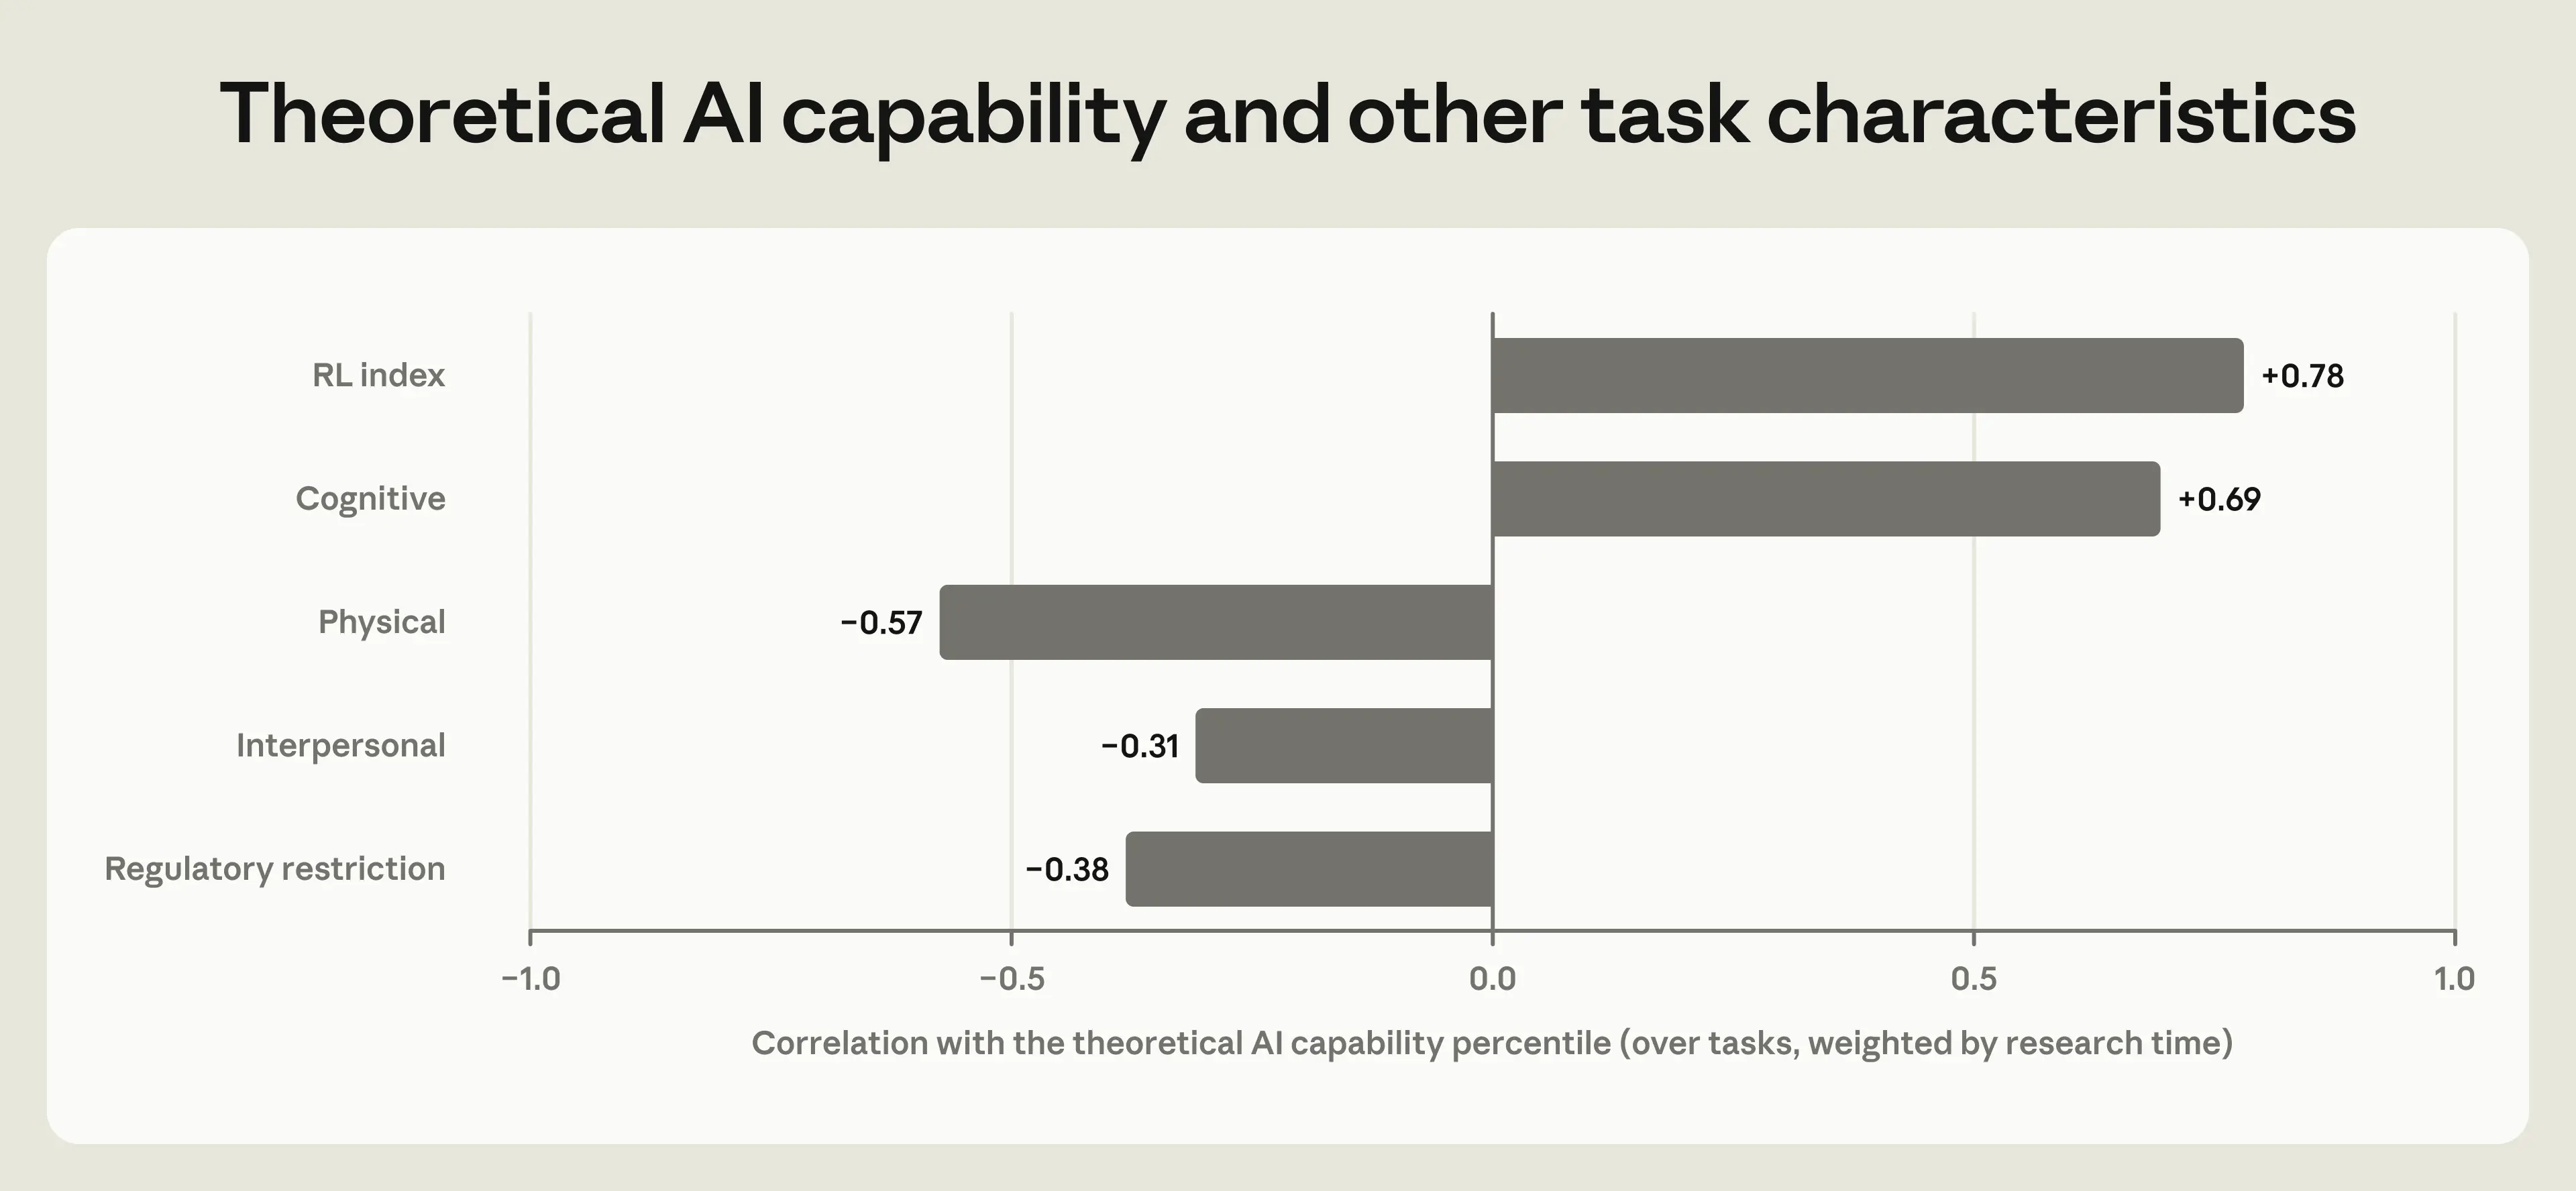
Теоретические возможности ИИ для разных задач могут различаться по многим причинам. Чтобы понять эти различия, мы сопоставили оценки возможностей ИИ для каждой задачи с тремя группами характеристик задач, полученных с помощью LLM: пригодностью для обучения с подкреплением (RL); преобладающим характером работы — когнитивным, межличностным или физическим;, а также наличием нормативных ограничений на использование ИИ (рисунок 9; определения и источники данных см. в Приложении).
Рассмотрим пригодность для RL. При обучении с подкреплением модель ИИ многократно выполняет задачу и получает вознаграждение за успешный результат, благодаря чему учится справляться с этой задачей. Задачи особенно хорошо подходят для RL, если успех легко проверить, если в вычислительной среде можно смоделировать множество примеров и если обратную связь можно получать быстро (Lambert et al. 2024; Guo et al. 2025). Для этих трёх связанных с RL компонентов мы используем показатели SciNet для каждой задачи и сводим их в единый индекс. Оценка возможностей задачи тесно связана с оценкой её индекса RL, рассчитанной отдельно (корреляция — 0,78). Это позволяет предположить, что ИИ лучше всего справляется с теми исследовательскими задачами, для которых проще всего применять RL.
Другие важные характеристики задач связаны с характером работы. Одни исследовательские задачи по своей сути когнитивны, другие требуют физических действий или межличностного взаимодействия. Физические задачи в целом недоступны машинам, работающим исключительно с когнитивными задачами. Использование ИИ также могут ограничивать нормативные требования. Оценки возможностей ИИ выше для задач, характеризующихся когнитивной работой (корреляция — 0,69). Напротив, у исследовательских задач, связанных с большим объёмом физической работы, оценки возможностей ИИ ниже (−0,57). Оценки также, как правило, ниже для исследовательской деятельности, предполагающей межличностное взаимодействие (−0,31) или подпадающей под нормативные ограничения на использование ИИ (−0,38).
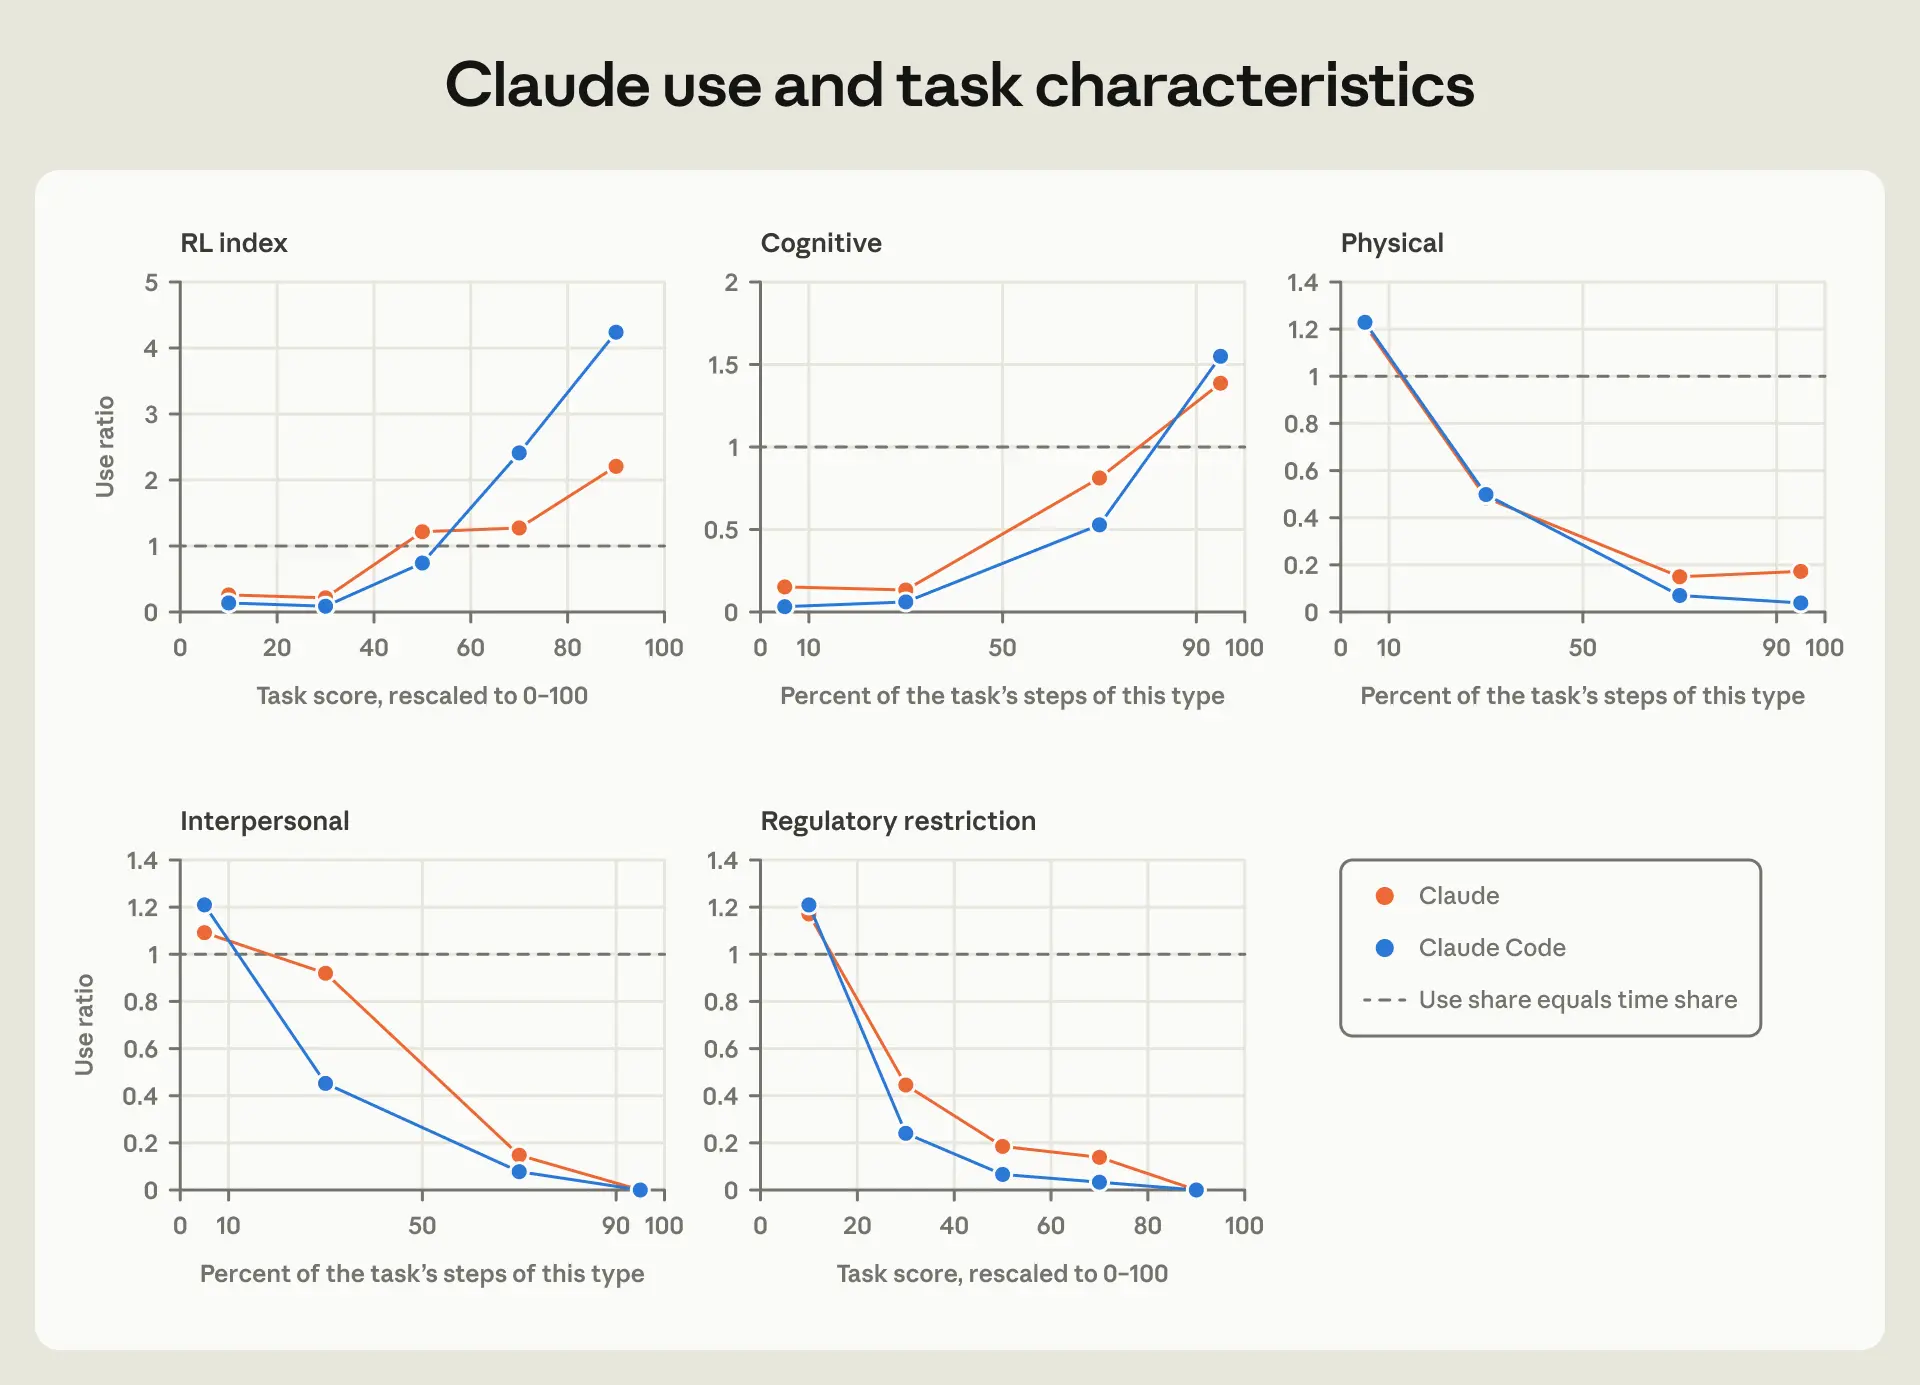
Те же характеристики задач позволяют предсказать, насколько активно исследователи используют Claude для каждой из них (рисунок 10). Для задач из нижней пятой части по пригодности к RL Claude почти не используют. Для задач из верхней пятой части его используют непропорционально часто относительно времени, которое исследователи на них тратят: вдвое чаще — Claude и вчетверо — Claude Code. Это похоже на общую связь между использованием Claude и оценками возможностей ИИ: на верхние 20% задач также приходится в два-четыре раза больше использования, чем ожидалось.
Claude также непропорционально часто используют для преимущественно когнитивных задач. Напротив, для физических задач и задач, предполагающих межличностное взаимодействие, его используют редко. Реже Claude применяют и для задач, где нормативные барьеры ограничивают помощь ИИ. В целом во всём спектре узкоспециализированных исследовательских задач показатели использования и возможностей тесно связаны.
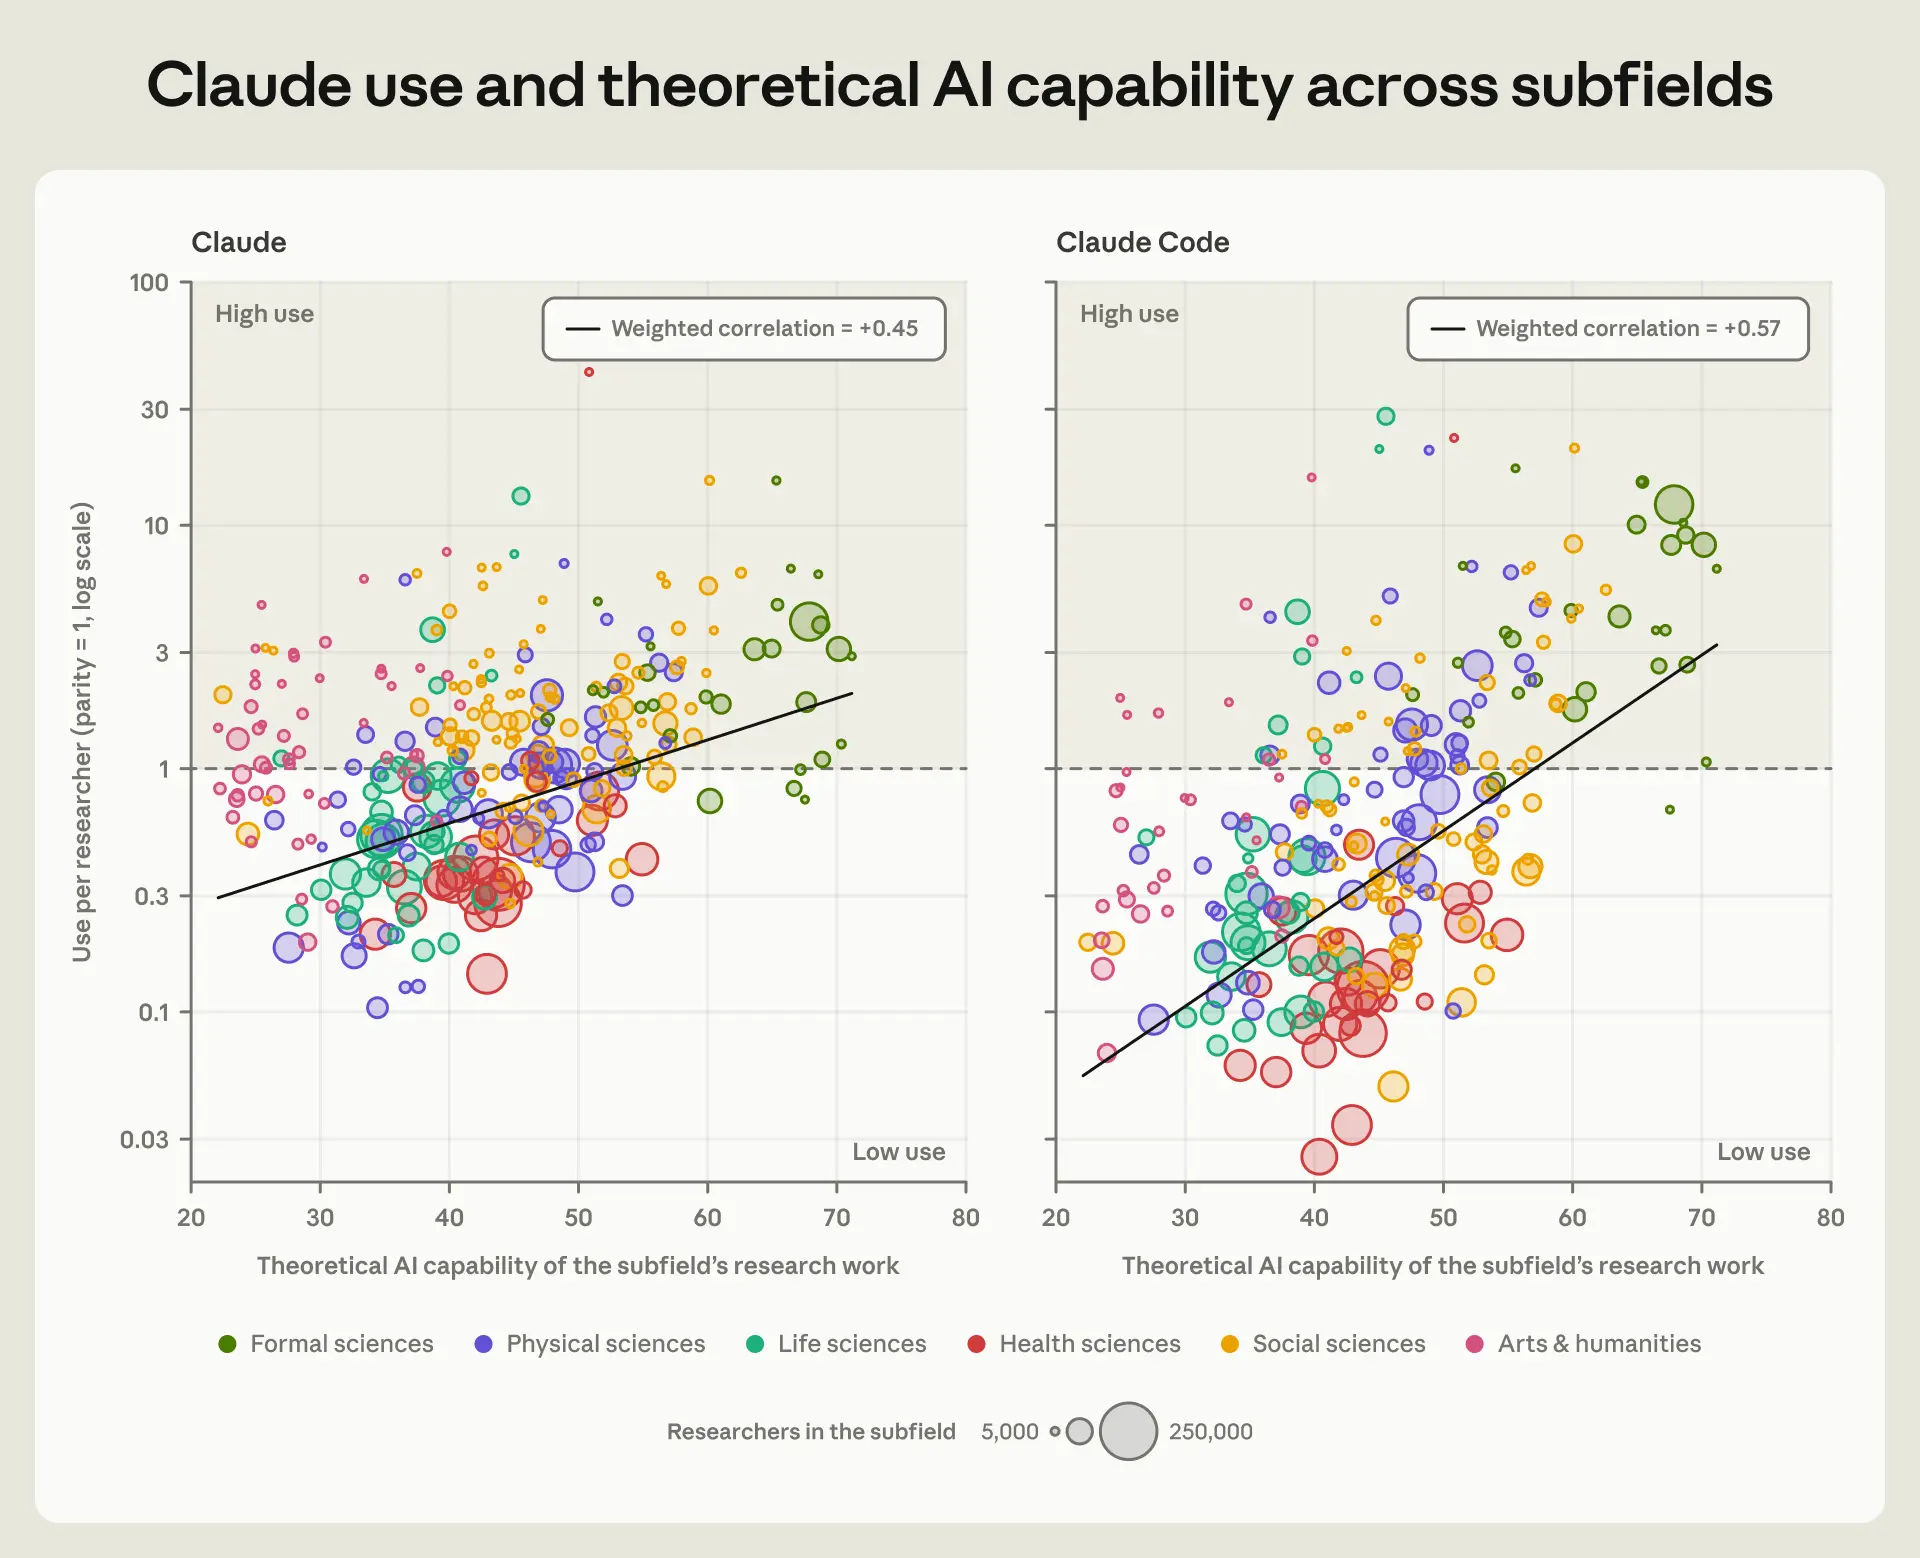
В разных научных областях используют разные сочетания исследовательских задач. Помогает ли корреляция между использованием и оценками возможностей для узкоспециализированных исследовательских задач объяснить, почему одни области используют Claude чаще других? Наши данные показывают, что да: использование Claude на одного исследователя в той или иной подобласти, как правило, растёт вместе со средней оценкой возможностей ИИ для её задач (корреляция — 0,45 для Claude и 0,57 для Claude Code), как показано на рисунке 11.
Между областями также наблюдаются значительные различия, что говорит о влиянии на использование Claude факторов помимо возможностей ИИ. Исследователи в области наук о здоровье используют Claude относительно редко, учитывая оценки возможностей ИИ для их задач. Возможно, регулирование медицинских данных и исследований ограничивает применение ИИ или затрудняет его интеграцию. Исследователи в формальных и социальных науках, а также в искусстве и гуманитарных дисциплинах используют Claude чаще, чем можно было бы ожидать исходя из оценок возможностей ИИ. Значительная часть работы в этих областях выполняется с помощью текста и кода, что, вероятно, облегчает внедрение инструментов ИИ. Использование Claude в физических науках и науках о жизни в целом теснее соответствует оценкам возможностей ИИ, хотя отдельные подобласти могут отклоняться от этой закономерности.
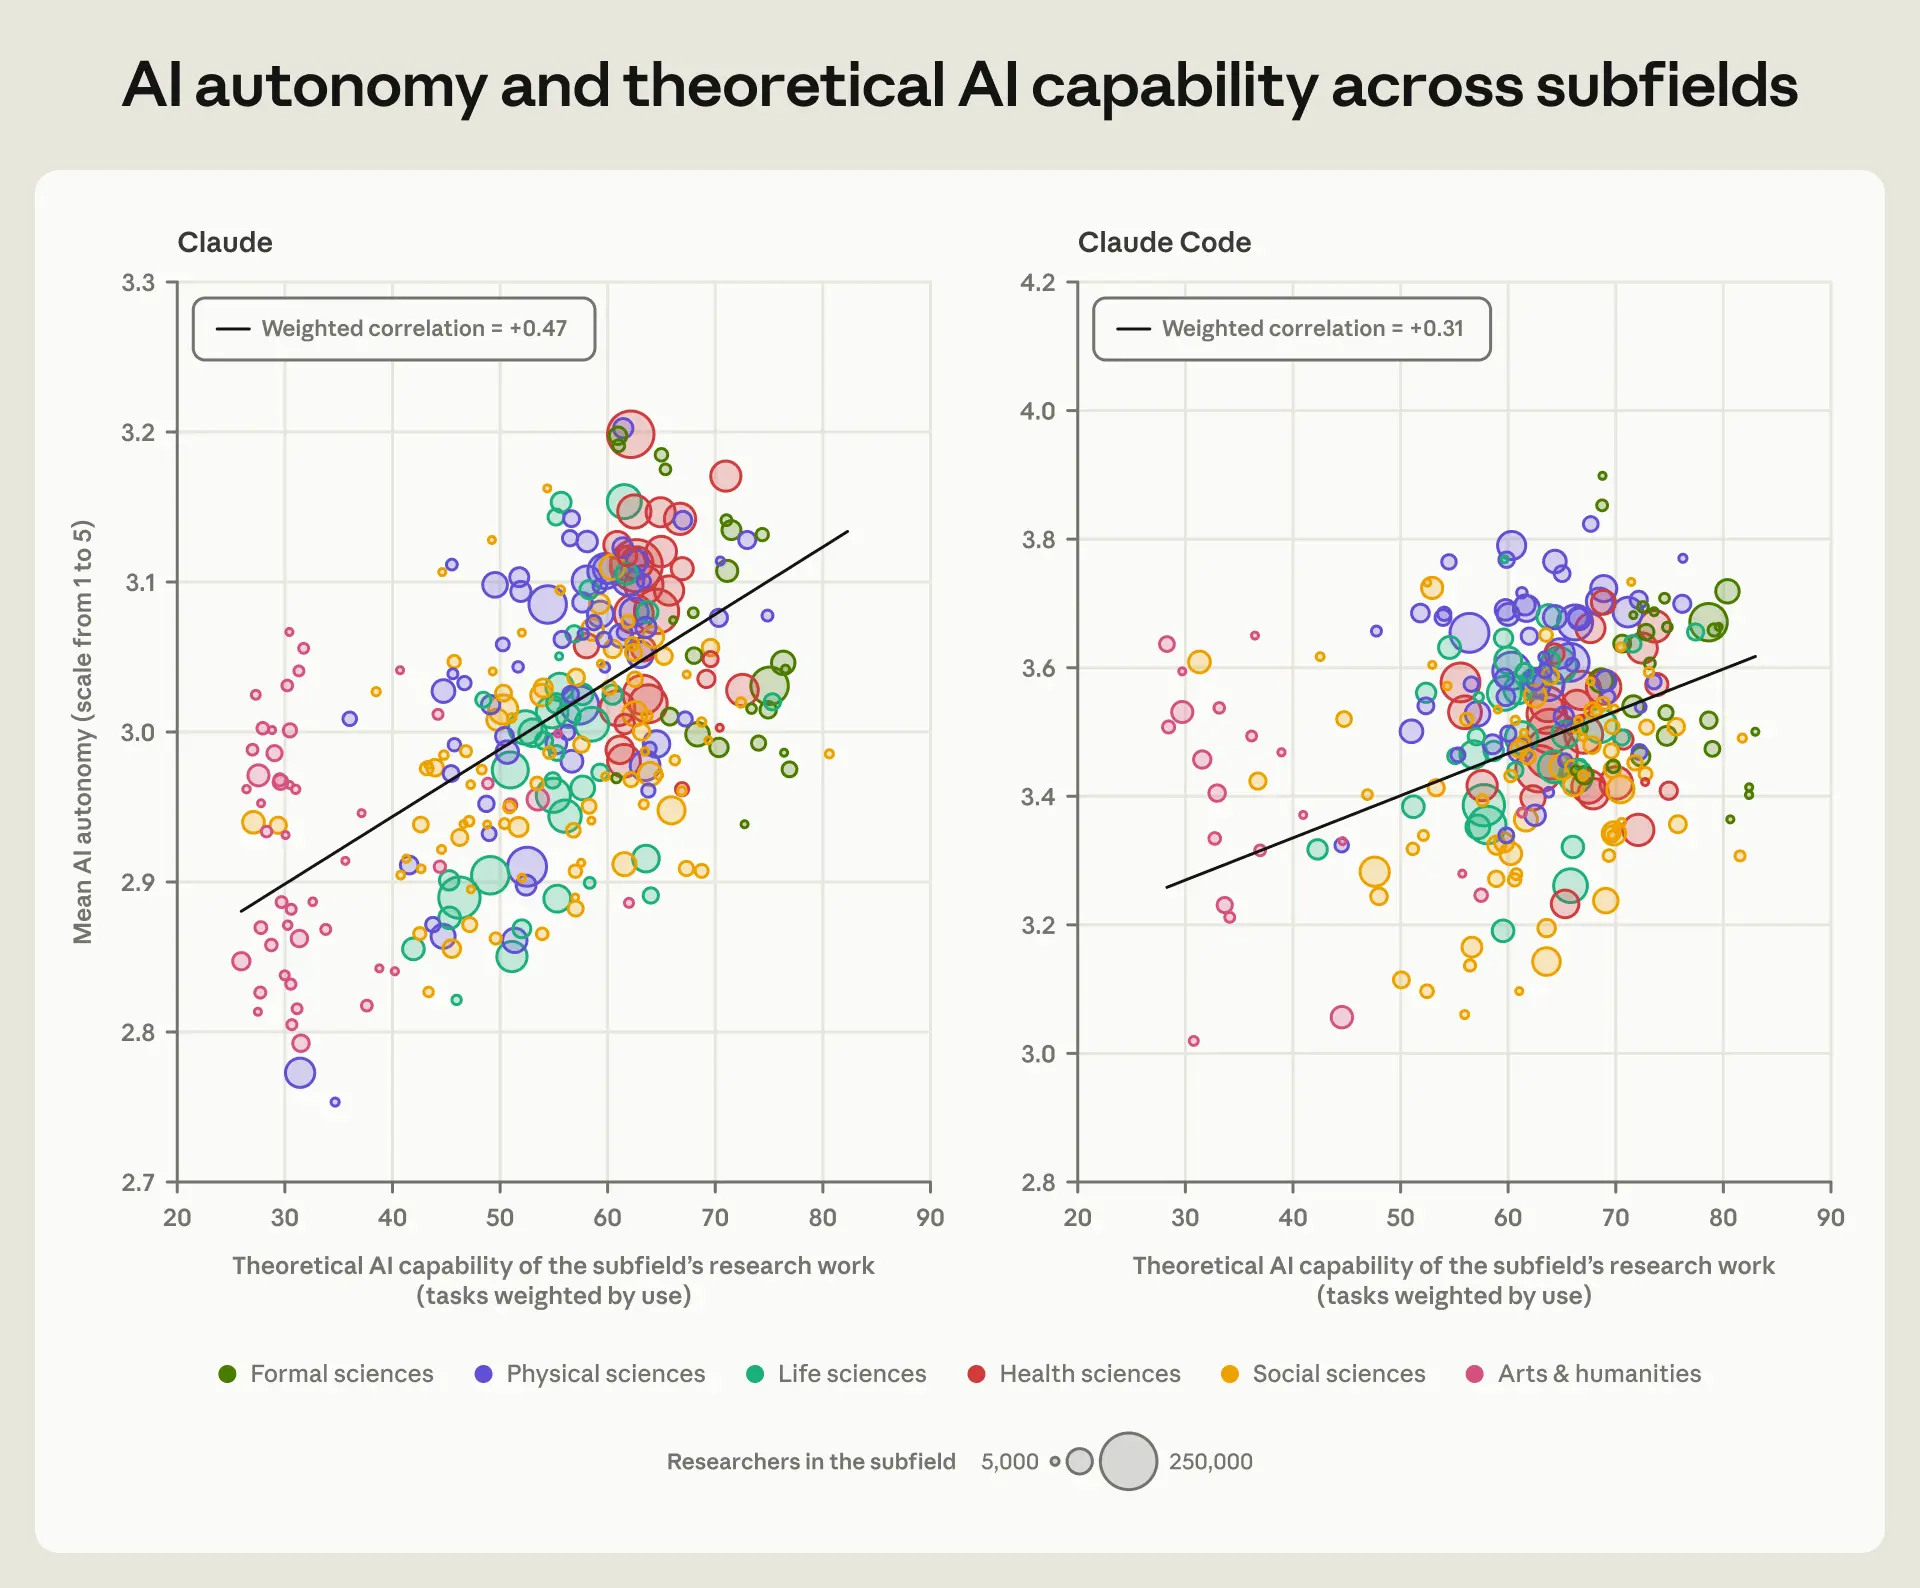
Теоретические возможности ИИ также позволяют предсказать, насколько автономно исследователи поручают работу Claude. На рисунке 12 видно, что автономность использования коррелирует с теоретическими возможностями ИИ в соответствующей подобласти. Иными словами, подобласти с большими теоретическими возможностями ИИ не только активнее используют ИИ, но и делают это более автономно.
Сценарии ускорения исследований с помощью ИИ
Темпы научно-технического прогресса зависят от хороших идей и возможностей для их реализации. Исторически и то и другое ограничивалось человеческими ресурсами. Число исследователей ограничено, и у каждого из них есть лишь определённое количество времени, чтобы сформулировать гипотезу, разработать подходящие тесты, провести анализ и обобщить результаты.
ИИ может ослабить эти ограничения двумя способами. Во-первых, он может взять на себя работу, которую сейчас выполняют исследователи, и тем самым позволить им заниматься большим числом идей. Во-вторых, он может предложить идеи, которые исследователи иначе не выявили бы. Второй эффект в конечном счёте может оказаться важнее, но его гораздо сложнее измерить, поэтому наш анализ сосредоточен на первом.
Методика
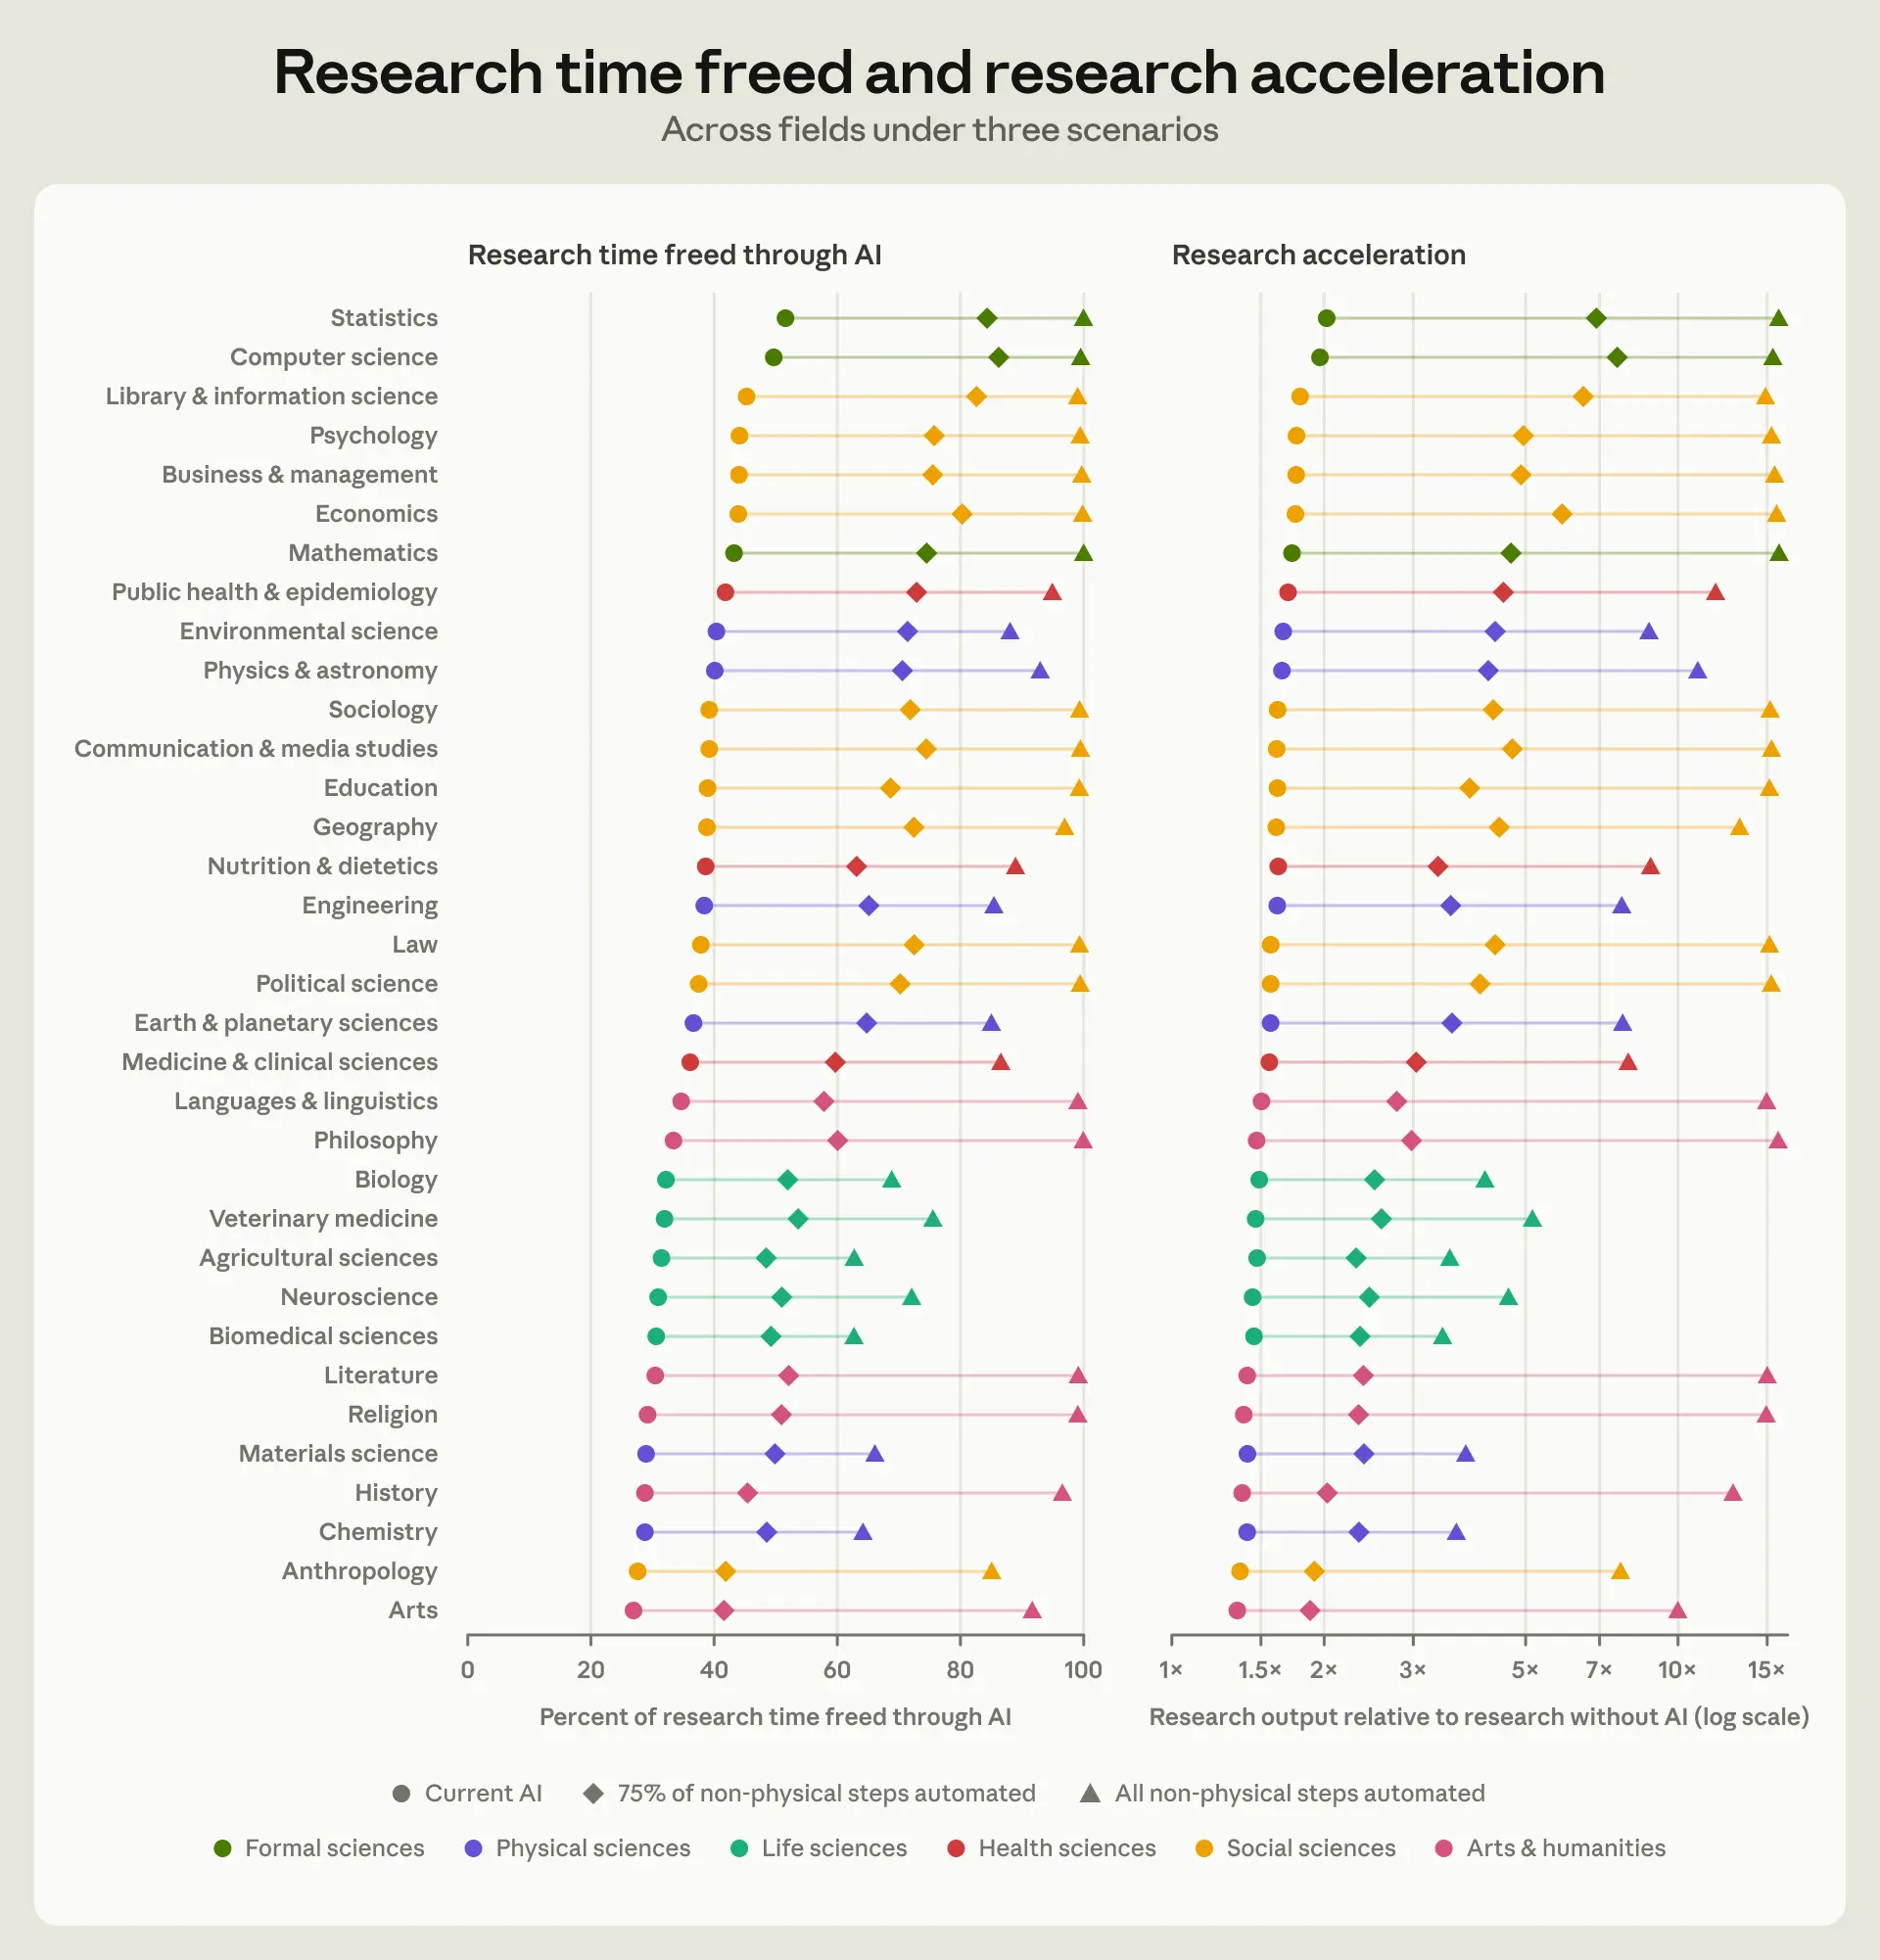
Мы рассматриваем три сценария ускорения науки с помощью ИИ. В сценарии 1 предполагается широкое внедрение современных возможностей ИИ, оценённых на основе нашего опроса и показателей возможностей ИИ. Сценарии 2 и 3 описывают гипотетическое будущее, в котором ИИ полностью автоматизирует 75% или 100% нефизических исследовательских шагов — отдельных действий, из которых, согласно SciNet, состоит каждая исследовательская задача. В первую очередь автоматизируются шаги с самыми высокими оценками возможностей ИИ. Во всех трёх сценариях физические шаги по-прежнему выполняют исследователи. Это иллюстративные сценарии, а не прогнозы. Они показывают, как физическая работа, теоретические возможности ИИ и его стоимость могут влиять на ускорение научных исследований и какие области способны ускориться сильнее всего.
Для каждого сценария мы приводим два показателя. Первый — доля работы, которую может взять на себя ИИ: часть времени, затрачиваемого на исследование, которую ИИ способен выполнять вместо исследователей. С учётом нынешнего распределения времени исследователей этот показатель отражает, сколько времени они могут высвободить благодаря ИИ, и напрямую следует из приведённого выше анализа. Освободившееся время можно направить на другие задачи, увеличив объём исследований. Второй показатель — ускорение, то есть предполагаемый прирост: увеличение объёма исследований при неизменном исследовательском бюджете по сравнению с объёмом без ИИ. Он показывает, сколько дополнительных результатов можно получить при том же бюджете. Высвободившееся время не приводит к пропорциональному росту результатов: исследователи переключаются на задачи, в которых ИИ помогает меньше, а сам ИИ требует затрат.
Для сценария 1 мы рассчитываем долю работы, которую может взять на себя ИИ, на основе нашего опроса, в котором зафиксированы пять уровней использования ИИ: отсутствие использования, помощь, совместная работа, делегирование и автономная работа. Мы предполагаем, что эти уровни соответствуют передаче ИИ 0%, 25%, 50%, 75% и 100% времени исследователя на выполнение конкретного шага задачи. Внутри каждой категории задач мы ранжируем шаги по оценкам возможностей ИИ. Затем распределяем уровни использования ИИ между шагами в тех же пропорциях, что и в опросе, назначая самые высокие уровни шагам с наивысшими оценками. Например, в ответах по генерации идей и выдвижению гипотез 17% респондентов сообщили, что не используют ИИ, а 53% — что используют его для помощи. Поэтому для 17% шагов по генерации идей с самыми низкими оценками возможностей ИИ мы предполагаем отсутствие доли работы, переданной ИИ, для следующих 53% — 25% и так далее по шкале. Поскольку респонденты, вероятно, активно используют ИИ, их ответы мы считаем косвенным показателем того, что ИИ способен делать сегодня. Наконец, мы суммируем время исследователей, высвобождаемое благодаря ИИ на отдельных шагах, по научным областям (см. Приложение).
Чтобы рассчитать ускорение, мы используем функцию производства идей — стандартную экономическую модель, описывающую, как ресурсы для исследований, например время исследователей, преобразуются в результаты. Согласно этой модели, для написания статьи необходимо выполнить множество исследовательских задач (Jones 2026). Эти задачи взаимодополняемы: сильные стороны в одной из них не могут полностью компенсировать слабые стороны в другой. Когда ИИ удешевляет выполнение некоторых задач, исследователи переключают усилия на те, в которых ИИ помогает меньше, и тем самым ослабляют узкие места, ограничивающие общий эффект. Например, исследователи могли бы больше времени уделять поиску новых вопросов или проводить больше физических экспериментов, чтобы расширить эмпирическую базу. Мы оцениваем, насколько такие узкие места ограничивают общий эффект, используя данные Ahmadpoor and Jones (2019). Для оценки затрат на ИИ мы предполагаем, что час работы ИИ-агента стоит 30 долларов против 95 долларов за час работы исследователя, а на каждый час, сэкономленный исследователем, ИИ работает 0,2 часа. Это иллюстративные предположения: стоимость ИИ основана на сегодняшних открытых прейскурантах. Чем ниже эти затраты, тем больше исследований можно провести в рамках заданного бюджета и тем выше ускорение, о чём мы расскажем ниже. Описание модели и предположений приведено в Приложении.
Сценарий 1: современные возможности
При широком внедрении современных возможностей ИИ мог бы взять на себя 27–52% времени исследователей, необходимого для проведения нового исследования; медианное значение по областям составляет 38% (рисунок 13, левая панель). Этим долям соответствуют значения ускорения от 1,35× в искусстве, 1,36× в антропологии и 1,41× в химии до 1,96× в информатике и 2,02× в статистике (рисунок 13, правая панель). Ускорение остаётся ограниченным, поскольку сегодня ИИ в основном помогает исследователям или работает вместе с ними, а не действует автономно, поэтому исследователям по-прежнему приходится тратить значительное время почти на каждый шаг. Даже в областях, наиболее готовых к внедрению ИИ, где работа почти целиком когнитивная, ускорение составляет лишь около 2×. Эти оценки предполагают широкое распространение ИИ и его применение исследователями на каждом шаге, где он может быть полезен сегодня.
Большую часть различий между областями объясняют два фактора. Первый — физическая работа, которую ИИ не может взять на себя без интеграции с физическими системами. В лабораторных и полевых науках, таких как сельскохозяйственные и биомедицинские науки, химия и материаловедение, на физические шаги приходится 38–41% времени исследователей, тогда как в медианной области — 4%. Одна лишь доля физической работы объясняет около трети различий в доле задач, которые может взять на себя ИИ. Второй фактор — распределение оценок возможностей ИИ для когнитивной работы. В искусстве и истории мало времени уходит на физические шаги (10% и 4% соответственно), однако оценки возможностей ИИ для когнитивных шагов низки — возможно, потому, что качественная и интерпретативная работа хуже поддаётся обучению с подкреплением. В информатике и статистике, напротив, оценки высоки, как и доля работы, которую может взять на себя ИИ; этому способствует анализ данных — тип работы с самыми высокими оценками возможностей ИИ во всех областях.
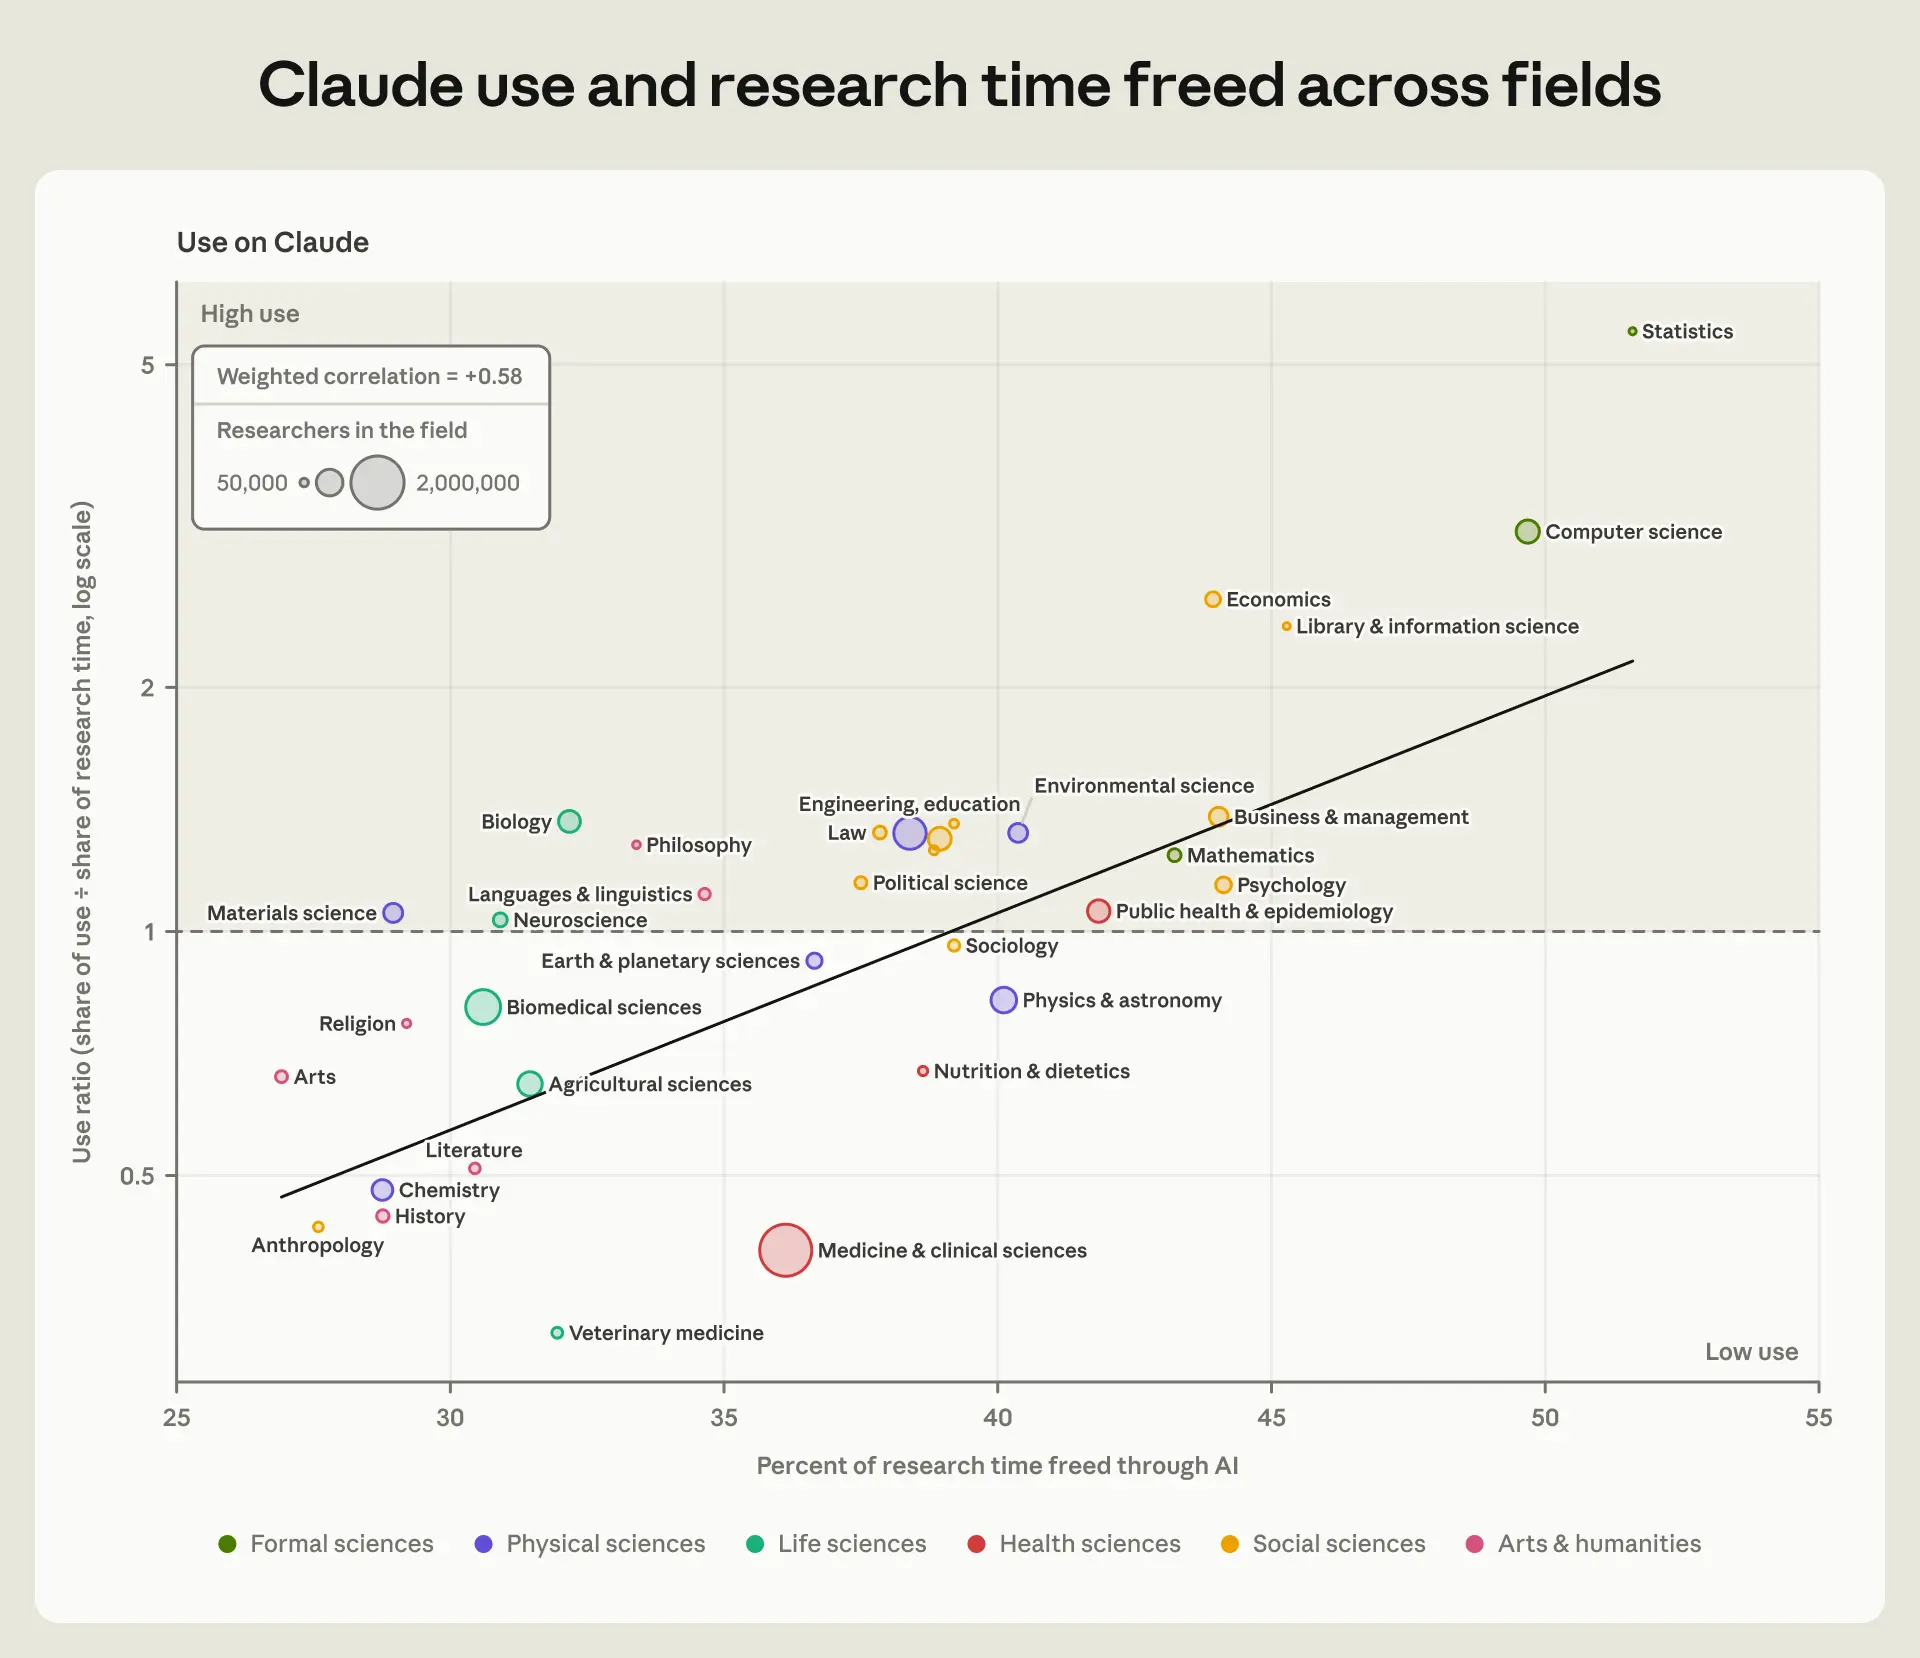
В областях с более высоким соотношением использования Claude, как правило, выше и доля работы, которую может взять на себя ИИ (рисунок 14). Эта доля рассчитана без использования данных об использовании Claude, поэтому данная связь служит дополнительным свидетельством того, что применение ИИ соответствует его теоретическим возможностям.
Сценарии 2 и 3: более широкая автоматизация
В этих более спекулятивных сценариях, в значительной степени зависящих от предположений о возможностях и стоимости ИИ, более широкая автоматизация резко увеличивает и долю работы, которую может взять на себя ИИ, и ускорение, а также усиливает различия между областями.
В сценарии 2, где ИИ может выполнять 75% нефизических шагов, ускорение достигает примерно 8× в информатике, 7× в статистике, библиотечном и информационном деле и 6× в экономике. В большинстве других социальных наук, математике, физике и астрономии оно составляет 4–5×, а в лабораторных и медицинских науках — около 2–3×. Наименьший выигрыш получают лабораторные науки, а также искусство и гуманитарные дисциплины, но по разным причинам. В лабораторных науках значительная часть работы физическая, и её по-прежнему должны выполнять исследователи. В искусстве и гуманитарных дисциплинах работа преимущественно когнитивная, но оценки возможностей ИИ низки, поэтому лишь немногие шаги попадают в число автоматизируемых. В информатике автоматизированные шаги составляют 82% нефизического времени исследователей, а в искусстве — лишь 28%. Ускорение в истории, антропологии и искусстве составляет около 2× или меньше.
В сценарии 3 искусство и гуманитарные дисциплины выходят вперёд, тогда как лабораторные науки по-прежнему отстают. Когда ИИ автоматизирует все нефизические шаги, низкие оценки возможностей ИИ больше не ограничивают когнитивную работу, и во многих областях ИИ может взять на себя почти всю исследовательскую деятельность (рисунок 13, левая панель). В этом спекулятивном сценарии области с небольшим числом физических задач — в том числе статистика, информатика, экономика, математика, психология и большая часть социальных наук, искусства и гуманитарных дисциплин — достигают примерно 15–16×. В областях со значительным объёмом лабораторной или полевой работы, таких как биология, химия, материаловедение, сельскохозяйственные и биомедицинские науки, ускорение составляет лишь 3–4×. Если лаборатории не автоматизированы, физические шаги, на которые приходится около 40% времени исследователей, остаются узким местом.
Из этих сценариев следуют два вывода. Во-первых, физические ограничения по-прежнему играют важную роль. Шаги, которые ИИ не может выполнять без интеграции с физическими системами, начинают занимать основную часть времени исследователей и бюджета, ограничивая ускорение. Во-вторых, там, где таких ограничений нет, становится возможен чрезвычайно быстрый прогресс, а его пределом оказывается стоимость ИИ. Согласно нашим предположениям, задача, полностью автоматизированная ИИ, всё равно обходится примерно в одну шестнадцатую стоимости её выполнения исследователем, поэтому ускорение приближается к 16× и на этом останавливается. Снижение стоимости ИИ соответственно повысит этот потолок: например, двукратное снижение затрат на ИИ удвоит темпы прогресса. Если стоимость резко снизится, в том числе для более сложных задач, которые ИИ автоматизирует позднее, области без физических ограничений смогут ускориться намного сильнее, чем предполагают эти оценки.
У этих расчётов есть важные ограничения, которые могут влиять на результаты в обе стороны. Мы не учитываем ограничения на уровне целой области, а не отдельной исследовательской группы. Например, на таких объектах, как Большой адронный коллайдер, можно провести лишь ограниченное число экспериментов. Мы учитываем только стоимость времени исследователей и ИИ, но не стоимость оборудования и экспериментальных материалов, которая может быть значительной в науках о здоровье, физических науках и науках о жизни. Мы также не рассматриваем возможность заменить физические эксперименты симуляциями, что могло бы ослабить ограничения в некоторых областях. Наконец, мы не учитываем качество идей. Если ИИ будет находить более удачные гипотезы с большей вероятностью успеха, исследования могут ускориться ещё сильнее; если же научное чутьё останется исключительно человеческим качеством, ускорение будет медленнее.
Ожидания исследователей
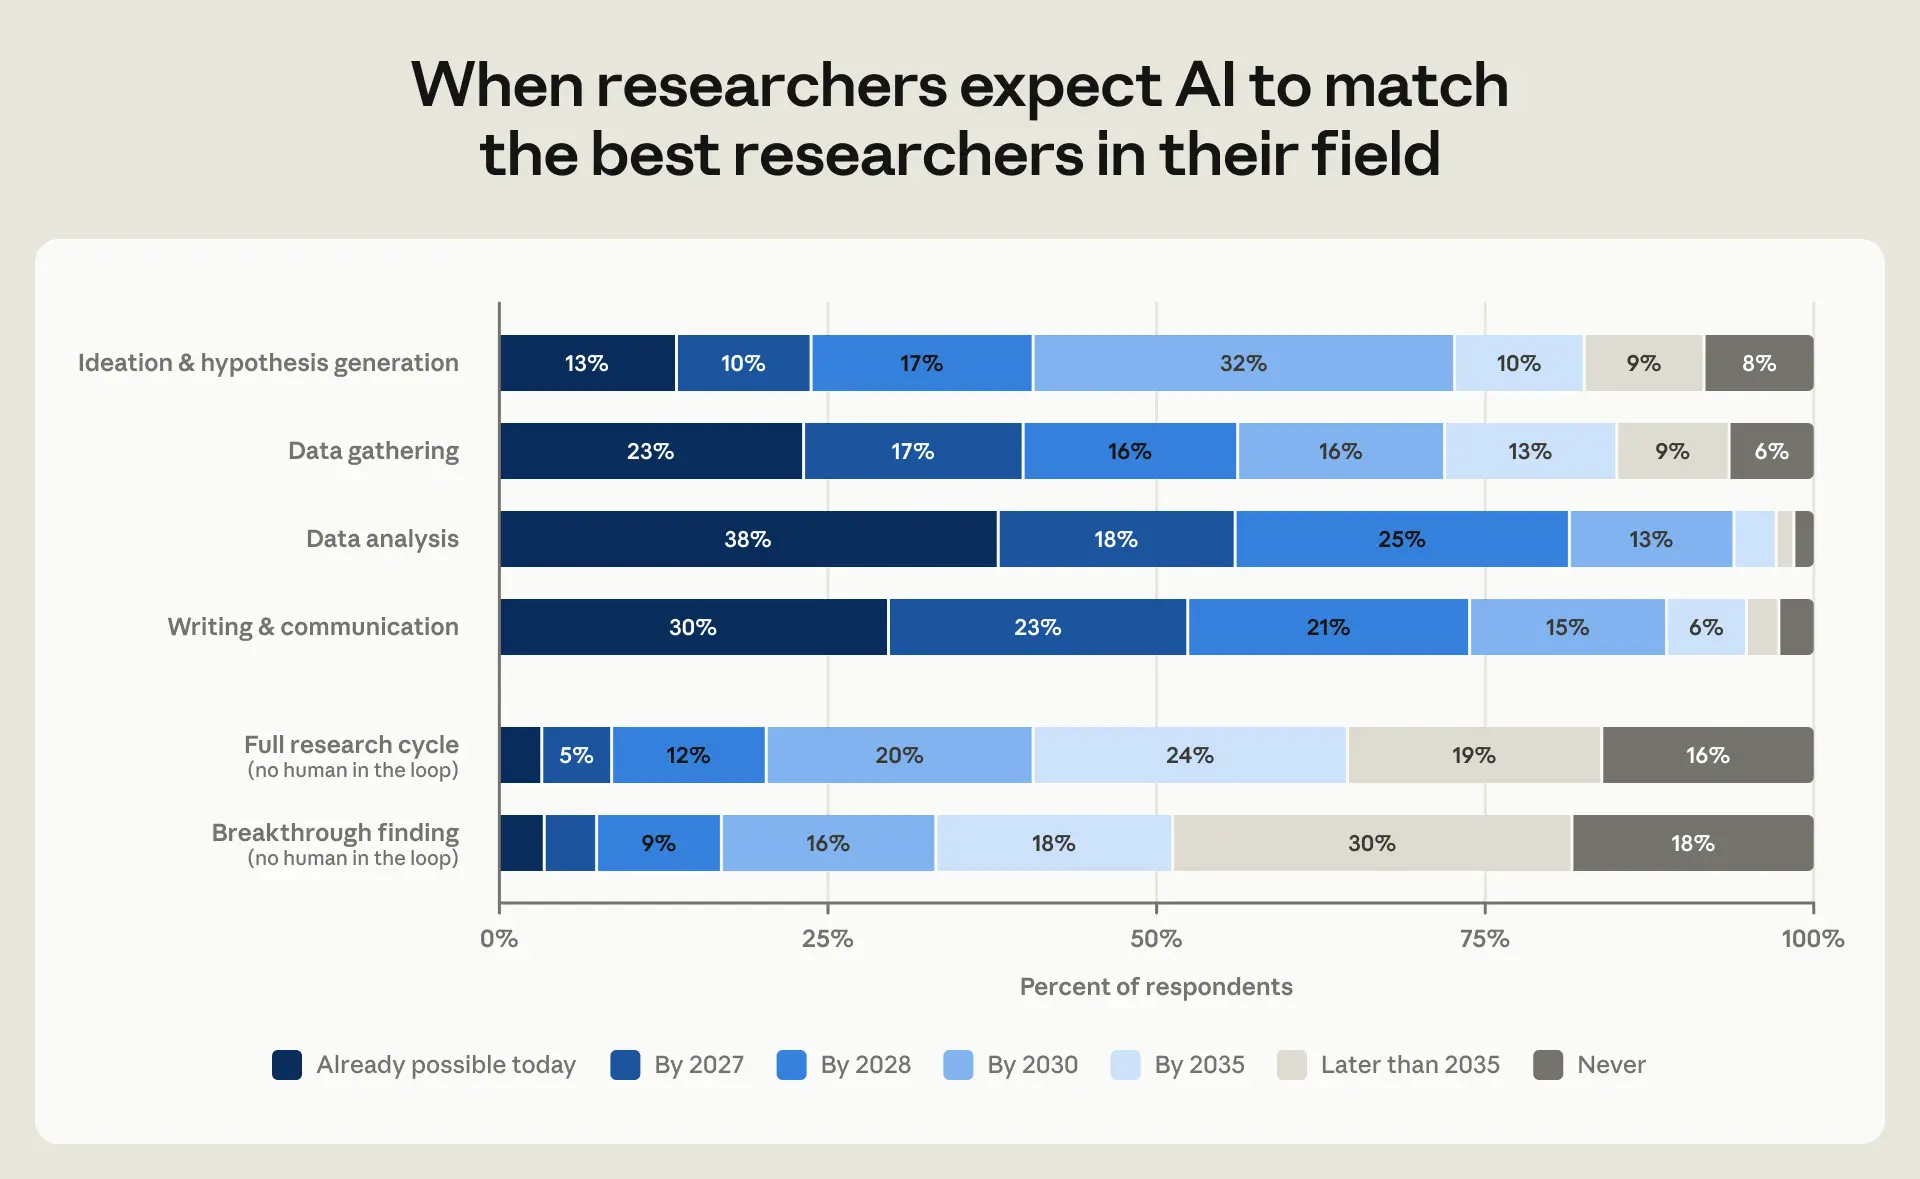
Приведённые выше сценарии охватывают широкий спектр возможностей. Собственные ожидания исследователей, основанные на их экспертных знаниях, могут дать уникальное представление о будущем. Чтобы узнать их мнение, мы опросили исследователей в науках о жизни и здоровье о том, когда, по их оценкам, ИИ, работающий самостоятельно, сможет сравниться с лучшими исследователями в их области в разных категориях исследовательской работы (рисунок 15). Респонденты ожидают этого в ближайшем будущем: более половины считают, что к 2027 году ИИ сможет сравниться с ведущими специалистами в анализе данных, а 38% говорят, что он уже достиг этого уровня. По оценкам респондентов, к 2030 году ИИ сравняется с лучшими исследователями в анализе данных у 94% ответивших, в написании текстов — у 89%, а в генерации идей и сборе данных — у 72% в каждой категории. Ожидания относительно генерации идей и сбора данных ниже, что согласуется с тем, что сегодня Claude реже используют для этих задач.
Ожидания относительно исследований от начала до конца, проводимых ИИ без участия людей, более сдержанны, однако исследователи всё же ждут значительного прогресса. Около 40% респондентов считают, что к 2030 году ИИ сможет проводить полноценные исследовательские проекты, а к 2035 году — около 64%, хотя 16% полагают, что этого не произойдёт никогда. Ещё осторожнее оценки перспектив автономного совершения научных прорывов: примерно половина исследователей ожидает этого не раньше 2035 года, если вообще ожидает. В целом многие исследователи рассчитывают на высокий уровень автоматизации в ближайшее десятилетие — примерно в соответствии с нашими сценариями более широкой автоматизации. Скорость и масштаб реализации этих ожиданий будут зависеть не только от развития ИИ как программной технологии, но и от усилий по созданию автоматизированных лабораторий, способных преодолеть физические барьеры.
Сопоставление результатов прошлых опросов с тем, что произошло на практике, показывает: прогресс ИИ часто недооценивали весьма значительно (Rosenberg et al. 2026). Например, в опросе, проведённом в середине 2022 года, эксперты в соответствующих областях в среднем считали, что ИИ достигнет золотого уровня на Международной математической олимпиаде к 2030 году, а супепрогнозисты — к 2035 году (Karger et al. 2023). ИИ достиг этой цели в 2025 году — на пять-десять лет раньше прогнозов. Хотя прогнозисты систематически недооценивали рост возможностей ИИ, есть и несколько исключений — прежде всего в областях, где требуется действовать в физическом мире, например при выполнении лабораторных задач в биологии с помощью ИИ.
Обсуждение
Если ИИ поможет ускорить научные открытия, это может способствовать повышению уровня жизни и ускорению прогресса в лечении болезней. Наши оценки указывают на значительный потенциал. Однако развитие исследовательских возможностей ИИ не приведёт автоматически к быстрому прогрессу: для достижения такого ускорения нам также придётся преодолеть ряд ограничений.
Во-первых, внедрение может значительно отставать от развития возможностей. Новые технологии, как правило, распространяются медленно (Comin and Hobijn 2010), а рост производительности обычно проявляется лишь после того, как организации перестраивают свою работу с учётом этих технологий (David 1990; Brynjolfsson, Rock, and Syverson 2021). Внедрение могут замедлять индивидуальное обучение, трения на организационном или системном уровне, а также ограничения доступа к ИИ или инфраструктуре.
Во-вторых, исследования могут и дальше сталкиваться с узкими местами, которые ИИ не устраняет. Физические эксперименты, проведение которых может быть дорогостоящим и медленным, способны существенно сдерживать прогресс даже при наличии чрезвычайно мощного ИИ. Особенно заметно это в описанных выше сценариях для экспериментальных наук. Ещё одним узким местом может стать выбор темы исследования. Ценность исследовательского проекта во многом определяется его вопросами, а способность ИИ генерировать хорошие вопросы пока неясна. Если узким местом станет выдвижение идей, это ограничит ускорение, даже если поиск ответа на конкретный вопрос станет гораздо дешевле. И наоборот, если ИИ превзойдёт людей в формулировании качественных гипотез, ускорение может оказаться более значительным — особенно в областях, где проверка гипотез обходится дорого.
В-третьих, исследования с применением ИИ могут увеличить объём или повысить качество научных работ, что по-разному повлияет на науку. Всплеск числа новых научных статей способен ускорить развитие целой области, но в то же время может превысить возможности учёных по усвоению и проверке результатов. С другой стороны, новые технологии — от микроскопов и телескопов до статистического программного обеспечения — исторически повышали качество научных выводов, и ИИ тоже может сделать возможными более комплексный анализ и более амбициозные проекты. А по мере того как публиковать статьи становится проще, научное сообщество может всё чаще поощрять особенно новаторские и качественные работы. Приведёт ли более эффективное проведение исследований к росту их количества или качества, будет зависеть от выбора учёных и стимулов, создаваемых журналами, фондами и учреждениями.
В-четвёртых, организация научной работы может измениться так, что предсказать эти перемены будет непросто. По мере роста возможностей и автономности ИИ-системы могут взять на себя проверку результатов, рецензирование и распространение важных выводов, что поможет решить описанную выше проблему их усвоения. В более отдалённом будущем ИИ-агенты для исследований могут также самостоятельно, без участия людей, продвигать науку вперёд в крупных сообществах, используя робототехнику и автоматизированные лаборатории. Такая автономная исследовательская деятельность ИИ поднимет вопросы о том, как люди будут следить за новыми знаниями, смогут ли они их понимать и как именно эти знания будут получены.
В-пятых, по мере роста автономности ИИ-систем усложнится задача обеспечения соответствия исследований с применением ИИ человеческим целям. По мере того как ИИ-агенты будут становиться мощнее и изобретательнее, для безопасности и благополучия людей может оказаться важным сохранять их участие в ключевых исследовательских решениях — например, в выборе вопросов и способов их изучения. Риски могут быть связаны и с самими открытиями, и с побочными результатами исследований — особенно в биологии, где те же возможности, что ускоряют медицинский прогресс, способны также привести к появлению опасных знаний или материалов. В таких случаях может потребоваться предусмотреть в исследовательском процессе специальные контрольные этапы, согласившись на более медленный прогресс ради снижения рисков.
Наконец, характер работы учёных может существенно измениться. Одним из последствий может стать изменение удовлетворённости исследователей своей работой. Если ИИ возьмёт на себя приятные или приносящие удовлетворение задачи, удовлетворённость может снизиться, и меньше людей будут выбирать научную карьеру. Если же ИИ возьмёт на себя задачи, которые исследователи считают утомительными, удовлетворённость может вырасти. Одной из потенциальных сфер применения ИИ может стать административная работа. В США руководители проектов, финансируемых из федерального бюджета, сообщают, что тратят около 44% своего исследовательского времени на выполнение административных требований, а не на научную работу (Schneider et al. 2020). Снижение этой нагрузки могло бы принести большую пользу, сэкономив время и повысив общую удовлетворённость. В конечном счёте общий эффект неясен и может меняться по мере развития возможностей ИИ. Оптимистичный взгляд состоит в том, что ИИ расширит возможности для открытий, которые и придают научной карьере особую привлекательность. Если наука — это путешествие к «бесконечному рубежу», то ИИ может стать новым судном, позволяющим учёным продвинуться дальше в огромном море исследовательских вопросов и открытий.
Приложение
Доступно здесь.
Литература
Ahmadpoor, Mohammad and Benjamin F. Jones, «Раскрывая вклад команд и отдельных исследователей в науку и изобретательство», Proceedings of the National Academy of Sciences, 2019, 116 (28), 13885–13890.
Alamos, Cristian and Lukas Althoff, «SciNet: анатомия науки», набор данных, 2026. https://www.anatomyofscience.com/
Amodei, Dario, «Машины милосердной благодати: как ИИ может изменить мир к лучшему», эссе, октябрь 2024 года. https://darioamodei.com/essay/machines-of-loving-grace
Anthropic, «Узнаём больше о математических способностях Claude», исследовательская публикация, 10 августа 2026 годаa. https://www.anthropic.com/research/riemann-zeta
Anthropic, «Формализация последней теоремы Ферма», исследовательская публикация, 4 сентября 2026 годаb. https://www.anthropic.com/research/formalizing-fermats-last-theorem
Appel, Ruth et al., «Отчёт Anthropic Economic Index: базовые экономические задачи», исследовательская публикация, 15 января 2026 года. https://www.anthropic.com/research/anthropic-economic-index-january-2026-report
Brynjolfsson, Erik, Daniel Rock, and Chad Syverson, «J-образная кривая производительности: как нематериальные активы дополняют технологии общего назначения», American Economic Journal: Macroeconomics, 2021, 13 (1), 333–372.
Bush, Vannevar, Наука — бесконечный рубеж: доклад президенту, Вашингтон, округ Колумбия: Государственная типография США, 1945.
Codreanu, Mihai et al., «ИИ в науке: первые выводы», препринт arXiv arXiv:2609.28504, 2026. https://arxiv.org/abs/2609.28504
Comin, Diego and Bart Hobijn, «Исследование распространения технологий», American Economic Review, 2010, 100 (5), 2031–2059.
David, Paul A., «Динамо и компьютер: исторический взгляд на современный парадокс производительности», American Economic Review, 1990, 80 (2), 355–361.
Eloundou, Tyna et al., «GPT — это GPT: потенциальное влияние больших языковых моделей на рынок труда», Science, 2024, 384 (6702), 1306–1308.
Guo, Daya et al., «DeepSeek-R1 стимулирует рассуждение в больших языковых моделях с помощью обучения с подкреплением», Nature, 2025, 645 (8081), 633–638.
Hao, Qianyue et al., «Инструменты искусственного интеллекта расширяют влияние учёных, но сужают фокус науки», Nature, 2026, 649 (8099), 1237–1243.
Jones, Benjamin F., «Искусственный интеллект в исследованиях и разработках», в: Ajay Agrawal, Erik Brynjolfsson, and Anton Korinek, ред., Экономика трансформирующего ИИ, Чикаго: University of Chicago Press, 2026, 37–61.
Jumper, John et al., «Высокоточное предсказание структуры белков с помощью AlphaFold», Nature, 2021, 596 (7873), 583–589.
Karger, Ezra et al., «Прогнозирование экзистенциальных рисков: данные долгосрочного турнира прогнозирования», рабочий документ № 1 Forecasting Research Institute, 2023. https://forecastingresearch.org/research/existential-risk-persuasion-tournament
Kobak, Dmitry et al., «Подробный анализ текстов биомедицинских публикаций, созданных при помощи больших языковых моделей, с помощью избыточной лексики», Science Advances, 2025, 11 (27), eadt3813.
Lambert, Nathan et al., «Tülu 3: расширение границ дообучения открытых языковых моделей», препринт arXiv arXiv:2411.15124, 2024. https://arxiv.org/abs/2411.15124
Liang, Weixin et al., «Количественная оценка использования больших языковых моделей в научных статьях», Nature Human Behaviour, 2025, 9 (12), 2599–2609.
Liu, Yinhong et al., «Согласование с человеческими суждениями: роль парных предпочтений при оценке больших языковых моделей», в: Материалы первой конференции по моделированию языка (COLM), 2024.
Mantiuk, Rafał K., Anna Tomaszewska, and Radosław Mantiuk, «Сравнение четырёх субъективных методов оценки качества изображений», Computer Graphics Forum, 2012, 31 (8), 2478–2491.
Massenkoff, Maxim et al., «Отчёт Anthropic Economic Index: частота использования», исследовательская публикация, 26 июня 2026 года. https://www.anthropic.com/research/economic-index-june-2026-report
Merchant, Amil et al., «Масштабирование глубокого обучения для поиска новых материалов», Nature, 2023, 624 (7990), 80–85.
OpenAI, «Модель OpenAI опровергла одну из ключевых гипотез дискретной геометрии», исследовательская публикация, 20 мая 2026 годаa. https://openai.com/index/model-disproves-discrete-geometry-conjecture/
OpenAI, «О задаче тысячелетия Навье — Стокса», исследовательская публикация, 8 сентября 2026 годаb. https://openai.com/index/navier-stokes-solution/
Parshall, Daniel and Andrea Lopez-Luzuriaga, «Измерение экономического охвата ИИ: многомерная таксономия задач», рабочий документ 2026–005 Центра экономических исследований Университета Джорджа Вашингтона, 2026. https://www2.gwu.edu/~forcpgm/2026–005.pdf
Robinson-Garcia, Nicolas et al., «Метаисследование: специализация на задачах на протяжении научной карьеры», eLife, 2020, 9, e60586.
Rosenberg, Josh et al., «Насколько точными были прогнозы прогресса ИИ на сегодняшний день?», исследовательская публикация Forecasting Research Institute, 22 сентября 2026 года. https://forecastingresearch.org/research/ai-progress-accuracy-update
Schneider, Sandra L. et al., «Опрос FDP о нагрузке преподавателей за 2018 год: отчёт об основных результатах», Federal Demonstration Partnership, 2020. https://thefdp.org/wp-content/uploads/FDP-FWS-2018-Primary-Report.pdf
Shah, Nihar B. et al., «Когда сравнение лучше выставления оценки?», препринт arXiv arXiv:1406.6618, 2014. https://arxiv.org/abs/1406.6618
Tomei, Philip Moreira and Bouke Klein Teeselink, «Каким задачам может научиться ИИ? Оценка подверженности влиянию обучения с подкреплением», препринт arXiv arXiv:2605.02598, 2026. https://arxiv.org/abs/2605.02598
Tsoukalas, George et al., «Развитие математических исследований с помощью формального поиска доказательств на базе ИИ», Science, 2026, 394 (6820), 234–239.
Varadi, Mihaly et al., «База данных структур белков AlphaFold в 2024 году: данные о структурах для более чем 214 миллионов белковых последовательностей», Nucleic Acids Research, 2024, 52 (D1), D368–D375.
Wang, Hanchen et al., «Научные открытия в эпоху искусственного интеллекта», Nature, 2023, 620 (7972), 47–60.
Сноски
01При подсчёте числа исследователей в каждой области по всему миру мы не учитываем страны, где Claude недоступен.
02Данные о числе исследователей мы получаем из SciNet. Подробнее о методике см. в приложении.
03Расшифровки распределяются по областям в зависимости от тематики исследований, а не используемых инструментов, поэтому программирование в других вычислительных науках не учитывается как информатика.
04Доли использования на уровне отдельных подотраслей оцениваются менее точно, чем на уровне целых областей, особенно для подотраслей с небольшим количеством сессий: здесь сильнее сказываются вариативность выборки и ошибки классификации. Поэтому мы сосредоточиваемся на общих закономерностях, а не на положении какой-либо отдельной подотрасли с малым числом сессий.
05Хотя наш анализ посвящён исследовательским задачам, на преподавание, общественную деятельность и административную работу может приходиться значительная часть времени учёных. Однако наш классификатор научного использования намеренно не учитывает преподавание студентам бакалавриата и не выделяет административную или рутинную работу, если она напрямую не связана с исследованиями или конкретным проектом. Кроме того, наша выборка не ограничена учёными, занимающими академические должности, у которых обычно больше преподавательской и общественной нагрузки. Поэтому изучение применения ИИ в этих рабочих процессах мы оставляем для будущих исследований.
06Среди отдельных задач чаще всего встречается подготовка черновиков статей — как в Claude (18,6%), так и в Claude Code (11,1%). В Claude далее по частоте идут обзор и обобщение литературы (6,8%), а также ответы на замечания рецензентов (6,7%). В Claude Code это проектирование, создание и доработка материалов (4,8%), а также визуализация данных и результатов (4,6%).
07Респондентов набирали среди претендентов на гранты Anthropic по программе AI for Science и смежным программам; они связаны с исследовательскими учреждениями США и Канады. Поскольку они подавали заявки на кредиты для исследований в области ИИ, вероятно, они используют ИИ активнее, чем типичный учёный. Подробности см. в приложении.
08Различия в задачах, выполняемых с помощью Claude Science, могут отчасти объясняться тем, кто им пользуется. Claude Science доступен всем платным пользователям, однако его, вероятно, выбирают те, у кого более специализированные или сложные задачи. Поэтому различия между продуктами мы описываем как закономерности использования.
09Чтобы определить результаты каждой сессии с Claude, мы используем классификатор, представленный в нашей предыдущей работе (Massenkoff et al. 2026). Классификатор определяет наиболее значимый результат, созданный Claude в ходе обмена сообщениями. Более детальные ответы мы распределяем по двум категориям: письменные и технические материалы. К письменным материалам относятся прежде всего документы, отчёты, научные статьи и презентации. К техническим — главным образом результаты работы с программным обеспечением, например скрипты, исправления кода, данные и графики. К материалам, не относящимся к письменным или техническим, относятся анализы и краткие обзоры, а также объяснения и рекомендации.
Авторы и благодарности
Cristian Alamos, Bailey Bova, Tom Chivers, Lauren Cottrell, Eleanor Dorfman, Adam Farina, Deep Ganguli, Rebecca Hiscott, Chad Jones, Anneke Jong, Aisling Keenan, Anton Korinek, Eva Lyubich, Paruul Maheshwary, Miles McCain, Teddy McGuire, Ankur Rathi, Santi Ruiz, Szymon Sacher, David Saunders, Monika Tuchowska, Nick Turner, Heather Whitney, Kim Withee, Jack Clark.
@techreport{hermle2026AIScience,
  author = {Hermle, Johannes and Jones, Benjamin and Althoff, Lukas and Heller, Ryan and Lyttelton, Thomas and Stein, Carolyn and Wilmers, Nathan and Massenkoff, Maxim and McCrory, Peter},
  title = {{AI} for scientific discovery: How researchers use {Claude}},
  institution = {The Anthropic Institute},
  type = {Technical Report},
  year = {2026},
  month = nov,
  url = {https://www.anthropic.com/research/how-researchers-use-claude}
}
Полный текст статьи читайте на Anthropic
Об этом также пишут
- 3DNews Anthropic выяснила, насколько ИИ ускорит научные исследования: в перспективе — до 15 раз 06.11.2026 15:20
