Бенчмарк Procgen
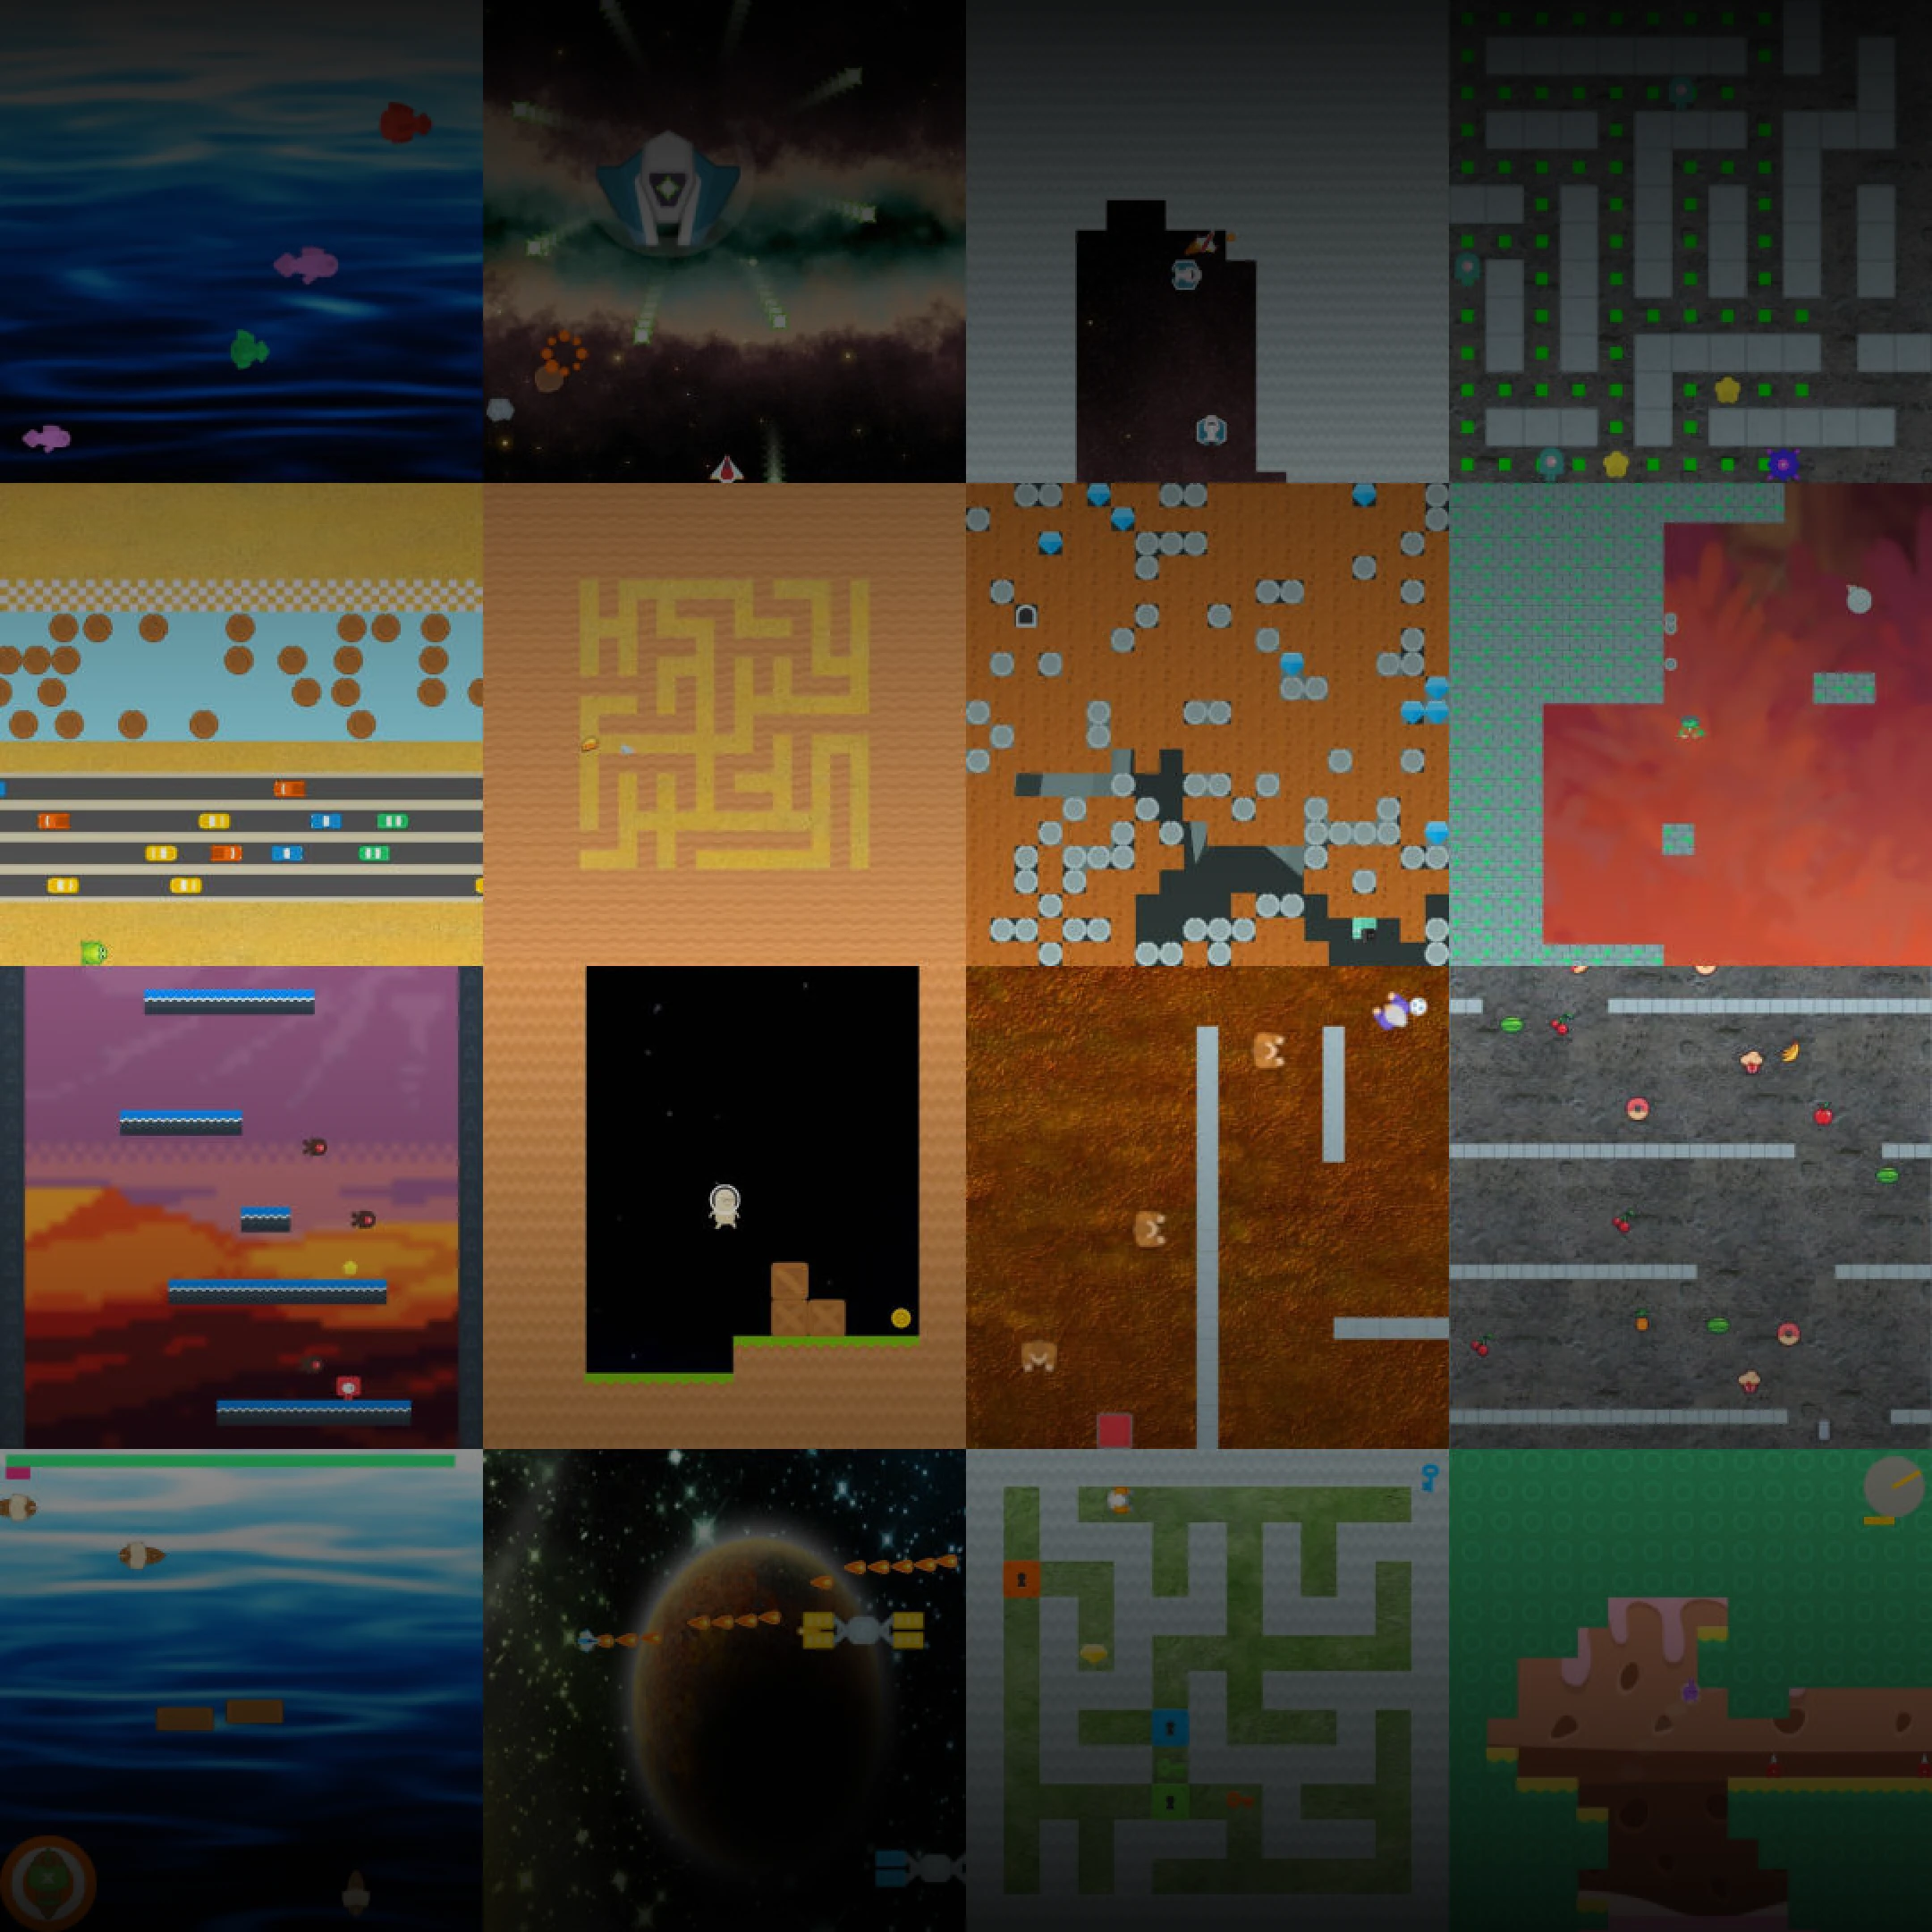
Мы выпускаем бенчмарк Procgen, состоящий из 16 простых в использовании процедурно сгенерированных сред, которые позволяют напрямую измерить, насколько быстро агент обучения с подкреплением осваивает навыки обобщения.
00:00
Начало работы
Bash
1$ pip install procgen # install2$ python -m procgen.interactive --env-name starpilot # human3$ python <# random AI agent 4import gym5env = gym.make('procgen:procgen-coinrun-v0')6obs = env.reset()7while True:8 obs, rew, done, info = env.step(env.action_space.sample())9 env.render()10 if done:11 break12EOFИспользовать среду очень просто, будь вы человеком или ИИ:
Мы выяснили, что для успешного обобщения на новые уровни все среды Procgen требуют обучения на 500–1000 различных уровнях. Это говорит о том, что стандартным бенчмаркам обучения с подкреплением требуется гораздо большая вариативность внутри каждой среды. Бенчмарк Procgen стал стандартной исследовательской платформой, используемой командой OpenAI по обучению с подкреплением, и мы надеемся, что он ускорит создание сообществом более совершенных алгоритмов обучения с подкреплением.
Разнообразие сред — это ключ к успеху
Внесколькихсредах было замечено, что агенты могут переобучаться на удивительно больших обучающих наборах. Это свидетельствует о том, что переобучение может быть присуще классическим бенчмаркам, таким как Arcade Learning Environment, который долгое время служил золотым стандартом в обучении с подкреплением (RL). Хотя разнообразие между различными играми в ALE является одним из сильнейших качеств бенчмарка, недостаточное внимание к обобщению представляет собой серьезный недостаток. В каждой игре возникает вопрос: действительно ли агенты надежно усваивают нужный навык или они просто заучивают конкретные траектории?
CoinRun был создан специально для решения этой проблемы путем использования процедурной генерации для создания различных наборов обучающих и тестовых уровней. Хотя CoinRun помог нам лучше количественно оценить обобщение в обучении с подкреплением, он все же представляет собой лишь одну среду. Вероятно, CoinRun не полностью отражает все те трудности, с которыми приходится сталкиваться агентам RL. Мы хотим получить лучшее из обоих миров: бенчмарк, состоящий из множества разнообразных сред, каждая из которых фундаментально требует способности к обобщению. Чтобы удовлетворить эту потребность, мы создали бенчмарк Procgen. Теперь CoinRun выступает в качестве первой среды в Procgen Benchmark, привнося свое разнообразие в общее дело.
Предыдущие работы, включая Obstacle Tower Challenge и General Video Game AI framework, также поощряли использование процедурной генерации для более точной оценки обобщения в RL. Мы спроектировали среды в схожем ключе: две среды Procgen напрямую вдохновлены работами на базе GVGAI. Другие среды, такие как Dota и StarCraft, также обеспечивают высокую сложность внутри каждой среды, но с ними трудно быстро проводить итерации (и еще труднее использовать более одной такой среды одновременно). Создавая бенчмарк Procgen, мы стремились достичь всего сразу: удобства экспериментов, высокой вариативности внутри сред и высокой вариативности между средами.
Бенчмарк Procgen
Бенчмарк Procgen состоит из 16 уникальных сред, предназначенных для измерения как эффективности использования выборок, так и способности к обобщению в обучении с подкреплением. Этот бенчмарк идеально подходит для оценки обобщения, поскольку в каждой среде можно генерировать различные обучающие и тестовые наборы. Он также отлично подходит для оценки эффективности выборки, так как все среды ставят перед агентами RL разнообразные и увлекательные задачи. Внутреннее разнообразие сред требует от агентов изучения надежных стратегий; переобучение на узких участках пространства состояний окажется недостаточным. Иными словами, способность к обобщению становится неотъемлемым компонентом успеха, когда агенты сталкиваются с постоянно меняющимися уровнями.
Принципы проектирования
Мы спроектировали все среды Procgen так, чтобы они удовлетворяли следующим критериям:
- Высокое разнообразие: Логике генерации среды предоставлена максимальная свобода в рамках базовых конструктивных ограничений. Разнообразие получаемых распределений уровней ставит перед агентами значимые задачи на обобщение.
- Быстрая оценка: Сложность среды откалибрована таким образом, чтобы базовые агенты добивались значительного прогресса после обучения на протяжении 200 млн временных шагов. Кроме того, среды оптимизированы для выполнения тысяч шагов в секунду на одном ядре CPU, что обеспечивает быстрый пайплайн экспериментов.
- Настраиваемая сложность: Все среды поддерживают два тщательно откалиброванных уровня сложности: простой (easy) и сложный (hard). Хотя мы публикуем результаты для сложного уровня, мы также делаем доступным простой уровень для тех, у кого ограничены вычислительные мощности. Для обучения на простых средах требуется примерно в восемь раз меньше ресурсов.
- Акцент на визуальное распознавание и моторный контроль: Следуя традициям, среды имитируют стиль многих игр Atari и Gym Retro. Успешное выполнение задач зависит в первую очередь от распознавания ключевых элементов в пространстве наблюдений и реализации соответствующих низкоуровневых моторных реакций.
00:00
Оценка обобщения
Мы осознали, насколько сложным может быть обобщение в обучении с подкреплением во время проведения Retro Contest, поскольку агенты постоянно не справлялись с обобщением на основе ограниченных данных из обучающего набора. Позже наши эксперименты с CoinRun нарисовали еще более четкую картину трудностей наших агентов с обобщением. Теперь мы расширили эти результаты, проведя наше самое тщательное на сегодняшний день исследование обобщения в RL с использованием всех 16 сред из бенчмарка Procgen.
Сначала мы измерили, как размер обучающего набора влияет на обобщение. В каждой среде мы сгенерировали обучающие наборы размером от 100 до 100 000 уровней. Мы обучали агентов на этих уровнях в течение 200 млн временных шагов, используя алгоритм Proximal Policy Optimization, и измеряли производительность на ранее не встречавшихся тестовых уровнях.
Мы обнаружили, что агенты сильно переобучаются на небольших обучающих наборах практически во всех средах. В некоторых случаях агентам требуется доступ к 10 000 уровням, чтобы преодолеть разрыв в обобщении. Мы также заметили любопытную тенденцию, проявившуюся во многих средах: после определенного порога показатели обучения улучшаются по мере роста обучающего набора! Это противоречит тенденциям, наблюдаемым в обучении с учителем, где результаты обучения обычно ухудшаются с увеличением размера обучающей выборки. Мы считаем, что этот рост показателей обучения обусловлен неявной учебной программой (implicit curriculum), создаваемой разнообразным набором уровней. Более крупный обучающий набор может улучшить качество обучения, если агент учится обобщать даже между уровнями внутри самого обучающего набора. Ранее мы уже замечали этот эффект на примере CoinRun и выяснили, что он часто проявляется и во многих средах Procgen.
Аблационное исследование с детерминированными уровнями
На этапе тестирования мы убираем детерминизм в последовательности уровней, выбирая последовательности случайным образом. Мы обнаруживаем, что в большинстве игр агенты становятся компетентными на первых нескольких уровнях обучения, создавая иллюзию значительного прогресса. Однако результаты тестирования показывают, что агенты на самом деле почти ничего не узнали о лежащем в основе распределении уровней. Мы считаем, что этот огромный разрыв между результатами обучения и тестирования заслуживает особого внимания. Он выявляет важнейший скрытый изъян обучения в средах, которые следуют фиксированной последовательности уровней. Эти результаты показывают, насколько важно использовать разнообразные распределения сред при обучении и оценке агентов RL.
Дальнейшие шаги
Мы ожидаем, что многие выводы, полученные из этого бенчмарка, найдут применение в более сложных условиях, и мы рады использовать эти новые среды для проектирования более способных и эффективных агентов.
Если вы хотите помочь в разработке разнообразных сред, мы ищем сотрудников!
Авторы
Благодарности
Спасибо Марку Беллемару (Marc Bellemare), Джулиану Тогелиусу (Julian Togelius), Карлесу Геладе (Carles Gelada), Джейкобу Джексону (Jacob Jackson), Алексу Рею (Alex Ray), Лилиан Венг (Lilian Weng) и Джошуа Ахиаму (Joshua Achiam) за их отзывы о статье.
Спасибо Мире Мурати (Mira Murati), Брук Чан (Brooke Chan), Джастину Джею Вангу (Justin Jay Wang), Грегу Брокману (Greg Brockman), Эшли Пилиписизин (Ashley Pilipiszyn) и Джеку Кларку (Jack Clark) за их работу по поддержке, проектированию, написанию текста и предоставлению отзывов об этой публикации.
Особая благодарность Kenney за множество высококачественных игровых ресурсов, использованных в этих средах.
Выражаем дополнительную благодарность Олегу Домрачеву и Антону Тыщенко (CraftPix.net) за несколько игровых фонов, а также GameArtGuppy и ansimuz. Со всеми лицензиями на ресурсы можно ознакомиться здесь.
Полный текст статьи читайте на OpenAI
