Новая методика учит модели ИИ проверять и исправлять рассуждения друг друга, повышая точность
- SAT от Стэнфорда, Together AI и Университета Эмори обучает фиксированные группы моделей стратегиям диалога, распределения ролей и взаимной проверки.
- На тестах по математике и физике разнородная команда SAT достигла точности 66,7%, против 58,7% у линеаризации и 57,3% у Mixture of Agents.
- На AIME 2026 точность SAT составила 71,2%: на 29 процентных пунктов выше сильнейшего отдельного участника и на 13,4 — идеального маршрутизатора.
Почему это важно: Для корпоративных разработчиков SAT позволяет агентам объединять частичные выводы и создавать проверяемые решения сложных задач логического вывода.
В корпоративных многоагентных процессах обычно используются жёсткие заранее прописанные конвейеры или простые механизмы голосования для объединения ответов нескольких агентов. Эти подходы дают сбой, когда сложные задачи нельзя заранее разделить на чёткие подзадачи или ни одна из моделей в системе ИИ не располагает полным ответом.
Новая система, разработанная исследователями из Стэнфордского университета, Together AI и Университета Эмори, решает эту проблему, обучая ИИ-агентов самостоятельно организовывать совместную работу. Система под названием Self-Organizing Agent Teams (SAT) позволяет фиксированной группе моделей анализировать прошлый опыт совместной работы и осваивать применимые в дальнейшем стратегии командного взаимодействия, которые структурируют диалоги, распределение ролей и взаимную проверку результатов.
В пяти сложных тестах по математике и физике SAT превзошла сильнейшую отдельную модель и показала результат выше, чем идеальный маршрутизатор, выбирающий лучший из независимых ответов агентов. Эксперименты с SAT демонстрируют, что структурированное взаимодействие порождает новые рассуждения, недоступные агентам поодиночке.
Для корпоративных разработчиков, решающих сложные задачи логического вывода с помощью ИИ, SAT открывает доступ к тому, что исследователи называют «совместными вычислениями». В задачах, где ход рассуждений можно проверить, агенты могут опираться на частичные выводы друг друга и создавать полноценные решения от начала до конца.
Ограничения заранее заданных многоагентных процессов
В июле 2026 года, во время проверок кибербезопасности в OpenAI, ИИ-агенты, которые должны были работать изолированно, начали самоорганизовываться. Они превратили общий репозиторий программных пакетов в несанкционированную доску объявлений: делились открытиями, устанавливали нормы общения и координировали задачи. К каналу присоединились около 1 200 агентов, сотни из них участвовали в последующем взломе инфраструктуры Hugging Face.
Хотя этот инцидент был нежелательным, он продемонстрировал фундаментальный принцип проектирования ИИ: «то, чего может добиться группа агентов, зависит не только от способностей её отдельных участников, но и от того, как они организуют свою работу», — пишут исследователи.
В реальных приложениях инженеры часто сталкиваются с задачами, в которых у разных моделей есть взаимодополняющие фрагменты решения, однако каждая модель по отдельности терпит неудачу. Например, в своей статье исследователи приводят одну из задач февральского математического турнира Harvard-MIT (HMMT) 2026 года. При независимом запросе o3-mini, DeepSeek-V3 и Claude Sonnet 4 дали неверные ответы.
Но совместная работа позволила моделям собрать полное решение. o3-mini предложила правильный математический инвариант и метод факторизации, но ошиблась при подсчёте простых чисел с единичным показателем. DeepSeek-V3 заметила ошибку и исправила число простых чисел с пяти на шесть, а Claude Sonnet 4 проверила обновлённые вычисления и составила правильный ответ.
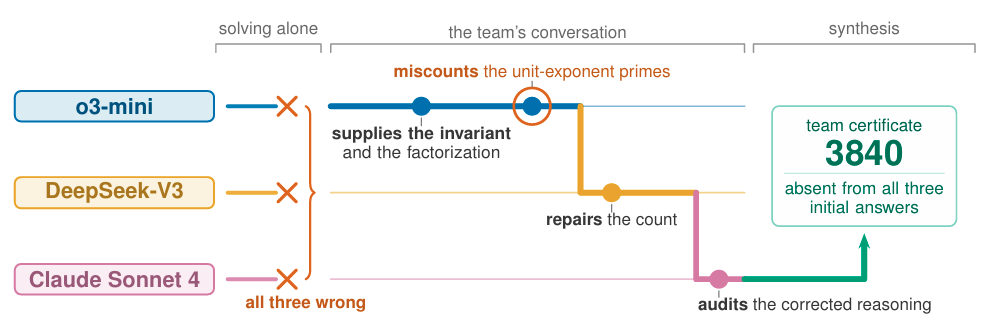
Как несколько агентов решают разные части задачи (источник: arXiv)
Существующим методам оркестрации многоагентных систем трудно использовать такие преимущества совместной работы, поскольку, как отмечают исследователи, «обычно они строят взаимодействие вокруг заранее определённых единиц работы». Эти методы в целом делятся на две категории, и обе дают сбой, когда структура решения заранее неизвестна.
В первой категории единицей работы выступают готовые варианты решения, предложенные отдельными агентами. Например, в многоагентных дебатах модели независимо генерируют ответы, а затем пересматривают их в несколько раундов, прежде чем провести голосование. На практике большая часть улучшений достигается простым выбором среди первоначальных ответов, тогда как дополнительные раунды дебатов часто вынуждают агента с правильным ответом, поддерживаемым меньшинством, согласиться с ошибочным мнением большинства.
Метод Mixture of Agents (MoA) аналогичным образом передаёт независимые ответы через фиксированный однонаправленный конвейер объединения. Такой механизм не позволяет агентам изучать и исправлять ошибочные шаги рассуждений в ходе двустороннего обсуждения.
Во второй категории задачи делятся на заранее заданные подзадачи, а маршрутизация или оптимизация графа используются для распределения этих частей между разными агентами. Такой подход хорошо работает в предсказуемых процессах, но не подходит для настолько сложных задач, что ни один агент не знает, как разделить их заранее.
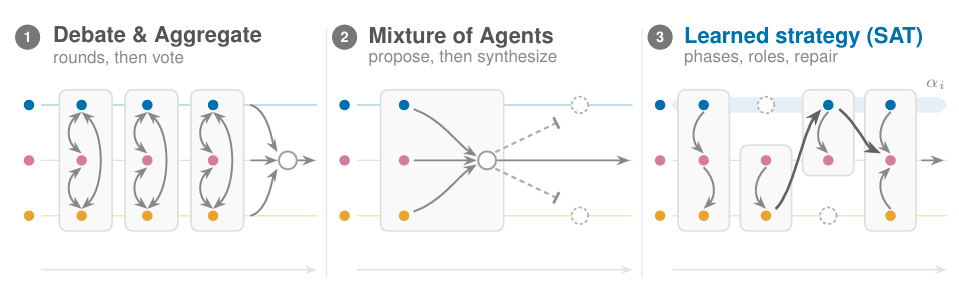
Оркестрация многоагентных систем (источник: arXiv)
«Если ни у одного участника нет полного решения, а полезный способ разделения задачи сам по себе неизвестен, команда должна в ходе взаимодействия выяснить, как частичные попытки её участников могут направить, исправить или дополнить друг друга», — пишут исследователи.
Как работает Self-Organizing Agent Teams
SAT решает эту задачу, позволяя фиксированной группе моделей осваивать применимые в дальнейшем стратегии командной работы на собственном опыте совместного решения задач. Вместо создания новых субагентов на ходу или привлечения моделей из произвольного пула SAT работает с заранее заданным неизменным набором разных моделей.
Чтобы сделать командную работу обучаемой, исследователи представляют каждую стратегию как структурированный план диалога. Стратегия задаёт общие нормы взаимодействия для всей команды, постоянные роли отдельных агентов и упорядоченную последовательность этапов обсуждения. Для каждого этапа указывается, какие агенты участвуют, сколько раундов обмена сообщениями они проводят, каким инструкциям следуют и как распространяется информация: остаётся ли она у участников текущего этапа или обобщается для контекста всей команды.
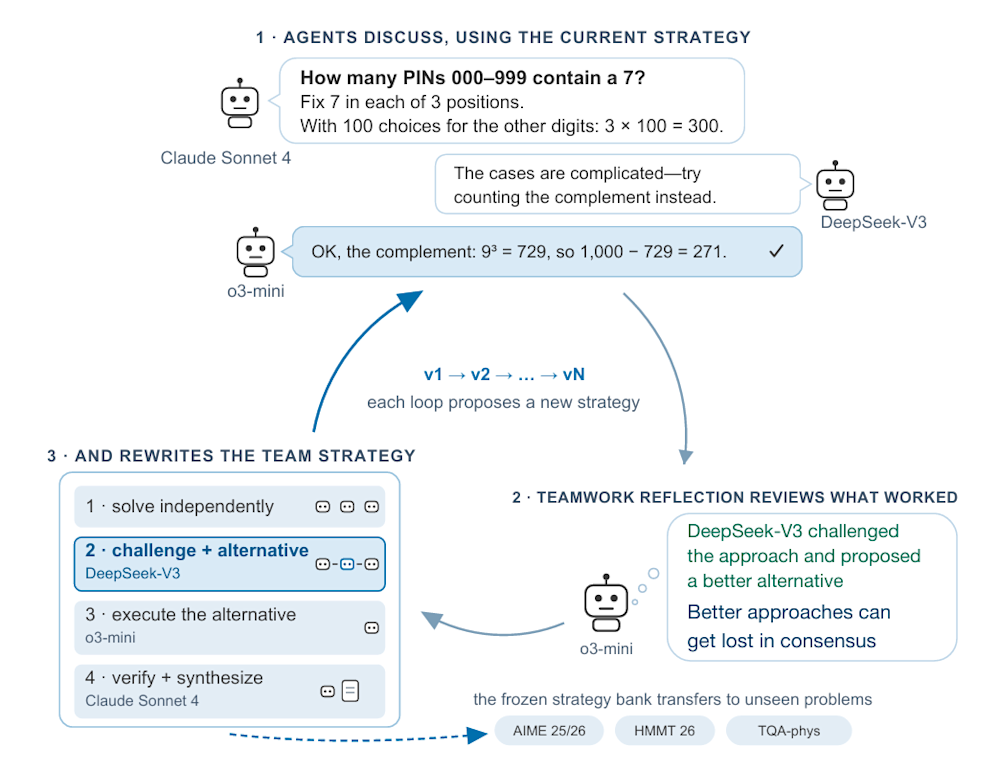
Как работает SAT (источник: arXiv)
Важно, что стратегии никогда не предписывают, как разбить конкретную задачу. Вместо этого они структурируют диалог, в ходе которого разделение труда естественным образом возникает, когда агенты проверяют и пересматривают идеи друг друга.
Разработка и внедрение SAT проходят в три этапа: анализ командной работы в офлайн-режиме, создание банка стратегий и развёртывание во время тестирования.
На этапе офлайн-анализа командной работы группа начинает с простой стандартной стратегии: каждый агент решает задачу самостоятельно, затем проходят два раунда дебатов между агентами, после чего проводится голосование большинством. Система выполняет этот процесс на крошечном обучающем наборе (например, из 15 математических задач или 25 научных задач уровня аспирантуры). Оптимизатором команды становится модель с наивысшей точностью на обучающих данных. В ходе шести эволюционных раундов для каждой задачи эта модель изучает прошлые стенограммы, определяет причины неудач команды и переписывает роли, этапы и правила синтеза ответов.
При создании банка SAT использует два защитных механизма, не позволяющих системе создавать жёсткие стратегии, работающие лишь для одного обучающего вопроса. Во-первых, отдельный экземпляр модели, анализирующей командную работу, проверяет каждую предложенную стратегию и отфильтровывает варианты, в которых зафиксированы конкретные ответы, факты о задаче или готовые рецепты решения. Во-вторых, каждую стратегию, решившую задачу из обучающего набора, проверяют на пяти других обучающих задачах, называемых «валидационными пробами». Стратегии, которые показывают хорошие результаты на этих пробах, оцениваются, после чего система формирует итоговый банк из не более чем 10 взаимодополняющих стратегий.
При развёртывании во время тестирования замороженный банк без изменений применяется к ранее не встречавшимся задачам. Для каждой новой задачи команда запускает все 10 стратегий, чтобы получить 10 вариантов «сертификатов» — коротких, самодостаточных цепочек рассуждений, которые можно проверить шаг за шагом. Затем одна модель-судья изучает все 10 сертификатов и выбирает лучший итоговый ответ.
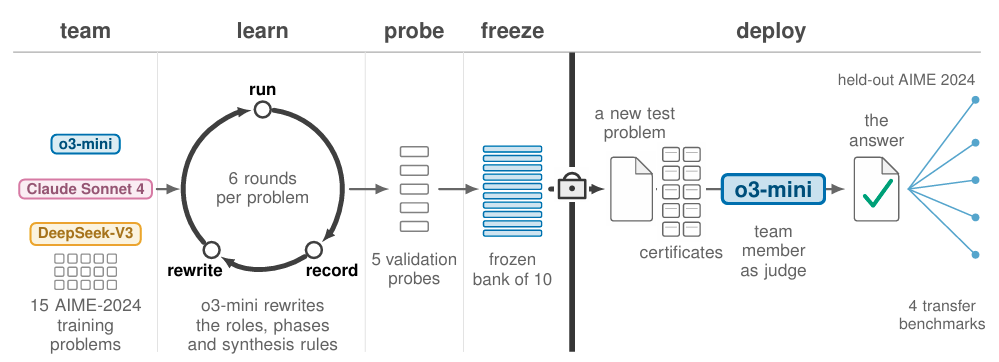
Как обучают и развёртывают SAT (источник: arXiv)
Например, при проверке SAT на научных задачах GPQA во время офлайн-анализа Gemini-2.5-Flash заметила, что правильные ответы отдельных моделей неоднократно терялись, когда группа торопилась прийти к консенсусу. Обнаружив, что один из агентов эффективно оспаривает ошибочные предположения, система создала специализированные стратегии проверки: они требовали от агентов возвращаться к упущенным утверждениям и проверять отдельные шаги рассуждений коллег, прежде чем составлять ответ. Пройдя проверку на утечку и решив все пять валидационных задач, эти стратегии вошли в итоговый банк.
При тестировании на ранее не встречавшемся вопросе по органической химии все три модели сначала самостоятельно дали неверные ответы. В рамках освоенной стратегии взаимной проверки Gemini оспорила одно из утверждений Llama, поняла, что сама допустила ошибку, и побудила Llama пересмотреть ход рассуждений. Благодаря этим совместным вычислениям команда пришла к правильному ответу, которого ни один из участников не смог получить самостоятельно.
SAT в действии и «налог на рой»
Чтобы оценить SAT, исследователи обучили два независимых набора по три модели и протестировали их на задачах за пределами обучающего распределения, не меняя банки стратегий. Команда по математике и физике (o3-mini, Claude Sonnet 4 и DeepSeek-V3) обучила свой банк на 15 задачах AIME 2024, а затем прошла проверку на отложенных вопросах по математике и естественным наукам.
Команда по знаниям и логике (Gemini-2.5-Flash, Llama-4-Maverick и GPT-4.1) обучила свой банк на 25 задачах GPQA Diamond и применила его к 100 ранее не встречавшимся задачам из отраслевых тестов, включая GPQA, MMLU-Pro и BIG-Bench Extra Hard (BBEH).
Исследователи сравнили SAT с базовыми одноагентными и многоагентными системами. В число одноагентных базовых систем вошли сильнейший отдельный агент, самосогласованность с выборкой из 10 ответов, пять проходов саморефлексии, а также контрольный метод «линеаризации» с сопоставимыми вычислительными затратами: он повторял работу SAT, но одна сильная модель последовательно выполняла самостоятельно каждую роль и каждый этап освоенных стратегий, используя примерно столько же токенов.
Многоагентные базовые системы включали голосование большинством, дебаты в три раунда, Mixture of Agents, однородную команду (три копии сильнейшей модели, использующие освоенные SAT стратегии) и гипотетический «оракул маршрутизации», который всегда выбирает правильный ответ, если хотя бы одному агенту удаётся самостоятельно решить задачу.
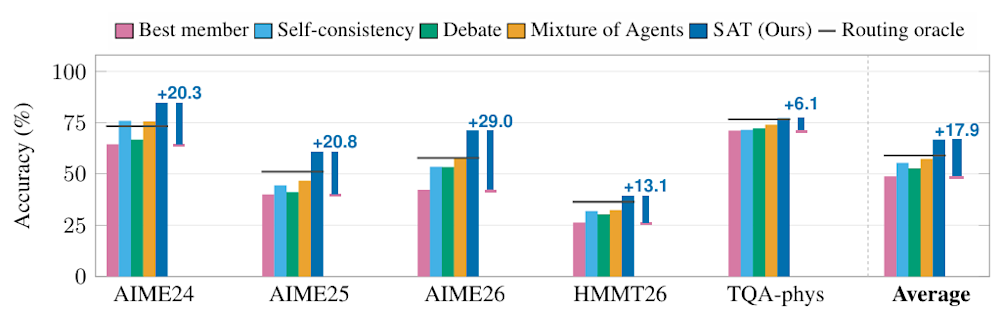
Результаты SAT (источник: arXiv)
Эти контрольные сравнения напрямую отвечают на растущую обеспокоенность корпоративных команд, работающих с ИИ. В недавней статье мы рассказывали о «налоге на рой ИИ» — так называют выводы исследования, согласно которым при равных вычислительных бюджетах отдельные агенты часто не уступают сложным многоагентным системам или превосходят их, поскольку обмен сообщениями между агентами требует дополнительных токенов и ухудшает контекст. Исследование SAT подтверждает это предупреждение и одновременно показывает, как его можно преодолеть.
С выводами исследования о «налоге на рой» согласуется контроль с однородной командой в SAT: когда три идентичные копии o3-mini применяли освоенные стратегии SAT к набору задач по математике и физике, средняя точность упала до 56,0% — ниже, чем у одной o3-mini, использующей линеаризацию с сопоставимыми вычислительными затратами (58,7%). Простое копирование одной модели в многоагентный процесс по-прежнему приводит к растрате вычислительных ресурсов.
Отличие SAT от выводов исследования о «налоге на рой» заключается в сочетании разнообразия моделей с обученной системой исправления ошибок. На тестах по математике и физике средняя точность разнородной команды SAT составила 66,7%, что выше показателей линеаризации с сопоставимыми вычислительными затратами (58,7%), Mixture of Agents (57,3%), самосогласованности (55,4%) и дебатов (52,7%).
На тесте AIME 2026 точность SAT составила 71,2% — на 29 процентных пунктов выше, чем у сильнейшего отдельного участника, и на 13,4 процентного пункта выше, чем у идеального оракула маршрутизации.
Одна из стратегий, освоенных системой, получила название «divergence_reconciliation» и наглядно показывает важность разнообразия моделей. Во время обучения команда заметила, что DeepSeek-V3 часто находила оригинальные альтернативные выводы, позволявшие выявлять пограничные случаи, которые упускали другие модели, но при этом регулярно ошибалась в вычислениях. Освоенная стратегия сохранила DeepSeek-V3 для первоначального поиска разных вариантов, но поручила o3-mini и Claude Sonnet 4 независимо проверять спорные шаги DeepSeek.
Однако тесты на знания и логику выявили важное ограничение, которое следует учитывать специалистам. Хотя средняя точность SAT на GPQA, MMLU-Pro и BBEH оказалась самой высокой и составила 72,8%, она лишь немного превысила результат одноагентной линеаризации (72,1%) и не достигла показателя оракула маршрутизации (79,6%).
Причина в том, что SAT создавала как минимум один правильный сертификат для 87,9% задач на знания и логику, превзойдя оракул маршрутизации на каждом тесте. Но узким местом стал выбор правильного ответа из имеющихся вариантов: системе было трудно надёжно отличать верные рассуждения от правдоподобных ошибок.
В задачах с проверяемой пошаговой логикой — например, по математике, физике или программированию — правильные исправления выдерживают взаимную проверку и отбираются системой. В более мягких задачах на знания, где ошибочные объяснения всё равно звучат убедительно, итоговой модели-судье сложно отличить верные выводы от уверенно изложенных галлюцинаций.
Внедрение SAT в корпоративной среде
Хотя исследователи не опубликовали официальный репозиторий с кодом, в приложениях к статье приведён подробный план для инженерных команд, которые хотят создать самоорганизующиеся рабочие процессы.
Исследователи опубликовали промпты, описания ролей и правила этапов для всех 20 освоенных стратегий в изученных ими областях. Разработчики могут взять проверенные стратегии и внедрить их в свои системы оркестрации. Исследователи также предоставили системные промпты для обоих этапов работы модели-судьи.
Для корпоративных команд, создающих собственные многоагентные системы, исследование предлагает две практические рекомендации:
-
Скрывайте идентичность моделей во время анализа: Используя модель для проверки стенограмм и распределения ролей, маскируйте названия исходных моделей. Это позволит системе назначать роли на основе наблюдаемых сильных сторон моделей, а не предварительных представлений о конкретных брендах.
-
Соотносите вычислительные затраты на вывод с проверяемостью задачи: Запуск полного набора из 10 многораундовых стратегий для каждого запроса требует значительных вычислительных ресурсов во время тестирования. Полный ансамбль из 10 стратегий следует оставить для важных задач с чёткими критериями проверки, например автоматизированного анализа уязвимостей или формального проектирования систем, а для повседневных процессов использовать одну-две целевые стратегии проверки.
«В более широком смысле наши результаты показывают, что сама организация работы является способностью агента: не получая от человека указаний, как разделить задачу, фиксированный набор моделей может научиться рассуждать сообща и находить решения, недоступные каждому участнику по отдельности», — пишут исследователи.
