ZGateway: выводы из опыта внедрения прокси перед ZippyDB
- Мы представляем ZGateway — прокси-сервер, который мы используем для унификации трафика в ZippyDB, самом популярном хранилище «ключ-значение» в Meta.
- В качестве бонуса он также обеспечивает контроль допуска (admission control), балансировку нагрузки, межрегиональную отказоустойчивость и расширенные возможности администрирования.
ZippyDB — это самое широко используемое в Meta хранилище типа «ключ-значение», на базе которого работают метаданные продуктов, счетчики и конфигурации. Оно способно обслуживать миллиарды операций в секунду в рамках глобально распределенного парка серверов.
В предыдущей статье рассказывалось о том, как работает ZippyDB. Данная статья посвящена слою, расположенному перед ним: ZGateway — прокси-серверу, через который мы объединяем клиентский трафик ZippyDB.
ZGateway возник из потребности управлять разросшимся парком клиентов ZippyDB, и в итоге его ценность оказалась фундаментальной. Клиентом ZippyDB может быть один из более чем миллиона хостов, принадлежащих сотням команд, которые мы не можем быстро изменить. Прокси находится совершенно в другом положении — на пути множества клиентов одновременно, — и эта общая точка обзора позволяет ему делать то, чего не может ни один отдельный клиент.
Любая из описанных ниже возможностей реализуется проще, безопаснее или вообще возможна только в рамках единого управляемого уровня, а не в миллионах клиентских бинарных файлов. Мы расскажем об этом на двух самых наглядных примерах: управлении соединениями и батчинге (пакетной обработке) запросов.
Почему ZippyDB потребовался уровень прокси
Прокси появляются везде, где большая и разнообразная масса клиентов обращается к общему бэкенду: пул соединений, sidecar-сервис в service mesh, CDN-граница, API-шлюз. Внедрение промеж большого числа вызывающих сторон и общего ресурса дает три преимущества:
- Оно ограничивает проблему: бэкенд перестает видеть разрозненную массу клиентов и начинает видеть парк, контролируемый его собственными операторами.
- Оно создает единое место для общих задач — пулинга, повторных попыток (retries), маршрутизации, кеширования, контроля допуска, — которые решаются один раз командой, лучше всего знающей бэкенд, а не в каждом клиенте.
- Оно создает точку контроля: единственное место, где можно видеть всю рабочую нагрузку, относить нагрузку на счет того, кто ее сгенерировал, и менять поведение за считанные минуты, не дожидаясь развертывания клиентов по всему парку.
Компромисс заключается в дополнительном сетевом переходе и еще одном уровне для обслуживания; эти затраты окупаются, когда клиентская база огромна, разнородна и не находится под вашим управлением. ZippyDB — это крайний случай.
В модели прямого доступа каждый клиент ZippyDB подключается к каждому нужному ему хосту базы данных. Один клиент может затронуть десятки тысяч различных шардов в стабильном окне; эти шарды распределены по сотням тысяч хостов баз данных. В результате получается плотная сеть TLS-соединений типа «многие ко многим»: типичный клиент удерживает десятки тысяч исходящих соединений, а типичный хост базы данных может принимать десятки тысяч входящих.
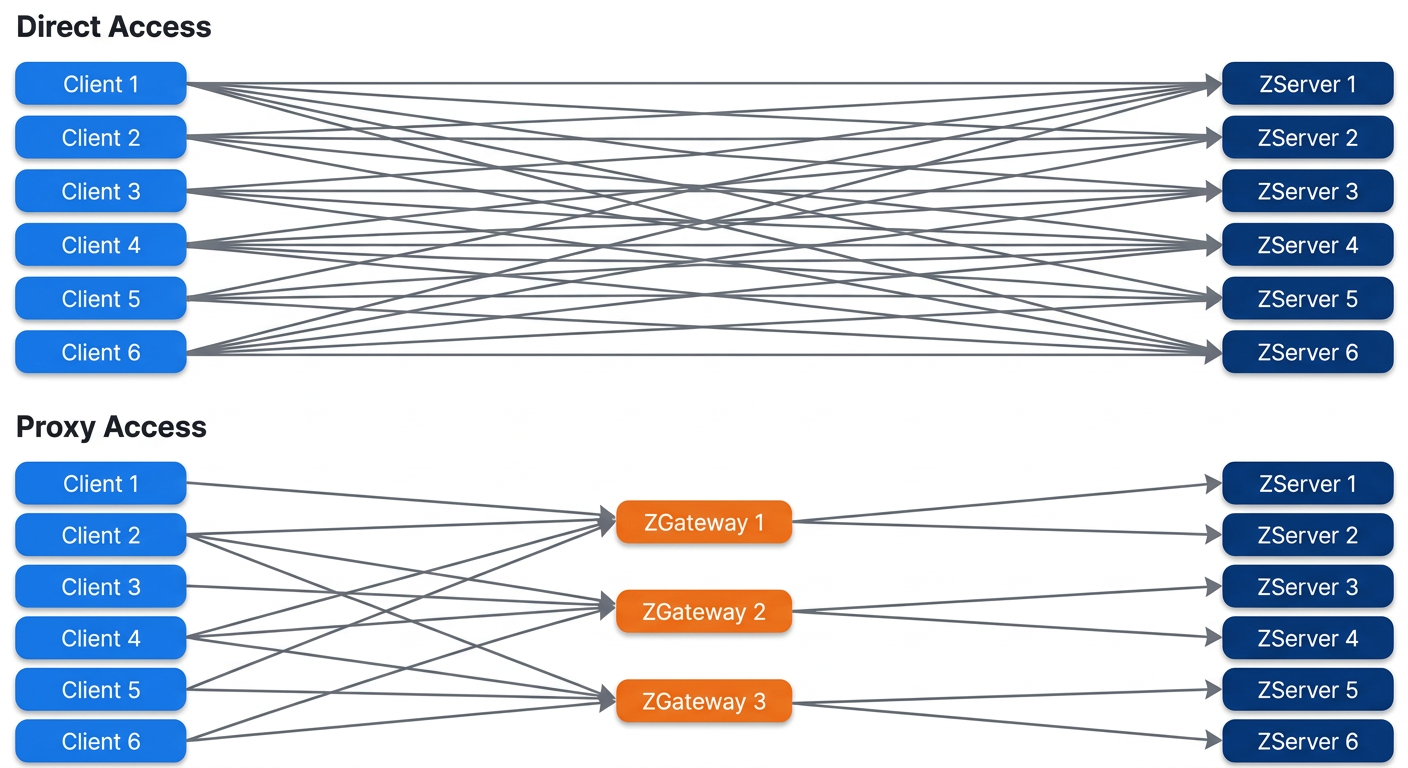 Рисунок 1: Прямой доступ создает неограниченную ячеистую сеть «многие ко многим»; ZGateway сводит разветвление клиентов и хостов БД к фиксированным значениям.
Эта сеть неэффективна и хрупка. Каждое открытое соединение потребляет память, процессорное время и файловый дескриптор на обоих концах, в основном в режиме простоя, а количество входящих соединений растет вместе с клиентской базой, поэтому каждая новая когорта клиентов ухудшает работу любого хоста базы данных. И поскольку каждый клиент управляет собственным пулингом и отказоустойчивостью, внезапное падение повторного использования соединений (перезапуск когорты, деплой) обрушивает на парк шторм новых соединений; мы отслеживали падения хостов из-за исчерпания файловых дескрипторов и OOM (нехватки памяти), вызванные ровно этим.
Эту проблему сложно решить на стороне клиента, потому что одновременно движутся две системы. Клиентские парки продолжают менять политики пулинга и расширяться, в то время как парк баз данных консолидируется по собственному графику. Связывать их напрямую — все равно что прыгать с одной движущейся машины на другую. Прокси разделяет их, сводя ячеистую сеть к двум ограниченным переходам — это выигрыш в эффективности, производительности, масштабируемости и, прежде всего, надежности.
Последний пункт имеет наибольшее значение. При прямом доступе шторм переподключений превращается в катастрофу. В одном из инцидентов ошибка маршрутизации привела к тому, что каждый клиент открыл по соединению на каждый шард, хосты исчерпали лимит файловых дескрипторов, и парк ушел в цикл перезагрузок. С ZGateway на пути этот шторм локализуется на уровне прокси — парка, который мы контролируем, мониторим и можем централизованно защищать. Управление соединениями никуда не исчезает за прокси; оно перемещается в единственное место, где мы можем эффективно его решить.
Прямой доступ был правильным решением для начального этапа жизни ZippyDB. Фактор разветвления (fan-in) масштабируется вместе с клиентской базой, поэтому использование ресурсов растет с ростом популярности: при нескольких тысячах клиентов сеть неэффективна, а в масштабе она становится пределом надежности. Необходимые средства появились вовремя: улучшения функционала ServiceRouter, защита от перегрузок Thrift, тонкий клиент (thin client) и другие особенности сделали возможным создание общего уровня, а создание ZGateway раньше означало бы необходимость предварительной реализации каждой из этих функций.
Что такое ZGateway
ZGateway — это уровень безгранечных (stateless) прокси между клиентами ZippyDB и парком баз данных (ZServer). Он способен обрабатывать более 1 миллиарда операций в секунду и пропускает через себя около 40% всего трафика ZippyDB (планируется рост до более чем 60%), добавляя при этом всего около 6% вычислительных накладных расходов для типичного сценария использования. Он работает в виде региональных уровней, обнаруживаемых с помощью ServiceRouter — решения Meta для гипермасштабируемых сервисных сетей (service mesh), что позволяет удерживать каждого клиента рядом с его шлюзом. ZGateway существует в двух вариантах, разделяющих единый пайплайн: чистый прокси и кеш с упреждающим чтением (read-through cache). В качестве своего движка он использует наш толстый C++ клиент (по одному внутреннему клиенту на каждый сценарий использования). ZGateway — это клиент ZippyDB, запущенный как управляемый сервис, что сделало перенос функционала сюда естественным шагом.
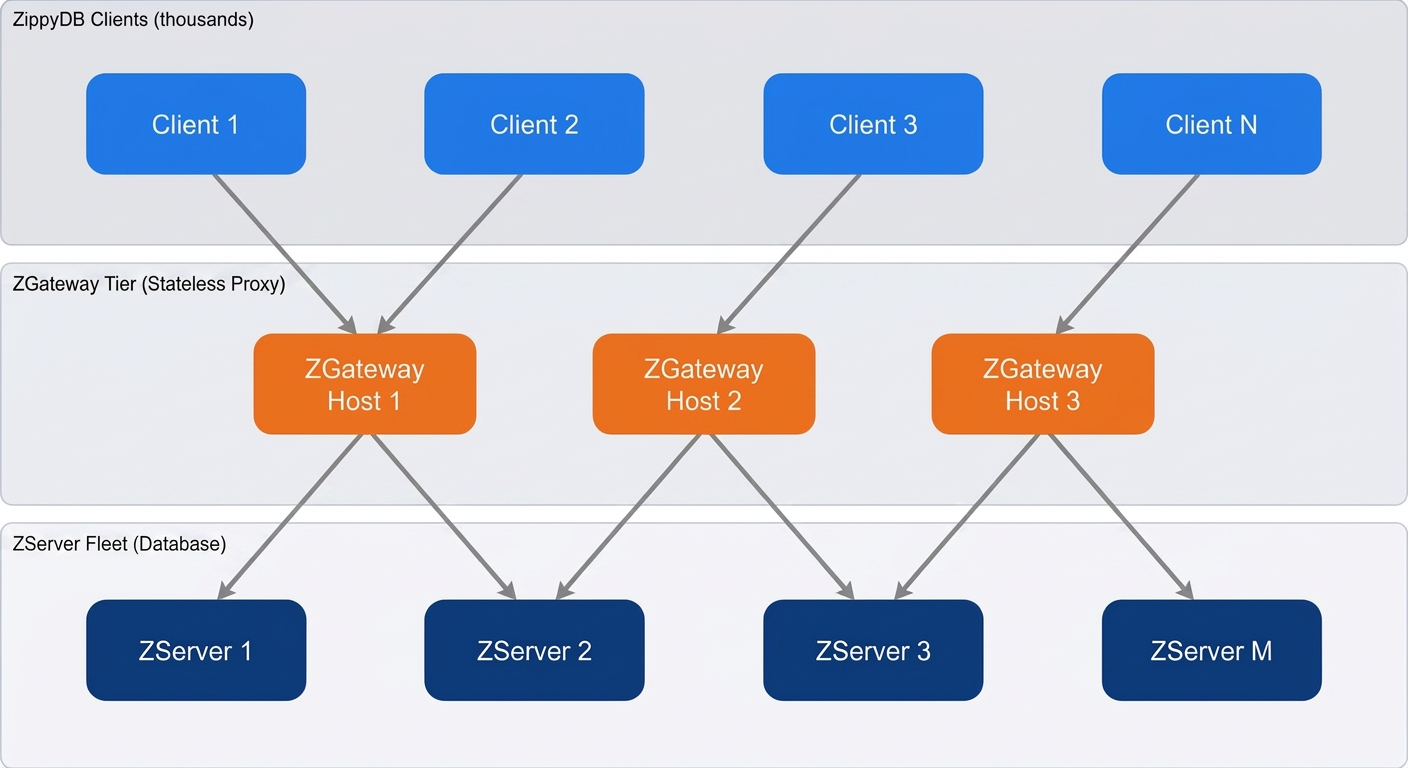 Рисунок 2: Путь запроса через ZGateway — от постоянного регионального соединения клиента до реплик ZServer.
Клиент отправляет запрос по своему постоянному (sticky) соединению на региональный хост ZGateway, который терминирует TLS, проверяет его авторизацию по ACL сценария использования, применяет контроль допуска для конкретного тенанта (tenant), валидацию и формирование потока. ZGateway определяет шард, проверяет локальный кеш на уровне кеширования, а также объединяет в пакеты промахи кеша и операции записи вместе с другими выполняющимися запросами для этого шарда перед отправкой их на правильные реплики. Ответы демультиплексируются обратно вызывающим абонентам, при этом по ходу дела фиксируются метрики для каждого сценария использования, трассировки и использование квот.
Ключевым свойством является асимметрия количества соединений. Каждому клиенту требуется лишь пул постоянных соединений с хостами регионального ZGateway, а каждый ZServer видит соединения только от парка ZGateway, размер которого мы контролируем. Некоторые обязанности намеренно остаются на прежних местах: TLS в стеке Thrift/ServiceRouter, сопоставление ключей с шардами в локаторе шардов, выбор реплик и хеджирование во встроенном клиенте. ZGateway отвечает за управление трафиком, а не за переписывание базы данных на стороне клиента.
Сокращение коэффициентов разветвления (Fan-In / Fan-Out)
Вот математика:
Представим парк в виде задачи о шарах и корзинах. Бросим B шаров (шардов, к которым обращается хост) в H корзин (хостов) и посчитаем количество затронутых уникальных корзин.
Ожидаемое число составляет:

А конкретная корзина затрагивается с вероятностью:

Fan-out — это количество затронутых уникальных корзин; fan-in — это эта вероятность, умноженная на количество вызывающих абонентов. При округленных цифрах модели (20 регионов, 500 000 хостов баз данных, 30 000 прокси-хостов, 1 000 000 клиентов, 50 000 шардов на клиента) получаем:
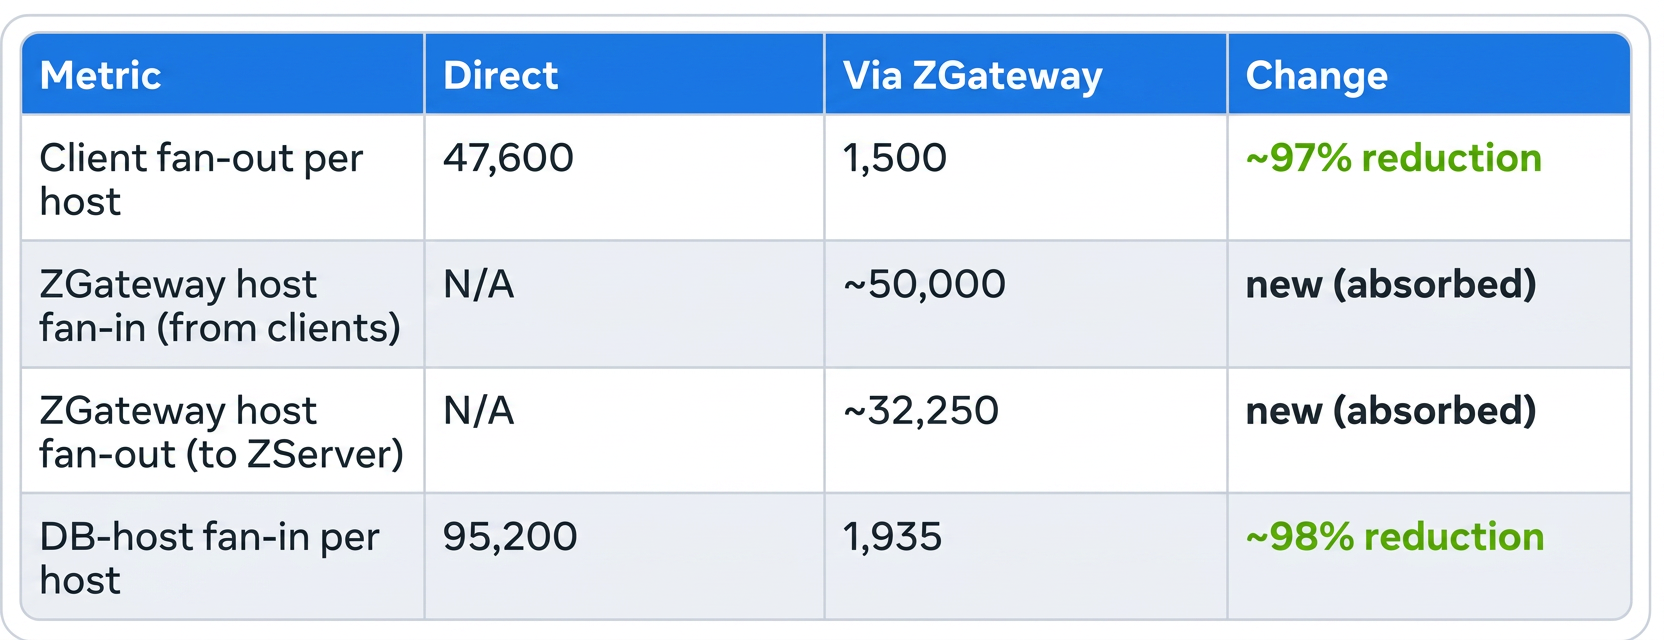 Рисунок 3: Количество соединений на один хост сокращается примерно на 97–98%. (Оценка на основе модели; множитель TLS для каждой пары сокращается в соотношении).
Соединения не исчезают бесследно; они перемещаются на уровень, созданный для их удержания. В целом общее число постоянных соединений все равно сокращается примерно в 19 раз, поскольку каждое соединение бэкенда мультиплексирует множество клиентов.
Но единовременное сокращение, каким бы впечатляющим оно ни было, — не главная цель. Главное — это изменение характера масштабирования. В модели прямого доступа fan-out для хоста базы данных равен H_client · p — линейно зависит от клиентской базы, поэтому каждая новая когорта ухудшает работу каждого хоста БД. С ZGateway клиентская база полностью исключается из уравнения: fan-out сводится примерно к R · S_host (регионы, умноженные на плотность шардов на хост), независимо от обоих парков. Единственным рычагом остается плотность шардов, которой управляем мы. Неконтролируемое число, определяемое всеми остальными, превращается в ограниченное число, которое контролируем мы.
Свертка потока запросов: батчинг и коалесценция
Поскольку ZGateway находится на пути множества клиентов, он может делать то, чего не способна ни одна клиентская библиотека, — объединять работу независимых вызывающих сторон. Общий батчер на каждом хосте группирует запросы, направляющиеся к одному и тому же пункту назначения, по сценарию использования и физическому шарду, и объединяет их в один RPC-запрос к бэкенду.
Он также производит коалесценцию (объединение одинаковых запросов). Если несколько вызывающих сторон запрашивают один и тот же ключ в один и тот же момент, шлюз извлекает его один раз и рассылает результат всем. Клиентский батчер может объединять запросы только своего собственного процесса; шлюз же объединяет их между клиентами.
Каждый RPC-запрос несет фиксированные накладные расходы независимо от своего размера (сериализация Thrift, поиск шарда, авторизация, системные вызовы), поэтому сведение множества операций в одну амортизирует все эти затраты. Это означает меньшее число более крупных запросов к бэкенду, снижение QPS и нагрузки на процессор, а также более стабильную нагрузку, поскольку окно задержки (linger window) сглаживает микропики. И поскольку тарификация сценария использования ведется по отправляемому QPS, батчинг расширяет его лимит запросов, снижая уровень троттлига без каких-либо усилий с его стороны.
Два преимущества батчинга вообще не связаны с производительностью. Первое — это то, как коалесценция работает при появлении горячего ключа (hot key). Тысячи одновременных запросов схлопываются в одно чтение из бэкенда, поэтому горячий ключ больше никогда не сможет вызвать лавинообразную нагрузку (stampede) на одну реплику.
Второе — это то, от чего он позволяет нам избавиться. Годами клиенты, которым требовался батчинг, использовали клиентские библиотеки, которые были хрупкими, требовательными к процессору, настраивались индивидуально и являлись постоянным источником инцидентов, потому что эта сложность была зашита в миллионе неконтролируемых нами бинарных файлов. Общий батчер объединяет запросы от разных клиентов (чего те библиотеки делать не умели) и позволяет нам отправить их в отставку.
Каждый запрос помещается в пакет, хранящийся в памяти, который сбрасывается (flushes), когда истекает окно задержки, объем данных превышает лимит размера или количество запросов достигает предела, благодаря чему дополнительная задержка остается ограниченной. Слишком большие или только что мигрировавшие пакеты обрабатываются традиционной отправкой отдельных запросов. Хранение запросов в памяти сопряжено с риском OOM, поэтому батчинг поставляется с двумя защитными механизмами.
Выселение простаивающих элементов (idle eviction) справляется с медленным ростом: записи в карте пакетов, простаивающие дольше TTL, стираются при следующем сбросе. Ограничение количества выполняющихся запросов (in-flight cap) справляется с острой перегрузкой. Когда бэкенд замедляется, корутины, выполняющие сброшенные пакеты, накапливаются быстрее, чем освобождаются, поэтому лимит отклоняет новые выполнения, как только счетчик превышает порог. Постоянная гигиена плюс аварийный клапан — вот что делает батчинг безопасным по умолчанию.
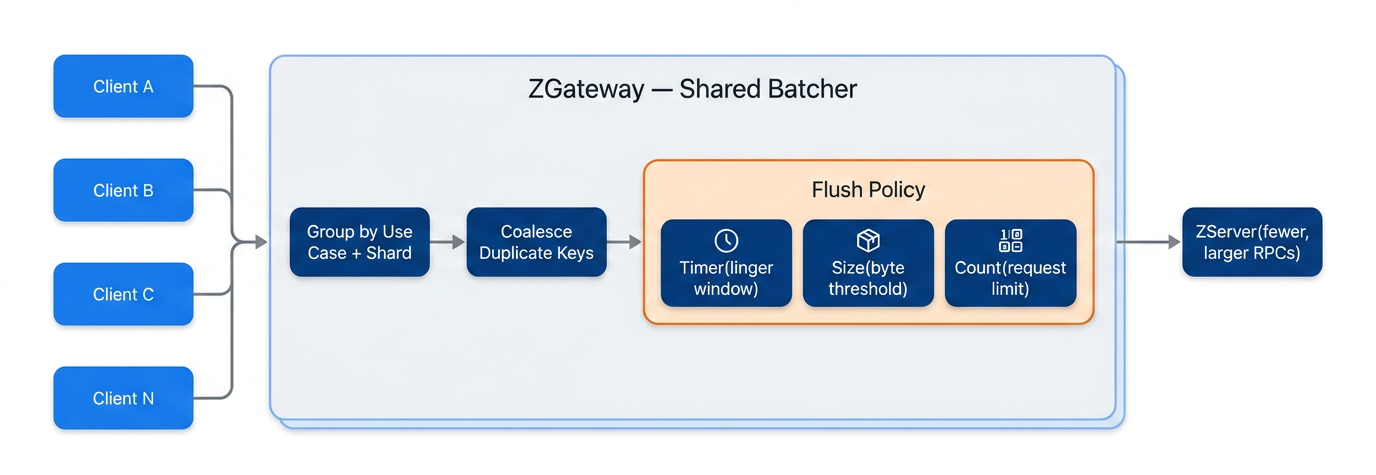 Рисунок 4: Батчинг и коалесценция запросов от разных клиентов.
Эволюция ZGateway
Как только весь трафик начинает проходить через один уровень, он становится идеальным местом для реализации функций, которые в противном случае каждый клиент реализовывал бы заново. Батчинг — самый наглядный пример; вот остальные.
Маршрутизация трафика и безопасный путь миграции
Перевод трафика на прокси — это рискованная миграция. Она должна быть инкрементальной, обратимой и ограниченной по области применения. Маршрутизация в ZGateway управляется клиентскими флагами конфигурации для каждого сервиса и префикса шарда: процентный регулятор плавно наращивает подходящий трафик, региональный фильтр ограничивает зону поражения, а глобальный аварийный выключатель (kill switch) обеспечивает мгновенный откат. Это чистая конфигурация без изменения клиентского кода, что позволяет контролировать процесс развертывания в реальном времени.
Изоляция тенантов и контроль допуска (Admission Control)
Общий уровень обслуживает сотни сценариев использования, поэтому один некорректно работающий тенант не должен ущемлять остальные. Защита ZGateway основана на дискриминантном сбросе нагрузки (Discriminant Load Shedding — DLS). Каждый запрос попадает в корзину конкретного тенанта с ключом по сценарию использования и разделением по приоритету, а опорожнение корзин происходит в порядке кругового обряда (round-robin). Когда тенант перегружает уровень, его собственная корзина переполняется, и излишки запросов сбрасываются, в то время как все остальные корзины продолжают обслуживаться. Это изоляция как свойство архитектуры, а не результат удачи. Перед DLS контроллер параллелизма CPU использует цикл AIMD (аддитивное увеличение / мультипликативное уменьшение) для регулирования скорости поступления работы в общий токен-бакет; менеджер памяти защищает от OOM аналогичным образом.
Сброс нагрузки остается дискриминантным. В условиях контролируемой перегрузки при нагрузке на процессор >90% примерно по 1 350 активным корзинам тенантов сбрасывали запросы только 6 из них (реальные «шумные соседи»); остальные ~1 344 выполнили 99,9% своих запросов без единого отклонения, эффективная пропускная способность (goodput) держалась на уровне 97–98%, а накладные расходы механизмов составили около 8% CPU.
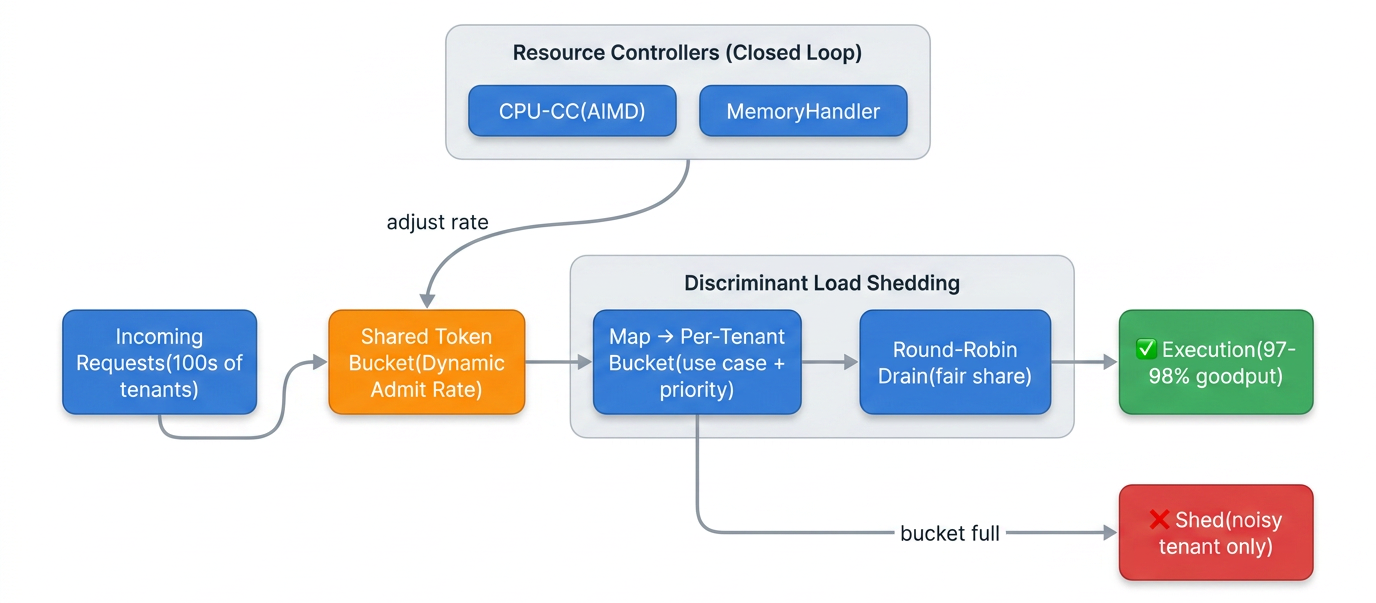 Рисунок 5: Дискриминантный сброс нагрузки в условиях перегрузки.
Кеширование чтения с динамической инвалидацией
На уровне кеширования горячие чтения обслуживаются из внутрипроцессного кеша; при промахе шлюз захватывает блокировку заполнения для конкретного ключа (fill lock), поэтому лавинообразный наплыв запросов (thundering herd) к одному ключу сводится к одному обращению к бэкенду. Актуальность данных поддерживается потоком изменений (change-data-capture stream) событий записи и чекпоинтов, который инвалидирует или перезаполняет затронутые записи в рамках строгого контракта ограниченной устареваемости (bounded-staleness). Каждый хост владеет частью пространства ключей благодаря согласующемуся хешированию (consistent hashing). Результатом является существенная разгрузка хранилища по чтению с меньшей задержкой и без потери корректности данных.
Балансировка нагрузки на уровне
Поскольку ZGateway не имеет состояния, любой запрос может быть обслужен любым хостом в региональном уровне, что позволяет нам перенаправлять трафик для выравнивания нагрузки. Этот уровень неоднороден: в нем смешаны хосты с количеством ядер от ~26 до ~126, а масштабная замена задач может перетасовать емкость за считанные минуты. Равное отношение к неравным хостам порождает горячие узлы-выбросы, а перегруженный хост ZGateway приводит к скаскам ошибок и троттлингу в ServiceRouter. Поскольку ServiceRouter выполняет маршрутизацию на основе взвешенного согласованного хеширования, рычагом управления здесь является правильный вес каждого хоста.
Балансировщик плоскости управления вычисляет эти веса. С фиксированной периодичностью он считывает недавнее использование ЦП каждым хостом, нормализует среднее значение по уровню до 1.0 и корректирует вес каждого хоста обратно пропорционально его нагрузке. Предохранители обеспечивают стабильность: корректировки затухают и ограничиваются, распределение центрируется вокруг целевого медианного значения, чтобы веса не стремились к нулю, а ограничитель изменений переносит только самые несбалансированные хосты за один проход, минимизируя перетасовку шардов (что дорого обходится на кеширующих уровнях, где изменение веса означает перемещение ключей). Новые хосты запускаются с весом, масштабированным под аппаратные возможности.
Урок заключается в том, что одна фиксированная политика не может одинаково хорошо обслуживать как спокойный уровень, так и уровень в состоянии шока. Поэтому балансировщик становится адаптивным: он классифицирует состояние каждого уровня (устойчивый дрейф, смена задач, плоские начальные веса, бимодальная нагрузка, горячие выбросы, региональный перекос) и применяет соответствующую политику.
Межрегиональная отказоустойчивость
Большую часть времени ZGateway оставался строго региональным, и отказоустойчивость ограничивалась рамками одного региона. Это отлично подходит для задержек, но когда под давлением оказывается региональный уровень целиком, запросы встают в очередь и локально превышают тайм-аут, в то время как здоровая емкость простаивает по соседству. Поскольку ZGateway работает поверх ServiceRouter, мы можем разрешить маршрутизации пересекать границы регионов контролируемым образом с помощью трех механизмов:
- Глобальная маршрутизация строит таблицу маршрутизации, охватывающую регионы, поэтому насыщенный локальный уровень переключается на здоровый вместо того, чтобы «умирать» дома.
- Мегарегионы объединяют географически близкие регионы в единую локацию, благодаря чему избыток трафика перетекает поблизости, сохраняя большую часть выигрыша в задержке.
- Кольца явно определяют, какие регионы страхуют друг друга и в каких пропорциях.
Каждый из этих механизмов включается для каждого уровня и региона с помощью процентного регулятора. Сигнал переключения при отказе оказался не менее важен, чем сама маршрутизация. Простое среднее значение загрузки ЦП по региону сглаживает именно те критические ситуации, которые нам необходимо вовремя фиксировать, поэтому аварийное переключение опирается на более точный показатель, настроенный на срабатывание до того, как регион сорвется в перегрузку, а не после.
Транзакции и расширенные операции
Транзакции требуют места для хранения клиентских метаданных: набора прочитанных данных (read set), отсканированных диапазонов, ожидающих записей. Исторически это размещалось в толстом клиенте. Когда ZGateway перевел клиентов на тонкую архитектуру, этот функционал пришлось перенести на шлюз. Первая попытка оставила две параллельные реализации — специализированное хранилище для ZGateway наряду с путем обработки в памяти, который уже использовал наш движок, — две версии наиболее критичной к корректности части потока.
Мы объединили их в одну реализацию за флагом, пройдя девять фаз вплоть до регионов с наибольшим объемом трафика, и достигли 100% транзакционного трафика без ухудшения надежности. Совместное использование этого пути с движком позволяет ZGateway идти нога в ногу с эволюцией серверных транзакций: возможность совершенствуется один раз внутри уровня, и ее получают все клиенты.
Эксплуатация ZGateway в продакшене
ZGateway работает на огромном объеме серверов в десятках регионов, разделенных на несколько уровней в зависимости от рабочей нагрузки: один большой универсальный уровень для длинного хвоста сценариев использования, выделенные уровни для крупнейших клиентов и отдельный высокопроизводительный прокси-уровень. Они различаются по занимаемым ресурсам и масштабу более чем на порядок, причем отдельные уровни также неоднородны, во многом из-за упаковки. Множество задач упаковывается на одну машину с различной плотностью рядом с полноразмерными выделенными хостами. Во всем этом ZGateway предоставляет богатые возможности наблюдаемости для каждого сценария использования — ту самую видимость, которая делает описанные выше контроль допуска и балансировку безопасными на общей инфраструктуре.
Дальнейшие планы развития ZGateway
Краткосрочная стратегия по унификации всего трафика ZippyDB через ZGateway остается неизменной. Более интересный вопрос заключается в том, что становится возможным благодаря повсеместно внедренному шлюзу. Выделяются три направления, и все они объединены общей темой: ZGateway видит больше всех и принимает решения лучше всех.
Эвристика под управлением агентов. Почти каждая функция здесь управляется циклом обратной связи и настроенными вручную регуляторами: размеры корзин сброса нагрузки и пороги ЦП, параметры балансировщика, триггеры отказоустойчивости, окна сброса пакетов, границы устареваемости кеша. Сегодня они настраиваются людьми и корректируются по cron; упомянутый выше адаптивный балансировщик уже является агентом во всем, кроме названия. Следующий шаг — сделать это явно, предоставить эти эвристики и внутреннее состояние в виде структурированной панели управления и позволить ИИ-агентам следить за той же телеметрией, что и мы: диагностировать состояние уровней, связывать инцидент с «шумным» тенантом и применять исправления в рамках предохранителей быстрее, чем это сделает дежурный инженер.
Размещение рядом (Co-location). ZGateway представляет собой отдельный уровень, что влечет за собой дополнительные сетевые расходы и несколько процентов накладных расходов. Для рабочих нагрузок, критичных к задержкам или эффективности, мы можем сдвинуть часть шлюза вниз, ближе к хосту ZServer, так что сегмент шлюз↔сервер превратится в локальный вызов, в то время как плоскость управления останется централизованной. Главная сложность — сделать это без повторного связывания парков, которые мы сознательно разделили. Интерфейс управления соединениями и контроля допуска остается общим региональным уровнем, а вниз переносится только то, чему полезна локальность данных.
Многопроцессорный шлюз. ZGateway выполняет множество различных функций в рамках одного процесса, поэтому сбой памяти одного тенанта может угрожать всему на хосте. Разделение его на взаимодействующие процессы (фронтенд соединений/TLS, воркеры запросов, отдельные компоненты кеша и транзакций) обеспечивает жесткую изоляцию сбоев и независимый жизненный цикл. Это также дополняется эвристиками под управлением агентов и совместным размещением: агенты могут управлять парком процессов на хосте, а совместное размещение становится чище, когда уровень данных сам по себе является отдельным размещаемым процессом.
Все это вместе превращает ZGateway из «умного» уровня в программируемый — с решениями по управлению, принимаемыми агентами, инфраструктурой, перемещающейся туда, где есть работа, и зонами отказов, изолированными по определению.
