Внутри Prometheus: путь Meta к суперкластеру гигаваттного масштаба
- Meta завершила первый этап Prometheus в Нью-Олбани, использовав его для обучения базовых моделей Muse.
- Сейчас кластер объединяет сотни тысяч GPU; после расширения их число составит около 1 млн.
- Полезная производительность при обучении Muse Wonder превысила 85% для предварительного обучения и 90% для обучения с подкреплением.
Почему это важно: Вычислительные мощности Prometheus позволяют создавать более крупные модели и использовать более длинные контекстные окна.
- С недавним выпуском семейства базовых моделей Muse мы хотим рассказать об инфраструктуре, благодаря которой это стало возможным.
- Первый этап создания Prometheus, нашего суперкластера гигаваттного масштаба, уже завершён, и мы работаем над его расширением примерно до 1 млн GPU.
- В Prometheus также используются такие технологии, как жидкостное охлаждение с замкнутым контуром, которое помогает повысить эффективность работы.
Сейчас в Нью-Олбани, штат Огайо, Meta реализует самый амбициозный на сегодняшний день проект в области ИИ-инфраструктуры. Prometheus, наш суперкластер гигаваттного масштаба, — это новый шаг в развитии нашей инфраструктуры. На нём обучаются модели нового поколения, которые откроют миллиардам людей новые возможности использования ИИ.
Два года назад в Нью-Олбани находился обычный дата-центр, обслуживавший веб-трафик. Благодаря достижениям в области аппаратного обеспечения, сетевых технологий и проектирования зданий мы переоборудовали эту площадку для обучения передовых моделей. Мы создаём суперкластер поэтапно. Первый этап уже завершён и использовался для обучения наших базовых моделей Muse, в том числе моделей Muse Wonder — наших новых передовых моделей, обеспечивающих лучшие в отрасли результаты при выполнении агентных задач в личной и профессиональной сферах.
Для эффективного выполнения крупных задач обучения все компоненты должны работать оптимально: неполадка на одном сервере может замедлить или остановить всю задачу, снизив её «полезную производительность». Сосредоточившись на повышении стабильности и надёжности наших систем, мы добились полезной производительности выше 85% при предварительном обучении и выше 90% при обучении с подкреплением (RL) моделей Muse Wonder. Во время этих обучающих запусков среднее время наработки на перерыв (MTBI) в пересчёте на фактическое время работы составило около 47 тыс. GPU-часов. С тех пор мы внесли дополнительные изменения во весь парк оборудования, включая исправления прошивок, благодаря которым MTBI превысило 54 тыс. GPU-часов. Мы продолжаем его повышать.
Теперь мы продолжаем расширять Prometheus, ориентируясь на наши следующие передовые модели, разрабатываемые Meta Superintelligence Labs.
Суперкластер Prometheus размещён в дата-центре Meta в Нью-Олбани, штат Огайо.
Суперкластер: новые возможности ИИ
Сегодня Prometheus объединяет сотни тысяч GPU в нескольких взаимосвязанных зданиях — это традиционные дата-центры, здания, оптимизированные для ИИ, и быстроразворачиваемые сооружения. Все они соединены тысячами километров оптоволокна и работают как единая машина.
Благодаря таким вычислительным мощностям мы можем создавать более крупные модели и использовать более длинные контекстные окна, чем это было практически возможно раньше. После выхода на полную мощность Prometheus будет объединять около 1 млн распределённых GPU, работающих синхронно.
Несколько поколений оборудования для ИИ
В Prometheus сейчас используются две платформы GPU NVIDIA, а вскоре появится третья — на базе Vera Rubin NVL72 от NVIDIA. Каждая из них обеспечивает значительный прирост производительности и эффективности по сравнению с предыдущим поколением. В них используется наша стоечная архитектура NVL72, в которой 72 GPU в рамках одной сетевой среды работают как единый ускоритель.
Catalina: NVIDIA GB200
В нашей первой платформе, Catalina, используется NVIDIA GB200 NVL72. Мы применяем вариант Ariel — конфигурацию из двух стоек, в каждой из которых 36 GPU соединены через NVLink и образуют единый домен из 72 GPU. Catalina обеспечивает более высокую вычислительную мощность и больший объём памяти, чем Grand Teton H100. В ней используется наша стойка высокой мощности Open Rack V3 (ORv3) — конструкция с открытым исходным кодом, переданная в Open Compute Project (OCP).
Вариант Ariel на базе GB200 NVL72 объединяет каждый GPU NVIDIA Blackwell с процессором NVIDIA Grace и двумя сетевыми адаптерами NVIDIA ConnectX-7 400G при соотношении один процессор на один GPU. Это позволило нам раньше остальной отрасли обеспечить ввод-вывод на скорости 800G для каждого GPU. Мы выбрали Ariel, потому что GB200 NVL72 обеспечивала почти по всем параметрам более высокие характеристики, чем NVIDIA H100: FLOPS, пропускную способность HBM, пропускную способность масштабирования и размер домена масштабирования. При этом пропускная способность масштабирования за пределы GPU оставалась бы на уровне 400G. Мы ожидали, что этот дисбаланс снизит производительность, поэтому выбрали конфигурацию, обеспечивающую 800G масштабирования за пределы каждого GPU. Это также позволило сохранить единые характеристики по мере расширения региона и появления возможностей масштабирования на скорости 800G.
Характеристики Catalina GB200 NVL72:
- 72 GPU NVIDIA Blackwell с 13,4 ТБ памяти HBM3e (192 ГБ на GPU).
- Пиковая вычислительная производительность при обучении FP8 — 720 PFLOPS (1 440 PFLOPS при FP4).
- Пиковая пропускная способность NVLink — 130 ТБ/с внутри домена.
- Пиковая совокупная пропускная способность памяти — 576 ТБ/с.
- Общая мощность системы — около 120 кВт на пару из двух стоек.
Clemente: NVIDIA GB300 NVL72
В нашей второй платформе, Clemente, используется NVIDIA GB300 NVL72. Она превосходит Catalina как на уровне GPU, так и на уровне платформы. GB300 увеличивает объём HBM на каждом GPU в 1,5 раза — с 192 до 288 ГБ, а плотную производительность FP4 — примерно в той же пропорции; при этом ускорение вычислений внимания (softmax) возрастает примерно вдвое. На уровне платформы масштабирование за пределы GPU больше не ограничено так, как в GB200 NVL72: сетевые адаптеры NVIDIA ConnectX-8 SuperNIC обеспечивают 800G на каждый GPU, и возможность, которую мы заранее внедрили в Ariel, становится базовым уровнем. Благодаря этому, а также соотношению два GPU на один процессор, Clemente размещает весь домен из 72 GPU в одной стойке, упрощая физическое развёртывание. Clemente можно развернуть с нашей модульной системой жидкостного охлаждения с поддержкой воздушного охлаждения (AALC) или использовать охлаждение жидкостью на уровне объекта (FLC) в наших новых дата-центрах. Существенно упрощается и обслуживание благодаря сокращению количества кабелей.
Характеристики Clemente GB300 NVL72:
- 72 GPU NVIDIA Blackwell Ultra с 20,7 ТБ памяти HBM3e (288 ГБ на GPU — на 50% больше, чем у GB200).
- Пиковая вычислительная производительность FP4 превышает 1 экзафлопс.
- Пиковая пропускная способность NVLink — 130 ТБ/с (1,8 ТБ/с в двунаправленном режиме на GPU).
- Мощность стойки — около 135 кВт.
- Повышение производительности на 5–10% по сравнению с GB200 NVL72.
Связь между компонентами суперкластера
В традиционных веб-сервисах сеть дата-центра передаёт запросы и ответы между сервисами, экземплярам которых обычно не требуются высокая пропускная способность, высокая производительность и тесная синхронизация между множеством серверов. Для масштабного обучения ИИ необходимы все эти условия, поэтому сеть, связывающая компоненты, стала важной частью ИИ-нагрузок. Чтобы оптимально решить эту задачу, несколько лет назад мы дополнили стандартную сеть дата-центра, соединяющую серверы, второй специализированной сетью передачи данных на базе Ethernet — Back-End (BE). Она обеспечивает прямую связь между GPU как внутри зданий дата-центра, так и между ними.
При предварительном обучении крупных моделей задачи обучения разбиваются на параллельные по данным реплики модели, что формирует иерархию сетевого трафика: операции, чувствительные к задержкам и пропускной способности, сосредоточены внутри реплики, тогда как трафик, менее чувствительный к задержкам и требованиям к пропускной способности, передаётся между репликами. Наша сеть разработана с учётом этой иерархии: внутри зданий используются сети с низкой задержкой и высокой пропускной способностью, а сети агрегации соединяют сетевые среды зданий.
Мы тесно сотрудничаем с Meta Superintelligence Labs, чтобы оптимизировать параллельные вычисления, схемы трафика, алгоритмы связи и программное обеспечение и свести к минимуму ожидание сетевых операций. Благодаря этому GPU максимально загружены и не простаивают в ожидании сети.
За последние несколько лет команда Meta применяла эти сетевые решения в кластерах на уровне зданий, включающих 24 тыс. GPU, а также в нашем региональном кластере, насчитывающем более 100 тыс. GPU. В Prometheus мы вывели их на новый уровень масштаба и расстояний.
Сетевые среды
На уровне зданий каждая сеть на базе Ethernet соединяет до 20 736 GPU с помощью многоуровневой топологии, обеспечивающей высокую пропускную способность и низкую задержку. В первоначальном проекте мы использовали дезагрегированную планируемую сетевую среду (DSF), чтобы снизить перегрузку сети, вызванную коллективными операциями обучения. Такие операции обычно создают небольшое количество крупных и долгоживущих сетевых потоков, которые сталкиваются при использовании традиционных методов балансировки нагрузки. Для этого DSF использует маршрутизацию с несколькими путями на уровне подпакетов и переупорядочивание пакетов в сети, а также виртуальные очереди выходных портов и сквозное управление потоком на основе кредитов.
По мере развития сетевых адаптеров Ethernet, позволившего переупорядочивать пакеты на конечном устройстве, мы смогли перейти на непланируемую сетевую среду (NSF) с коммутаторами Ethernet 51,2T с небольшими буферами, такими как Minipack3 с динамической балансировкой нагрузки, и Minipack3N на базе коммутирующей микросхемы NVIDIA Spectrum-4 с адаптивной маршрутизацией на сетевых адаптерах ConnectX. И DSF, и NSF используют сетевой стек FBOSS компании Meta, что позволяет нам быстро совершенствовать и оптимизировать сетевые среды Prometheus, а также получать данные, необходимые для эксплуатации этих кластеров в больших масштабах.
Агрегация
Сеть агрегации внутренней сети (BAG) — это многоуровневая сеть по топологии «звезда», которая соединяет сетевые среды зданий по всему кластеру Prometheus на расстоянии от 2 до более чем 100 км. Она построена на шасси Arista серии 7800 с микросхемами Broadcom Jericho3 с глубокими буферами и обеспечивает пропускную способность в несколько петабит в секунду для каждой пары регионов.
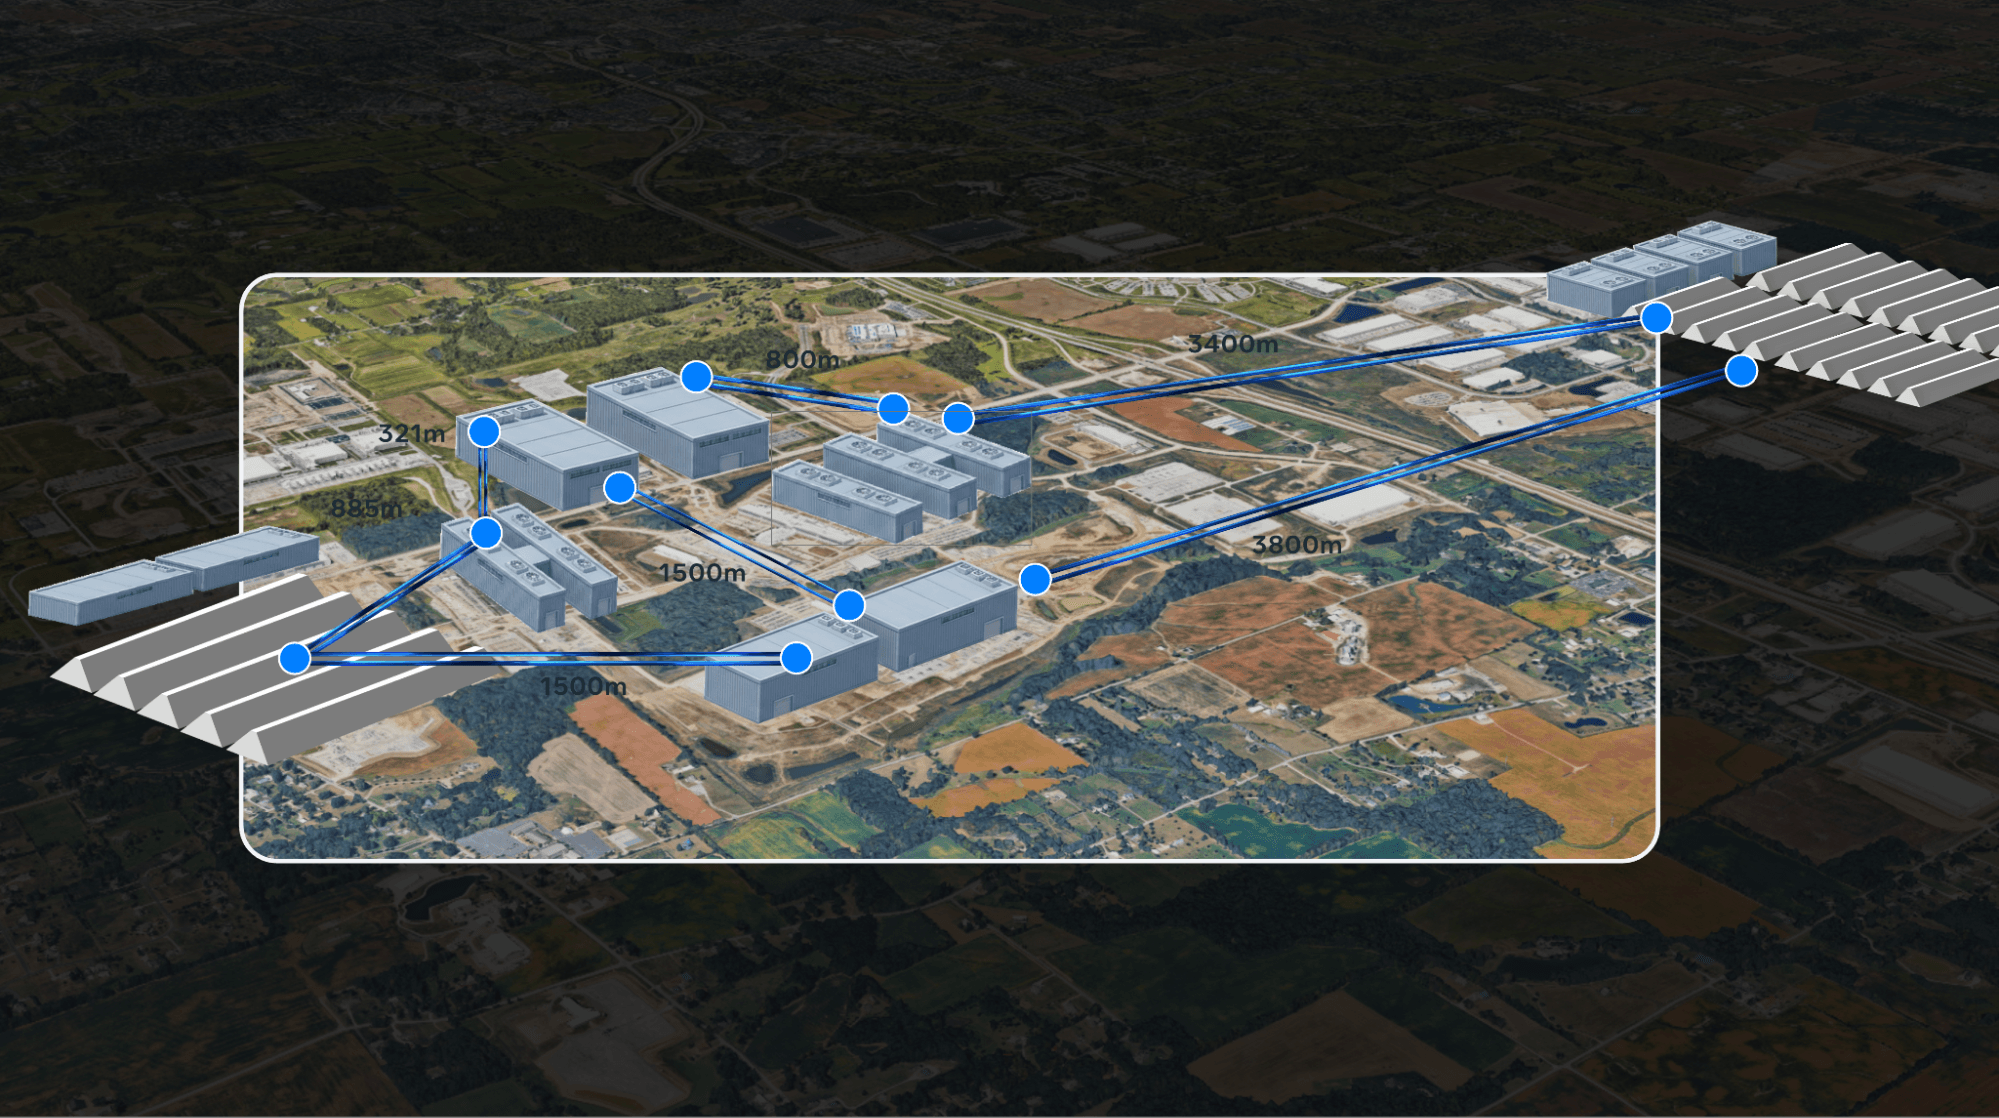
Для предварительного обучения по этой сети потребовалась отдельная работа по оптимизации совместно с Meta Superintelligence Labs, чтобы обучение не замедлялось, особенно с учётом ограничений, связанных со скоростью света на таких расстояниях.
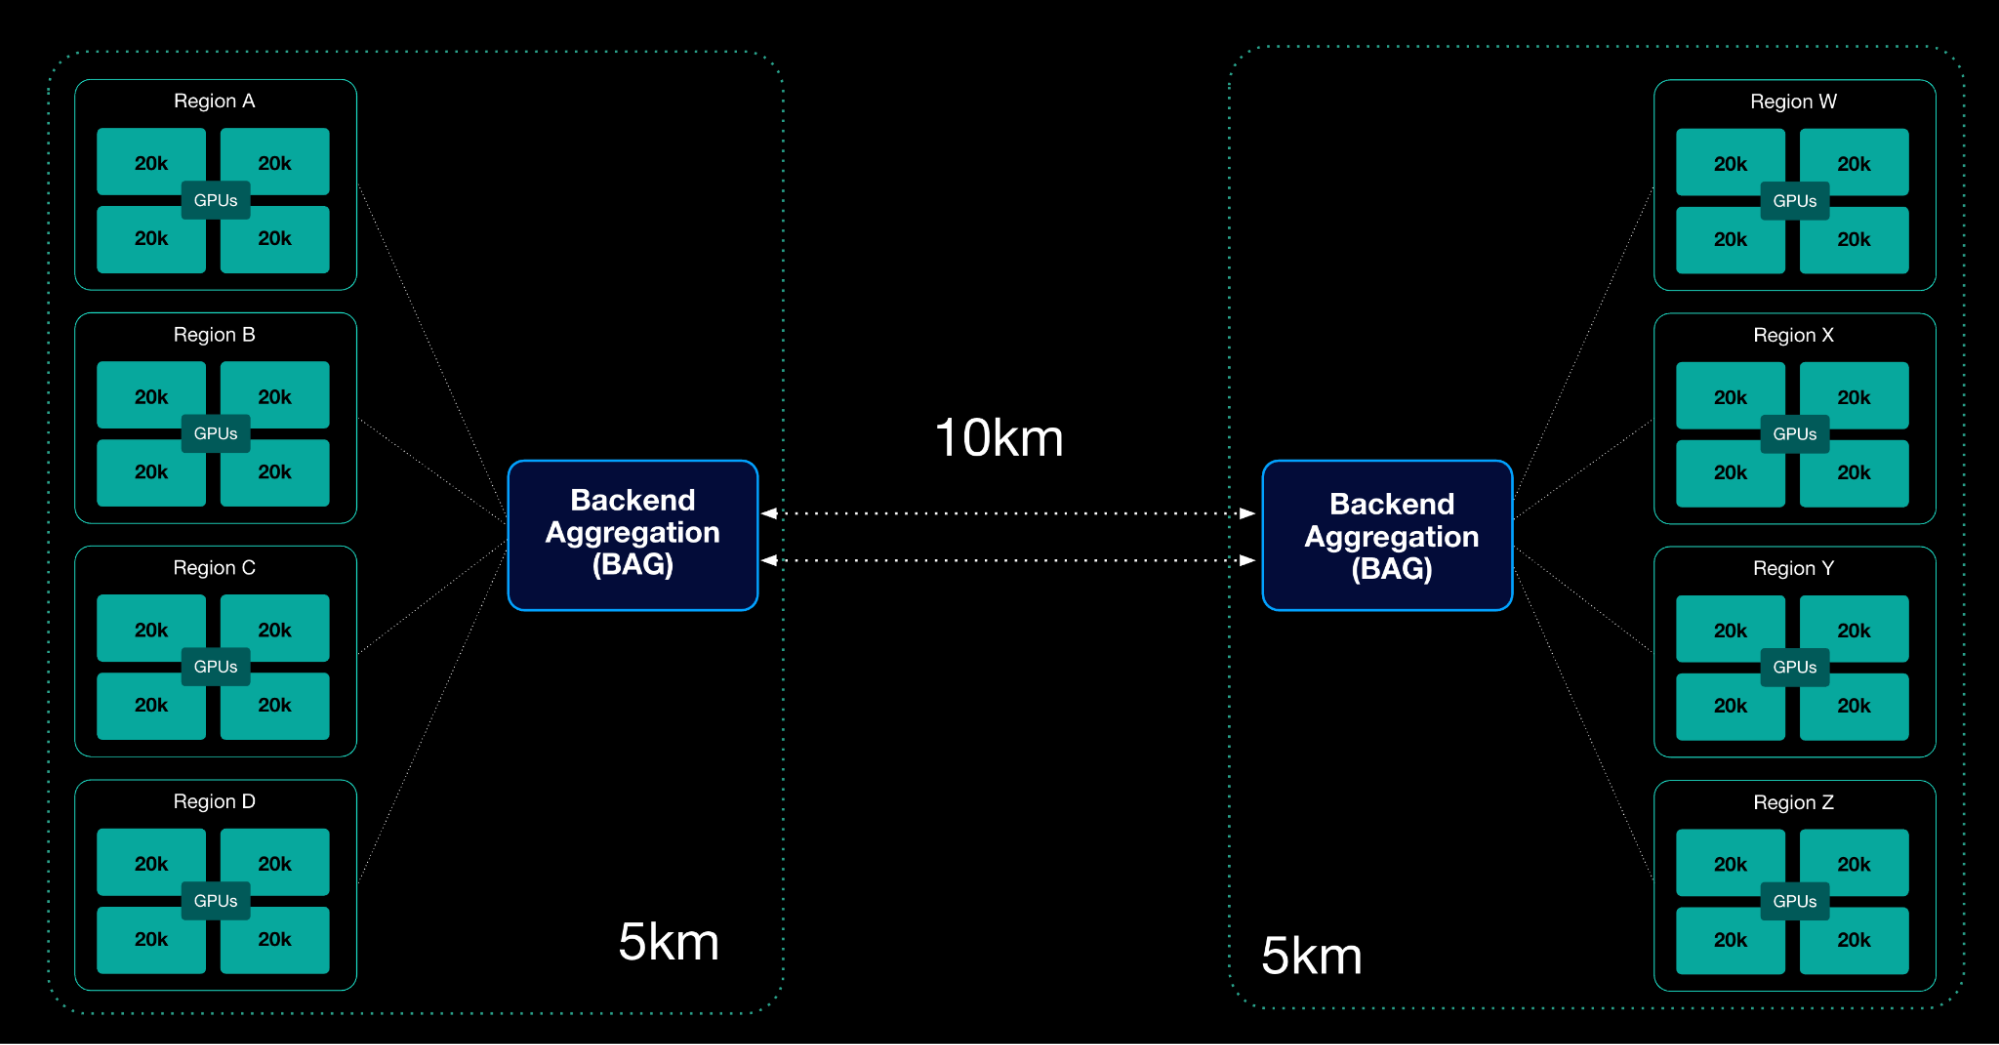
Вся сеть Prometheus — это миллионы километров оптоволокна, десятки тысяч коммутаторов и миллионы оптических модулей: от недорогих модулей короткого радиуса действия 2×400G FR4 LITE внутри зданий до когерентной оптики 800G-ZR для линий длиной более примерно 10 км.
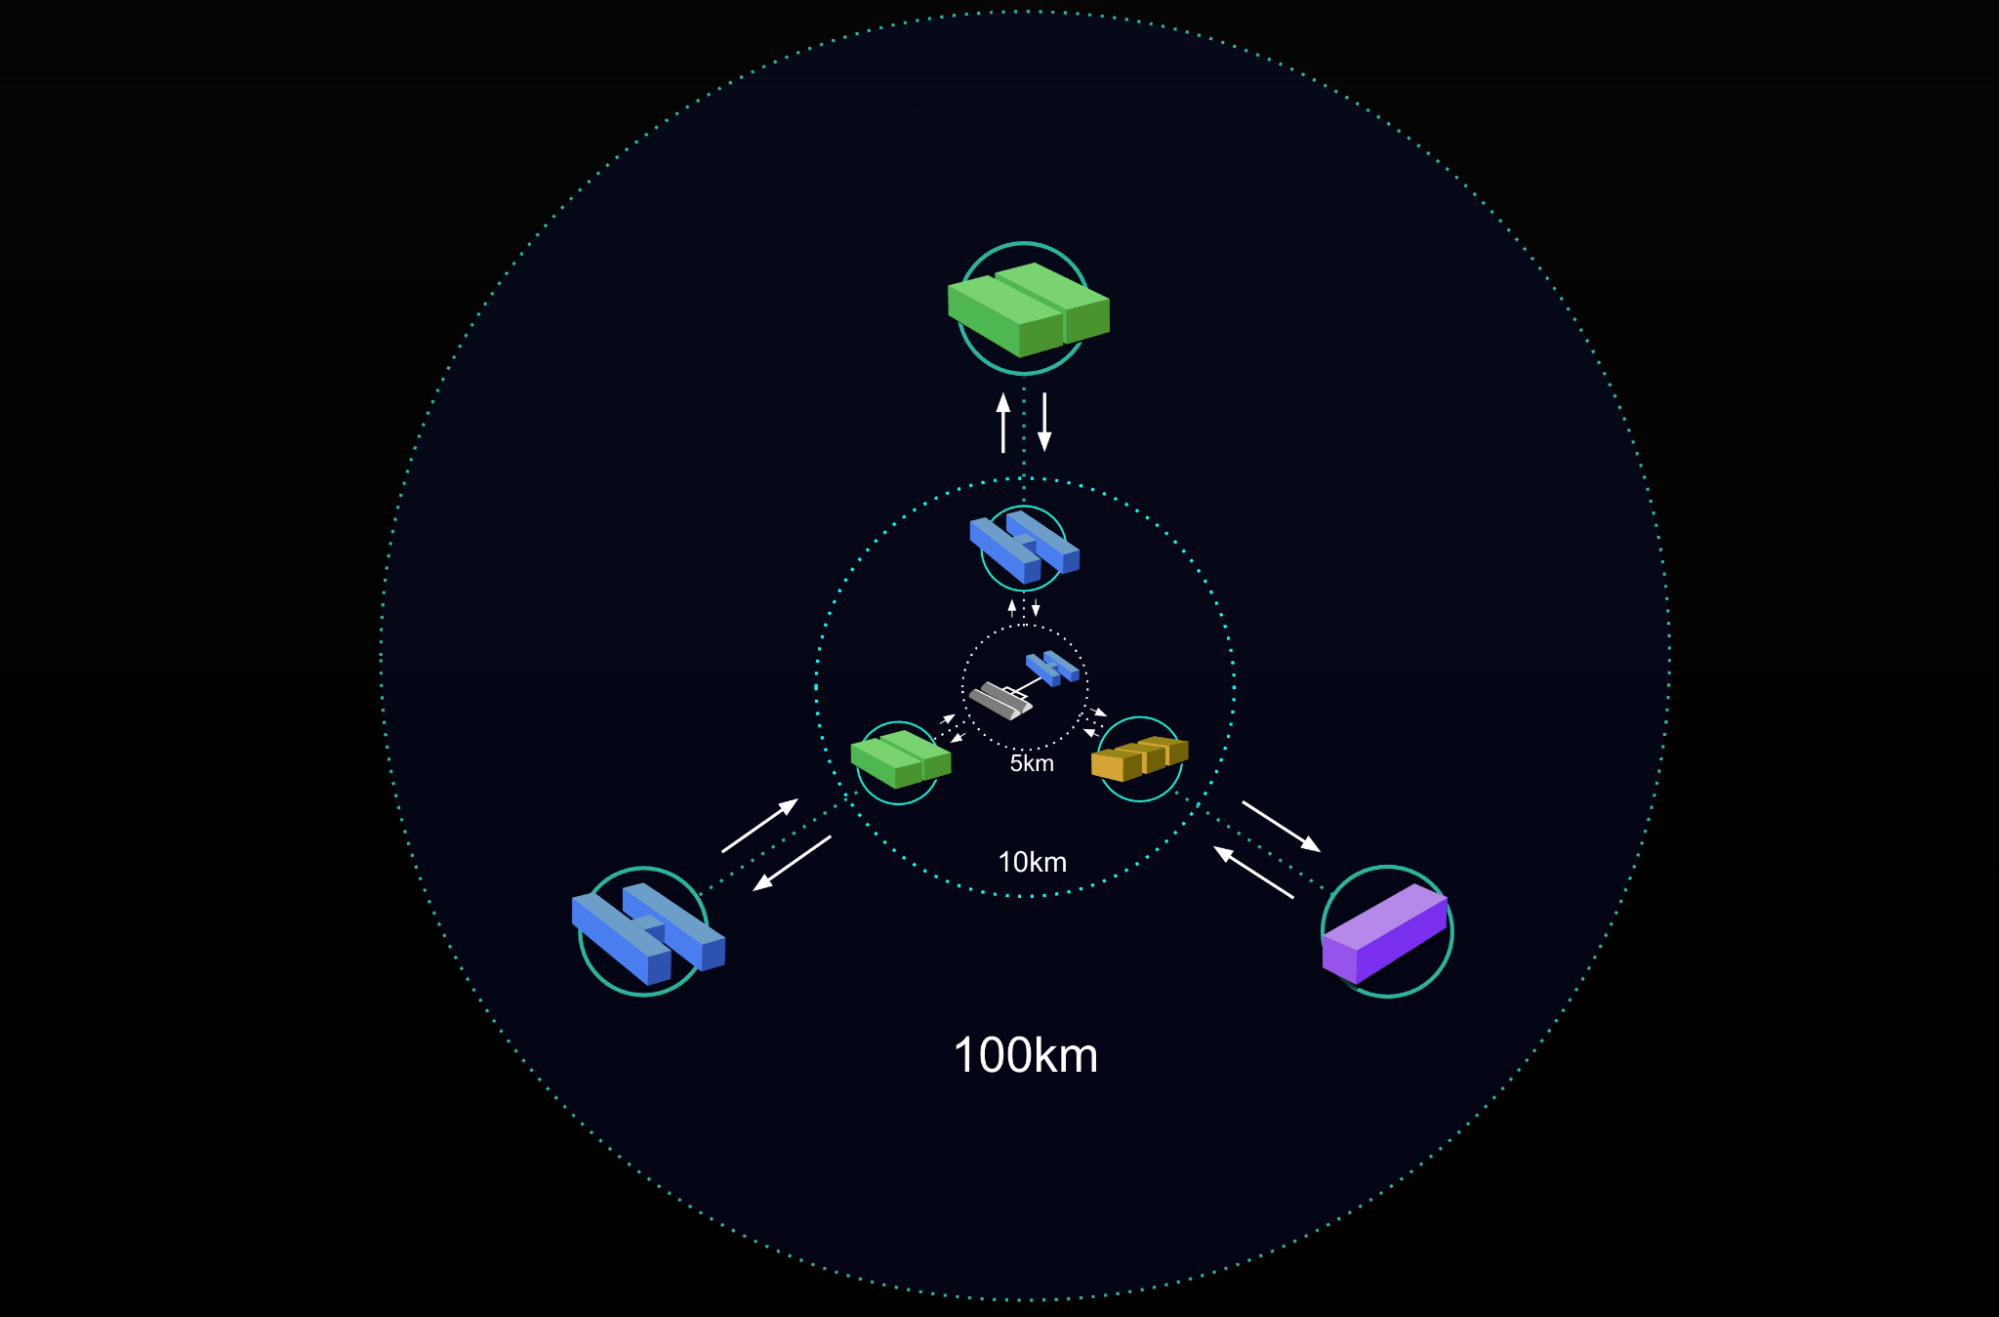
Надёжность на каждом уровне
В масштабе Prometheus необходимо следить за надёжностью каждого компонента. Любой единичный сбой может остановить всю задачу обучения и привести к потере ценных вычислительных ресурсов.
Для поддержания такого уровня надёжности необходима модель совместной разработки с NVIDIA, выходящая за рамки обычных отношений с поставщиком. Команды постоянно работают в наших дата-центрах, обмениваются телеметрическими данными в реальном времени и вместе разбирают причины каждой остановки системы.
Эта модель ответственности, основанная на установлении причин сбоев, помогает обеим сторонам сосредоточиться на целевых улучшениях. Meta оптимизирует планирование и инфраструктуру, а NVIDIA занимается прошивками, диагностикой сигналов и обработкой памяти. Такая прозрачность исключает неопределённость и ускоряет устранение неполадок в обеих организациях.
Домен отказа из 72 GPU
Переход от архитектуры NVL8 поколения H100 к NVL72 коренным образом изменил наш подход к отказоустойчивости инфраструктуры. В эпоху NVL8 домен масштабирования — группа GPU, тесно связанных через NVLink для параллельных тензорных вычислений, — ограничивался восемью устройствами. В NVL72 домен расширяется до 72 GPU, увеличивая радиус воздействия сбоя в девять раз.
Расширенный домен масштабирования обеспечивает NVL72 преимущество в пропускной способности, но одновременно делает стойку на 72 GPU единицей, исходя из которой мы планируем вычислительные мощности. Параллелизм при обучении наиболее эффективно работает с группами, размер которых представляет собой степень двойки. Поэтому в каждом домене NVL72 используется срез из 64 GPU, а оставшиеся восемь GPU в стойке служат резервом. При отказе GPU резервный немедленно занимает его место, и задача возобновляется с последней контрольной точки, не дожидаясь ремонта оборудования, а стойка остаётся в составе задачи. Резервирование внутри стойки сводит её эффективную частоту отказов к минимуму, определяемому сбоями, способными вывести из строя целый модуль. На случай более редких отказов целой стойки мы резервируем ещё около 2% стоек. Для обучающего запуска с 32 768 активными GPU это означает, что необходимо выделить 523 стойки NVL72, или 37 656 GPU, — примерно на 13% больше активного объёма. Большая часть этого запаса (11%) обусловлена геометрией среза 64 из 72, а не является неизбежной платой за надёжность.
Физическая сложность ещё больше повышает требования к надёжности. Один домен NVL72 включает 5 184 настроенных дифференциальных сигнальных линии, работающих на скорости 200 Гбит/с. Каждая проходит через несколько потенциальных точек отказа, включая SerDes GPU, печатные платы вычислительных лотков, кабельные кассеты и интерфейсы коммутирующих лотков. Поддержание стабильной целостности сигналов в такой плотной сети при скорости 200 Гбит/с на линию — беспрецедентная инженерная задача для системы такого масштаба.
Восстановление после сбоев
Восстановление после сбоев определяет, как мы реагируем на неполадки, чтобы свести к минимуму их влияние на время обучения. В зависимости от масштаба сбоя и области его воздействия мы применяем два механизма:
Отказоустойчивость с учётом параллелизма (PAFT): если сбой можно локализовать в одной реплике модели, параллельной по данным, мы уменьшаем влияние аппаратного отказа, временно отключая только эту неисправную реплику, в то время как остальная часть кластера повторяет этот этап и продолжает обучение. Повреждённый срез перезапускается на доступных резервных серверах и синхронизируется, превращая потенциальную остановку всей системы в незначительное временное снижение общей пропускной способности.
Сохранение контрольных точек: если область воздействия сбоя превышает одну реплику модели, параллельную по данным, перезапускается вся задача — с последней контрольной точки. Частое сохранение контрольных точек сокращает объём работы, потерянной при таких событиях. Наша распределённая архитектура сохранения контрольных точек асинхронно записывает состояние модели — включая градиенты и данные оптимизатора — в многоуровневую систему хранения. Мы используем инкрементальное сохранение контрольных точек и промежуточное хранение в памяти, чтобы свести к минимуму влияние этих операций на пропускную способность обучения.
Оба механизма восстановления после сбоев дополняются стратегией резервирования: в стойках заранее размещаются запасные лотки с GPU, а также резервируются целые стойки. Это позволяет быстрее вводить в эксплуатацию оборудование на замену и сокращать объём работы, теряемой из-за аппаратных отказов
Систематическое сокращение числа перерывов
При обучении передовых моделей для оценки надёжности инфраструктуры недостаточно учитывать лишь её доступность. Главная задача — поддерживать непрерывность обучения, избегая частых остановок системы. В Prometheus перерывом считается любой сбой — от дефектов кристаллов GPU и неполадок сетевой среды до ограничений хранилища или температуры, — из-за которого задача приостанавливается и запускается цикл восстановления.
Такие перерывы влекут за собой значительные операционные издержки, поскольку наши нагрузки тесно взаимосвязаны: один сбой в домене из 72 GPU может повлиять на общую пропускную способность всего кластера. Это снижение производительности напрямую замедляет разработку и приводит к менее эффективному использованию вычислительных ресурсов, а также увеличивает сроки предоставления передовых ИИ-возможностей миллиардам людей.
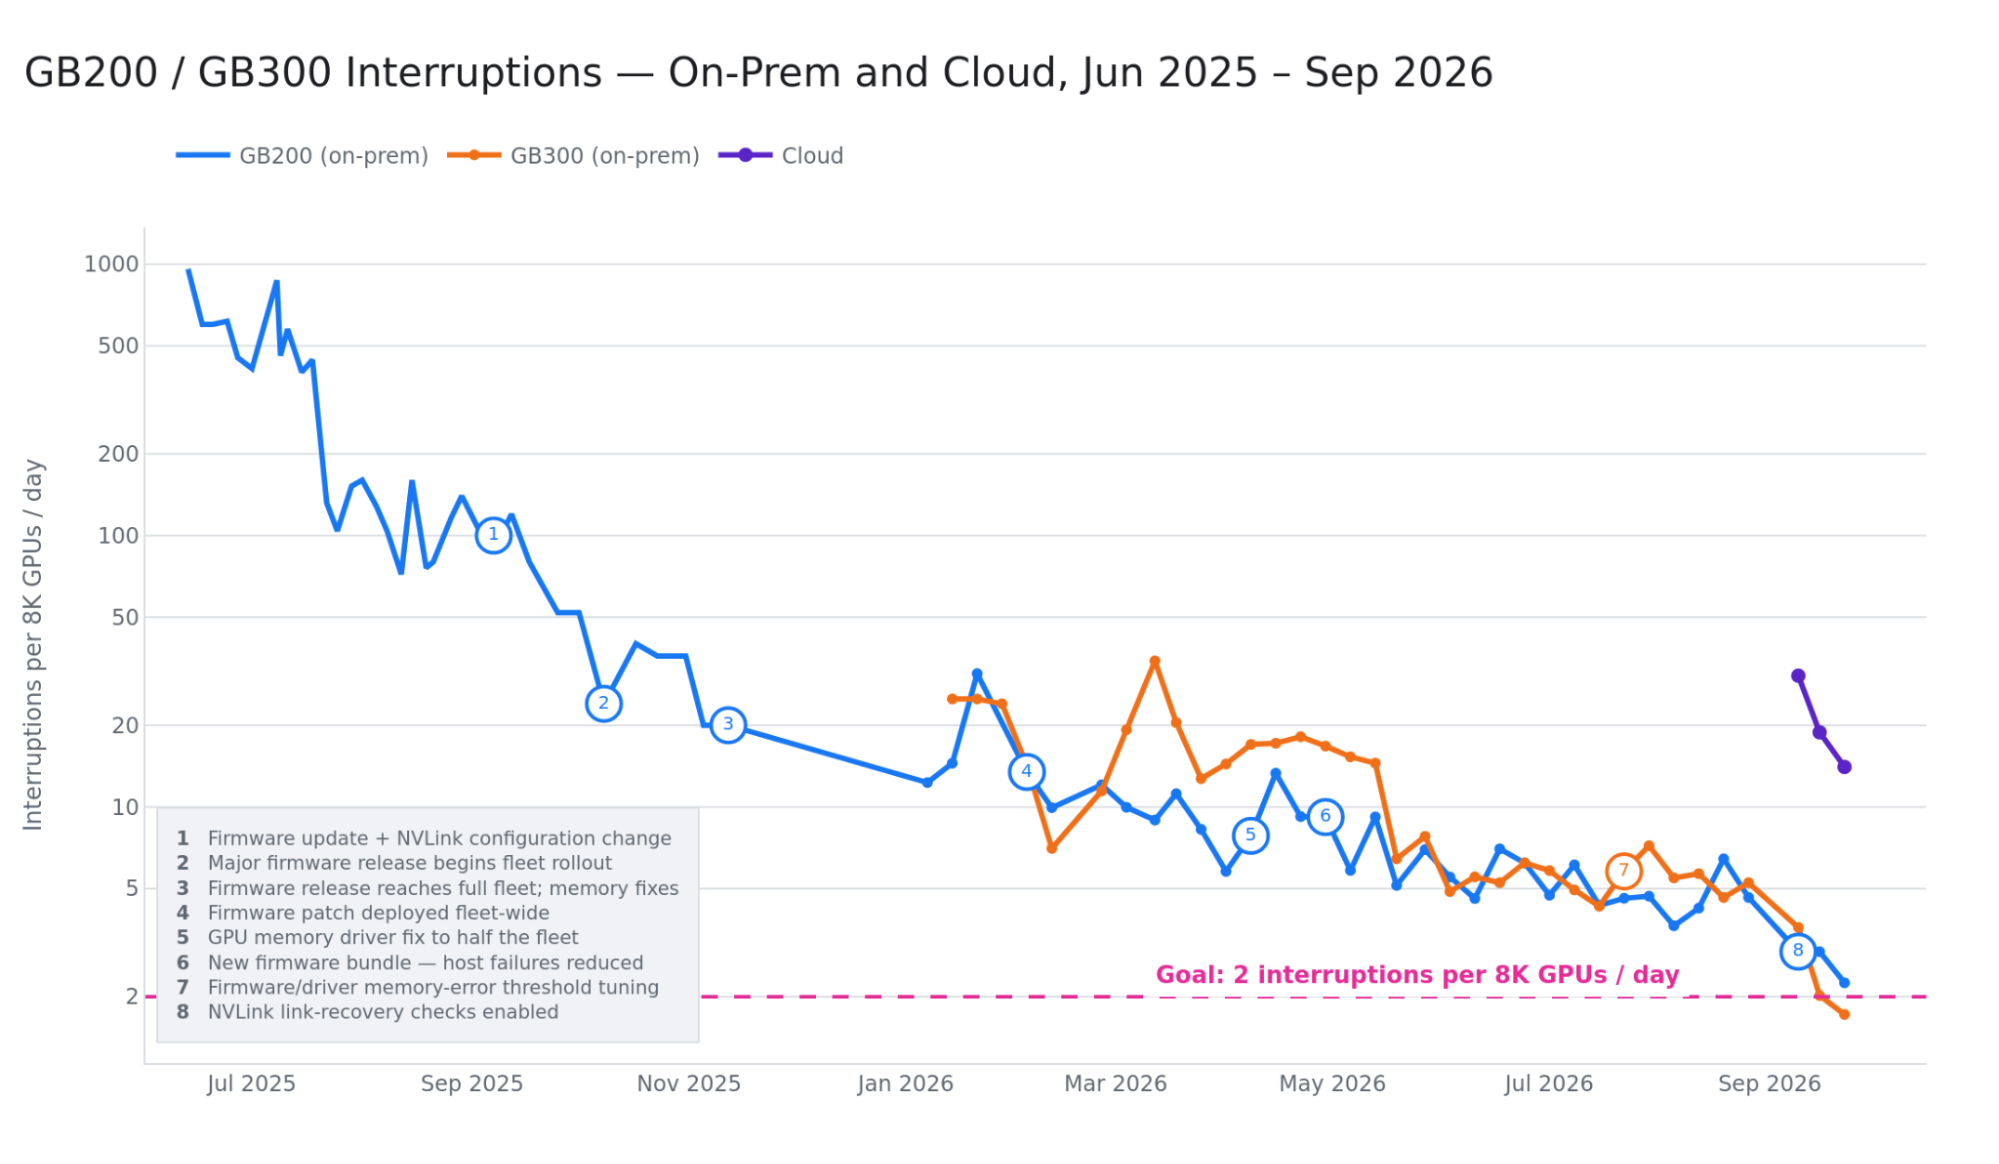
На начальном этапе работы Prometheus, в середине 2025 года, количество перерывов достигало пика — почти 1 000 событий в день на каждые 8 тыс. GPU. За год интенсивной межфункциональной инженерной работы нам удалось сократить число перерывов на 99%, благодаря чему кластер может одновременно поддерживать несколько задач обучения, каждая из которых задействует десятки тысяч GPU.
Для достижения такой стабильности мы подробно проанализировали каждую причину перерыва, а затем внедрили целевые инженерные решения для каждой категории отказов:
Целостность сигналов NVLink: изначально была главным узким местом при развёртывании GB200. При более чем 600 000 соединений NVLink даже незначительное ухудшение сигнала вызывает частые циклы восстановления NVLink. Мы внедрили непрерывный сбор телеметрии и автоматическую маркировку, используя диагностические стресс-тесты L11 для выявления слабых соединений до начала эксплуатации. Наши инструменты классификации отличают временные сбои от постоянных нарушений целостности сигнала, помогая определять, где нужны целевой ремонт и замена компонентов. Перед возвращением в эксплуатацию мы проверяем отремонтированные системы.
Надёжность памяти (HBM и LPDDR): по мере масштабирования GB300 и увеличения объёмов памяти сбои, связанные с памятью, стали одной из основных причин перерывов. В тесном сотрудничестве с NVIDIA мы использовали телеметрию парка оборудования и подробный анализ ошибок, чтобы выявить повторяющиеся сигнатуры отказов. Мы устраняем их с помощью улучшенных настроек прошивки HBM, очистки памяти, усовершенствованного алгоритма коррекции ошибок для LPDDR и прогнозирования на основе шаблонов, позволяющего выводить деградирующие устройства из эксплуатации до того, как они повлияют на пропускную способность задач. Мы внедряем эти изменения во всём парке и оцениваем их влияние на частоту перерывов и потребность в замене оборудования.
Состояние коммутаторов и сетевой среды NVLink: сбой одного коммутатора может вывести из строя весь домен NVL72. Мы отслеживаем состояние сети с точностью до миллисекунд и используем автоматизированные механизмы восстановления, чтобы изолировать неисправные компоненты и перераспределять трафик между оставшимися элементами инфраструктуры без остановки задачи.
События во внутренней сети: на уровне супермагистральной сети BAG сбои каналов связи незаметно обрабатываются аппаратными средствами обнаружения неисправностей. Наша планарная топология позволяет перенаправлять трафик при отказе отдельных оптоволоконных линий или портов, не прерывая синхронизированные потоки данных от GPU.
Постоянное повышение надёжности обеспечивается нашей операционной инфраструктурой: совместной командой по анализу сбоев, работающей на площадке в Нью-Олбани; комплексным мартовским спринтом по стабилизации, в ходе которого синхронно устранялись неполадки на всех уровнях системы; и строгой системой ответственности, основанной на установлении причин сбоев. После каждого ремонта оборудование обязательно помещается в карантин, чтобы проверить целостность системы перед возвращением в вычислительный пул.
Наша главная цель в области надёжности — два перерыва в день на каждые 8 тыс. GPU, что соответствует примерно 100 тыс. GPU-часов среднего времени наработки на перерыв. Сокращение пикового числа перерывов на 99% показывает, что стабильность Prometheus такого масштаба — это инженерная задача, для которой можно найти решение.
Совершенствование оборудования в масштабах всего парка
Развёртывание сотен тысяч ускорителей первого поколения позволяет выявить проблемы качества, незаметные при меньших объёмах. Развёртывание GB200 превратило совершенствование оборудования в одно из ключевых направлений инженерной работы наших команд и партнёров.
К направлениям нашей работы относятся:
- Быстрое развёртывание комплектов прошивок: мы создали надёжную и быструю систему автоматического развёртывания комплектов прошивок, способную устанавливать исправления прошивок и драйверов на более чем 100 тыс. GPU за несколько часов. Нам удалось сократить время обновления одного модуля на уровне P90 с более чем семи часов на раннем этапе внедрения оборудования до двух часов. Благодаря этому мы можем быстро распространять по всему парку исправления для наиболее частых причин перерывов.
- Состояние всего парка оборудования: мы сопоставляем данные телеметрии систем из нескольких стоек и классифицируем каждый перерыв в работе, чтобы определять необходимость исправлений программного обеспечения, ремонта оборудования или его замены. Мы отслеживаем MTBI наряду с доступными вычислительными мощностями и фактической пропускной способностью обучения. Кроме того, у нас действует надёжный цикл обратной связи, позволяющий превращать улучшения надёжности оборудования и ПО в более эффективные вычисления.
- Квалификация с участием нескольких партнёров: мы проводим параллельную проверку с несколькими производственными партнёрами, чтобы поддерживать стабильное качество благодаря непрерывной обратной связи от парка оборудования, используемого в производстве.
- Автоматизированная проверка сигналов: мы проверяем более 600 000 каналов NVLink с помощью диагностических стресс-тестов до начала передачи производственного трафика. При таком масштабе даже незначительные показатели дефектов требуют превентивного выявления.
- Стресс-тестирование электропитания: мы изучаем взаимодействие модулей блоков питания и регуляторов напряжения при нагрузке 1 400 Вт на отдельный GPU, чтобы выявить типы отказов, которые проявляются только при больших объёмах.
- Точное жидкостное охлаждение: мы устанавливаем строгие критерии качества сборки холодных пластин и коллекторов, чтобы поддерживать оптимальную температуру перехода и предотвращать утечки во всём парке.
- Обслуживание парка оборудования: заблаговременная подготовка, быстрое определение порядка действий, приоритизация ремонта и размещение запасных частей и оборудования на нужных площадках.
- Проверка состояния: расширенные процедуры приёмки и прогрева, а также проверки состояния перед запуском задачи помогают выбрать исправные узлы для крупных задач обучения.
Каждая новая архитектура платформы — от Blackwell до Vera Rubin — учитывает эти практические выводы, а требования к проверке и проектированию ужесточаются на каждом этапе.
Оптимизация электропитания и управление переходными процессами
Максимизация пропускной способности при заданном лимите мощности, сокращение неиспользуемых энергоресурсов и синхронное распределённое обучение создают серьёзные требования к системе электропитания. Когда десятки тысяч GPU одновременно выполняют вычислительно интенсивные этапы и циклы обмена данными, возникают значительные скачки потребления — внезапные колебания нагрузки на 30–40% в пределах кластера. Запуск или приостановка крупной задачи обучения может изменить нагрузку на десятки мегаватт всего за несколько секунд.
Для решения этой задачи мы используем Dynamo Dimmer — систему управления питанием всего кластера, которая обеспечивает интеллектуальное ограничение мощности. Вместо жёсткой остановки задач Dimmer постепенно меняет ограничения мощности GPU по мере приближения кластера к пределу энергопотребления, позволяя обучению продолжаться без перерывов. Систему дополняют аккумуляторные модули в стойках (BBU), сглаживающие мгновенные скачки нагрузки, конденсаторные модули (CBU) для сглаживания пиков, системы накопления энергии на уровне объекта (BESS), а также тесная координация с поставщиками электроэнергии, помогающая управлять характерными для ИИ профилями потребления.
Управление охлаждением в неоднородном парке оборудования
Хотя распределённый подход позволил нам быстро построить Prometheus, он также потребовал учитывать специфические для каждой площадки ограничения по электропитанию и охлаждению.
Наша физическая инфраструктура объединяет несколько поколений систем охлаждения, обеспечивающих жидкостное охлаждение стоек высокой мощности. Prometheus использует сочетание модульных систем жидкостного охлаждения с поддержкой воздушного охлаждения (AALC), включая здания дата-центров с естественным воздушным охлаждением и быстроразворачиваемые сооружения. В нашем специально построенном здании, оптимизированном для ИИ, теперь используется система охлаждения жидкостью на уровне объекта (FLC), обеспечивающая максимальную плотность мощности.
Помимо наших собственных зданий, мы также используем арендованные мощности стратегических партнёров, чтобы ускорить развёртывание и увеличить общую доступную вычислительную мощность. В то же время наши быстроразворачиваемые промышленные сооружения изменили подход к строительству, позволяя быстрее вводить в эксплуатацию готовые к работе вычислительные мощности.
Эффективная эксплуатация
В Нью-Олбани мы давно сотрудничаем с местными энергокомпаниями, чтобы полностью оплачивать энергопотребление нашей площадки и не создавать лишней нагрузки на местную электросеть. Мы также работаем с компаниями, занимающимися энергетикой, чтобы обеспечить соответствие нашего энергопотребления новым источникам чистой и возобновляемой энергии.
В новейших дата-центрах Meta, оптимизированных для ИИ, используется жидкостное охлаждение с замкнутым контуром — это наиболее эффективный способ охлаждать серверы с GPU, позволяющий рационально использовать воду. Жидкостное охлаждение с замкнутым контуром и прямым отводом тепла от чипов экономит пространство и позволяет разместить больше GPU в серверной стойке. Мы также распространяем наши наработки в области устойчивого развития, публикуя проекты таких систем, как IcePack — нашей стойки для сетевого оборудования с жидкостным охлаждением — для широкой отрасли через OCP.
После Prometheus
Мы продолжим тесно сотрудничать с NVIDIA и расширять мощности Prometheus, сочетая NVIDIA GB300 NVL72 и NVIDIA Vera Rubin NVL72.
Платформа следующего поколения NVIDIA Vera Rubin NVL72 обеспечит значительный прирост производительности на каждый GPU и будет напрямую интегрирована в существующую сетевую среду Prometheus. По мере развития кластера мы сможем увеличить объём вычислений на ватт, дополнив его вычислительные мощности — в первую очередь взаимосвязанные GPU GB300 — платформой Vera Rubin на базе нашей готовящейся к запуску платформы San Miguel.
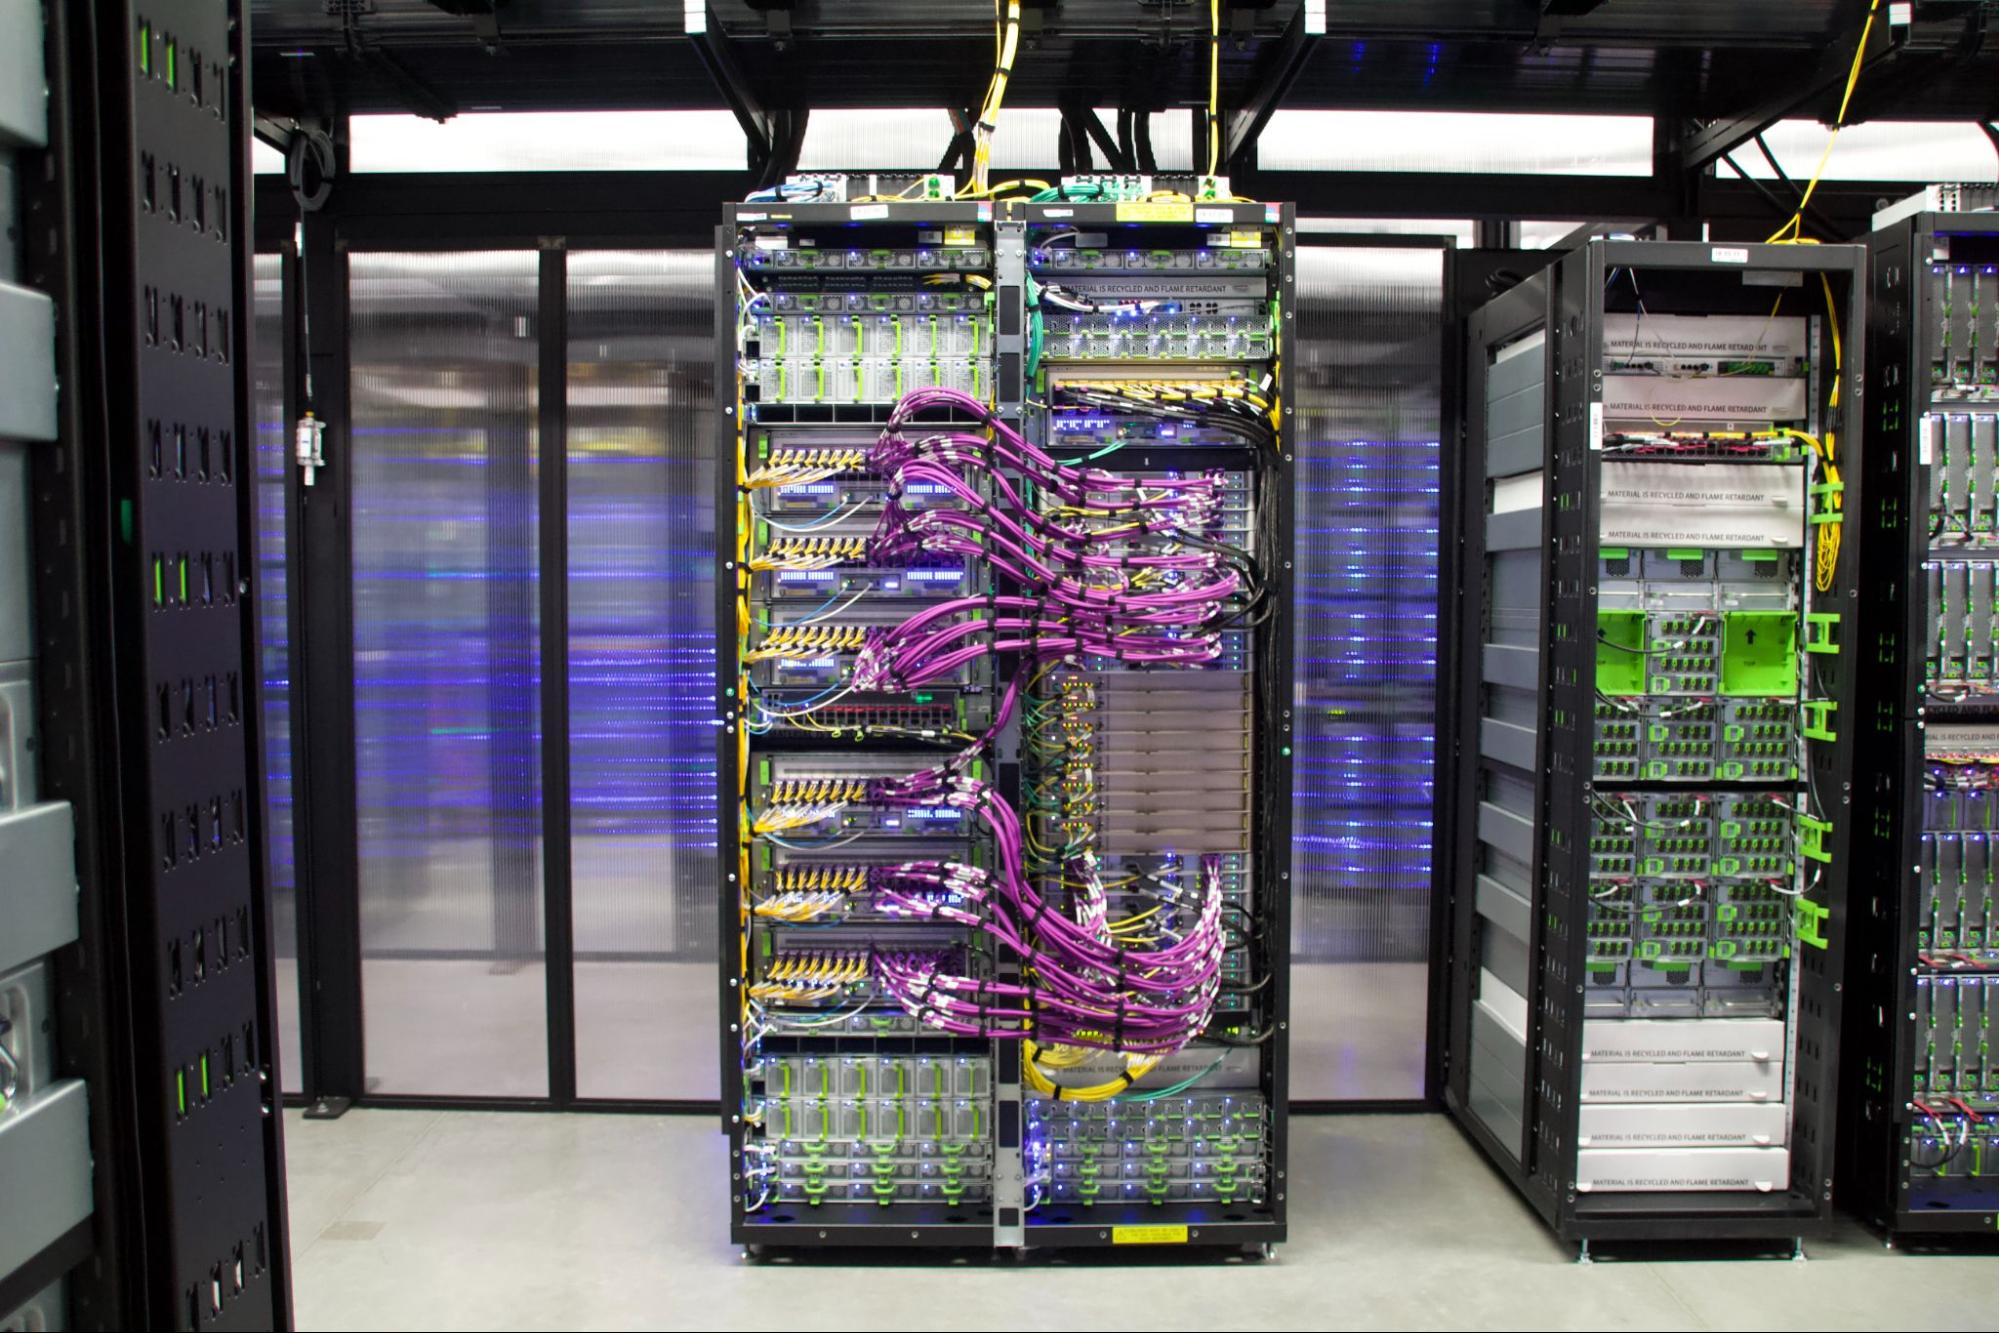
Характеристики San Miguel Vera Rubin NVL72:
- 72 GPU NVIDIA Vera Rubin с 288 ГБ памяти HBM4 и пиковой пропускной способностью 19,2 ТБ/с на GPU.
- Пиковая вычислительная производительность при обучении FP4 — 2,52 EFLOPS; при обучении FP8 — 1,26 EFLOPS на стойку.
- Пиковая пропускная способность NVLink — 216 ТБ/с (3 ТБ/с в двунаправленном режиме на GPU).
- Пиковая совокупная пропускная способность памяти — около 1 500 ТБ/с.
- Полностью жидкостное охлаждение вычислительных лотков при мощности более 170 кВт на стойку.
- Повышение производительности на ватт на 10–20% по сравнению с GB300 NVL72.
Технологические достижения, воплощённые в Prometheus, помогли заложить основу для проектирования суперкластеров и определить, как мы будем решать связанные с ним сложные задачи в будущем. Наш будущий суперкластер Hyperion в приходе Ричленд, штат Луизиана, проектируется с нуля с учётом опыта, полученного при создании Prometheus. В нём будут использоваться жидкостное охлаждение с замкнутым контуром, полноценное подключение к электросети в сотрудничестве с нашим партнёром — энергокомпанией Entergy, расходы на которое Meta полностью оплачивает, а также сетевые решения нового поколения.
Узнайте больше о нашей работе с местным сообществом в Нью-Олбани.
Об этом также пишут
- TheNextWeb.ru Meta раскрыла подробности о Prometheus — супер-кластере в Огайо на миллион GPU 21.10.2026 00:08
