Токенизация GenRecs: как Meta преобразует рекомендации рекламы с помощью стабильного словаря моделей
- Токенизация представляет объявления, товары и другие объекты последовательностями токенов из стабильного семантического словаря, а не отдельными идентификаторами.
- В связке с GEM и адаптивной моделью ранжирования Meta система повысила конверсии на 0,35%; измерения проведены в феврале 2026 года.
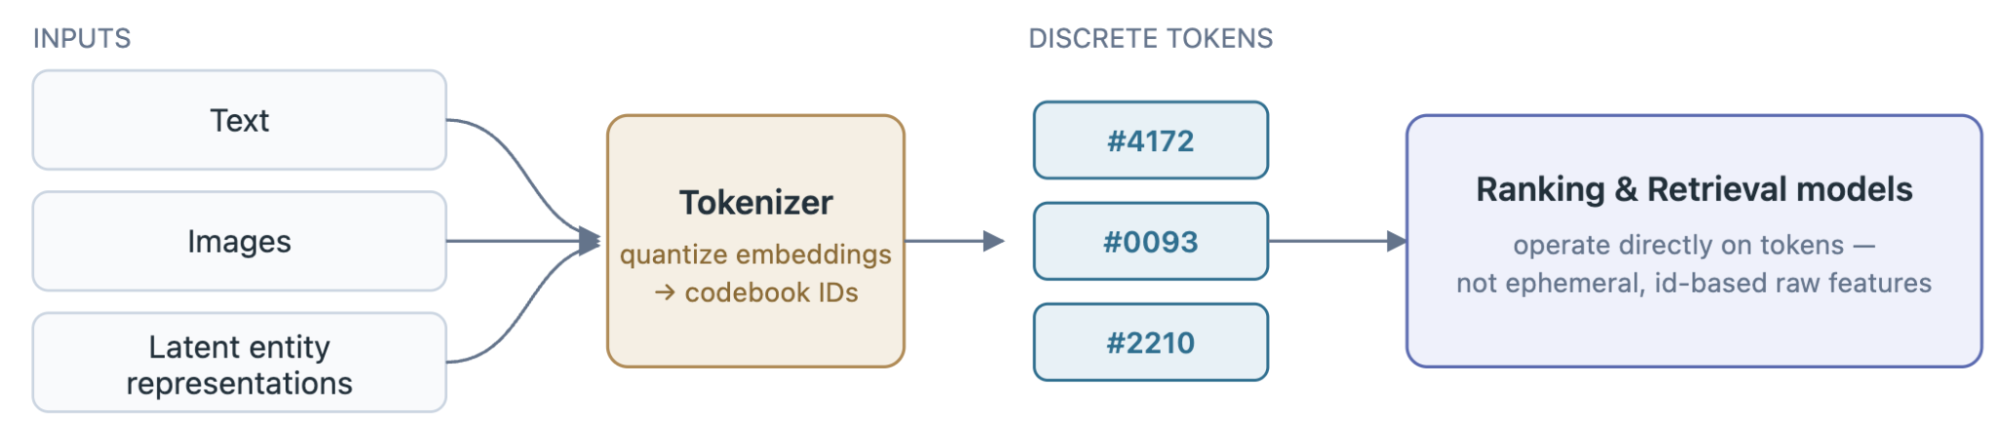
- Токенизатор формирует токены из эмбеддингов объектов и взаимодействий пользователей, затем квантуя их в короткую последовательность.
Почему это важно: Семантические токены позволяют новым объектам использовать знания модели о похожих объектах, даже если у них ещё мало взаимодействий.
- Генеративные рекомендательные системы (GenRecs) представляют собой смену парадигмы: вместо оценки каждого объявления система анализирует его содержание и предпочтения пользователя в совокупности, чтобы прогнозировать наилучший результат для рекламодателей. Использование знаний о мире, заложенных в больших языковых моделях (LLM), делает подбор рекламы более интеллектуальным и точным, повышая эффективность рекламных кампаний.
- Токенизация GenRecs — это фундаментальное представление данных, благодаря которому такой подход становится возможным. Вместо того чтобы присваивать каждому объекту отдельный идентификатор, токенизация GenRecs представляет его набором токенов из стабильного семантического словаря.
- В сочетании с генеративной рекламной моделью Meta (GEM) и адаптивной моделью ранжирования Meta токенизация GenRecs обеспечила рекламодателям рост конверсий на 0,35% на разных площадках.
GenRecs совершенствует прогнозирование в рекламных рекомендательных системах Meta. GenRecs — сокращение от Generative Recommenders (генеративные рекомендательные системы) — меняет наш подход: вместо оценки каждого отдельного рекламного объявления-кандидата мы используем архитектуру LLM, чтобы глубоко анализировать содержание рекламы и предпочтения пользователей одновременно. Сочетая предварительно усвоенные знания о мире с семантическим пониманием того, что именно представляет собой реклама, система выходит за рамки сопоставления шаблонов кликов и выявляет лежащие в основе предпочтения пользователей. Благодаря этому модель может предсказать наиболее релевантное объявление для каждого человека, даже если речь идет о совершенно новых товарах, с которыми он прежде не взаимодействовал, а также с рекламой или компаниями, их предлагающими.
Токенизация GenRecs — это фундаментальное представление данных, благодаря которому такой подход становится возможным. Вместо того чтобы присваивать отдельный идентификатор каждому понятию в мире, языковые модели составляют небольшой словарь семантических токенов, которыми можно представить любое понятие. Поскольку токены описывают, что собой представляет объект (например, объявление, товар, услуга и т. д.), модель может связать объект, с которым еще не сталкивалась, с хорошо знакомыми ей объектами. Недавно выпущенная «кроссовка для трейлраннинга» наследует знания модели об этой категории, а не получает новое представление без каких-либо исходных данных.
Токенизация GenRecs вводит структурированный словарь для рекламных рекомендаций и позволяет использовать GenRecs как для поиска, так и для ранжирования объектов всех типов в системе, включая объявления, товары, страницы и пиксели.
Современная рекламная рекомендательная система Meta постоянно повышает эффективность рекламы для рекламодателей, изучая отдельные объекты и результаты их работы. LLM открывают уникальную возможность дополнительно повысить эффективность рекомендательных систем благодаря семантической токенизации в нескольких областях применения рекламы:
- Ускорение обучения на новых объектах: Семантическая токенизация помогает моделям определять релевантность и устанавливать связи на основе общих понятий. К новым объектам относятся недавно созданные объявления, нишевые товары и страницы с небольшим числом взаимодействий.
- Перенос знаний между кампаниями: Семантическая токенизация создает стабильный словарь, который позволяет моделям переносить знания из одной кампании рекламодателя в другую.
- Преимущества масштабирования LLM: Семантическая токенизация позволяет накапливать преимущества по мере роста эффективности LLM при масштабировании.
- Использование знаний о мире: Семантическая токенизация дает предварительно обученным языковым моделям прямой способ анализировать содержание рекламы и намерения пользователей.
После перевода объектов в семантические токены модели учатся на шаблонах токенов, подобно LLM. В рабочей среде это дает следующие результаты:
- Повышение точности прогнозов в рабочей среде: В сочетании с GEM от Meta и адаптивной моделью ранжирования токенизация GenRecs обеспечила рост конверсий на 0,35%1.
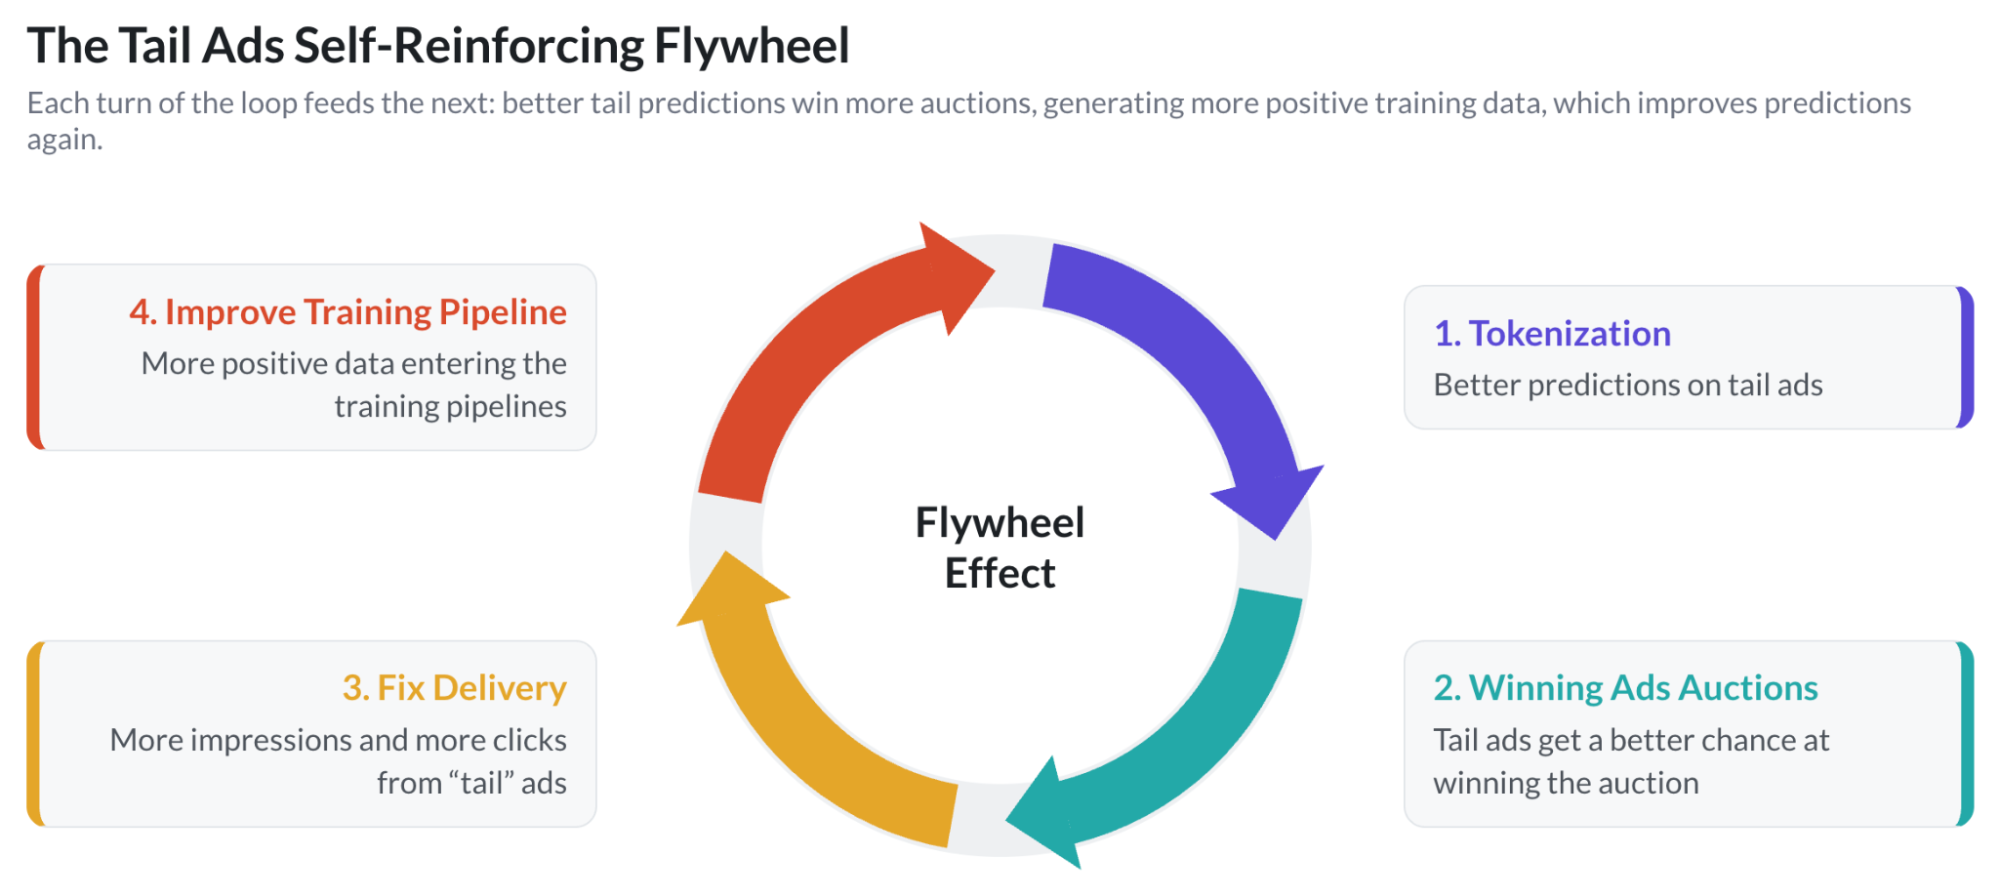
- Самоусиливающаяся обратная связь: Более точные прогнозы для объявлений с малым охватом позволяют извлекать из них больше полезной информации. Она обогащает обучающие данные и дополнительно повышает точность прогнозов модели для всех объявлений, создавая цикл обратной связи, который улучшает результаты.
- Новый способ масштабирования: При ранжировании и поиске в рабочей среде токены меняют кривую масштабирования в зависимости от длины последовательности, объема обучающих данных и архитектуры модели.
1 Внутренние данные Meta, измерения за февраль 2026 года.
Представляем токенизацию GenRecs
Предварительно обученные мультимодальные модели анализируют каждое объявление, товар и страницу, включая текст и изображения, и кодируют эти объекты в эмбеддинг, содержащий знания о мире. Токенизатор объединяет этот сигнал содержания с представлениями, полученными на основе взаимодействий людей с объектами, а затем квантует результат в короткую последовательность дискретных токенов. У похожих объектов есть общие токены — так же, как у родственных слов есть общие корни. Например, рекламные объявления двух моделей беговых кроссовок — из прошлого и текущего сезонов — частично пересекаются по содержанию, поэтому новая кампания сразу получает преимущество от знаний, которые модель уже приобрела о товарах прошлого сезона.
В основе токенизации GenRecs лежит конвейер из трех этапов:
- Кодирование каждого объекта в семантическое пространство эмбеддингов.
- Разложение этого эмбеддинга на независимые подпространства.
- Квантование путем сопоставления каждого подпространства с элементом кодовой книги.
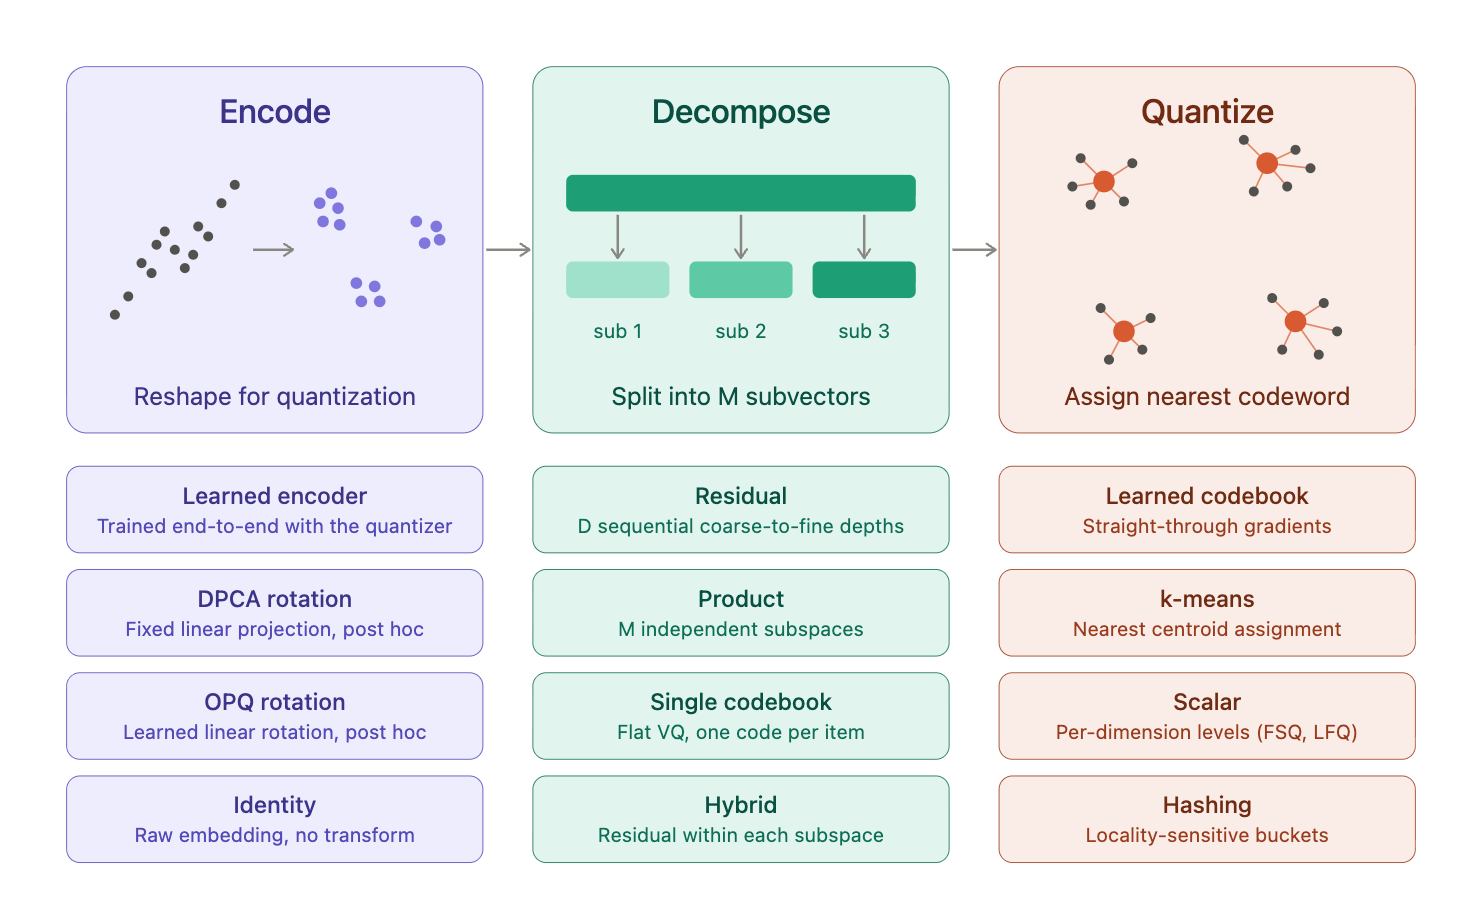
Чтобы добиться максимального качества рекламных рекомендаций, необходимо подбирать различные сочетания этих этапов с учетом семантики объектов и признаков. Например, для многих представлений рекламы токенизация GenRecs использует префиксные n-граммы, объединяющие обучаемый кодировщик, остаточное разложение, обучаемые векторные кодовые книги и параметризацию токенов.
Качество токенов предсказывает точность ранжирования
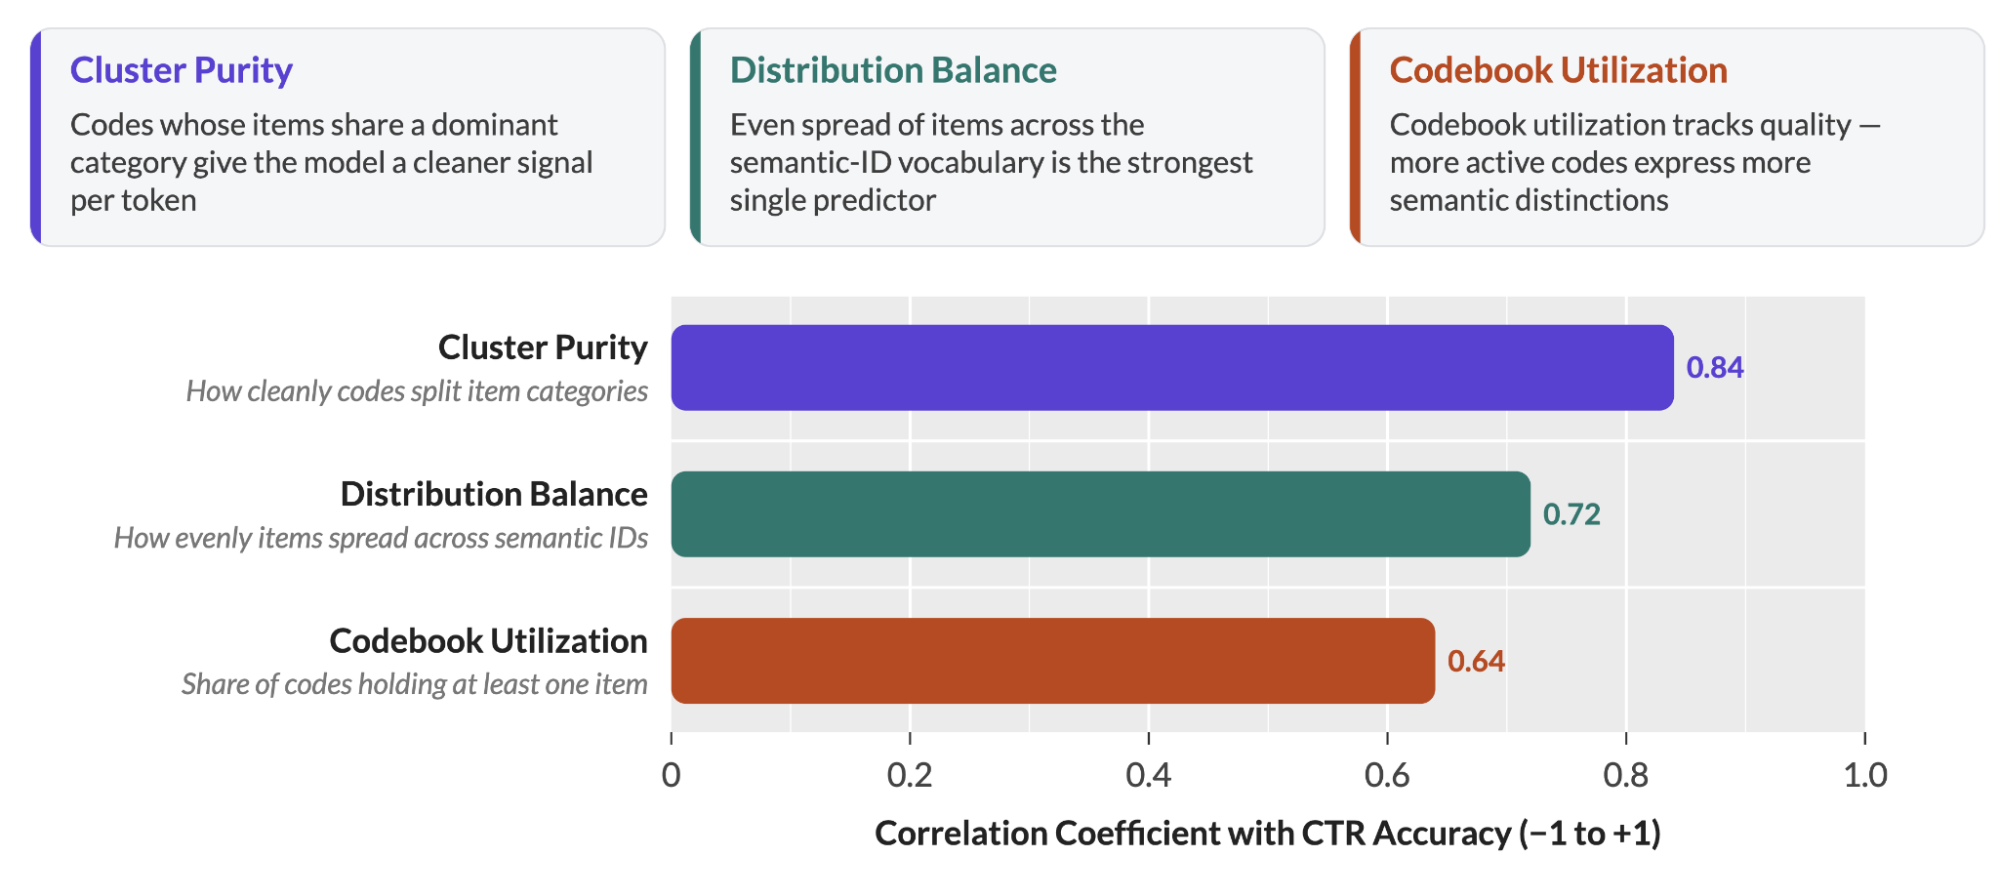
Помимо влияния на качество последующего ранжирования, качество модели-токенизатора можно оценивать по таким внутренним показателям, как:
- Чистота кластеров: Объекты с общим кодом, как правило, принадлежат к одной категории, благодаря чему модель получает более четкий сигнал от каждого токена;
- Сбалансированность распределения: Объекты равномерно распределяются между семантическими идентификаторами, а не сосредоточиваются в нескольких группах.
- Использование кодовой книги: Большая доля кодов содержит хотя бы один объект, поэтому словарь позволяет выражать больше различий.
Среди восьми протестированных нами версий токенизатора мы наблюдаем сильную корреляцию между этими внутренними показателями качества и точностью прогнозирования при последующем ранжировании. Версии токенизатора, показавшие лучшие результаты по этим показателям, также обеспечили более точное прогнозирование CTR в рекламных моделях.
Цикл развития токенизации
Токенизация повышает эффективность крупных кампаний, выявляя более глубокие семантические закономерности в обширных каталогах товаров. Для рекламных объявлений с небольшим охватом и малым числом показов токенизация позволяет рекомендательным моделям обобщать информацию на основе общей структуры содержания, восстанавливая эффективность при холодном старте и обеспечивая перенос знаний между объектами. Когда бренд спортивной одежды выпускает кроссовки для трейлраннинга следующего сезона, токенизация позволяет новому товару и его рекламе опираться на знания модели о кроссовках прошлого сезона — еще до того, как кто-либо увидит новое объявление.
Повышая точность прогнозов для объявлений с небольшим охватом, токенизация не только помогает правильно их ранжировать, но и улучшает обучающие данные, что, в свою очередь, повышает точность прогнозов для всех объявлений. Каждый виток этого самоусиливающегося цикла повышает качество прогнозов модели.
Основа рекомендательных систем на базе LLM
Улучшения токенизатора не ограничиваются моделью, для которой он был настроен. Оптимизация качества кодовой книги с помощью функции потерь разнообразия, сброса неиспользуемых кодов и контрастивных целевых функций обеспечивает измеримое повышение качества последующей работы, когда полученные токены используются для обучения генеративных рекомендательных систем. Наша работа над поиском, изначально ориентированным на LLM показывает, каких результатов можно добиться. Двухбашенная архитектура на основе общего кодировщика LLM обеспечивает передовое качество поиска и при этом эффективно работает в производственной среде, достигая результатов классических двухбашенных моделей при значительно меньшем объеме обучающих данных. Развивая этот подход, мы теперь совершенствуем ранжирование с учетом логических рассуждений на основе того же словаря.
Будущее токенизации GenRecs
Мы продолжаем развивать токенизацию GenRecs, чтобы приблизить ее к оптимальному по рентабельности инвестиций (ROI) уровню, и сосредоточились на трех направлениях:
Улучшение обобщения при холодном старте: Наибольшую пользу от семантических токенов получают рекламные объявления с небольшим охватом, и именно здесь их влияние на результаты рекламодателей наиболее заметно. Мы расширяем охват токенизации на все объекты, чтобы повысить эффективность рекламы для рекламодателей.
Приоритет качества токенизатора: Среди наших текущих направлений работы — обучение с учетом взаимодействий пользователей, единый словарь для разных типов объектов и совершенствование кодовой книги. Поскольку внутренние показатели качества позволяют предсказывать улучшения последующего ранжирования, мы можем совершенствовать токенизатор, не дожидаясь полного цикла обучения модели.
Эффективное использование архитектур, изначально рассчитанных на LLM: Токенизация с полным представлением в виде текста дает модели наиболее полное представление о рекламе, но требует контекстных окон, которые непрактично использовать в масштабах рекламной системы. Мы сочетаем компактные текстовые токены с семантическими идентификаторами, чтобы сохранить качество рассуждений и обеспечить приемлемую задержку.
В перспективе мы изучаем, может ли тот же словарь, который уже повышает качество ранжирования рекламы, объединить представления на разных площадках. Единое пространство токенов для рекламного контента — текста, изображений, аудио и видео — позволит моделям анализировать интересы человека и предложения рекламодателей на основе единого представления, а не объединять эмбеддинги, обученные по отдельности.
По мере того как рекомендательные системы переходят от дискриминативной оценки к генеративным рассуждениям, должна развиваться и основа данных: вместо временных идентификаторов необходимы стабильные семантические представления. Токенизация GenRecs закладывает эту основу, преобразуя сложную рекламную экосистему Meta в словарь, на котором генеративные модели могут обучаться, рассуждать и создавать новый контент.
Благодарности
Мы хотели бы поблагодарить Weifeng Cui, Ling Leng, Luke Simon, Hadar Ohana, Jimmy Chen, Minghai Chen, Chiyu Zhang, Dinesh Ramasamy, Debajyoti Roy, Shawn Shi, Gajanan Golegaonkar, Xiao Yang, Ashkan Aleali, Anuj Gargava, Xizhou Feng, Liquan Huang, Frank Shyu, Xiaoyu Chen, Kungang Li, Chonglin Sun, Matt Steiner, Sandeep Pandey, Santanu Kolay, Anuj Madan, Tak Yan и всю команду, которая участвовала в разработке и внедрении первой масштабной системы семантической токенизации в рекламной рекомендательной системе Meta.
