Как Meta создала Forum с помощью ИИ-ориентированной разработки
- Meta создала отдельное приложение Forum для групп Facebook небольшой командой с нуля, используя ИИ-агентов для планирования, разработки, тестирования и проверки.
- Успех измеряли количеством проверенных изменений, готовых к production: они должны были собираться, проходить автоматические тесты и визуальную проверку.
- Агент стресс-тестирования обнаружил проблему с памятью во время разработки, воспроизвёл её и проверил исправление до запуска.
Почему это важно: Meta сообщает, что подход ускорил выпуск приложения и повысил его качество.
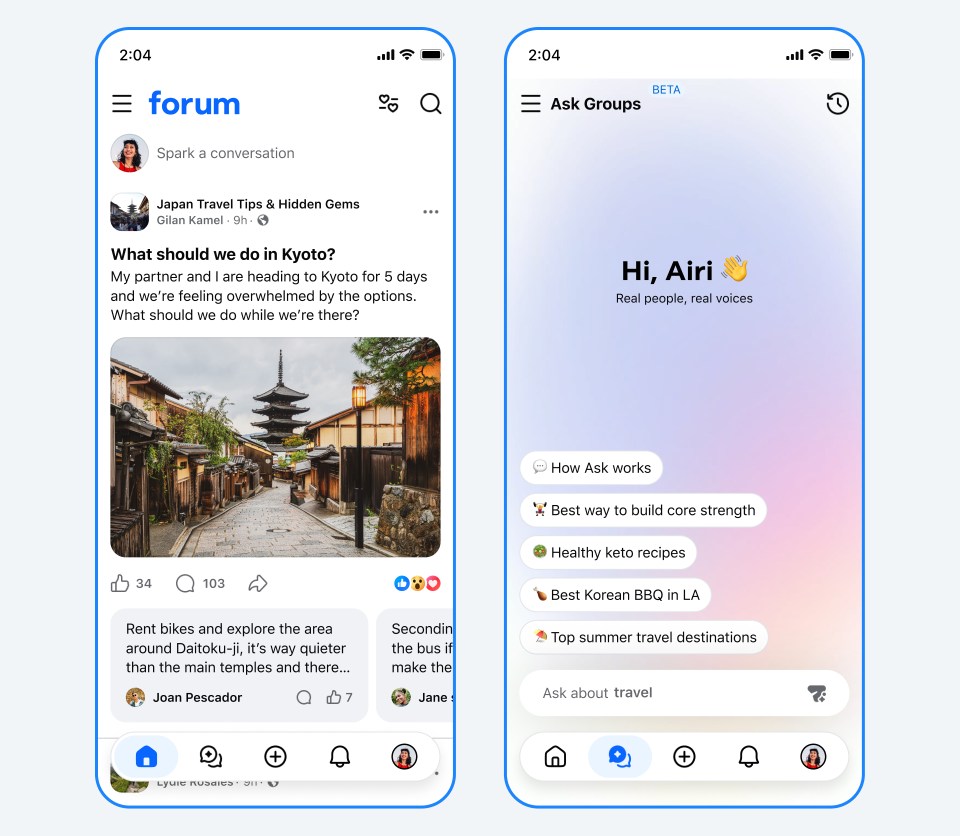
- Новейшее приложение Meta — Forum, — предназначено для всех, кто хочет глубже погрузиться в обсуждения в своих группах Facebook.
- Создавая Forum, инженеры Meta освоили совершенно новый подход к работе, включив ИИ-агента в цикл разработки.
- Мы рассказываем, что потребовалось для создания Forum с помощью агентного ИИ: как мы адаптировали кодовую базу, тестировали фреймворки и внутренние инструменты для агентного выполнения задач, что сработало, а что нет.
Forum — отдельное приложение для групп, созданное небольшой командой с нуля. Здесь мы также испытали иной подход к работе: рассматривали ИИ-агента как участника инженерного процесса, а не просто как средство быстрее набирать код.
Для этого эксперимента нужно было определить критерии успеха, и мы оценивали его не по объёму кода. Мы измеряли количество проверенных результатов, готовых к запуску в production, — изменений, которые собираются, проходят тесты и выдерживают проверку.
От участия человека в цикле — к надзору человека за циклом
Если направить ИИ только на этап написания кода, это мало что изменит. Результаты накапливались по мере того, как мы распространяли этот подход на этапы вокруг реализации — планирование, разработку, тестирование и проверку. Лучше всего перемены видны по тому, кто отвечает за каждый этап.
При подходе human-in-the-loop инженер управляет каждым этапом, а ИИ помогает в его рамках: автодополняет функцию, предлагает исправление или отвечает на вопрос. Каждая итерация продвигается с той скоростью, которую задаёт человек.
При подходе human-on-the-loop агент сам выполняет итерацию — планирует, реализует, собирает, тестирует, исправляет и повторяет, —, а инженер задаёт цель, следит за процессом, вмешивается, если тот отклоняется от курса, и утверждает результат. Роль человека смещается от выполнения отдельных этапов к ответственности за итог и соблюдению планки качества. Именно к этому мы стремимся, но пока не достигли конечной точки: сегодня некоторые этапы выполняются автономно, тогда как на других инженер по-прежнему участвует в каждой итерации.
Когда инженер осуществляет надзор, работа перестаёт быть строго последовательной. Циклы, которые раньше выполнялись один за другим, могут идти параллельно, а инженер тратит время на выбор направления и оценку, а не на то, чтобы ждать завершения цикла. Но это возможно, только если результатам можно доверять. Без проверки сгенерированный ИИ код создаёт знакомую проблему: правдоподобный результат, который никто не подтвердил, — действительно ли он работает, — и который инженеру приходится читать, отлаживать и зачастую отбрасывать. Ненадёжные сигналы не снимают ограничение, а лишь переносят его с написания кода на проверку кода, который выглядит готовым, но на деле таковым не является.
Поэтому мы установили планку на уровне проверки, а не компиляции. Успешная компиляция — не финишная черта: задача считается выполненной, только когда пройдены автоматические тесты и визуальные проверки. Прежде чем показать результат инженеру, агенты проверяют свою работу сами. Поэтому на проверку поступает меньше результатов, зато они надёжнее, — вместо того чтобы разбирать целую гору сгенерированного материала. Генерируется меньше, и меньше приходится отбрасывать. За каждым выпущенным результатом по-прежнему стоит одобрение инженера; мы постарались сделать его быстрым и подкреплённым убедительными данными, приложив к изменению результаты сборки и тестов, а также записи сеансов проверки.
Если инженер не участвует в каждом цикле, цикл должен безопасно выполняться самостоятельно. Для этого необходимы четыре возможности:
Планирование как техническая спецификация: Агентное выполнение требует предельной точности. Неоднозначность, которую инженер мог бы устранить, опираясь на интуицию, приводит к сбою агента. Мы вложились в тщательную предварительную декомпозицию и машиночитаемый контекст, что сделало инженерный цикл эффективнее как для инженеров, так и для агентов.
Автоматическая проверка внутри цикла — ключевой множитель эффективности: Мы встроили прямо в цикл агента автоматические сигналы об успехе или неудаче: статус сборки, модульные тесты и соответствие пользовательского интерфейса спецификации. Это позволило вести разработку асинхронно и получать готовые к проверке pull request«ы с заранее заполненными планами тестирования и записями сеансов проверки. Сложнее всего наладить именно проверку, и объём задач, которые можно безопасно передать циклу, зависит от того, насколько мы доверяем средствам проверки.
Имитация пользовательского тестирования с помощью агентов: Мы задействовали агентов навигации, которые взаимодействуют с работающим приложением так же, как человек. Они выполняют действия, считывают содержимое экрана и сообщают о регрессиях. Агенты навигации могут непрерывно проходить одни и те же сценарии проверки.
Агентное управление production-средой: После запуска агенты помогают автоматизировать анализ первопричин. Когда пользователь Forum отправляет отзыв, агенты используют его, чтобы проверить возможные регрессии. Затем они передают результаты анализа инженерам, которые решают, что делать дальше.
Модель работы
Для такой модели распределения ответственности нужна система из пяти ключевых компонентов:
- Правила — постоянные инструкции проекта. Если агент повторяет одну и ту же ошибку больше двух раз, мы один раз фиксируем способ её исправления для всех.
- Навыки превращают командные соглашения в загружаемые инструкции, которые агент может вызывать.
- Агенты автоматизируют проверки, которые раньше требовали ручного выполнения.
- Команды объединяют навыки и агентов в рабочие процессы. Они оценивают сложность, воспроизводят ошибку, планируют и реализуют исправление, создают pull request и проводят многоэтапную проверку.
- Хуки — автоматические триггеры, например запуск линтера после каждого хода агента, проверка подключения симулятора перед установкой и проверка тестов перед созданием pull request.
Адаптация среды к моделям
Наибольший эффект дала не смена промптов, а изменения кода и инструментов.
Понятность архитектуры важнее унаследованной сложности: Мы старались сделать кодовую базу Forum как можно проще и решили модульно разделить ключевые компоненты архитектуры. Так мы получили преимущества проверенной временем инфраструктуры и при этом упростили агентам подключение и работу с компонентами. Там, где это было сложно сделать, мы создавали всё с нуля, жертвуя повторным использованием ради пропускной способности агентной разработки; это окупилось ускорением разработки. Агенты усваивают закономерности из прочитанного кода. Исправьте неудачную закономерность один раз — и все последующие сеансы работы агентов унаследуют это улучшение; оставьте её — и тот же обходной путь будет появляться во всём коде, который агент напишет дальше.
Предоставляйте агентам инструменты, а не описания: Чаще всего агент терял ориентацию в приложении — например, менял главную ленту вместо главного экрана группы или угадывал координаты элементов. Поэтому вместо описания приложения мы дали ему инструменты для проверки: считывать актуальную иерархию представлений из симулятора, перечислять элементы, фактически отображаемые на экране, и находить путь к целевому представлению — всё это до выполнения действия. Число ошибочно направленных изменений резко сократилось. Тот же подход мы применили во всех случаях, когда агенты взаимодействовали с нашими системами: давали им возможность напрямую проверить состояние, а не описание, на основании которого нужно делать выводы.
Изоляция на уровне сборки для безопасного прототипирования с ИИ: По мере подготовки Forum к запуску мы хотели дать ранним прототипам и экспериментам, созданным агентами, пространство для работы, сохранив при этом в production-приложении только завершённые и проверенные изменения. Нам требовалась более надёжная гарантия, чем простое ограничение доступа к функциям, при котором прототипный код всё равно остаётся внутри production-сборки. Решением стала отдельная конфигурация сборки — тестовое приложение с той же самой кодовой базой, фреймворками и дизайн-системой, что и production-версия, но с архитектурой плагинов и сокетов, которая полностью исключает прототипный код из production-сборки.
Так мы одновременно получили три преимущества:
- Дизайнеры и коллеги из смежных команд могли свободно создавать прототипы с помощью инструментов ИИ, не привлекая инженера для каждого изменения.
- Всё созданное в тестовой среде можно было перенести в production напрямую, без повторной сборки.
- Прототипный код не мог привести к сбою production-приложения, потому что физически отсутствовал в этой сборке.
Благодаря такому подходу мы сохранили возможность быстро итерировать с помощью ИИ даже после того, как приложение стало использоваться реальными людьми, которых нужно было защитить.
Поиск реальных ошибок с помощью стресс-тестирования на ИИ
Адаптация среды не только ускорила работу агента — она превратила его в тестировщика. Мы не указывали ему на конкретный дефект. Вместо этого мы создали повторяемые стресс-сценарии, имитирующие поведение реальных пользователей: интенсивную прокрутку, случайный просмотр групп, быструю навигацию, многократную загрузку медиафайлов, — и регулярно запускали их на разных сборках. Поскольку такие запуски дают стабильные сигналы — сбои, рост потребления памяти, ошибки страниц, регрессии интерфейса, — агент может сортировать аномалии, выявлять последовательность действий, которая их вызвала, а затем исследовать первопричину.
Один из таких запусков выявил проблему с памятью. Агент выделил сценарий воспроизведения ошибки, предложил исправление и проверил его — всё это во время разработки, до того как приложение стало доступно пользователям. Исправление значительно снизило рост потребления памяти и количество ошибок страниц на устройстве при повторных стресс-тестах.
Архитектурные решения принимали инженеры, а обнаружение и мониторинг регрессий были автоматизированы и воспроизводимы. После обнаружения аномалии агент мог воспроизвести её → изолировать → предложить исправление → проверить его с помощью того же тестового инструментария.
Применение того же подхода к ленте Forum
Мы применили подход human-on-the-loop в двух областях:
Создание стека: Агенты описывали архитектурные варианты и компромиссы, а инженеры затем оценивали их и делали выбор. Мы намеренно оставили за человеком определение цели: решение о том, как выглядит хороший результат, — это продуктовая оценка, а не то, что система должна определять для себя сама.
Работа со стеком: Вопросы, для ответа на которые раньше требовался инженер, знакомый с соответствующим участком кода, теперь передаются агенту-исследователю. Он собирает необходимые данные и публикует отчёт с предложениями по исправлению. Вручную оценив ряд реальных расследований, мы выстроили рабочий процесс, в котором агент берёт на себя рутинную работу и передаёт инженеру структурированный отчёт. Инженер затем проверяет, действительно ли обнаружена ошибка или речь идёт о намеренном компромиссе.
Качество повысилось не благодаря более удачным промптам, а благодаря контексту. Результаты в одной повторяющейся категории расследований оставались слабыми, пока мы не дали агенту те же ссылки на соответствующие фрагменты кода, примеры запросов и проектную документацию, которые предоставили бы новому инженеру в первый рабочий день. Качество результатов в этой категории резко выросло. В отличие от обучения нового сотрудника, достаточно провести его один раз — и каждый последующий сеанс уже начинается с этого уровня.
Сработало ли это?
Мы не только ускорили выпуск приложения, но и повысили его качество. Непрерывная проверка выявляла системные проблемы — например, упомянутый выше узкий участок, связанный с памятью, — ещё во время разработки, а не после запуска. Результаты отражаются на показателях производительности:
- Качество, обеспеченное на раннем этапе: Автономный цикл стресс-тестирования обнаружил и помог устранить упомянутую выше проблему с памятью во время разработки, а не после запуска, сократив примерно вдвое использование памяти и число ошибок страниц.
- Скорость: За восемь недель Forum достиг паритета по основным функциям с Facebook Groups. ИИ выполнял значительную часть рутинной реализации, позволяя инженерам сосредоточиться на архитектуре, продуктовых решениях и качестве.
- Долгосрочный эффект: После запуска агенты помогали инженерам разбирать отзывы пользователей и выявлять первопричины проблем.
ИИ не просто генерировал код. Он усовершенствовал цикл контроля качества и помог небольшой команде выпустить качественное приложение, сократив объём последующих доработок.
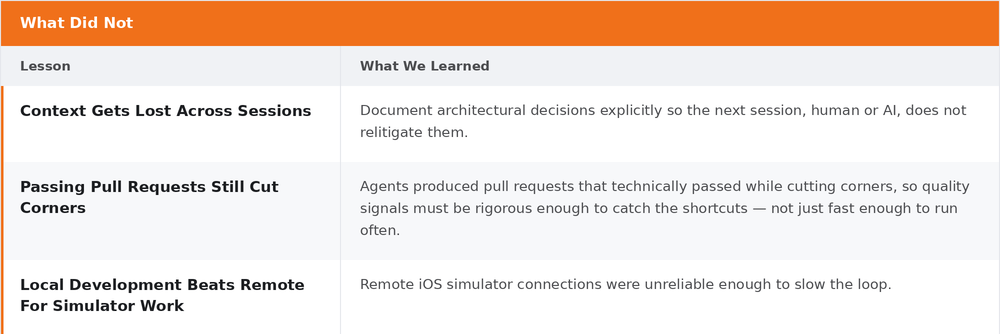
Что сработало, а что нет

Благодарности
Благодарим Neeharika Sinha, Jane Kou, Gang Yang, Guohao Zhang, Zeya Zhang, Kinnary Jangla, а такжеYonghui Lu за их ценный вклад.
