[Перевод] Правда о традиционных JavaScript-бенчмарках
Пожалуй, будет достаточно справедливо сказать, что JavaScript — самая важная современная технология в разработке программного обеспечения. Для многих из тех, кто изучал языки программирования, компиляторы и виртуальные машины, всё ещё удивителен тот факт, что при всей своей элегантности с точки зрения структуры языка JavaScript не слишком хорошо оптимизируем с точки зрения компилирования и не может похвастаться замечательной стандартной библиотекой. В зависимости от того, кто ваш собеседник, вы можете неделями перечислять недоработки в JavaScript и всё равно обнаружите какую-то странность, о которой ещё не слышали. Но несмотря на очевидные недостатки, сегодня JavaScript является ключевой технологией в вебе, доминирует в серверной/облачной сфере (благодаря Node.js), а также проникает в интернет вещей.
Возникает вопрос — почему JavaScript так популярен? Боюсь, у меня нет исчерпывающего ответа. Сегодня есть много причин для использования этого языка, важнейшими из которых, вероятно, являются огромная экосистема, выстроенная вокруг JavaScript, и несметное количество ресурсов. Но всё это в известной мере следствия. А почему же изначально язык стал популярен? Вы можете сказать: потому что долгое время он был лингва франка для веба. Но это было очень давно, и разработчики страстно ненавидели JavaScript. Если оглянуться назад, то рост популярности JavaScript начался во второй половине 2000-х. Как раз в те времена движки JavaScript начали гораздо быстрее работать с различными нагрузками, что, вероятно, повлияло на отношение многих к этому языку.
В те годы для измерения скорости применялись так называемые традиционные JavaScript-бенчмарки, начиная с Apple SunSpider, прародителя всех JS-микробенчмарков, затем были Mozilla Kraken и Google V8. Позднее гугловский бенчмарк был вытеснен Octane, а Apple выпустила JetStream. Эти традиционные бенчмарки приложили невероятные усилия для выведения производительности JavaScript на такую высоту, какой в начале века никто не ожидал. Отмечались тысячекратные ускорения, и внезапно использование <script> перестало быть танцем с дьяволом, а выполнение вычислений на клиентской стороне стало не просто возможным, а даже поощряемым.
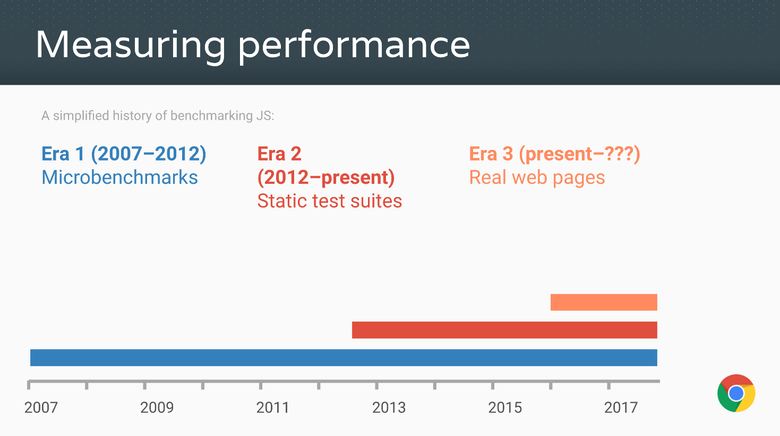
Источник: Advanced JS performance with V8 and Web Assembly, Chrome Developer Summit 2016, @s3ththompson.
В 2016 году все (значимые) JS-движки достигли невероятной производительности, и веб-приложения стали такими же шустрыми, как и нативные (или могут быть такими же шустрыми). Движки поставляются со сложными оптимизированными компиляторами, генерирующими короткие последовательности высокооптимизированного машинного кода. Достигается это за счёт вдумчивого выбора типа/формы (type/shape) для каждой операции (доступ к свойствам, двоичные операции, сравнения, вызовы и так далее) в зависимости от имеющейся статистики по различным типам/формам. Большинство этих оптимизаций диктовались микробенчмарками наподобие SunSpider и Kraken, а также статистическими пакетами вроде Octane и JetStream. Благодаря основанным на JavaScript технологиям вроде asm.js и Emscripten сегодня можно компилировать в JavaScript большие С++-приложения и выполнять их в браузере безо всякого скачивания и установки. Например, вы без труда прямо из коробки поиграете по сети в AngryBots, в то время как раньше для этого требовались специальные плагины вроде Adobe Flash или Chrome PNaCl.
Подавляющее большинство всех этих достижений стало возможным благодаря наличию микробенчмарков и пакетов измерения производительности, а также конкуренции, возникшей между традиционными JS-бенчмарками. Можете что угодно говорить о SunSpider, но очевидно, что без него производительность JavaScript вряд ли была бы такой, как сегодня.
Но довольно восхвалений, пришла пора взглянуть на обратную сторону монеты. Все измерительные тесты — будь то микробенчмарки или большие пакеты — обречены со временем становиться неактуальными! Почему? Потому что бенчмарк может вас чему-то научить только до тех пор, пока вы не начнёте с ним играться. Как только вы превысите (или не превысите) определённый порог, общая применимость оптимизаций, дающих выигрыш для данного бенчмарка, будет экспоненциально уменьшаться.
Например, мы использовали Octane в качестве прокси для измерения производительности реальных веб-приложений. И какое-то время он достаточно хорошо справлялся с этой задачей. Но сегодня распределение времени (distribution of time) в Octane и реальных приложениях сильно различается, поэтому дальнейшая оптимизация Octane вряд ли приведёт к каким-то значимым улучшениям в реальных приложениях (в том числе и для Node.js).

Источник: Real-World JavaScript Performance, конференция BlinkOn 6, @tverwaes.
По мере того как становилось всё более очевидным, что все традиционные бенчмарки для измерения производительности JavaScript, включая самые свежие версии JetStream и Octane, похоже, себя изжили, мы начали искать новые пути измерения реальных приложений, добавив в V8 и Chrome новые перехватчики для профилирования и трассировки. Также мы задействовали средства, позволяющие понять, на что у нас тратится больше времени при просмотре сайтов: на исполнение скрипта, сборку мусора, компилирование и так далее. Результаты исследований оказались очень интересными и неожиданными. Как видно из предыдущей иллюстрации, при запуске Octane более 70% времени тратится на исполнение JavaScript и сборку мусора, в то время как при просмотре сайтов на JavaScript всегда уходит меньше 30% времени, а на сборку мусора — не более 5%. Зато немало времени отнимают парсинг и компилирование, чего не скажешь об Octane. Так что значительные усилия по оптимизации исполнения JavaScript дадут вам хороший прирост попугаев в Octane, но сайты не станут грузиться заметно быстрее. Причём увлечение оптимизацией исполнения JavaScript может даже навредить производительности реальных приложений, потому что на компилирование начнёт уходить больше времени — или вам понадобится отслеживать дополнительные параметры, что удлинит компилирование, IC и Runtime.
Есть ещё один пакет бенчмарков, который пытается измерять общую производительность браузера, включая JavaScript и DOM: Speedometer. Он старается подходить к измерению более реалистично, запуская простое приложение TodoMVC, реализованное на разных популярных веб-фреймворках (на сегодняшний день оно немного устарело, но уже делается новая версия). В пакет включены новые тесты (angular, ember, react, vanilla, flight и backbone). На сегодняшний день Speedometer выглядит наиболее предпочтительным вариантом на роль прокси для измерения производительности реальных приложений. Но обратите внимание, что это данные по состоянию на середину 2016 года, и всё уже могло измениться по мере развития применяемых в вебе паттернов (например, мы рефакторим IC-систему для сильного снижения издержек, а также перепроектируем парсер). Хотя выглядит так, будто вышеописанная ситуация имеет отношение только к просмотру сайтов, мы получили очень убедительное доказательство того, что традиционные бенчмарки пиковой производительности не слишком хорошо подходят на роль прокси и в случае с реальными Node.js-приложениями.
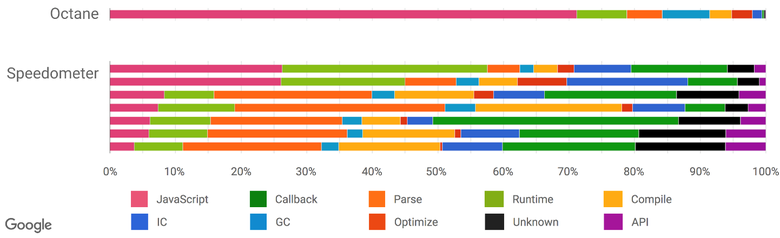
Источник: Real-World JavaScript Performance, конференция BlinkOn 6, @tverwaes.
Возможно, всё это уже известно широкой аудитории, так что дальше я лишь остановлюсь на нескольких конкретных примерах, иллюстрирующих мысль, почему для JS-сообщества не просто полезно, но и критически важно с определённого момента прекратить обращать внимание на статические бенчмарки пиковой производительности. Начну с примеров того, как JS-движки могут проходить бенчмарки и как они это делают на самом деле.
Печально известные примеры с SunSpiderСтатья о традиционных JS-бенчмарках была бы неполной без упоминания очевидных проблем SunSpider. Начнём с теста производительности, чья применимость в реальных ситуациях ограничена: bitops-bitwise-and.js.
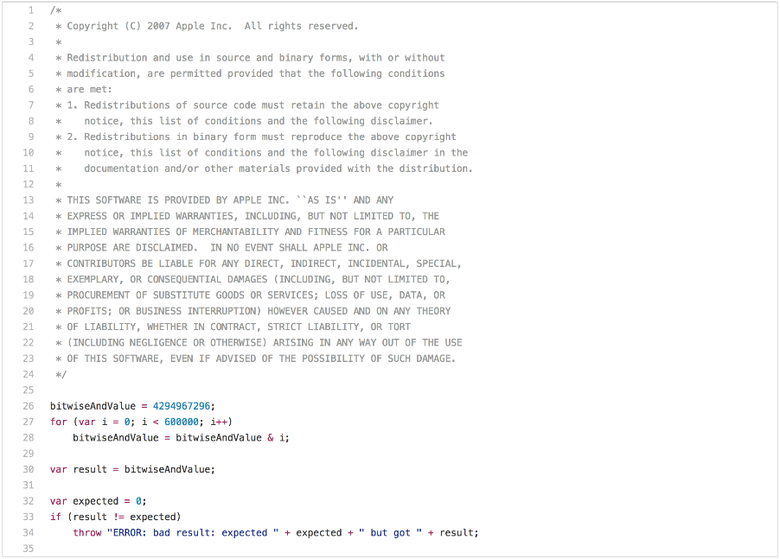
Здесь есть пара алгоритмов, которым требуется быстрая поразрядная операция И (bitwise AND), особенно в коде, транспилированном (transpile) из C/C++ в JavaScript. Однако вряд ли веб-страницам есть дело до того, может ли движок выполнять поразрядную операцию И в цикле вдвое быстрее другого движка. Вероятно, вы заметили, что после первой итерации цикла bitwiseAndValue становится равно 0 и остаётся таковым в течение следующих 599 999 итераций. Так что как только вы прогоните это с хорошей производительностью, то есть быстрее 5 мс на приличном железе, можете начать гонять этот бенчмарк в попытках понять, что нужна только первая итерация этого цикла, а все остальные — просто потеря времени (то есть мёртвый код после расщепления цикла). Для выполнения такого преобразования в JavaScript потребуется проверить:
- является ли
bitwiseAndValueобычным свойством глобального объекта до исполнения скрипта, - чтобы не было перехватчика глобального объекта или его прототипов, и так далее.
Но если вы действительно хотите победить в бенчмарке и ради этого готовы на всё, то можете выполнить тест менее чем за 1 мс. Но применимость оптимизации ограничена лишь этим конкретным случаем, и небольшие изменения теста, вероятно, не приведут к её срабатыванию.
Короче, тест bitops-bitwise-and.js был худшим примером микробенчмарка. Перейдём к более практичному примеру — тесту string-tagcloud.js. По сути, он прогоняет очень раннюю версию полифилла json.js. Пожалуй, этот тест выглядит куда разумнее предыдущего. Но если внимательнее посмотреть на профиль бенчмарка, то становится очевидно, что он тратит кучу времени на единственное выражение eval (до 20% общего времени исполнения для парсинга и компилирования и ещё до 10% для реального исполнения скомпилированного кода):

Посмотрим ещё внимательнее: eval исполняется лишь один раз и передаётся JSON-строке, содержащей массив из 2501 объекта с полями tag и popularity:
 ([
  {
    "tag": "titillation",
    "popularity": 4294967296
  },
  {
    "tag": "foamless",
    "popularity": 1257718401
  },
  {
    "tag": "snarler",
    "popularity": 613166183
  },
  {
    "tag": "multangularness",
    "popularity": 368304452
  },
  {
    "tag": "Fesapo unventurous",
    "popularity": 248026512
  },
  {
    "tag": "esthesioblast",
    "popularity": 179556755
  },
  {
    "tag": "echeneidoid",
    "popularity": 136641578
  },
  {
    "tag": "embryoctony",
    "popularity": 107852576
  },
  ...
])
Очевидно, что будет дорого парсить эти объектные литералы, генерировать нативный код и затем его исполнять. Гораздо дешевле просто парсить входную строку в виде JSON и генерировать соответствующий объектный граф. Чтобы улучшить результаты в бенчмарке, можно попробовать всегда изначально интерпретировать
eval как JSON и реально выполнять парсинг, компилирование и исполнение только в том случае, если не получится прочитать в виде JSON (правда, для пропуска скобок потребуется дополнительная магия). В 2007 году такое не сошло бы даже за плохой хак, ведь ещё не существовало JSON.parse. А к 2017-му это превратилось просто в технический долг в JavaScript-движке, да ещё и потенциально может замедлить использование eval. По сути, обновление бенчмарка до современного JavaScript--- string-tagcloud.js.ORIG 2016-12-14 09:00:52.869887104 +0100
+++ string-tagcloud.js 2016-12-14 09:01:01.033944051 +0100
@@ -198,7 +198,7 @@
replace(/"[^"\\\n\r]*"|true|false|null|-?\d+(?:\.\d*)?(:?[eE][+\-]?\d+)?/g, ']').
replace(/(?:^|:|,)(?:\s*\[)+/g, ''))) {
- j = eval('(' + this + ')');
+ j = JSON.parse(this);
return typeof filter === 'function' ? walk('', j) : j;
}приводит к немедленному повышению производительности: на сегодняшний день runtime для V8 LKGR снижается с 36 до 26 мс, 30-процентное улучшение!
$ node string-tagcloud.js.ORIG
Time (string-tagcloud): 36 ms.
$ node string-tagcloud.js
Time (string-tagcloud): 26 ms.
$ node -v
v8.0.0-pre
$
Это обычная проблема статичных бенчмарков и пакетов тестирования производительности. Сегодня никто не будет всерьёз использовать
eval для парсинга JSON-данных (по причине безопасности, а не только производительности). Вместо этого во всём коде, написанном за последние пять лет, используется JSON.parse. Более того, применение eval для парсинга JSON в production может быть расценено как баг! Так что в этом древнем бенчмарке не учитываются усилия авторов движков по увеличению производительности относительно недавно написанного кода. Вместо этого было бы полезно сделать eval излишне сложным, чтобы получить хороший результат в string-tagcloud.js.Перейдём к другому примеру — 3d-cube.js. Этот бенчмарк выполняет много матричных операций, с которыми даже самые умные компиляторы не могут ничего поделать, кроме как просто исполнить. Бенчмарк тратит много времени на выполнение функции Loop и вызываемых ею функций.

Интересное наблюдение: функции RotateX, RotateY и RotateZ всегда вызываются с параметром-константой Phi.
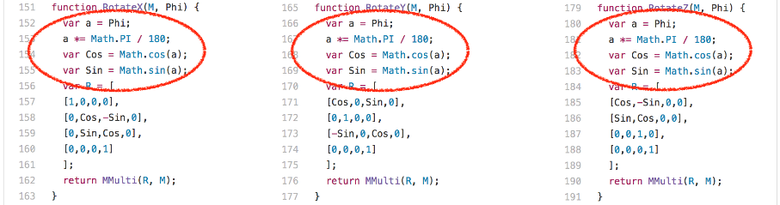
Это означает, что мы всегда вычисляем они и те же значения для Math.sin и Math.cos, каждое по 204 раза. Есть только три разных входных значения:
- 0,017453292519943295
- 0,05235987755982989
- 0,08726646259971647
Чтобы избежать лишних вычислений одних и тех же значений синуса и косинуса, можно кешировать ранее вычисленные значения. Раньше V8 именно это и делал, а все остальные движки делают так до сих пор. Мы убрали из V8 так называемый трансцендентальный кеш, поскольку его избыточность была заметна при реальных нагрузках, когда ты не вычисляешь всегда одни и те же значения в строке. Мы сильно провалились в результатах бенчмарка SunSpider, убрав эту специфическую оптимизацию, но полностью уверены, что не имеет смысла оптимизировать под бенчмарк и в то же время ухудшать результаты на реальных проектах.
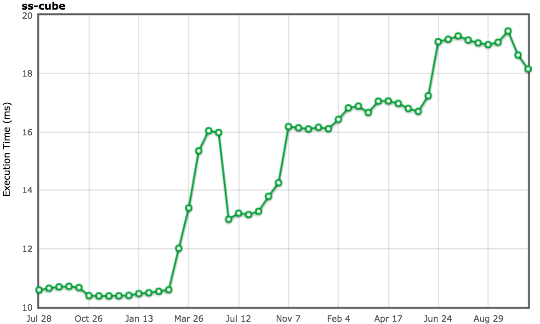
Источник: arewefastyet.com.
Очевидно, что лучший способ работы с такими константами — входными синусом/косинусом — нормальная эвристика замещения вызова (inlining heuristic), которая попытается сбалансировать замещение и учесть разные факторы вроде предпочтения замещения в точках вызова, когда может быть полезна свёртка констант (constant folding) (как в случае с RotateX, RotateY и RotateZ). Но по ряду причин такое не подходило для компилятора Crankshaft. Зато это разумный вариант в случае с Ignition и TurboFan, и мы уже работаем над улучшением эвристики замещения.
Помимо специфических случаев, у SunSpider есть и другая фундаментальная проблема: общее время исполнения. Сейчас на приличном железе Intel движок V8 прогоняет весь бенчмарк примерно за 200 мс (в зависимости от живых объектов в новом пространстве и фрагментации старого пространства), в то время как основная пауза на сборку мусора легко может достигать 30 мс. И мы ещё не учитываем расходы на инкрементальную маркировку (incremental marking), а это более 10% общего времени исполнения пакета SunSpider! Так что если движок не хочет замедлиться на 10—20% из-за сборки мусора, то ему нужно как-то удостовериться, что она не будет инициирована во время выполнения SunSpider.
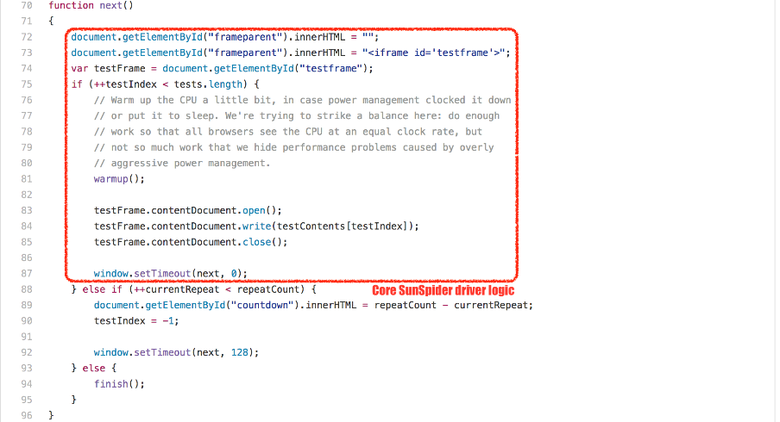
Для этого используются разные трюки, но все они, насколько мне известно, не оказывают положительного влияния на реальные задачи. V8 поступает просто: поскольку каждый тест SunSpider выполняется в новом