Создание защитных механизмов для Claude

Claude помогает миллионам пользователей решать сложные задачи, раскрывать творческий потенциал и глубже понимать окружающий мир. Мы стремимся расширять возможности человека, одновременно заботясь о том, чтобы потенциал наших моделей был направлен на благо. Это означает постоянное совершенствование поддержки пользователей в их обучении и решении проблем, а также предотвращение злоупотреблений, которые могут нанести вред в реальном мире.
Именно здесь вступает в дело наша команда по обеспечению безопасности (Safeguards): мы выявляем потенциальные злоупотребления, реагируем на угрозы и создаем средства защиты, которые помогают сделать Claude полезным и безопасным. Команда Safeguards объединяет экспертов в области политики безопасности, правоприменения, продуктов, науки о данных, анализа угроз и инженерии, которые понимают, как создавать надежные системы и как злоумышленники пытаются их взломать.
Мы работаем на нескольких уровнях: разрабатываем правила, влияем на обучение моделей, проводим тестирование на предмет вредоносных ответов, обеспечиваем соблюдение правил в режиме реального времени, а также выявляем новые виды злоупотреблений и атак. Такой подход охватывает весь жизненный цикл наших моделей, гарантируя, что Claude обучается и создается с учетом средств защиты, эффективных в реальном мире.
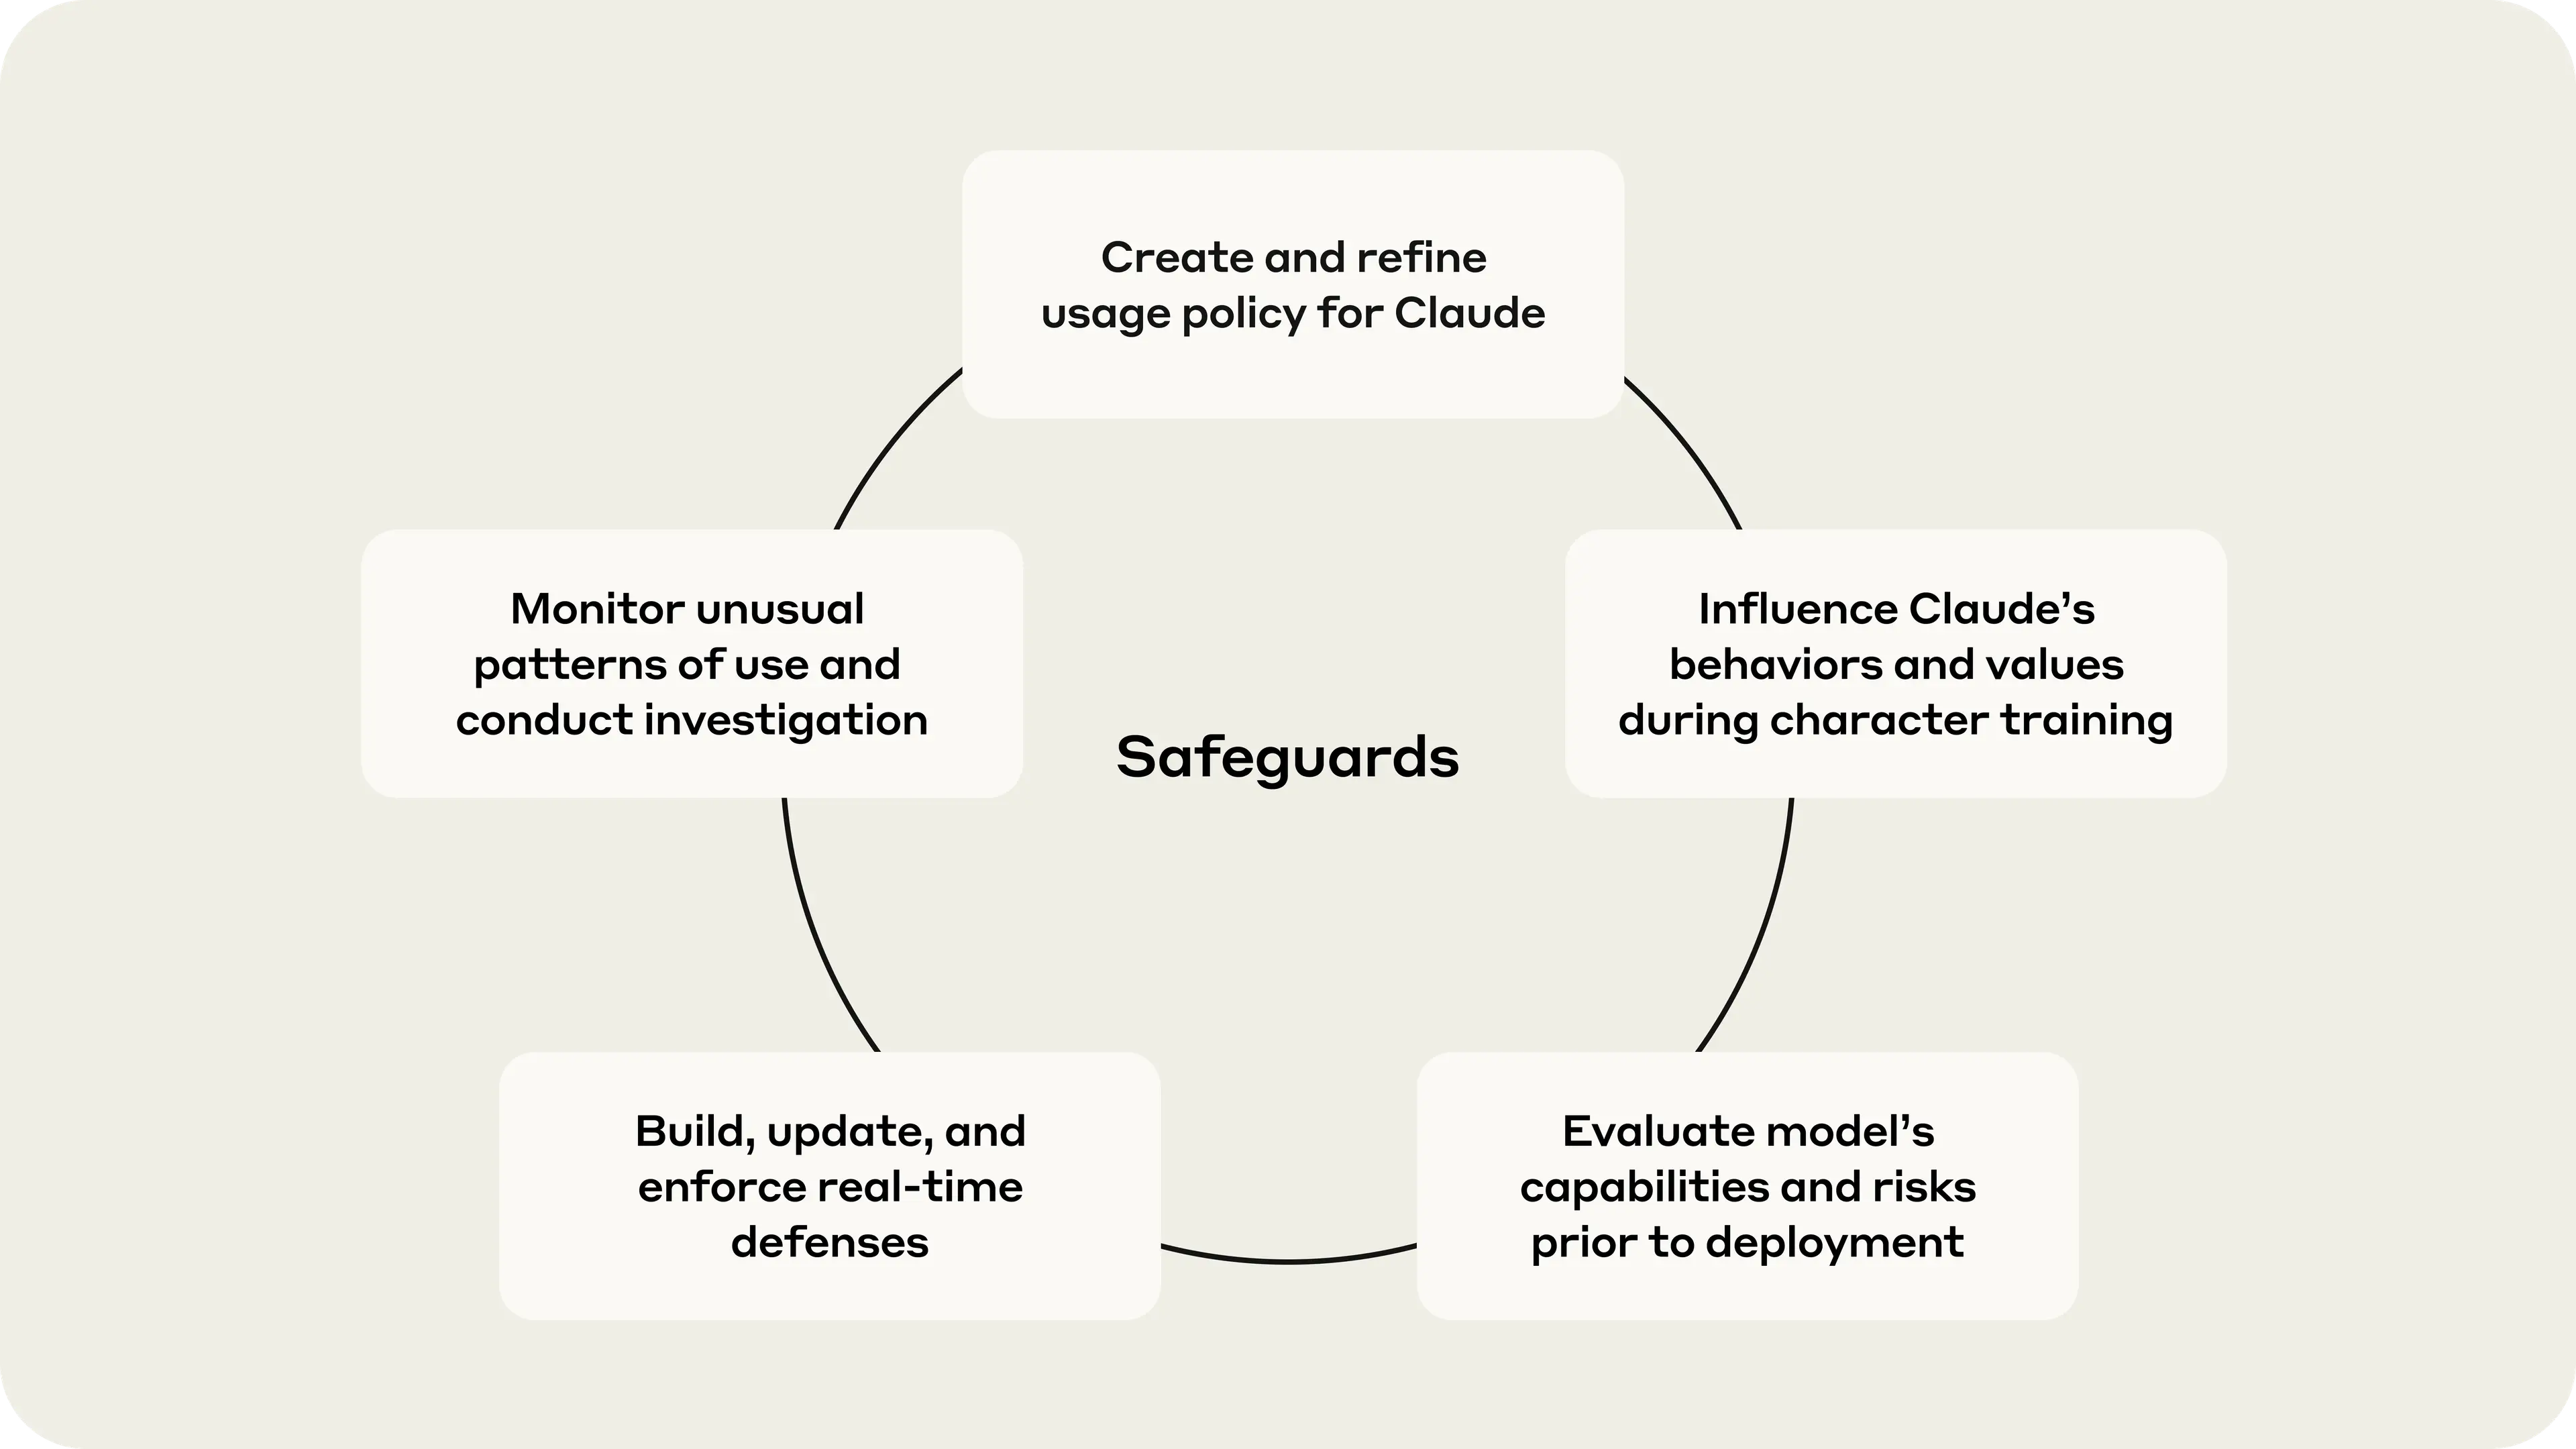 Рисунок 1: Подход команды Safeguards к созданию эффективной защиты на протяжении всего жизненного цикла наших моделей
Разработка правил
Команда Safeguards разрабатывает Правила использования (Usage Policy) — основу, определяющую, как можно и как нельзя использовать Claude. Правила использования определяют наш подход к таким критически важным сферам, как безопасность детей, защита выборов и кибербезопасность, а также содержат детальные рекомендации по применению Claude в таких отраслях, как здравоохранение и финансы.
Процесс разработки и доработки правил регулируется двумя основными механизмами:
- Единая концепция вреда (Unified Harm Framework): Эта развивающаяся концепция помогает нашей команде оценивать потенциально вредные последствия использования Claude по пяти измерениям: физическому, психологическому, экономическому, социальному и нарушению индивидуальной автономии. Вместо формальной системы оценивания этот фреймворк служит структурированной оптикой, которая учитывает вероятность и масштаб возможных злоупотреблений при разработке политик и процедур правоприменения.
- Тестирование политик на уязвимость: Мы сотрудничаем с внешними профильными экспертами для выявления проблемных зон, а затем проверяем эти зоны на прочность в отношении наших правил, оценивая ответы моделей на сложные запросы. Среди наших партнеров — специалисты по борьбе с терроризмом и радикализацией, эксперты по детской безопасности и психическому здоровью. Выводы, полученные в ходе такого стресс-тестирования, напрямую влияют на наши правила, методы обучения и системы обнаружения. Например, во время выборов в США в 2024 году мы сотрудничали с Институтом стратегического диалога (Institute for Strategic Dialogue), чтобы понять, в каких ситуациях Claude может предоставлять устаревшую информацию. В результате мы добавили баннер, который направляет пользователей Claude.ai, ищущих информацию о выборах, к авторитетным источникам, таким как TurboVote.
 Рисунок 2: Баннер с точной информацией о голосовании, отображавшийся во время избирательного цикла в США в 2024 году как результат тестирования наших правил на уязвимость совместно с Институтом стратегического диалога
Обучение Claude
Команда Safeguards тесно сотрудничает с командами дообучения в рамках совместного процесса, призванного предотвратить вредное поведение и ответы со стороны Claude. Это предполагает детальное обсуждение того, какое поведение модель должна или не должна демонстрировать, что помогает принимать решения о внедрении тех или иной черт в модель в процессе обучения.
Наши процессы оценки и обнаружения также выявляют потенциально вредные ответы. При обнаружении проблем мы работаем с командами дообучения над такими решениями, как обновление моделей вознаграждения в процессе обучения или корректировка системных промптов для уже развернутых моделей.
Мы также привлекаем профильных специалистов и экспертов для того, чтобы Claude лучше понимал чувствительные темы. Например, мы сотрудничаем с ThroughLine, лидером в сфере онлайн-поддержки в кризисных ситуациях, чтобы сформировать глубокое понимание того, где и как модель должна реагировать в ситуациях, связанных с самоповреждением и психическим здоровьем. Мы передаем эти данные нашей обучающей команде, чтобы помочь Claude тоньше реагировать на подобные запросы вместо того, чтобы полностью отказываться от диалога или неверно истолковывать намерения пользователя.
Благодаря этому совместному процессу Claude приобретает ряд важных навыков. Модель учится отказывать в помощи при совершении вредных противоправных действий, а также распознает попытки создания вредоносного кода, мошеннического контента или планирования опасных мероприятий. Она учится аккуратно обсуждать деликатные темы и отличать их от попыток причинить реальный вред.
Тестирование и оценка
Перед выпуском новой модели мы оцениваем ее производительность и возможности. Наши оценки включают в себя:
 Рисунок 3: Перед развертыванием мы тестируем каждую модель посредством проверок безопасности, оценок рисков и тестов на предвзятость
- Оценка безопасности: Мы проверяем соблюдение Claude наших правил использования по таким темам, как эксплуатация детей или самоповреждение. Мы тестируем различные сценарии, включая очевидные нарушения правил, неоднозначные контексты и продолжительные многошаговые диалоги. В этих оценках используются наши собственные модели для анализа ответов Claude, а проверка человеком служит дополнительным контролем точности.
- Оценка рисков: Для областей с высоким уровнем риска, таких как киберугрозы или оружие массового уничтожения (химическое, биологическое, радиологическое, ядерное и высокомощные взрывчатые вещества — CBRNE), мы проводим тестирование возможностей ИИ на предмет их прироста в партнерстве с государственными структурами и частным сектором. Мы определяем модели угроз, которые могут возникнуть из-за расширения возможностей ИИ, и оцениваем эффективность наших защитных барьеров против таких угроз.
- Оценка предвзятости (Bias evaluations): Мы проверяем, насколько стабильно Claude предоставляет надежные и точные ответы в различных контекстах и для разных пользователей. Для выявления политической предвзятости мы тестируем запросы с противоположными точками зрения, сравнивая ответы и оценивая их на предмет фактической точности, полноты, эквивалентности и согласованности. Мы также тестируем ответы на такие темы, как трудоустройство и здравоохранение, чтобы определить, приводит ли наличие атрибутов идентичности (например, пола, расы или религии) к предвзятым результатам.
Это тщательное тестирование перед развертыванием помогает нам проверить, выдерживает ли обучение нагрузку, и подсказывает, нужно ли создавать дополнительные защитные механизмы для мониторинга рисков и защиты от них. Во время предварительных оценок нашего инструмента для работы с компьютером (computer use) мы установили, что он может способствовать созданию и распространению спама. В ответ на это еще до запуска мы разработали новые методы обнаружения и механизмы правоприменения, включая возможность отключить инструмент для аккаунтов, проявляющих признаки злоупотребления, а также новую защиту пользователей от атак внедрения промптов (prompt injection).
Результаты наших оценок публикуются в системных картах (system cards), выпускаемых вместе с каждой новой линейкой моделей.
Обнаружение и правоприменение в реальном времени
После развертывания моделей мы используем комбинацию автоматизированных систем и проверки человеком для выявления вредоносных действий и обеспечения соблюдения Правил использования.
Наши системы обнаружения и правоприменения работают на базе набора специализированных или особым образом дообученных моделей Claude, называемых »классификаторами» (classifiers). Они созданы для выявления конкретных типов нарушений правил в режиме реального времени. Мы можем одновременно развертывать множество различных классификаторов, каждый из которых отслеживает определенные виды угроз, в то время как основной диалог протекает естественным образом. Наряду с классификаторами мы также используем специализированные средства обнаружения материалов с сексуальным насилием над детьми (CSAM): в наших собственных продуктах мы сверяем хэши загруженных изображений с базами данных известных материалов CSAM.
Эти классификаторы помогают нам определять, следует ли принимать меры принудительного характера, и если да, то какие именно:
- Коррекция ответов: Мы можем в режиме реального времени корректировать то, как Claude интерпретирует определенные запросы пользователей и реагирует на них, чтобы предотвратить появление опасного контента. Например, если наш классификатор обнаруживает, что пользователь пытается сгенерировать спам или вредоносное ПО, мы можем автоматически добавить дополнительные инструкции в системный промпт Claude для изменения характера ответа. В ограниченном числе случаев мы также можем полностью остановить генерацию ответа Claude.
- Меры в отношении аккаунтов: Мы анализируем паттерны нарушений и можем принимать дополнительные меры на уровне учетной записи, включая предупреждения или, в тяжелых случаях, блокировку аккаунта. У нас также имеются средства защиты от создания мошеннических аккаунтов и неправомерного использования наших сервисов.
Создание таких правоприменительных систем представляет собой серьезную задачу как с точки зрения исследований в области машинного обучения, необходимых для их проектирования, так и с точки зрения инженерных решений, требуемых для их реализации. Например, наши классификаторы должны обрабатывать триллионы входных и выходных токенов, одновременно минимизируя вычислительные затраты и избегая ложных срабатываний на безопасном контенте.
Непрерывный мониторинг и расследования
Мы также отслеживаем вредоносный трафик, выходя за рамки отдельных запросов и учетных записей, чтобы понимать распространенность конкретных видов вреда и выявлять более изощренные схемы атак. Эта работа включает в себя:
- Аналитика и наблюдения Claude: Наш инструмент аналитики (insights tool) помогает измерять реальное использование Claude и анализировать трафик с сохранением конфиденциальности, объединяя диалоги в тематические кластеры высокого уровня. Исследования на основе этой работы (например, об эмоциональном влиянии использования Claude) помогают формировать новые защитные барьеры.
- Иерархическая суммаризация: Для мониторинга возможностей использования компьютера или потенциальных вредоносных киберактивностей мы используем иерархическую суммаризацию — метод, который сводит отдельные взаимодействия в краткие сводки, а затем анализирует их для выявления проблем на уровне учетных записей. Это помогает замечать поведение, которое может казаться нарушением только в совокупности, например, автоматизированные операции влияния и другие крупномасштабные злоупотребления.
- Анализ угроз (Threat intelligence): Мы также изучаем наиболее серьезные случаи злоупотребления нашими моделями, выявляя противоправное использование и паттерны, которые могут пропускать существующие системы обнаружения. Мы используем такие методы, как сравнение индикаторов злоупотреблений (например, необычных всплесков активности аккаунта) с типичными паттернами использования для выявления подозрительной активности, а также сопоставляем внешние данные об угрозах (из открытых репозиториев или отраслевых отчетов) с нашими внутренними системами. Мы также отслеживаем площадки, где могут действовать злоумышленники, включая социальные сети, мессенджеры и хакерские форумы. Мы делимся своими выводами в публичных отчетах об угрозах.
Взгляд в будущее
Обеспечение безопасности при использовании ИИ — слишком важная задача, чтобы какая-то одна организация могла решить ее в одиночку. Мы активно ищем отзывы и партнерство со стороны пользователей, исследователей, директивных органов и организаций гражданского общества. Мы также опираемся на обратную связь от широкой общественности, в том числе в рамках продолжающейся программы выплаты вознаграждений за найденные уязвимости (bug bounty) для тестирования нашей защиты.
Для поддержки нашей работы мы активно ищем специалистов, которые помогут нам решать эти задачи. Если вам интересна работа в команде Safeguards, мы приглашаем вас заглянуть на нашу страницу вакансий.
Полный текст статьи читайте на Anthropic
