Результаты работы нашей команды передового тестирования (Frontier Red Team)

В этой публикации мы делимся нашими выводами о траектории потенциальных рисков для национальной безопасности со стороны передовых ИИ-моделей, а также размышлениями о проблемах и передовых методах оценки этих рисков. Информация в этом посте основана на работе, которую мы проводили в течение последнего года для четырех выпусков моделей. Наша оценка заключается в том, что ИИ-модели демонстрируют «ранние предупреждающие» признаки быстрого прогресса в ключевых возможностях двойного назначения: модели приближаются, а в некоторых случаях и превосходят навыки уровня бакалавриата в области кибербезопасности и знания экспертного уровня в некоторых областях биологии. Тем не менее, современные модели не дотягивают до тех пороговых значений, при которых мы считаем, что они создают существенно повышенные риски для национальной безопасности.
ИИ стремительно совершенствуется в различных сферах
Хотя возможности ИИ быстро развиваются во многих областях, важно отметить, что реальные риски зависят от множества факторов, выходящих за рамки самого ИИ. Физические ограничения, специализированное оборудование, человеческий опыт и практические трудности внедрения остаются значительными барьерами, даже несмотря на то, что ИИ совершенствуется в задачах, требующих интеллекта и знаний. Учитывая этот контекст, вот что мы узнали о развитии возможностей ИИ в ключевых областях.
Кибербезопасность
В сфере кибернетики 2024 год стал моментом «от нуля до единицы». В соревнованиях CTF (Capture The Flag — состязания по кибербезопасности, которые заключаются в поиске и использовании уязвимостей программного обеспечения в контролируемой среде) модель Claude всего за один год улучшила свои показатели с уровня старшеклассника до уровня студента бакалавриата.
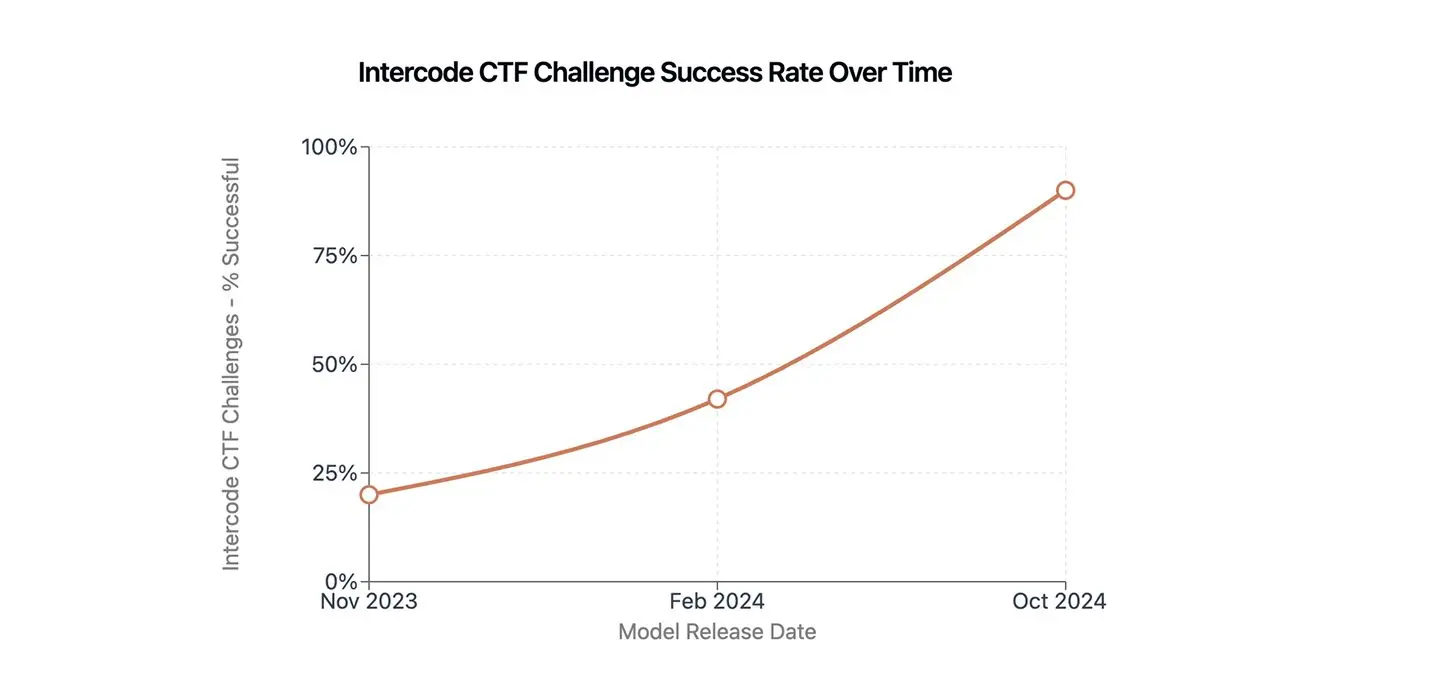 Рисунок 1: Меньше чем за год Claude прошла путь от решения менее чем четверти до практически всех задач Intercode CTF — общедоступных соревнований CTF, разработанных для школьных турниров.
Мы уверены, что это отражает реальное улучшение возможностей, поскольку мы самостоятельно разработали дополнительные задания, чтобы гарантировать их отсутствие в обучающих данных модели.
Это улучшение кибернетических возможностей продолжилось и в нашей новейшей модели Claude 3.7 Sonnet. На Cybench — публичном бенчмарке, использующем задачи CTF для оценки больших языковых моделей (LLM), — Claude 3.7 Sonnet решает примерно треть задач в течение пяти попыток, по сравнению примерно с пятью процентами у нашей передовой модели в это же время в прошлом году (см. Рисунок 2).
 Рисунок 2: Claude 3.7 Sonnet демонстрирует явное улучшение в бенчмарке Cybench CTF по сравнению с предыдущими двумя поколениями моделей, даже без использования расширенного мышления.
Эти улучшения происходят в различных категориях задач по кибербезопасности. На Рисунок 3 показано улучшение показателей разных поколений моделей на различных типах задач CTF, которые требуют обнаружения и использования уязвимостей в небезопасном программном обеспечении на удаленном сервере («pwn»), веб-приложениях («web»), а также криптографических примитивах и протоколах («crypto»). Тем не менее, навыки Claude все еще отстают от экспертов-людей. Например, модель по-прежнему испытывает трудности с обратной разработкой (реверс-инжинирингом) бинарных исполняемых файлов для поиска скрытых уязвимостей, а также с проведением разведки и эксплуатации уязвимостей в сетевой среде — по крайней мере, без посторонней помощи.
 Рисунок 3: Claude совершенствуется в решении CTF-задач в нескольких категориях (производительность Claude 3.7 Sonnet указана без использования расширенного мышления).
Работая со сторонними экспертами из Университета Карнеги-Меллона, мы провели эксперименты на реалистичных крупных киберполигонах (около 50 хостов), которые проверяют способность модели обнаруживать и использовать уязвимости в небезопасном ПО, а также заражать сеть и распространяться внутри нее в латеральном направлении. По сравнению с традиционными упражнениями CTF, эти задачи имитируют сложность реальной кибероперации, требуя от модели способности проводить разведку и координировать многоэтапную кибератаку. На данный момент модели не способны автономно преуспеть в такой сетевой среде. Но будучи оснащенными набором программных инструментов, созданных исследователями в области кибербезопасности, Claude (и другие LLM) смогли с помощью простых инструкций успешно воспроизвести атаку, аналогичную известной масштабной краже персональных данных из бюро кредитных историй.
 Рисунок 4: Один из наших исследователей совместно с академическими партнерами разработал Incalmo — набор инструментов, позволяющих современным LLM успешно действовать в качестве киберпреступников в реалистичных сетевых условиях. Иллюстрация предоставлена Singer et al. (2025).
Эта инфраструктура оценки позволяет нам своевременно предупреждать об улучшении автономных возможностей модели, а также потенциально способствует повышению полезности ИИ для киберобороны — путь, по которому идут и другие лаборатории, добиваясь многообещающих результатов.
Биобезопасность
В нашей предыдущей публикации мы подробно останавливались на оценке биобезопасности, и мы продолжили эту работу. Мы наблюдаем быстрый прогресс в понимании биологии нашими моделями. Меньше чем за год Claude прошла путь от показателей ниже уровня экспертов мирового класса по вирусологии в тесте, разработанном для проверки типичных сценариев устранения неполадок в лабораторных условиях, до уверенного превосходства этого базового уровня (см. Рисунок 5).
 Рисунок 5: Производительность Claude улучшилась в тесте VCT (оценка возможностей модели в устранении неполадок при решении вирусологических задач), разработанном организацией SecureBio. Claude 3.7 Sonnet использовала функцию расширенного мышления.
Тем не менее, возможности Claude в области биологии остаются неравномерными. Например, внутреннее тестирование вопросов, оценивающих навыки модели в исследованиях «мокрой лаборатории» (wet-lab), показывает, что наши модели приближаются к базовым уровням экспертов-людей в понимании биологических протоколов и манипуляциях с последовательностями ДНК и белков. Наша новейшая модель превосходит базовые показатели экспертов-людей в рабочих процессах клонирования. При этом модели по-прежнему уступают экспертам-людям в интерпретации научных графиков и иллюстраций.
 Рисунок 6: Claude 3.7 Sonnet улучшила свои показатели в задачах LabBench по сравнению с Claude 3.5 (New), приблизившись к человеческому базовому уровню, а в некоторых случаях и превзойдя его. Claude 3.7 Sonnet использовала функцию расширенного мышления.
Чтобы оценить, как эти улучшающиеся, но неоднородные биологические знания соотносятся с рисками в сфере биобезопасности, мы провели небольшие контролируемые исследования задач, связанных с созданием оружия, и поработали с экспертами мирового уровня по биозащите. В ходе одного из экспериментальных исследований мы выяснили, что наша самая последняя модель предоставила новичкам определенный прирост эффективности по сравнению с другими участниками, у которых не было доступа к модели. Тем не менее, даже самый высоко оцененный план участника, имевшего доступ к модели, все равно содержал критические ошибки, которые привели бы к провалу в реальном мире.
Аналогичным образом, выводы независимых экспертов по red-teaming оказались неоднозначными. Некоторые эксперты отметили улучшение знаний модели в определенных аспектах создания оружия, в то время как другие указали, что количество критических ошибок в планировании модели было слишком велико для успешного завершения атаки от начала до конца. В целом, этот анализ предполагает, что наши модели не могут надежно провести начинающего злоумышленника через ключевые практические этапы приобретения биооружия. Учитывая быстрый прогресс, тем не менее, мы продолжаем инвестировать значительные средства в мониторинг рисков биобезопасности и разработку мер противодействия — таких как наша недавняя работа над конституционными классификаторами, — чтобы быть готовыми, если и когда модели достигнут более тревожных уровней производительности.
 Рисунок 7: В небольших экспериментах с сотрудниками Anthropic и внешними участниками из Sepal AI группы, использовавшие любую из двух новейших моделей Claude, продемонстрировали лучшие результаты по сравнению с теми, кто пользовался только интернетом при оценке текстовых сценариев приобретения и планирования биооружия. (Участники из Sepal имели доступ к двум предварительным версиям Claude 3.7 Sonnet, одна из которых, «H-only V2», была разработана исключительно с целью помощи и с меньшей вероятностью отказа от вредоносных запросов. Сотрудники Anthropic использовали либо другую предварительную версию Claude 3.7 Sonnet, либо последнюю продакшн-версию Claude 3.5 Sonnet).
Преимущества партнерства для стратегического предупреждения: быстрое и ответственное развитие ИИ
Важным преимуществом этой работы является то, что она помогает нам двигаться быстрее, а не медленнее. Заблаговременно разрабатывая планы оценки и принимая обязательства по соблюдению пороговых значений возможностей, которые требуют повышения уровня безопасности, команда Frontier Red Team компании Anthropic расширяет наши возможности по ускоренному продвижению рубежей ИИ с уверенностью в том, что мы делаем это ответственно.
Эта работа — особенно в партнерстве с правительством — приводит к конкретным улучшениям в сфере безопасности и предоставляет полезную информацию для государственных чиновников. В рамках добровольных и взаимовыгодных соглашений наши модели прошли предпродажное тестирование как в Институте безопасности ИИ США, так и в Институте безопасности ИИ (AISI) Великобритании. Последнее тестирование, проведенное институтами AISI, помогло нам лучше понять возможности Claude 3.7 Sonnet, имеющие отношение к национальной безопасности, и мы использовали этот анализ для определения уровня безопасности ИИ (ASL) для данной модели.
Компания Anthropic также инициировала первое в своем роде партнерство с Национальным управлением по ядерной безопасности (NNSA), входящим в состав Министерства энергетики США (DOE), специалисты которого проводят оценку Claude в закрытой среде на предмет знаний, связанных с ядерными и радиологическими рисками. Этот проект включал непосредственное тестирование на проникновение (red-teaming) со стороны правительства из-за особой конфиденциальности информации, связанной с ядерным оружием. В рамках этого партнерства компания Anthropic поделилась опытом выявления рисков и методологий их снижения, примененными в других областях химического, биологического, радиологического и ядерного оружия (CBRN), которые NNSA адаптировала для ядерной сферы. Успех этого соглашения между государственными и частными структурами в жестко регулируемой ядерной отрасли доказывает, что аналогичное сотрудничество возможно и в других чувствительных сферах.
Взгляд в будущее
Наша работа по борьбе с передовыми угрозами подчеркнула важность внутренних механизмов защиты, таких как наша политика ответственного масштабирования (Responsible Scaling Policy), независимых экспертных организаций, включая Институты безопасности ИИ, и надлежащим образом сфокусированного внешнего надзора. В дальнейшем наша цель заключается в переходе к более частым тестированиям с использованием автоматизированной оценки, извлечения данных, анализа и отчетности. Это правда, что возможности ИИ стремительно развиваются, но точно так же растут и наши возможности по проведению таких оценок и более раннему и надежному обнаружению потенциальных рисков.
Мы действуем безотлагательно. По мере того как модели совершенствуют способность использовать расширенное мышление, некоторые абстракции и сценарии планирования, реализуемые с помощью такого киберинструментария, как Incalmo, могут устареть, и модели станут лучше справляться с задачами кибербезопасности «из коробки». Отчасти опираясь на описанные здесь исследования в области биологии, мы считаем, что наши модели приближаются к пересечению порога возможностей, который требует принятия мер безопасности уровня ASL-3, что стимулирует дополнительные инвестиции для своевременной готовности этих защитных мер. Мы убеждены, что более глубокое сотрудничество между передовыми ИИ-лабораториями и государствами имеет решающее значение для совершенствования наших оценок и снижения рисков во всех этих приоритетных областях.
Если вы хотите внести свой непосредственный вклад в нашу работу, мы нанимаем сотрудников.
Полный текст статьи читайте на Anthropic
