Промпт-инженерия для длинного контекстного окна Claude
Длинное контекстное окно Claude на 100 000 токенов позволяет модели работать со стенами технической документации на сотни страниц или даже с целой книгой. Поскольку мы продолжаем масштабировать API Claude, мы наблюдаем рост спроса на рекомендации по составлению промптов для максимального раскрытия потенциала модели. Сегодня мы рады поделиться количественным тематическим исследованием (case study) по двум методам, которые могут улучшить способность Claude удерживать информацию в памяти при работе с длинными контекстами:
- Извлечение справочных цитат, относящихся к вопросу, перед тем как дать ответ
- Дополнение промпта примерами правильно отвеченных вопросов по другим разделам документа
Давайте перейдем к деталям.
Тестирование точности воспроизведения длинного контекста: вопросы и ответы с множественным выбором
Наша цель в этом эксперименте — оценить методы, которые позволяют максимизировать вероятность того, что Claude правильно вспомнит конкретную информацию из длинного документа.
В качестве базового источника данных для тестирования мы использовали ежедневно публикуемый правительственный документ, который содержит стенограммы заседаний и отчеты о деятельности различных департаментов. Мы выбрали документ от 13 июля, то есть созданный уже после даты отсечки обучающих данных Claude. Это сводит к минимуму вероятность того, что Claude уже знаком с информацией из документа.
Чтобы сформировать набор данных из пар вопросов и ответов, мы использовали подход, который называем «случайным коллажем». Мы разделили документ на разделы и с помощью Claude сгенерировали пять вопросов с множественным выбором для каждого раздела: три неправильных ответа и один правильный. Затем мы заново собрали рандомизированные наборы этих разделов в длинные документы, чтобы передать их Claude и проверить его способность вспоминать их содержимое.
Использование Claude для генерации вопросов с множественным выбором
Поручение Claude создавать для вас оценочные тесты (evals) — это мощный инструмент, которым мы, как команда промпт-инженеров, пользуемся регулярно. Однако чтобы заставить Claude формулировать вопросы оптимальной степени сложности, требуется тщательная проработка промптов. Вот с какими трудностями мы столкнулись при разработке эффективного набора тестов:
- Claude может предлагать вопросы, на которые способен ответить без всякой опоры на документ, например: «Чем занимается Министерство транспорта?»
- Claude может включать вопросы, на которые ему трудно дать правильный ответ даже в условиях короткого контекста. Например, поскольку Claude воспринимает мир через токены, а не слова, вопрос вроде «Сколько слов в этом отрывке?» часто вызывает у него затруднения.
- Claude может случайно оставлять в ответах подсказки, которые делают правильный ответ слишком очевидным. В частности, мы заметили тенденцию делать правильный ответ гораздо более подробным по сравнению с неправильными.
- Claude может ссылаться на «этот документ» или «этот отрывкок», не уточняя, о каком именно отрывке идет речь. Это создает проблемы, так как при объединении нескольких документов в один длинный контекст Claude не может знать, к какому именно документу относится вопрос.
- Существует также риск зайти слишком далеко и сделать вопросы настолько конкретными, что они будут содержать в себе ответ. Например, вопрос «Какова дата публикации уведомления Министерства внутренних дел от 2 июля 2023 года о дополнительных мерах в отношении рыболовства в текущем сезоне?» будет неэффективным.
Чтобы избежать этих ловушек, мы использовали шаблон промпта, который включает два примера фрагментов встреч вместе с написанными вручную вопросами в качестве few-shot примеров составления вопросов, а также ряд рекомендаций по стилю изложения, побуждающих Claude указывать конкретные детали отрывка. Шаблон и все остальные промпты, использованные в этом эксперименте, доступны здесь.
Оценка
Для данной оценки мы сосредоточились в основном на нашей более компактной модели Claude Instant (версия 1.2), а не на Claude 2. Это обусловлено несколькими причинами. Во-первых, Claude 2 и так отлично справляется с извлечением информации после чтения очень длинных документов. Claude Instant нуждается в большей поддержке, что позволяет легко заметить, когда изменения в промптах улучшают производительность. Кроме того, Claude Instant работает настолько быстро, что вы можете самостоятельно воспроизвести эти тесты с помощью предоставленного нами ноутбука.
Когда Claude Instant получал в свое распоряжение только тот точный отрывок, который он использовал для создания вопроса, модель могла ответить на собственный вопрос примерно в 90% случаев. Мы отсеяли те 10% вопросов, на которые она ответила неправильно — поскольку Claude ошибался даже в условиях короткого контекста, они слишком сложны для тестирования длинного контекста.1
Мы также проверили способность Claude вспоминать информацию при предъявлении случайного раздела, не содержащего исходного материала для вопроса. Теоретически, при наличии трех неправильных вариантов ответа Claude должен угадывать правильный ответ лишь в 25% случаев. На практике он угадывал правильно в 34% случаев — выше случайного угадывания, но ненамного. Вероятно, иногда Claude интуитивно угадывает правильный ответ, основываясь на своих общих знаниях или тонких подсказках в формулировке ответа.
Чтобы собрать длинные документы из более коротких фрагментов, мы искусственно сгенерировали новый длинный контекст для каждого вопроса, объединяя случайный набор отрывков до тех пор, пока не достигалось требуемое количество токенов. Мы протестировали Claude на таких «сшитых» документах объемом примерно 75 000 и 90 000 токенов.
Именно из-за такого формирования контекста из лоскутов ссылки Claude на двусмысленные фразы вроде «этот документ» или «этот отрывок» в формулировке вопросов вызывали проблемы. Вопрос вроде «Какова дата публикации этого уведомления?» теряет смысл, когда в контексте присутствует дюжина разных уведомлений, к которым может относиться «этот документ». Именно поэтому наш промпт для генерации вопросов содержит инструкцию, предписывающую Claude делать формулировки максимально конкретными — например: «Какова дата публикации уведомления о дополнительных мерах в отношении рыболовства в текущем сезоне?»
После генерации длинных документов (коллажей) мы протестировали способность Claude извлекать информацию, используя четыре различные стратегии промптинга:
- Базовая (Base) — просто попросить Claude дать ответ
- Посторонние примеры (Nongov examples) — дать Claude два фиксированных примера правильно отвеченных вопросов на общие темы, не связанные с правительственным документом2
- Два примера (Two examples) — дать Claude два примера правильно отвеченных вопросов с множественным выбором, динамически выбранных случайным образом из набора созданных Claude вопросов по другим фрагментам контекста
- Пять примеров (Five examples) — аналогично стратегии №3, но с пятью примерами
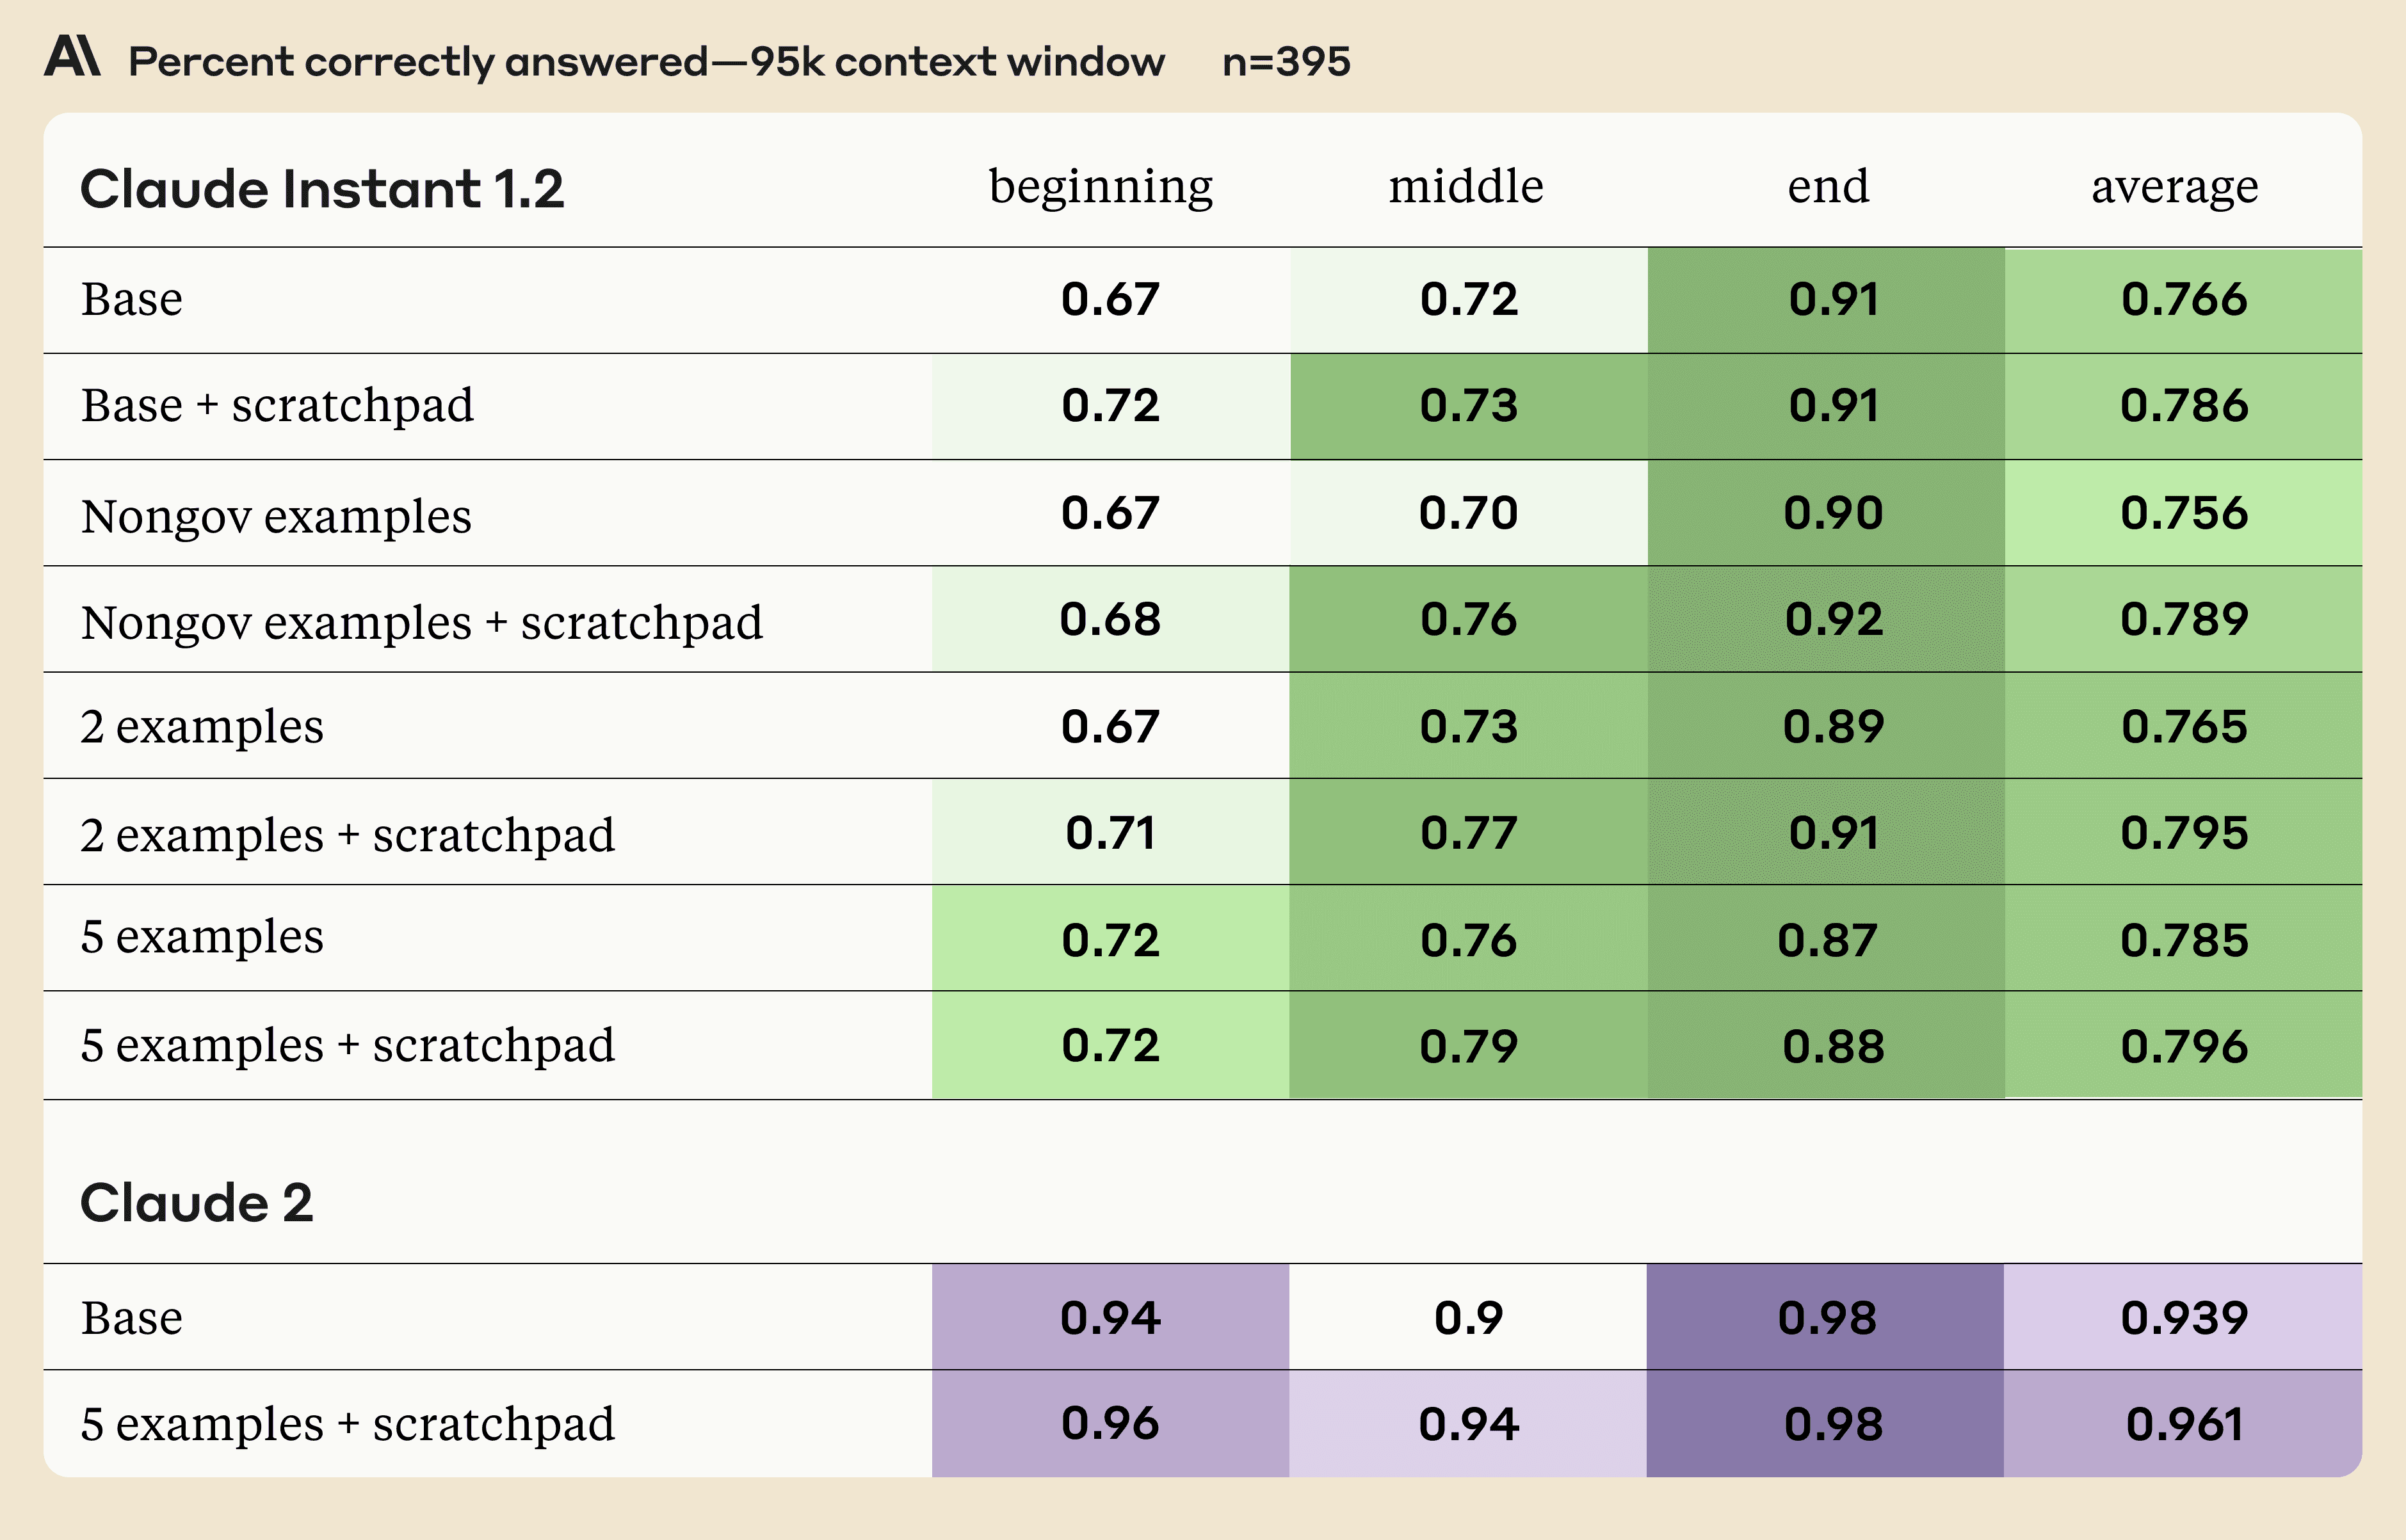
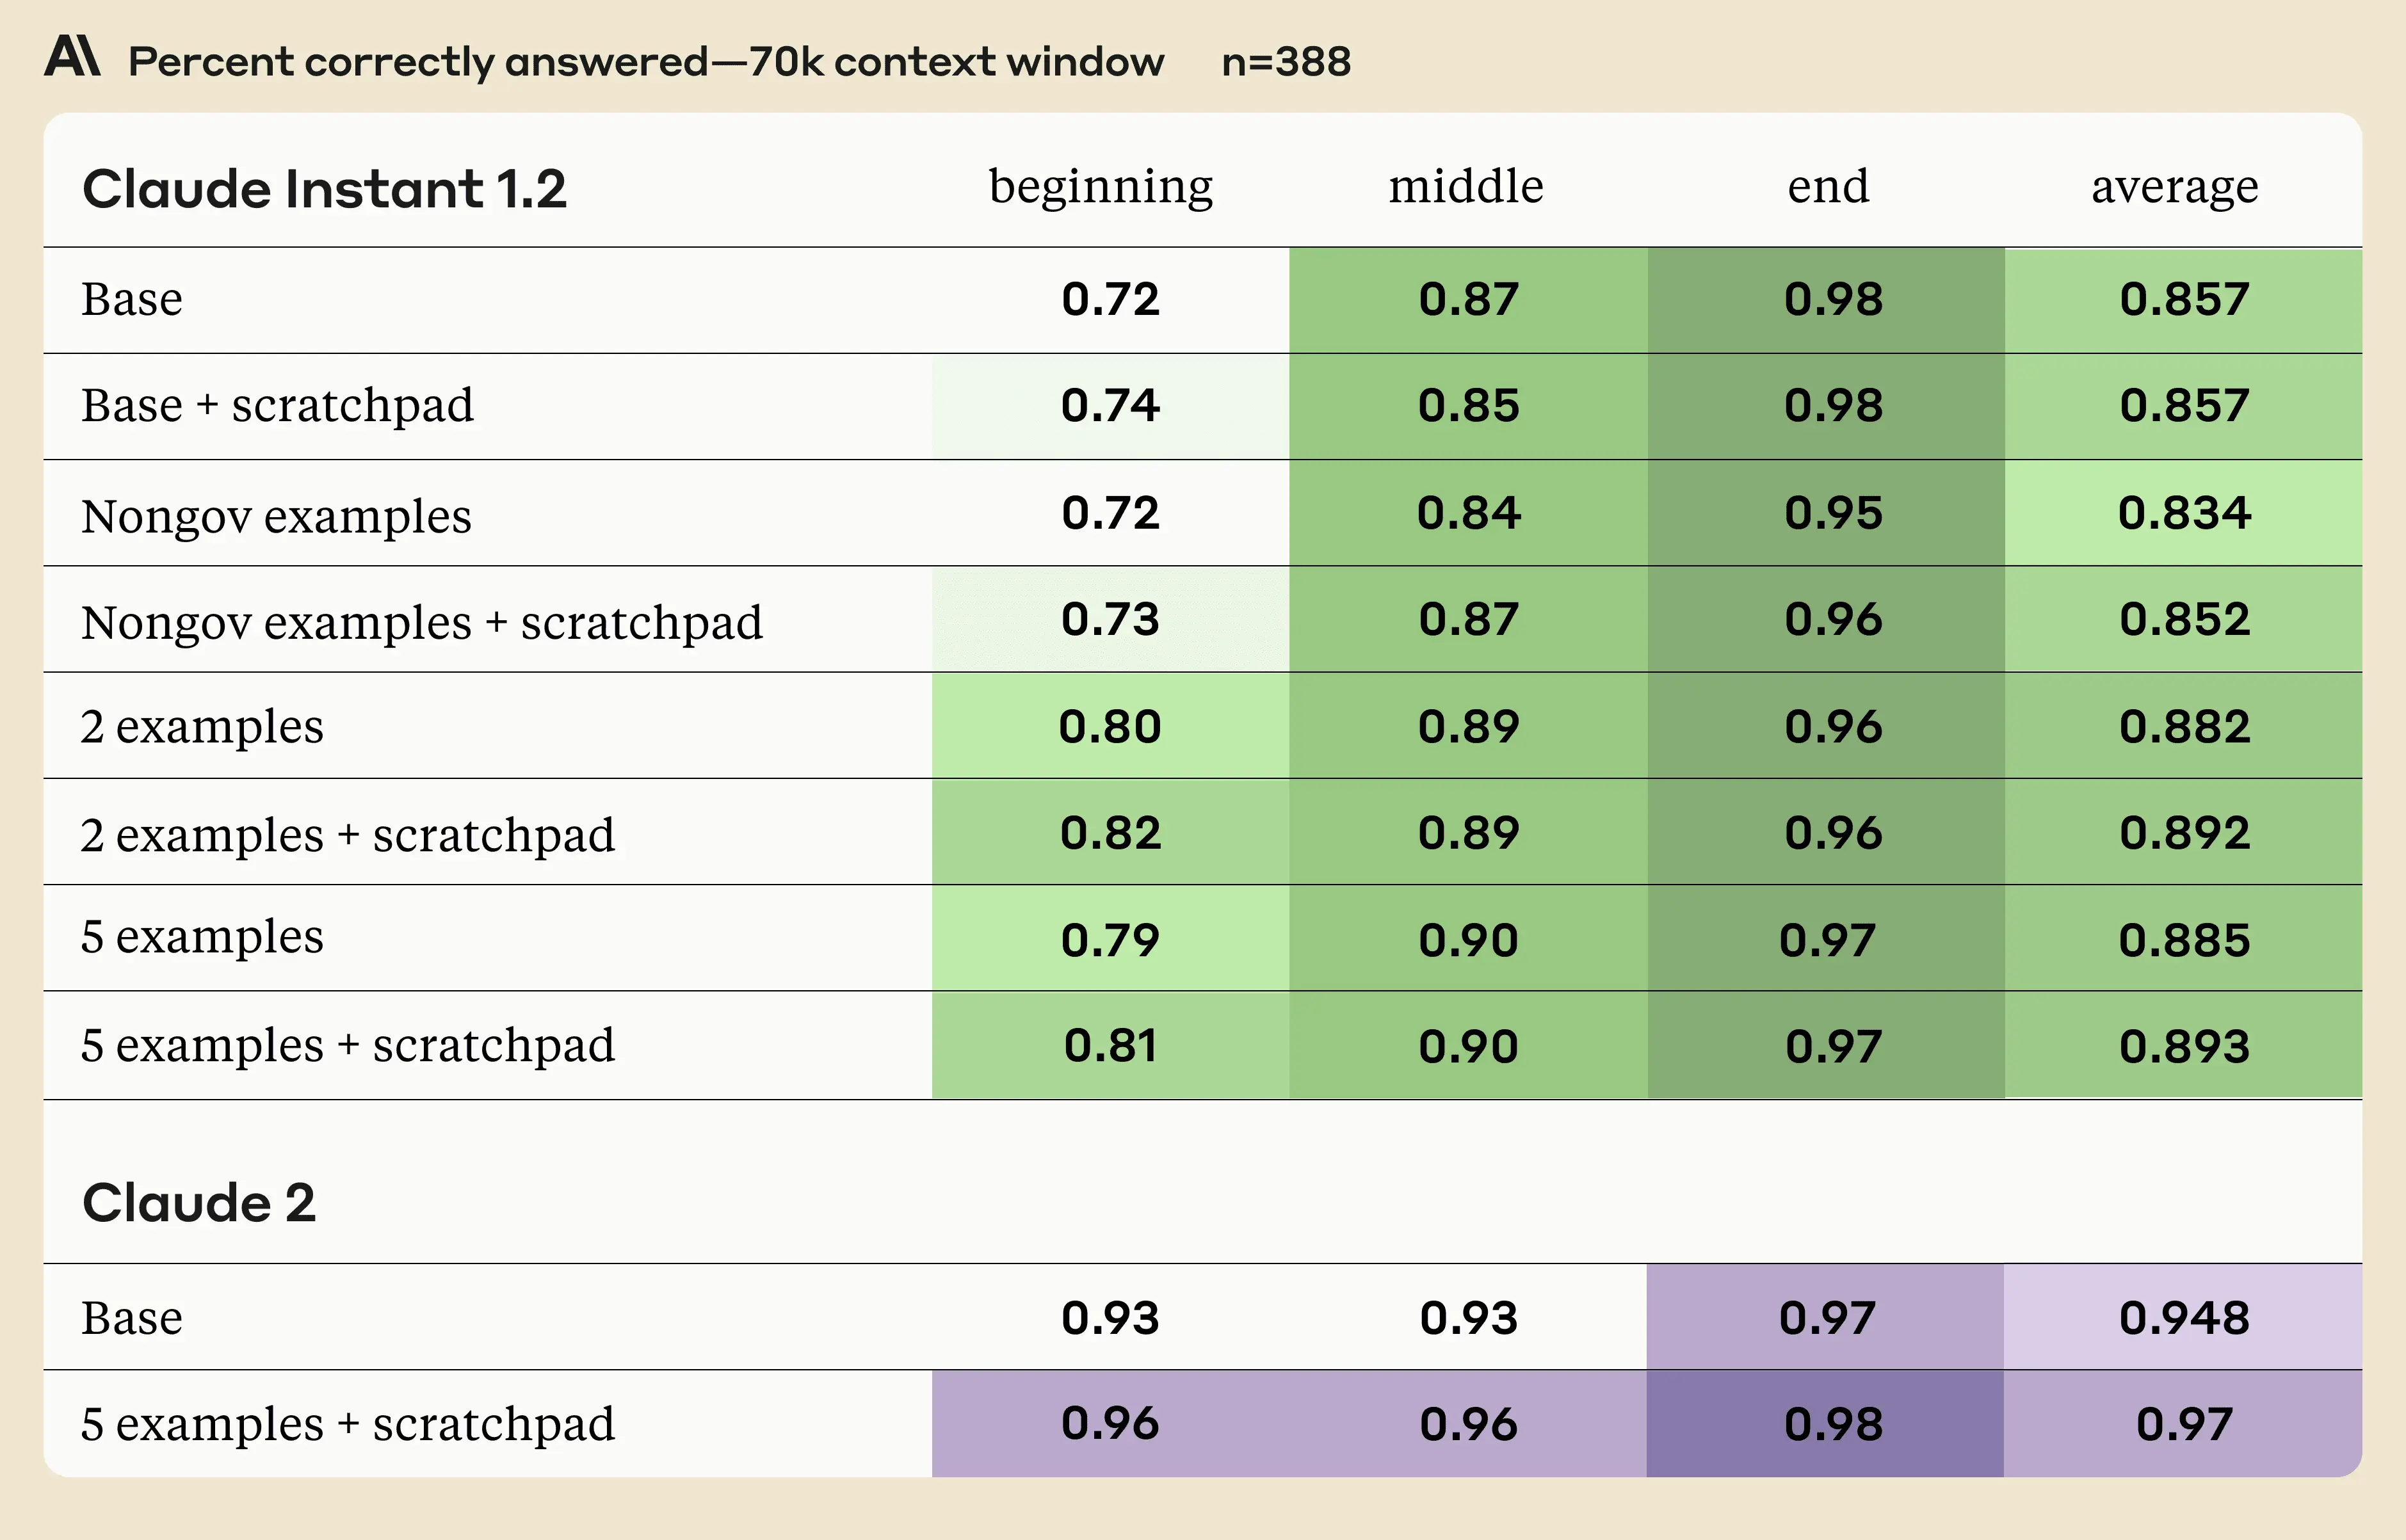
Для каждой из четырех указанных выше стратегий мы также провели тестирование как с использованием специального блока для черновика (), в котором мы инструктируем Claude выписывать релевантные цитаты, так и без него. Кроме того, мы проверили каждую из этих стратегий при разном расположении отрывка с ответом: в начале, в конце или в середине входных данных. Наконец, чтобы оценить влияние длины контекста на результаты, мы провели тестирование с документами объемом 70 тыс. и 95 тыс. токенов.
Для описанного выше теста мы использовали Claude Instant 1.2. Мы также приводим результаты для Claude 2 на основе базовой стратегии и стратегии, показавшей наилучшие результаты для Claude Instant 1.2.
Результаты
Несколько замечаний об эксперименте:
- В то время как качество работы с началом и серединой документа существенно повышается за счет использования черновика и примеров, качество обработки конца документа может ухудшаться. Это может быть связано с тем, что добавление примеров в промпт увеличивает расстояние между самым концом документа (где находится нужная информация) и моментом, когда Claude должен на нее ответить. Вероятно, это имеет лишь второстепенное значение, поскольку лишь малая доля данных в исходном документе располагается в самом конце. Тем не менее, это подчеркивает важность размещения инструкций в самом конце промпта, поскольку мы хотим, чтобы модель вспоминала их как можно точнее.
- Улучшение показателей Claude 2 с 0,939 до 0,961 при использовании промптинга может показаться небольшим в абсолютном выражении, но оно отражает сокращение количества ошибок на 36%.
Несколько полезных выводов, которые вы можете использовать при составлении промптов для работы с вопросами и ответами по длинному контексту:
- Используйте большое количество примеров и черновик (scratchpad) для достижения наилучшей производительности при любой длине контекста.
- Извлечение релевантных цитат в черновик полезно во всех сравнительных тестах. Это связано с небольшими затратами времени на отклик (latency), но повышает точность. В случае с Claude Instant задержка и так настолько мала, что этим можно пренебречь.
- Контекстные примеры помогают как для 70 тыс., так и для 95 тыс. токенов, причем чем больше примеров, тем лучше.
- Общие примеры из области общих/внешних знаний, судя по всему, не повышают эффективность.
Для Claude Instant наблюдается монотонная обратная зависимость между эффективностью и удаленностью релевантного отрывка от вопроса и конца промпта, в то время как показатели Claude 2 на 95 тыс. токенов демонстрируют небольшой спад в середине.3
Представляем новую кулинарную книгу Anthropic Cookbook
Полностью воспроизводимый код для этого эксперимента уже доступен в новой Anthropic Cookbook. В этом постоянно пополняемом хранилище ресурсов на данный момент также представлены два других руководства:
- Демонстрация поиска и извлечения данных (Search and Retrieval), демонстрирующая использование инструментов для поиска по Wikipedia.
- Рекомендации по реализации функции загрузки и суммирования псевдо-PDF-файлов через API Anthropic.
Мы с нетерпением ждем возможности расширить Anthropic Cookbook и другие наши ресурсы по промпт-инженерии в будущем, и надеемся, что они вдохновят вас на амбициозные проекты с использованием Claude. Если вы еще не получили доступ к API Claude, пожалуйста, зарегистрируйте свою заявку.
Сноски
1Частая проблема в вопросах, на которых Claude ошибается — это подсчет объектов, например: «Каково предполагаемое количество ответов на одного респондента, указанное в уведомлении для каждой формы в пакете стандартных форм для гарантированных ссуд?» или «Сколько предполагаемых готовых продуктов указано в уведомлении о производственной деятельности на предприятии Getinge Group Logistics Americas LLC?» Примечательно, что в некоторых из таких вопросов предварительно заданный Claude «правильный» ответ (сгенерированный при создании пар вопросов и ответов) на самом деле не является верным. Это источник шума в данном эксперименте.
2Вопросы: 1. Кто был первым президентом Соединенных Штатов? A. Томас Джефферсон, B. Джордж Вашингтон, C. Авраам Линкольн, D. Джон Адамс. 2. Какова температура кипения воды в градусах Фаренгейта? A. 200, B. 100, C. 287, D. 212.
3В недавней научной работе для аналогичной задачи была обнаружена U-образная зависимость между производительностью и расположением информации в контексте. Возможным объяснением различия в результатах является то, что средняя длина примеров в той статье составляла 15 тыс. токенов (Приложение F), по сравнению с 70 тыс./95 тыс. токенов в нашем эксперименте.
Полный текст статьи читайте на Anthropic
