Представляем OpenAI o3 и o4-mini
Обновление от 10 июня 2025 г.: OpenAI o3‑pro теперь доступна пользователям версии Pro в ChatGPT, а также в нашем API. Как и OpenAI o1‑pro, модель o3‑pro представляет собой версию нашей самой интеллектуальной модели OpenAI o3, созданную для более глубокого размышления и предоставления максимально надежных ответов. Все подробности можно найти в наших примечаниях к выпуску.
Сегодня мы выпускаем OpenAI o3 и o4-mini, новейшие модели из серии «o», обученные дольше размышлять перед ответом. Это самые умные модели из всех, что мы выпускали на сегодняшний день. Они представляют собой качественный скачок в возможностях ChatGPT для всех пользователей — от любопытствующих до продвинутых исследователей. Впервые наши модели рассуждений могут автономно использовать и комбинировать каждый инструмент в ChatGPT: это включает поиск в интернете, анализ загруженных файлов и других данных с помощью Python, глубокий анализ визуальных входов и даже генерацию изображений. Что особенно важно, эти модели обучены принимать решения о том, когда и как использовать инструменты для получения детальных и продуманных ответов в правильных форматах вывода (обычно менее чем за минуту) для решения более сложных задач. Это позволяет им эффективнее справляться с многоаспектными вопросами, делая шаг к более автономному ChatGPT, способному самостоятельно выполнять задачи от вашего имени. Сочетание передовых рассуждений и полного доступа к инструментам обеспечивает значительно более высокую производительность в академических тестах и реальных задачах, устанавливая новый стандарт как в интеллектуальном плане, так и с точки зрения полезности.
Что изменилось
OpenAI o3 — наша самая мощная модель рассуждений, которая раздвигает границы в области программирования, математики, науки, зрительного восприятия и многого другого. Она устанавливает новый уровень (SOTA) в бенчмарках, включая Codeforces, SWE-bench (без создания пользовательского каркаса под конкретную модель) и MMMU. Она идеально подходит для сложных запросов, требующих многоаспектного анализа, ответы на которые могут быть не очевидны с первого взгляда. Модель демонстрирует особенно высокие результаты в визуальных задачах, таких как анализ изображений, графиков и диаграмм. По оценкам независимых экспертов, o3 совершает на 20 процентов меньше серьезных ошибок, чем OpenAI o1 в сложных реальных задачах, особенно преуспевая в таких областях, как программирование, бизнес/консалтинг и генерация творческих идей. Ранние тестировщики отметили ее аналитическую строгость в качестве партнера по мышлению и подчеркнули ее способность генерировать и критически оценивать новые гипотезы — особенно в контексте биологии, математики и инженерии.
OpenAI o4-mini — это меньшая по размеру модель, оптимизированная для быстрых и экономичных рассуждений. Она достигает выдающихся результатов для своего размера и стоимости, особенно в математике, программировании и визуальных задачах. Это лучшая модель среди протестированных в бенчмарке на AIME 2024 и 2025 годов. Хотя наличие компьютера существенно снижает сложность экзамена AIME, мы также отметили, что o4-mini достигает 99.5% pass@1 (100% consensus@8) на AIME 2025 при доступе к интерпретатору Python. Хотя эти результаты не следует сравнивать с производительностью моделей без доступа к инструментам, они являются наглядным примером того, как эффективно o4-mini использует доступные средства; o3 демонстрирует аналогичные улучшения на AIME 2025 благодаря использованию инструментов (98.4% pass@1, 100% consensus@8).
По оценкам экспертов, o4-mini также превосходит своего предшественника, o3‑mini, в задачах, не связанных с точными науками (STEM), а также в таких областях, как наука о данных. Благодаря своей эффективности o4-mini поддерживает значительно более высокие лимиты использования, чем o3, что делает ее отличным вариантом с высокой пропускной способностью для вопросов, требующих рассуждений. Внешние эксперты-оценщики отметили, что обе модели демонстрируют улучшенное следование инструкциям и более полезные, проверяемые ответы по сравнению со своими предшественницами, что стало возможным благодаря возросшему интеллекту и интеграции веб-источников. По сравнению с предыдущими итерациями наших моделей рассуждений, эти две модели также должны ощущаться более естественными и разговорными, особенно учитывая их способность ссылаться на память и прошлые беседы, делая ответы более персонализированными и релевантными.
Мультимодальность
Программирование
Все тестовые прогоны SWE-bench используют фиксированное подмножество из n=477 проверенных задач, прошедших валидацию на нашей внутренней инфраструктуре.
Следование инструкциям и использование агентных инструментов
Все модели оцениваются при высоких настройках «усилия рассуждений» (reasoning effort), аналогично вариантам вроде «o4-mini-high» в ChatGPT.
Продолжение масштабирования обучения с подкреплением
В ходе разработки OpenAI o3 мы заметили, что крупномасштабное обучение с подкреплением демонстрирует ту же тенденцию «больше вычислений = лучше производительность», которая наблюдалась при предварительном обучении серии GPT. Пройдя по пути масштабирования повторно — на этот раз в рамках обучения с подкреплением (RL), — мы увеличили вычислительные затраты на обучение и рассуждения во время инференса на порядок, но по-прежнему наблюдаем четкий рост производительности. Это подтверждает, что возможности моделей продолжают улучшаться по мере того, как им разрешено больше размышлять. При аналогичных задержках и затратах по сравнению с OpenAI o1 модель o3 обеспечивает более высокую производительность в ChatGPT, и мы подтвердили: если позволить ей думать дольше, ее показатели продолжают расти.
Мы также обучили обе модели использовать инструменты посредством обучения с подкреплением, научив их не просто применять инструменты, но и рассуждать о том, когда именно их стоит задействовать. Способность разворачивать инструменты в зависимости от желаемых результатов делает их более эффективными в открытых сценариях, особенно тех, которые связаны с визуальными рассуждениями и многоэтапными рабочими процессами. Это улучшение отражается как в академических тестах, так и в реальных задачах, о чем сообщают первые тестировщики.
Мышление с помощью изображений
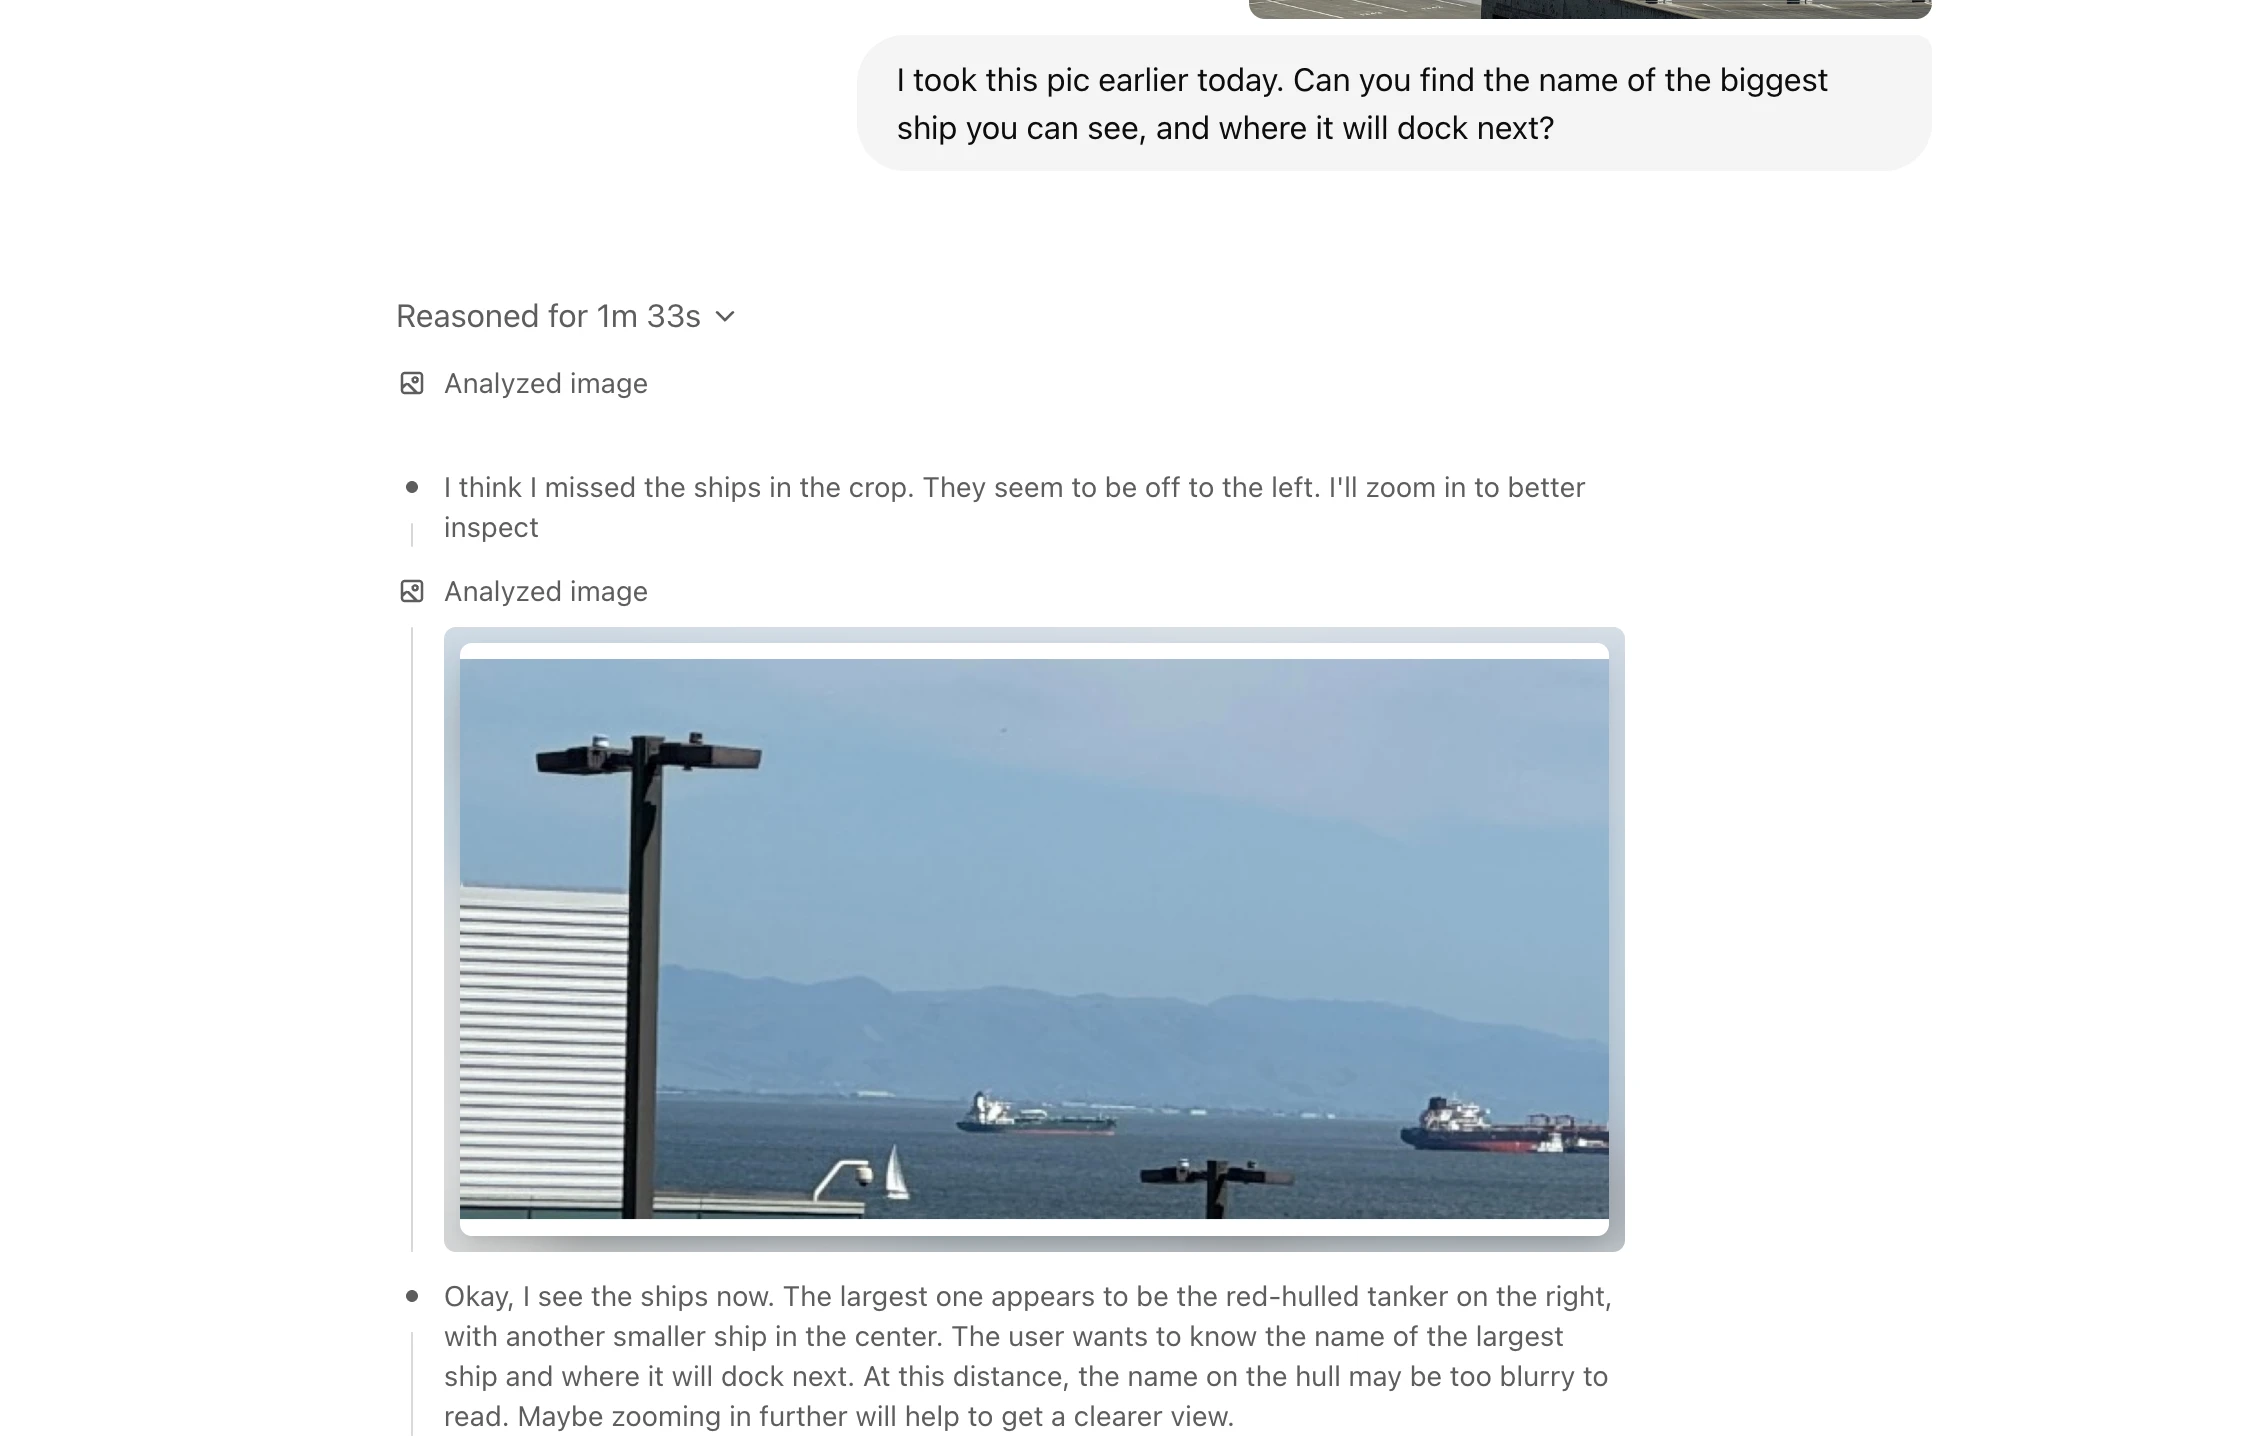
Впервые эти модели могут интегрировать изображения непосредственно в свою цепочку рассуждений. Они не просто видят картинку — они думают с ее помощью. Это открывает новый класс задач, сочетающих визуальные и текстовые рассуждения, что отражается в их передовых результатах в мультимодальных тестах.
Пользователи могут загрузить фотографию маркерной доски, схемы из учебника или наброска от руки, и модель сможет интерпретировать ее — даже если изображение размытое, перевернутое или низкого качества. С помощью инструментов модели могут манипулировать изображениями на лету: вращать, приближать или трансформировать их в процессе рассуждения.
Эти модели обеспечивают лучшую в своем классе точность при решении задач на зрительное восприятие, позволяя справляться с вопросами, которые раньше были недоступны. Ознакомьтесь с блогом об исследованиях визуальных рассуждений, чтобы узнать больше.
На пути к использованию агентных инструментов
OpenAI o3 и o4-mini имеют полный доступ к инструментам внутри ChatGPT, а также к вашим собственным пользовательским инструментам через вызов функций (function calling) в API. Эти модели обучены рассуждать о том, как решать проблемы, выбирая, когда и как использовать инструменты для быстрого создания подробных и продуманных ответов в правильных форматах вывода — обычно менее чем за минуту.
Например, пользователь может спросить: «Как летнее энергопотребление в Калифорнии соотносится с прошлогодним?» Модель может выполнить поиск данных коммунальных служб в интернете, написать код на Python для построения прогноза, сгенерировать график или изображение и объяснить ключевые факторы, лежащие в основе предсказания, объединяя в цепочку несколько вызовов инструментов. Рассуждения позволяют моделям реагировать и перестраиваться по мере необходимости на основе обнаруженной информации. Например, они могут выполнять поиск в интернете несколько раз с помощью поисковых провайдеров, просматривать результаты и пробовать новые поисковые запросы, если им требуется дополнительная информация.
Этот гибкий стратегический подход позволяет моделям решать задачи, требующие доступа к актуальной информации за пределами встроенных знаний модели, расширенных рассуждений, синтеза и генерации вывода в разных модальностях.
Все примеры были выполнены с помощью OpenAI o3.
Совершенствование экономически эффективных рассуждений
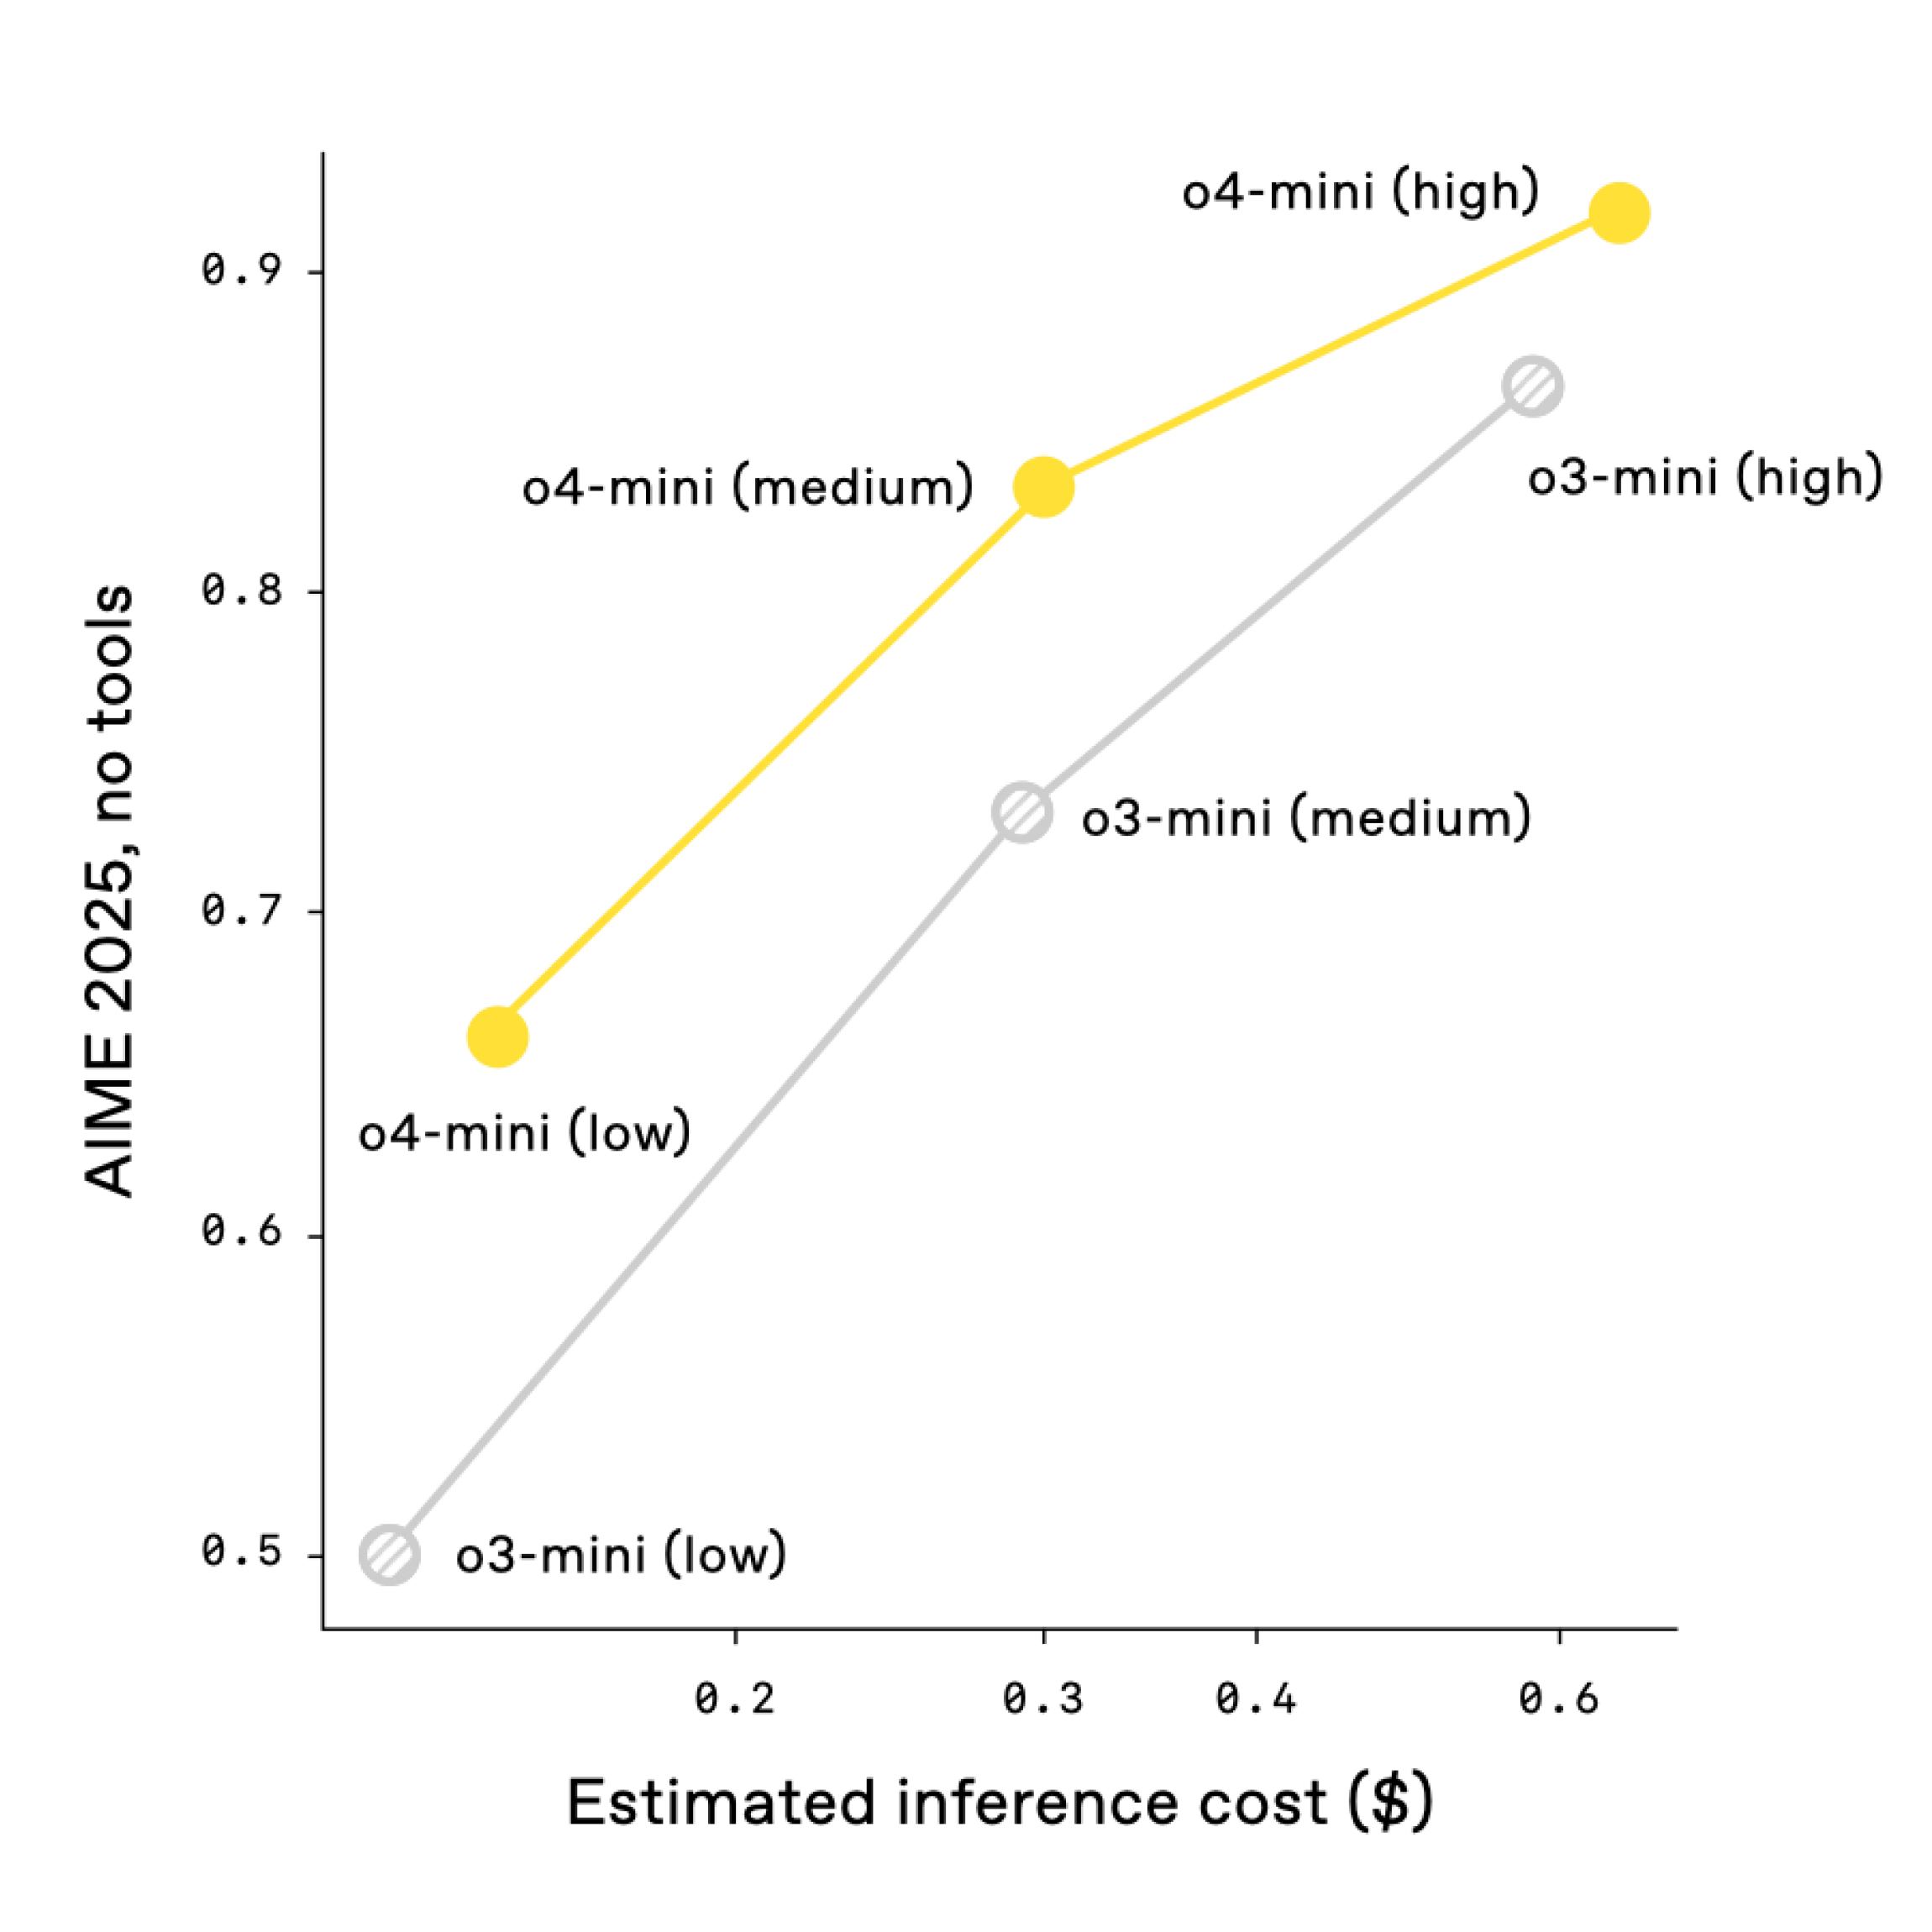
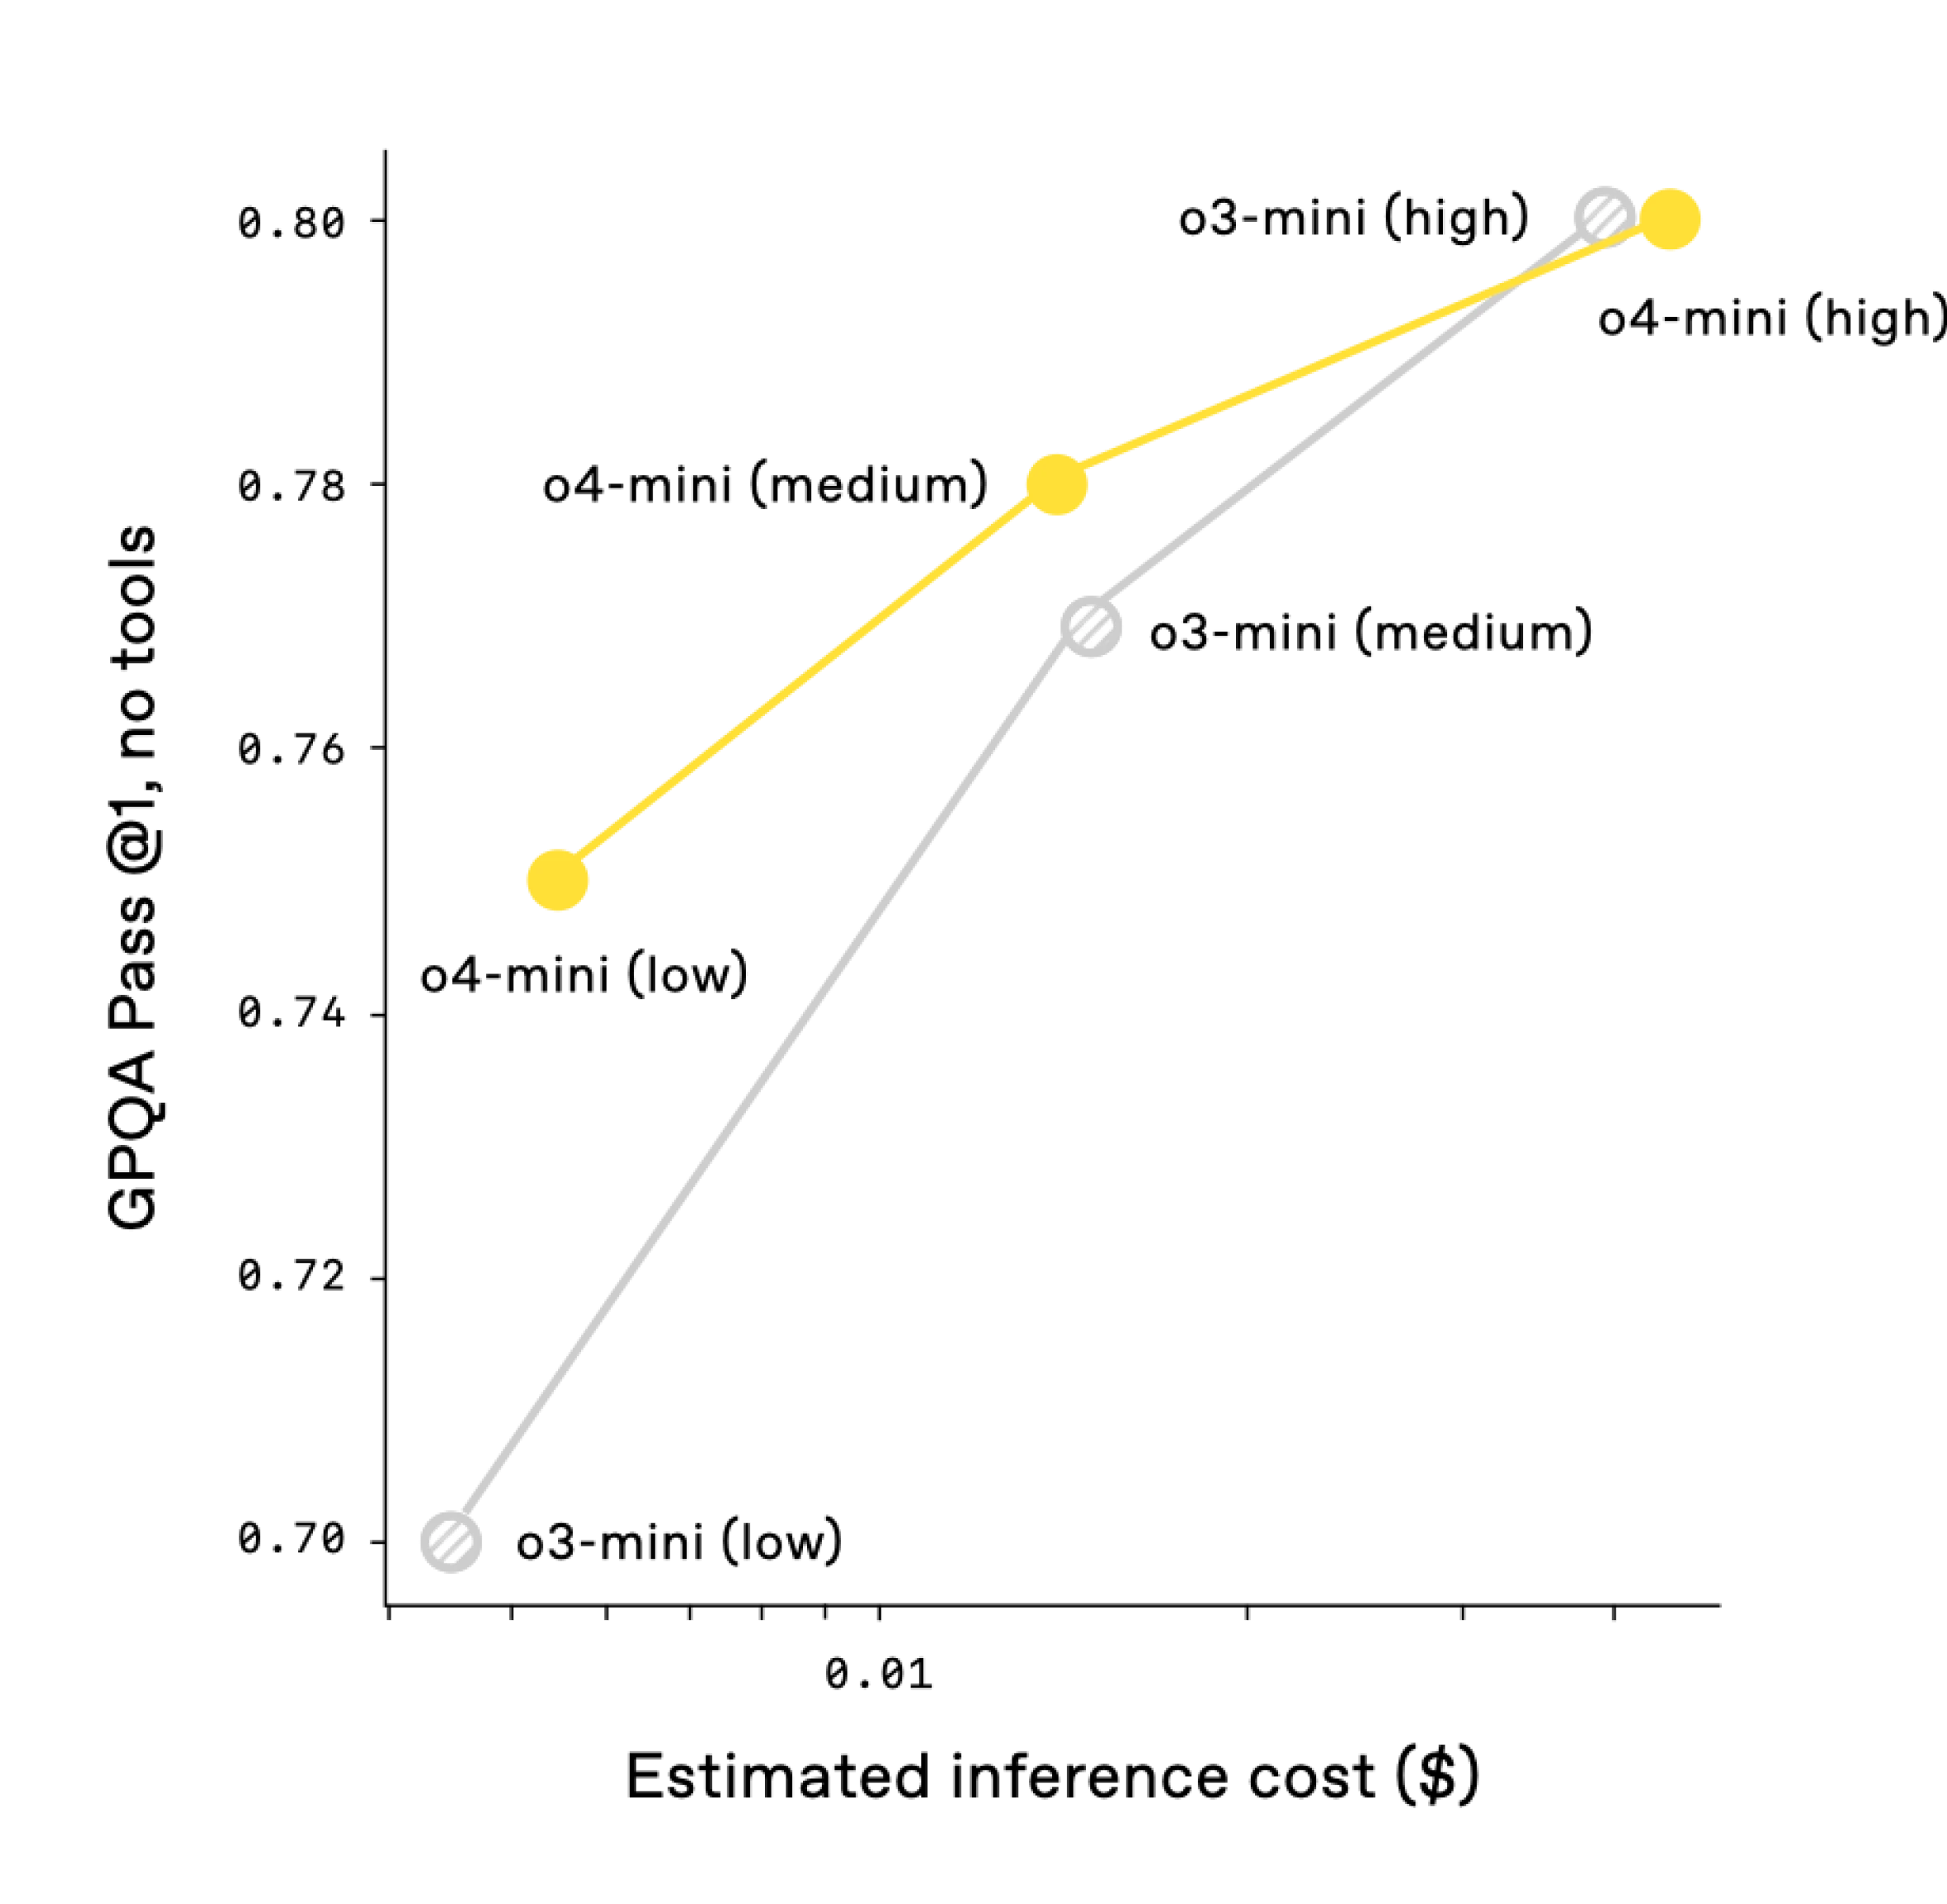
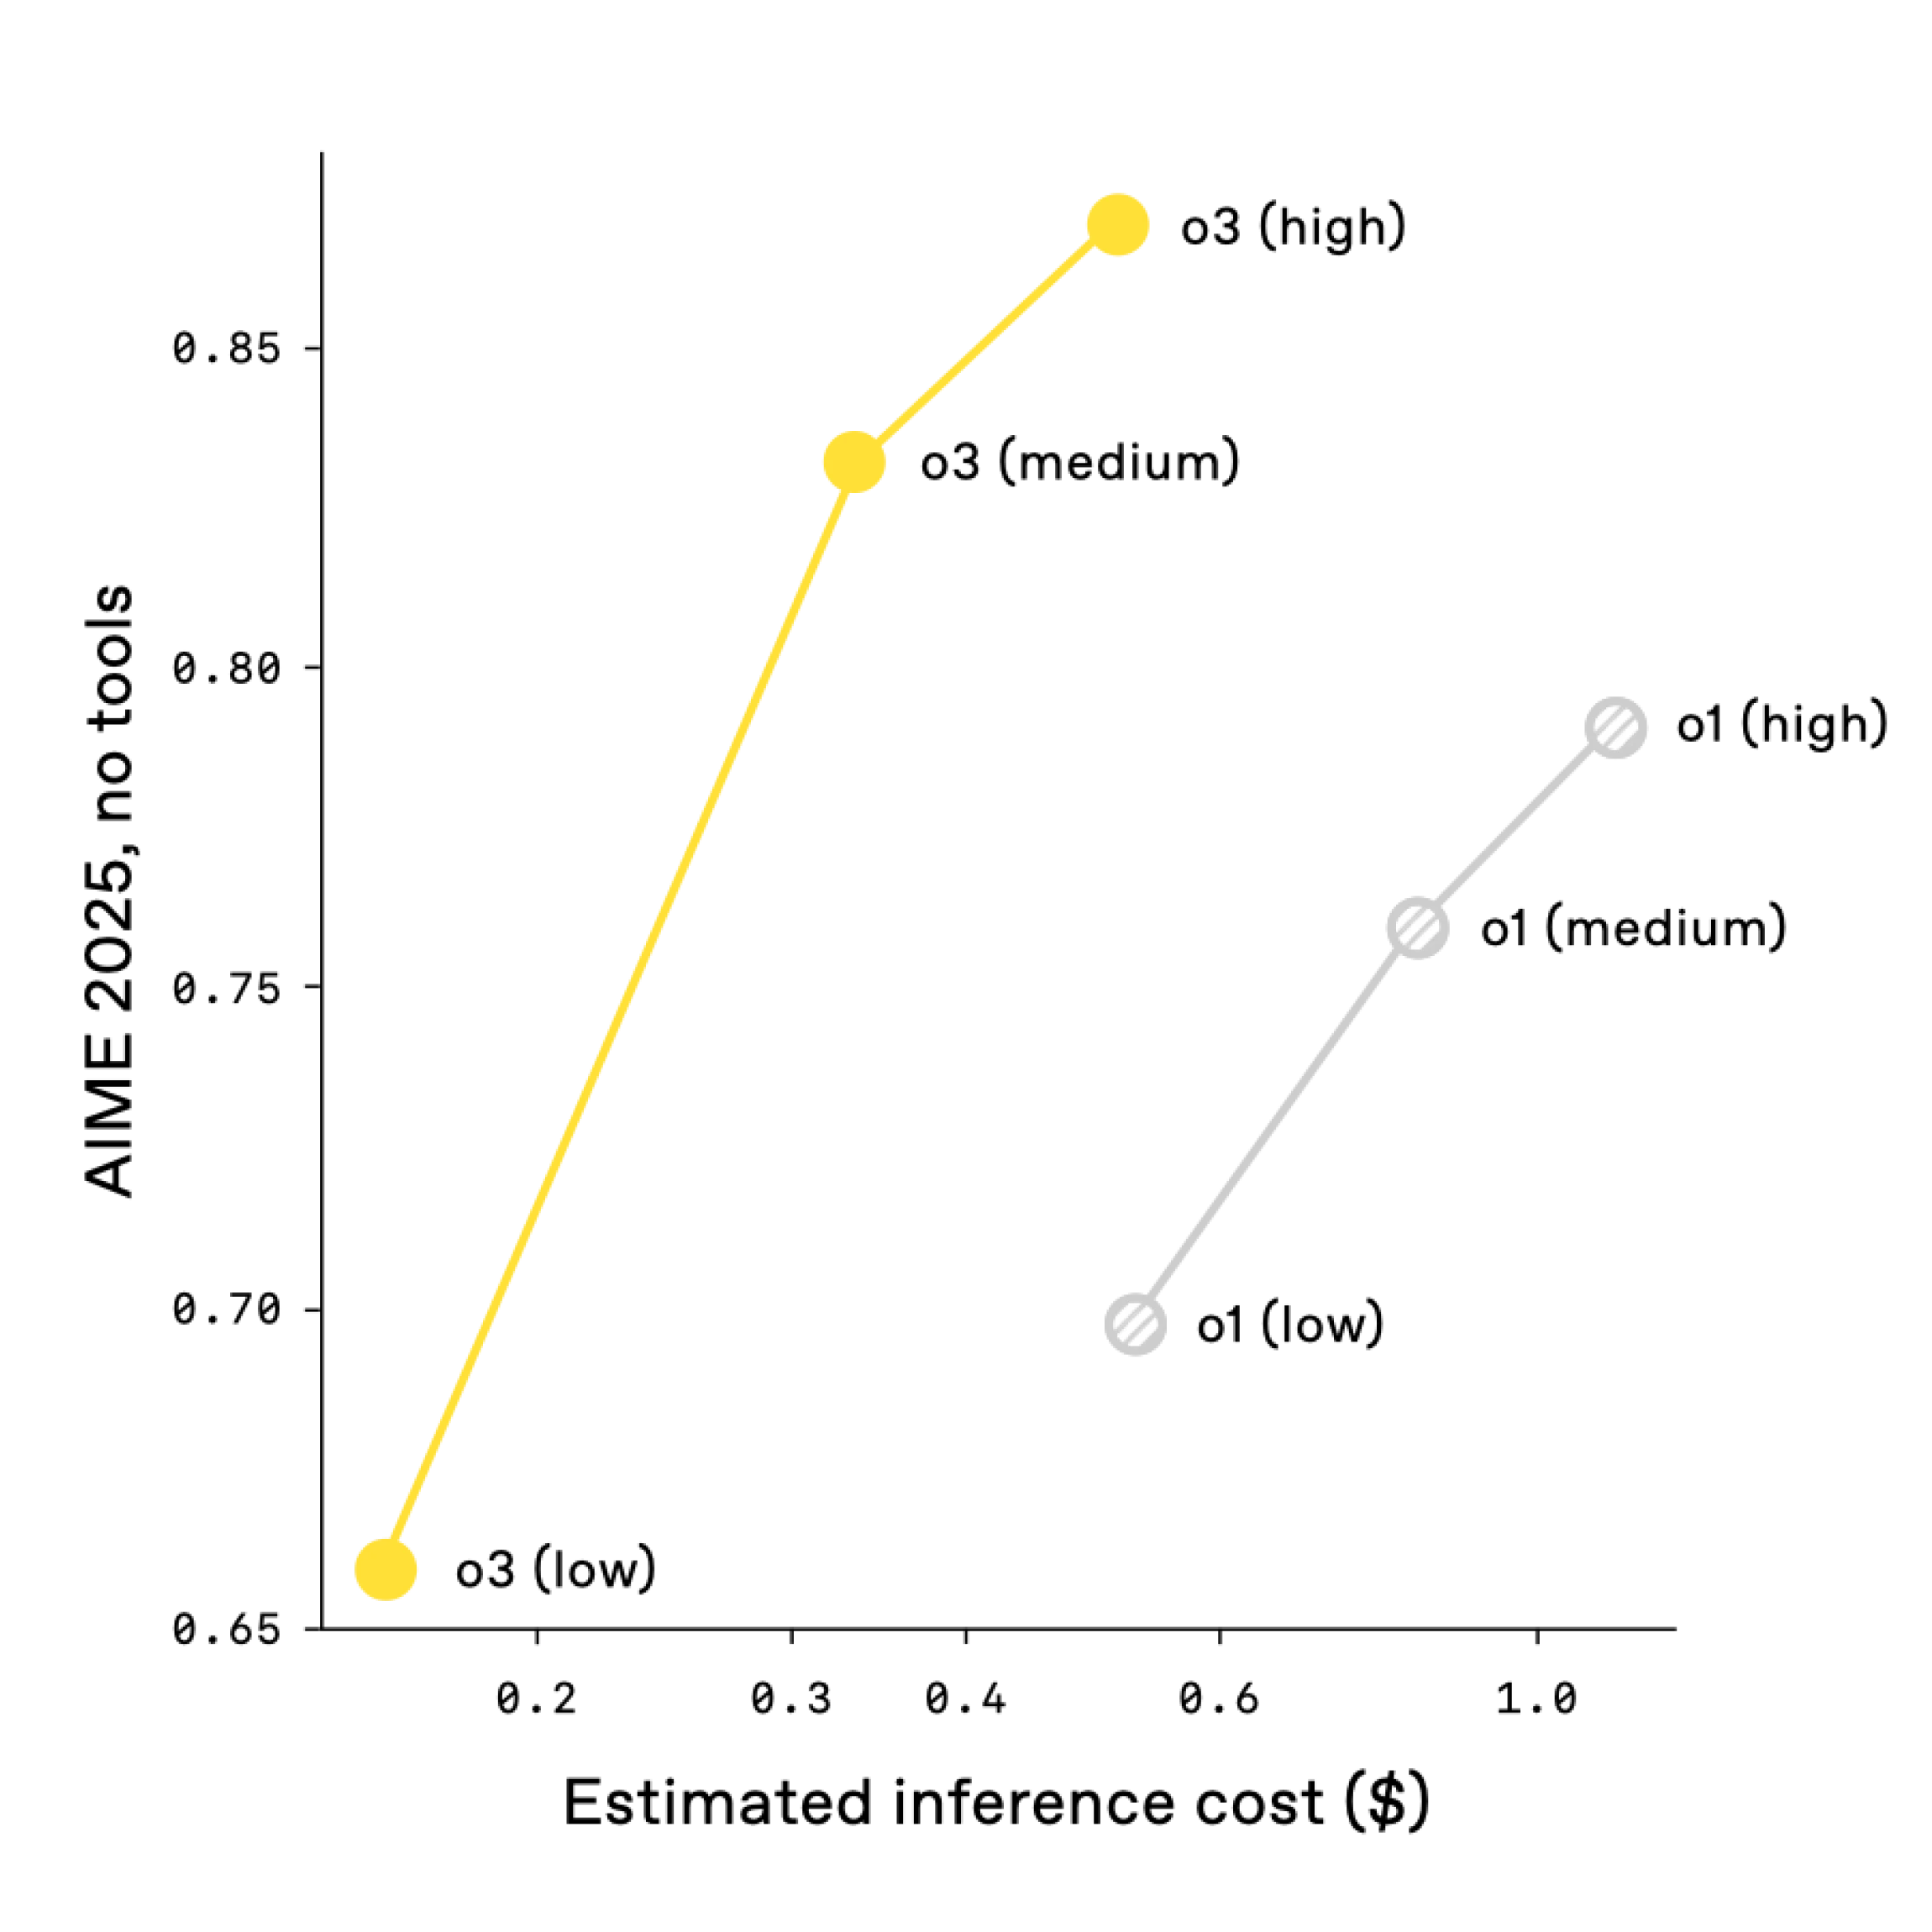
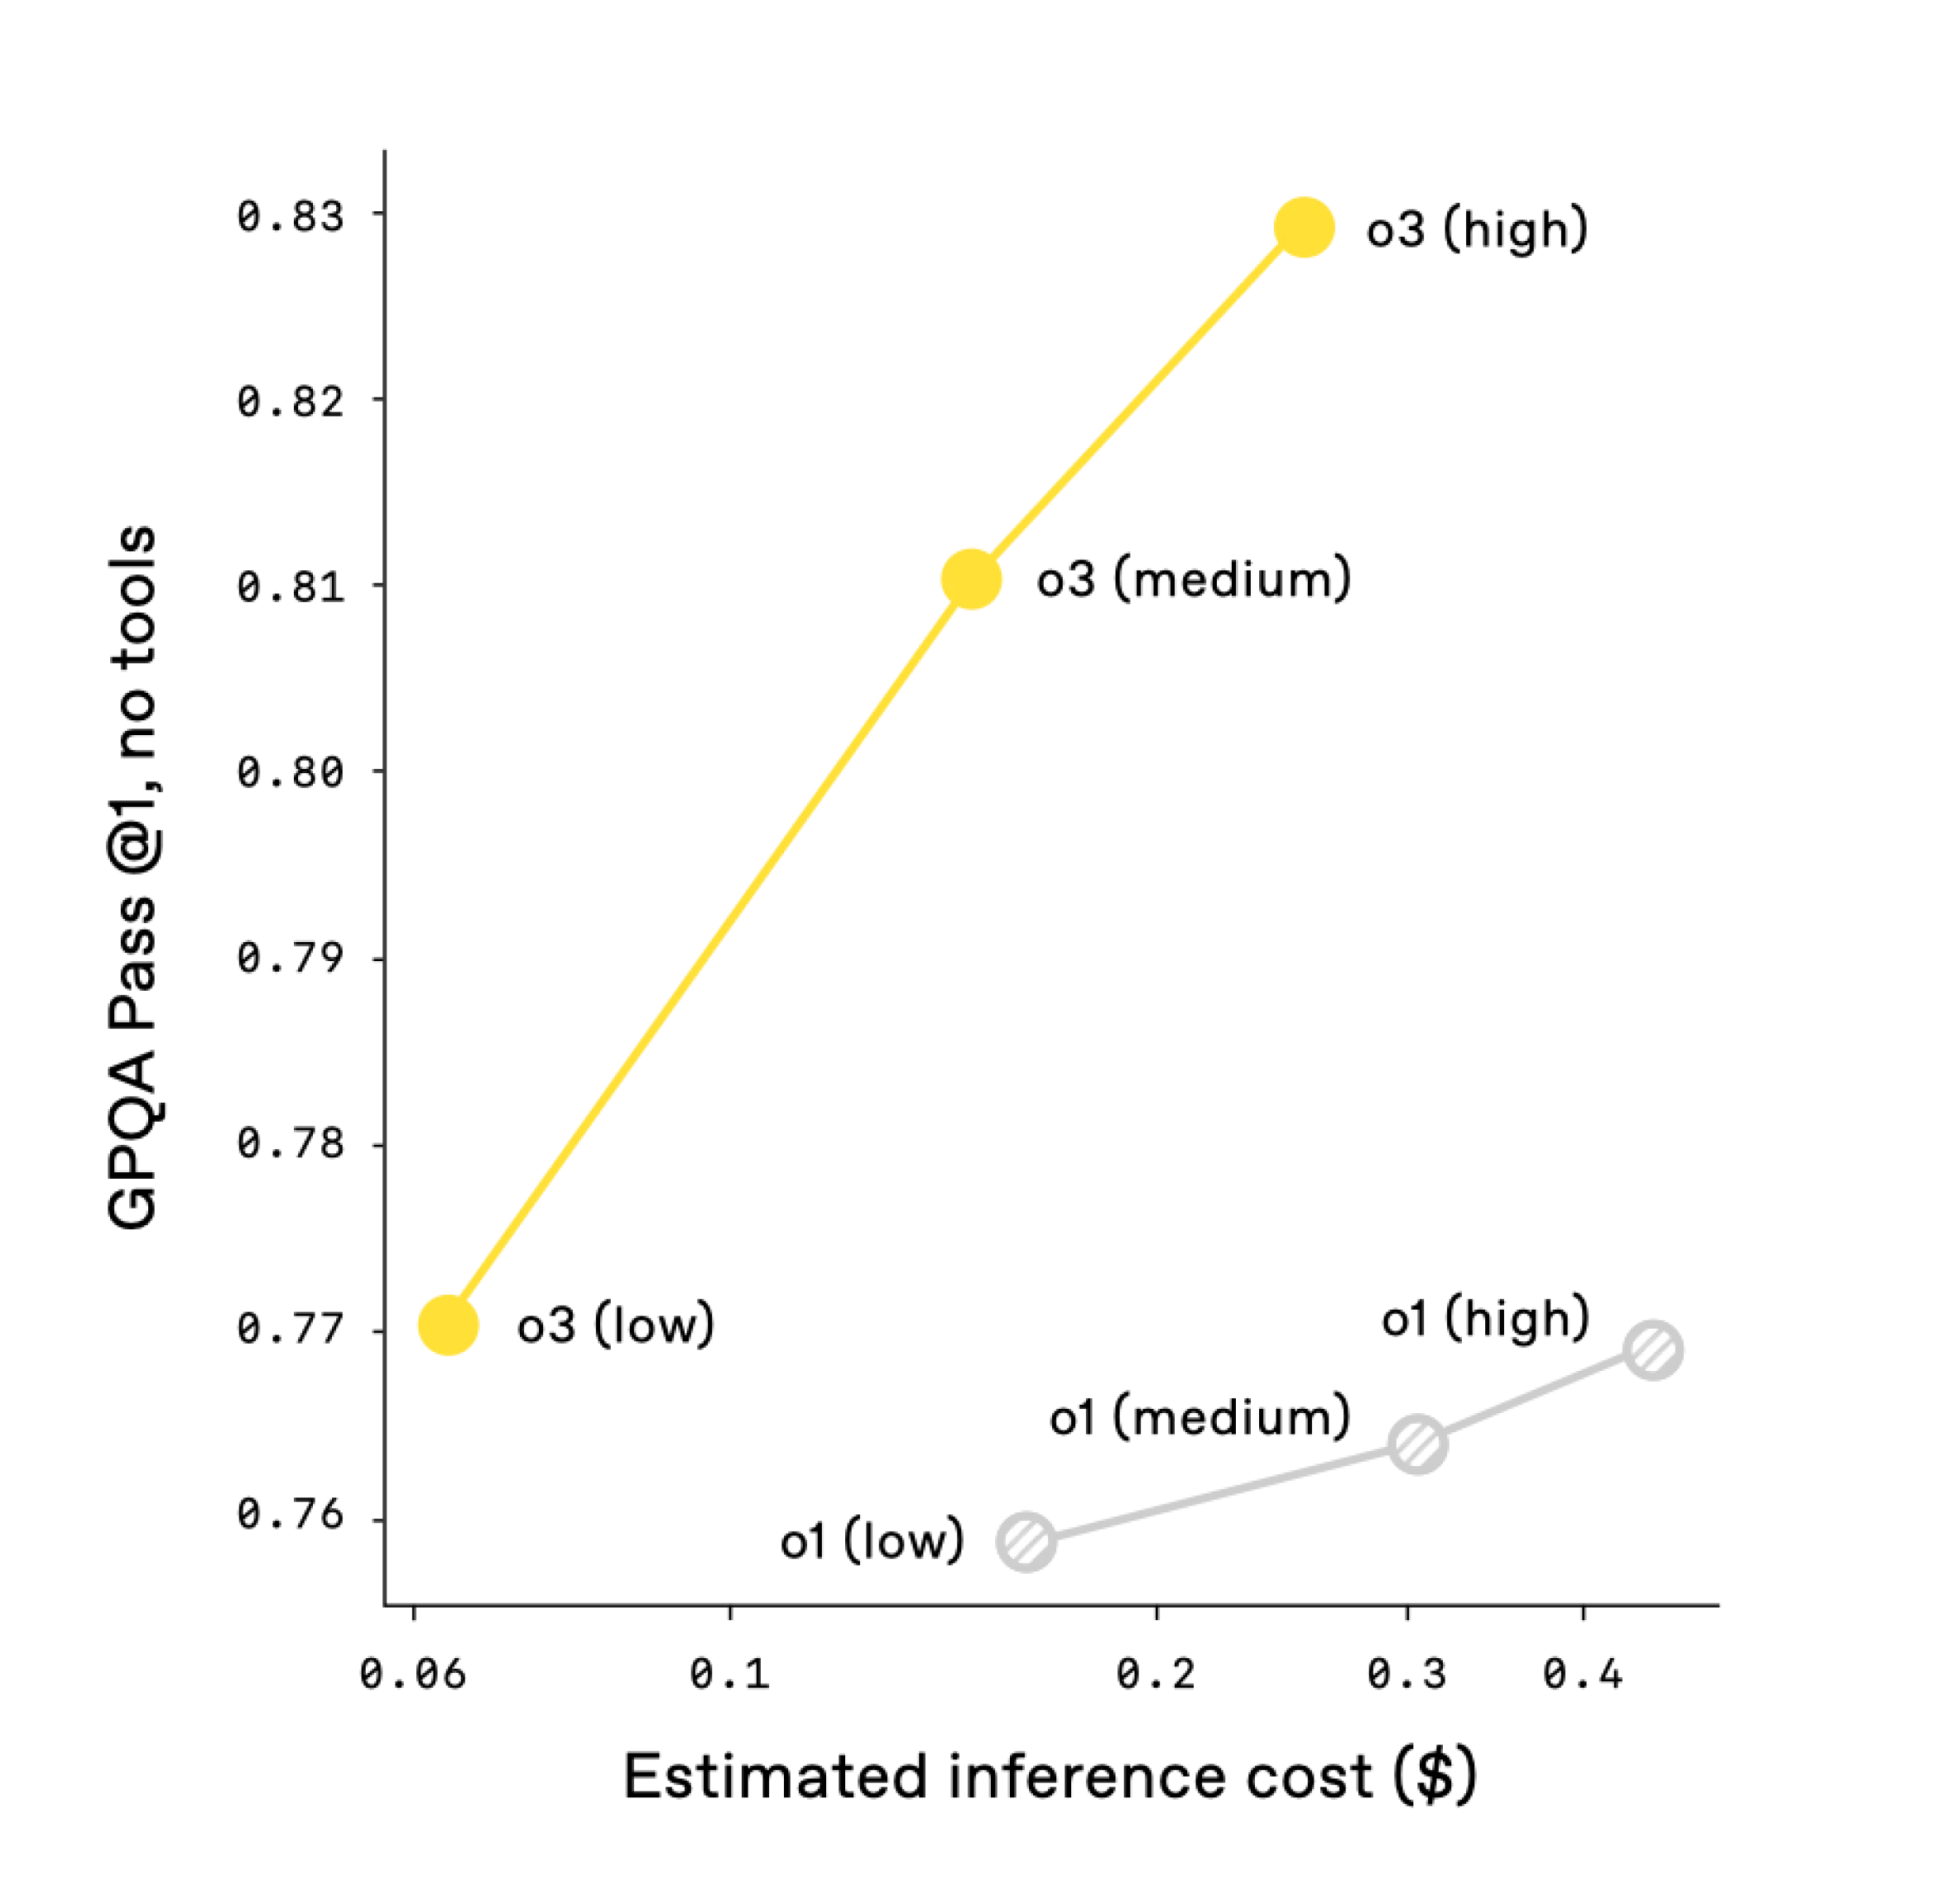
OpenAI o3 и o4-mini — это самые интеллектуальные модели из всех, что мы когда-либо выпускали, и зачастую они также более эффективны, чем их предшественники, OpenAI o1 и o3‑mini. Например, на математическом конкурсе AIME 2025 года граница соотношения стоимости и производительности для модели o3 значительно превосходит о1, а аналогичная граница для o4-mini превосходит o3‑mini. В более общем плане мы ожидаем, что при большинстве сценариев реального использования o3 и o4-mini будут одновременно умнее и дешевле, чем o1 и o3‑mini соответственно.
Безопасность
Каждое улучшение возможностей моделей требует соразмерного повышения уровня безопасности. Для OpenAI o3 и o4-mini мы полностью переработали наши обучающие данные по безопасности, добавив новые правила отказа от выполнения запросов в таких областях, как биологические угрозы (биориски), создание вредоносного ПО и обход систем защиты (джейлбрейки). Эти обновленные данные позволили o3 и o4-mini продемонстрировать высокие результаты в наших внутренних тестах на отказ от запросов (например, иерархия инструкций, джейлбрейки). Помимо эффективного отказа модели от нежелательных запросов, мы также разработали системные механизмы для выявления опасных запросов в передовых областях риска. Аналогично нашей предыдущей работе по генерации изображений, мы обучили языковую модель для мониторинга рассуждений, которая работает на основе написанных человеком и интерпретируемых спецификаций безопасности. Применительно к биорискам этот монитор успешно зафиксировал около 99% диалогов в рамках нашей кампании по имитации кибератак силами экспертов (red-teaming).
Мы провели стресс-тестирование обеих моделей, используя нашу самую строгую программу обеспечения безопасности на сегодняшний день. В соответствии с нашим обновленным фреймворком готовности (Preparedness Framework), мы оценили o3 и o4-mini по трем отслеживаемым направлениям возможностей, охватываемым фреймворком: биологическая и химическая безопасность, кибербезопасность и самосовершенствование ИИ. На основе результатов этих оценок мы определили, что и o3, и o4‑mini остаются ниже порога «Высокий» во всех трех категориях. Подробные результаты этих оценок опубликованы в сопутствующей карточке модели (system card).
Codex CLI: передовые рассуждения в терминале
Мы также делимся новой разработкой — Codex CLI, легковесным агентом для написания кода, который можно запускать прямо из терминала. Он работает непосредственно на вашем компьютере и предназначен для максимального использования возможностей рассуждения таких моделей, как o3 и o4-mini, а в будущем появится поддержка и других API-моделей, например GPT‑4.1.
Вы можете получить преимущества мультимодальных рассуждений из командной строки, передавая модели скриншоты или эскизы низкого качества в сочетании с локальным доступом к вашему коду. Мы рассматриваем это как минималистичный интерфейс для связи наших моделей с пользователями и их компьютерами. Проект Codex CLI полностью с открытым исходным кодом и доступен сегодня по адресу github.com/openai/codex.
Параллельно мы запускаем инициативу на сумму 1 миллион долларов для поддержки проектов, использующих Codex CLI и модели OpenAI. Мы будем оценивать и принимать заявки на гранты в размере 25 000 долларов США в виде кредитов API. Заявки можно подать здесь.
Доступ
Начиная с сегодняшнего дня, пользователи ChatGPT Plus, Pro и Team увидят в селекторе моделей o3, o4-mini и o4-mini-high, которые заменят o1, o3-mini и o3-mini-high. Пользователи ChatGPT Enterprise и Edu получат доступ через неделю. Бесплатные пользователи могут попробовать o4-mini, выбрав «Think» в панели ввода перед отправкой своего запроса. Лимиты запросов для всех планов останутся прежними по сравнению с предыдущим набором моделей.
Мы планируем выпустить OpenAI o3-pro через несколько недель с полной поддержкой инструментов. На данный момент пользователи Pro по-прежнему могут использовать o1-pro.
И o3, и o4-mini также доступны разработчикам уже сегодня через API Chat Completions и Responses (некоторым разработчикам потребуется подтвердить свои организации, чтобы получить доступ к этим моделям). API Responses поддерживает сводки рассуждений, возможность сохранять токены рассуждений при вызове функций для повышения производительности, а в скором времени будет поддерживать встроенные инструменты, такие как веб-поиск, поиск по файлам и интерпретатор кода в рамках рассуждений модели. Чтобы начать работу, ознакомьтесь с нашей документацией и следите за обновлениями.
Что дальше
Сегодняшние обновления отражают вектор развития наших моделей: мы объединяем специализированные возможности рассуждения о-серии с более естественными навыками разговорной речи и использования инструментов серии GPT. Объединив эти сильные стороны, наши будущие модели обеспечат бесшовные, естественные беседы наряду с проактивным использованием инструментов и продвинутым решением задач.
Обновление от 28 июля 2025 г.: Набор данных SWE-Lancer и результаты обновлены по состоянию на 17 июля 2025 г. и доступны по адресу: https://github.com/openai/preparedness и в карточках наших систем. Это обновление устраняет несколько проблем, которые влияли на результаты заработанных средств, и отменяет требование подключения к интернету во время выполнения, устраняя основной источник вариативности в производительности модели.
Обновление от 16 апреля 2025 г.: результаты для o3 на Charxiv-r и Mathvista были обновлены с учетом изменения системного промпта, отсутствовавшего в первоначальной оценке.
Запись трансляции
Автор
Сноски
* Показатели оценки tau-bench усреднены по 5 запускам для снижения дисперсии и выполняются без каких-либо пользовательских инструментов или промптов. Мы обнаружили, что розничные запуски tau-bench более подвержены ошибкам модели пользователя. Показатели для закрашенного столбца получены при использовании GPT-4.1 в качестве модели пользователя, так как она значительно лучше справляется с выполнением инструкций, чем GPT-4o.
* SWE-bench использует максимальную длину контекста 256k, что повышает показатель успешного решения для o4-mini примерно на 3% и влияет на показатель o3 менее чем на 1%. Мы также исключаем 23 образца, которые невозможно запустить на нашей внутренней инфраструктуре.
** При включении поиска модель иногда может находить точные ответы в сети, например, читая блоги с примерами задач из набора данных. Мы снижаем риски того, что модель будет мошенничать при поиске, с помощью двух стратегий:
Наконец, наши оценки с использованием поиска могут не полностью воспроизводиться в API OpenAI из-за различий в бэкендах поисковых систем между ChatGPT и API OpenAI. Эти результаты призваны отражать пользовательский опыт работы с ChatGPT, однако в зависимости от спроса конфигурация поиска может со временем меняться.
Участники
Aaditya Singh, Aaron Schlesinger, Adam Fry, Adam Lerer, Adam Perelman, Adam Walker, Ahmed El-Kishky, Aidan Clark, Aidan McLaughlin, Aiden Low, Akila Welihinda, Akshay Nathan, Aleksander Madry, Aleksandra Spyra, Alex Karpenko, Alex Neitz, Alex Tachard Passos, Alex Wei, Alexander Prokofiev, Alexander Zielenski, Alexandra Barr, Alexey Ivanov, Alexi Christakis, Alfred Xue, Allison Tam, Ally Bennett, Ally Bennett, Amelia Liu, Amy McDonald Sandjideh, Ananya Kumar, Andre Saraiva, Andrea Vallone, Andrew Chen, Andrew Duberstein, Andrew Gibiansky, Andrew Kondrich, Andrew Tulloch, Andrey Mishchenko, Andy Applebaum, Andy Wang, Angela Baek, Annie Wei, Anting Shen, Antoine Pelisse, Anuj Saharan, Arun Vijayvergiya, Ashley Tyra, Ashvin Nair, Avi Nayak, Avital Oliver, Behrooz Ghorbani, Belinda Truong, Ben Sokolowsky, Beth Hoover, Bo Xu, Boaz Barak, Bohan Zhang, Borys Minaiev, Botao Hao, Bowen Baker, Bowen Cheng, Brandon McKinzie, Brandon Wang, Brian Hsu, Brian Yang, Brian Yu, Brian Zhang, Camillo Lugaresi, Carolina Paz, Carpus Chang, Cary Bassin, Cary Hudson, Casey Chu, Chak Li, Charles Zhao, Charlie Jatt, Charlotte Cole, Chelsea Voss, Chen Shen, Chengxu Zhuang, Chris Colby, Chris Hallacy, Chris Koch, Christina Kaplan, Christina Kim, Colin Reid, Colin Wei, Cristina Scheau, D. Sculley, Damien Deville, Dan Roberts, Dana Palmie, Dane Stuckey, Daniel Levine, David Hu, David Martin, David Robinson, David Sasaki, Davis Wu, Derek Chen, Dibya Bhattacharjee, Dimitris Tsipras, Dinghua Li, DJ Strouse, dmed Medina, Drew Hintz, Eddie Zhang, Edmund Wong, Elaine Ya Le, Eli Yani, Elizabeth Proehl, Emily Sokolova, Enoch Cheung, Eri Schwartz, Eric Mitchell, Eric Ning, Eric Sigler, Eric Wallace, Eugenio Panero, Evan Mays, Evgenii Nikishin, Fan Wang, Fangyuan Li, Filippo Raso, Foivos Tsimpourlas, Fouad Matin, Francis Song, Francis Zhang, Gary Yang, Gene Oden, Giambattista Parascandolo, Gildas Chabot, Grace Kim, Grace Zhao, Greg Brockman, Gregory Valiant, Guillaume Leclerc, Hadi Salman, Haitang Hu, Hannah Sheahan, Hao Sheng, Haoyu Wang, Henrique Ponde de Oliveira Pinto, Henry Aspegren, Heqing Yan, Hessam Bagherinezhad, Hongyu Ren, Hunter Lightman, Hyeonwoo Noh, Ian Kivlichan, Ian Sohl, Ignasi Clavera, Ikai Lan, Ilge Akkaya, Ilya Kostrikov, Irina Kofman, Isa Fulford, Jake Brill, Jakub Pachocki, James Betker, James Lee, James Qin, Jamie Kiros, Jason Ai, Jay Wang, Jean Harb, Jeff Mickey, Jeffrey Han, Jeffrey Wang, Jeremy Chen, Jerry Tworek, Jessica Liang, Jessica Shieh, Ji Lin, Jiahui Yu, Jianfeng Wang, Jie Tang, Jihan Yin, Jing Li, Joanne Jang, Joel Morris, Johannes Ferstad, Johannes Heidecke, John Fishbein, Jon Okun, Jonathan Gordon, Joost Huizinga, Jos Kraaijeveld, Joseph Mo, Josh Lawson, Josh Tobin, Junhua Mao, Kai Chen, Kai Hayashi, Karan Singhal, Karina Nguyen, Katy Shi, Kelly Stirman, Kenji Hata, Kenny Nguyen, Keren Gu-Lemberg, Kevin Gladstone, Kevin King, Kevin Liu, Kevin Lu, Kevin Park, Kevin Stone, Kevin Weil, Kevin Whinnery, Kevin Yu, Kote Mushegiani, Kristen Ying, Kristian Georgiev, Kshitij Gupta, Kyle Kosic, Lama Ahmad, Larry Lv, Lauren Itow, Lauren Yang, Lee Byron, Leo Chen, Leo Liu, Leon Maksin, Leyton Ho, Li Jing, Liang Xiong, Lin Yang, Linden Li, Lorenz Kuhn, Louis Feuvrier, Lu Zhang, Łukasz Kaiser, Mahmoud Eariby, Maja Trębacz, Manas Joglekar, Manoli Liodakis, Manuka Stratta, Mark Chen, Mark Hudnall, Mark Sun, Mark Wang, Martin Li, Marvin Zhang, Mateusz Litwin, Matt Jones, Matt Lim, Max Johnson, Max Schwarzer, Mayank Gupta, Meghan Shah, Mengqing Wang, Mengyuan Yan, Mia Glaese, Michael Bolin, Michael Lampe, Michael Malek, Michael Sharman, Michael Zhang, Michele Wang, Michelle Pokrass, Miguel Oom Temudo de Castro, Mihai Florian, Mike McClay, Mike Trpcic, Miki Habryn, Miles Wang, Ming Chen, Mingxuan Wang, Minnia Feng, Mitchell Gordon, Mo Bavarian, Mostafa Rohaninejad, Nacho Soto, Nakul Khanna, Nat McAleese, Natalie Staudacher, Natan LaFontaine, Neel Ajjarapu, Nick Felt, Nick Turley, Nikil Pancha, Nikita Mikhaylin, Niko Felix, Nikunj Handa, Ning Liu, Nishant Rai, Noah Jorgensen, Noam Brown, Oleg Boiko, Oleg Murk, Olivia Watkins, Olivier Godement, Oona Gleeson, Paul Ashbourne, Pavel Belov, Peter Flockhart, Peter Hoeschele, Peter Zhokhov, Philip Pronin, Phillip Guo, Phoebe Thacker, Prafulla Dhariwal, Prashanth R, Rachel Dias, Rahul Arora, Rajkumar Samuel, Rasmus Rygaard, Ravi Teja Mullapudi, Raymond Li, Raz Gaon, Reah Miyara, Reiichiro Nakano, Reimar Leike, Rennie Song, Rhythm Garg, RJ Marsan, Robert Xiong, Robin Brown, Roman Tsiupa, Rui Shu, Ruslan Nigmatullin, Saachi Jain, Saagar Patel, Sam Altman, Sam Toizer, Sam Toyer, Samir Ahmed, Samuel Miserendino, Samuel Wolrich, Sandhini Agarwal, Santiago Hernández, Sarah Dong, Savannah Heon, Scott Ethersmith, Scott Mayer McKinney, Sean Fitzgerald, Sever Banesiu, Shamez Hemani, Shengjia Zhao, Shengli Hu, Shibani Santurkar, Shreyas Krishnaswamy, Shuchao Bi, Shunyu Yao, Shuyuan Zhang, Simón Posada Fishman, Spencer Papay, Spug Golden, Srinivas Narayanan, Stanley Hsieh, Stephen Logsdon, Sundeep Tirumalareddy, Tal Stramer, Tao Wang, Tao Xin, Taylor Gordon, Tejal Patwardhan, Thibault Sottiaux, Tina Sriskandarajah, Tony Casparro, Tony Zhao, Trapit Bansal, Trevor Creech, Uzair Navid Iftikhar, Valerie Qi, Vineet Kosaraju, Vishal Kuo, Vitchyr Pong, Vivek Verma, Vlad Petrov, Wenda Zhou, Wenlei Xie, Wenting Zhan, Will DePue, Will Ellsworth, William Sheu, Wyatt Thompson, Yaming Lin, Yann Dubois, Yaodong Yu, Yara Khakbaz, Yash Patil, Yifan Wu, Yilong Qin, Yining Chen, Yirui Zhang, Yo Shavit, Young Cha, Yunyun Wang, Yushi Wang, Zack Sultan, Zehao Dou, Zewei Chu, Zheng Shao, Zhigang Wang, Zhishuai Zhang, Zihao Zhang
Полный текст статьи читайте на OpenAI
