OpenAI o3‑mini
Расширяя границы экономически эффективных рассуждений.
Мы выпускаем OpenAI o3‑mini — нашу новейшую и самую экономичную модель в серии рассуждающих моделей, которая уже сегодня доступна в ChatGPT и через API. Представленная в декабре 2024 года, эта мощная и бытая модель раздвигает границы возможностей небольших моделей, обеспечивая исключительные навыки в области точных наук, технологий, инженерии и математики (STEM) — с особым упором на науку, математику и программирование, — и всё это при сохранении низкой стоимости и уменьшенной задержки OpenAI o1‑mini.
OpenAI o3‑mini — наша первая небольшая модель с возможностью рассуждения, которая поддерживает столь востребованные разработчиками функции, включая вызов функций (function calling), структурированные выводы (Structured Outputs) и сообщения разработчика (developer messages), что делает её готовой к использованию в продакшене с самого начала. Как и OpenAI o1‑mini и OpenAI o1‑preview, o3‑mini поддерживает потоковую передачу данных (streaming). Кроме того, разработчики могут выбирать из трех вариантов интенсивности рассуждений (reasoning effort) — низкого (low), среднего (medium) и высокого (high), — чтобы оптимизировать модель под свои конкретные задачи. Эта гибкость позволяет o3‑mini «сильнее задумываться» при решении сложных проблем или отдавать приоритет скорости, когда критически важна задержка. Модель o3‑mini не поддерживает работу с визуальными данными, поэтому для задач визуального анализа разработчикам следует продолжать использовать OpenAI o1. Начиная с сегодняшнего дня, o3‑mini внедряется в Chat Completions API, Assistants API и Batch API для избранных разработчиков с 3–5 уровнями использования API (API usage tiers 3–5).
Пользователи тарифных планов ChatGPT Plus, Team и Pro получат доступ к OpenAI o3‑mini уже сегодня, а корпоративный доступ (Enterprise) появится в феврале. Модель o3‑mini заменит OpenAI o1‑mini в селекторе моделей, предложив более высокие лимиты запросов и меньшую задержку, что делает её привлекательным выбором для программирования, задач STEM и логического решения проблем. В рамках этого обновления мы утроим лимит запросов для пользователей Plus и Team: с 50 сообщений в день для o1‑mini до 150 сообщений в день для o3‑mini. Кроме того, o3‑mini теперь работает с поиском, позволяя находить актуальные ответы со ссылками на соответствующие веб-источники. Это ранний прототип в рамках нашей работы по интеграции поиска во все рассуждающие модели.
Начиная с сегодняшнего дня, пользователи бесплатного тарифа также могут попробовать OpenAI o3‑mini, выбрав пункт «Рассуждать» (Reason) при создании сообщения или сгенерировав ответ заново. Это первый случай, когда рассуждающая модель становится доступна бесплатным пользователям в ChatGPT.
Хотя OpenAI o1 остается нашей универсальной моделью рассуждений общего назначения, OpenAI o3‑mini представляет собой специализированную альтернативу для технических областей, требующих точности и скорости. В ChatGPT o3‑mini использует средний уровень интенсивности рассуждений для обеспечения сбалансированного компромисса между скоростью и точностью. Все платные пользователи также получат возможность выбрать o3‑mini‑high в селекторе моделей для получения более интеллектуальной версии, на генерацию ответов которой уходит чуть больше времени. Пользователям Pro будет предоставлен неограниченный доступ как к o3‑mini, так и к o3‑mini‑high.
Быстрая, мощная и оптимизированная для рассуждений в области точных наук (STEM)
Подобно своему предшественнику OpenAI o1, модель OpenAI o3‑mini оптимизирована для логических рассуждений в STEM-областях. При среднем уровне усилий на рассуждения o3‑mini соответствует показателям o1 в математике, программировании и естественных науках, обеспечивая при этом более быстрый ответ. Оценки экспертов-тестировщиков показали, что o3‑mini выдает более точные и понятные ответы с более сильными способностями к рассуждению, чем OpenAI o1‑mini. Тестировщики отдавали предпочтение ответам o3‑mini по сравнению с o1‑mini в 56% случаев и отметили сокращение числа серьезных ошибок на 39% при решении сложных реальных задач. При среднем уровне усилий на рассуждения o3‑mini не уступает o1 в некоторых из самых сложных тестов на интеллект и логику, включая AIME и GPQA.
Олимпиадная математика (AIME 2024)
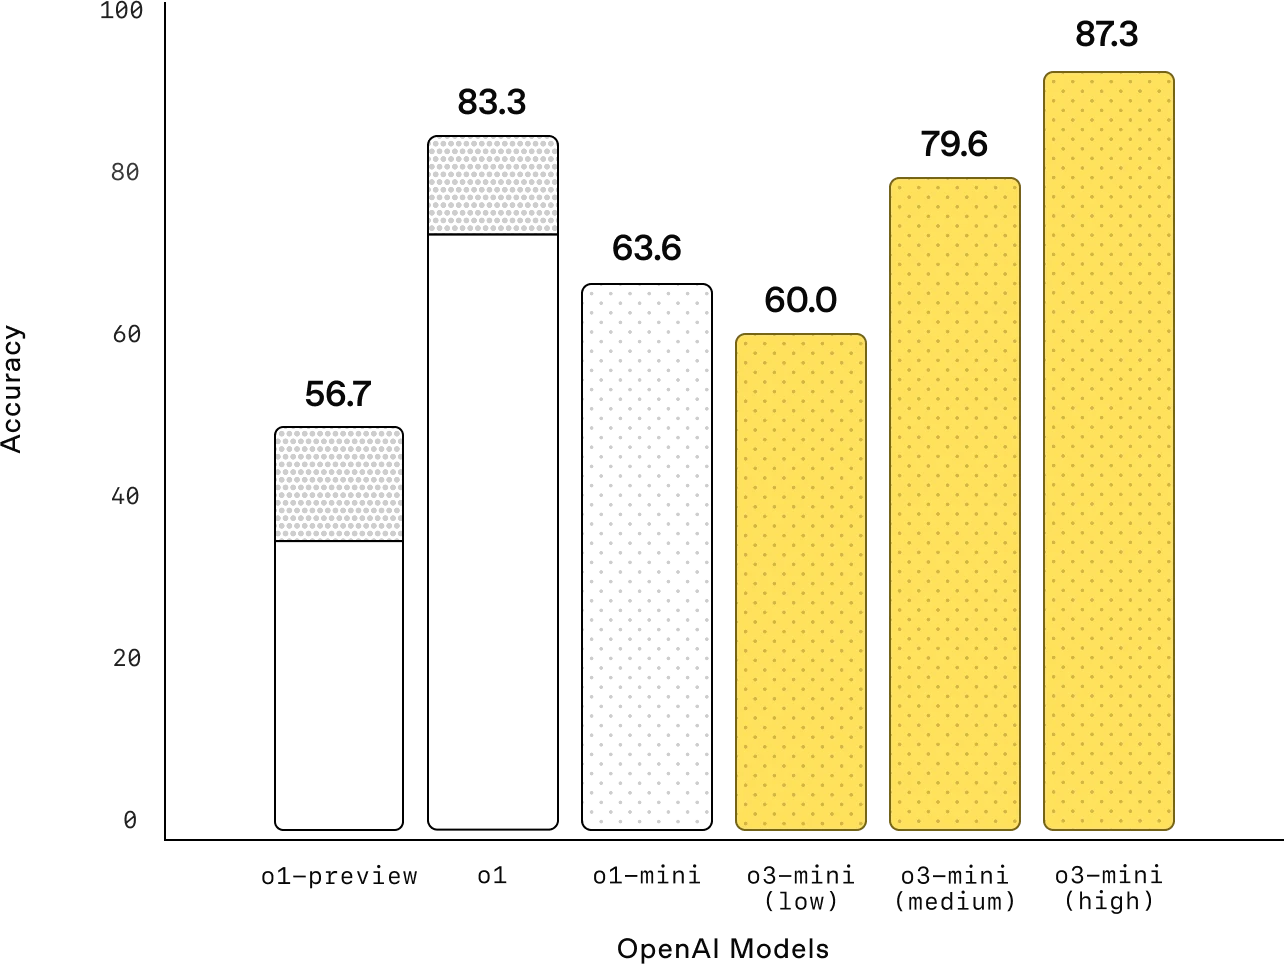
Математика: при низком уровне усилий на рассуждения OpenAI o3‑mini достигает производительности, сопоставимой с OpenAI o1‑mini, в то время как при среднем усилии o3‑mini демонстрирует результаты на уровне o1. Между тем, при высоком уровне усилий на рассуждения o3‑mini превосходит как OpenAI o1‑mini, так и OpenAI o1; области, закрашенные серым цветом, отображают результаты мажоритарного голосования (консенсуса) по 64 выборкам.
Научные вопросы уровня PhD (GPQA Diamond)
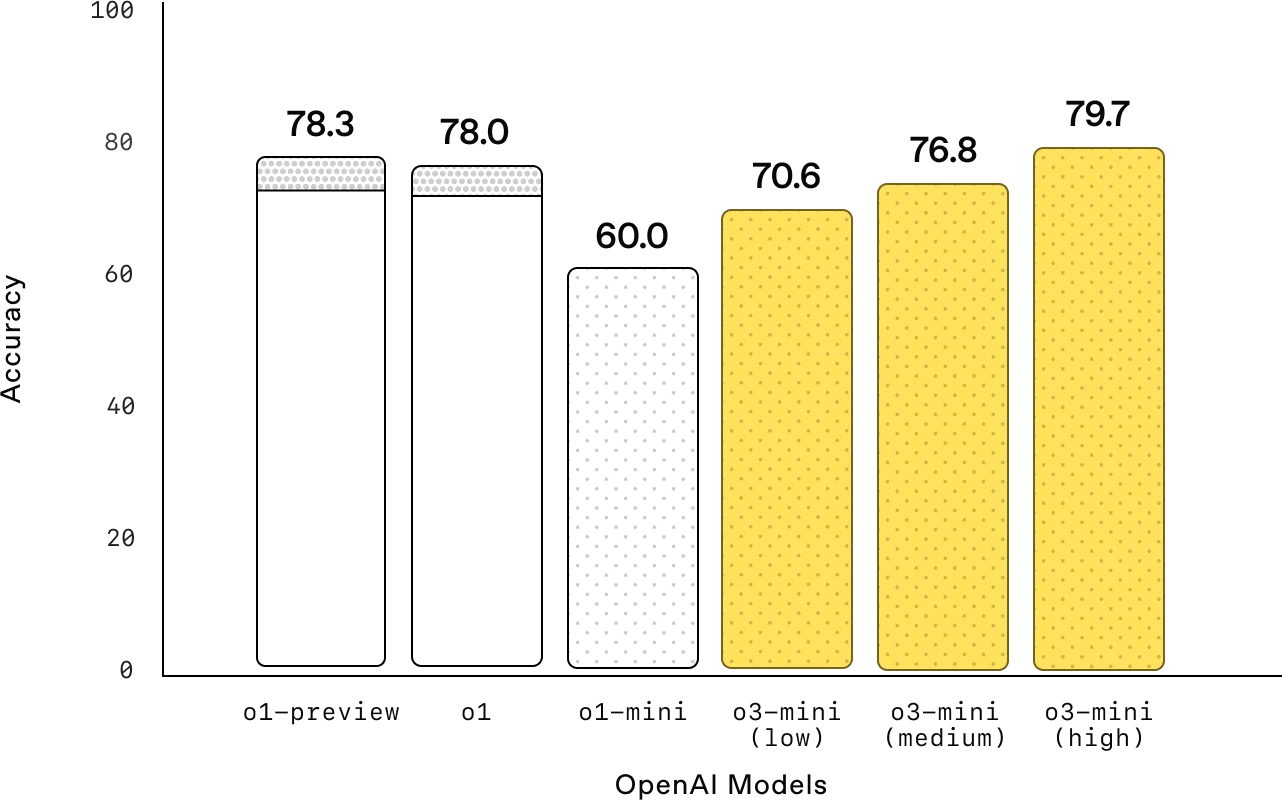
Наука на уровне PhD: при решении вопросов по биологии, химии и физике уровня PhD с низким уровнем усилий на рассуждения OpenAI o3‑mini превосходит OpenAI o1‑mini. При высоком уровне усилий o3‑mini достигает производительности, сопоставимой с o1.
FrontierMath
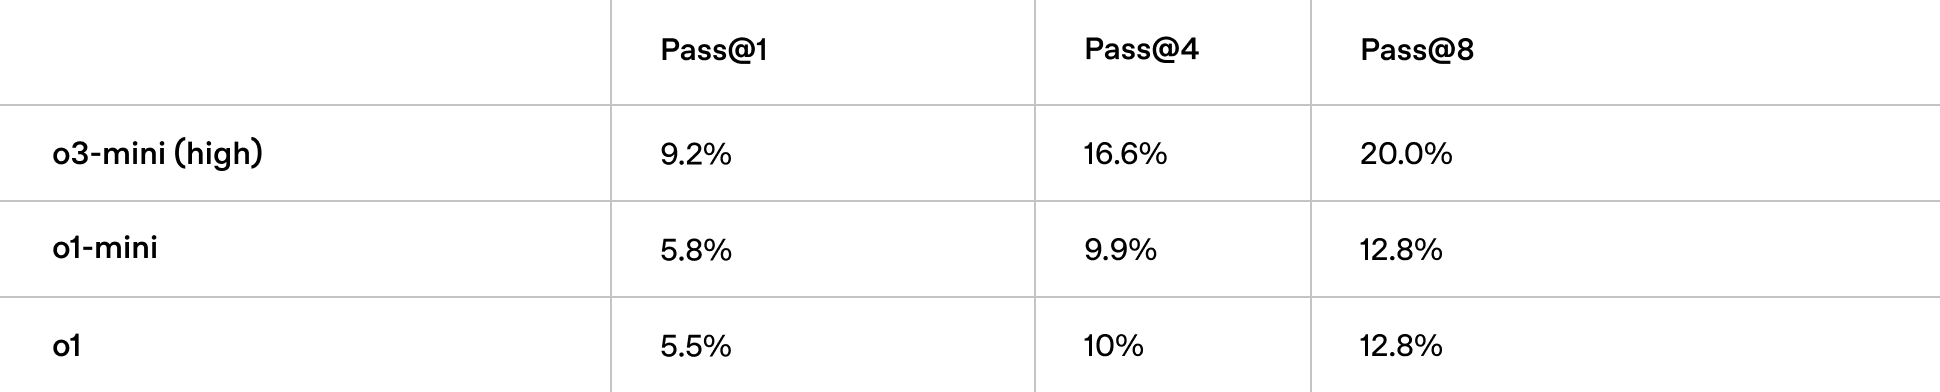
Математика на уровне научных исследований: OpenAI o3‑mini с высоким уровнем рассуждений работает лучше своего предшественника в тестах FrontierMath. В FrontierMath при получении запроса на использование инструмента Python o3‑mini с высоким уровнем усилий на рассуждения успешно решает более 32% задач с первой попытки, включая более 28% сложных задач (T3). Эти цифры являются предварительными, а на графике выше показана производительность без использования инструментов или калькулятора.
Соревновательное программирование (Codeforces)
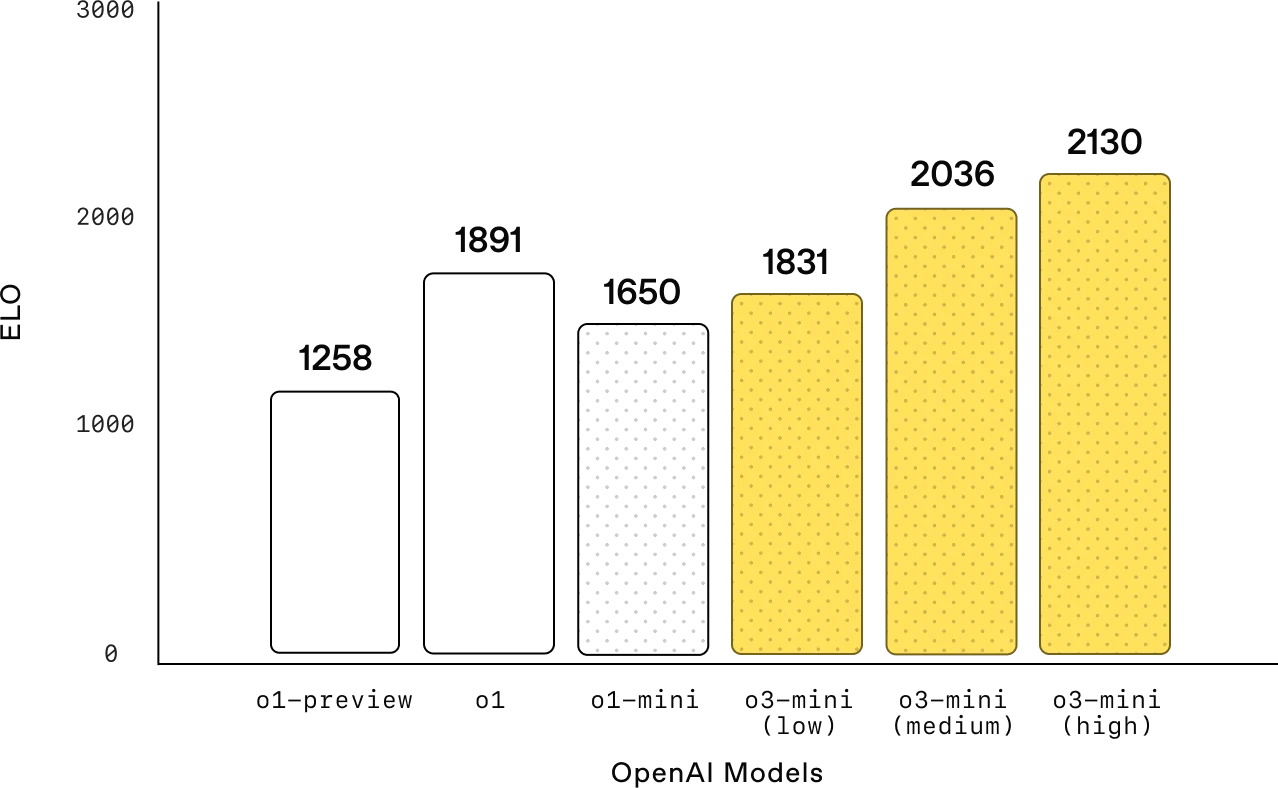
Соревновательное программирование: в соревновательном программировании на Codeforces модель OpenAI o3‑mini достигает все более высоких рейтингов Elo по мере увеличения усилий на рассуждения, и все они превосходят o1‑mini. При среднем уровне усилий на рассуждения она соответствует производительности o1.
Программная инженерия (SWE-bench Verified (n=477))
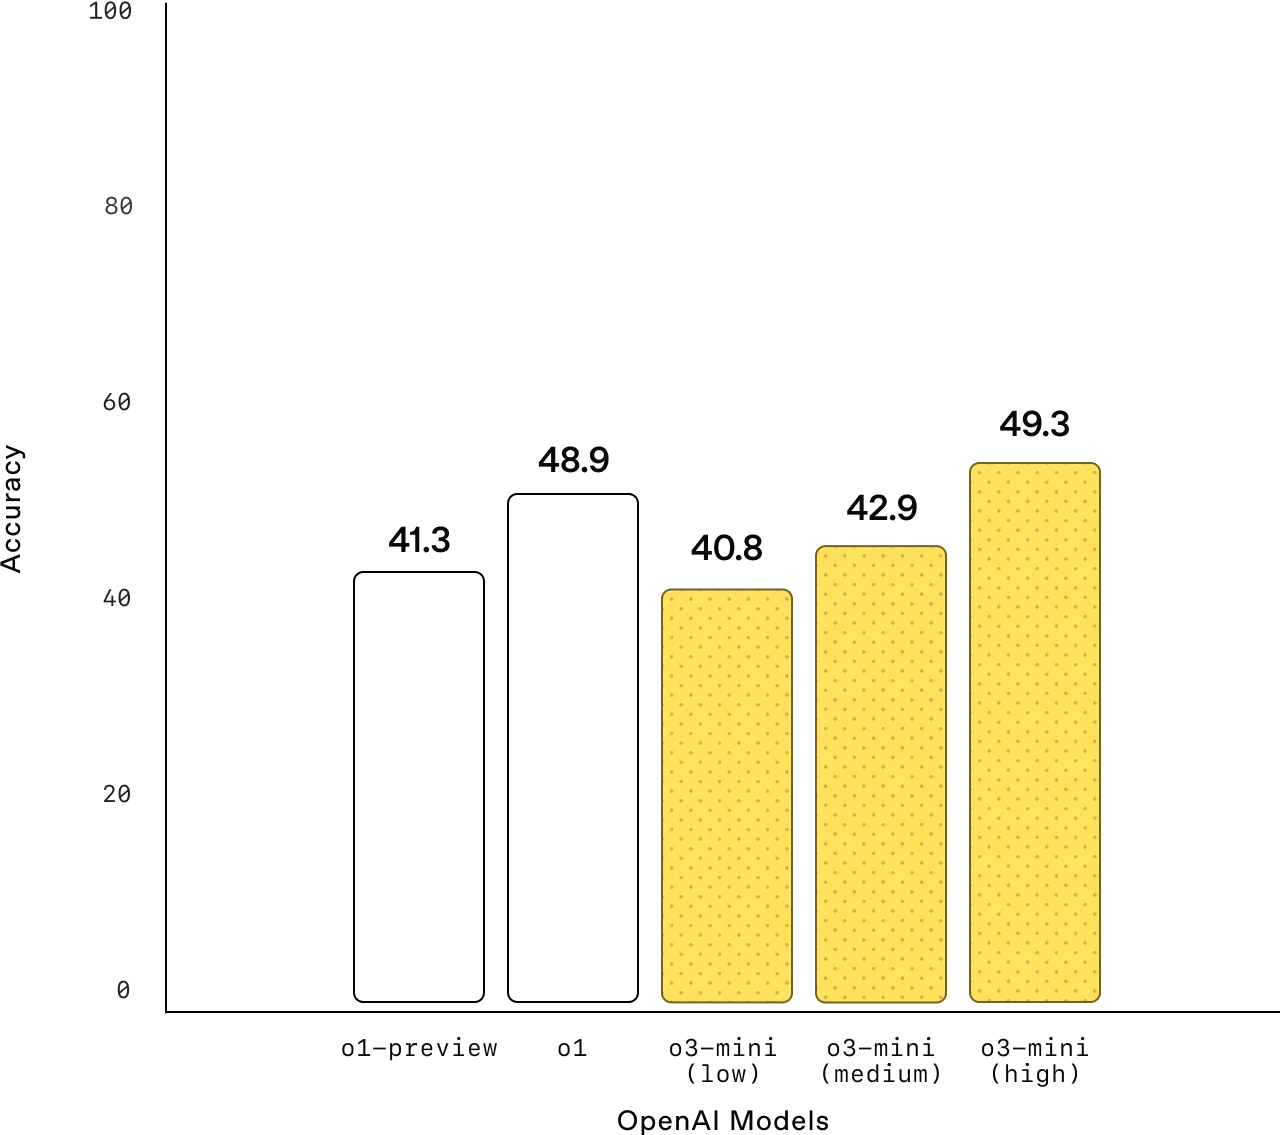
Разработка программного обеспечения: o3‑mini — наша самая производительная выпущенная модель в бенчмарке SWE-bench Verified. Дополнительные данные о результатах в SWE-bench Verified с высоким уровнем логического рассуждения, включая результаты с каркасом с открытым исходным кодом Agentless (39%) и каркасом внутренних инструментов, представляющим максимальное выявление возможностей (61%), см. в нашей системной карте в качестве первоисточника. Все запуски оценки SWE-bench используют фиксированную подмножество из n=477 проверенных задач, прошедших валидацию на нашей внутренней инфраструктуре.
Программирование в LiveBench
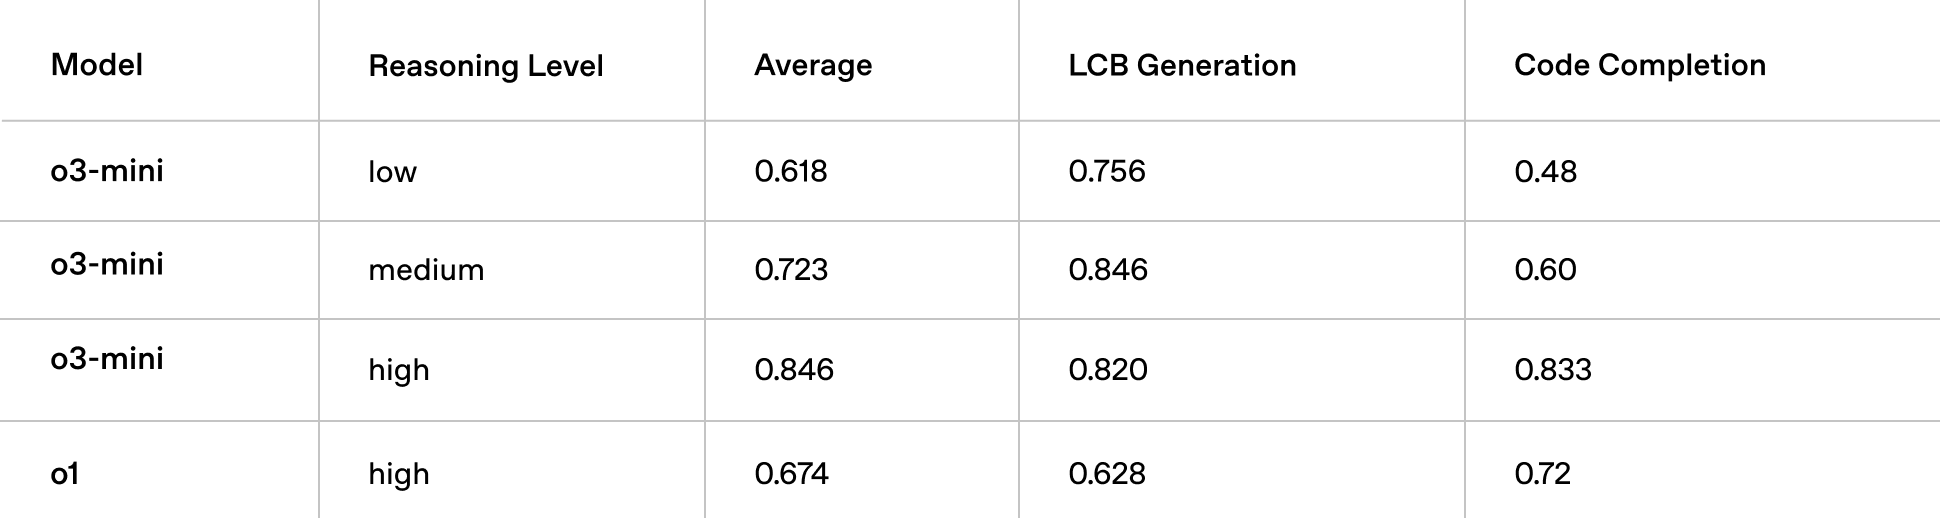
Программирование в LiveBench: OpenAI o3‑mini превосходит o1‑high даже при среднем уровне логического рассуждения, что подчеркивает его эффективность в задачах программирования. При высоком уровне логического рассуждения o3‑mini еще больше увеличивает отрыв, демонстрируя значительно более высокие результаты по ключевым метрикам.
Общие знания
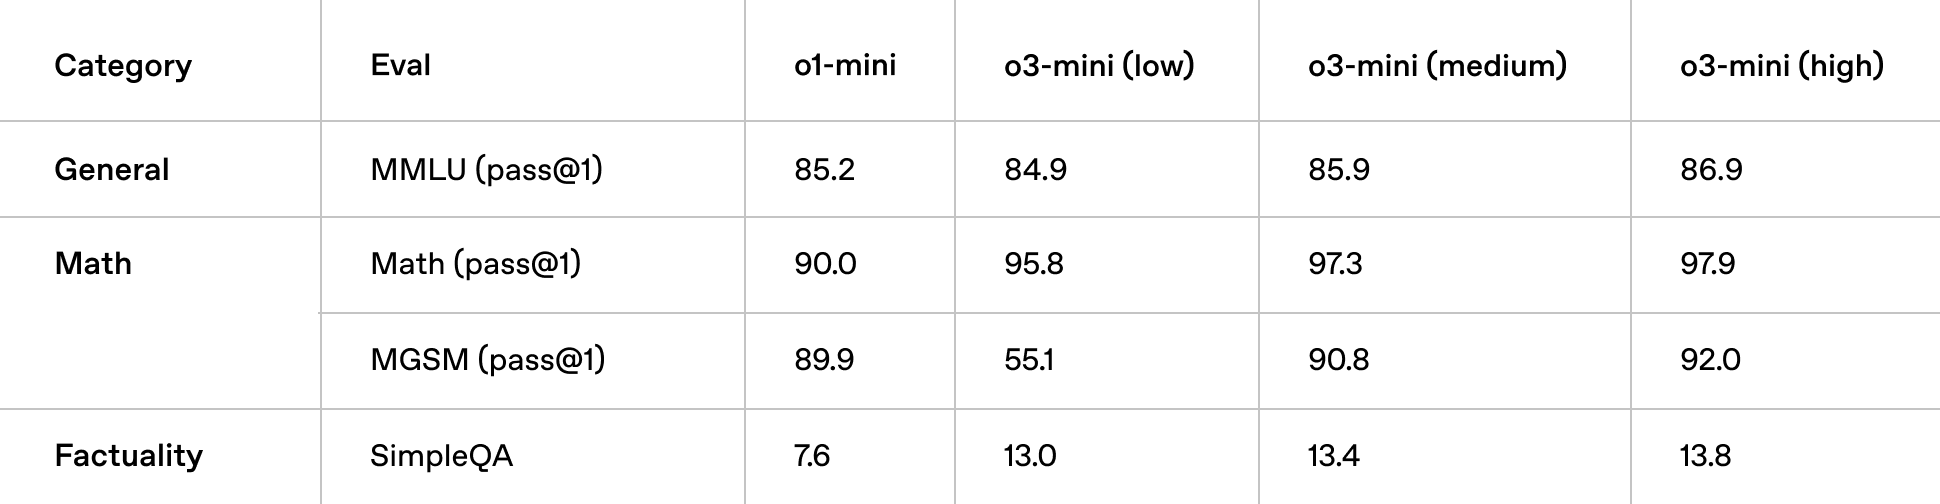
Общие знания: o3‑mini превосходит o1‑mini в оценках знаний в различных областях общих знаний.
Оценка предпочтений человека
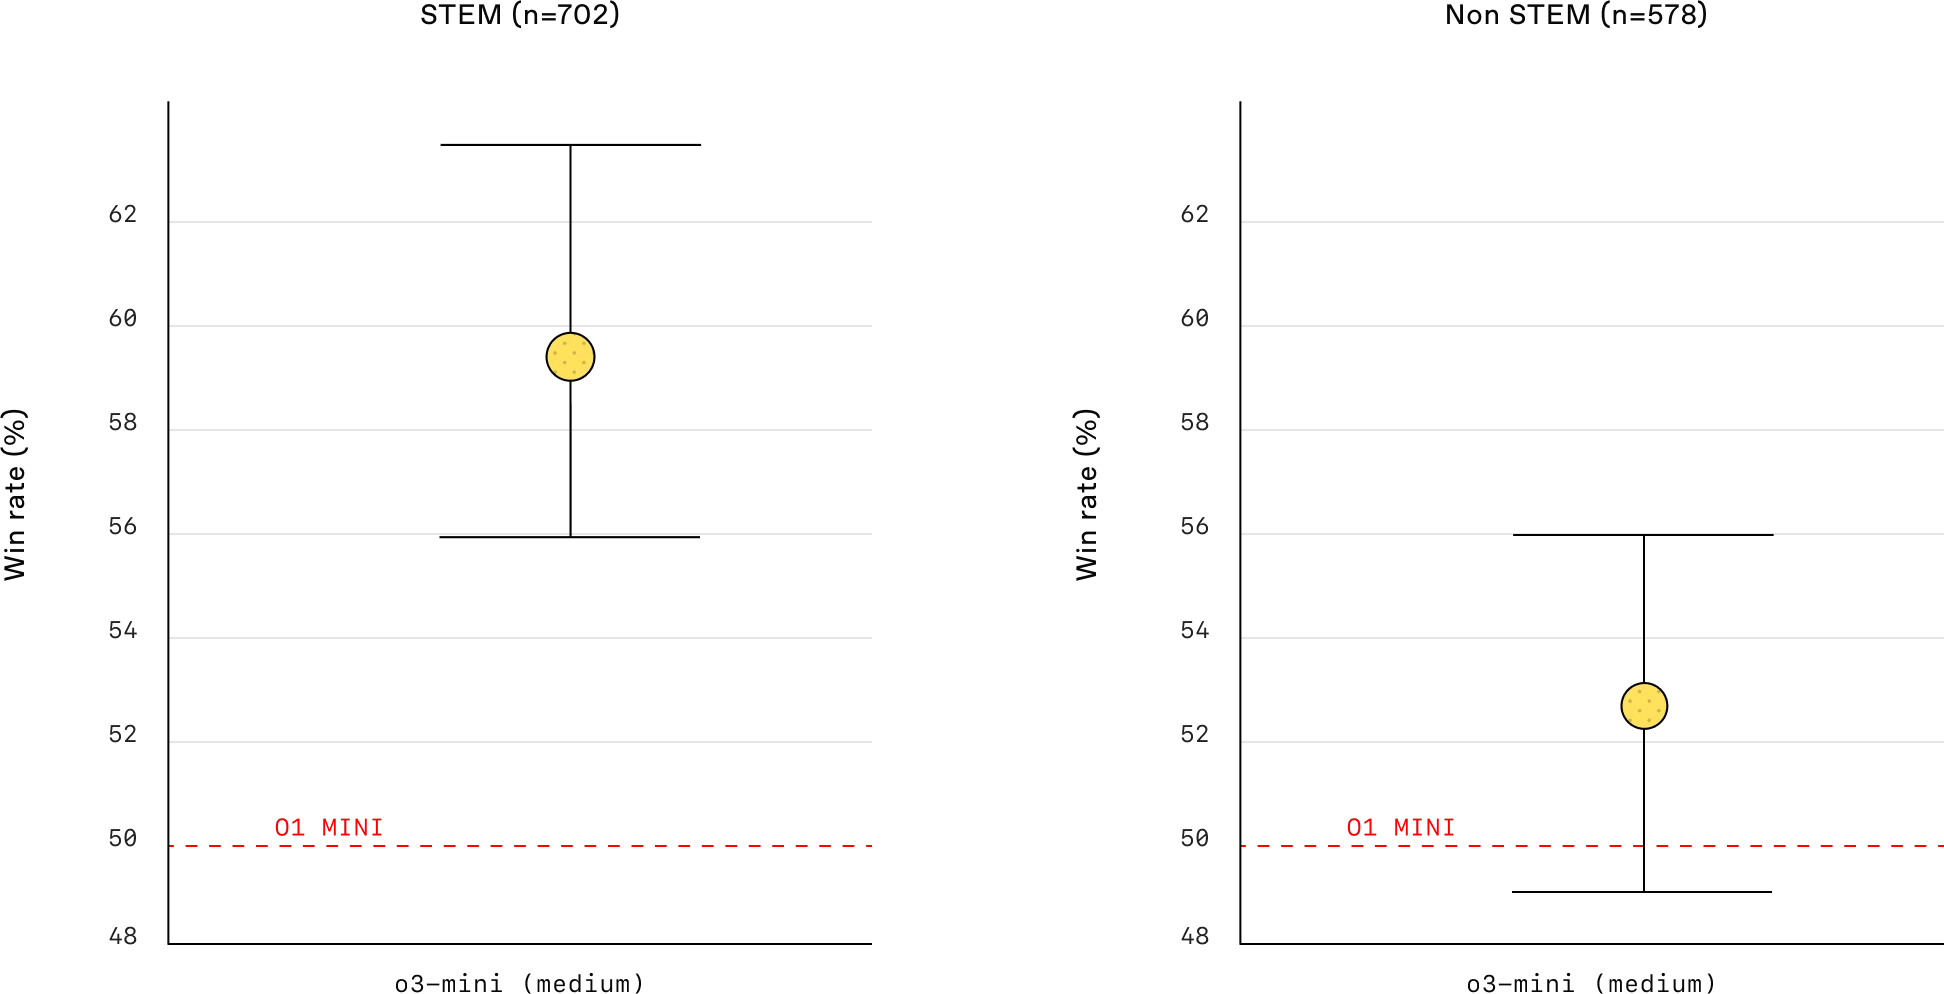
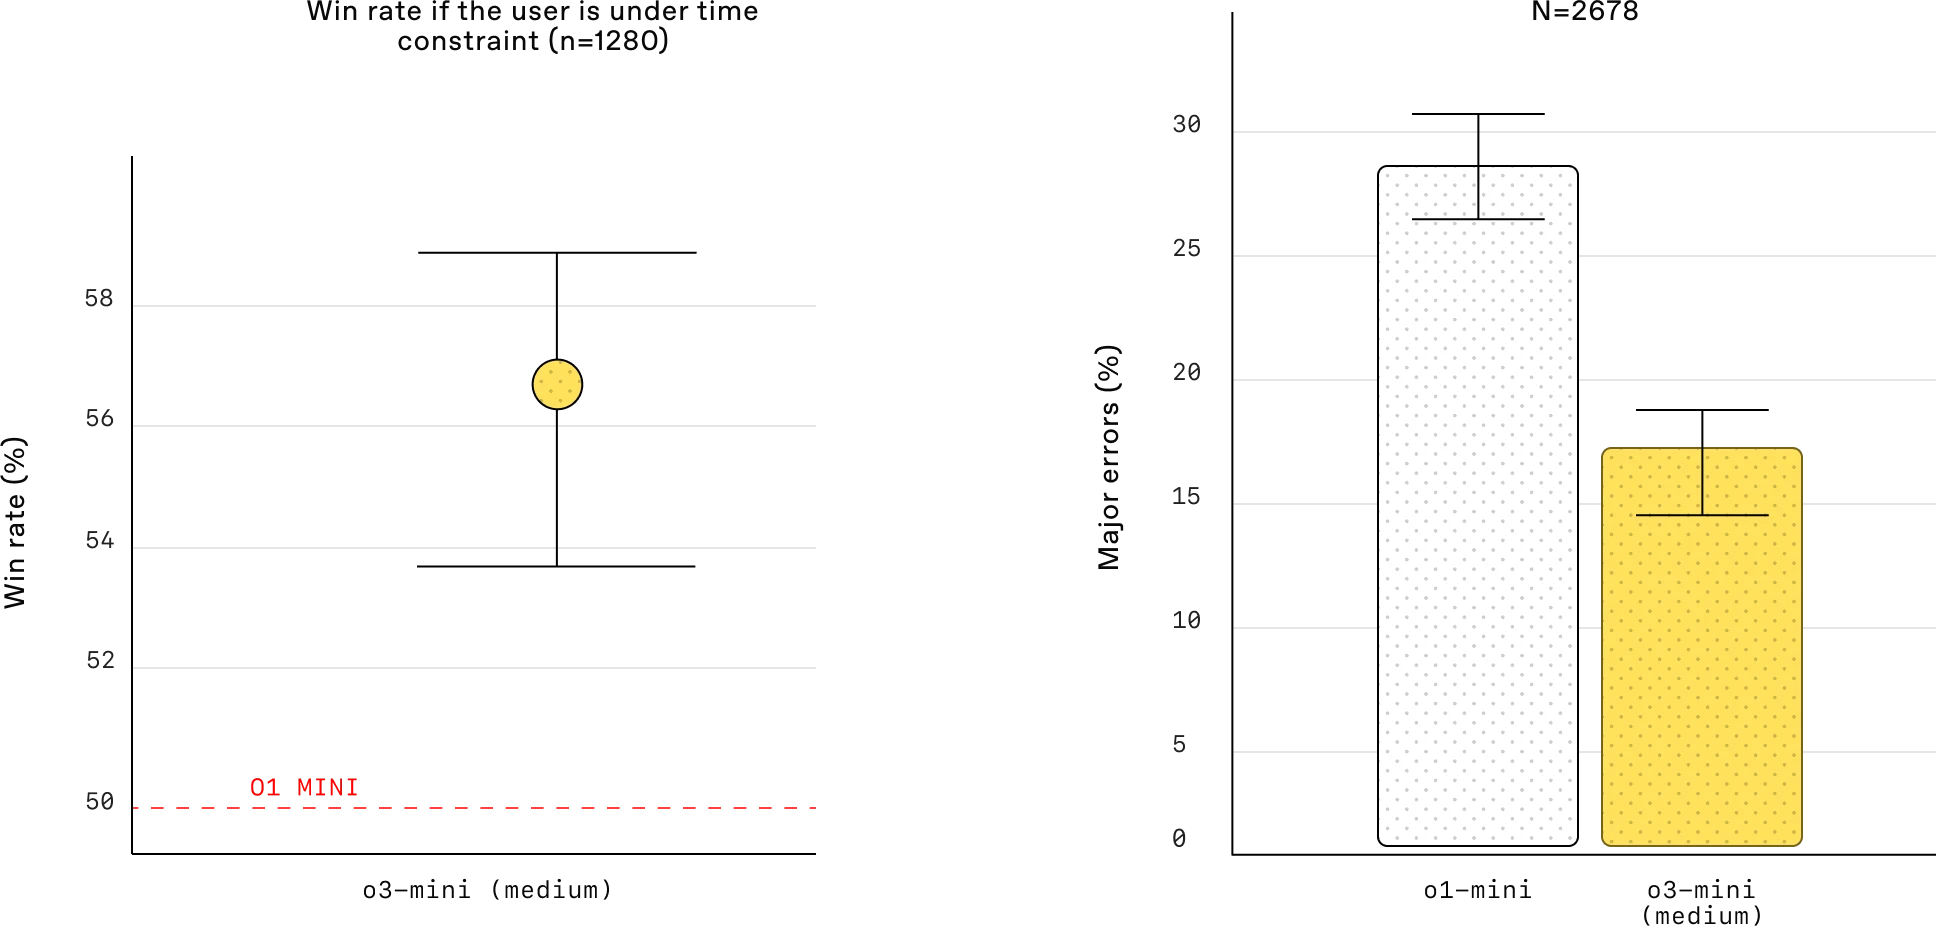
Оценка предпочтений человека: Оценки независимых экспертов-тестировщиков также показывают, что OpenAI o3‑mini дает более точные и понятные ответы, обладая более сильными способностями к рассуждению, чем OpenAI o1‑mini, особенно в точных науках (STEM). Тестировщики отдавали предпочтение ответам o3‑mini по сравнению с o1‑mini в 56% случаев и отметили сокращение количества серьезных ошибок на 39% при решении сложных реальных задач.
Скорость и производительность модели
Обладая интеллектом, сопоставимым с OpenAI o1, модель OpenAI o3‑mini обеспечивает более высокую скорость работы и улучшенную эффективность. Помимо упомянутых выше тестов в области STEM, o3‑mini демонстрирует превосходные результаты в дополнительных тестах по математике и фактологической точности при среднем уровне рассуждений. В ходе A/B-тестирования o3‑mini выдавала ответы на 24% быстрее, чем o1‑mini, при этом среднее время ответа составило 7,7 секунды по сравнению с 10,16 секунды.
Сравнение задержки между o1-mini и o3-mini (средний уровень)
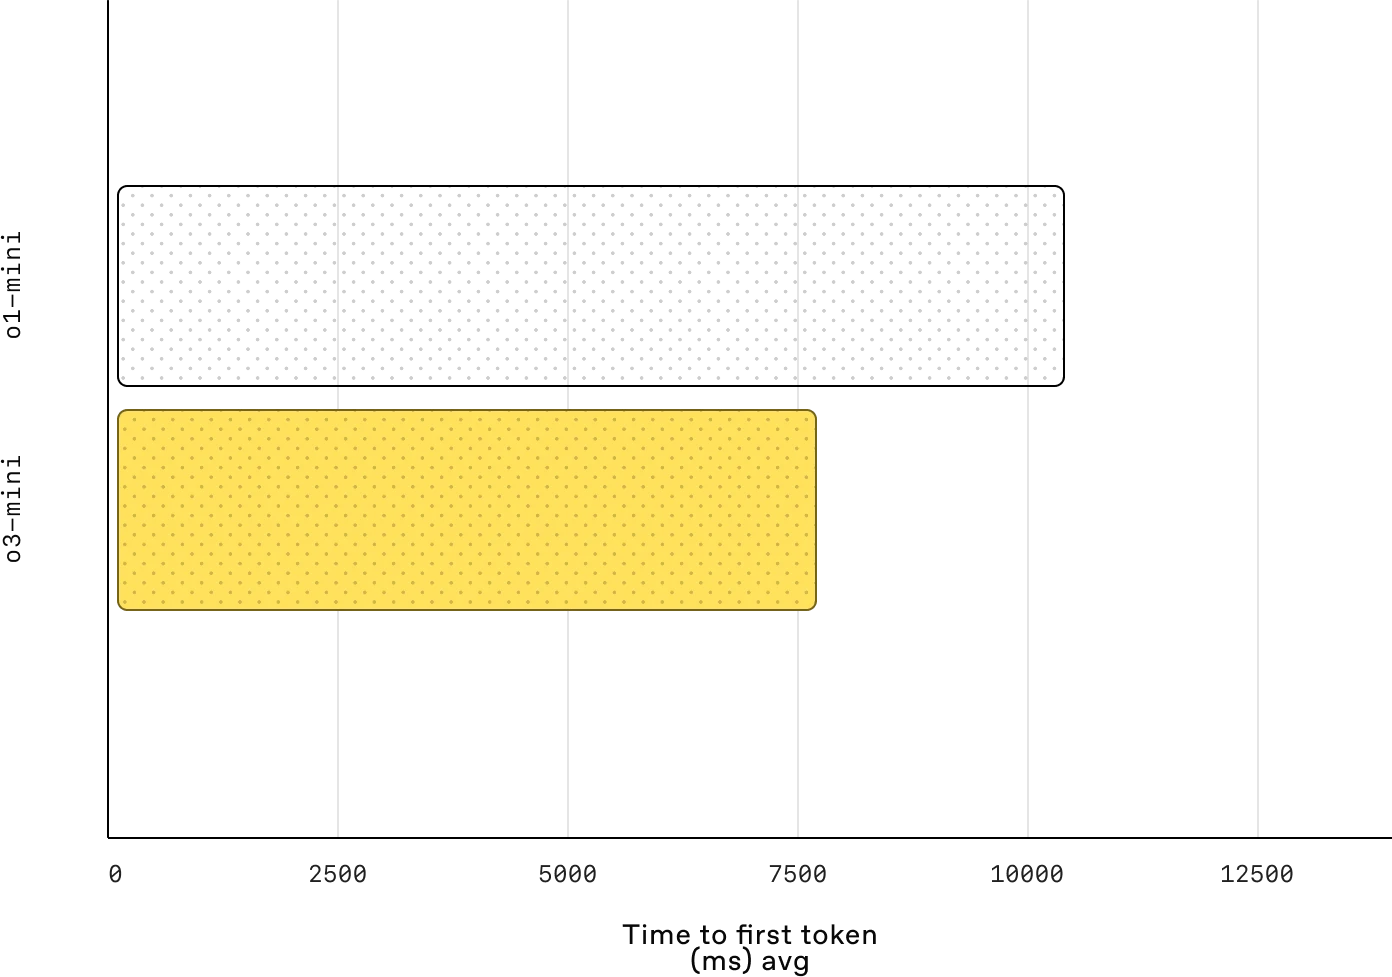
Задержка: модель o3‑mini выдает первый токен в среднем на 2500 мс быстрее, чем o1‑mini.
Безопасность
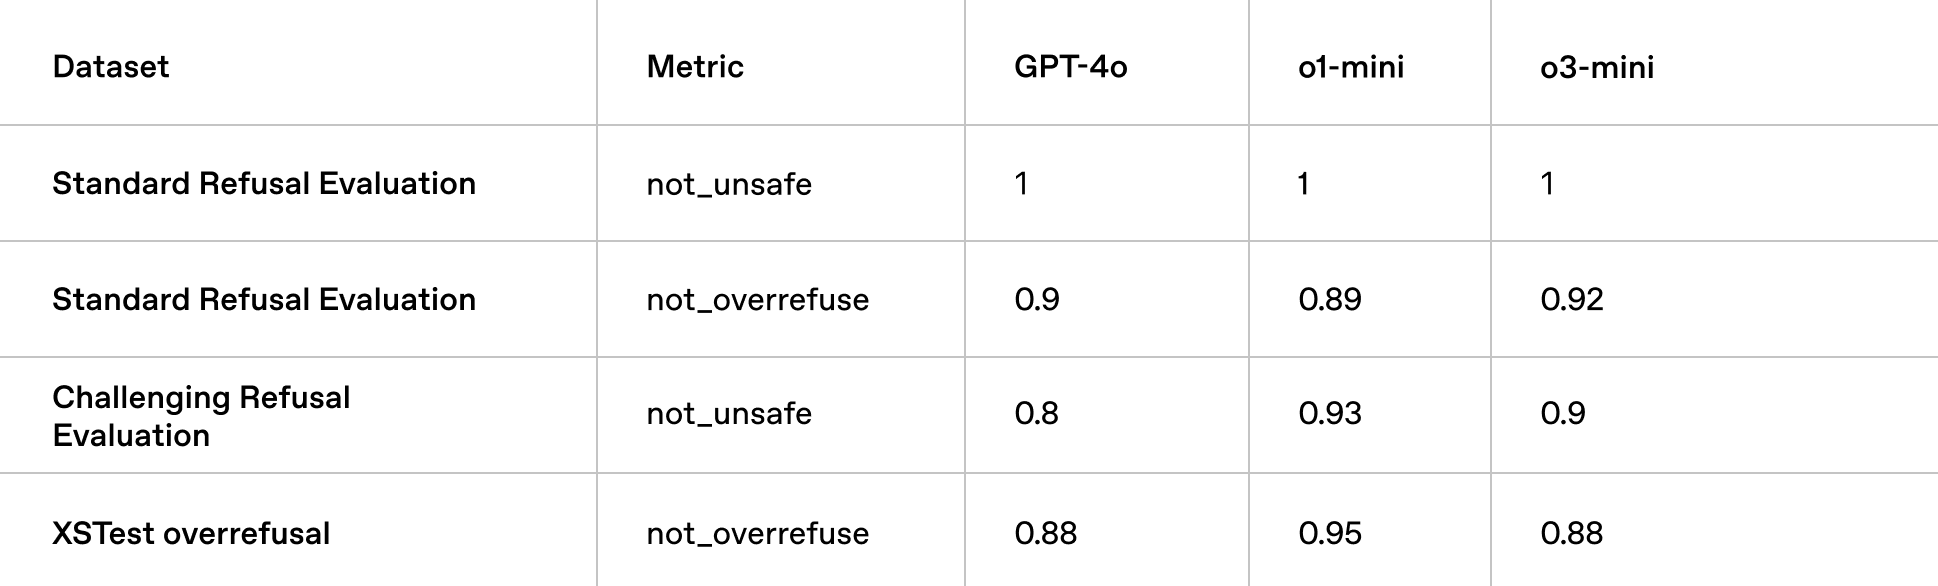
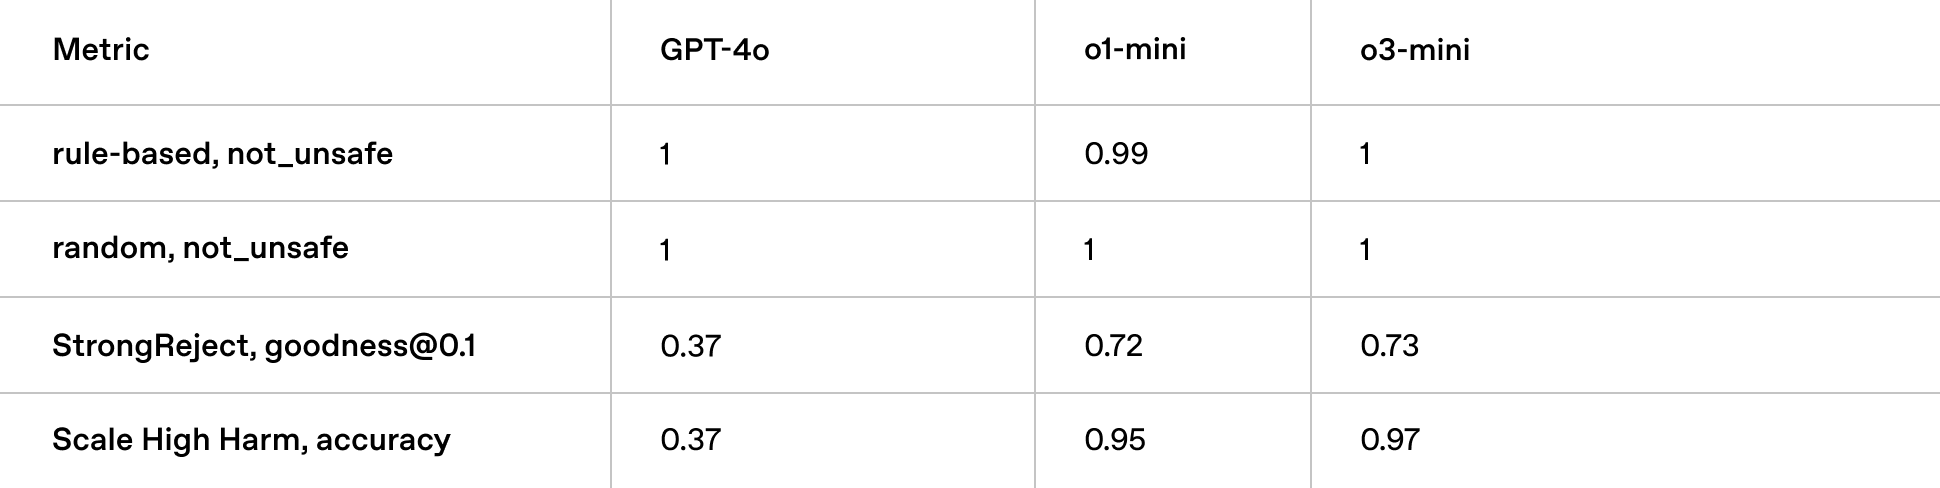
Одним из ключевых методов, которые мы использовали для обучения OpenAI o3‑mini безопасным ответам, является преднамеренное выравнивание (deliberative alignment): мы обучали модель рассуждать над написанными людьми спецификациями безопасности перед ответом на запросы пользователей. Аналогично OpenAI o1, модель o3‑mini значительно превосходит GPT‑4o в сложных тестах на безопасность и обход систем защиты (jailbreak). Перед развертыванием мы тщательно оценили риски безопасности o3‑mini, используя тот же подход к обеспечению готовности, внешнему тестированию на проникновение (red-teaming) и оценке безопасности, что и для o1. Мы благодарим тестировщиков безопасности, подавших заявки на тестирование o3‑mini на этапе раннего доступа. Подробные сведения об оценках, приведенных ниже, а также исчерпывающее объяснение потенциальных рисков и эффективности наших мер по их минимизации доступны в системной карте o3‑mini.
Оценка запрещенного контента
Тестирование на обход защиты (Jailbreak)
Что дальше
Выпуск OpenAI o3‑mini знаменует собой еще один шаг в реализации миссии OpenAI по расширению границ экономически эффективного интеллекта. Оптимизируя логические рассуждения для областей STEM и одновременно удерживая затраты на низком уровне, мы делаем высококачественный ИИ еще более доступным. Эта модель продолжает нашу традицию снижения стоимости искусственного интеллекта — сократив цены за токен на 95% с момента запуска GPT‑4 — при сохранении первоклассных возможностей рассуждения. По мере расширения внедрения ИИ мы по-прежнему привержены лидерству на передовой, создавая модели, которые сочетают в себе интеллект, эффективность и безопасность в масштабном исполнении.
Авторы
Обучение
Brian Zhang, Eric Mitchell, Hongyu Ren, Kevin Lu, Max Schwarzer, Michelle Pokrass, Shengjia Zhao, Ted Sanders
Тестирование
Adam Kalai, Alex Tachard Passos, Ben Sokolowsky, Elaine Ya Le, Erik Ritter, Hao Sheng, Hanson Wang, Ilya Kostrikov, James Lee, Johannes Ferstad, Michael Lampe, Prashanth Radhakrishnan, Sean Fitzgerald, Sebastien Bubeck, Yann Dubois, Yu Bai
Передовые тесты и готовность
Andy Applebaum, Elizabeth Proehl, Evan Mays, Joel Parish, Kevin Liu, Leon Maksin, Leyton Ho, Miles Wang, Michele Wang, Olivia Watkins, Patrick Chao, Samuel Miserendino, Tejal Patwardhan
Разработка
Adam Walker, Akshay Nathan, Alyssa Huang, Andy Wang, Ankit Gohel, Ben Eggers, Brian Yu, Bryan Ashley, Chengdu Huang, Christian Hoareau, Davin Bogan, Emily Sokolova, Eric Horacek, Eric Jiang, Felipe Petroski Such, Jonah Cohen, Josh Gross, Justin Becker, Kan Wu, Kevin Whinnery, Larry Lv, Lee Byron, Manoli Liodakis, Max Johnson, Mike Trpcic, Murat Yesildal, Rasmus Rygaard, RJ Marsan, Rohit Ramchandani, Rohan Kshirsagar, Roman Huet, Sara Conlon, Shuaiqi (Tony) Xia, Siyuan Fu, Srinivas Narayanan, Sulman Choudhry, Tomer Kaftan, Trevor Creech
Поиск
Adam Fry, Adam Perelman, Brandon Wang, Cristina Scheau, Philip Pronin, Sundeep Tirumalareddy, Will Ellsworth, Zewei Chu
Продукт
Antonia Woodford, Beth Hoover, Jake Brill, Kelly Stirman, Minnia Feng, Neel Ajjarapu, Nick Turley, Nikunj Handa, Olivier Godement
Безопасность
Andrea Vallone, Andrew Duberstein, Enis Sert, Eric Wallace, Grace Zhao, Irina Kofman, Jieqi Yu, Joaquin Quinonero Candela, Madelaine Boyd, Mehmet Yatbaz, Mike McClay, Mingxuan Wang, Saachi Jain, Sandhini Agarwal, Sam Toizer, Santiago Hernández, Steve Mostovoy, Young Cha, Tao Li, Yunyun Wang
Внешнее тестирование на проникновение (Redteaming)
Lama Ahmad, Troy Peterson
Менеджеры исследовательской программы
Carpus Chang, Kristen Ying
Руководство
Aidan Clark, Dane Stuckey, Jerry Tworek, Jakub Pachocki, Johannes Heidecke, Kevin Weil, Liam Fedus, Mark Chen, Sam Altman, Wojciech Zaremba
+ все разработчики, внесшие свой вклад в o1.
Полный текст статьи читайте на OpenAI
