Обучение ИИ созданию научных моделей
- На примере модели Ходжкина — Хаксли описаны три этапа моделирования: построение, настройка параметров по измерениям и интерпретация.
- Вывод на основе симуляций обучает нейросеть по результатам запусков: около 100 000 для модели Ходжкина — Хаксли и миллионы для более сложных моделей.
- LLM-агенты создают код моделей-кандидатов, сравнивают результаты с данными и повторяют цикл, меняя, например, форму уравнений.
Почему это важно: Совпадения модели с данными недостаточно: оно само по себе не даёт понимания реальной системы.
01Программа из трёх этапов
Стипендиаты программы AI for Science Якоб Макке, Даниэль Гедон и Штефан Валь — исследователи из Института ELLIS в Тюбингене и Тюбингенского университета. Они разрабатывают инструменты ИИ для создания научных моделей в нейронауке и других областях. В этой авторской статье они рассказывают о том, как ИИ начинает менять научное моделирование.
В 1951 году компьютер Кембриджского университета вышел из строя на шесть месяцев. Это было весьма некстати для физиолога Эндрю Хаксли: вместе со своим коллегой Аланом Ходжкином он только что разработал систему уравнений, описывающую работу определённой нервной клетки кальмара. Учёные хотели понять, как возникает «потенциал действия» этих нервных клеток — электрические импульсы, с помощью которых они обмениваются сигналами и которые лежат в основе всего, что делает мозг: от восприятия до интеллекта. Единственный способ выяснить, работают ли уравнения, состоял в том, чтобы решить их и сравнить результаты с данными.
Хаксли рассчитывал воспользоваться новейшим компьютером для решения уравнений. Вместо этого ему пришлось решать их с помощью механического калькулятора с ручным приводом. На это ушло больше трёх недель.
Основную структуру модели определяли известные свойства клетки. Ходжкин и Хаксли представили её мембрану в виде электрической цепи. Однако одна часть модели была лишь обоснованным предположением. Чтобы кривая совпала с полученными ими данными, оказалось, что одну переменную нужно возвести в четвёртую степень — то есть умножить саму на себя три раза. Тогда учёные не знали почему. Они лишь понимали, что иначе модель хуже предсказывает наблюдаемые данные.
Впрочем, они предложили гипотезу. Учёные предположили, хотя и с осторожностью, что переменная, определявшая открытие некоторых каналов в мембране клетки, должна возводиться в четвёртую степень, потому что для открытия канала на место должны переместиться несколько заряженных частиц в мембране.
Спустя десятилетия, уже после того, как Ходжкин и Хаксли получили Нобелевскую премию по физиологии и медицине в 1963 году, другая группа учёных определила структуру родственного белка калиевого канала. Выяснилось, что он действительно состоит из четырёх одинаковых частей, расположенных вокруг центральной поры. Модель подогнали под данные ещё в 1951 году. Уже тогда она достаточно точно предсказывала скорость распространения импульса. Более того, оказалось, что она помогла предсказать структуру самих калиевых ионных каналов, хотя её для этого никогда не подгоняли.
Сегодня система ИИ вполне могла бы найти уравнение, подобное уравнению Ходжкина и Хаксли, за один день и, возможно, ещё точнее подогнать его под экспериментальные данные. Но суть этой истории в том, что просто знать, что четвёртая степень даёт нужный результат, было недостаточно. Важно было понять, что более простая версия модели не работает. Система ИИ, которая просто выдаёт вам модель, может дать ответ, но не понимание. Одного воспроизведения данных с помощью модели недостаточно, ведь то же самое могли бы сделать самые разные модели. Важно уметь делать выводы о самой системе реального мира, а в идеале — и о других подобных системах. Для этого нужно знать, какие характеристики у этой модели общие с другими работающими моделями и чем она отличается от неработающих. Как написал математик Ричард Хэмминг в 1962 году: «Цель вычислений — понимание, а не числа».
Программа из трёх этапов
Спустя более 70 лет модель Ходжкина — Хаксли по-прежнему остаётся стандартным описанием электрической активности нейронов. Уравнения того же типа, но с другими константами, описывают нервные клетки всего животного мира — от кальмаров до людей, хотя наши эволюционные линии разошлись более полумиллиарда лет назад.
Однако ещё важнее её долговечности то, что модель Ходжкина — Хаксли говорит нам о принципах работы моделей. Подход Ходжкина и Хаксли можно разделить на три этапа, и научное моделирование в большинстве случаев включает те или иные их варианты.
- Первый этап — построение модели. Нужно решить, из чего она состоит и какую форму имеют её уравнения. В случае Ходжкина и Хаксли это означало определить составляющие электрической цепи — мембрану и каналы — и форму уравнений, например возведение исходной переменной в четвёртую степень.
- Второй этап — ограничение модели: настройка её изменяемых параметров в соответствии с реальными измерениями. Для Ходжкина и Хаксли это включало такие параметры, как частота открытия каналов при разных напряжениях.
- Третий этап — интерпретация модели: выяснение того, что она говорит о реальной системе. Например, можно предположить, что четвёртая степень указывает на наличие у канала четырёх подвижных частей.
На практике учёные неоднократно проходят эти этапы. Если числа не соответствуют измерениям или интерпретация не имеет смысла, они возвращаются к началу и вносят изменения.
Когда-то все три этапа выполняли люди, но системы ИИ всё активнее участвуют в каждом из них. Пожалуй, наибольшего прогресса машины добились в ограничении моделей — с него и начнём.
Как поделить счёт, или как ограничить модель
Ограничивая модель на глаз и по наитию, Ходжкин и Хаксли получили один набор чисел. Это показало, что модель может соответствовать данным. Но из этого не следовало, что другие числа подошли бы так же хорошо или даже лучше.
Представьте, что вы знаете: общий счёт за ужин компании составил 120 долларов, но не знаете, кто что заказал. Разные сочетания блюд могли дать такую сумму: возможно, все взяли бургеры средней ценовой категории, а может, один человек заказал стейк и лобстера, а остальные — суп. Модели нервных клеток работают по тому же принципу: разные сочетания параметров каналов могут приводить почти к одинаковой электрической активности. Если показать только одно удачное сочетание параметров, все остальные правдоподобные варианты останутся за кадром, хотя другие сочетания могли бы привести к иным прогнозам. Это справедливо почти для любого моделируемого явления. Наблюдаемые данные могут одинаково хорошо объяснять множество разных наборов параметров.
Решение — статистический метод, называемый байесовским выводом. Он позволяет получить все наборы чисел, которые достаточно хорошо работают, в виде вероятностного распределения, учитывающего соответствие данных и ваши исходные знания о параметрах. Распределение имеет форму кривой: лучшие соответствия находятся на пике, а худшие — по краям.
Однако этот метод обычно непрактичен для сложных моделей, поскольку требует рассчитывать вероятность получения измерений при каждом возможном наборе чисел. Для модели Ходжкина и Хаксли это всё ещё выполнимая задача, но для чего-либо более сложного она потребовала бы недостижимых вычислительных ресурсов. Например, если каждый из тысяч ионных каналов случайным образом открывается и закрывается, пришлось бы рассмотреть все сочетания. Возвращаясь к примеру со счётом в ресторане: ответить на вопрос «Сколько будет стоить ужин, если человек А заказал бургер, а человек Б — стейк?» легко, но гораздо сложнее выяснить, какие сочетания заказов могли привести к итоговой сумме, особенно если растёт число людей и блюд в меню.
Другой подход, называемый выводом на основе симуляций (SBI), решает эту задачу обратного проектирования с помощью больших вычислительных мощностей. Вы выбираете случайные параметры, запускаете модель и записываете результат. Так нужно делать снова и снова — возможно, 100 000 раз для модели вроде модели Ходжкина — Хаксли и миллионы раз для более крупных и сложных моделей. Затем на полученных результатах обучают нейронную сеть, которая по заданному результату сможет определить диапазон параметров, способных его породить.
Для SBI достаточно, чтобы модель можно было запускать: задавать ей параметры и получать данные, которые можно ожидать увидеть. Такая модель — на входе параметры, на выходе данные — называется симулятором, отсюда и название «вывод на основе симуляций». Вам никогда не нужно использовать формулу для расчёта вероятности получения тех или иных измерений — именно этот этап часто делает стандартный байесовский вывод непрактичным. Сегодня симулятор обычно представляет собой компьютерную программу, но это не обязательно: Хаксли, вручную прокручивавший уравнения, тоже запускал симулятор. Многие симуляторы легко запустить в прямом направлении, но невозможно развернуть в обратном. Некоторые нельзя даже записать в виде аккуратного уравнения: их допущения заложены в правилах, по которым они работают, —, но это всё равно модели. Для многих сложных явлений, от сетей нейронов до сталкивающихся галактик, симуляторы зачастую единственный доступный тип моделей. SBI позволяет ограничивать такие модели с помощью данных.
Проведение всех этих симуляций требует больших затрат и может занимать недели. Но после этого обученная сеть способна обрабатывать новые данные за секунды, без дополнительных симуляций. Такая скорость изменила границы возможного. Когда сталкиваются две нейтронные звезды, SBI может быстро определить примерное место столкновения на небе — достаточно быстро, чтобы направить туда телескопы, пока сигнал ещё можно обнаружить. Такой же подход успешно применяли для решения задач в космологии, структурной биологии, геофизике и многих других областях.
SBI применяли и к моделям нервных клеток, в том числе к модели Ходжкина — Хаксли. Поскольку метод возвращает распределение, а не одно-единственное соответствие, мы можем увидеть, какие параметры хорошо ограничены данными, где правдоподобны сразу несколько объяснений и в каких случаях особенно не хватает данных —, а значит, нужен новый эксперимент.
Счёт на уровень выше, или как строить модели
Прежде чем ограничивать модель, нужно её построить. Уравнения модели Ходжкина — Хаксли не были выведены из первых принципов. Напротив, четвёртая степень исходной переменной появилась эмпирически — благодаря биологической интуиции учёных и тому, что более простые варианты работали хуже.
Большую часть истории науки модели строили именно так. Учёные, опираясь на свой опыт и допущения, записывали модель-кандидат. Затем проверяли её, пересматривали и пробовали снова. Проблема в том, что пространство возможных моделей практически бесконечно, и учёный, который на основе опыта предлагает всего несколько вариантов, почти наверняка упустит модели, которые могли бы не хуже объяснить наблюдаемые данные.
Теперь системы ИИ могут помочь на этом этапе или даже взять его на себя. Получив данные и описание системы на естественном языке, агент на основе большой языковой модели (LLM) пишет код для одной или нескольких моделей-кандидатов. Затем он запускает модель, ограничивает её параметры, сравнивает результат с данными реального мира и вносит изменения, например меняя форму уравнения. Этот цикл повторяется, пока модель не начнёт достаточно точно воспроизводить данные. За последние два года появилось несколько таких систем.1 Детали различаются, но все системы используют LLM для разработки самой модели. До недавнего времени считалось, что на такое способны только люди.
Но то, что модель воспроизводит данные, ещё не означает, что она даёт новое понимание. Как и в случае со счётом в ресторане или параметрами Ходжкина — Хаксли, разные сочетания параметров внутри одной модели могут давать одинаковый результат. То же самое справедливо и уровнем выше — для самой модели: самые разные модели с уравнениями разной формы могут одинаково хорошо объяснять одни и те же данные. Если дважды запустить агента на одних и тех же данных, он может вернуть две разные, но одинаково хорошие модели. Агент, который выдаёт только одну из них, скрывает остальные — так же, как это происходит с единственным набором чисел, лучше всего соответствующим данным.
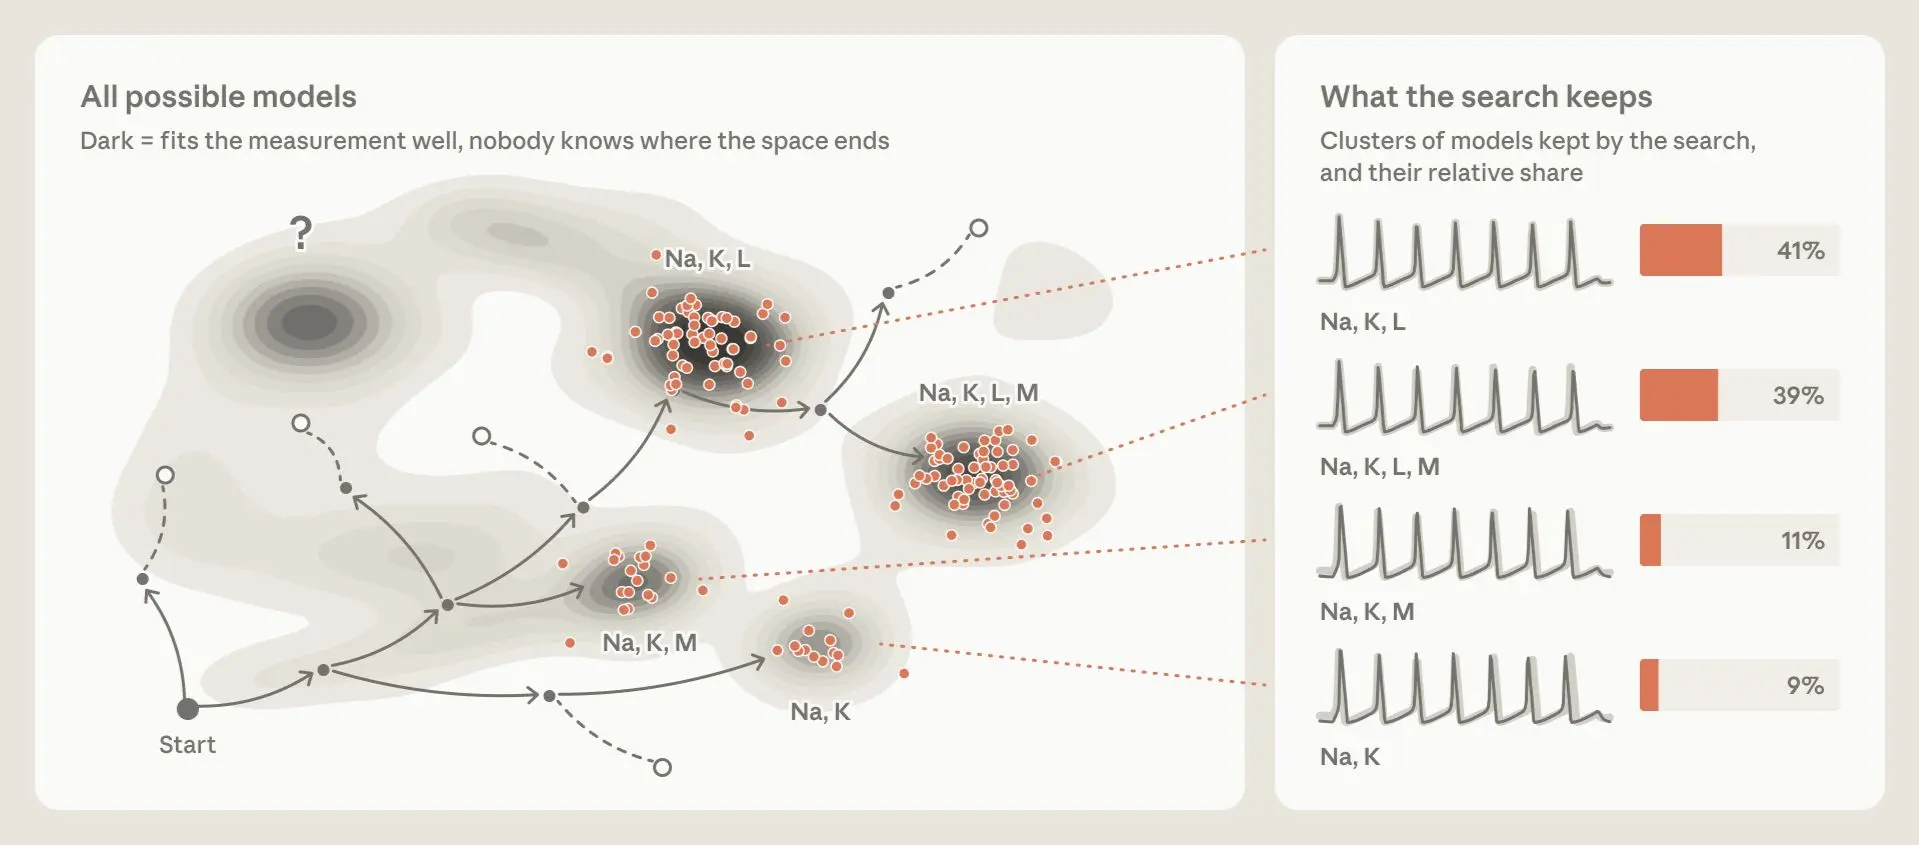
Поэтому строить модель лучше так же, как мы ограничиваем её: искать полный диапазон моделей, которые могут правдоподобно объяснить данные.2 Система ИИ предлагает множество вариантов. Затем каждому присваивается вес в зависимости от того, насколько хорошо он подтверждается данными; модели, которым для подгонки нужна большая гибкость, получают меньший вес, чем те, что хорошо соответствуют данным сами по себе. Слабые варианты отсеиваются, а система ИИ предлагает новые вариации более сильных моделей.
Таким образом, ИИ-агенты могут выдавать распределение правдоподобных моделей, а не одно-единственное наилучшее соответствие. Это распределение позволяет узнать то, чего не может показать одна модель. Если у всех сохранившихся моделей есть общая характеристика, вероятно, данные говорят в её пользу. Если модели расходятся во мнениях, это указывает на недостаток доказательств и подсказывает исследователям, в каком направлении проводить следующий эксперимент.
Не стоит забегать вперёд. Пока что эти системы в основном проверяли на повторном обнаружении моделей, уже известных учёным. Данных о том, как они справляются с задачами, на которые нет известного ответа, мало. И всё же новые LLM лучше справляются с исследовательскими задачами, чем старые, и мы ожидаем, что эти системы продолжат совершенствоваться.
Трудности перевода, или как интерпретировать модели
После построения и ограничения модель всё ещё нужно интерпретировать. Что она говорит о реальной изучаемой системе? Гипотеза Ходжкина и Хаксли о четырёх частицах возникла потому, что уравнения с четвёртой степенью соответствуют ситуации, когда перед открытием канала должны произойти четыре отдельных события. Поэтому учёные предположили, что именно это и происходит внутри мембраны. Как мы уже видели, во многом они оказались правы.
Эта интерпретация имела вес только потому, что учёные исключили другие варианты. Если бы более простая модель работала так же хорошо, не было бы оснований считать, что у канала несколько подвижных частей. Именно неудача альтернативных объяснений позволила им сделать такой вывод. Точное число оставалось неопределённым: Ходжкин и Хаксли отметили, что необходима третья или четвёртая степень, и остановились на четвёртой. Они писали, что ещё более высокие степени могли бы дать немного лучшее соответствие, однако «не считали возможное улучшение достаточным, чтобы оправдать дополнительное усложнение».
Уравнения позволили Ходжкину и Хаксли вывести и ряд других следствий. Например, они объяснили, почему у нервных клеток есть порог напряжения: ниже него импульс не возникает, а выше — возникает. Они также объяснили, почему нервные импульсы всегда имеют одинаковую форму. Кроме того, модель предсказала, что ток, нарастающий достаточно медленно, никогда не заставит клетку сработать. Философы науки называют теорию «постижимой», если она позволяет вывести свои следствия без необходимости запускать её. Такой критерий подходит для модели с небольшим числом переменных, как модель Ходжкина — Хаксли. Для более крупной модели, возможно, с тысячами переменных, аналогичным критерием может быть возможность свести её к нескольким ключевым механистическим идеям, достаточным для её построения. Чем крупнее модель, тем труднее это сделать.
Из трёх этапов именно интерпретацию сложнее всего поручить ИИ. Цель труднее определить: мы можем измерить, насколько хорошо модель соответствует данным, но не то, приводит ли она к лучшему пониманию системы. И непонятно, как объяснить системе ИИ, что её задача — «понимать». Согласно одному предложению, понимание системой ИИ можно оценивать по тому, насколько хорошо она предсказывает поведение системы после того, как на неё воздействовали. Другой подход — вовсе обойти этот вопрос и спросить, помогают ли результаты агента учёным лучше понять проблему. Один из примеров — система ИИ для проектирования квантовых экспериментов. Вместо того чтобы предложить одну экспериментальную схему, её обучили составлять короткую программу, которая создаёт схемы для целого семейства родственных экспериментов. Физик может сразу увидеть заложенный в программе принцип проектирования, а не пытаться восстановить его по одной экспериментальной схеме.
В обоих подходах для интерпретации крайне важно иметь полный набор подходящих моделей, а не одну, лучше всего соответствующую данным. Одна модель не может сказать, какие её части действительно ограничены данными, поэтому легко приписать смысл тем частям, которые на самом деле ими не определяются. Как мы уже видели на примере Ходжкина — Хаксли, гипотеза о четырёх частицах имеет смысл только в том случае, если знать, что меньшие степени работают хуже. Диапазон моделей также делает прогнозы надёжнее. Допустим, вы спрашиваете у своих моделей, что произойдёт, если воздействовать на систему, например заблокировать все или только некоторые натриевые каналы в мембране клетки. Если все модели, соответствующие данным, дают один и тот же ответ, как и следовало бы ожидать при блокировке всех каналов, ему можно вполне доверять. Если же они расходятся во мнениях, как это может произойти при блокировке лишь некоторых каналов, это подскажет идеи для следующего эксперимента.
Клетки и масштабы
Большинство известных моделей, в том числе модель Ходжкина — Хаксли, компактны. Они состоят из нескольких переменных и уравнений — настолько небольшого набора, что учёный может записать его и осмыслить. Это не случайность: модели должны были быть компактными, потому что людям приходилось их строить, ограничивать и интерпретировать. Компактность делала их и постижимыми. Но по мере того, как ИИ берёт на себя всё больше работы, ограничение на размер моделей начнёт ослабевать. Мы сможем моделировать системы, которые слишком сложны, чтобы описать их вручную, даже если уже не сможем понять их, просто прочитав уравнения.
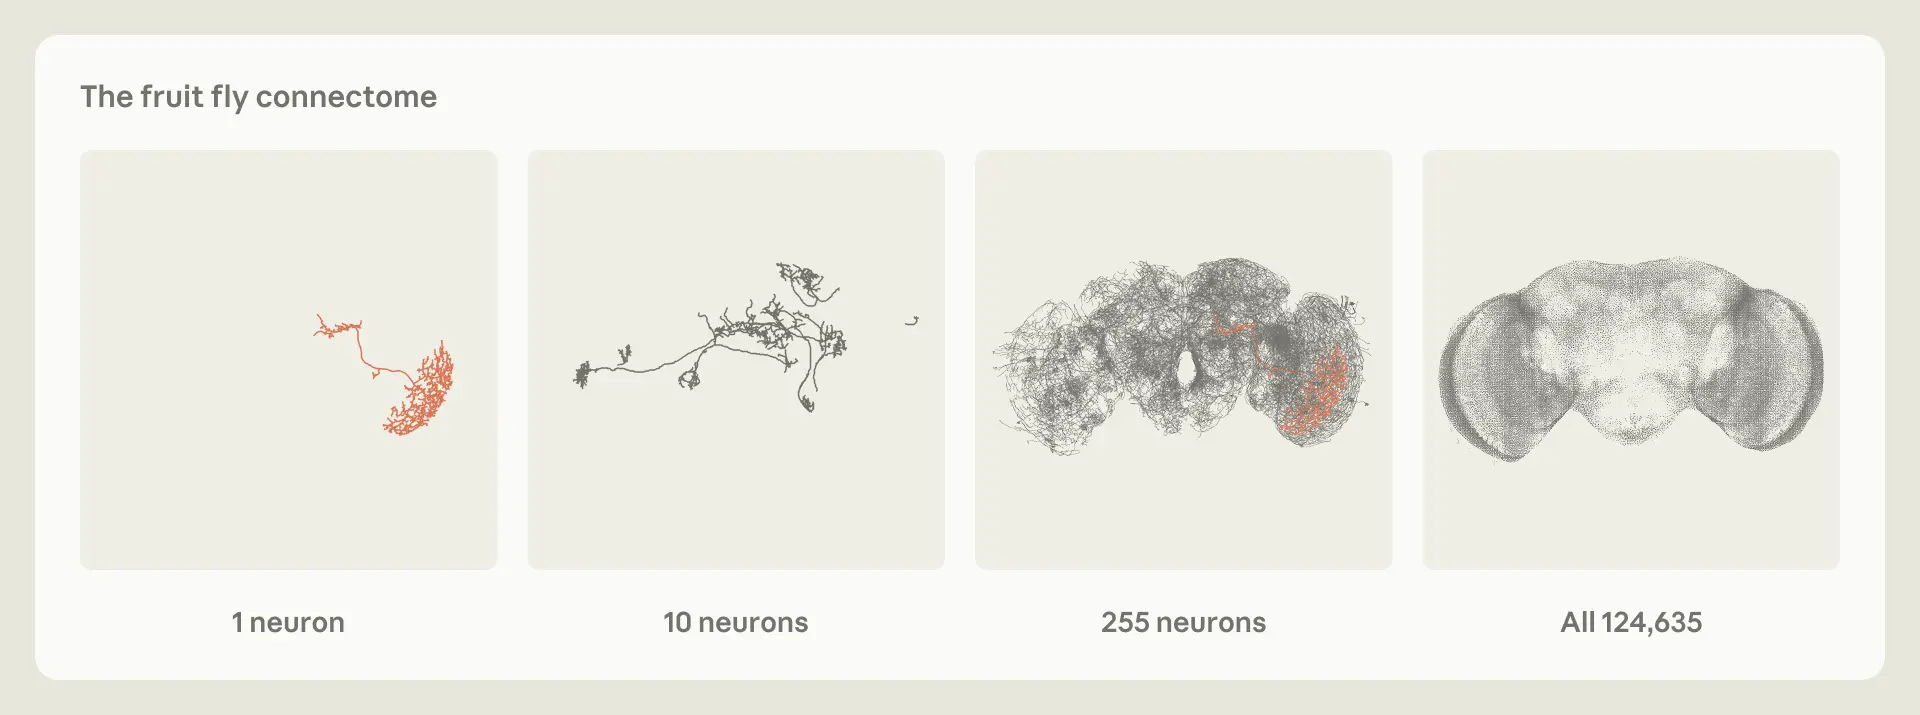
Очевидный пример — мозг. Уравнения Ходжкина — Хаксли описывают одну нервную клетку. Но в мозге плодовой мушки более 100 000 нейронов, а в человеческом — десятки миллиардов. Именно взаимодействие между этими нейронами порождает поведение и мышление. Теперь у нас есть то, что было недоступно предыдущим поколениям учёных: полная схема связей мозга плодовой мушки, на которой показаны все нейроны и их взаимосвязи.3 Исследователи уже начали создавать на её основе крупномасштабные модели, в том числе модель, предсказывающую активность нейронов во всей зрительной системе мушки. Это открывает вопросы, которые раньше было бессмысленно задавать. Как целый мозг превращает схему связей в поведение? Насколько поведение животного можно предсказать, зная только схему его нервных связей? И какие связи действительно важны?
Однако на таких масштабах найти единственную правильную модель будет невозможно. Более того, в большинстве случаев её просто не существует. Как писал статистик Джордж Бокс: «Все модели ошибочны, но некоторые полезны». Данные всегда будут согласовываться со множеством моделей. Вопрос будет уже не в том, какая модель правильная, а в том, какие свойства есть у всех моделей, совместимых с данными, и какие прогнозы из них следуют. Наиболее полезными окажутся эксперименты, позволяющие исключить как можно больше оставшихся моделей, даже если человеку-учёному они не всегда покажутся самыми интересными.
Это касается не только нейронауки. Климатологи уже работают именно так: создают множество огромных численных симуляций, каждая из которых основана на несколько отличающихся допущениях, а затем сообщают прогнозы в виде диапазона результатов всех моделей. Физики элементарных частиц на Большом адронном коллайдере придерживаются похожего подхода: в поисках новой частицы они не просто объявляют, подтвердилась ли конкретная теория, а составляют карту, показывающую, какие варианты теории исключены данными, а какие всё ещё возможны.
Кропотливая работа Ходжкина и Хаксли — построение модели, подгонка каждой кривой на глаз, проверка не подошедших степеней и, в случае Хаксли, три недели за механическим калькулятором с ручным приводом — не то, к чему мы хотели бы вернуться. Но эта работа не была напрасной. Значительная часть понимания, которое даёт модель, рождается в процессе её создания. Ходжкин и Хаксли понимали, что говорит им модель, потому что построили её сами и знали, какие варианты не сработали. Это понимание помогло им сформулировать интерпретацию переменных, отвечающих за работу каналов, — часть открытия, которое в конечном счёте принесло им Нобелевскую премию.
Сегодня система ИИ вполне могла бы выполнить большую часть той же работы за один день. Но чтобы дать понимание, ей нужно предоставить то, что дал медленный труд двух учёных: не только модель, соответствующую данным, но и объяснение того, какие её части подтверждаются данными, какие остаются неопределёнными, какие альтернативы были отвергнуты по пути и какие новые загадки удалось обнаружить. Научная модель может дать ответ, но понимание рождается в процессе её построения.
Сноски
01 См., например: Romera-Paredes и др., 2024; Shojaee и др., 2025; Ma и др., 2024; Novikov и др., 2025; Xia и др., 2026; и Ziaei Bideh и Gryak, 2026.
02 См.: Wahl и др., 2026; Mishra-Sharma, 2026; и Murphy, 2026.
03 См.: Dorkenwald и др., 2024; Schlegel и др., 2024; и Azevedo и др., 2024.
Авторы и благодарности
Jakob Macke, Daniel Gedon и Stefan Wahl
Благодарим Xander Balwit, Tom Chivers и Siddharth Mishra-Sharma за рецензирование и редакторские рекомендации.
Полный текст статьи читайте на Anthropic
