Neural MMO: Масштабная игровая среда для множества агентов

Мы выпускаем Neural MMO — многоагентную игровую среду для агентов, обучающихся с подкреплением. Наша платформа поддерживает большое и изменяющееся число агентов в рамках персистентной и открытой задачи. Включение множества агентов и видов приводит к лучшему исследованию, дивергентному формированию ниш и повышению общей эффективности.
В последние годы многоагентные среды стали эффективной платформойдляисследованийвобластиглубокого обучения с подкреплением. Несмотря на этот прогресс, перед многоагентным обучением с подкреплением по-прежнему стоят две основные задачи. Нам необходимо создавать открытые задачи с высоким пределом сложности: текущие среды либо сложны, но слишкомузки, либо открыты, но слишкомпросты. Такие свойства, как персистентность и крупномасштабные популяции, имеют ключевое значение, однако нам также нужны новые эталонные среды (бенчмарки) для количественной оценки прогресса обучения в условиях масштабных популяций и персистентности. Жанр массовых многопользовательских онлайн-игр (MMO) симулирует крупную экосистему с переменным числом игроков, соревнующихся в персистентных и обширных средах.
Чтобы решить эти задачи, мы создали Neural MMO в соответствии со следующими критериями:
- Персистентность: агенты обучаются одновременно в присутствии других обучающихся агентов без перезагрузки среды. Стратегии должны учитывать долгосрочные горизонты планирования и адаптироваться к потенциально быстрым изменениям в поведении других агентов.
- Масштаб: среда поддерживает большое и изменяющееся число сущностей. В наших экспериментах рассматривается до 100 млн жизненных циклов 128 одновременных агентов на каждом из 100 одновременных серверов.
- Эффективность: вычислительный порог входа невелик. Мы можем обучать эффективные стратегии на одном настольном процессоре.
- Расширяемость: подобно существующимMMO, наша Neural MMO спроектирована с расчетом на обновление новым контентом. Текущие базовые функции включают процедурную генерацию тайлового ландшафта, систему поиска пищи и воды, а также стратегическую боевую систему. В будущем появится возможность расширения силами открытого сообщества.
Среда
Игроки(агенты) могут присоединиться к любому доступному серверу(среде), каждый из которых содержит автоматически сгенерированную тайловую игровую карту настраиваемого размера. Некоторые тайлы, например лесные тайлы с едой и травяные тайлы, проходимы. Другие, такие как вода и сплошной камень — нет. Агенты появляются в случайных точках по краям среды. Для поддержания здоровья они должны добывать пищу и воду, а также избегать боевого урона от других агентов. Наступление на лесной тайл или тайл рядом с водой пополняет запасы еды или воды агента соответственно. Тем не менее, лесные тайлы имеют ограниченный запас пищи, который медленно восстанавливается со временем. Это означает, что агенты должны соревноваться за тайлы с едой, периодически пополняя запас воды из бесконечных водных тайлов. Игроки участвуют в боях, используя три боевых стиля: Melee (ближний бой), Range (дальний бой) и Mage (магия).
Входные данные: агенты видят квадратный участок тайлов с центром в их текущем положении. Сюда входят типы ландшафта тайлов и выбранные свойства (здоровье, еда, вода и положение) находящихся там агентов.
Выходные данные: агенты выдают выбор действий для следующего игрового такта(тиков). Действия состоят из одного перемещения и одной атаки.

Модель
В качестве простого бэйзлайна мы обучаем небольшую полносвязную архитектуру с использованием стандартных градиентов стратегии (vanilla policy gradients), причем единственными улучшениями выступают базовые функции ценности и дисконтирование наград. Вместо того чтобы вознаграждать агентов за достижение конкретных целей, агенты оптимизируют только свою продолжительность жизни(длину траектории): они получают награду 1 за каждый такт своей жизни. Мы преобразуем наблюдения переменной длины (например, список окружающих игроков) в вектор фиксированной длины, вычисляя максимум по всем игрокам (OpenAI Five также использовала этот трюк). Релиз исходного кода включает нашу полную реализацию распределенного обучения, которая основана на PyTorch и Ray.
Результаты оценки
Стратегии агентов выбираются равномерно из ряда популяций: агенты в разных популяциях используют общие архитектуры, но только агенты в рамках одной популяции разделяют веса. Первичные эксперименты показывают, что компетентность агентов растет по мере увеличения многоагентного взаимодействия. Увеличение максимального числа одновременных игроков усиливает исследование; увеличение числа популяций усиливает формирование ниш — то есть тенденцию популяций расселяться и искать пропитание в разных частях карты.
Турниры слияния серверов: многоагентность повышает компетентность
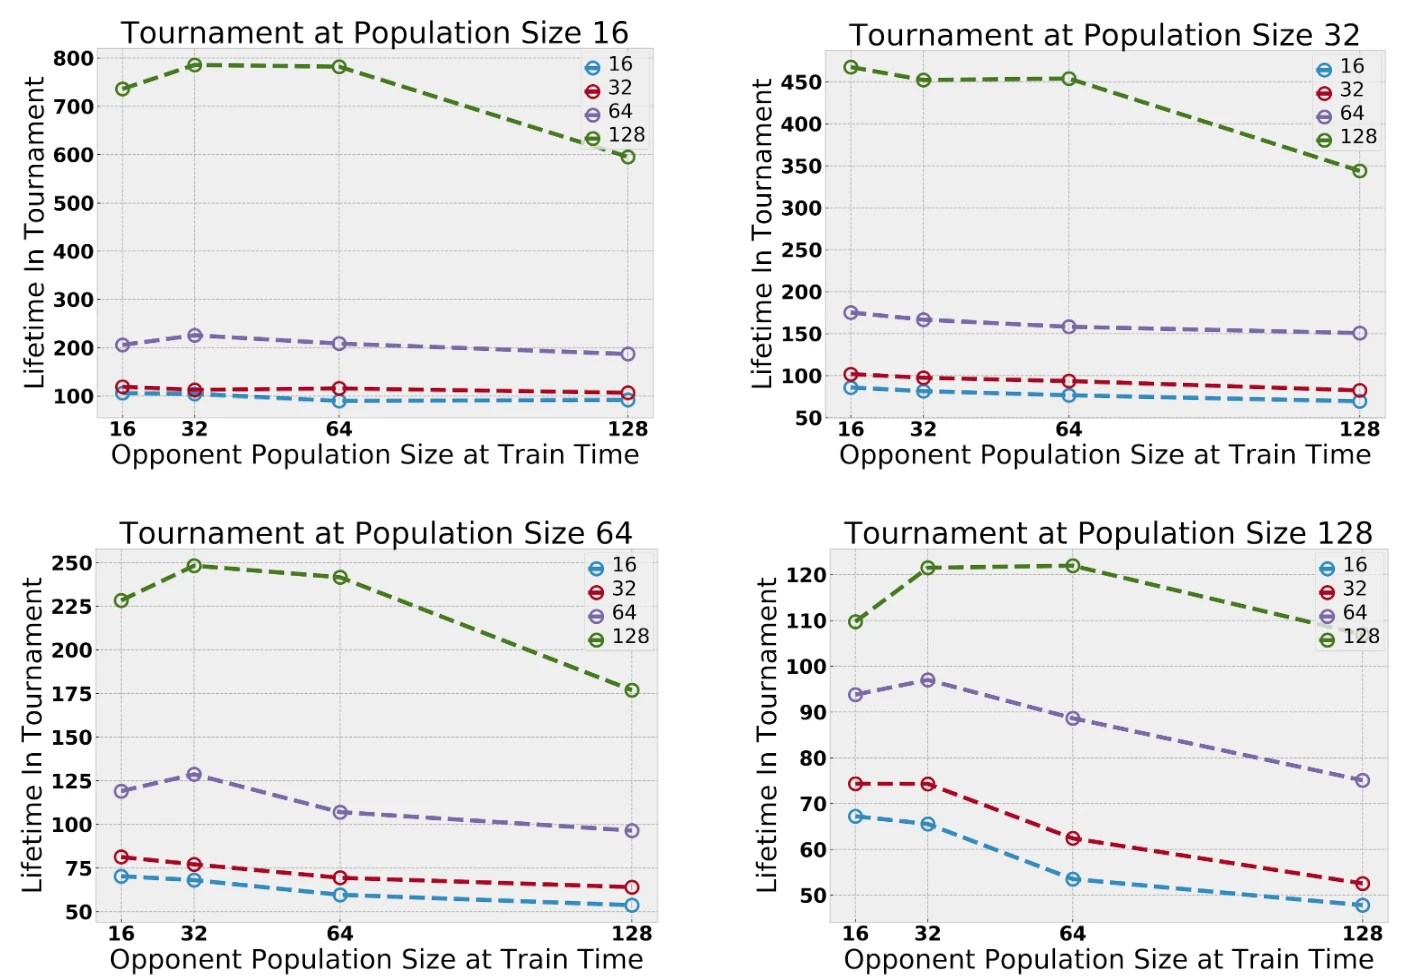
Среди MMO не существует стандартной процедуры оценки относительной компетентности игроков на разных серверах. Тем не менее, в MMO иногда проводятся слияния, при которых базы игроков с нескольких серверов объединяются на одном. Мы реализуем оценку в «турнирном» стиле, объединяя базы игроков, обученных на разных серверах. Это позволяет нам напрямую сравнивать стратегии, выученные в различных конфигурациях экспериментов. Варьируя масштаб тестового времени, мы обнаруживаем, что агенты, обученные в более крупных условиях, стабильно превосходят агентов, обученных в меньших условиях.
Увеличение размера популяции усиливает исследование
В дикой природе конкуренция между животными может стимулировать их расселяться во избежание конфликтов. Мы наблюдаем, что покрытие карты увеличивается по мере роста числа одновременных агентов. Агенты учатся исследовать карту исключительно потому, что присутствие других агентов создает естественный стимул для этого.
Увеличение числа видов усиливает формирование ниш

Учитывая достаточно большую и богатую ресурсами среду, мы обнаружили, что по мере роста популяций разные группы агентов разделялись по карте, чтобы не конкурировать друг с другом. Поскольку сущности не могут превзойти других агентов своей собственной популяции (т.е. агентов, с которыми они делят веса), они стремятся искать те области карты, которые содержат достаточно ресурсов для поддержания их популяции. Похожие эффекты также независимо наблюдались в параллельных многоагентных исследованиях DeepMind.
Дополнительные выводы

Мы визуализируем зависимости между агентами, фиксируя агента в центре гипотетического фрагмента карты. Для каждой позиции, видимой этим агентом, мы показываем, какой была бы функция ценности, если бы в этой позиции находился второй агент. Мы обнаруживаем, что агенты вырабатывают стратегии, зависимые от поведения других агентов, как в среде поиска пищи, так и в боевой среде. Агенты учатся картам избегания по типу «яблочка мишени», чтобы эффективнее начинать поиски пищи всего после нескольких минут обучения. По мере того как агенты осваивают боевую механику среды, они начинают должным образом оценивать эффективные дистанции боя и углы подхода.
Следующие шаги
Наша Neural MMO устраняет два ключевых ограничения предыдущих игровых сред, но многое еще остается нерешенным. Эта Neural MMO занимает золотую середину между сложностьюсреды и масштабомпопуляции. Мы разработали эту среду с расчетом на расширение с открытым исходным кодом и на то, чтобы исследовательское сообщество могло развивать ее дальше.
Если вы увлечены проведением исследований в области многоагентных систем, подумайте о том, чтобы присоединиться к OpenAI.
Авторы
Благодарности
Спасибо Клэр Чжу (Clare Zhu) за ее значительный вклад в разработку 3D-клиента.
Мы также благодарим следующих лиц за отзывы о черновиках этой публикации: Грега Брокмана (Greg Brockman), Илью Суцкевера, Джека Кларка (Jack Clark), Эшли Пилипишин (Ashley Pilipiszyn), Райана Лоу (Ryan Lowe), Джулиана Тогелиуса (Julian Togelius), Джоэла Либо (Joel Liebo), Синьжона Ресника (Cinjon Resnick).
Полный текст статьи читайте на OpenAI
