Модели принятия решений вроде Jev не объясняют свои ответы. Поэтому контекст — ваша забота
- Jev, Clef и Decisions API возвращают структурированные данные с вероятностями уверенности, снижая задержку и расход токенов.
- Модели не показывают цепочки решений и логи; разработчикам нужно заранее включать релевантную информацию в контекст.
- Среди подходящих сценариев названы сравнение ответов чат-ботов с эталонами и распределение обращений в поддержку.
Почему это важно: Без объяснений ответы моделей могут вводить в заблуждение, особенно при решении критически важных вопросов.
Модели принятия решений сейчас на пике популярности: в интернете активно обсуждают Jev (от TypeSafe AI), Clef от Cloudflare и Decisions API от OpenAI. Эти модели обеспечивают низкую задержку, поскольку пропускают многословную генерацию текста и возвращают структурированные данные в формате JSON вместе с вероятностями уверенности.
Разработчикам программного обеспечения очень нравится такая детерминированность, ведь она упрощает интеграцию структурированных данных в приложения. Задаёте вопрос — получаете фиксированный JSON, который можно извлечь с помощью библиотеки; никакого сложного парсинга текста или разбора формата.
Осознанный выбор
Под капотом каждая современная большая языковая модель (LLM) построена на одной и той же архитектуре трансформера «кодировщик — декодировщик». Промпты принимаются и кодируются в пространство меньшей размерности, а затем распаковываются, порождая по одному токену за раз, которые объединяются в выходной текст.
Модели с миллиардами параметров обучаются на триллионах строк текста, усваивая сложные языковые закономерности, чтобы генерируемый текст следовал шаблонам, имитирующим человеческое мышление и разговор. Многословный вывод часто содержит рассуждения, которые привели модель к выводу. Это настолько полезно, что появилась отдельная категория — модели рассуждений, которые специально формируют цепочку рассуждений в обоснование своих решений.
Но в случае с моделями принятия решений мы сознательно отказываемся от подробных цепочек рассуждений и сразу переходим к ответу. Такое мышление, так называемая «Система 1», очень полезно в определённых сценариях: ответ приходит быстрее, а экономия токенов значительна. Однако обычно в итоге мы накапливаем технический долг в своих системах. Тем самым мы фактически лишаемся ключевой возможности, которая делает LLM столь мощными.
Рассмотрим пример. Я задал разным типам моделей вопрос »Будет ли сегодня дождь?» через интерфейс OpenRouter. Традиционная LLM, прежде чем сделать прогноз, рассуждает, чтобы понять, что для этого необходимо и какие существуют ограничения.
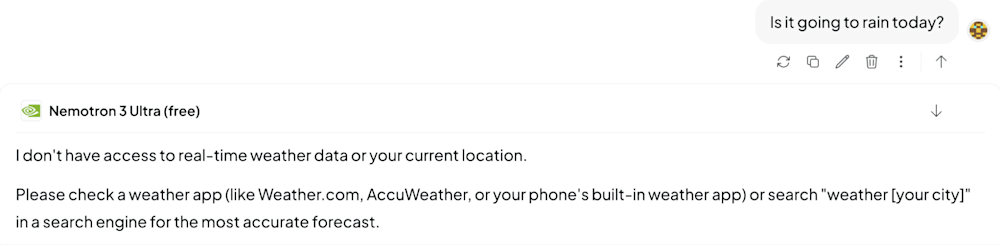
Предоставлено автором
Если же задать тот же вопрос модели принятия решений, например Jev, она вернёт ответ в виде структуры данных «noul» (названной в честь великого швейцарского математика и физика Даниила Бернулли).
Noul содержит единственное значение — true или false. Поэтому, ничего не объясняя, модель выдаст обобщённый ответ: true или false. Это может серьёзно вводить в заблуждение, особенно когда мы используем модели для ответов на критически важные вопросы.
Вот пример.
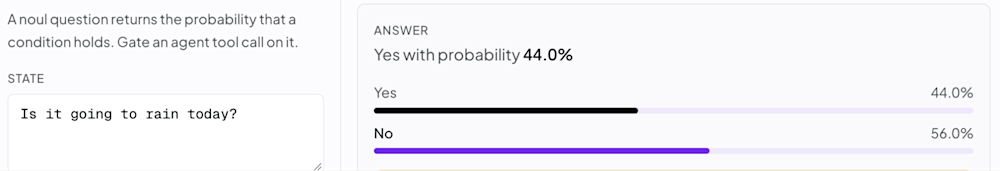
Предоставлено автором
Это не значит, что модели принятия решений бесполезны или ошибочны. Просто они не обладают объяснимостью, как традиционные LLM. Это перекладывает важнейшую ответственность на создателя ИИ-систем и разработчика: если модель не рассуждает за вас, вы должны заранее порассуждать за неё. Именно здесь проектирование контекста становится самым важным навыком, которым может овладеть создатель ИИ-систем.
При проектировании контекста ваша задача — упаковать всю релевантную информацию в контекст или состояние, чтобы модель могла принять обоснованное решение. С агентом на базе традиционной LLM можно задать расплывчатый вопрос, и модель, как правило, задаст уточняющие вопросы или подробно объяснит сделанные допущения.
У модели принятия решений такой возможности нет. Модель берёт любой предоставленный контекст, соотносит его с тем, чему обучена, и возвращает структурированный результат — часто единственное значение. Это значение и вероятность можно использовать, чтобы запрограммировать соответствующее действие в приложении. Однако никаких цепочек решений или логов нет, поэтому полной ясности в том, почему модель приняла то или иное решение, не будет.
Модели принятия решений особенно хороши в определённых сценариях — например, LLM-as-a-judge, когда ответы чат-бота сравниваются с заранее определёнными эталонными, «золотыми» ответами. Другая область — сортировка обращений в службу поддержки и их распределение по категориям. Обращения часто содержат пространный текст, который нужно понять, чтобы направить его в нужную категорию или команду.
Время покажет, какие ещё ключевые сценарии использования появятся. Но одно несомненно: модели принятия решений — крупный технологический шаг вперёд в богатой истории LLM.
Даттарадж Рао — архитектор по инновациям и НИОКР в Persistent Systems
Добро пожаловать в сообщество VentureBeat!
В рамках нашей программы гостевых публикаций технические эксперты делятся знаниями и предлагают нейтральный, независимый глубокий анализ ИИ, инфраструктуры данных, кибербезопасности и других передовых технологий, определяющих будущее корпоративного сектора.
Читайте другие материалы нашей программы гостевых публикаций — и ознакомьтесь с нашими правилами, если хотите предложить собственную статью!
Полный текст статьи читайте на VentureBeat.ru
