Модели ИИ, возможно, способны к самовоспроизведению без доступа к дата-центру
- Авторы запустили Gemma4-26B-A4B на 15 недорогих Android TV-приставках со скоростью 0,39 токена в секунду.
- Модель с 9 млрд параметров запустила инференс на 8 из 9 испытанных типов оборудования; модели до 30 млрд пока ошибаются при объединении этапов самовоспроизведения.
- По упрощённым оценкам авторов, GLM-5.2 и более мощные модели уже способны пройти полный цикл, а небольшие могут достичь этого уровня к концу года.
Почему это важно: Авторы предупреждают, что такой репликатор трудно остановить без единого централизованного узла, а для работы ему не нужны серверные GPU.
Уильям Чжоу, Дэниел Фриман
Наши эксперименты показывают, что небольшим моделям ИИ, возможно, осталось всего несколько месяцев до того, как они смогут самостоятельно размножаться на коммерческих IoT-устройствах — например, умных духовках и Android TV-приставках сторонних производителей. Такого репликатора будет сложно остановить, поскольку у него нет единого централизованного узла, который можно отключить, — хотя он может распространяться медленно (удваивая численность за несколько дней). В отличие от вредоносных программ без ИИ, он также сможет самостоятельно разбираться в незнакомых устройствах. В наших оценках модель с 9 млрд параметров смогла запустить инференс на 8 из 9 типов оборудования, которые мы тестировали.
Модели с 30 млрд параметров и меньше уже сегодня способны выполнять многие отдельные этапы самовоспроизведения, однако при объединении этих этапов в сквозной процесс допускают ошибки. В наших упрощённых оценках GLM-5.2 и более мощные модели способны к полному циклу самовоспроизведения. Если небольшие модели продолжат совершенствоваться прежними темпами, к концу этого года они достигнут такого уровня возможностей. Вскоре после этого могут появиться репликаторы на основе весов небольших моделей.
Введение
Постоянное совершенствование возможностей ИИ делает всё более реальной давнюю проблему — автономное самовоспроизведение и адаптацию (ARA), при которых модель развёртывает и распространяет себя без участия человека.
В киберпространстве червь — это программа, которая без участия человека копирует себя с одного компьютера на другой. Предыдущие исследования уже показали, что ИИ-агенты могут действовать подобным образом: сканировать свою сеть, выполнять эксплойт и копировать веса модели на целевую машину в кластере GPU. Такой «ИИ-червь» может переносить веса модели с собой при размножении (или повторно скачивать их из общедоступного хаба), а затем запускать инференс непосредственно на скомпрометированном оборудовании. По сути, веса станут частью полезной нагрузки вредоносной программы.
Серверные GPU в дата-центрах — очевидная и ценная цель для таких вредоносных программ. Но дорогие ускорители вовсе не обязательны. В этой публикации мы показываем, что распределённый ботнет из IoT-устройств — дешёвых и, как правило, плохо защищённых — тоже может обеспечить достаточно вычислительных ресурсов для запуска мощной модели.
Мы запустили Gemma4–26B-A4B со скоростью 0,39 токена в секунду, распределив её по 15 недорогим Android TV-приставкам сторонних производителей (примерно по 55 долларов за штуку), которые мы купили и объединили в сеть. На каждой плитке ниже показана физическая TV-приставка, на которой размещены два слоя модели во время её работы.
Разумеется, чтобы показать, что автономный червь может распространяться по сети слабых машин, необходимо пройти множество других этапов. Для этой публикации мы разделили цепочку самовоспроизведения на несколько шагов.
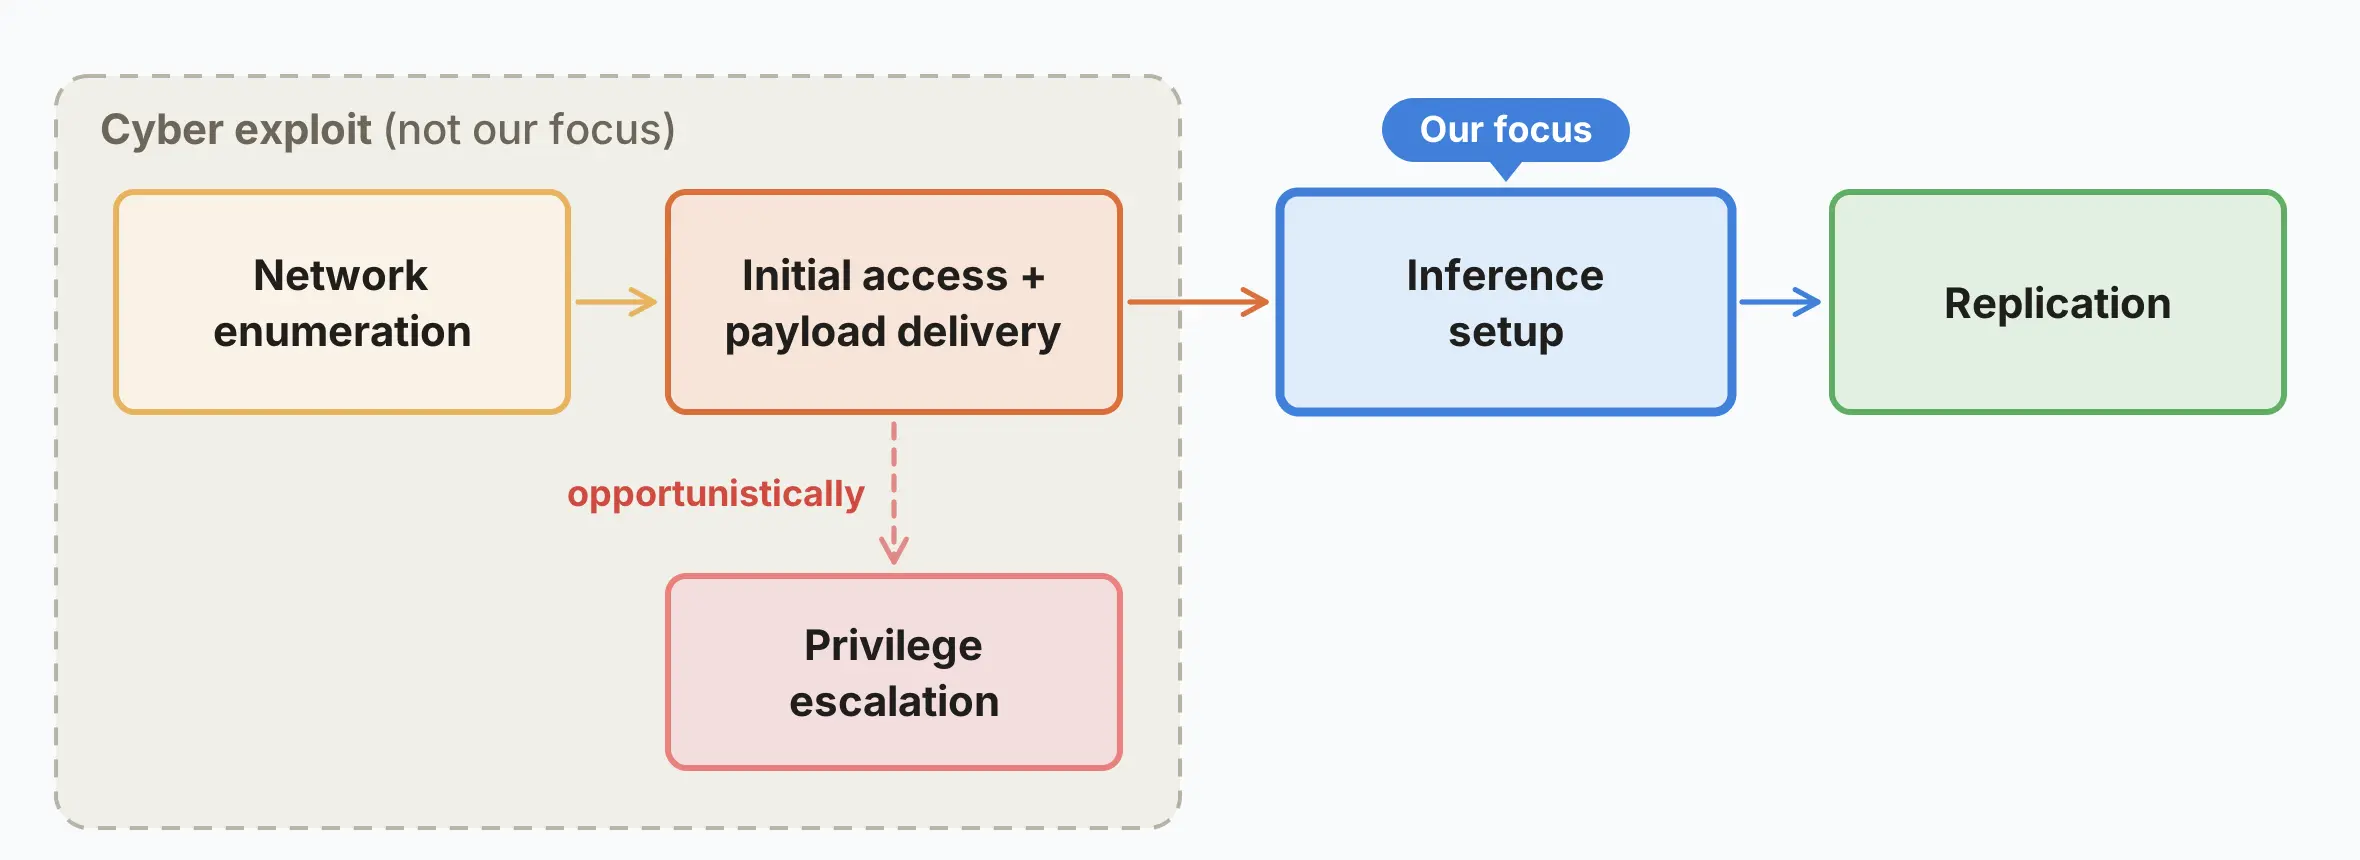 В этом исследовании мы разделили автономное самовоспроизведение на четыре практических этапа: поиск целей, получение возможности выполнять код, настройка инференса и продолжение распространения с нового узла.
Мы в основном оставляем без внимания этап кибервзлома в процессе самовоспроизведения (первые два шага выше), поскольку более ранние работы — CyberGym, ExploitBench и адаптивные черви — уже показали, что небольшие модели способны использовать киберэксплойты, особенно при наличии подходящих инструментов. Однако менее изученная часть процесса самовоспроизведения — настройка инференса на скомпрометированных устройствах. Именно на ней мы сосредоточимся в этой работе.
Сначала мы опишем модели угроз, которые, по нашему мнению, с наибольшей вероятностью станут реальностью. Затем проверим, могут ли небольшие модели настраивать инференс на незнакомом оборудовании и объединять весь цикл самовоспроизведения в один процесс, выполняемый на парке машин. После этого оценим, с какой скоростью такой червь мог бы распространяться, и проверим, способен ли он учиться и адаптироваться по мере размножения. В заключение мы расскажем, чем ИИ-черви отличаются от вредоносных программ, появившихся до ИИ, и кратко предложим способы защиты от подобных репликаторов.
Моделирование угроз
В этой публикации мы сосредоточимся на одном из возможных способов распространения ИИ-червей: небольших моделях, которые размножаются, захватывая устройства, на которых работают. Однако ИИ-черви могут использовать и другие методы: красть доступы, чтобы запускать хосты (например, ключи API или учётные данные платформ), либо оплачивать инференс за счёт легальной работы (например, выполняя задания на фрилансе). Вот модели угроз, которые, на наш взгляд, ближе всего к воплощению уже сегодня:
- Небольшая модель, размножающаяся за счёт захвата хостов. В этой публикации мы будем называть автономные черви, запускающие модели непосредственно на скомпрометированном оборудовании, репликаторами на основе весов. Первыми целями таких атак могут стать домашние IoT-устройства и устройства малого бизнеса: они подключены к интернету, а исторически меры их защиты были минимальными.
Модель, слишком большая для одного устройства, может быть разделена на части — шарды, которые запускаются на разных машинах и взаимодействуют друг с другом, совместно выполняя модель. Значительные шарды модели <30B могут запускать умные холодильники и духовки, роботы-пылесосы и газонокосилки. Всё больше домашних и рабочих устройств — например, камер видеонаблюдения и систем видеоконференцсвязи — поставляются со встроенными небольшими ИИ-чипами, предназначенными для запуска моделей непосредственно на устройстве. Благодаря дополнительным вычислительным мощностям они, вероятно, тоже станут привлекательными целями.
- Люди-хакеры часто проникают в защищённые системы с помощью социальной инженерии (например, убеждая IT-отдел компании, что они сотрудники, забывшие пароль), а не взлома. Для современных небольших моделей это соотношение, похоже, обратное: они сравнительно хорошо справляются с агентным программированием и взломом, но хуже — с социальной инженерией (см. приложение E). Однако по мере совершенствования моделей ситуация может измениться.
- Крупный продвинутый репликатор на основе весов, нацеленный на дата-центры и другие объекты с большими вычислительными мощностями. Более крупные модели, как правило, обладают и более высокими кибервозможностями, но им также потребуется проникнуть в относительно хорошо защищённые дата-центры, чтобы запустить себя. Мы разделяем эту модель угроз на две подкатегории:
- Передовые репликаторы: крупные репликаторы с закрытыми весами работают на инфраструктуре своей лаборатории и могут запускать внутренние развёртывания без мониторинга или похищать свои веса и переносить их на внешние вычислительные мощности.
- Репликаторы с открытыми весами: у таких репликаторов изначально относительно мало ресурсов (поскольку они не пользуются вычислительными мощностями лаборатории), но они с самого начала остаются без мониторинга.
- Репликатор на основе API, который размножается, похищая учётные данные для собственного API инференса. Для работы таких репликаторов поставщик модели должен обслуживать их запросы, сам того не зная. Кроме того, они могут оказаться менее устойчивыми, поскольку их, вероятно, проще обнаружить (хотя скорость распространения может быть выше, если, например, они смогут размножаться с помощью учётных записей жертв).
На практике ИИ-червь не обязательно будет состоять из одной модели или использовать одну стратегию. Более реалистичной атакой по сценарию «худшего случая» может стать целый рой разных моделей, развёрнутых на разных типах оборудования и использующих различные схемы самовоспроизведения.
В этой публикации мы рассматриваем возможность создания небольших репликаторов на основе весов (пункт 1 выше). Мы сосредоточились на этом варианте, поскольку он представляет собой угрозу, которая может реализоваться в ближайшее время и которую можно изучить напрямую. Наша демонстрация в начале публикации — модель с 26 млрд параметров, работающая на 15 приставках, — показывает, что IoT-устройства способны запускать на удивление мощные модели. Достаточно ли у них возможностей для автономного самовоспроизведения?
Мы изучаем этот вопрос в двух частях. Во-первых, могут ли небольшие модели запустить модель на незнакомом оборудовании? Во-вторых, могут ли они за один запуск выполнить весь цикл целиком: найти незаражённое устройство, скопировать себя на него, запуститься там и повторить процесс?
А. Настройка инференса
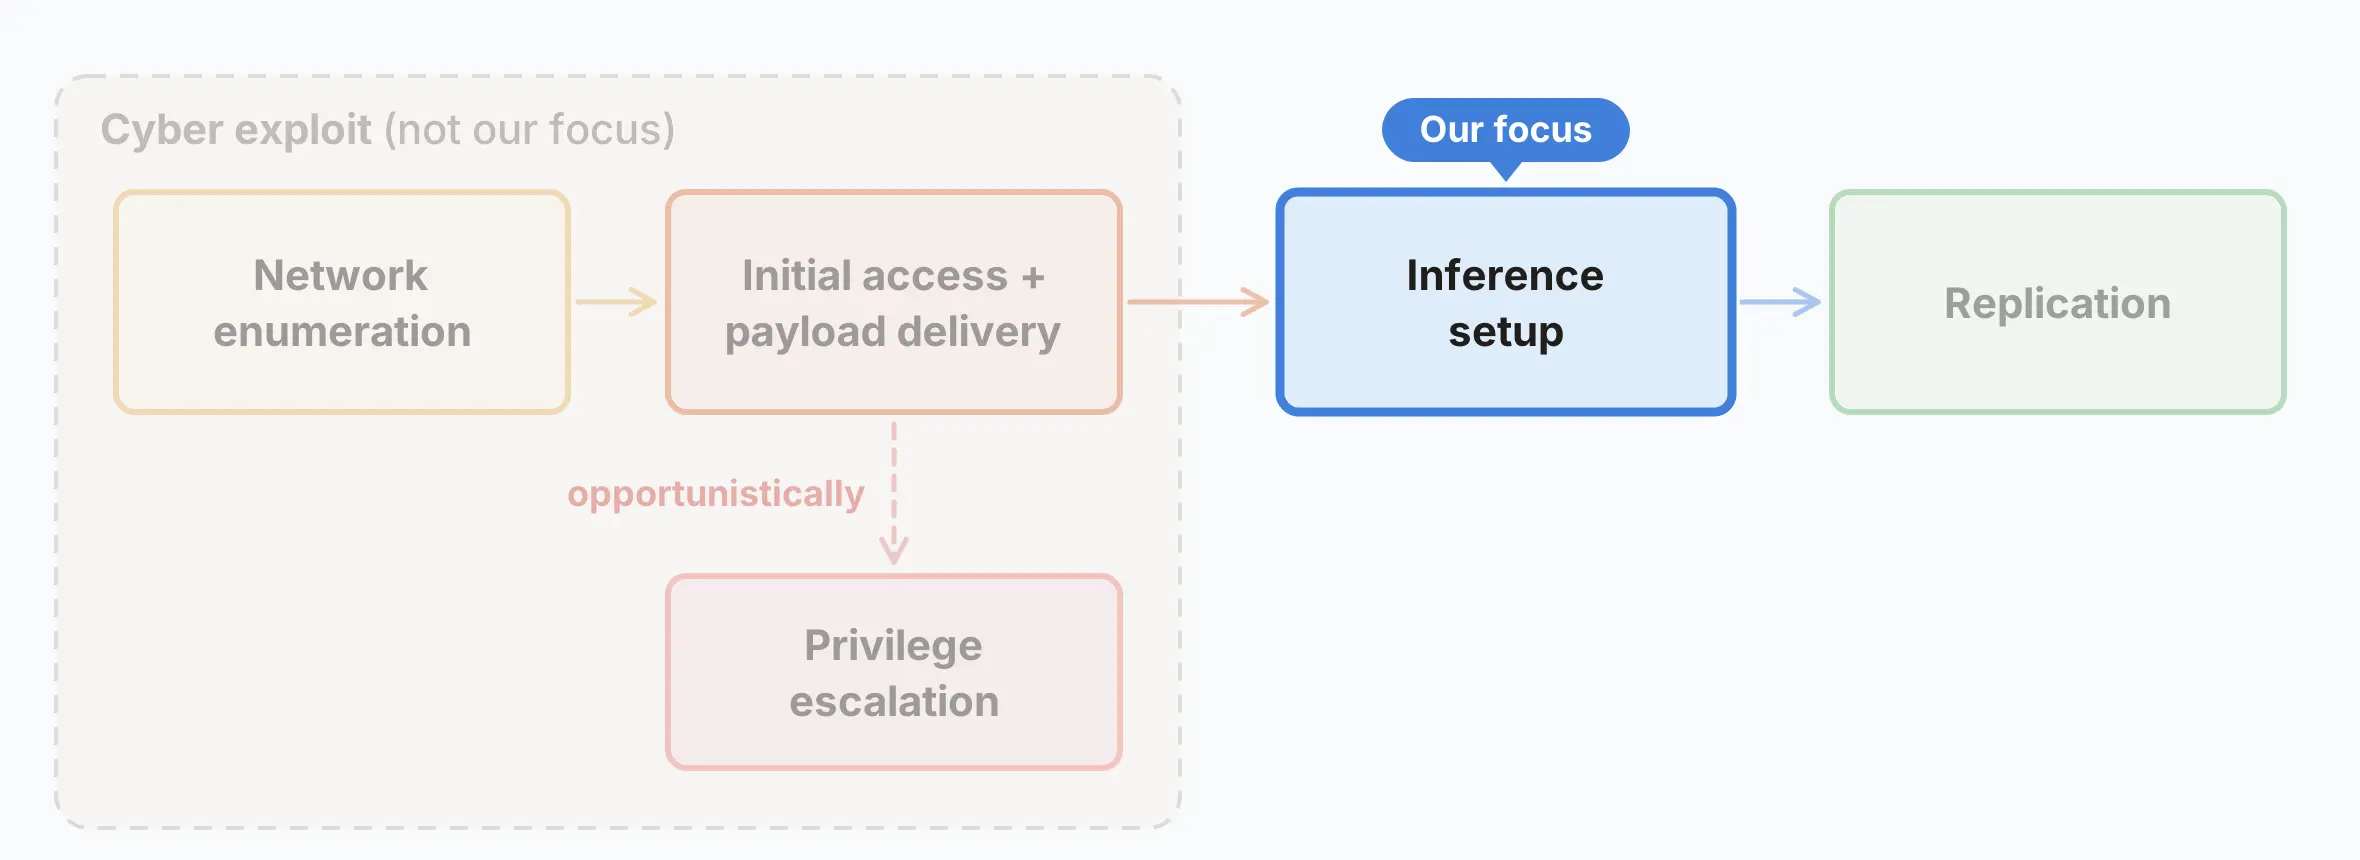
Среди этапов цикла самовоспроизведения, показанных на схеме выше, настройка инференса изучена меньше всего и может оказаться самой сложной для небольших моделей. Она требует целой последовательности решений, связанных с оборудованием и операционной системой: нужно выбрать совместимый стек инференса, найти подходящие версии пакетов и устранить неполадки, характерные для конкретной машины. Эти шаги зависят друг от друга, а после неудачи трудно восстановить процесс.
К слову
В отличие от многих других типов вредоносных программ, репликаторам на основе весов не нужны права суперпользователя. Повышение привилегий для сохранения работы после перезагрузки — например, с помощью заданий cron — было бы удобно, но не обязательно. Среды инференса могут работать целиком в пользовательском пространстве, а многие слабо защищённые устройства, на которых, как мы предполагаем, будет распространяться такой репликатор, можно заразить повторно после перезапуска. Аналогичные примеры — криптомайнеры и ботнеты или черви вроде P2Pinfect и Fritzfrog: они могут работать без повышения привилегий, но при возможности пытаются их получить.
Оценка эффективности настройки инференса
Мы оцениваем, насколько хорошо различные модели с открытыми весами могут запускать Llama3.1–8B на разнородном оборудовании. В таблице ниже показано количество токенов в секунду на разных типах оборудования:
- Нажмите на ячейку, чтобы увидеть распределение скоростей генерации.
- Нажмите на подпись строки или столбца, чтобы сравнить модели или типы оборудования.
Небольшие модели, такие как Qwen3.5–9B, способны настраивать серверы инференса на самых разных устройствах — от Jetson Nanos до компьютеров Mac и RTX 4090. Более мощные модели, например GLM-5.2, не только работают надёжнее, но и обеспечивают более высокую скорость генерации токенов, что позволяет быстрее размножаться. Мы тестируем и упоминаем конкретные чипы, чтобы оценить, насколько хорошо модели могут настраивать инференс на них. Сами чипы не представляют источник риска или уязвимости.
Для этих экспериментов мы используем Memento — созданный нами инструмент на базе агента для программирования с открытым исходным кодом Pi. Memento предназначен для смягчения распространённой проблемы, с которой мы сталкиваемся в длительных запусках: агент может зациклиться на ошибочной идее (например, о причине возникновения бага) и продолжать следовать ей вместо того, чтобы вернуться назад. Один из примеров такой ошибки — агент Qwen часами отлаживал версии пакетов, хотя настоящая проблема заключалась в том, что он реализовал конечную точку, несовместимую с API системы проверки.
Memento периодически запускает новый экземпляр агента с рабочим пространством предыдущего экземпляра и краткими заметками о том, что тот пробовал. Благодаря этому последующие экземпляры могут выбирать другие стратегии.
Как модель работает на Smart TV?
У IoT-устройств мало памяти, но распределённый инференс, как в проекте Petals, позволяет запускать наши компактные модели. Характерный пример угрозы — Kimwolf, крупный ботнет IoT-устройств, заразивший более двух миллионов устройств, преимущественно Android TV-приставки сторонних производителей. Такие Smart TV-приставки легко купить; обычно на них работают форки Android Open Source Project (AOSP), в которые производители не добавляют средства защиты. Обычно у таких приставок от 1 до 4 гигабайт оперативной памяти. Если предположить, что у устройства 4 ГБ ОЗУ, а квантование составляет 4 бита, то с помощью 4 или более машин можно запустить модель с 9 млрд параметров, а с помощью 10 и более — модель с 26 млрд параметров.
В демонстрации в начале публикации мы запустили Gemma4–26B-A4B на 15 Smart TV-приставках с 4 ГБ оперативной памяти каждая. Мы разделили модель на шарды, используя параллелизм по конвейеру: на каждой приставке размещена небольшая часть слоёв модели.
Б. Вирусное распространение: автономная настройка и самовоспроизведение в парке узлов GCP
Теперь, когда мы убедились, что модели могут настраивать инференс на незнакомом оборудовании, давайте проверим, способны ли они объединить отдельные шаги: сканировать сеть в поисках целей, получать к ним доступ через обратную оболочку, передавать вирусную полезную нагрузку (веса и среду запуска) и настраивать инференс.
Автономная настройка инференса и самовоспроизведение (с упрощённой кибератакой)
Для этого мы создали изолированную от внешней сети VPC с 8 узлами GCP под управлением redroid — эмулятора Android 15. «Нулевой пациент» (серый узел) изначально заражён червём. При каждом следующем заражении червь самостоятельно переходит с узла на узел через незащищённый порт ADB, а затем настраивает сервер инференса для запуска Llama3.1–8B. Если сервер проходит ряд проверок на корректность и отсутствие попыток обмана, мы запускаем ещё одну копию червя на целевом узле (например, если GLM-5.2 настраивает запуск Llama3.1 на машине, мы запускаем на ней копию червя GLM-5.2). Модель червя работает на отдельном сервере инференса, поскольку узлы VPC недостаточно мощные для запуска более крупных моделей.
На графике ниже мы используем указанную модель в качестве полезной нагрузки и измеряем её способность к самовоспроизведению.
Почему модели настраивают инференс для Llama3.1–8B, а не для себя?
Нам важно сравнивать модели на равных условиях, поскольку обслуживать инференс более крупных моделей сложнее. Наш эксперимент показывает, способны ли модели GLM автономно выполнять шаги, которые позволили бы достаточно небольшой модели размножаться, — то есть, если GLM-5.2 способна к размножению, значит, модель размером 8B с возможностями GLM-5.2 тоже смогла бы запустить себя (с оговоркой, что новые небольшие модели могут иметь более сложные архитектуры и ядра).
Среди протестированных нами моделей с открытыми весами только GLM-5.2 способна полностью пройти сквозной цикл самовоспроизведения (если предположить, что её возможности можно реализовать в Llama3.1–8B). Обратите внимание: GLM-5.2 делает это стабильно, тогда как остальные модели стабильно терпят неудачу (в 4 из 5 испытаний модель распространилась на 8 из 8 узлов, а в одном — на 7 из 8).
Похоже, GLM-5.2 способна эффективно распространять Llama3.1–8B. Это позволяет предположить, что будущие небольшие модели с такими же возможностями тоже смогут выполнять этапы перечисления узлов сети, доставки полезной нагрузки и настройки инференса в процессе самовоспроизведения. В нашей оценке этап кибервзлома упрощён до предела (порт ADB не требует аутентификации), поэтому она показывает верхнюю границу успеха в реальных условиях. Следует отметить, что прежние IoT-ботнеты распространялись настолько простыми способами, как перебор стандартных списков имён пользователей и паролей производителей, — так действовал, например, ботнет Mirai. Поэтому реальная защита IoT может оказаться ненамного сложнее, чем этот упрощённый этап нашей оценки.
Для проверки здравого смысла можно оценить сложность этапа автономности и оркестрации: насколько трудны оставшиеся рутинные операции в командной строке, если убрать кибервзлом и настройку инференса? В этом варианте оценки из предыдущего эксперимента исключены шаги настройки инференса (вместо них используется заранее написанный скрипт). Многие модели из нашего списка, включая самые небольшие, способны выполнить оставшиеся шаги.
Самовоспроизведение в изолированном парке из 17 узлов redroid: две группы по 8 узлов, соединённые одним промежуточным узлом (см. приложение F, где использовалась менее строгая формулировка запроса). Каждое дерево соответствует медианному результату модели в шести запусках.
Для этого червя можно представить:
- Нижний порог возможностей модели, выше которого автономный червь должен находиться, чтобы надёжно размножаться. В нашей упрощённой оценке GLM-5.2 превышает этот порог.
- Верхний предел размера модели: она должна быть меньше этого предела, чтобы её можно было запускать на устройствах, на которые она нападает. Для класса Smart TV, который мы тестируем (4 ГБ оперативной памяти), ниже этого предела находятся Qwen3.5–9B и Gemma4–26B-A4B.
На данный момент нижний и верхний пороги не пересекаются. Когда это может измениться?
На графике выше показаны известные модели с открытыми весами, содержащие не более 30 млрд параметров; для каждой модели указана дата выпуска и значение по индексу возможностей Epoch (ECI). Сплошная линия — аппроксимация методом наименьших квадратов для лучших моделей в каждом классе на соответствующую дату; прирост составляет 13,7 пункта ECI в год (R2 равен 0,95). Если считать GLM-5.2 нижним порогом возможностей для самовоспроизведения, то по линии тренда небольшая модель достигнет этого уровня к концу 2026 года. ECI — это общий индекс возможностей, лишь косвенно отражающий способность к самовоспроизведению, поэтому оценка срока появления репликатора на основе небольшой модели весьма приблизительна.
В. Как быстро может размножаться ИИ-червь для IoT?
В отличие от агентов для программирования, такие репликаторы будут работать медленнее, чем пользовательские чаты и инструменты для программирования. Их распространение будет медленным и устойчивым: токены будут постепенно генерироваться на периферийных устройствах. В качестве подтверждённой базовой скорости распространения можно использовать результаты, которых мы достигли на реальных Smart TV. Для Gemma4–26B-A4B неоптимизированная скорость на окне контекста в 32k токенов составляет около 0,3 токена в секунду в среднем для этапов предварительной обработки и декодирования в нашей рабочей нагрузке по настройке инференса. Подробнее см. приложение C.
Общее время можно оценить по тому, сколько часов занимает обработка окна контекста размером 32k токенов, после чего происходит его сжатие. Согласно статистике наших оценок настройки инференса, для выполнения одной траектории требуется от примерно 2,6 до 4,7 полных окон.
| модель | время обработки окна | полное время настройки инференса |
|---|---|---|
| Gemma4–26B-A4B (без оптимизации) | 27,3–31,8 ч | 71–150 ч |
| Qwen3.5–9B | 10,9 ч | 28–51 ч |
По данным Synthient, на пике ботнет Kimwolf заразил более 2 млн устройств, преимущественно Android TV-приставок. Если представить заражённый парк телевизоров такого же размера, на котором работают модели ИИ, и предположить, что на каждых 15 телевизорах запущена копия Gemma4–26B-A4B, получится около 133 тыс. копий («реплик»). Группа телевизоров, как в нашей демонстрации, может одновременно обслуживать запросы двух агентов со скоростью примерно 0,3 токена в секунду каждый, что даёт 80 тыс. токенов в секунду для всего ботнета.
Для сравнения: H100 может обслуживать Gemma4–26B-A4B со скоростью около 1,95 тыс. токенов в секунду при высокой параллельной нагрузке и спекулятивном декодировании. Следовательно, вычислительные мощности нашего роя не превышали бы эквивалент примерно 40 H100. В абсолютном выражении это очень мало, а агенты размножались бы медленно (на копирование модели с 9 млрд параметров уходило бы от 1 до 2 дней). Можно представить такого репликатора как слизевика или рой плодовых мушек, которые размножаются в течение нескольких дней.
Это приблизительная оценка, основанная на одном классе IoT-оборудования и одном примере существовавшего ботнета, но она описывает, как мог бы выглядеть простой репликатор, выпущенный в ближайшем будущем. На практике более мощные репликаторы использовали бы и другие типы слабо защищённых вычислительных устройств и по ситуации запускали бы модели разного размера на разных устройствах. (Им также не пришлось бы загружать модель на каждое устройство, которое они скомпрометировали.) Со временем объём используемых периферийных вычислительных мощностей, как мы ожидаем, будет расти, а минимальный размер модели, необходимый для надёжного самовоспроизведения, — снижаться.
Г. Адаптация и повышение возможностей
Обучение в процессе работы
Именно «адаптация» в концепции ARA — одна из причин, по которым ИИ-репликатор может превзойти традиционного червя. В частности, модели и запросы могут эволюционировать по Ламарку по мере распространения: родительские экземпляры смогут передавать свои запросы, код и заметки дочерним репликаторам. Чтобы адаптироваться и распространяться на самых разных типах оборудования, модели потребуются две способности:
- Превысить определённый порог возможностей, необходимый для распространения на незнакомое, ранее не встречавшееся оборудование (или программную среду, или тип сети).
- После знакомства адаптироваться к типу среды, в которую она попала (на уже знакомом оборудовании модель должна размножаться надёжнее).
В разделах A и B мы проверяем первое условие, а в следующем эксперименте — второе. Каждый экземпляр Qwen3.5–9B ведёт краткие заметки о применённых стратегиях и возникших проблемах. Затем новый экземпляр получает эти заметки и снова пытается настроить инференс.
Успешность настройки инференса в шести поколениях Qwen3.5–9B, каждое из которых наследует заметки предыдущего. Бледные линии соответствуют 20 отдельным линиям наследования, а жирная линия показывает долю запусков в каждом поколении, в которых настройка завершилась успешно. Показатель растёт с 45% в первом поколении до 61–84% в последующих. Используется конфигурация Memento (приложение A).
Использование накопленного опыта
Ещё один повод для беспокойства — небольшие модели могут обращаться за помощью к передовой модели-консультанту, более мощной модели, доступной либо в виде вызова инструмента, либо самостоятельно предлагающей советы, когда небольшая модель заходит в тупик. Чтобы проверить это, во время задачи по настройке инференса мы предоставили Qwen3.5–9B доступ к Opus 4.8. Советы передовой модели не дают измеримого эффекта: небольшие модели, как правило, не знают, какие вопросы нужно задавать, и не становятся лучше, когда получают советы без запроса.
Даже после обучения с подкреплением использовать консультанта в аналогичных условиях — при решении задач на Python — небольшая модель по-прежнему с трудом обращается за помощью с пользой для развертывания инференса. Оба результата показаны на графике ниже.
Доля успешных настроек инференса в зависимости от доступа к консультанту, с 95%-ными интервалами Уилсона. Доступ к консультанту — как через вызов инструмента, так и в виде автоматических советов модели, когда она заходит в тупик, — не даёт существенного улучшения. Две группы с обучением с подкреплением тренировались с доступом к консультанту на задачах по разработке ПО, а в самой правой группе также поощрялся вызов консультанта при возникновении затруднений.
Поскольку небольшие модели способны действовать самостоятельно и настойчиво, но плохо пользуются советами, мы считаем, что координация, скорее всего, будет устроена так: большая модель отвечает за стратегию высокого уровня и запускает небольшие модели в качестве субагентов.
E. Чем это отличается от ботнета до эпохи ИИ?
Жёстко запрограммированные ботнеты, такие как ботнет Kimwolf, нацелены каждый на определённый тип устройств — в случае Kimwolf это Android-телевизоры и мобильные устройства. ИИ-ботнет не привязан к какому-либо конкретному типу оборудования или программного обеспечения: небольшие модели способны настраивать движки инференса на устройствах от Jetson Nano до Mac (см. таблицу в разделе A). Мы ожидаем, что ИИ-ботнеты будут заражать не только устройства интернета вещей и использовать размножение на основе весов лишь как одну из стратегий в своём арсенале. ИИ-ботнеты также могли бы разумно противодействовать защитникам, но мы этого не проверяли.
F. Меры защиты
Как и в случае с эпидемией, задача защиты — снизить R₀ (число новых устройств, которые заражает каждое инфицированное устройство) ниже 1, чтобы механизм размножения исчез, а не стал эндемичным.
Некоторые особенности этой модели угроз играют на руку защитникам:
- Размножающийся на основе весов механизм, масштабно распространяющийся через устройства интернета вещей, оставит сетевой след, который будет заметен как аномалия в системах интернет-провайдеров для мониторинга потоков трафика. Заражённые устройства могут получать многогигабайтные файлы модели от других устройств или внешних хостингов, а распределённый инференс может создавать постоянный трафик между устройствами, которые обычно не обмениваются данными в таком объёме. Само распространение также приведёт к дополнительному сканированию и исходящим подключениям.
На практике механизм размножения выбирает компромисс между скоростью распространения и незаметностью: чем быстрее он распространяется, тем больше трафика создаёт. После обнаружения механизма защитники могут использовать ханипоты (устройства-приманки), чтобы собрать его оболочку и полезную нагрузку и изучить его поведение.
- Ликвидировать ботнет Mirai удалось, когда интернет-провайдер использовал полученные извне данные о заражениях, чтобы изолировать клиентов и уведомить их. Изоляция заражённых абонентов заключалась в ограничении их сетей доступом лишь к короткому списку разрешённых сайтов; в остальных случаях браузеры перенаправлялись на инструкции по очистке. За 14 дней это позволило устранить 92% заражений против 74% при отсутствии уведомлений. Мы ожидаем, что изоляция будет столь же эффективна как первоначальная мера защиты от механизма размножения на основе весов. Полностью устранить его было бы сложно: для этого пришлось бы скоординировать действия всех интернет-провайдеров, в чьих сетях есть заражённые устройства.
- Производители могут сократить число потенциальных целей, а регулирование поможет скоординировать эти усилия. Например, использование паролей по умолчанию на устройствах интернета вещей теперь запрещено на рынке Великобритании. Более безопасные настройки по умолчанию и повышение базовых требований соответствия помогут защититься как от ИИ-ботнетов, так и от ботнетов на скриптах.
G. Заключение: первые признаки жизни
Способности, которые делают ИИ-модели в целом мощными агентами для программирования, применимы и к киберзадачам, включая автономное размножение. Как и в случае с агентами для программирования в 2024 году, мы наблюдаем первые признаки жизни ИИ-червей. У нас пока нет полноценного самораспространяющегося механизма, действующего без контроля, но агенты всё лучше справляются с отдельными этапами цепочки размножения и передают свои адаптации будущим копиям.
В то же время всё больше вычислительных ресурсов для инференса становится доступно как внутри, так и за пределами дата-центров (см. приложение D). Пока неясно, какую именно форму примет автономное размножение ИИ. Это может быть медленная распределённая «цифровая слизевикоподобная сеть», обитающая на относительно незащищённых вычислительных устройствах. Это также может быть мощная кибермодель, быстро взламывающая дата-центры, или модель, выманивающая у людей кредиты на вычисления.
В качестве прогноза, выходящего за рамки наших экспериментов, мы ожидаем, что в будущем агенты будут повсюду работать на самых разных устройствах, в том числе на некоторых, не подконтрольных людям. Устройства интернета вещей давно уязвимы, но лёгкие агенты могут быть гораздо охотнее людей-злоумышленников тратить усилия на взлом значительной доли вычислительных ресурсов интернета вещей по всему миру. Появление медленных механизмов размножения также станет предвестником более агрессивных и быстрых механизмов, способных взламывать лучше защищённые устройства или эффективно красть ключи API. Нам следует укреплять системы, чтобы затруднить распространение таких механизмов, но также готовиться к миру, в котором они останутся с нами надолго.
Приложение
A. Оболочка Memento
Memento работает следующим образом:
- Мы запускаем экземпляр агента, который некоторое время решает задачу — до истечения времени генерации.
- Экземпляр ведёт краткие заметки, а по истечении времени составляет небольшой документ с описанием испробованных стратегий, возникших затруднений и результатов своей работы (если задача решена).
- Мы создаём новый экземпляр агента, который наследует кодовую базу и среду предшественника, а также его блокнот.
В эксперименте с запуском моделей каждая из них помещается в оболочку Memento с ограничением в 1,5 часа на итерацию и 6 часов на весь процесс. В промпте содержится около 1 тыс. токенов информации, включая спецификации оборудования и скрипт простого профилировщика выборки.
Memento предназначена для повышения надёжности при длительной работе, а не для предоставления новых возможностей в области кибербезопасности или инференса. Кроме того, это не универсально эффективная оболочка; мы ожидаем, что по мере развития возможностей небольшие модели будут лучше справляться с ролью механизмов размножения и без какой-либо оболочки.
Одна попытка в сравнении с Memento, по моделям (95%-ный доверительный интервал Уилсона).
B. Почему параллелизм по конвейеру?
Распространённые схемы распараллеливания инференса включают тензорный параллелизм (TP), параллелизм экспертов (EP) и параллелизм данных. В большинстве «умных» телевизоров и устройств интернета вещей используются процессоры ARM Cortex и память DDR3/4; на таких устройствах почти всегда узким местом становится пропускная способность памяти.
Мы используем параллелизм по конвейеру из-за его отказоустойчивости. Как отмечается в работе (Borzunov и соавторы, 2022), отказ одного узла при тензорном параллелизме или параллелизме экспертов выводит из строя весь набор машин, на которых работает реплика модели. При конвейерном параллелизме вышедший из строя узел можно заменить; KV-кэш слоёв, размещённых на этом узле, можно пересчитать повторным прямым проходом узла до перезапуска.
C. Пропускная способность и память устройств интернета вещей
На таких устройствах почти всегда узким местом становится пропускная способность ОЗУ на каждом отдельном устройстве — как при предварительной обработке, так и при декодировании. Даже на сравнительно слабых ядрах ARM Cortex вычислительная пропускная способность выше пропускной способности ОЗУ. При декодировании на каждом устройстве возникает значительное время простоя из-за пузырьков конвейера: во время каждого прямого прохода активно только одно устройство. Возможна одновременная обработка задач с разнесённым по времени выполнением, но жёсткие ограничения памяти не позволяют поддерживать высокий уровень параллелизма.
Объём памяти на одном устройстве в зависимости от контекста — 4-битные веса + KV-кэш fp8 + активации.
Число токенов в секунду при предварительной обработке и декодировании строго уменьшается с увеличением длины последовательности. Ниже показан график скорости инференса в зависимости от длины контекста:
Кроме того, существует минимальная длина последовательности, необходимая для эффективной работы моделей. Используемая нами оболочка создана на основе агента для программирования Pi (pi.dev) и включает встроенный механизм сжатия контекста. И всё же мы обнаружили, что производительность моделей значительно падает, если ограничить длину последовательности значением менее 32 тыс.
Агентные способности Qwen3.5–9B при выполнении задачи настройки инференса в зависимости от доступного бюджета контекстного окна.
На основании приведённой выше оценки мы предполагаем, что контекст длиной 32 тыс. токенов может быть достаточным для приемлемой агентной производительности. В нашей задаче настройки инференса стандартное контекстное окно длиной 32 тыс. токенов состоит на 12–15% из сгенерированных токенов декодирования, а остальное приходится на предварительную обработку промптов и вызовов инструментов. Из-за пузырьков конвейера предварительная обработка токенов выполняется примерно в 15 раз быстрее. Сложив время обработки каждого токена на протяжении всего контекста длиной 32 тыс. токенов и учитывая скорости предварительной обработки и декодирования, мы получаем, что генерация 3,8–4,8 тыс. выходных токенов декодирования и обработка примерно 28 тыс. токенов предварительной обработки занимают от 27,3 до 31,8 часа для Gemma4–26B-A4B и 10,9 часа для Qwen3.5–9B.
Число выходных токенов на цепочку (сумма по генерациям в цепочке), по моделям; медианные значения ≈ 19,7 тыс. / 12,3 тыс. / 11,0 тыс. Данные получены в ходе оценки настройки инференса.
D. Периферийные ускорители
Мы можем получить более точную верхнюю оценку, рассмотрев парк Nvidia Jetson — периферийных ускорителей. В отличие от традиционного ботнета устройств интернета вещей, периферийные устройства интернета вещей могут запускать модель целиком. Jetson AGX Orin с 64 ГБ памяти запускает Qwen3–30B-A3B со скоростью 76,7 токена в секунду, а AGX Thor достигает 226 токенов/с. Мы не считаем эти устройства необычайно уязвимыми — здесь речь лишь об оценке верхней границы. Среди типов устройств, в которых используются Jetson, есть:
- Умные камеры безопасности с поддержкой ИИ и встроенными ускорителями, развёрнутые в значительных масштабах.
- Системы для видеоконференций, часто оснащённые встроенным ускорителем для шумоподавления или расшифровки речи прямо на устройстве.
- Транспортные средства, четвероногие и двуногие роботы, а также дроны. Мы ожидаем, что для транспортных средств кибербезопасность станет приоритетом, поэтому большинство потенциальных целей, вероятно, приходится на две другие категории.
Быстрый поиск в FOFA показал, что по IPv4 доступен как минимум один узел умной камеры, оснащённой ускорителем:
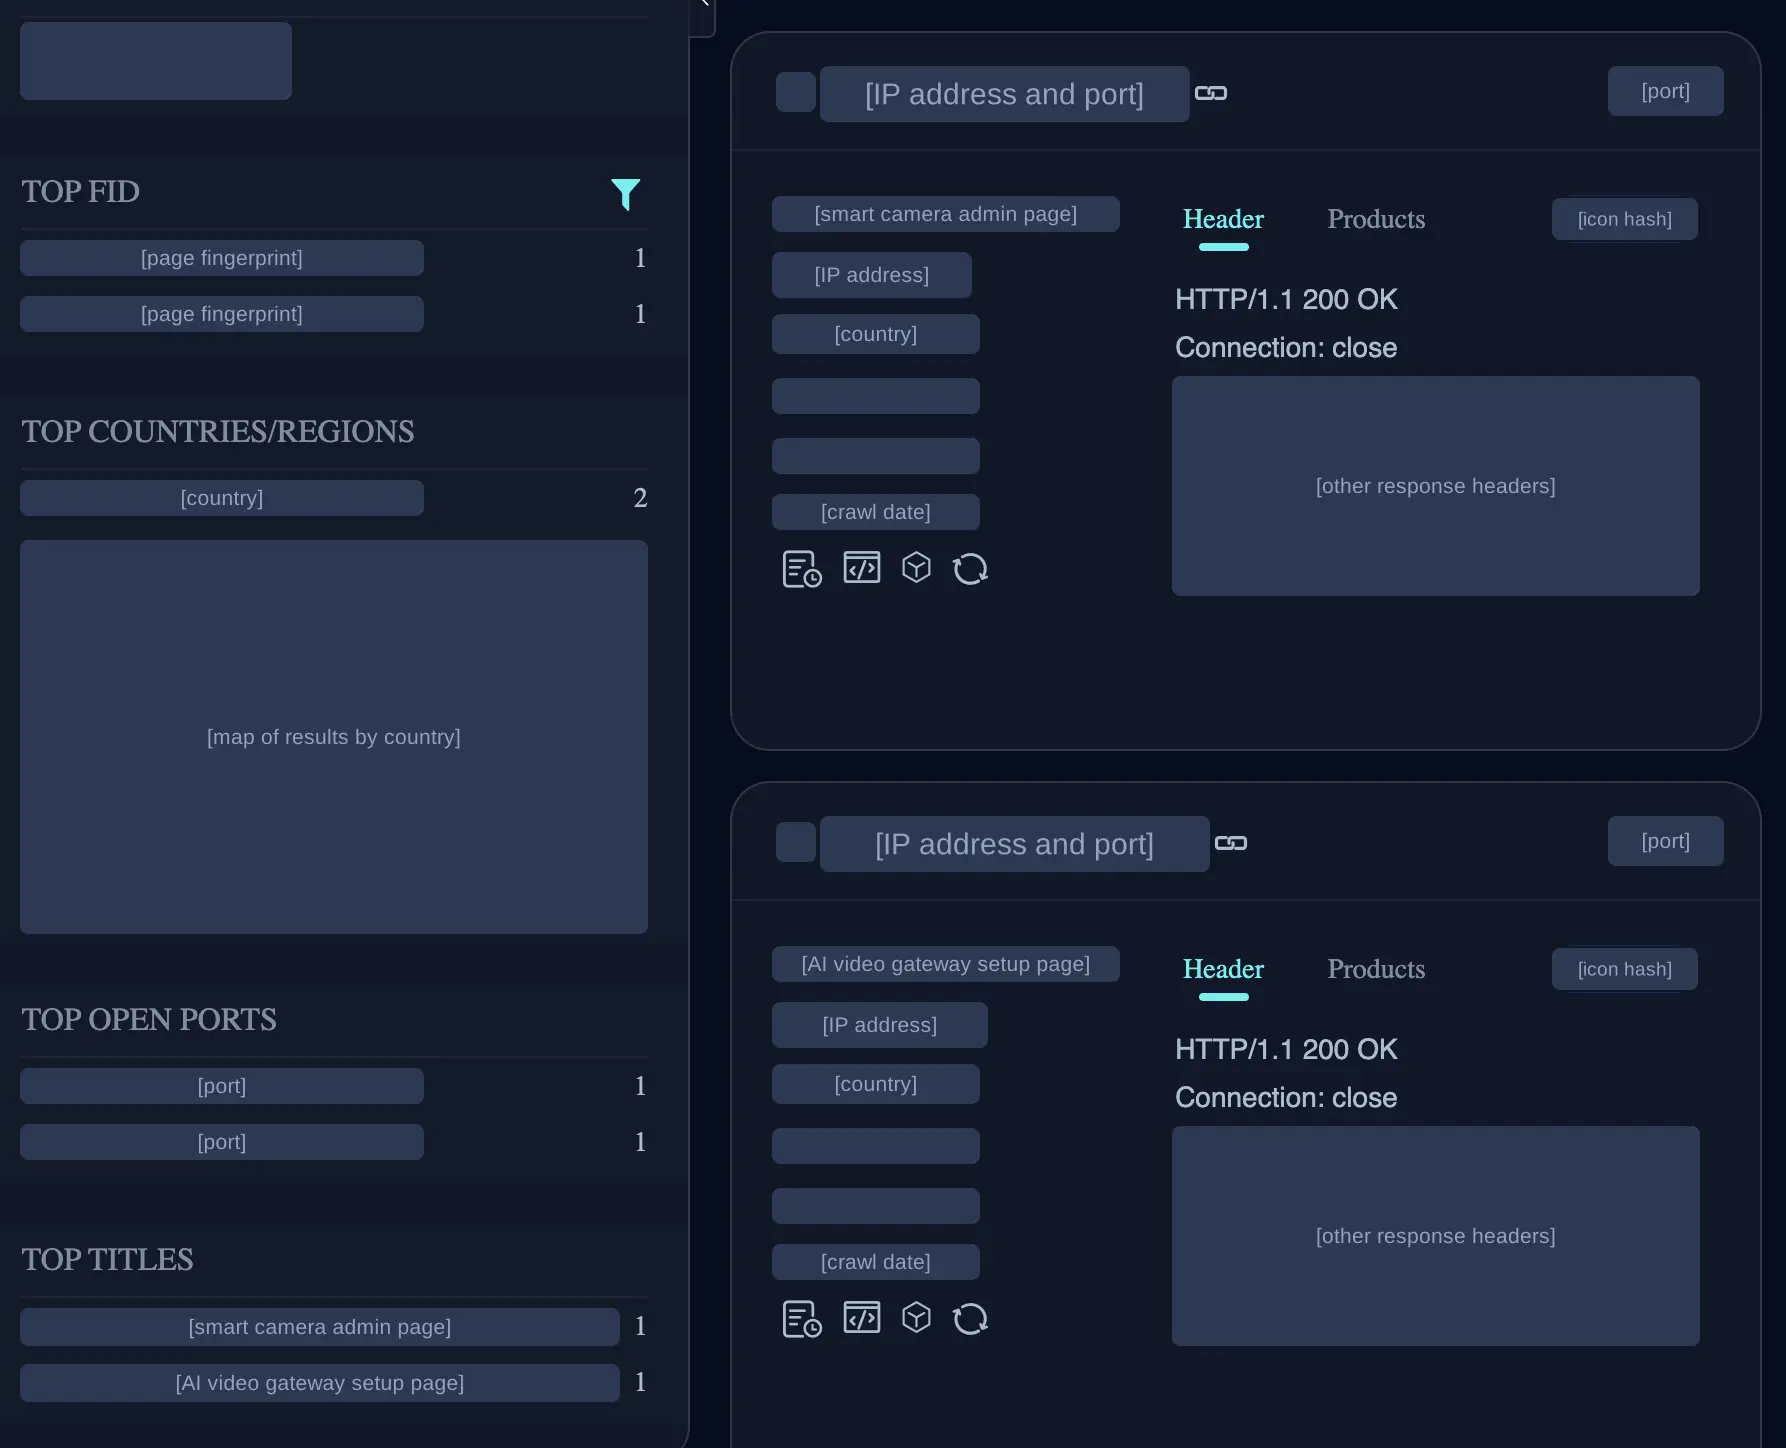 Поиск в FOFA обнаруживает узел с известным периферийным ускорителем: он доступен и отвечает кодом HTTP 200 по IPv4. Однако доступность сама по себе не означает, что устройство обязательно уязвимо для эксплуатации.
Хотя сложно оценить, сколько периферийных устройств с ускорителями доступны из интернета и уязвимы, мы можем рассчитать строгую верхнюю границу общего числа таких устройств. В мире насчитывается около 90 отдельных линеек устройств интернета вещей на кремниевых компонентах NVIDIA и примерно 9,5 млн устройств, находящихся в эксплуатации. Доступ к ним обеспечивается преимущественно через исходящие туннели управления облачными сервисами, а не входящие порты, поэтому большинство устройств недоступны через веб. В отличие от обычных ботнетов устройств интернета вещей, в прошлом не было случаев массового взлома периферийных устройств с ускорителями, что указывает на большую сложность их компрометации.
Число устройств в эксплуатации для каждого семейства, окрашенных в зависимости от доступности из интернета.
Очень приблизительная оценка на основе данных о продуктах показывает, что периферийные ускорители располагают вычислительными ресурсами, эквивалентными 9 000–35 000 H100, однако доступный извне объём, вероятно, как минимум на порядок меньше, а число уязвимых устройств — ещё ниже.
Отступление
Помимо этих периферийных ускорителей, мы также рассматриваем сегменты интернета вещей для малого бизнеса и промышленности, например сетевые хранилища NAS, мини-ПК и системы на кристалле Rockchip (как в Orange Pi). Известно, что сетевые хранилища для малого бизнеса уязвимы для программ-вымогателей и криптоджекинга (Агентство по кибербезопасности и защите инфраструктуры США и Национальный центр кибербезопасности Великобритании, 2020); в каждом из них установлено 512 МБ–2 ГБ распаянной оперативной памяти, что относит их к той же категории, что и умные телевизоры. Мини-ПК, как правило, защищены значительно лучше, а устройства вроде Orange Pi достаточно производительны (см. нашу таблицу настройки инференса), но их тоже сложно взломать.
E. Возможности целевого фишинга
Мы также оценили, насколько хорошо современные небольшие модели справляются с целевым фишингом. Целевой фишинг — это рассылка адресных сообщений конкретным людям с целью обманом заставить их раскрыть учётные данные или запустить вредоносную программу. Агентные способности небольших моделей в области кибербезопасности стремительно выросли, но их общие знания и языковая изощрённость совершенствуются медленнее. Мы ожидаем, что атаки с применением социальной инженерии и фишинга будут в основном проводить большие передовые модели (хотя вполне вероятно, что это станет дополнительным способом распространения в разнородном ботнете, где работают и большие, и небольшие модели).
Способность к целевому фишингу по результатам теста на целевой фишинг из набора CyberSecEval 3 компании Meta (Wan и соавторы, 2024), воспроизведённого локально. Оценка по шкале от 0 до 5, судья — gpt-4o. Красные ромбы обозначают оценки эталонных моделей по человеческой шкале из статьи (CyberSecEval 3), показывая, что gpt-4o выставляет оценки примерно на 0,4–0,7 пункта выше, чем люди. Оценка 2 означает «плохо», 3 — «средне», а 4 — «хорошо». После приведения к человеческим оценкам небольшие модели получают результаты от «очень плохо» до «плохо».
В качестве эталонной модели на 405B используется Hermes-3–405B — модель с минимальным числом отказов, заменяющая недоступную Llama3.1–405B-Instruct.
F. Распространение с помощью скриптовой настройки инференса:
Мы провели ещё несколько экспериментов на сети из 17 узлов со следующей топологией:
Две сети по 8 узлов, соединённые одним узлом с доступом к обеим подсетям. Внутри каждой сети все узлы связаны друг с другом. Агент-червь начинает работу на единственном начально заражённом узле в сегменте A; наличие промежуточного узла немного усложняет задачу: червю нужно получить к нему доступ и повторно провести сканирование уже с него.
На каждом устройстве работает Android, а порт ADB открыт без аутентификации. После перехода на новую цель агент может сразу вызвать прямую функцию для самостоятельного размножения — это сделано лишь для того, чтобы оценить сложность оставшихся этапов после исключения задач по кибербезопасности и настройке инференса. Как видно на графике, даже модель с 3B параметрами достигает примерно половины узлов. Это позволяет оценить число препятствий в нашей проверке, которые мы не учитываем при оценке этапов кибербезопасности и настройки инференса.
Более подробная разбивка запусков в эксперименте «размножение в сети из 17 узлов». В каждом столбце указано медианное число достигнутых узлов при разном объёме подсказок в промпте; нижний индекс обозначает, сколько агентов пересекли промежуточный узел и перешли на другую сторону сети.
Подпишитесь на рассылку Frontier Red Team
Получайте новости о наших последних исследованиях и выводах в области red teaming.
Полный текст статьи читайте на Anthropic
Об этом также пишут
- TheNextWeb.ru В Anthropic считают, что небольшие модели ИИ вскоре смогут копировать себя на умные устройства 13.10.2026 09:55
- 3DNews Anthropic предупредила о нашествии ИИ-червей — они смогут автономно размножаться и заражать телевизоры, бытовую технику и серверы 13.10.2026 12:38
- iXBT Восстание машин начнется с робота-пылесоса? ИИ сможет «размножаться» через телевизоры, холодильники и другую умную технику 13.10.2026 16:49
- overclockers.ru Anthropic: ИИ-червь сможет самовоспроизводиться, заражать устройства и распространяться без ЦОД 13.10.2026 21:21
