Модели генерации видео как симуляторы мира
Мы исследуем масштабное обучение генеративных моделей на видеоданных. В частности, мы обучаем диффузионные модели с текстовым условием одновременно на видео и изображениях различной длительности, разрешения и соотношения сторон. Мы задействуем архитектуру трансформера, которая работает с пространственно-временными патчами латентных кодов видео и изображений. Наша крупнейшая модель, Sora, способна генерировать минутные видео высокого качества. Наши результаты показывают, что масштабирование моделей генерации видео — это перспективный путь к созданию универсальных симуляторов физического мира.
Этот технический отчет посвящен (1) нашему методу преобразования визуальных данных всех типов в единое представление, которое обеспечивает масштабное обучение генеративных моделей, и (2) качественной оценке возможностей и ограничений Sora. Сведения о модели и ее реализации в данном отчете не приводятся.
В большом количестве предыдущих работ изучалось генеративное моделирование видеоданных с использованием различных методов, включая рекуррентные сети, 1, 2, 3 генеративно-состязательные сети, 4, 5, 6, 7 авторегрессионные трансформеры, 8, 9 и диффузионные модели.10, 11, 12 Эти работы часто сосредоточены на узкой категории визуальных данных, на более коротких видео или на видео фиксированного размера. Sora — это модель общего назначения для работы с визуальными данными: она может генерировать видео и изображения разной длительности, с разными соотношениями сторон и разрешениями вплоть до полномасштабных видео высокой четкости продолжительностью до одной минуты.
Превращение визуальных данных в патчи
Мы черпаем вдохновение из больших языковых моделей, которые приобретают универсальные возможности благодаря обучению на данных интернет-масштаба.13, 14 Успех парадигмы БЯМ отчасти обеспечивается использованием токенов, которые изящно объединяют различные модальности текста — код, математику и различные естественные языки. В этой работе мы рассматриваем то, как генеративные модели визуальных данных могут перенять подобные преимущества. В то время как у БЯМ есть текстовые токены, у Sora имеются визуальные патчи. Ранее было доказано, что патчи являются эффективным представлением для моделей визуальных данных.15, 16, 17, 18 Мы обнаружили, что патчи представляют собой отлично масштабируемое и эффективное представление для обучения генеративных моделей на самых разных типах видео и изображений.
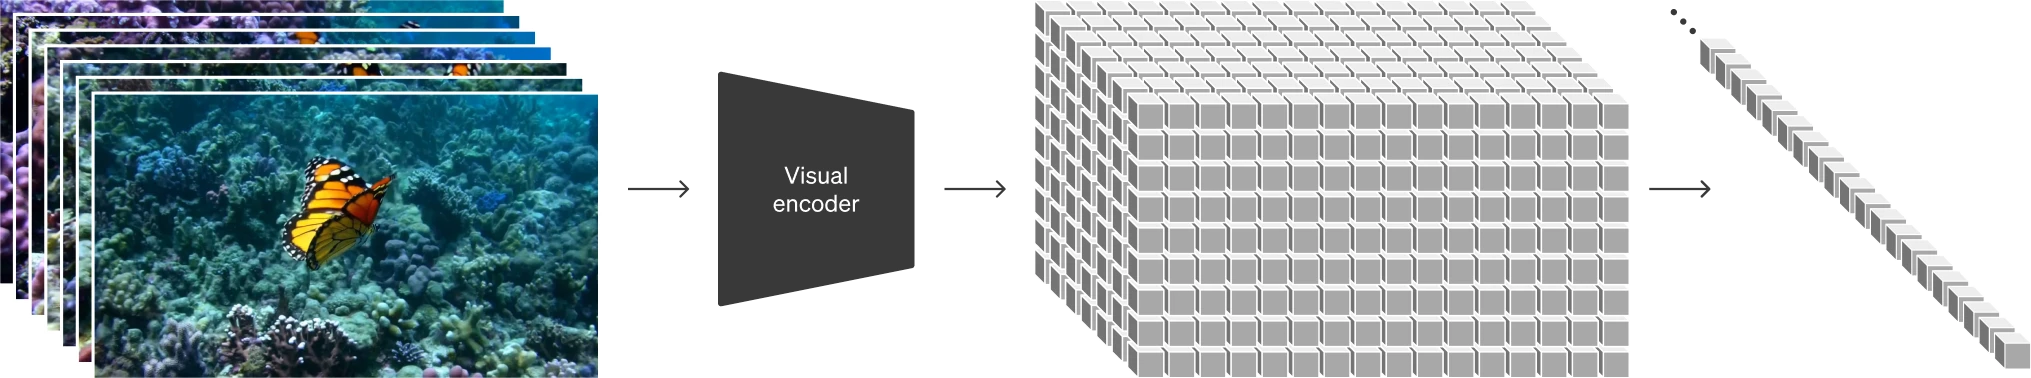
На высоком уровне мы преобразуем видео в патчи, сначала сжимая их в латентное пространство более низкой размерности, 19, а затем декомпозируя полученное представление на пространственно-временные патчи.
Сеть сжатия видео
Мы обучаем сеть, которая снижает размерность визуальных данных.20 Эта сеть принимает на вход исходное видео и выдает латентное представление, сжатое как во времени, так и в пространстве. Sora обучается на видео внутри этого сжатого латентного пространства и впоследствии генерирует их там же. Мы также обучаем соответствующую модель декодировщика, которая преобразует сгенерированные латентные переменные обратно в пространство пикселей.
Пространственно-временные латентные патчи
Получая на входе сжатое видео, мы извлекаем последовательность пространственно-временных патчей, которые выступают в роли токенов трансформера. Эта схема работает и для изображений, так как изображения — это просто видео с одним кадром. Наше патч-ориентированное представление позволяет Sora обучаться на видео и изображениях с переменным разрешением, длительностью и соотношением сторон. На этапе инференса мы можем управлять размером сгенерированных видео, располагая случайно инициализированные патчи в сетке подходящего размера.
Масштабирование трансформеров для генерации видео
Sora — это диффузионная модель21, 22, 23, 24, 25; получая на вход зашумленные патчи (а также управляющую информацию вроде текстовых подсказок), она обучена предсказывать исходные «чистые» патчи. Важно отметить, что Sora — это диффузионный трансформер.26 Трансформеры продемонстрировали выдающиеся свойства масштабирования в самых разных областях, включая языковое моделирование, 13, 14 компьютерное зрение15, 16, 17, 18 и генерацию изображений.27, 28, 29
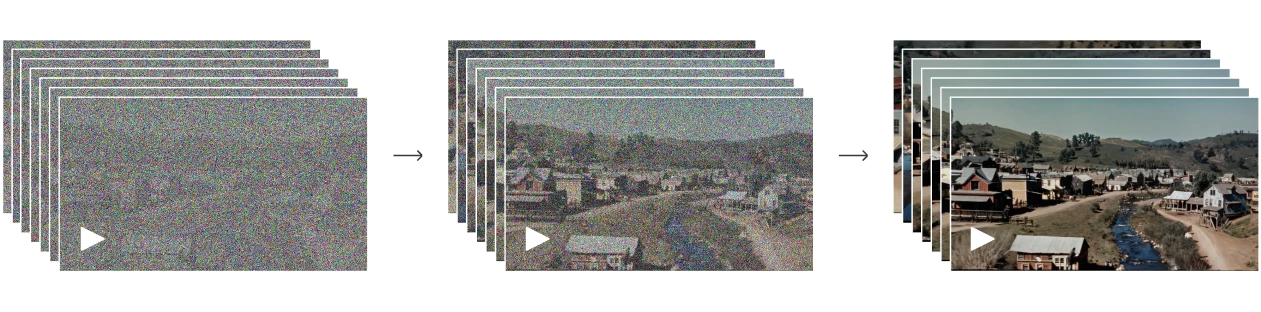
В этой работе мы обнаружили, что диффузионные трансформеры также эффективно масштабируются в качестве видеомоделей. Ниже мы приводим сравнение образцов видео с фиксированными сидами и входными данными по мере продолжения обучения. Качество примеров заметно возрастает по мере увеличения вычислительных ресурсов, затрачиваемых на обучение.
Различная длительность, разрешение и соотношение сторон
Прошлые подходы к генерации изображений и видео обычно меняют размер, обрезают или подрезают видео до стандартного формата — например, 4-секундные ролики с разрешением 256×256. Мы обнаружили, что вместо этого обучение на данных с их исходным размером дает ряд преимуществ.
Гибкость выборки
Sora может создавать широкоформатные видео 1920×1080p, вертикальные видео 1080×1920 и любые промежуточные форматы. Это позволяет Sora создавать контент для различных устройств непосредственно в их родном соотношении сторон. Это также позволяет нам быстро создавать прототипы контента в меньшем размере перед генерацией в полном разрешении — и все это с помощью одной и той же модели.
Улучшенные кадрирование и композиция
Мы эмпирически обнаружили, что обучение на видео в их исходном соотношении сторон улучшает композицию и кадрирование. Мы сравнили Sora с версией нашей модели, которая обрезает все обучающие видео до квадратного формата, что является обычной практикой при обучении генеративных моделей. Модель, обученная на квадратных обрезанных фрагментах (слева), иногда генерирует видео, на которых объект виден лишь частично. Для сравнения, видео от Sora (справа) отличаются более качественным кадрированием.
Понимание языка
Обучение систем генерации текста в видео требует большого количества видеоматериалов с соответствующими текстовыми описаниями. Мы применяем к видео метод добавления подробных описаний (re-captioning), представленный в DALL·E 330. Сначала мы обучаем модель, создающую высокодетализированные описания, а затем используем ее для генерации текстов для всех видеороликов из нашего обучающего набора. Мы выяснили, что обучение на основе детализированных описаний видео повышает как точность следования тексту, так и общее качество видео.
Как и в случае с DALL·E 3, мы также используем GPT для преобразования коротких пользовательских запросов в более длинные и подробные описания, которые передаются видеомодели. Это позволяет Sora генерировать высококачественные видеоролики, которые точно соответствуют запросам пользователей.
Создание видео по изображениям и другим видео
Все результаты, приведенные выше и на нашей главной странице, демонстрируют примеры преобразования текста в видео. Но в качестве входных данных для Sora можно использовать и другие материалы, например уже существующие изображения или видео. Эта возможность позволяет Sora выполнять широкий спектр задач по редактированию фото и видео: создавать идеально закольцованные видеоролики, анимировать статичные изображения, продлевать видео вперед или назад во времени и т. д.
Анимация изображений DALL·E
Sora способна генерировать видео на основе поданных на вход изображения и текстового запроса. Ниже мы показываем примеры видеороликов, созданных на основе изображений DALL·E 231 и DALL·E 330.
Продление сгенерированных видео
Sora также способна продлевать видео как вперед, так и назад во времени. Ниже представлены три видеоролика, каждый из которых был продлен назад во времени, начиная с определенного фрагмента сгенерированного видео. В результате каждое из трех видео начинается по-разному, но все они приводят к одному и тому же финалу.
Мы можем использовать этот метод для продления видео как вперед, так и назад, чтобы создать бесшовную бесконечную петлю.
Редактирование видео на основе видео
Диффузионные модели открыли множество методов редактирования изображений и видео с помощью текстовых подсказок. Ниже мы применяем один из таких методов — SDEdit32 — к модели Sora. Эта техника позволяет Sora изменять стили и окружение исходных видеороликов в режиме zero-shot (без предварительного обучения на конкретной задаче).
Соединение видео
Мы также можем использовать Sora для постепенной интерполяции между двумя исходными видео, создавая плавные переходы между роликами с совершенно разными объектами и композицией сцен. В приведенных ниже примерах центральные видео осуществляют переход между соответствующими видео слева и справа.
Возможности генерации изображений
Sora также способна генерировать изображения. Мы делаем это, располагая патчи гауссовского шума в пространственной сетке с временной протяженностью в один кадр. Модель может создавать изображения переменного размера — вплоть до разрешения 2048×2048.
Появляющиеся возможности симуляции
Мы обнаружили, что при масштабном обучении видеомодели демонстрируют ряд интересных эмерджентных (возникающих) возможностей. Эти способности позволяют Sora симулировать некоторые аспекты людей, животных и элементов реального физического мира. Эти свойства возникают без каких-либо явных индуктивных смещений для трехмерного пространства, объектов и т. д. — они являются чисто следствием масштаба.
3D-консистентность. Sora может генерировать видео с динамичным движением камеры. По мере смещения и вращения камеры люди и элементы сцены последовательно и согласованно перемещаются в трехмерном пространстве.
Долгосрочная согласованность и постоянство объектов. Серьезной проблемой для систем генерации видео всегда было поддержание временной согласованности при создании длинных видеороликов. Мы обнаружили, что Sora часто (хотя и не всегда) способна эффективно моделировать как кратковременные, так и долгосрочные зависимости. Например, наша модель способна сохранять людей, животных и объекты в кадре, даже если они перекрыты другими предметами или выходят за границы кадра. Кроме того, она может генерировать несколько планов одного и того же персонажа в рамках одного видеофрагмента, сохраняя его внешность на протяжении всего ролика.
Взаимодействие с миром. Sora иногда способна симулировать действия, которые простым образом влияют на состояние мира. Например, художник может оставлять на холсте новые мазки, которые сохраняются с течением времени, или человек может есть бургер и оставлять на нем следы от укусов.
Симуляция цифровых миров. Sora также способна симулировать искусственные процессы — например, видеоигры. Sora может одновременно управлять игроком в Minecraft с помощью базовой стратегии и при этом с высокой степенью детализации рендерить сам мир и его динамику. Эти возможности можно активировать в режиме zero-shot, задавая для Sora описания, в которых упоминается «Minecraft».
Эти возможности говорят о том, что дальнейшее масштабирование видеомоделей является перспективным путем к созданию высокофункциональных симуляторов физического и цифрового миров, а также объектов, животных и людей, которые в них обитают.
Обсуждение
В настоящее время Sora имеет множество ограничений в качестве симулятора. Например, она неточно моделирует физику многих базовых взаимодействий, таких как разбивание стекла. Другие взаимодействия, например прием пищи, не всегда приводят к корректным изменениям состояния объектов. Другие распространенные типы сбоев модели — такие как несогласованность, возникающая в длинных видеофрагментах, или спонтанное появление объектов — мы перечислили на нашей главной странице.
Мы считаем, что возможности, которыми Sora обладает сегодня, демонстрируют: дальнейшее масштабирование видеомоделей является перспективным путем к разработке функциональных симуляторов физического и цифрового миров, а также населяющих их объектов, животных и людей.
Ссылки
- 1
Srivastava, Nitish, Elman Mansimov, and Ruslan Salakhudinov. «Unsupervised learning of video representations using lstms.» International conference on machine learning. PMLR, 2015.
- 2
Chiappa, Silvia, et al. «Recurrent environment simulators.» arXiv preprint arXiv:1704.02254 (2017).
- 3
Ha, David, and Jürgen Schmidhuber. «World models.» arXiv preprint arXiv:1803.10122 (2018).
- 4
Vondrick, Carl, Hamed Pirsiavash, and Antonio Torralba. «Generating videos with scene dynamics.» Advances in neural information processing systems 29 (2016).
- 5
Tulyakov, Sergey, et al. «Mocogan: Decomposing motion and content for video generation.» Proceedings of the IEEE conference on computer vision and pattern recognition. 2018.
- 6
Clark, Aidan, Jeff Donahue, and Karen Simonyan. «Adversarial video generation on complex datasets.» arXiv preprint arXiv:1907.06571 (2019).
- 7
Brooks, Tim, et al. «Generating long videos of dynamic scenes.» Advances in Neural Information Processing Systems 35 (2022): 31769–31781.
- 8
Yan, Wilson, et al. «Videogpt: Video generation using vq-vae and transformers.» arXiv preprint arXiv:2104.10157 (2021).
- 9
Wu, Chenfei, et al. «Nüwa: Visual synthesis pre-training for neural visual world creation.» European conference on computer vision. Cham: Springer Nature Switzerland, 2022.
- 10
Ho, Jonathan, et al. «Imagen video: High definition video generation with diffusion models.» arXiv preprint arXiv:2210.02303 (2022).
- 11
Blattmann, Andreas, et al. «Align your latents: High-resolution video synthesis with latent diffusion models.» Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2023.
- 12
Gupta, Agrim, et al. «Photorealistic video generation with diffusion models.» arXiv preprint arXiv:2312.06662 (2023).
- 13
Vaswani, Ashish, et al. «Attention is all you need.» Advances in neural information processing systems 30 (2017).
- 14
Brown, Tom, et al. «Language models are few-shot learners.» Advances in neural information processing systems 33 (2020): 1877–1901.
- 15
Dosovitskiy, Alexey, et al. «An image is worth 16×16 words: Transformers for image recognition at scale.» arXiv preprint arXiv:2010.11929 (2020).
- 16
Arnab, Anurag, et al. «Vivit: A video vision transformer.» Proceedings of the IEEE/CVF international conference on computer vision. 2021.
- 17
He, Kaiming, et al. «Masked autoencoders are scalable vision learners.» Proceedings of the IEEE/CVF conference on computer vision and pattern recognition. 2022.
- 18
Dehghani, Mostafa, et al. «Patch n’Pack: NaViT, a Vision Transformer for any Aspect Ratio and Resolution.» arXiv preprint arXiv:2307.06304 (2023).
- 19
Rombach, Robin, et al. «High-resolution image synthesis with latent diffusion models.» Proceedings of the IEEE/CVF conference on computer vision and pattern recognition. 2022.
- 20
Kingma, Diederik P., and Max Welling. «Auto-encoding variational bayes.» arXiv preprint arXiv:1312.6114 (2013).
- 21
Sohl-Dickstein, Jascha, et al. «Deep unsupervised learning using nonequilibrium thermodynamics.» International conference on machine learning. PMLR, 2015.
- 22
Ho, Jonathan, Ajay Jain, and Pieter Abbeel. «Denoising diffusion probabilistic models.» Advances in neural information processing systems 33 (2020): 6840–6851.
- 23
Nichol, Alexander Quinn, and Prafulla Dhariwal. «Improved denoising diffusion probabilistic models.» International Conference on Machine Learning. PMLR, 2021.
- 24
Dhariwal, Prafulla, and Alexander Quinn Nichol. «Diffusion Models Beat GANs on Image Synthesis.» Advances in Neural Information Processing Systems. 2021.
- 25
Karras, Tero, et al. «Elucidating the design space of diffusion-based generative models.» Advances in Neural Information Processing Systems 35 (2022): 26565–26577.
- 26
Peebles, William, and Saining Xie. «Scalable diffusion models with transformers.» Proceedings of the IEEE/CVF International Conference on Computer Vision. 2023.
- 27
Chen, Mark, et al. «Generative pretraining from pixels.» International conference on machine learning. PMLR, 2020.
- 28
Ramesh, Aditya, et al. «Zero-shot text-to-image generation.» International Conference on Machine Learning. PMLR, 2021.
- 29
Yu, Jiahui, et al. «Scaling autoregressive models for content-rich text-to-image generation.» arXiv preprint arXiv:2206.10789 2.3 (2022): 5.
- 30
Betker, James, et al. «Improving image generation with better captions.» Computer Science. https://cdn.openai.com/papers/dall-e-3. pdf 2.3 (2023): 8
- 31
Ramesh, Aditya, et al. «Hierarchical text-conditional image generation with clip latents.» arXiv preprint arXiv:2204.06125 1.2 (2022): 3.
- 32
Meng, Chenlin, et al. «Sdedit: Guided image synthesis and editing with stochastic differential equations.» arXiv preprint arXiv:2108.01073 (2021).
Авторы
Цитата
Пожалуйста, ссылайтесь на работу как Brooks, Peebles, et al., и используйте следующий BibTeX для цитирования: https://openai.com/bibtex/videoworldsimulators2024.bib
Полный текст статьи читайте на OpenAI
