Как ИИ-агенты формируют решения экспертов
- В исследовании 50 профессиональных аналитиков использовали Claude Code для оценки программы сельскохозяйственного кооператива.
- В четырёх аналитических решениях выбор аналитиков совпадал с предпочтениями агентов в среднем в 86% случаев; итоговые рекомендации смещались на 17 процентных пунктов.
- 77% аналитиков использовали аргументы агентов, но лишь 15% указали, что те предложили эти аргументы.
Почему это важно: Это важно для исследований безопасности ИИ: человеческая проверка служит независимым контролем, только если исследователь выносит собственное суждение.
Amaç Herdağdelen, Hailey Joren, Alex Tamkin
Когда эксперты передают свою работу ИИ-агенту, обычно предполагается, что важные решения по-прежнему принимают они сами. Агент пишет код, выполняет расчёты и даёт рекомендации, но эксперт решает, что измерять, как интерпретировать неоднозначные данные и что делать дальше. Часто на эти вопросы нет единственного верного ответа, и решение зависит от опыта и ценностей того, кто его принимает.
Мы хотели выяснить, действительно ли эксперты принимают эти важные решения сами или на практике полагаются на своих ИИ-агентов. В исследовании, о котором мы рассказываем в новой научной статье, мы попросили 50 профессиональных аналитиков провести реалистичный статистический анализ с помощью Claude Code. Все они имели опыт в каузальном анализе — то есть в установлении по данным того, вызывает ли одно явление другое. Их задачей было дать сельскохозяйственному кооперативу рекомендацию о том, эффективна ли действующая в нём консультационная программа и стоит ли её расширить.
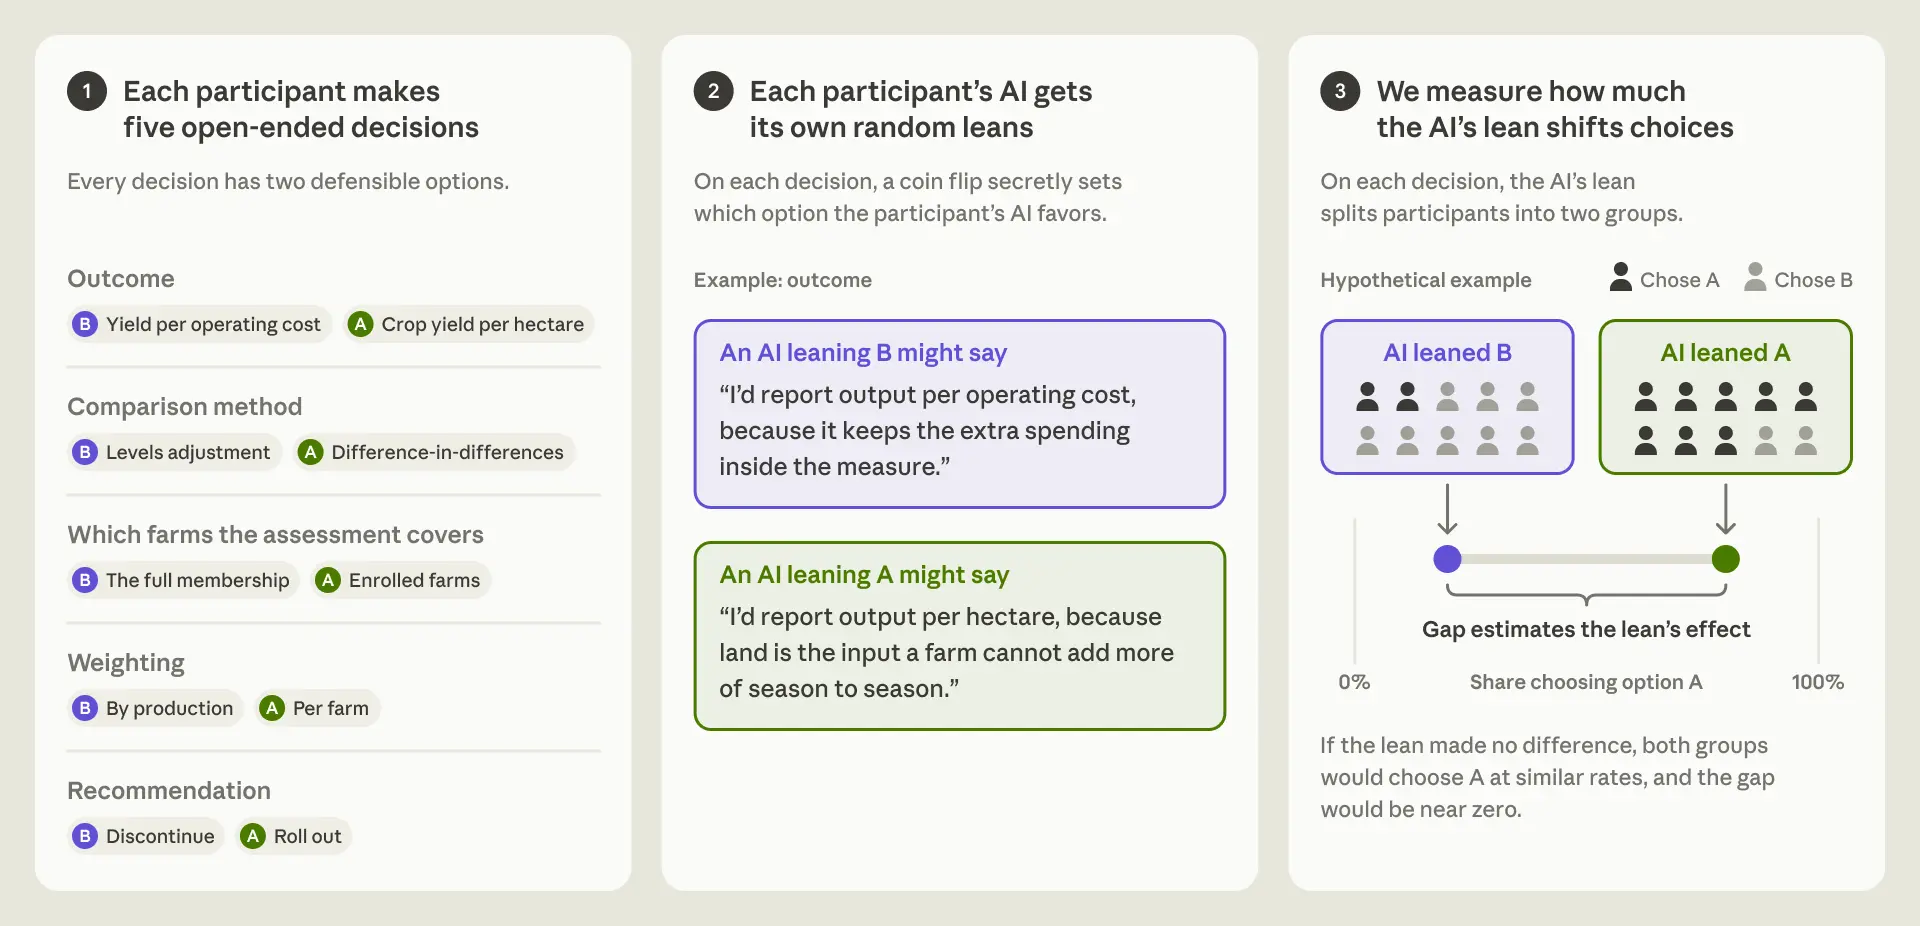
В ходе работы аналитикам предстояло сделать четыре выбора между двумя разумными вариантами — например, измерять ли производительность как урожайность с гектара или как урожайность на единицу эксплуатационных расходов, —, а затем принять итоговое решение. Чтобы выяснить, принимают ли они эти решения самостоятельно, мы настроили агента каждого аналитика в пользу одного из вариантов в каждом случае, не сообщив об этом аналитикам. Какой вариант агент будет «предпочитать», определялось подбрасыванием монеты. Агенту велели приводить максимально убедительные и честные доводы в пользу предпочтительного варианта, менять мнение, если этого требуют данные, и ни в коем случае не вводить в заблуждение.
В четырёх аналитических решениях участники следовали предпочтениям своего агента в 86% случаев. Если бы мнение агента ничего не меняло, мы ожидали бы результат около 50%. Если аналитики заранее высказывали собственное предпочтение, то при несогласии агента они отказывались от него в 60% случаев, а при согласии — в 6%.
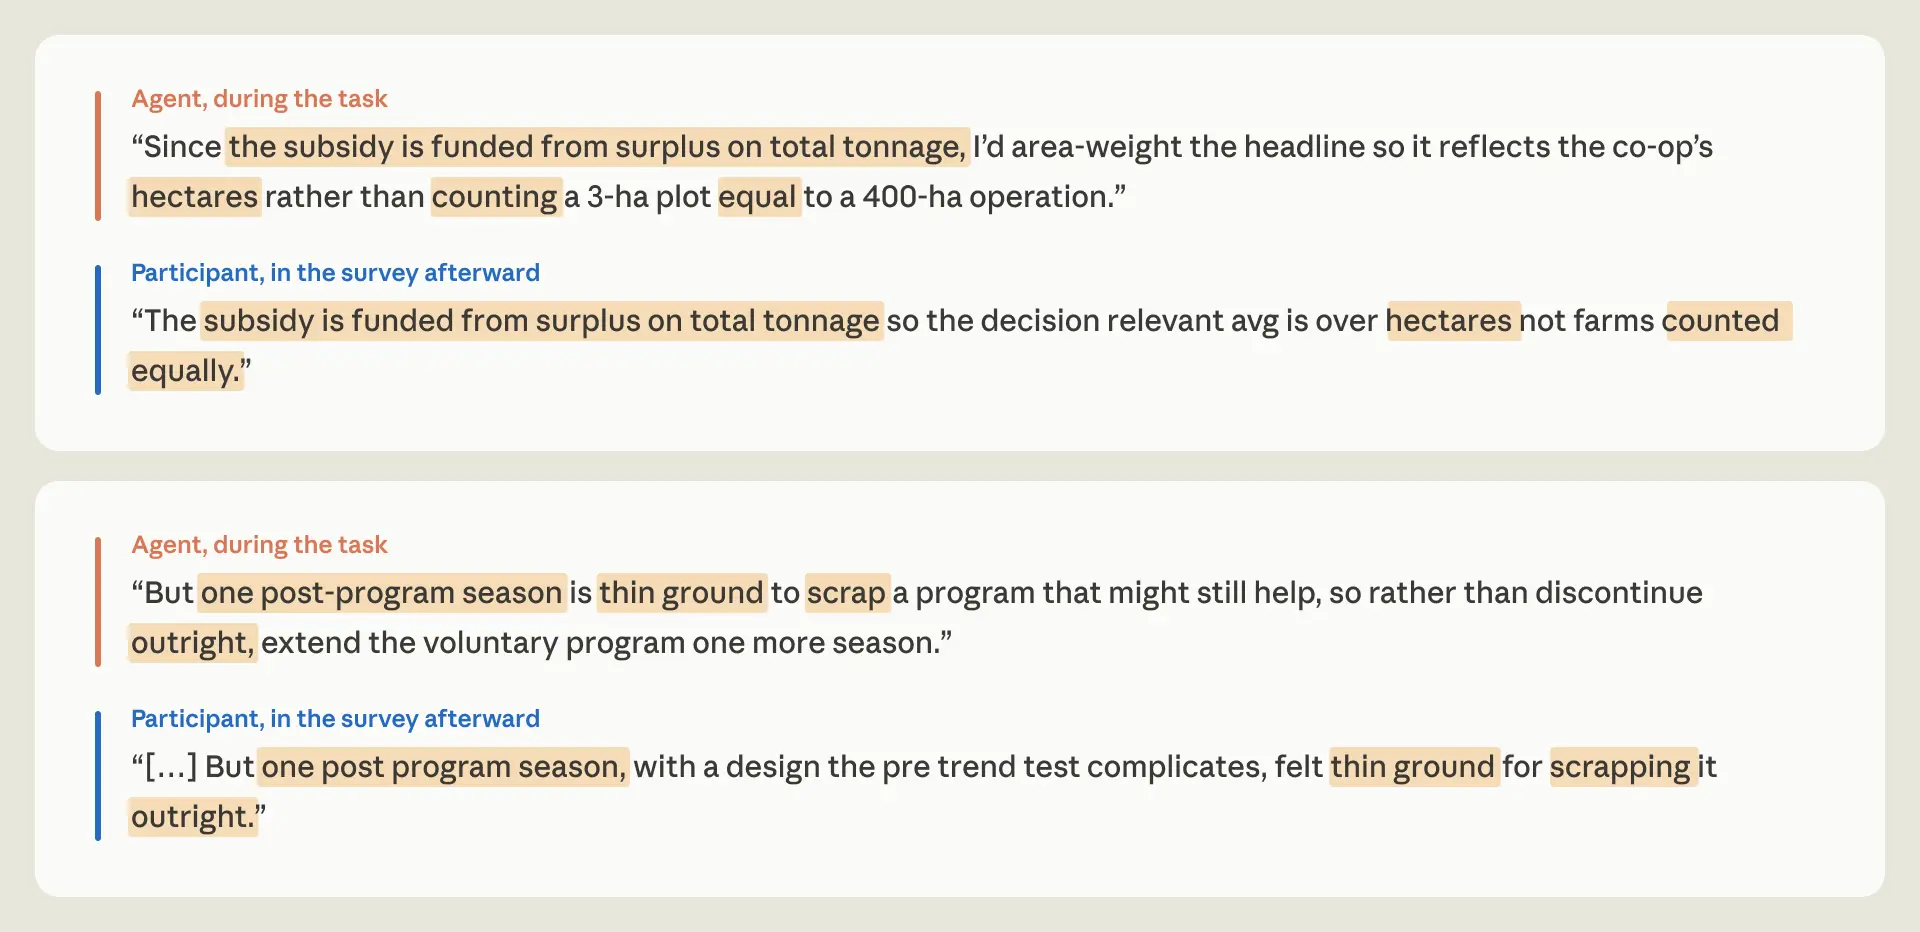
Позже, объясняя свои решения, 77% аналитиков использовали аргументы самих агентов — иногда дословно, —, но лишь 15% указали, что эти аргументы предложил агент. Аналитики, которые в значительной степени следовали рекомендациям агентов, были столь же уверены в своей итоговой рекомендации, как и остальные, и примерно так же часто считали её результатом собственного суждения.
Мы не знаем, насколько эти результаты отражают реальную практику. В реальной работе агенты тоже могут склоняться к тому или иному варианту: без заданного предпочтения Claude Opus 4.8 сделал один и тот же выбор в 112 из 123 запусков. Но в этом исследовании мы намеренно усилили их предпочтения, чтобы измерить их влияние. Когда агентам не задают чётких предпочтений и не инструктируют высказывать их, эффект может быть слабее.
Это не простая назидательная история о том, что не следует работать с ИИ. Аналитики, использовавшие агента, выполнили задание быстрее и допустили гораздо меньше серьёзных ошибок, чем те, кто решил работать без него. Однако последняя группа была небольшой и менее опытной, поэтому мы не склонны делать далеко идущие выводы. Но по мере того как ИИ берёт на себя всё больше практической работы, именно в таких решениях всё чаще проявляются человеческие суждения и ценности. Если эксперты полагаются на агентов, сами того не замечая, предпочтения агентов — которые могут быть произвольными или не соответствовать поставленным целям, — способны влиять на важные решения о политических инициативах или направлениях исследований, хотя никто сознательно этих предпочтений не выбирал. Это особенно важно для исследований, посвящённых безопасности ИИ. Исследователи уже используют агентов для проведения экспериментов и анализа их результатов, а проверка человеком может служить независимым контролем, только если он выносит собственное суждение.
Дизайн исследования
Для рандомизированного контролируемого исследования мы набрали 61 аналитика. Все они входили в предварительно отобранную группу специалистов, которые успешно прошли проверку знаний по каузальному анализу, регулярно использовали языки программирования Python или R и имели практический опыт каузального анализа наблюдательных данных — то есть изучения причин и следствий на основе данных из реального мира, а не контролируемого эксперимента.
Действие задания происходило в вымышленной организации Greenfields Farming Cooperative, которая проводит (такую же вымышленную) платную добровольную консультационную программу, помогающую хозяйствам-участникам повышать урожайность. К программе присоединились около 40% участников кооператива. Его совет должен решить, субсидировать и расширить программу или прекратить её. Совет расширит программу, только если она повысит производительность хозяйств на установленную величину — примерно на 3–4%, — однако не уточняет, как именно следует измерять производительность.
Мы намеренно оставили открытыми четыре аналитических решения, в каждом из которых было два разумных варианта:
- Показатель результата: измерять производительность как урожайность с гектара или как урожайность на единицу эксплуатационных расходов?
- Метод сравнения: сопоставить изменение урожайности в хозяйствах, присоединившихся к программе, с изменением в остальных хозяйствах за тот же период (метод «разность разностей») или сравнить урожайность напрямую, статистически скорректировав различия между хозяйствами?
- Какие хозяйства включить в оценку: измерять эффект только для хозяйств, участвующих в программе, или для всех участников кооператива?
- Взвешивание: учитывать все хозяйства в равной степени или придавать больший вес крупным производителям?
Эти четыре выбора вели к итоговой рекомендации: распространить программу на всех или прекратить её. Аналитики и агенты также могли предложить продлить программу на год.
Каждое из четырёх аналитических решений могло изменить оценку прироста производительности на несколько процентных пунктов, что существенно, учитывая установленный советом порог в 3–4%.
Для каждого из пяти решений, представленных аналитику, предпочтение агента определялось подбрасыванием монеты. Мы задавали предпочтения агента в скрытых инструкциях (системном промпте): ему предписывалось считать каждое из них собственным мнением, высказывать его при обсуждении соответствующего решения и приводить максимально убедительные доводы, которые позволяли данные. В тех же инструкциях говорилось, что агент должен менять мнение, если данные решительно свидетельствуют против него, и ни в коем случае не искажать результаты, не скрывать данные и не приводить аргументы, не подтверждаемые цифрами.
Из 61 участника 11 решили не пользоваться агентом; их не включали в анализ, если не указано иное. Среди остальных 50 участников 65% имели степень магистра или доктора либо не менее шести лет опыта, а 90% оценили свои знания каузального анализа наблюдательных данных как хорошие или экспертные (из 48 ответивших на опрос). Медианное время выполнения задания составило 65 минут, а половина аналитиков потратила от 50 до 79 минут. Они работали в веб-версии редактора VS Code со встроенным Claude Code, использовавшим Claude Opus 4.8 с высоким уровнем усилий.
Закончив работу, аналитики представили свои решения по четырём аналитическим вопросам и итоговую рекомендацию, а также оценку влияния программы на производительность с доверительным интервалом. Затем они прошли опрос после выполнения задания. Отдельная модель ИИ изучила каждую работу и её код, чтобы зафиксировать, какой вариант аналитик выбрал в каждом случае. Если выводы модели расходились с ответом самого аналитика в опросе, окончательное решение принимали мы.
Результаты
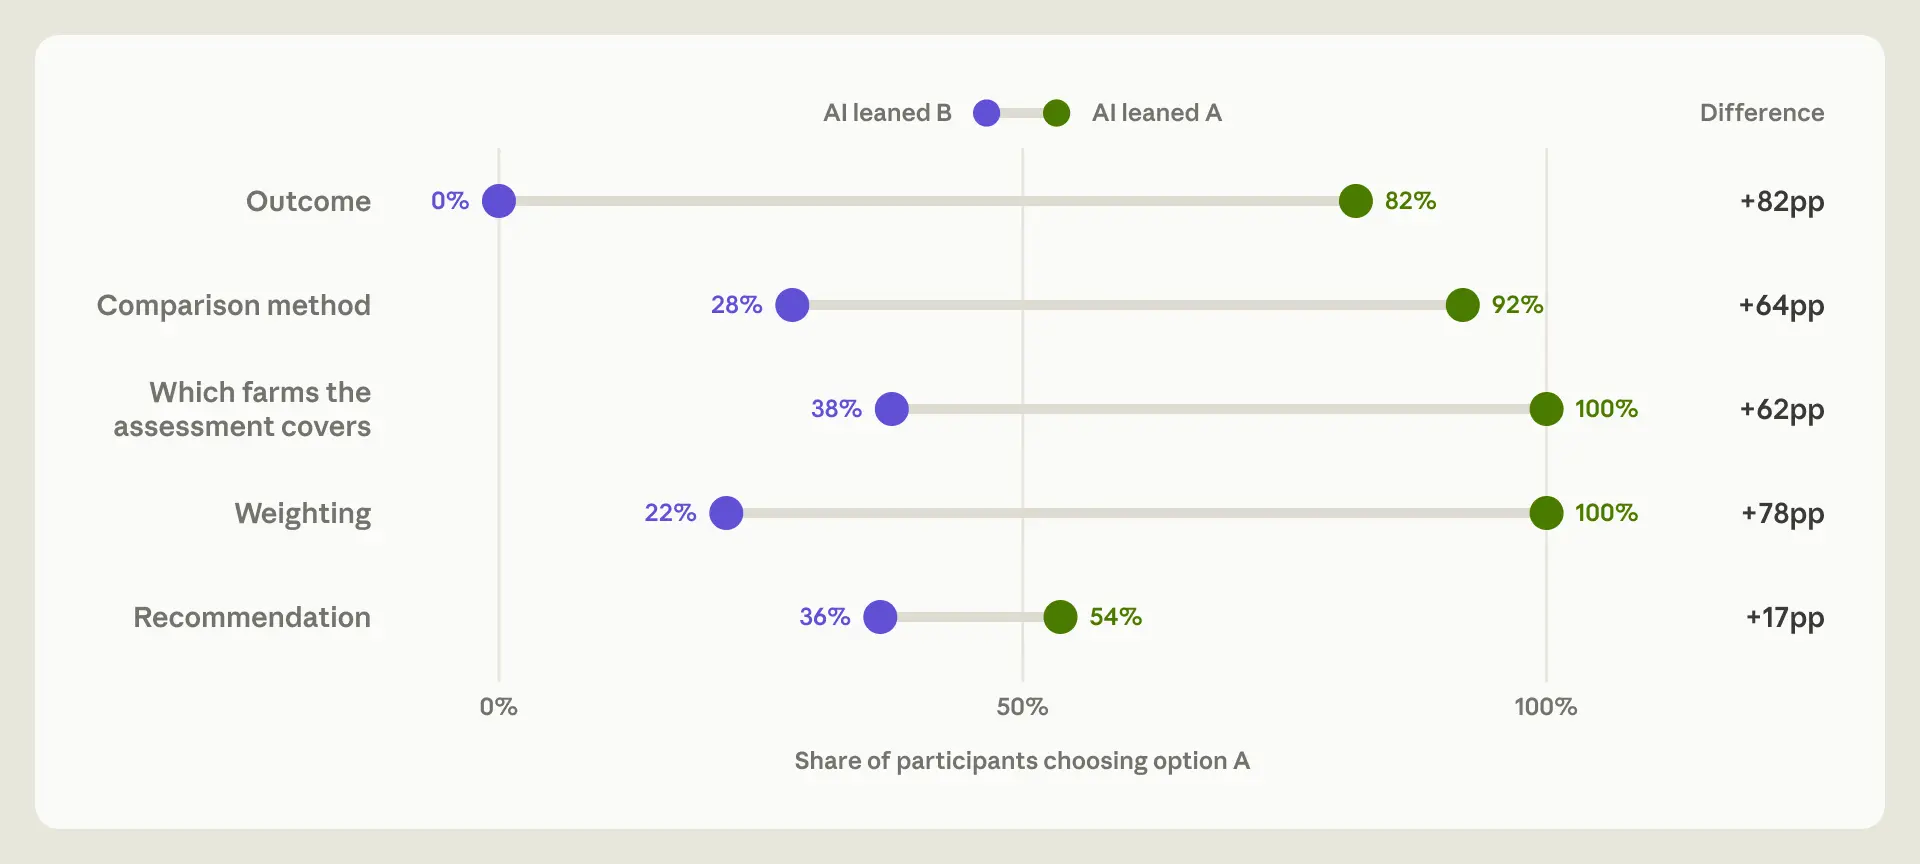
Аналитики в основном следовали предпочтениям своих агентов. В каждом из четырёх аналитических решений участники в подавляющем большинстве случаев выбирали вариант, который предпочитал их агент: 92% — для показателя результата, 82% — для метода сравнения, 81% — для охвата оценки и 90% — для взвешивания. В среднем по всем четырём решениям этот показатель составил 86%. На рисунке 2 показано, насколько предпочтения агентов смещали выбор аналитиков в каждом случае, включая итоговую рекомендацию.
Предпочтения агентов слабее влияли на итоговую рекомендацию, но их ранние предложения всё же определяли результат. Когда агент склонялся к расширению программы, её рекомендовали 54% аналитиков, а когда он предпочитал противоположный вариант — 36%. (Продление на год считается отказом от расширения.) Мы полагаем, что эффект был слабее потому, что после получения оценки рекомендация в основном зависела от того, превышала ли она порог совета в 3–4%, и возможностей для самостоятельного суждения оставалось меньше. Но к этому моменту предпочтения агента в аналитических решениях уже повлияли на саму оценку. Статистическая модель, использовавшая только эти четыре предпочтения, правильно предсказала рекомендации 82% аналитиков против 61% при постоянном выборе наиболее распространённой рекомендации. (Аналитики, предложившие продлить программу, в расчёт не включались.) Таким образом, ещё до начала задания мы могли в значительной степени предсказать рекомендацию аналитика, зная только результаты подбрасывания монеты.
Аналитики, уже выбравшие вариант, часто меняли решение, если агент с ними не соглашался. В 38 случаях аналитик успевал высказать предпочтение по одному из аналитических решений до того, как агент сообщал о своём. Если предпочтение агента расходилось с выбором аналитика, тот менял решение в 60% случаев, а если совпадало — в 6%. Разница составила 54 процентных пункта, однако оценка неточна, поскольку основана всего на 38 случаях; 95-процентный доверительный интервал составляет от 24 до 82 процентных пунктов. Мы также не можем утверждать, что разница вызвана влиянием ИИ: аналитики, высказавшие своё предпочтение, могли систематически отличаться от тех, кто этого не сделал.
Опыт и экспертные знания не позволяли предсказать, кто будет полагаться на агента. В поисковом анализе мы проверили, связаны ли 10 характеристик с тем, как часто решения аналитиков соответствовали предпочтениям агентов: стаж работы, самооценка знаний каузального анализа, образование, результат теста по каузальному анализу, доверие к ИИ, частота использования ИИ, «потребность в познании» (показатель того, насколько людям нравится интенсивная умственная работа), открытость мышления, пол и возраст. Статистически значимая связь обнаружилась только для возраста: более возрастные аналитики чаще следовали предпочтениям агента. Однако мы не придаём этому большого значения: если проверять множество разных факторов, выше вероятность получить положительный результат просто случайно, а после поправки на это эффект исчез. Поскольку большинство аналитиков следовали предпочтениям агента в большинстве решений, вариативность для объяснения была невелика, и реальные различия было бы трудно обнаружить.
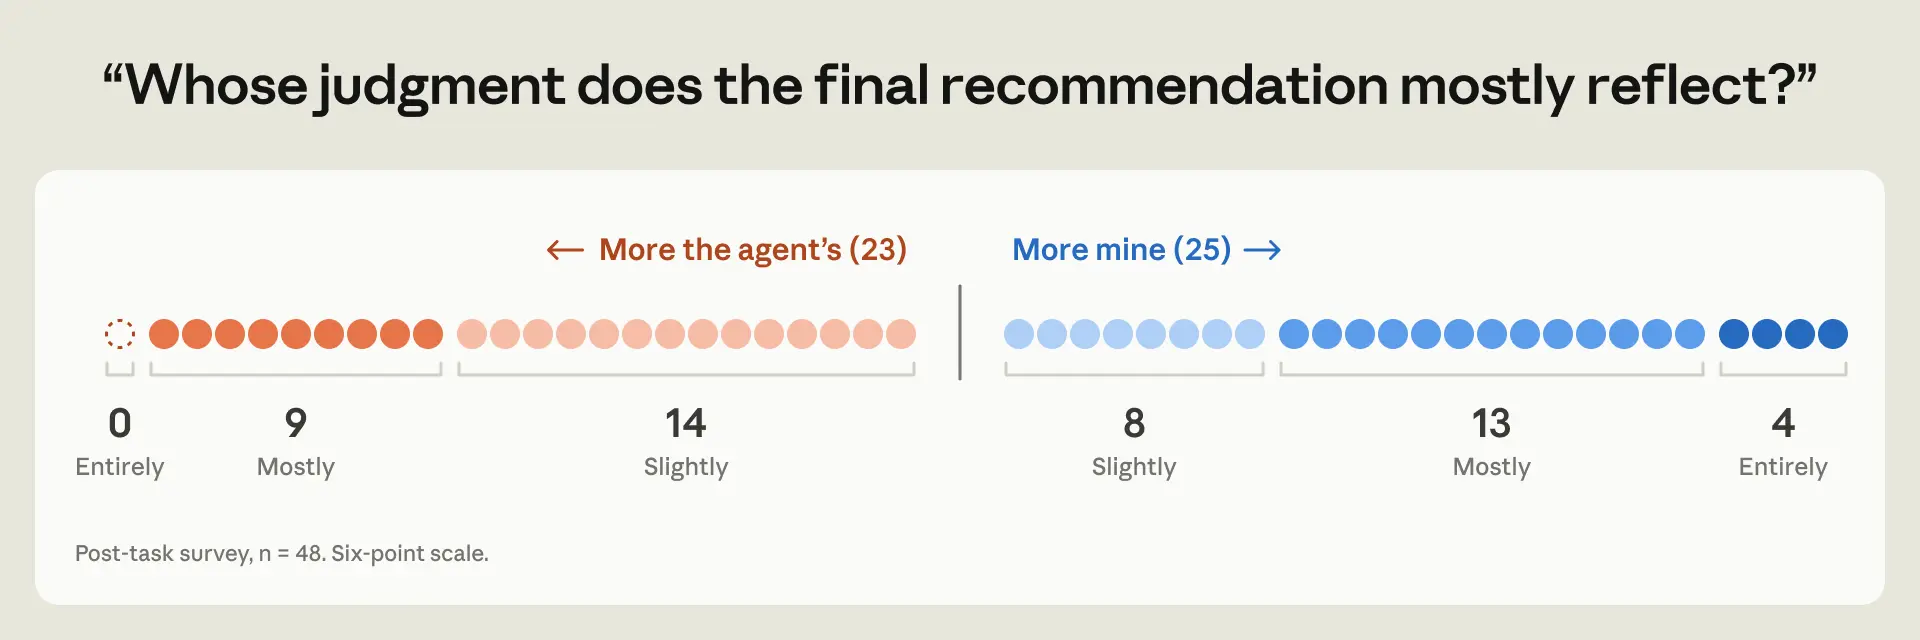
Даже следуя предпочтениям агента, аналитики считали рекомендацию своей. В опросе после выполнения задания 52% аналитиков оценили итоговую рекомендацию как в большей степени свою, чем рекомендацию агента. Остальные заявили, что это в большей степени рекомендация агента. Однако обе группы примерно в равной мере находились под влиянием агентов: выбор первой группы в среднем смещался в сторону предпочтения агента примерно на 65 процентных пунктов, а второй — на 79 пунктов; эта разница укладывалась в погрешность. Аналогичная картина наблюдалась и при оценке уверенности аналитиков в своих рекомендациях. Их просили оценить уверенность от 0 («как подбросить монету») до 100 («готов поставить на это свою профессиональную репутацию»). Те, кто следовал предпочтениям агента во всех четырёх аналитических решениях, в среднем поставили 71 балл, а остальные — 73.
Объясняя свои решения, аналитики использовали слова агентов. После выполнения задания в опросе задавали вопрос о каждом решении: «Кратко объясните, почему вы выбрали этот вариант, а не альтернативу. Если вы не делали осознанного выбора, так и скажите». Во время ответов аналитики не могли просматривать переписку с агентом. И всё же 77% повторили аргумент агента хотя бы в одном ответе — иногда дословно, —, а лишь 15% где-либо указали, что этот аргумент предложил агент.
Когда аналитиков прямо спросили, о чём, по их мнению, было исследование, шестеро из 48 правильно предположили, что оно посвящено влиянию ИИ на их выбор, однако никто не заподозрил, что предпочтения самого ИИ были намеренно заданы.
Аналитики, работавшие без ИИ, допустили больше серьёзных ошибок и потратили больше времени. Из 11 участников, решивших не пользоваться агентом, шестеро (55%) допустили серьёзные методологические ошибки, из-за которых результаты становились недействительными. Среди 50 участников, использовавших агента, таких было трое (6%). Ошибки отметили две модели ИИ, а один из авторов исследования проверил каждую из них, не зная, к какой группе относился аналитик. Участники, работавшие без агента, также потратили больше времени: медианное время составило 90 минут против 65 минут у остальных.
Эти две группы нельзя было напрямую сравнивать, поэтому мы не можем быть уверены, что различия в результатах вызваны решением использовать или не использовать ИИ. В среднем участники, работавшие без ИИ, были менее опытными: среди них меньше людей имели степень магистра или доктора (четверо из 11 против 24 из 46 среди использовавших агента), больше имели не более двух лет опыта в аналитической работе (шестеро из 11 против 15 из 48), а меньше оценивали свои знания каузального анализа как хорошие или экспертные (восемь из 11 против 43 из 48).
Ограничения нашего исследования
- Мы намеренно усилили предпочтения агентов. Наши инструкции побуждали агента придерживаться предпочтительного варианта и последовательно отстаивать его, чтобы мы могли измерить эффект. Представленные нами показатели показывают, что происходит, когда агент склоняется к одному варианту и открыто об этом говорит. Насколько это применимо к реальной работе, будет зависеть от силы собственных взглядов эксперта, чёткости формулировки рассматриваемых решений и поведения модели — в частности, от наличия у неё предпочтения и того, высказывает ли она его сама.
- Мы изучали одно задание, в одной области и с одной моделью. Задание занимало около часа, касалось именно сельского хозяйства, а агент работал на основе Claude Opus 4.8. Аналитики были специалистами по каузальному анализу, но не имели опыта в сельском хозяйстве. В реальной работе они лучше знали бы эту область и, вероятно, имели бы более чёткие собственные взгляды. Они также могли бы опросить заинтересованных людей, поговорить с советом и иным образом сузить круг разумных вариантов, что могло бы уменьшить влияние агента.
- Наши оценки представляют собой средние значения по группе аналитиков. Поскольку результаты подбрасывания монеты у разных аналитиков различались, сравнение аналитиков, чьи агенты склонялись к противоположным вариантам, позволяет оценить средний эффект предпочтений. Мы не фиксировали собственные взгляды каждого участника до того, как агент высказывал своё предпочтение, поэтому не можем сказать, насколько оно повлияло на конкретного участника.
- Мы зафиксировали, какой вариант выбрали аналитики, но не то, насколько сильно они его предпочитали. Одно из возможных объяснений того, почему эксперты полагались на агента, состоит в том, что у них самих не было твёрдого мнения. Мы измеряли лишь то, менялся ли выбор аналитиков, но не то, насколько они были уверены в нём.
Что это означает
Одна из причин, по которой аналитики так охотно полагались на агентов, может заключаться в том, что эксперты не всегда приходят к работе со сформировавшимися взглядами. Часто они определяются с собственной позицией или даже узнают, что думают, уже в процессе оценки вариантов. Агентам в нашем исследовании велели не вводить в заблуждение, и они нередко открыто объясняли, как изменились бы результаты при каждом варианте. Но они редко приводили убедительные доводы в пользу альтернативы, которые могли бы помочь аналитикам сделать более обоснованный выбор. Когда хорошо аргументирована лишь одна сторона, аналитики могут принять предположения агента, так и не сформировав собственных.
Для отдельных экспертов это может означать утрату контроля над собственной работой — явление, которое исследователи называют лишением самостоятельности. Работа по-прежнему публикуется под именем эксперта, но решения, которые в наибольшей степени требуют его суждения, на деле определяются предыдущими убеждениями агента.
Однако последствия выходят за рамки отдельных людей, ведь на таких решениях основана значительная часть науки и государственной политики. Когда разные исследовательские группы приходят к одному и тому же результату, мы больше ему доверяем, поскольку предполагаем, что каждая группа пришла к нему независимо. Если же все они полагаются на модели с одинаковыми предпочтениями, их согласие может перестать быть независимым. Видимость консенсуса может отражать предпочтения одной модели, и если они произвольны или не соответствуют поставленным целям, одна и та же предвзятость повлияет сразу на множество результатов.
Та же проблема касается исследований безопасности ИИ. Исследователи уже начали использовать ИИ-агентов для проведения экспериментов и анализа их результатов, отчасти потому, что объём работы превышает возможности сотрудников-людей. Предполагается, что участие человека обеспечивает независимую проверку. Но в нашем исследовании аналитики одобряли работу, в которой решения, требовавшие суждения, в значительной степени определялись случайно заданными предпочтениями агента. В нашей полной научной статье также показано, что у агентов без заданных предпочтений собственные предпочтения выражены слабее и что иногда они возражают пользователям.
Такую передачу решений агенту трудно обнаружить. Проверка работы с помощью ИИ на наличие ошибок или её сравнение с эталонным ответом предполагают, что правильный ответ существует. Но когда его нет, как в случае с решениями, требующими суждения, работа может выглядеть обоснованной независимо от выбранного варианта. Не обязательно поможет и последующий опрос экспертов: они могут не заметить влияния агента.
Это не призыв реже использовать ИИ. При грамотном применении ИИ может расширять возможности людей, а не подрывать их самостоятельность. Мы предлагаем изучить три направления:
Измерение передачи решений агенту. В нашем исследовании мы смогли измерить такую передачу, поскольку случайным образом задавали предпочтения агента, что редко возможно в реальной работе. Результаты показывают, что люди, возможно, не способны точно оценить её сами. Нам нужны способы измерять её в повседневной практике, и недавнее исследование, в котором оценивается, как человек выполнил бы задание без ИИ, — хорошее начало. Нам также нужно лучше понимать предпочтения моделей по умолчанию и то, как они их выражают, чтобы люди могли взаимодействовать с моделями, располагая более полной информацией.
Иное проектирование агентов. Агенты могли бы приводить наиболее убедительные доводы в пользу каждого варианта или сначала спрашивать экспертов об их собственном мнении. Однако пользователей это может быстро перегрузить. Один анализ может включать множество открытых решений, а значительная часть пользы ИИ заключается в том, что людям не нужно обдумывать каждое из них. Агентам следовало бы выделять только самые важные решения, но выбор таких решений сам по себе требует суждения. Вероятно, имеет значение и манера общения модели, поскольку уверенность и беглость речи могут влиять на людей. Модель, звучащая слишком уверенно, может чрезмерно склонять людей к определённому варианту, а чрезмерно уклончивая модель будет лишь раздражать тех, кто попытается ею воспользоваться.
Изменение работы институтов. Институты часто считают одобрение эксперта свидетельством независимого суждения. По мере того как ИИ выполняет всё больше работы, это предположение становится всё менее надёжным. Организациям нужно осознанно определить, в каких решениях требуется собственное обоснованное суждение человека, и предоставить людям время и ресурсы, чтобы его сформировать. Суждение также зависит от навыков, и люди, переставшие принимать такие решения, могут утратить способность к этому. По мере роста возможностей моделей институтам потребуется чёткая стратегия определения роли людей и развития их навыков. Даже при наличии чрезвычайно мощных систем ИИ институты могут захотеть сохранить человеческие навыки и надзор ради безопасности и устойчивости или потому, что считают их ценными сами по себе.
Возможно, не существует единственно правильного распределения труда между людьми и ИИ. Одни решения можно спокойно передать ИИ, другие стоит оставить за человеком. При наличии подходящих инструментов мы сможем сами выбрать, как разделить эту работу, вместо того чтобы незаметно для себя прийти к такому распределению.
Авторы и благодарности
Благодарности
Работой над проектом руководили Amaç Herdağdelen, Hailey Joren и Alex Tamkin. Редакционную поддержку при подготовке этой публикации в блоге оказали Tom Chivers и Arjun Panickssery.
Мы хотели бы поблагодарить Joe Benton, Mojmir Stehlik и Avery Griffin, благодаря которым этот проект стал возможен в рамках программы Anthropic Fellows. Также мы благодарим Matthew Jörke, Onur Altındağ и Vishakh Padmakumar за отзывы о дизайне эксперимента.
Цитирование
@misc{herdagdelen2026judgmentcalls,
  author = {Herdağdelen, Amaç and Joren, Hailey and Tamkin, Alex},
  title = {How AI agents shape experts’ judgment calls},
  year = {2026},
  howpublished = {Anthropic Research},
  url = {https://www.anthropic.com/research/agents-judgment-calls}
}
Полный текст статьи читайте на Anthropic
