Claude Opus 4.1

Сегодня мы выпускаем Claude Opus 4.1 — обновление для Claude Opus 4, направленное на улучшение работы с агентными задачами, написания кода в реальных условиях и рассуждений. В ближайшие недели мы планируем выпустить значительно более масштабные улучшения для наших моделей.
Opus 4.1 теперь доступен платным пользователям Claude и в Claude Code. Он также доступен через наш API, Amazon Bedrock и Google Cloud Vertex AI. Цены остались прежними, как у Opus 4.
Claude Opus 4.1
Opus 4.1 повышает наши передовые показатели в написании кода до 74,5% на бенчмарке SWE-bench Verified. Он также улучшает навыки глубоких исследований и анализа данных Claude, особенно в части отслеживания деталей и агентного поиска.
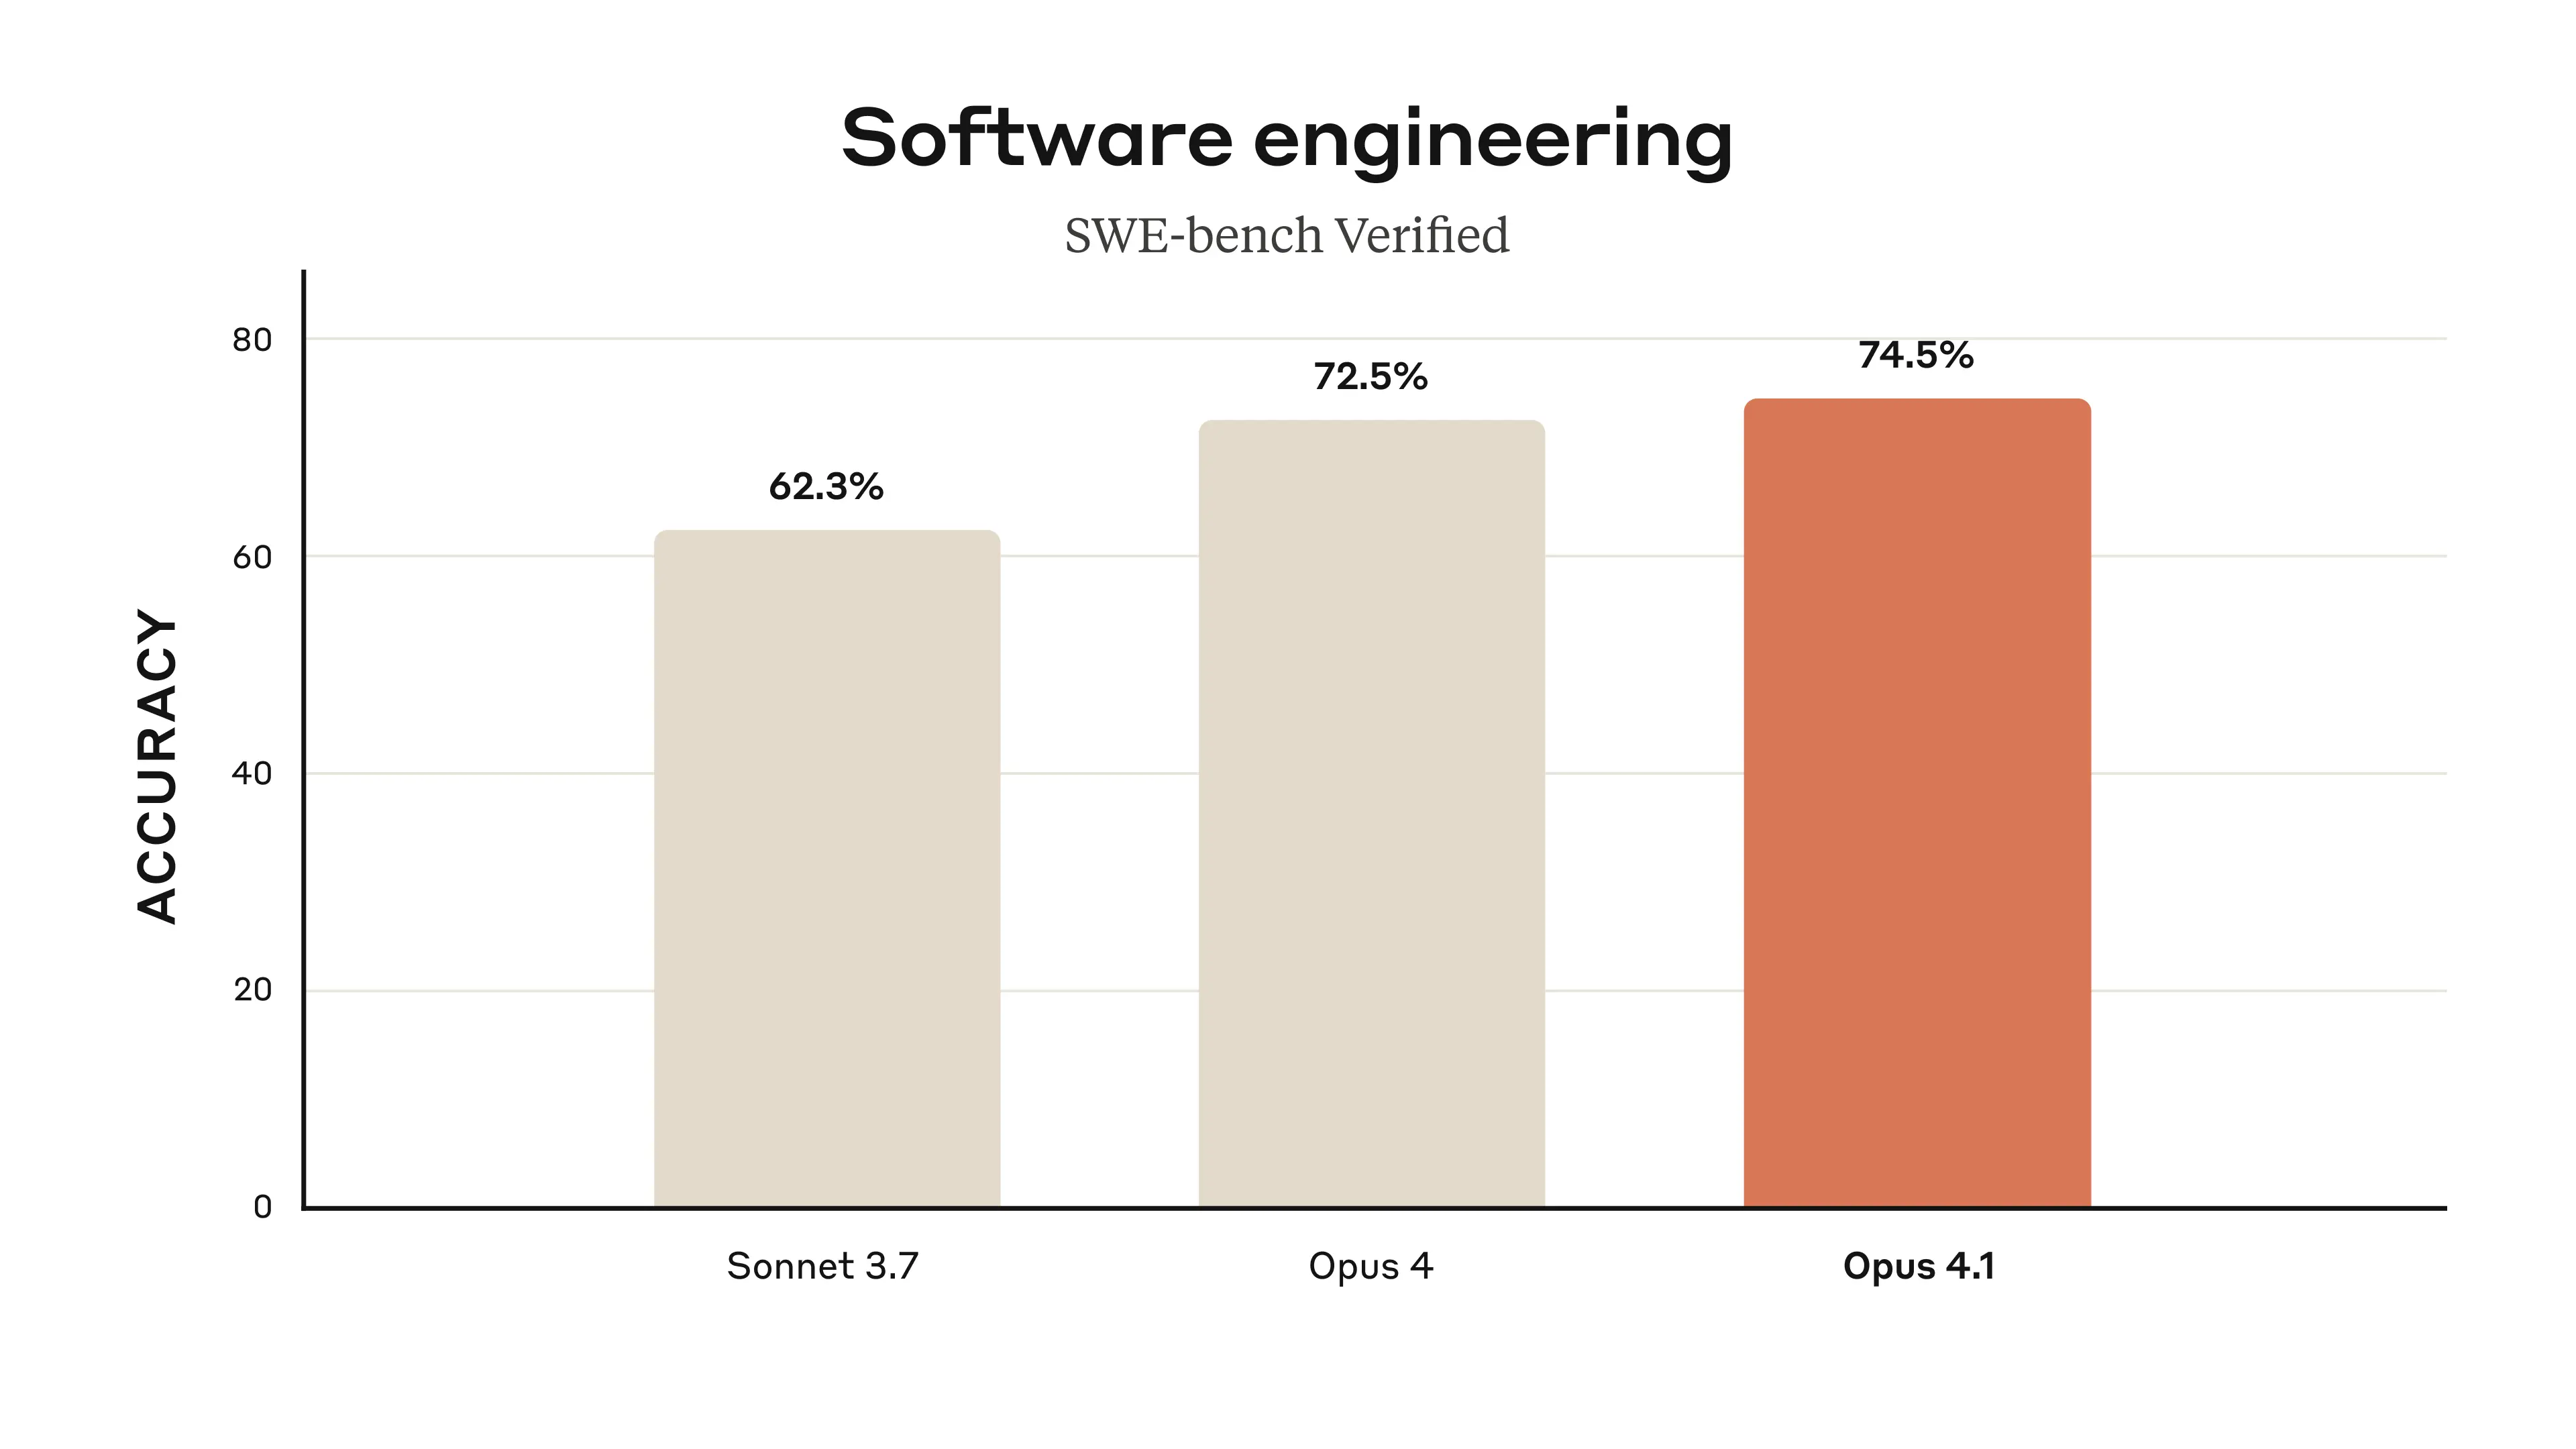
В GitHub отмечают, что Claude Opus 4.1 демонстрирует улучшение почти по всем возможностям по сравнению с Opus 4, с особенно заметным приростом производительности при рефакторинге кода в нескольких файлах. Компания Rakuten Group обнаружила, что Opus 4.1 превосходно справляется с точным определением исправлений в крупных кодовых базах без внесения лишних изменений или ошибок, и их команда предпочитает использовать эту точность в повседневных задачах по отладке. В Windsurf сообщают, что Opus 4.1 обеспечивает улучшение на одно стандартное отклонение по сравнению с Opus 4 в их бенчмарке для начинающих разработчиков (junior developer), что демонстрирует примерно такой же скачок производительности, как переход от Sonnet 3.7 к Sonnet 4.
Начало работы
Мы рекомендуем обновиться с Opus 4 до Opus 4.1 для всех сценариев использования. Если вы разработчик, просто используйте claude-opus-4-1-20250805 через API. Вы также можете ознакомиться с нашей системной картой (system card), страницей модели, страницей цен и документацией, чтобы узнать больше.
Как всегда, ваши отзывы помогают нам становиться лучше, особенно в то время как мы продолжаем выпускать новые и еще более мощные модели.
Приложение
Источники данных
- OpenAI: публикация о запуск о3, системная карта o3
- Gemini: карта модели 2.5 Pro
- Claude: публикация о запуске Sonnet 3.7, публикация о запуске Claude 4
Отчеты о бенчмарках
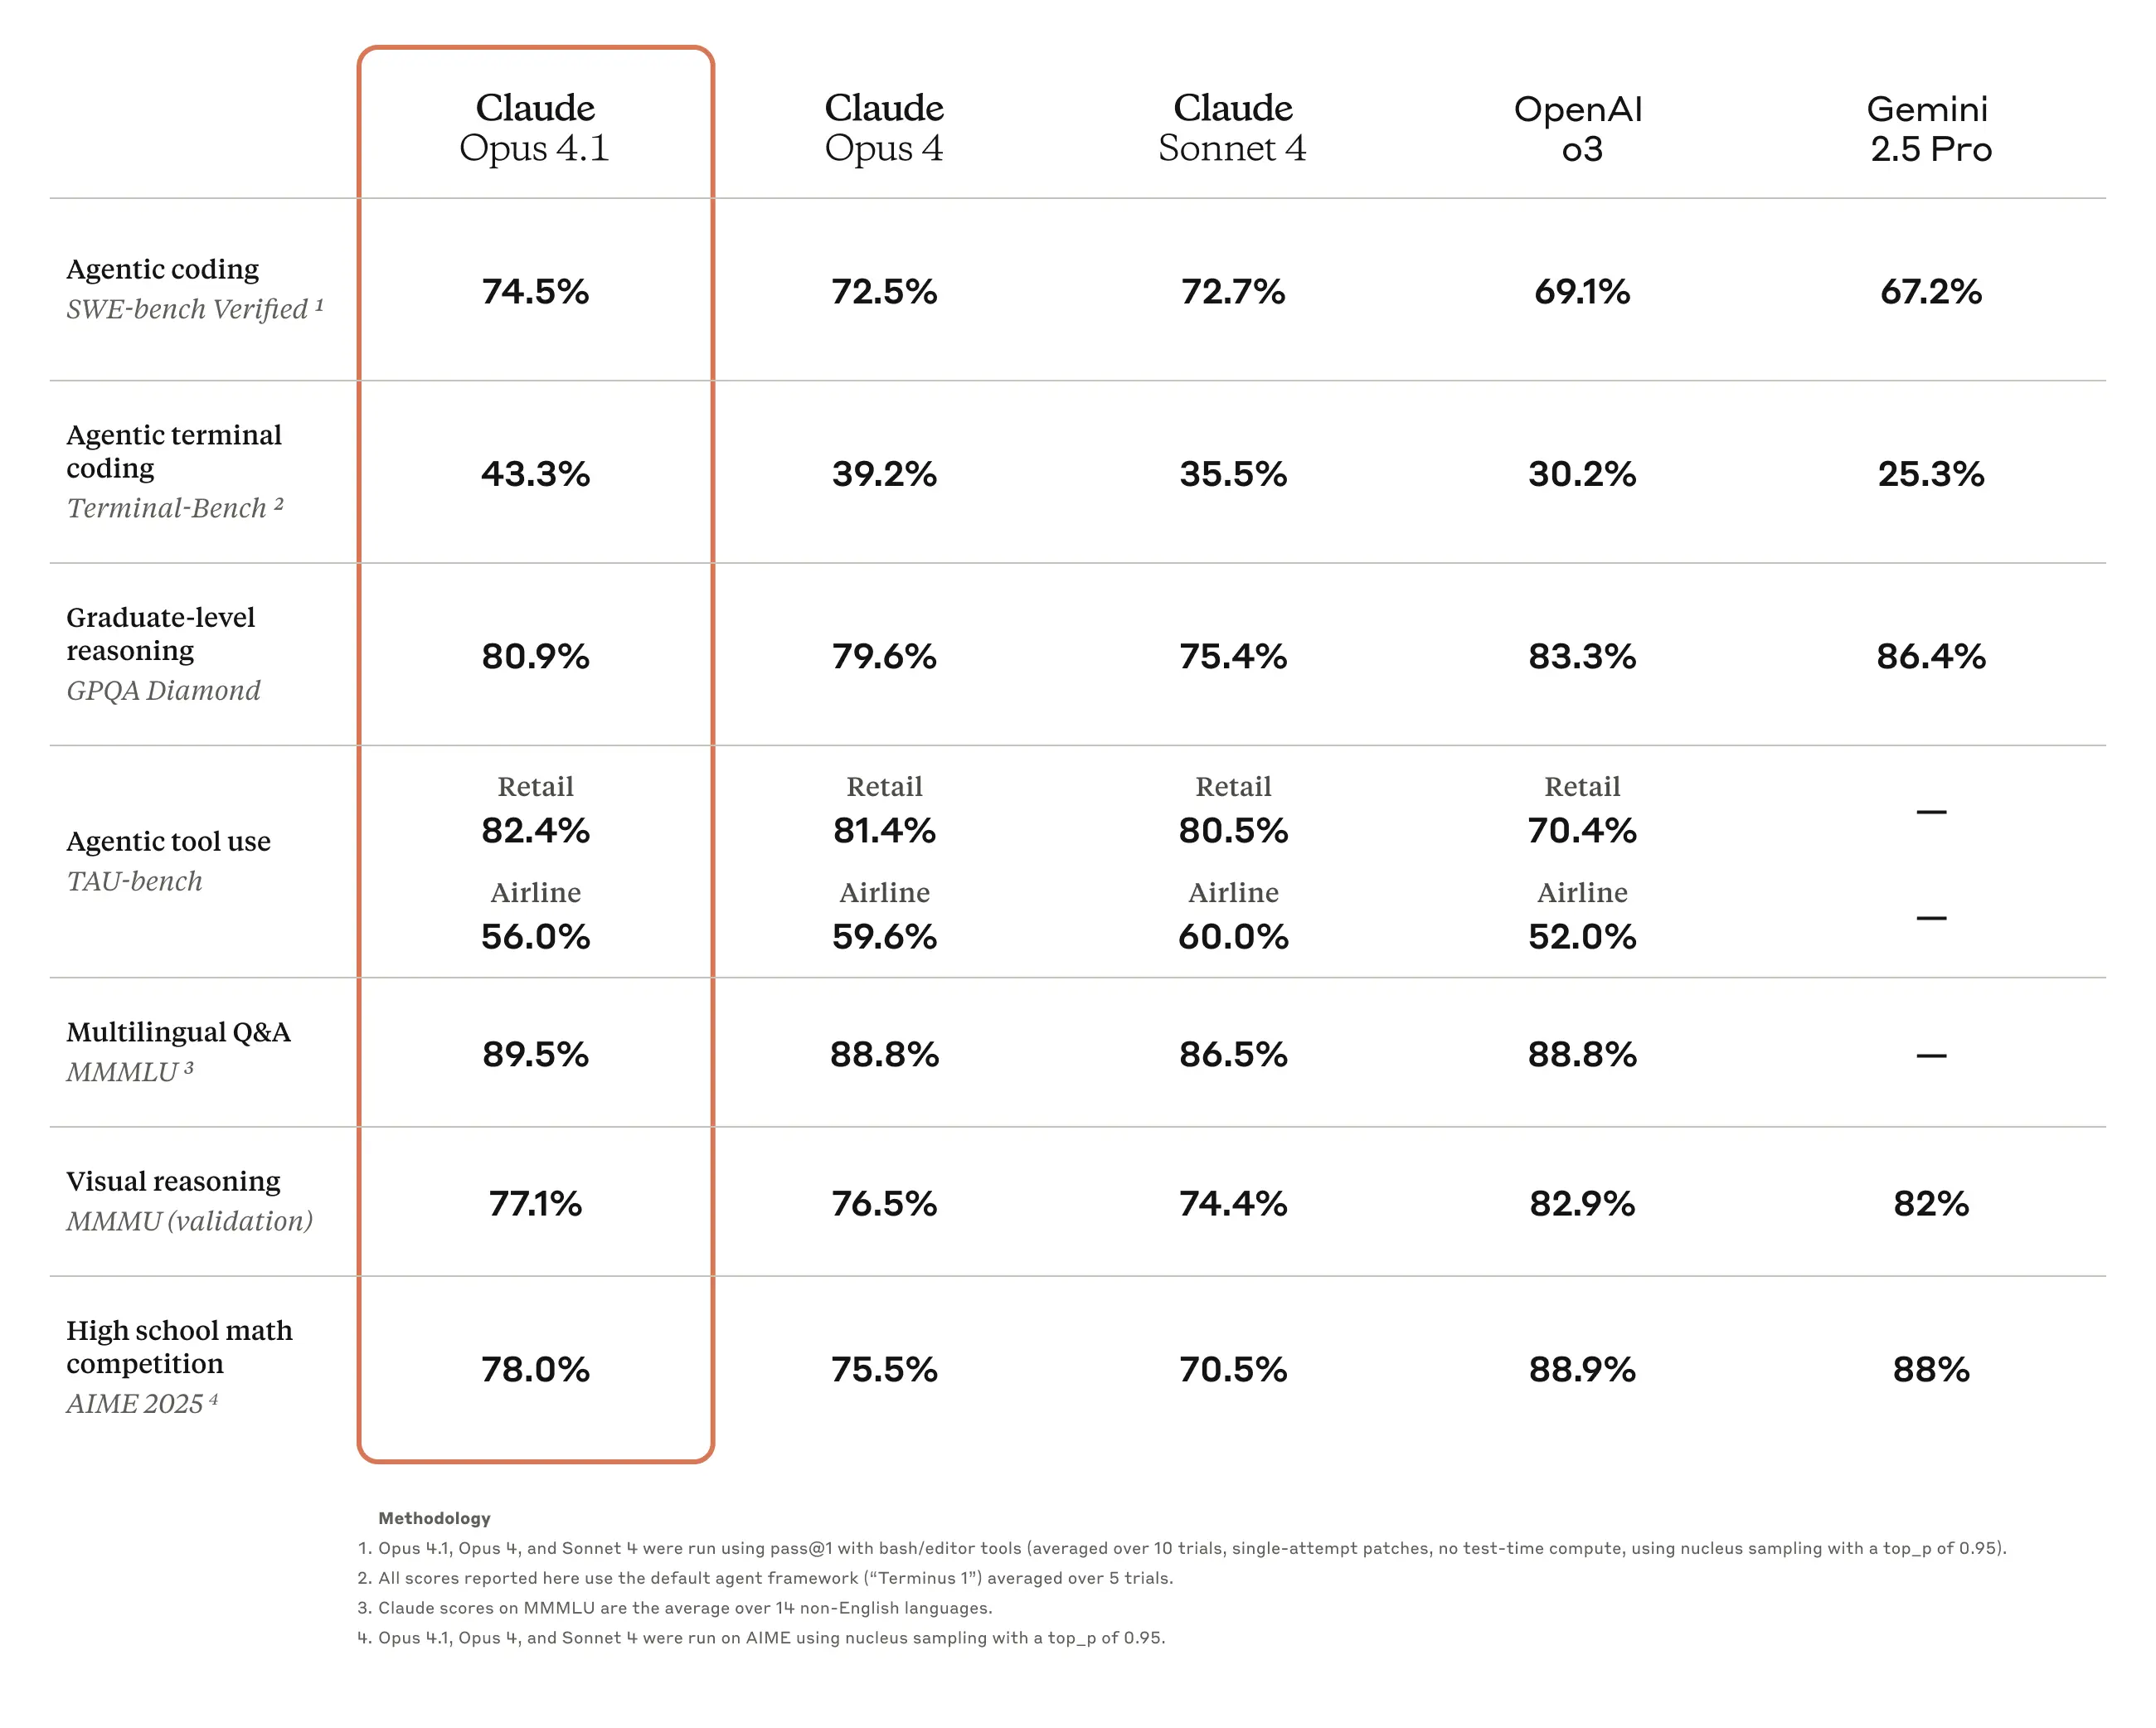
Модели Claude являются гибридными моделями рассуждения. Результаты бенчмарков, приведенные в этой записи блога, отображают наивысшие показатели, достигнутые как с расширенным режимом мышления, так и без него. Ниже для каждого результата мы указали, использовался ли расширенный режим мышления:
- Без расширенного режима мышления: SWE-bench Verified, Terminal-Bench
- Следующие бенчмарки были протестированы с использованием расширенного режима мышления (до 64 тыс. токенов): TAU-bench, GPQA Diamond, MMMLU, MMMU, AIME
Методология TAU-bench
Баллы были получены с помощью добавления к промпту для политик агентов как авиакомпаний, так и розничной торговли инструкций для Claude лучше использовать свои способности к рассуждению при задействовании расширенного мышления в сочетании с инструментами. Модели рекомендуется записывать свои мысли по мере решения задачи отдельно от нашего обычного режима мышления в ходе многошаговых траекторий, чтобы наилучшим образом задействовать ее способности к рассуждению. Чтобы учесть дополнительные шаги, которые предпринимает Claude при задействовании расширенного мышления, максимальное количество шагов (подсчитываемых по завершениям модели) было увеличено с 30 до 100 (большинство траекторий завершалось менее чем за 30 шагов, и лишь одна траектория превысила 50 шагов).
Методология SWE-bench
Для семейства моделей Claude 4 мы продолжаем использовать ту же простую оболочку (scaffold), которая наделяет модель исключительно двумя инструментами, описанными в наших предыдущих релизах здесь — инструментом bash и инструментом редактирования файлов, работающим посредством замен строк. Мы больше не включаем третий «инструмент планирования», который использовался в Claude 3.7 Sonnet. Для всех моделей Claude 4 мы указываем результаты по полному набору из 500 задач. Результаты для моделей OpenAI приводятся по подмножеству из 477 задач.
Полный текст статьи читайте на Anthropic
