PrivacyLib: инструменты контроля конфиденциальности на границе доступа к данным
- PrivacyLib работает в клиентских компонентах сотен систем Meta и выполняет миллиарды проверок каждую секунду.
- Систему интегрируют один раз, а новые требования добавляют модулями; раньше их внедрение во всех системах могло занимать месяцы.
- Контекст ИИ-агента связывает доступ к данным с сессией, чтобы модули отслеживали использование и блокировали недопустимые операции.
Почему это важно: PAI контролирует потоки данных на уровне инфраструктуры, поскольку ручные проверки могут устаревать по мере изменений систем.
- В этом подробном разборе инфраструктуры Meta с учётом требований конфиденциальности (PAI) мы рассмотрим PrivacyLib.
- Требование конфиденциальности должно соблюдаться по мере прохождения данных через разнообразные системы хранения и обработки Meta. Раньше для поддержки нового требования одну и ту же логику контроля приходилось отдельно внедрять в каждой системе. PrivacyLib заменяет этот подход общей библиотекой, которая работает внутри клиентских компонентов систем хранения и обработки данных Meta.
- Система интегрируется с PrivacyLib один раз, а новые возможности для защиты конфиденциальности подключаются в виде модулей, использующих эту интеграцию. PrivacyLib выполняет миллиарды проверок каждую секунду, а изменения сначала моделируются, а затем развёртываются отдельно для каждого модуля.
- У внутренних ИИ-агентов пути доступа к данным могут быть заранее неизвестны, поэтому вызовы инструментов на поддерживаемых путях передают в PrivacyLib контекст агента. Этот контекст связывает каждый доступ с соответствующей сессией, позволяя модулям отслеживать использование данных и блокировать недопустимые операции.
В Meta многие требования конфиденциальности в конечном счёте сводятся к одному вопросу: можем ли мы доказать, что данные попадают только туда, куда им разрешено? При масштабах Meta нельзя полагаться исключительно на ручные проверки конфиденциальности: по мере изменений в системах их результаты могут устаревать. Чтобы ответить на этот вопрос непосредственно на уровне инфраструктуры, мы разработали инфраструктуру Meta с учётом требований конфиденциальности (PAI). PAI предоставляет встроенные в инфраструктуру Meta эффективные и надёжные механизмы защиты конфиденциальности, позволяя продуктам быстро развиваться и дальше.
В предыдущих публикациях мы рассказывали о роли понимания данных, происхождения данных и зон политик (нашей технологии контроля информационных потоков) в PAI. Теперь мы подробно рассмотрим PrivacyLib — общую библиотеку, которая работает внутри клиентских компонентов сотен наших систем хранения и обработки данных непосредственно в момент доступа к данным.
PrivacyLib играет важную роль на заключительном этапе общего рабочего процесса PAI: постоянно контролирует потоки данных и обеспечивает соблюдение правил.
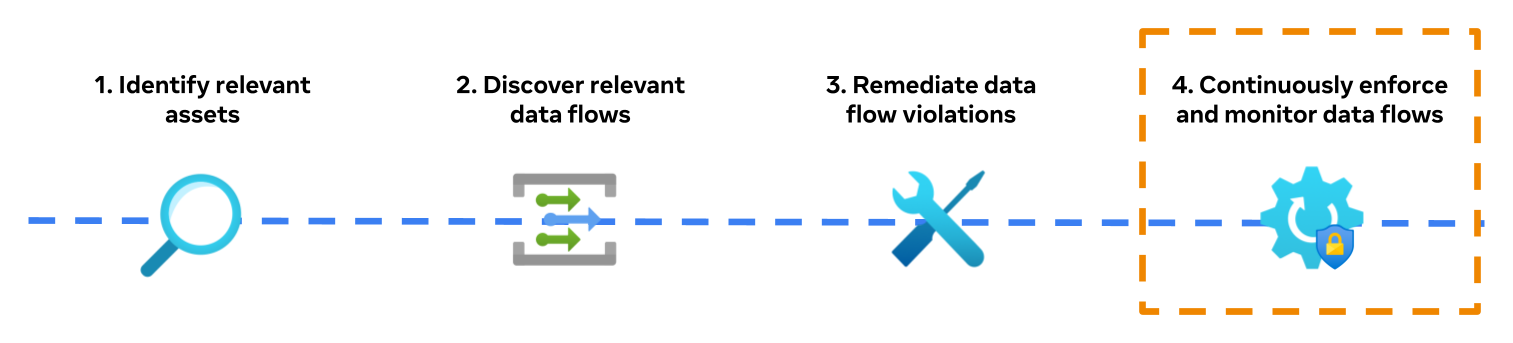 В этой публикации рассматривается роль PrivacyLib на заключительном этапе рабочего процесса PAI.
До появления PrivacyLib мы отдельно встраивали средства контроля конфиденциальности в клиентские компоненты каждой системы хранения и обработки данных для каждого требования. При таком подходе внедрение нового требования во всех системах могло занимать месяцы. Для каждого нового требования — будь то ограничение целей использования или обнаружение потоков данных — требовался один и тот же набор возможностей: охват широкого спектра систем; развёртывание за недели, а не месяцы; проверка каждого обращения к данным без создания проблем с задержками;, а также развёртывание изменений контроля без остановки всего парка систем. Со временем масштабировать этот подход становилось всё труднее по мере развития требований и систем.
PrivacyLib отделяет интеграцию с системой от реализации требований. Каждую систему мы интегрируем один раз. Если требование можно выполнить в момент доступа к данным, мы реализуем его в виде модуля PrivacyLib, общего для уже интегрированных систем. Таким образом, новое требование больше не нужно отдельно внедрять в каждой системе.
Существует два типа модулей:
- Модули контроля могут блокировать доступ к данным. Например, зоны политик обеспечивают соблюдение ограничений на цели использования.
- Модули наблюдения лишь регистрируют обращения к данным. Например, Privacy Probes собирает сигналы во время выполнения, которые используются для обнаружения потоков данных.
Когда внутренние ИИ-агенты стали новым способом доступа к данным, мы также добавили модуль Agent Observability, чтобы отслеживать связанные с агентами события доступа к данным и помогать защищать данные, к которым агенты могут получить доступ. Системы, уже интегрированные с PrivacyLib, получили этот модуль без дополнительной работы по интеграции — именно в этом преимущество однократной интеграции: каждая новая возможность защиты конфиденциальности появляется как модуль, а не как отдельный проект.
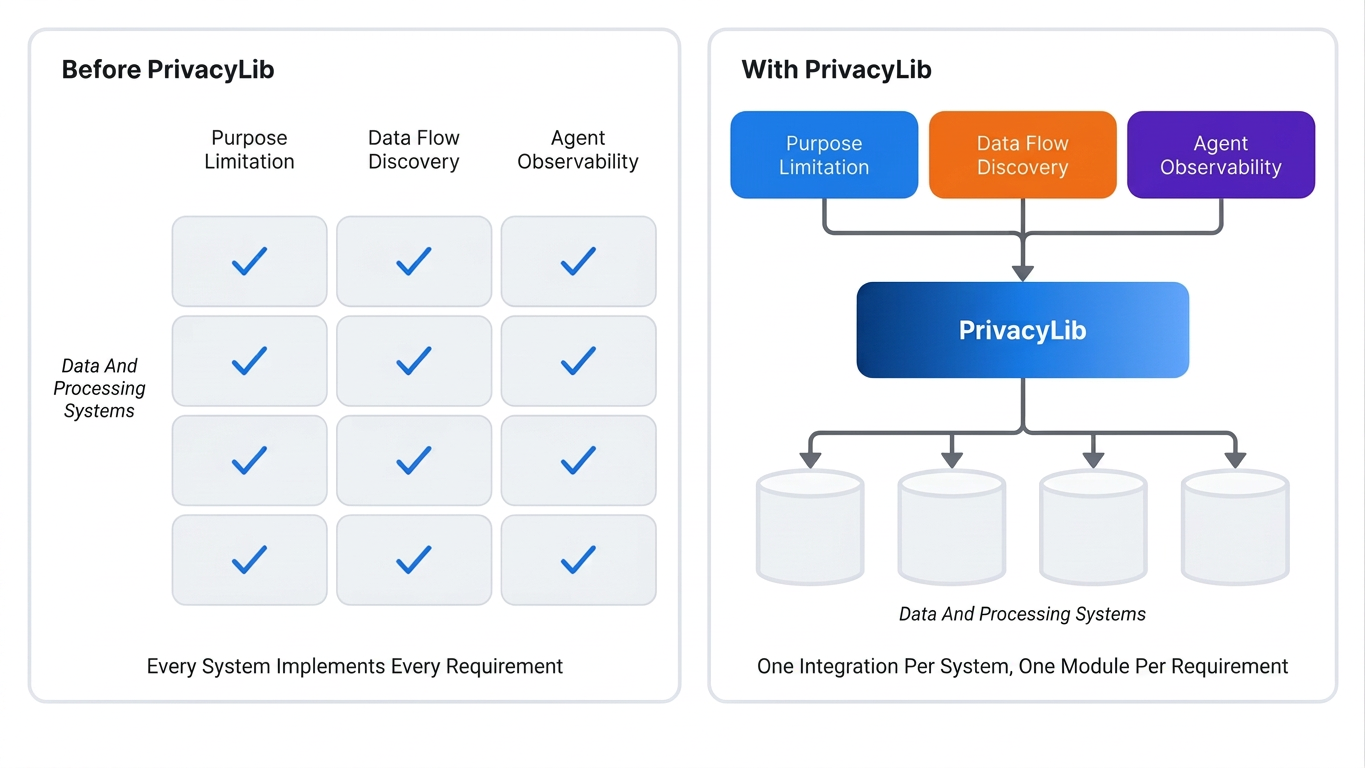 PrivacyLib заменяет многократную реализацию одних и тех же механизмов в разных системах.
Инженерные задачи и подходы PrivacyLib в масштабах Meta
PrivacyLib работает с широким спектром путей доступа к данным в Meta:
- Более сотни библиотек для доступа к сервисам данных — от хранилищ «ключ — значение» до функций на базе ИИ.
- Тысячи производственных сервисов с разными версиями развёрнутой библиотеки.
- Миллионы ресурсов, к которым ежедневно обращаются.
- Миллиарды проверок каждую секунду.
Работа в таких масштабах ставит перед инженерами три задачи:
| Задача | Подход |
|---|---|
| Охват: В системах могут использоваться несколько клиентских библиотек и устаревшие интеграции; они могут принимать прямые сетевые вызовы и предоставлять прямой доступ к базам данных в базовых хранилищах. Необходимо охватить все эти пути, чтобы требования соблюдались независимо от способа доступа. | Мы выполняем интеграцию на двух уровнях: в типизированных клиентских библиотеках, где PrivacyLib получает полный контекст запроса, и на нижележащих сетевых границах для оставшихся путей RPC — так мы обеспечиваем полный охват. Каждая интегрированная система сопоставляет собственные API с общими операциями PrivacyLib и предоставляет входные данные, необходимые настроенным модулям. Когда эти компоненты готовы, один и тот же модуль можно включить в нескольких системах без отдельной интеграции для каждой из них. |
| Масштаб: При миллиардах проверок в секунду даже небольшие вычислительные затраты на одну проверку становятся существенными для всего парка систем. Эти затраты несёт каждый сервис на критическом пути. | Мы преобразуем требования во время сборки в простейшую форму, пригодную для вычисления, а большинство проверок выполняем с помощью кэшей внутри процесса, чтобы избежать сетевых вызовов на наиболее распространённом пути. |
| Надёжность: Логика защиты конфиденциальности работает на критическом пути важнейших систем, которыми управляют команды с собственными графиками выпусков. Изменения должны поддаваться изолированному тестированию и отдельному откату, поскольку откат всего парка систем не может быть способом восстановления. | Механизмы контроля развёртываются в составе сервиса, за который они отвечают, поэтому изменения попадают в производственную среду через собственный конвейер этого сервиса, а не посредством общей для всего парка систем рассылки конфигурации. |
Разбор на примере: защита метаданных сообщений
Чтобы показать, как всё это работает в масштабах Meta, рассмотрим требование конфиденциальности, которое необходимо соблюдать при обработке метаданных сообщений.
Пользователи обмениваются сообщениями в таких приложениях, как Messenger, где поддерживается сквозное шифрование. Маршрутизируя и доставляя эти сообщения с учётом применимого законодательства, внутренние системы Messenger обрабатывают данные о сообщениях, не включающие их содержимое (то есть метаданные сообщений), например сведения о времени отправки и доставки сообщений, чтобы повышать производительность продукта, выявлять злоупотребления и защищать пользователей от вредоносного поведения.
Ряд этих внутренних сервисов использует Logger — клиентскую библиотеку, работающую в процессе сервиса, — чтобы записывать эти метаданные в таблицы хранилища данных. Перед записью записи интеграция PrivacyLib внутри Logger вызывает Policy Zones — модуль контроля, который проверяет, разрешено ли передавать метаданные в целевую таблицу. Эта проверка состоит из двух частей: какие входные данные должны быть доступны для принятия решения и как именно проверка выполняется во время работы. Рассмотрев эти части, мы расскажем, как PrivacyLib масштабируется на разные системы и как развёртывать изменения, не нарушая работу сервисов на этом пути.
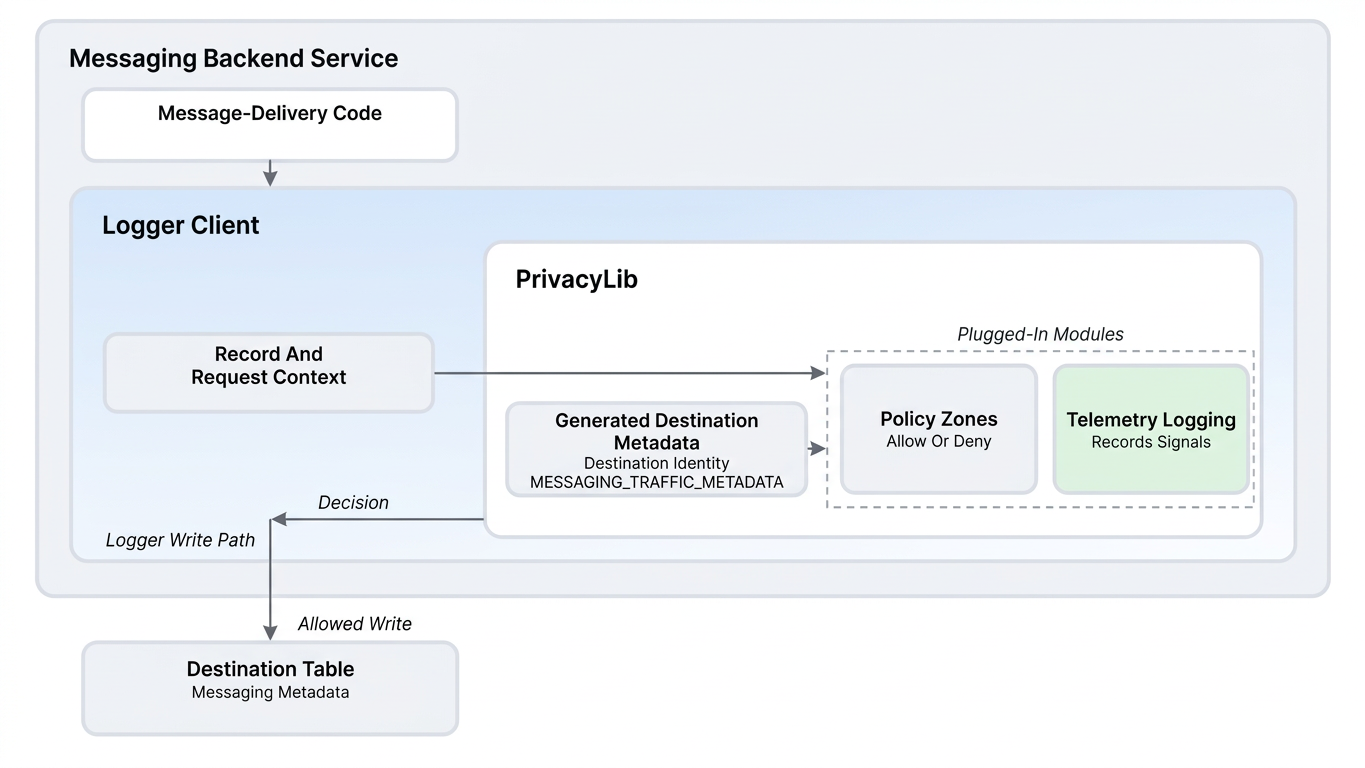 PrivacyLib работает внутри клиентского компонента Logger в сервисе внутренней системы обработки сообщений. Библиотека объединяет контекст запроса с метаданными целевого ресурса, сформированными автоматически, вызывает модули, настроенные для записи, и возвращает Logger решение о применении контроля.
Добавление аннотаций к метаданным сообщений
Для каждой целевой таблицы Logger существует LoggerConfig, описывающий записи, которые в неё помещаются. MetadataTraceLoggerConfig задаёт одну из таких конфигураций для трассировок доставки сообщений и помечает их как содержащие метаданные сообщений:
final class MetadataTraceLoggerConfig extends LoggerConfigBase {
  use MessagingTrafficMetadataPolicyTrait;
  public function configure(
    LoggerFieldDefiner $fd,
  ): LoggerFieldDefiner {
    $this->annotateWithTableLevelPolicy();
    // Field and destination definitions
  }
}
В целевую таблицу для журналирования могут записывать данные многие компоненты, поэтому аннотация с описанием выходных данных должна относиться к целевой таблице, а не к каждому сервису, который в неё записывает данные. Если бы каждый сервис отдельно объявлял такую аннотацию, объявления могли бы различаться, а новый компонент записи мог бы вовсе её пропустить. Объявление в LoggerConfig позволяет всем компонентам использовать одно и то же описание данных.
Для этой целевой таблицы MessagingTrafficMetadataPolicyTrait задаёт аннотацию уровня таблицы MESSAGING_TRAFFIC_METADATA, а annotateWithTableLevelPolicy() добавляет её к целевой таблице.
LoggerConfig — это собственная схема Logger, и каждая система описывает данные в своём формате. Чтобы предоставить PrivacyLib единый формат, конвейер генерации кода Logger преобразует конфигурацию в артефакт, совместимый с PrivacyLib. Сгенерированный MetadataTraceLoggerConfigPrivacyLibArtifact создаётся на основе MetadataTraceLoggerConfig и содержит идентификатор целевого ресурса и аннотацию метаданных сообщений:
/**
 * @codegen-source MetadataTraceLoggerConfig
 */
class MetadataTraceLoggerConfigPrivacyLibArtifact
  extends LoggerInputPrivacyLibArtifact {

  final public static function getAssetIDImpl(
  ): LoggerInputAssetID {
    return LoggerInputAssetID::get(
      'MetadataTraceLoggerConfig',
    );
  }

  protected static function getPurposePolicyVars(
  ): TPurposePolicyVars {
    return PurposePolicy::makeVars(
      TPurposePolicyName::MESSAGING_TRAFFIC_METADATA,
    );
  }

  // Other generated fields omitted.
}
Показанный выше сгенерированный класс используется клиентским компонентом Logger на языке Hack — типизированном языке Meta на основе PHP. Для клиентов на C++ и Python Logger публикует идентификаторы целевых ресурсов и аннотации в централизованный каталог. PrivacyLib использует эту информацию для генерации артефактов для конкретных языков. В примере на C++ в следующем разделе PrivacyLib использует имя LoggerConfig, чтобы загрузить артефакт C++ для целевого ресурса.
Выполнение проверки
Артефакт из предыдущего раздела описывает одну целевую таблицу Logger. PrivacyLib также должна знать, что означает операция записи Logger и какие модули нужно запустить. Интеграция Logger с Hack задаёт это один раз для всех целевых таблиц:
$config->libraryConfig()->enablePrivacyLib(
  PrivacyLibOperation::write()
    ->input(
      PrivacyLibInput::instance(
        nameof ILoggerInputPrivacyLibPayloadProvider,
      ),
    )
    ->enforcements(
      PrivacyLibWriteEnforcement::zones(
        ZoneDataType::LOGGER,
      )
        ->withPropagation()
        ->enabled(),
      PrivacyLibWriteEnforcement::telemetryLogging()->enabled(),
      // Other modules
    ),
);
PrivacyLibOperation: write () объявляет операцию записи Logger для PrivacyLib, а enforcements () перечисляет запускаемые модули. Модуль Policy Zones может повлиять на результат, а модуль Telemetry Logging регистрирует результаты проверки, не влияя на них. Добавление модуля здесь не требует изменений отдельных целевых таблиц или мест вызова Logger. ZoneDataType: LOGGER указывает Policy Zones, что проверяется целевая таблица Logger.
В сервисах на C++ Logger формирует запрос PrivacyLib следующим образом:
const auto assetList =
      std::vector{configName};

PrivacyLibBuilder builder(
      "LOGGER_WRITE_CLIENT",
      assetList,
      LoggerWriteAPIEnumHelper::apiToHashedString(
          PolicyEnforcedLoggerWriteAPI::log),
      Caller::LOGGER,
      getLoggerWriteImplementation());

auto result =
      PrivacyLibRequest(std::move(builder)).dispatch();
PrivacyLib использует configName, чтобы загрузить артефакт целевого ресурса. Хешированное значение PolicyEnforcedLoggerWriteAPI: log сопоставляет API Logger с операцией записи PrivacyLib. Остальные аргументы построителя указывают, что вызывающей стороной является Logger, и предоставляют реализацию, выполняющую запись. Метод dispatch () вызывает настроенные модули и регистрирует их результаты. Для модуля Policy Zones PrivacyLib предоставляет аннотации целевого ресурса из сгенерированного артефакта и текущий контекст обработки. В этом примере Policy Zones проверяет два условия:
- Текущий контекст соответствует разрешённому использованию метаданных сообщений.
- Артефакт целевого ресурса содержит аннотацию MESSAGING_TRAFFIC_METADATA .
Если контроль включён, модуль Policy Zones запрещает запись, когда хотя бы одно из условий не выполнено. PrivacyLib объединяет результаты модулей контроля в один ответ. Отказ останавливает запись до того, как Logger отправит запись дальше по цепочке. Модули наблюдения передают телеметрию, не влияя на ответ.
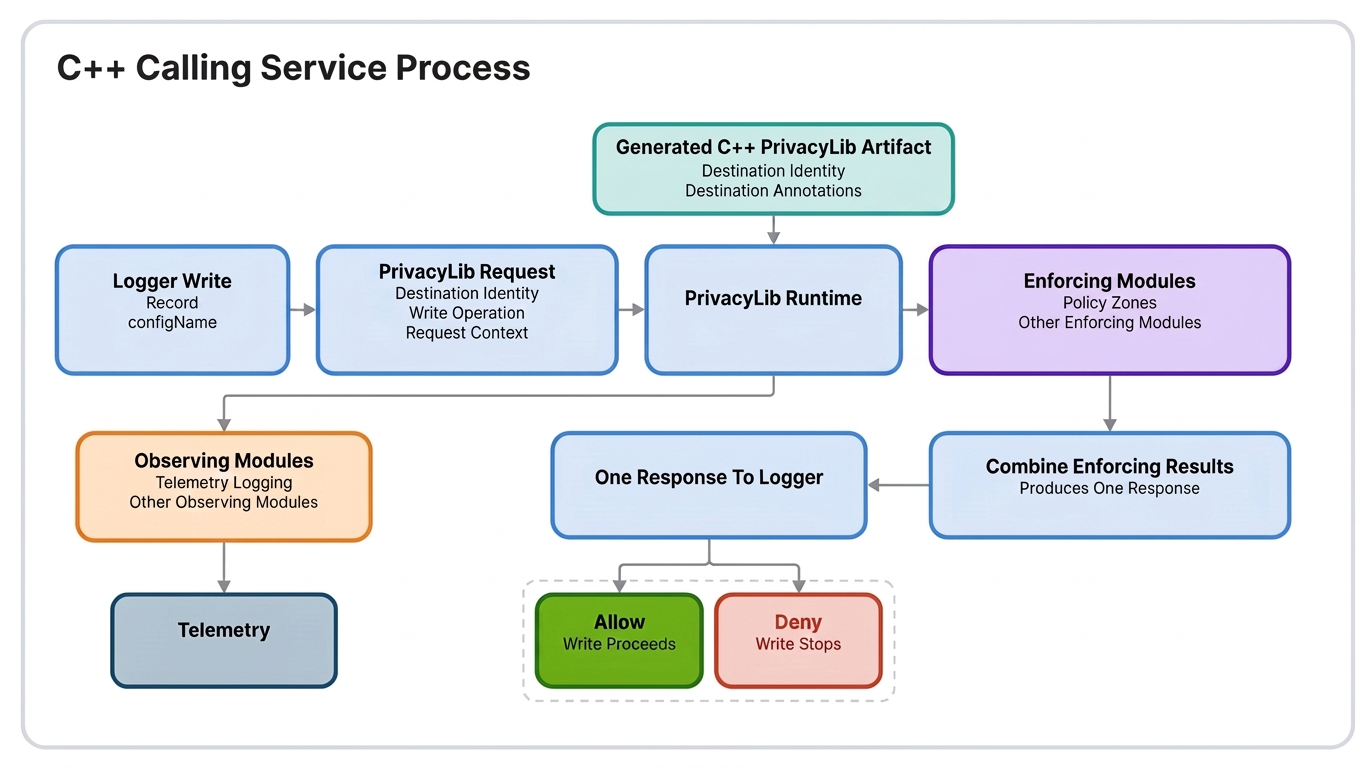 Подробный разбор работы модулей при записи через Logger.
Масштабирование проверок конфиденциальности на разные системы
PrivacyLib обеспечивает масштабирование проверок конфиденциальности на неоднородные системы благодаря общей модели выполнения, малозатратным проверкам и сбору телеметрии, а также охвату запросов, обходящих интегрированные клиентские компоненты.
Общая модель выполнения для разных систем
Интеграции PrivacyLib охватывают системы с совершенно разными API: хранилища «ключ — значение», графовые базы данных, конвейеры машинного обучения, файловые системы и системы журналирования, например Logger. Каждая интеграция сопоставляет точки доступа с одной из пяти общих операций, а PrivacyLib вызывает соответствующие модули при выполнении каждой из них:
- Чтение: выполняется при получении данных.
- Запись: выполняется при сохранении данных.
- RPC: выполняется при вызове другого сервиса.
- Начало обработки запроса: выполняется один раз, когда сервис начинает обрабатывать запрос.
- Встроенное выполнение: оборачивает отдельное вычисление в рамках более крупного запроса, например вычисление признака. Доступ к данным во время этого вычисления проверяется с учётом его встроенного контекста конфиденциальности.
Модули работают с этими пятью операциями, а не с собственными API каждой системы. Для чтения, записи и RPC также предусмотрены варианты, выполняемые после операции, поэтому модули наблюдения могут запускаться после принятия решения о доступе. Как только система предоставляет нужное сопоставление, его могут использовать все совместимые модули. Именно поэтому подключение дополнительного модуля к уже интегрированной системе занимает всего несколько дней.
PrivacyLib работает внутри клиентских компонентов систем хранения и обработки данных, поскольку именно там уже доступны идентификатор целевого ресурса и контекст запроса, необходимые модулям. Проверка в том же процессе избавляет от необходимости передавать эти входные данные между процессами при каждом обращении. Такой подход даёт ещё два преимущества:
- Более полный контекст: PrivacyLib может использовать идентификатор вызывающей стороны, конечную точку и цель использования, пока эта информация ещё доступна. При выполнении проверки на уровне хранилища данных эти сведения часто теряются.
- Изоляция сбоев: Ошибка в изменении ограничивается сервисом, в котором запущена эта версия кода, а общее хранилище данных остаётся за пределами зоны сбоя.
Снижение вычислительных затрат на проверки
Проверки внутри процесса также должны быть эффективными с вычислительной точки зрения, поскольку они выполняются при каждом обращении к данным. Кэши на время обработки запроса устраняют повторные проверки в рамках одного запроса, а кэши на уровне хоста сохраняют часто используемые конфигурации и результаты. Это позволяет не обращаться к удалённому источнику конфигурации, как требовалось в более ранней реализации: уже один такой запрос был в тысячи раз медленнее локальной проверки внутри процесса. В результате PrivacyLib выполняет миллиарды проверок в секунду по всему парку систем с низкой задержкой на одну проверку, используя лишь небольшую долю общих вычислительных ресурсов Meta.
Сбор телеметрии тоже должен быть малозатратным при масштабах PrivacyLib. PrivacyLib записывает статус каждого модуля, выборочно измеряет задержку и регистрирует ошибки, давая нам возможность следить за работой механизмов контроля в производственной среде по всему парку систем. Подробная регистрация каждого вызова перегрузила бы системы, принимающие эти события. Поэтому наша задача — устранять дублирование повторяющихся событий, не теряя при этом редкие.
Для этого вместе работают два механизма: фильтры Блума на каждом хосте с фиксированной частотой отбирают данные для высокочастотных шаблонов, а частоты детализированной выборки корректируются по мере изменения трафика.
Охват прямых путей RPC
Не все вызывающие компоненты обращаются к данным через интегрированную с PrivacyLib клиентскую библиотеку — некоторые выполняют прямые вызовы RPC. Уровень RPC всё равно может проверять такие запросы, но ему доступно гораздо меньше контекста, чем клиенту. PrivacyLib устраняет этот разрыв с помощью криптографически подписанного токена: когда проверка на стороне клиента завершается успешно, PrivacyLib добавляет токен к запросу, а ServiceRouter проверяет его на нижележащей границе для поддерживаемого RPC-трафика, подтверждая, что запрос уже прошёл более полную проверку на стороне клиента.
Если запрос поступает на уровень RPC без токена, ServiceRouter выполняет менее детальную проверку, опираясь только на контекст, видимый в сетевых данных. Поскольку этот контекст ограничен, нижележащий уровень применяет наиболее строгую трактовку, предпочитая ложноположительные результаты пропускам. Вместе эти два уровня охватывают доступ через клиенты, управляемые Meta, и поддерживаемые пути RPC. Пути за пределами этих границ данный механизм не охватывает — для них требуется собственная интеграция с PrivacyLib.
В результате проверки выполняются локально и с небольшими вычислительными затратами везде, где это возможно; там, где локальная проверка недоступна, действует менее детальный резервный механизм. При этом модули получают единое место выполнения в системах, которые в остальном не имеют ничего общего. Остаётся более сложный операционный вопрос: как менять поведение механизмов контроля, не нарушая текущий трафик и не принимая ошибочных решений о доступе.
Безопасное развёртывание изменений механизмов контроля
Требования конфиденциальности со временем меняются. Обновление аннотации целевого ресурса или модуля контроля может повлиять на то, разрешена ли запись. Для обоих типов изменений в PrivacyLib предусмотрен безопасный процесс развёртывания.
Изменение аннотации
Чтобы добавить или удалить аннотацию, нужно изменить две строки в LoggerConfig: объявление, импортирующее MessagingTrafficMetadataPolicyTrait, и вызов annotateWithTableLevelPolicy (). Поскольку у целевого ресурса может быть много компонентов записи, эта правка из двух строк может одновременно начать блокировать записи из множества сервисов.
Поэтому процесс проверки построен так, чтобы автор и рецензенты могли понять, к каким последствиям на практике приведёт изменение. Во время проверки кода конвейер генерации кода Logger обновляет артефакт PrivacyLib для целевого ресурса. Затем моделирование воспроизводит наблюдавшиеся потоки данных на основе как нового, так и существующего артефакта и сообщает обо всех потоках, для которых изменился результат. Исходное изменение, сгенерированный артефакт и результаты моделирования рассматриваются вместе, поэтому решение принимается на основании данных о последствиях изменения, а не только чтения кода. Если моделирование выявляет неожиданное изменение, рецензенты приостанавливают выпуск артефакта.
После утверждения артефакт попадает в сервисы через обычный конвейер сборки и развёртывания. До развёртывания изменения доступны два источника информации: моделирование показывает, какие решения изменятся, а сгенерированный код точно демонстрирует, что будет развёрнуто. Кроме того, есть один механизм контроля: каждая служба определяет, когда изменение попадёт в производственную среду, в рамках собственного развёртывания. Это также ограничивает масштаб возможных последствий: если проблема обнаружится после развёртывания, она затронет только сервисы, в которых запущена эта сборка.
Недостаток такого подхода в том, что изменения не доходят до всего парка систем одновременно, поэтому распространяются медленнее, чем при глобальном обновлении конфигурации. На практике ответственные за требования команды ведут учёт и отслеживают обновление сервисов, попадающих в область действия изменений, к установленному сроку. Сервису, которому обновление нужно раньше, можно воспользоваться процедурой экстренного развёртывания.
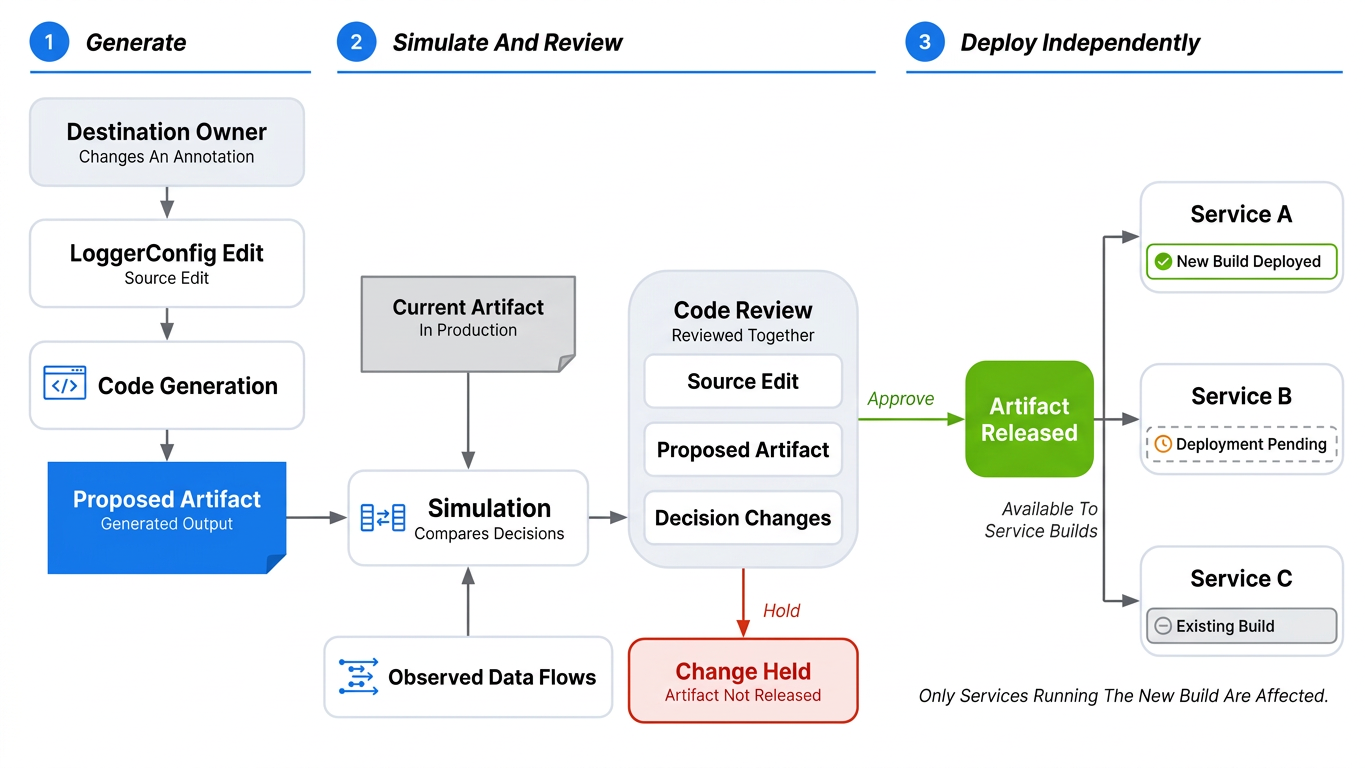 Моделирование выявляет изменения в принимаемых решениях до выпуска, а независимое развёртывание сервисов позволяет выбрать время и ограничить последствия для производственной среды.
Развёртывание модуля
Изменение аннотации применяется к одной целевой таблице Logger. Модуль, добавленный в путь записи Logger, запускается для каждой целевой таблицы Logger. Поэтому прежде, чем включить модуль для всего трафика, мы развёртываем его отдельно.
Рассмотрим, как на этом пути был внедрён Policy Zones. Сначала мы задали для модуля Policy Zones значение rollingOut () в конфигурации операций записи PrivacyLib для Logger:
PrivacyLibWriteEnforcement::zones(ZoneDataType::LOGGER)
    ->rollingOut()
Ключ развёртывания logger.input.write.zones, обозначал сочетание входных данных Logger, операции записи и модуля Policy Zones. rollingOut () поместил выполнение модуля под управление механизма контроля во время работы. Затем мы поэтапно изменяли значение этого механизма с 0 до 100%, отслеживая отказы, ошибки и задержки. Если корректные записи начинали завершаться с ошибкой, мы могли снизить процент без пересборки и повторного развёртывания сервиса. Модуль Telemetry Logging продолжает работать, поскольку настроен независимо.
Когда модуль Policy Zones стабильно заработал на всём трафике Logger, мы заменили в конфигурации rollingOut () на enabled (). После этого интеграция Logger запускала модуль, не сверяясь с процентом развёртывания.
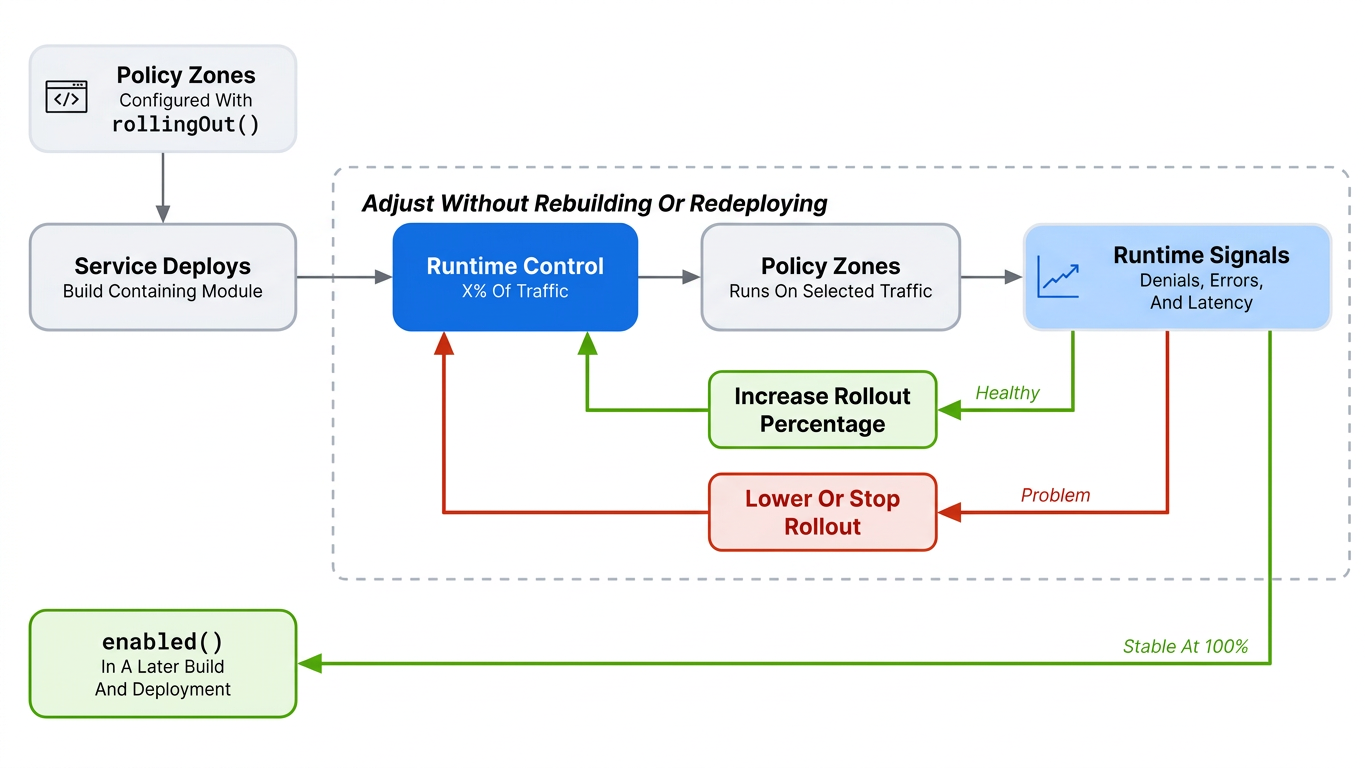 После развёртывания инженеры используют сигналы, поступающие во время работы, чтобы увеличивать или снижать охват модуля либо останавливать его развёртывание без пересборки и повторного развёртывания.
Для двух описанных выше путей изменения на разных этапах предусмотрены защитные механизмы. Если моделирование показывает неожиданные изменения потоков, мы приостанавливаем выпуск артефакта аннотации. Если после начала развёртывания модуль работает некорректно, мы снижаем его процент охвата с помощью механизма контроля во время работы.
Эти механизмы безопасности изменили подход к выполнению требований конфиденциальности в Meta. Теперь PrivacyLib работает внутри клиентских компонентов сотен систем хранения и обработки данных и выполняет миллиарды проверок в секунду, расходуя лишь небольшую долю вычислительных ресурсов Meta. Требования, реализованные поверх этой инфраструктуры, — например, ограничение целей использования с помощью зон политик и обнаружение потоков данных с помощью Privacy Probes — используют уже существующие интеграции вместо того, чтобы создавать их заново. Поэтому подключение модуля к уже охваченным системам занимает дни, а не месяцы, которые раньше требовались для индивидуальных интеграций. Если что-то идёт не так, сбой остаётся внутри сервиса, где развёрнуто изменение. Теперь мы можем использовать эту основу для нового класса задач — ИИ-агентов.
Механизмы контроля PrivacyLib для ИИ-агентов
Поведение ИИ-агентов сложнее анализировать, чем поведение традиционных сервисов: оно динамично, а данные, к которым агенты обращаются, определяются во время работы. Поэтому меры безопасности для агентов нужно продумывать заранее, обеспечивая соблюдение таких правил, как требования Policy Zones, не только в отношении данных, к которым, как мы предполагали при создании агента, он будет обращаться, но и в отношении данных, к которым он пытается получить доступ во время работы. Если такие механизмы включены, они могут блокировать запрещённый доступ до того, как данные будут возвращены.
Агенты вызывают инструменты для выполнения задач. Один вызов инструмента может последовательно пройти через несколько сервисов, прежде чем достичь данных. Чтобы справиться с этой новой задачей, мы создали AgentLib — общую среду выполнения, основанную на принципах проектирования PrivacyLib, — для наблюдения за вызовами инструментов внутренними агентами и управления ими. На поддерживаемых путях AgentLib связывает каждый вызов инструмента с сессией агента, а нижележащие клиенты и сервисы передают этот контекст дальше, пока вызов не достигнет системы, интегрированной с PrivacyLib. На границе доступа к данным PrivacyLib объединяет контекст, запрошенную операцию и аннотации целевого ресурса, а затем передаёт их отдельным модулям для принятия окончательного решения.
В PrivacyLib модуль Agent Observability регистрирует идентификаторы сессии агента и вызова инструмента вместе с целевым ресурсом, клиентским API, точкой интеграции и любыми ошибками. Инженеры могут выполнять поиск по этим событиям, используя идентификатор сессии, чтобы выяснить, какие сервисы и целевые ресурсы участвовали в вызове инструмента. Когда мы внедрили модуль Agent Observability, широкий охват, уже обеспеченный PrivacyLib, позволил нам инструментировать системы, интегрированные с библиотекой, вместо того чтобы вручную встраивать модуль в сотни систем. Даже с помощью ИИ при разработке это было бы чрезвычайно сложной задачей.
Для обеспечения соблюдения некоторых политик мы без изменений использовали существующий модуль Policy Zones, поскольку он опирается на те же входные данные. На путях, где включён этот механизм контроля, перед разрешением операции он учитывает аннотации целевого ресурса и контекст агента. Если Policy Zones блокирует операцию, PrivacyLib передаёт результат обратно по цепочке вызовов в среду агента. Policy Zones выполняет эту проверку даже в том случае, если агент выбирает инструмент, которого разработчик не предусмотрел. Решение о доступе не зависит от того, действует ли агент ожидаемым образом.
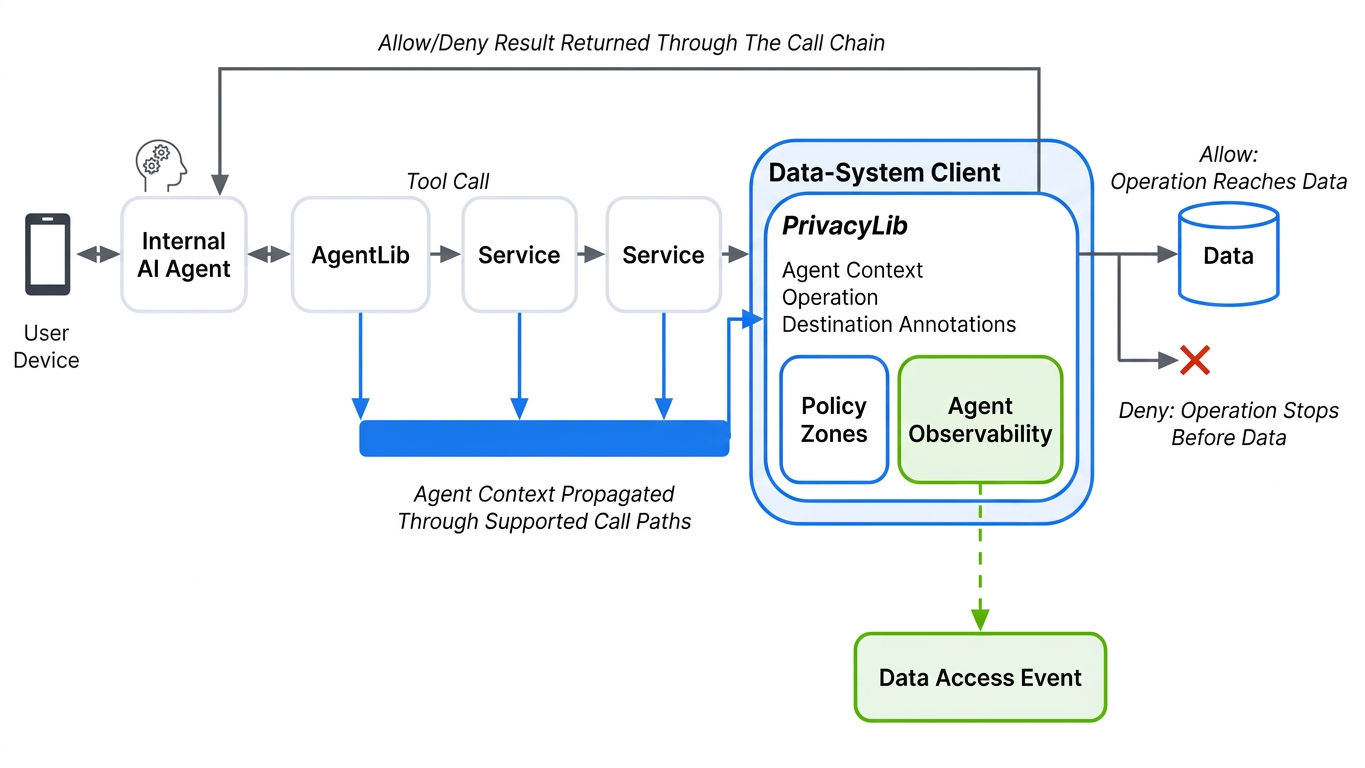 AgentLib связывает поддерживаемые вызовы инструментов внутренних агентов с контекстом агента, который сервисы передают в PrivacyLib на границе доступа к данным. PrivacyLib использует этот контекст для наблюдения и контроля.
Выводы из создания и эксплуатации PrivacyLib
Создание и эксплуатация PrivacyLib в системах Meta помогли нам сделать несколько важных выводов.
Проектируйте системы с учётом изменений требований и инфраструктуры: До появления PrivacyLib мы добавляли механизмы защиты конфиденциальности в отдельные места вызовов, необходимые для выполнения каждого нового требования. Со временем Meta создавала новые системы хранения и обработки данных, сервисы получали новые способы работы с данными, а требования конфиденциальности расширялись. Каждое изменение требовало дополнительной работы по интеграции, а новые пути доступа порой появлялись быстрее, чем мы успевали их охватить. Мы поняли, что интеграцию нужно выполнять на стабильной границе доступа к данным, определить небольшой набор общих для систем операций и хранить аннотации вместе с данными. Модули могут повторно использовать те же интеграции, со временем сокращая объём инженерной работы.
Надёжность способствует внедрению: На раннем этапе некорректная конфигурация приводила к сбоям процессов по всему парку систем, нарушая наши же принципы безопасного развёртывания. Другие инциденты были вызваны изменениями аннотаций: они успешно проходили компиляцию, но меняли решения о доступе и вызывали сбои в продуктах. Эти инциденты показали, что владельцы сервисов доверят PrivacyLib критически важный путь доступа к данным только в том случае, если смогут до выпуска увидеть, как изменения повлияют на их трафик, и восстановить работу после проблемного изменения без отката всего парка систем.
Охват включает развёртывание: Когда для выполнения новых требований нужно изменить модули, поддерживаемые политики или аннотации, старые сервисы должны развернуть версии с обновлёнными возможностями PrivacyLib. Мы предусмотрели явный учёт, отслеживание и механизмы развёртывания для координации этих обновлений. Это позволяет ответственным за требования командам безопасно соблюдать сроки, обновляя только те сервисы, которых касаются изменения.
Дальнейшие планы
Эти выводы определяют дальнейшее развитие PrivacyLib: по мере распространения ИИ доступ к данным перемещается в новые среды и проходит по всё более необычным путям вызовов. Мы продолжаем расширять возможности PrivacyLib в двух направлениях:
- Обучение ИИ: Данные, используемые для обучения, поступают в наши системы из самых разных источников. Значительная их часть создаётся или преобразуется в различных местах. Мы распространяем на эту область подходы, подобные PrivacyLib, чтобы обеспечить масштабирование тех же гарантий. Подробнее о том, как Meta работает с данными для обучения ИИ, см. в материале ИИ в Meta: прозрачность в отношении данных для обучения.
- Внутренние ИИ-агенты: Отслеживание попыток доступа к данным и блокировка запрещённых попыток — это лишь отправная точка, а не полное решение для агентов, используемых внутри Meta в инженерной работе и для повышения продуктивности. Далее возникают более сложные задачи: оценивать поведение внутренних агентов в процессе их работы и анализировать взаимодействие между ними, когда между человеком, запросившим доступ к данным, и самим доступом могут находиться несколько агентов.
Благодарности
Авторы хотели бы поблагодарить многих нынешних и бывших сотрудников Meta, чей вклад на протяжении многих лет играл важнейшую роль в разработке PrivacyLib. В частности, мы хотели бы выразить особую благодарность (в алфавитном порядке) Adwait Sathe, Andrew Vaslas, Darrien Glasser, Diana Marsala, Hanzhi Zhang, Kousik Nandy, Matthew Hillman, Matthieu Martin, Michael Dietz, Nathan Maue, Ramy Wassef, Sen Luo, Spencer Baumgardner, Vince Yang и Zhong Hu. Мы также благодарны всем, кто рецензировал эту публикацию, в том числе (в алфавитном порядке) Aleksandar Ilic, Alex Kagan, Alex Ponomarenko, Arash Nikkar, Avtar Brar, Chloe Lu, Chris Wiltz, Emil Vazquez, Emily Van Deuren, Rituraj Kirti, Sushaant Mujoo и Wenlong Dong. Особую благодарность мы хотели бы выразить Jonathan Bergeron за руководство этой работой, ценные советы и отзывы, а также Chloe Lu — за организацию необходимой поддержки, благодаря которой эта публикация стала возможной.
Engineering at Meta прочитано 1246 раз
