Создайте один раз — развертывайте в масштабе: создание ML-экосистемы на основе шаблонов
- Meta внедрила стандартные шаблоны моделей: методы проверяют на репрезентативных моделях и распространяют на целые группы.
- За два года шаблоны сократили инженерную работу над каждой моделью на 92% и помогли внедрить более 5 000 сочетаний методов и моделей.
- Офлайн-качество выросло в среднем на 0,63% при неизменной пропускной способности, а онлайн-показатели — на 0,86%; охват составил 70% моделей.
Почему это важно: Это важно, поскольку в крупных экосистемах распространение улучшений часто становится главным препятствием для масштабирования.
- По мере того как экосистемы машинного обучения разрастаются и включают множество моделей, работающих в production, узким местом становится уже не разработка новых методов улучшения этих моделей, а их надёжное и эффективное внедрение в разнородную среду моделей, создающее эффект, от которого выигрывают все.
- В Meta мы разработали подход на основе шаблонов, который стандартизирует проектирование моделей с помощью небольшого набора повторно используемых и комбинируемых блоков. Благодаря этому итерационная работа над моделями перестала быть задачей для каждой модели по отдельности и стала общей системной задачей.
- За последние два года этот подход сократил время инженерной работы над каждой моделью на 92%, позволил внедрить более 5 000 сочетаний методов и моделей, повысил качество моделей при офлайн-оценке в среднем на 0,63% при неизменной пропускной способности обслуживания и обеспечил совокупный прирост онлайн-показателей на 0,86%, охватив 70% моделей.
- Подробное описание этой работы приведено в нашей статье »Спроектировать один раз, развернуть в масштабе: разработка машинного обучения на основе шаблонов для крупных экосистем моделей».
Ранжирующие системы рекламы Meta обрабатывают миллиарды запросов ежедневно в самых разных продуктах и с различными целями оптимизации; их обслуживает множество моделей, работающих в production. В таких масштабах главная задача повышения релевантности для пользователей и ценности для рекламодателей сместилась с разработки новых методов на их распространение. Каждая важная идея должна охватить все подходящие для неё модели, а адаптировать её по одной модели за раз невозможно в масштабах всего парка.
В крупных системах машинного обучения фрагментация быстро усугубляется. Новая архитектура внедряется в одну модель, но на её распространение во всех уголках экосистемы могут уйти годы. Миграция платформы подходит одному семейству моделей, но оказывается несовместимой с длинным хвостом специализированных конфигураций. Результат настройки улучшает одну модель, но почти ничего не говорит о следующей, потому что её базовая конфигурация слишком отличается. Со временем распространить новшество становится сложнее, чем разработать его.
Рекламная экосистема ранжирования Meta столкнулась именно с этой проблемой. По мере того как количество моделей в production росло вместе с разнообразием целей оптимизации рекламы, увеличивалось и разнообразие архитектур, признаков, настроек обучения, ограничений обслуживания и логики, специфичной для платформ. Такое разнообразие давало командам гибкость, но одновременно создавало три системные проблемы: высокие инженерные затраты на широкое внедрение новых идей, высокие затраты на обеспечение надёжности из-за множества нестандартных случаев и низкую предсказуемость при оценке влияния изменений на всю экосистему.
Более глубокая проблема в том, что фрагментация создаёт невыгодный закон масштабирования для самой инженерной работы. Если каждую идею нужно оценивать и адаптировать отдельно для каждой модели, объём работы растёт линейно с количеством моделей. На раннем этапе с этим можно справиться, но при большом количестве моделей это становится серьёзным узким местом.
Фрагментация также снижает эффективность автоматизации. AutoML и системы оптимизации лучше всего работают в структурированном пространстве, но если каждая модель устроена по-своему, методы с наибольшим потенциалом охватывают лишь часть моделей.
Мы решили не добавлять ещё один уровень автоматизации поверх этой сложности, а сначала уменьшить её. Для этого мы внедрили стандартные шаблоны моделей (Standard Model Templates, SMT) — подход, который стандартизирует проектирование моделей с помощью тщательно подобранного набора повторно используемых шаблонов.
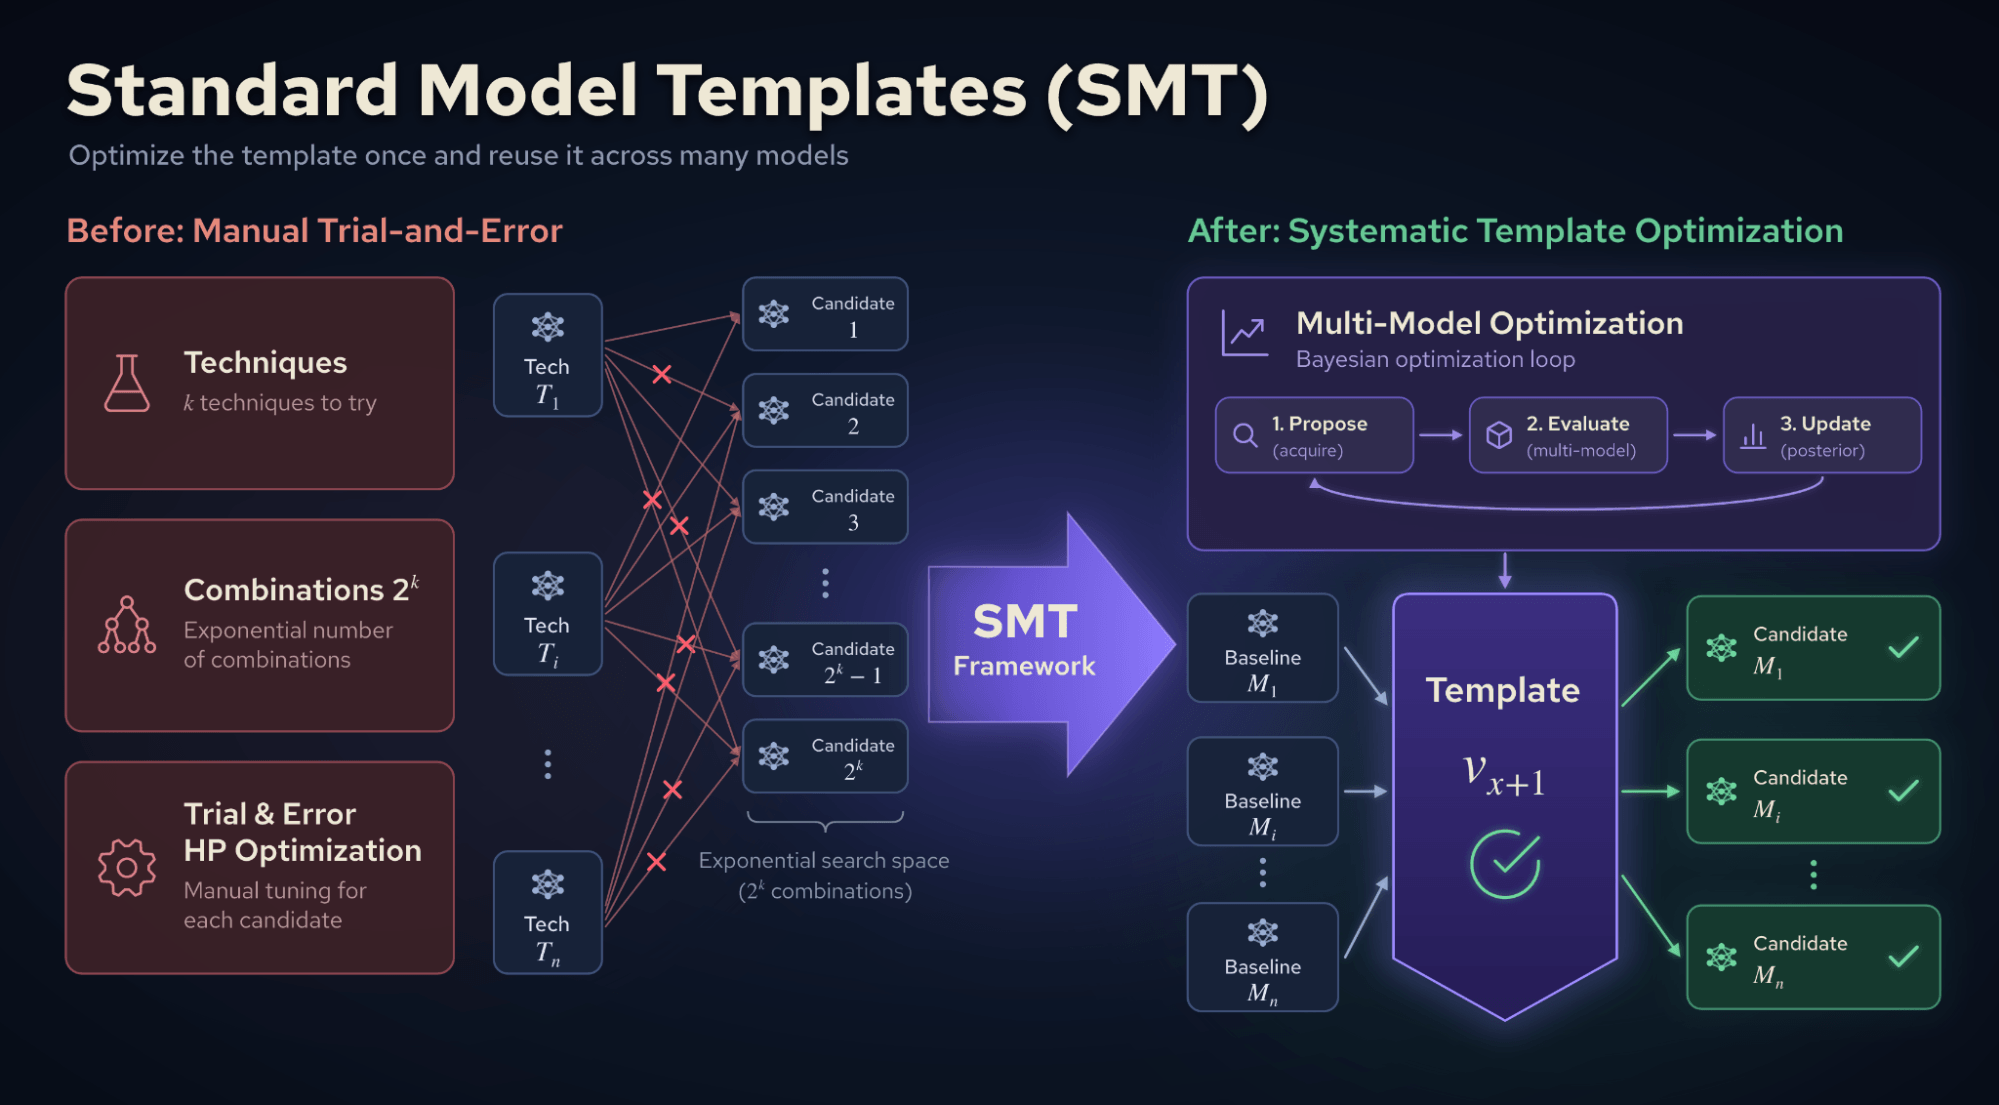 Рисунок 1. До внедрения SMT каждый метод настраивался вручную для каждой модели, а количество возможных сочетаний росло экспоненциально. С SMT многомодельная оптимизация позволяет один раз настроить методы на репрезентативных моделях, а те из них, которые хорошо переносятся, включаются в следующую версию шаблона.
Основа на базе шаблонов
Шаблон — это продуманная минимальная конфигурация модели, составленная из общих компонентов, таких как выбор архитектуры, логика работы с признаками, настройки обучения и конфигурации обслуживания. Вместо того чтобы поддерживать каждую модель в production как практически независимое решение, мы объединяем похожие модели вокруг меньшего числа стандартных шаблонов. При необходимости сохраняется логика, специфичная для отдельных моделей, но общие части явно описаны и используются совместно.
На практике мы используем небольшой набор шаблонов, охватывающих основные сценарии ранжирования и извлечения данных для моделей разного размера. В этих шаблонах собраны повторно используемые компоненты для отбора признаков, взаимодействия признаков, параллелизма моделей, конфигурации обучения и обслуживания с учётом аппаратных особенностей.
Это существенно меняет подход к работе. Вместо того чтобы независимо проверять новую идею на каждой модели, мы можем оценить её на гораздо меньшем наборе репрезентативных шаблонов, а затем распространить на группы моделей, которые их используют. Иными словами, мы переходим от итерационной работы над каждой моделью отдельно к итерационной работе на уровне шаблонов.
Это даёт нам три основных преимущества.
- Упрощение распространения: общий шаблон позволяет использовать одну реализацию для множества последующих моделей, снижая стоимость внедрения новых идей в масштабе всей системы.
- Повышение надёжности: Когда уникальных конфигураций моделей становится меньше, проще внедрять более строгую проверку, надёжные защитные механизмы и переносимые процессы отладки. Проблемы, например нестабильность обучения или ухудшение показателей при обслуживании, легче анализировать, поскольку они возникают в рамках общей структуры шаблона, а не в бесконечном множестве конфигураций.
- Повышение предсказуемости: если модели в группе используют общий шаблон, показатели репрезентативных моделей гораздо точнее отражают результаты для всей группы. Благодаря этому планирование на уровне экосистемы становится более обоснованным и меньше зависит от предположений.
Со временем этот подход на основе шаблонов стал не просто способом стандартизации, а основой более широкой системы разработки машинного обучения.
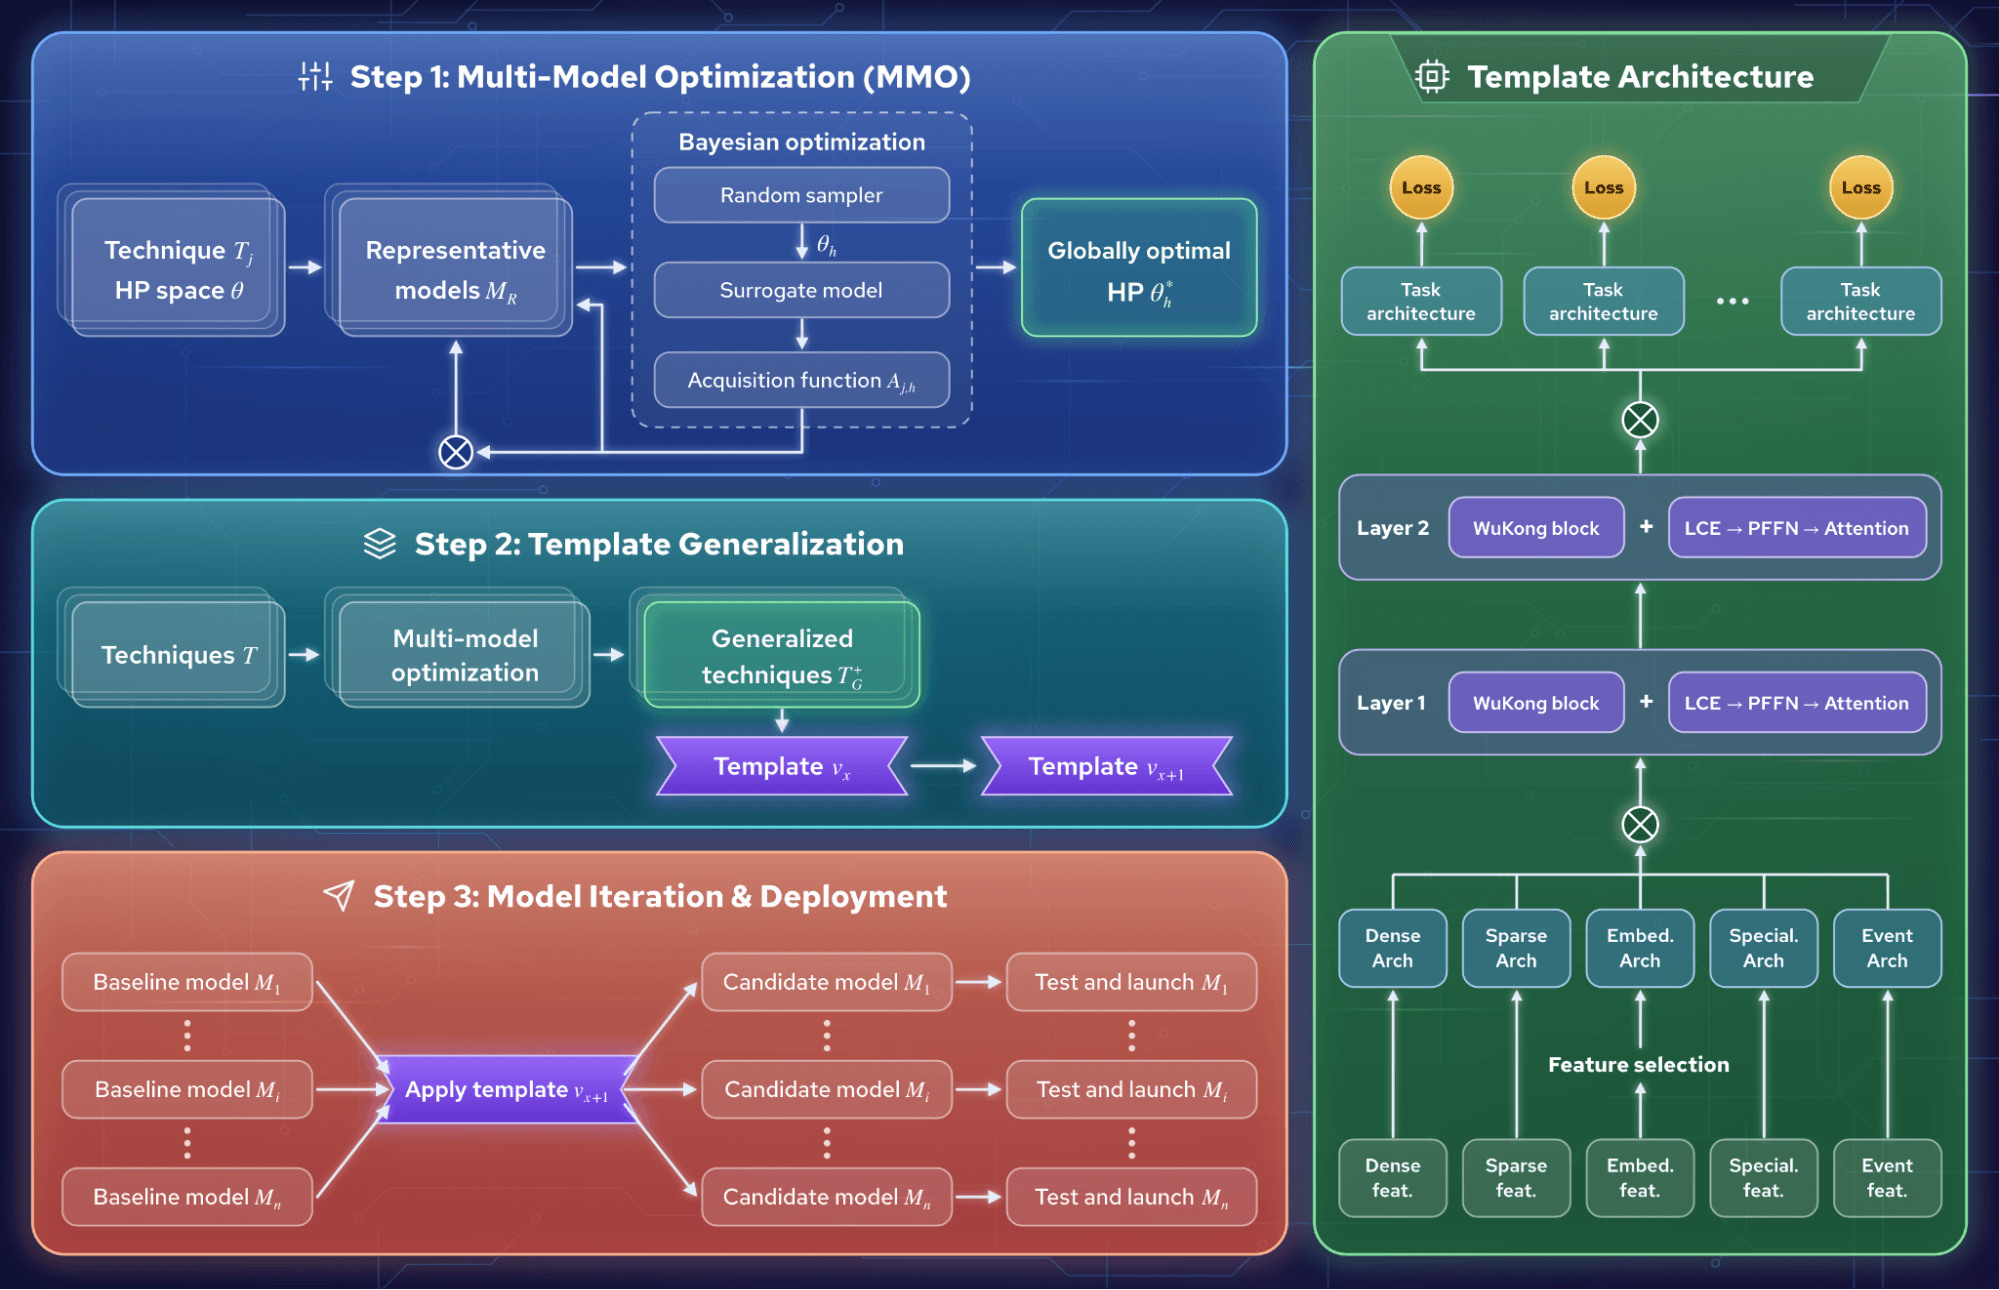 Рисунок 2. Цикл разработки SMT (слева) и многоуровневая архитектура каждого шаблона (справа). Методы настраиваются один раз на репрезентативных моделях, добавляются в новую версию шаблона, а затем внедряются во все модели, построенные на его основе.
SMT: от стандартизации к масштабируемому переносу методов
Переход на SMT открыл возможности для более амбициозной задачи — оптимизации всей экосистемы как единого целого. Вместо управления парком независимых моделей мы начали рассматривать его как общее пространство для внедрения новшеств.
Вместо последовательного распространения отдельных методов мы переносим проверенные комплексные модели — результат проектирования — от сильных исходных моделей к целевым семействам моделей через общий слой шаблонов. Это важно, поскольку многие улучшения возникают благодаря взаимодействию архитектурных решений, выбора масштаба и стратегий обучения, а не за счёт отдельных компонентов, применяемых независимо друг от друга.
За последние два года этот подход сократил время инженерной работы над каждой моделью на 92% и позволил внедрить более 5 000 сочетаний методов и моделей в нашем крупном и разнообразном парке моделей , одновременно повысив качество моделей при офлайн-оценке в среднем на 0,63% при неизменной пропускной способности обслуживания и обеспечив совокупный прирост онлайн-показателей на 0,86%. Что ещё важнее, этот подход поставил под сомнение распространённое мнение, будто для разных целей оптимизации необходимы совершенно разные модели. Во многих случаях хорошо спроектированный общий шаблон способен применяться гораздо шире, чем можно было ожидать.
Мы также выяснили, что стандартизация структуры моделей упрощает повторное использование решений по масштабированию. Вместо того чтобы заново искать компромисс между стоимостью и производительностью для каждой модели, мы можем изучить его в пространстве шаблонов и применять полученные результаты шире. Это привело к созданию процессов оптимизации на основе законов масштабирования, которые делают распределение ресурсов более обоснованным и менее ситуативным.
Многомодельная оптимизация
Мы используем многомодельную оптимизацию, чтобы итерационная работа над шаблонами опиралась на строгую оценку. В ходе этого процесса потенциальные методы проверяются на репрезентативных моделях, а также выполняется поиск конфигураций, улучшающих совокупные показатели и ограничивающих ухудшения.
Метод со значительным средним приростом, но частыми ухудшениями трудно внедрить во всём крупном парке моделей. Для распространения в production стабильность не менее важна, чем максимальный прирост. Принимая решение о готовности метода к интеграции, многомодельная оптимизация учитывает и совокупные показатели, и частоту ухудшений.
После оптимизации потенциальные методы проверяются на отложенных моделях, чтобы выяснить, распространяются ли улучшения за пределы репрезентативной выборки. Успешно прошедшие проверку методы включаются в следующую версию шаблона. За последние два года мы внедрили с помощью этого процесса 80 новых методов машинного обучения.
Результат накапливается со временем: каждая модель, использующая зрелый шаблон, получает все обобщённые улучшения, накопленные ранее, а не начинает с отдельной базовой конфигурации.
Почему SMT важны для агентных систем машинного обучения
В концепциях создания моделей с помощью агентов часто предполагается, что один агент будет исследовать обширное пространство проектных решений от начала до конца, имея доступ к инструментам, конвейерам обучения и результатам оценки. На практике такой подход сталкивается со знакомой проблемой: пространство поиска слишком слабо ограничено. Без надёжных априорных предположений агент тратит слишком много усилий на исследование бесперспективных областей, устранение предотвратимых сбоев или предложение изменений, которые трудно объяснить и ещё сложнее внедрить.
SMT помогают решить эту проблему, поскольку в них заложены проверенные проектные шаблоны. Это даёт агентам структурированную отправную точку, ограниченное пространство поиска и минимально гарантированный уровень качества. Вместо того чтобы рассматривать создание моделей как поиск без заданных рамок, мы можем разбить эту задачу на специализированные подзадачи.
В Meta SMT также служат основой нашего мультиагентного подхода к созданию моделей. Шаблоны задают структуру, а агенты обеспечивают адаптивный поиск и автоматизацию. На уровне шаблонов агенты помогают создавать, оценивать и улучшать сами шаблоны. Они предлагают идеи оптимизации на основе проверенных методов, запускают эксперименты на репрезентативных моделях, диагностируют сбои и проводят несколько итераций, помогая управлять многодневными циклами, необходимыми для разработки шаблонов. Агентам можно поручить и более сложные задачи, например перенос моделей на новые аппаратные платформы. Проверенный таким способом метод охватывает все модели, созданные на основе соответствующего шаблона, при этом вычислительных ресурсов требуется лишь малая часть от тех, что понадобились бы для адаптации каждой модели по отдельности. Подробнее об этом мы рассказываем в статье Как Meta использует ИИ-агентов для масштабного внедрения методов машинного обучения в моделях ранжирования рекламы.
Выводы и дальнейшее развитие SMT
В крупных экосистемах машинного обучения распространение новшеств для улучшения моделей часто становится главным препятствием для масштабирования. SMT эффективны, поскольку автоматизация становится мощнее по мере того, как базовая система приобретает более чёткую структуру. Разработка на основе шаблонов не только упростила работу с экосистемой для людей, но и помогла системам оптимизации, процессам масштабирования и агентам эффективнее анализировать её.
Однако стандартизация работает, только если она достаточно строго ограничивает ненужное разнообразие, сохраняя при этом необходимую гибкость. Система шаблонов, которая пытается учитывать каждый исторически сложившийся особый случай, в итоге воспроизведёт ту самую фрагментацию, которую должна была устранить.
Нам ещё предстоит расширить охват шаблонов, улучшить оптимизацию на основе законов масштабирования и перейти к полностью сквозным агентным процессам — включая агентное создание шаблонов и моделей, онлайн-оценку и непрерывную оптимизацию на основе онлайн-сигналов. Кроме того, необходимо сделать эти процессы надёжнее и понятнее.
Но основная идея подтвердила свою состоятельность. Чтобы масштабировать внедрение новшеств в крупной экосистеме машинного обучения, нужно стандартизировать основу, на которую они опираются. Иными словами, проектировать один раз и развёртывать в масштабе — это не просто способ повысить эффективность, а архитектурное решение, позволяющее крупной экосистеме машинного обучения быстрее учиться.
Читать статью
Благодарности
Aayush Aggarwal, Saurabh Aggarwal, Anuj Bindal, Nakul Camasamudram, Shouyuan Chen, Wenlin Chen, Kevin De Angeli, Jason Flaks, Luc Kien Hang, Rupinder Khandpur, Santanu Kolay, Nhat Le, Swamy Muddu, Sandeep Pandey, Dhiraj Parashar, Akshay Pardeshi, Jingzheng Qin, Shah Rahman, Shiblee Sadik, Munaf Sahaf, Vibha Sinha, Saied Tahaghoghi, Terry Tang, Alireza Vahdatpour, Fangjing Wu, Haoyu Wu, Wendan Yan и Chang Yang.
