Обзор методов численной оптимизации. Безусловная оптимизация: метод линий
Я работаю в американской компании, разрабатывающей софт для химической и нефтегазовой промышленности. Одной из наиболее востребованных тем в этой области является оптимизация чего-либо при заданных параметрах производства. Например, минимизация расходов на выработку какого-нибудь газа, максимизация прибыли при реализации топлива, максимизация давления в какой-нибудь трубе при вариабельных термодинамических параметрах на другой части проектируемого завода и заданных ограничениях и т.д. Я занимался реализацией методов оптимизации для подобных задач и, думаю, накопил ощутимый опыт в этой области. С этого поста хотел бы начать серию обзоров известных методов оптимизации.
Введение
Оптимизация — это процесс нахождения точки экстремального значения некоторой заданной целевой функции
 . Это один из крупнейших краеугольных камней прикладной математики, физики, инженерии, экономики, промышленности. Область её применений необъятна и может распространяться от минимизации физических величин на микро- и макроуровнях до максимизации прибыли или эффективности логистических цепочек. Машинное обучение также заострено на оптимизации: всевозможные регрессии и нейроные сети пытаются минимизировать ошибку между предсказанием и реальными данными.
Экстремум может быть как минимумом, так и максимумом, но обычно принято изучать любую оптимизацию исключительно как поиск минимума, поскольку любая максимизация эквивалентна минимизации из-за возможности поменять знак перед целевой функцией:  . Следовательно, в любом месте ниже под оптимизацией мы будем понимать именно минимизацию.
Некоторые посты по оптимизации на Хабре от других авторов:
Обзор градиентных методов в задачах математической оптимизации
Обзор основных методов математической оптимизации для задач с ограничениями
Метод BFGS или один из самых эффективных методов оптимизации. Пример реализации на Python
Квазиньютоновские методы, или когда вторых производных для Атоса слишком много
Метод оптимизации Trust-Region DOGLEG. Пример реализации на Python
Раздел численных методов, изучающий оптимизацию общих нелинейных функций, называется нелинейным программированием, или NLP (конечно, сейчас на слуху у всех другое NLP — Natural Language Processing, но это не тот случай).
Кто хочет сразу перейти к сердцевине — можно перескочить к главе «Характеристики методов».
Типы оптимизаций
Безусловная vs условная
Следующая оптимизация

 , в то время как добавление неравенства как показано

 .
В механике равенства соответствуют двусторонним ограничениям. Это может быть, например, условие, при котором материальная точка никогда не покидает определённую поверхность, пока её потенциальная энергия сводится к минимуму. Односторонние ограничения, с другой стороны, соответствуют неравенствам и распространены в негладкой механике, например: столкновения, непроникновение поверхностей сквозь друг друга, трение и т. д. Такие системы рассматриваются с помощью множителей Лагранжа, представляющих силы реакции со стороны поверхностей.
В данном посте мы будем рассматривать безусловную оптимизацию, а к условной, может быть, перейдём в другой раз.
Локальная vs глобальная
Гладкая vs негладкая
В другом случае смысл «Гладкая vs негладкая» состоит в том, что идёт разделение между самими функциями: какие-то гладкие, а какие-то только непрерывные или даже разрывные. Понятно, что считать производные для последних не всегда будет корректным, или её расчёт крайне неточен. Например, метод Нелдера-Мида не требует какой-то информации о гладкости функции выше непрерывности для своей работы и вполне себе подходит для работы с функциями класса  (само по себе это, конечно, не значит, что на более гладких функциях он не будет работать надёжнее).
В втором разделении я не шибко разбираюсь и подозреваю, что набор методов эксклюзивно для негладких функции более худосочен, чем для гладких функций. В любом случае, эти два разделения условны и часто не имеют чёткой границы.
Ниже мы рассмотрим методы, которые нацелены как минимум на непрерывно-дифференцируемые функции, т.е. из класса
 . Последнее условие требуется, чтобы иметь возможность положиться на обширную доступную теорию гладких функций, а также использовать как минимум градиент функции для ускорения процесса поиска. Как известно, если
 является локальным минимизатором, то
 . Обратное, к сожалению, неверно.
Трудоёмкость целевой функции
Дополнительные трудности могут возникать в задачах, в которых целевая функции вычислется неточно, а с некоторым шумом, вносящим неопределённость.
Алгоритмы, которые мы будем рассматривать ниже, не принимают во внимание возможную трудоёмкость целевой функции и предполагают, что мы можем её вычислять без ограничений столько раз, сколько нам нужно. Нам важна оптимальность самих алгоритмов оптимизации.
Разделений ещё больше
Поскольку оптимизация является активно развивающейся и актуальной областью, она содержит слишком много — безумного много — тематических подобластей и вариаций. Задачи, требующие оптимизации, и методы для них растут как грибы после дождя на протяжении многих лет.
Например, есть огромная подобласть Mixed-Integer Programming, в которой рассматриваются дискретные сценарии. Есть недетерминированная (хаотическая) оптимизация, использующая вероятностые подходы в своей работе. Есть робастная оптимизация, в которую заложены параметры, не являющиеся переменными. Есть оптимизация динамических систем, в которых присутствует эволюция во времени. Есть всевозможные мета-эвристические методы: метод имитируемого отжига (simulated annealing), генетические алгоритмы, методы эволюции роя. Есть оптимизация неопределённой логики (fuzzy logic optimization).
Есть бог знает что! Я знаю лишь какую-то часть из представленного, и обо всём точно не расскажу никогда.
Даже по гладким методам я не смогу представить их все с достаточно глубоким анализом по каждому из них из-за нехватки времени и ресурсов. Я, однако, сделаю все возможное, чтобы передать основные идеи читателю.
Наши реалии
 в области определения , любой метод последовательно генерирует специальное направление на основе предыдущих данных и самой функции. Метод полагает, что направление указывает на точку возможного локального минимума , и поэтому смещает положение в этом направлении.
Численная минимизация непрерывной невыпуклой функции не дает гарантии, что полученное решение действительно является точкой локального минимума. Критерий останова метода проверяет магнитуду градиента функции  и прерывает алгоритм в случае, если эта магнитуда ниже некоторого малого значения
 0$» />. Теоретически доказанные результаты сходимости с таким критерием существуют для многих методов, но его можно обмануть, заменив минимизатор произвольной стационарной точкой, что приведёт к невозможности предоставить истинное решение. Например, для функции
 начальное приближение
 уже будет ответом, ввиду того, что
 , но ответ этот фейковый, т.к. представляет собой локальный максимум, в то время как реальная точка минимума — это любая из
 .
Что в этом случае делать? Ничего. Скрестить пальцы и надеяться на лучшее.
По этой причине, наши методы отвечают только за определение местоположения стационарной точки, хоть и будучи подкреплены сильной теоретической базой, подогревающей наши надежды на то, что такая точка всё-таки является локальным минимизатором для большинства функций, с которыми мы сталкиваемся в реальных задачах.
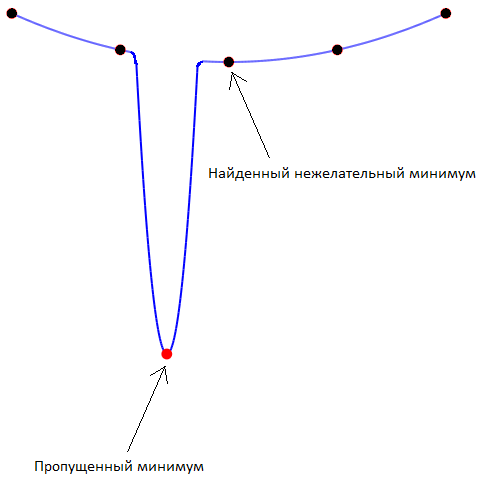
Есть и другая оговорка. Некоторые функции, которые формально являются гладкими, на самом деле могут быть слишком нерегулярными, чтобы методы надёжно производили минимизацию. И это ожидаемо, когда дискретный подход используется на задачах континуума (в отличие, например, от фундаментально дискретных задач, связанных с разреженными матрицами, графами и т. д.).
Как пример, картинка ниже демонстрирует гипотетический сценарий, когда математически реальный минимум может быть скрыт от глаз за счёт неплотности чисел с плавающей точкой во множестве  . Чёрные точки показывают возможные итерации метода.
Что в этом случае делать? Ничего. Скрестить пальцы и надеяться на лучшее.
Характеристики методов
Рассматриваемые ниже методы минимизации можно разделить по множеству актуальных характеристик. В этом посте нам могут быть интересны следующие:
- Глобальная сходимость.
- Скорость локальной сходимости.
- Размеры задачи, на которую они нацелены.
- Требуется ли хранить в памяти матрицы или нет.
- Требуется ли матрица Гессе или нет.
- Требуется ли масштабирование или нет.
Первые два пункта являются теоретическими, другие же более приземлены и непосредственно относятся к практической реализации. Пройдёмся по каждому из пунктов.
Говорят, что метод имеет свойство глобальной сходимости, если его итерации сходятся к локальному минимизатору независимо от начального положения (не путать с поиском глобального минимизатора! ). Скорость локальной сходимости показывает, насколько быстро метод «настигает» минимизатор, когда он уже достаточно близко подошёл к нему. Удивительно, но эти две характеристики метода, будучи обе очень желательными в реальных вычислениях, могут конфликтовать между собой в многих методах оптимизации. Так называемые гибридные методы умело используют оба этих преимущества.
Размер задачи сужает выбор до тех методов, которые мы можем себе позволить. Для крупных задач интенсивное использование памяти может быть недопустимым, и для таких задач используют методы, возникшие из таких ограничений и основанные на экономном потреблении памяти. Параллельно рассматривается вопрос, нужны ли нам плотные матрицы в итерационных вычислениях или нет, поскольку объём памяти для матриц растёт квадратично с увеличением размера задачи.
Матрица Гессе  это такая матрица, у которой
 -компонента равна
 . Эта матрица использует информацию о второй производной функции (кривизне) и, при правильном использовании, обеспечивает более быструю сходимость за счёт лучшего определения направления шага. Получить такую матрицу для решателя может быть проблематично, в зависимости от типа и условий задачи. Это особенно верно для крупномасштабных задач или сценариев, использующих опосредованный расчёт функции (когда функция не предоставляется нам удобной аналитической формулой). Из матана известно, что если в стационарной точке матрица Гессе положительно определена (SPD), то эта точка является строгим локальным минимизатором. На практике это условие не проверяется даже при наличии матрицы Гессе, ибо слишком затратно проверять знаковую определённость матрицы.
Наконец, для некоторых методов может потребоваться масштабирование (скейлинг). Эффективность метода может зависеть от того, как именно поставлена задача. Задача плохо масштабируется, если изменения для  в определённом направлении приводят к гораздо большим изменениям в значении , чем в другом направлении. Простым примером является
 , которая чувствительна к изменениям
 , но не чувствительна к изменениям
 . Некоторые методы, применяемые к таким задачам, могут страдать от медленной сходимости. Чтобы ускорить сходимость в этом примере, рекомендуется выполнить масштабирование, изменив переменные на новую пару
 . Некоторые методы нечувствительны к масштабированию, поэтому они предпочтительнее в практических ситуациях. Увы, на практике о целевой функции мало что бывает известно, и никто нам не предоставляет масштабирующих коэффициентов.
Ну, а теперь, имея представления об основных характеристиках методов оптимизации, мы наконец можем перечислить сами методы — наиболее известные из них. На самом высоком уровне все методы гладкой локальной безусловной оптимизации можно разделить на два больших класса: методы линейного поиска (или методы линий) и методы доверительной области. В этом посте нас будет интересовать только первый класс.
Методы линий
Основная суть методов линий заключается в том, что на каждой итерации они выполняют поиск одномерного минимизатора в заданном направлении, которое они вычислили ранее. Грубо говоря, их алгоритмы имеют следующий паттерн:
k:= 0
while 
- рассчитать направление

- найти такое
 0$» />, что функция
 минимизируется

- k:= k + 1
Методы этого класса между собой различаются, как правило, тем, как они генерируют направление
на шаге 1, и — реже — тем, как они реализуют шаг 2. Тем не менее, что объединяет эти методы при выполнении шага 1 — это то, что все они пытаются рассчитать так называемое направление спуска . Это такое направление, которое обеспечивает мгновенное уменьшение целевой функции, если движется вдоль него. Можно провести аналогию из реальной жизни: человек, идущий по холму, всегда знает, в каком направлении в данном месте идет подъём, а в каком спуск, и выбирает то, которое ему нужно.Формально, направление спуска
определяется так, что выполняется неравенство  , означающее, что угол между градиентом функции, всегда указывающим в сторону роста, и направлением больше 90 градусов. Указание направления спуска гарантирует корректность одномерной подзадачи минимизации на шаге 2, если предполагать, конечно, что целевая функция начинает расти, когда становится достаточно большим. А это, в свою очередь, гарантируется ограниченностью функции снизу. Не будем же мы искать минимум у неограниченной снизу функции. :)
Шаг 2 почти никогда не вычисляется точно, несмотря на одномерность задачи. Дело в том, что для этого может потребоваться дорогостоящая оценка матрицы Гессе целевой функции. По этой причине эта подзадача заменяется неточным аналогом, запрашивающим такую позицию  , которая обеспечивает в каком-то смысле «хорошее» уменьшение функции. Существует несколько типов условий, которые используются как критерии решения этой неточной задачи, и все они формализованы как те или иные неравенства. Наиболее известны следующие:
- Условие Армиджо (или Армихо, фиг знает), или условие достаточного убывания
- Условия Вульфа двух типов: стандартное и сильное
- Условия Голдштайна
Первое условие заботится о том, чтобы в направлении поиска достигалось достаточно существенное уменьшение целевой функции. Несоблюдение этого условия может привести к стагнации процесса редукции (например, уменьшение может происходить на положительное значение, уменьшающееся от итерации к итерации) во всём алгоритме минимизации. Условия Вульфа в оригинале состоят из двух, первое из которых — само условие Армиджо, а второе называется условием кривизны. Последнее в свою очередь делится на стандартное и сильное условия кривизны и означает, что число
 достаточно велико, чтобы обеспечивать разумный прогресс в пространстве переменных (простым языком: мы хотим, чтобы сдвигался достаточно далеко, а не топтался на месте).
Сильное условие Вульфа, как очевидно из названия, «усиливает» условие кривизны таким образом, что
помещается в окрестность точного минимизатора. Наконец, условия Голдштайна имеют примерно ту же цель, что и условия Вульфа, хотя они могут исключить фактический одномерный минимизатор из области поиска по чистой случайности. Условия представлены в таблице ниже, где мы используем обозначения  ,
 ,
 .
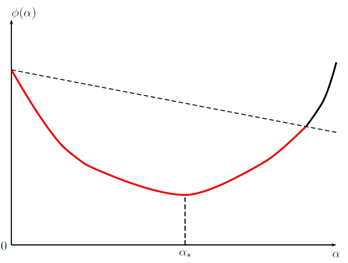
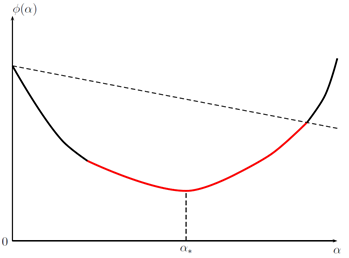
Ниже изображены четыре условия из таблицы, в указанном порядке: Армиджо, стандартный Вульф, сильный Вульф, Гольдштайн. График относится к
 во всех случаях. Его красные части соответствуют тем значениям
 , которые удовлетворяют соответствующему условию.
 обозначает точный одномерный минимизатор:
 0}{\text{argmin}}f (\mathbf{x}_k + \alpha \mathbf{p}_k)$» />.
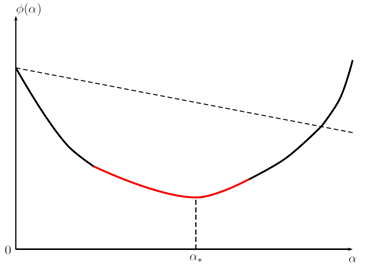
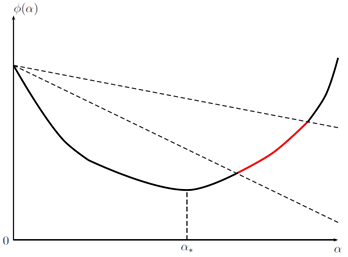
Кстати, в машинном обучении коэффициент
называют скоростью обучения — learning rate (в самой же оптимизации названия не помню, может что-то вроде «шаг поиска»?).Условия Вульфа обладают некоторыми доказанными свойствами, связанными с глобальной сходимостью. Приведём ниже очень важную теорему о глобальной сходимости методов линий.
Теорема. Пусть целевая функция ограничена снизу и везде дифференцируема, причём её градиент непрерывен по Липшицу: существует константа  0$» /> такая, что
 для любой пары
 . Пусть есть направление спуска, а удовлетворяет стандратному условию Вульфа для всех
 . Обозначим положительный косинус угла между и
 как
 0$» />. Тогда ряд
 сходится.
Непрерывность по Липшицу не является слишком ограничивающим условием. Напомним из математического анализа, что это условие гладкости находится между равномерной непрерывностью и дифференцируемостью. Другими словами, если дважды дифференцируема, то липшицева непрерывность гарантируется.
Хорошая новость в том, что сходимость ряда означает сходимость его последовательности к нулю, что также известно из математического анализа. Иными словами, заключаем, что  . Плохая же новость в том, что это само по себе не гарантирует сходимости к стационарной точке
 из-за присутствия косинуса рядом. Если можно показать, что последовательность косинусов ограничена снизу положительной константой, то сходимость к стационарной точке подразумевается. Но если выяснится, что
 , т.е. что направление становится всё меньше и меньше направлением спуска из-за стремления к ортогональности градиенту, то факта стремления к стационарной точке может и не быть. Этот фундаментальный недостаток алгоритма может быть одной из основных причин, по которым методы доверительной области имеют такое же право на существование, как и методы линий.
Одномерная минимзация
Второй шаг в алгоритме методов линий выглядит так:

Более конкретно, нас интересует удовлетворение того или иного условия Вульфа.
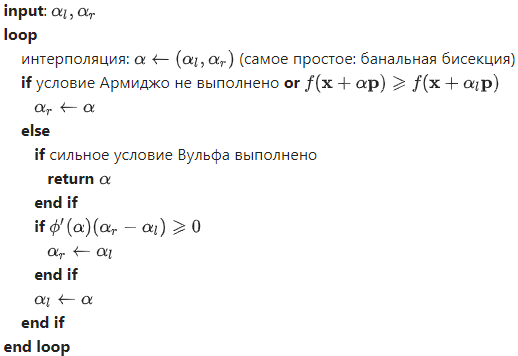
Есть относительно простой алогоритм для этих целей. Допустим, нам требуется сильное условие Вульфа. Начиная с некоторого начального приближения  , мы каким-нибудь образом шагаем либо вперёд (т.е. последовательность
 возрастает), либо назад (т.е. убывает, по-английски это называется backtracking). А по ходу шагания, мы проверяем следующие условия в представленном порядке, при учёте невыполнения предыдущих:
- Неравенство Армиджо не выполнено или

- Условие Вульфа выполнено
 0$» />
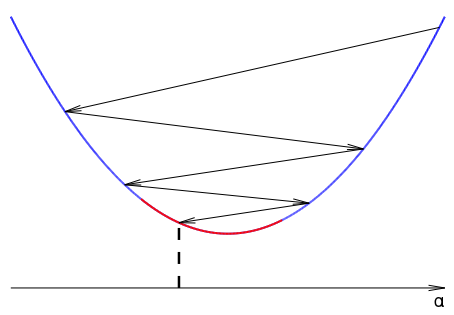
Если выполнено второе условие, то цель достигнута. Если выполнено первое или третье, то мы проваливаемся в следующий алгоритм по названием «Зум», позволяющий локализовать нужную нам точку
для выполнения условия Вульфа. Это напоминает работу под увеличительным стеклом, отсюда и название.Если выполнено первое условие, то мы на вход «Зуму» подаём два параметра
 . Если же третье, то подаём их же, но в другом порядке.
Вот так графически могут выглядеть итерации алгоритма «Зум», где красный участок соответствует выполнению сильного условия Вульфа:
Давайте теперь посмотрим на самые известные алгоритмы безусловной оптимизации метода линий.
Метод наискорейшего спуска
Он же метод градиентного спуска. В алгоритме 1, шаг 1 цикла просто нам выдаёт
 . Да, вот так просто. Для этого случая просто всегда имеем
 , и глобальная сходимость по теореме выше нам гарантирована. Скорость сходимости линейна, и метод требует масштабирования. Например, для целевой функции
 с начальным положением
 наискорейший спуск может потребовать десятки итераций, чтобы сойтись к минимизатору
 , в то время как при масштабировании с коэффициентами
 , которые применяются к градиенту, уже одной итерации может быть достаточно, поскольку такое направление указывает непосредственно на начало координат. Метод не требует никакого матричного хранения в памяти.
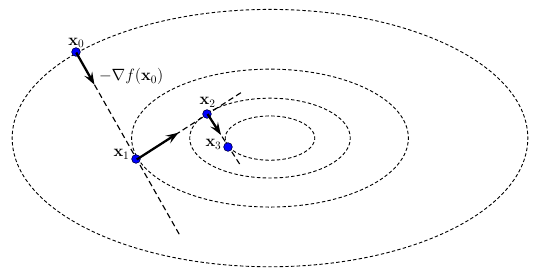
На рисунке выше показаны первые три итерации, выполненные методом наискорейшего спуска в сторону минимизатора на возможной выпуклой функции, например, выпуклой квадратичной функции. Здесь продемонстированы точные одномерные минимизаторы вдоль направлений
, что эквивалентно тому, что вектор антиградиента  касателен линии уровня функции, на которой лежит следующее приближение
 . Это также эквивалентно тому, что два последовательных градиента ортогональны друг другу. На практике, т.е. при неточной одномерной минизации вдоль направления, такое случается крайне редко.
На рисунке ниже показано, как ведет себя наискорейший спуск при масштабировании с идеально подходящими положительными коэффициентами, содержащимися в диагональной матрице  для той же целевой функции, что изображена на предыдущем рисунке.
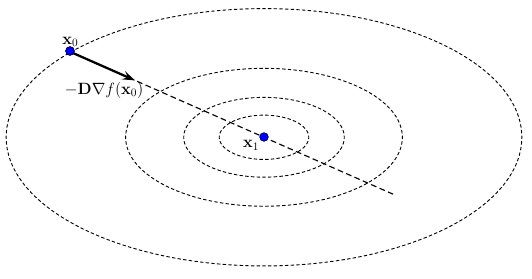
Антиградиент
 сразу указывает на точный минимизатор! Обратите внимание, что в случае неточного поиска вдоль линий, например, с использованием условий Вульфа, даже этот сценарий может потребовать немного больше одной итерации, чтобы сойтись. Все направления в этом случае будут параллельны друг другу.
Метод наискорейшего спуска является бесспорным «королём» глобальной сходимости. Это значит, что он сможет, во что бы то ни стало, достичь ямы, в которой располагается искомый минимизатор. Однако метод страдает от первого порядка сходимости, не позволяющего ему быстро «схватить» этот минимизатор. Он будет топтаться в его окрестности, неуверенно приближаясь к нему. Именно по этой причине я называю этот метод «дальнозорким».
Тем не менее, наискорейший спуск известен и используется всеми, от студентов, сдающих зачёты, до питоновских инженеров по машинному обучению. Причина в его теоретической простоте и одновременно в дешевизне реализации. Производные второго порядка целевой функции, как правило, недоступны при фиттинге нейронными сетями, поэтому дорогостоящий метод Ньютона (популярный больше среди академических исследователей) в таких ситуациях даёт дорогу наискорейшему спуску.
Метод Ньютона
Классический метод Ньютона полагается на решение на каждой итерации системы линейных уравнений
 с матрицей Гессе в левой части. При возможности используется коэффициент
 в одномерном поиске. Любая матрица Гессе симметрична. Если дополнительно предположить, что она положительно определена (SPD), то созданное направление является наравлением спуска, что несложно показать напрямую:
 0.$» />
Если известно, что число обусловленности матрицы Гессе равноверно ограничено, т.е. существует константа
 такая, что
 для всех , то
 0$» />, и, cледовательно, глобальная сходимость гарантируется в случае матрицы Гессе из класса SPD. Однако матрица Гессе не является SPD для невыпуклой функции во всей области её определения. В таких случаях используют разнообразные методы для корретикровки собственных значений матрицы Гессе, до тех пор, пока участки положительной определённости в пространстве переменных не будут достигнуты, так чтобы потом итерации могли продолжать свою работу с настоящей матрице Гессе. Такие методы относятся к классу модифицированного метода Ньютона, и затрагивать здесь мы их не будем.
Несмотря на отсутствие глобальной сходимости стандартного метода Ньютона для общего класса функций, преимущество его использования заключается в квадратичной скорости сходимости вблизи минимизатора. Вблизи минимизатора выбор сразу же удовлетворяет условиям Вульфа. Метод также инвариантен по отношению к масштабированию задачи, что является безусловным плюсом. Естественно, необходимость вычислять и сохранять в памяти матрицу Гессе, а также решать линейные системы на каждом шаге, во многих случаях не делает метод Ньютона напрямую доступным на практике.
Откуда шаг в методе Ньютона берётся? Из полиномиальной аппроксимации второго порядка для функции в окрестности точки  . Мы просто заменяем функцию её квадратичным многочленом Тейлора и ищем для него минимум, предполагая, конечно, что этот многочлен выпуклый:

