Meta Andromeda: новый этап поиска рекламных объявлений благодаря совместному проектированию моделей и систем
- Новая архитектура смеси экспертов приближает качество подбора к ранжированию, используя примерно в 300 раз меньше операций, чем модель 2024 года.
- Инференс превышает 10 млрд объявлений в секунду на одном GPU GH200; совместное размещение сокращает сетевой трафик примерно в 100 раз.
- С 2025 года Meta Andromeda обеспечила рост числа конверсий на Facebook на 2,4%.
Почему это важно: Система сопоставляет объявления с более широким пулом кандидатов в рамках того же бюджета задержки, автоматически повышая эффективность для рекламодателей.
- В этой публикации рассказывается о новом поколении Meta Andromeda — механизме Meta для подбора персонализированной рекламы, — и о том, как совместное проектирование модели, системы и графического процессора открывает новые возможности для повышения эффективности подбора рекламы.
- В рабочей среде система оценивает каждое подходящее объявление, обеспечивая качество модели, близкое к ранжированию, при масштабах этапа подбора, и отбирает наиболее перспективные варианты со скоростью более миллиарда объявлений в секунду. Это новый рекорд пропускной способности для моделей этапа подбора рекламы (то есть показатель в 100 раз выше, чем у системы Meta Andromeda 2024 года).
- Для рекламодателей это означает автоматическое повышение эффективности: система подбора сопоставляет объявления с более широким пулом кандидатов в рамках того же бюджета задержки. С 2025 года Meta Andromeda обеспечила рост числа конверсий на Facebook на 2,4%.
Meta Andromeda — это система машинного обучения Meta для подбора персонализированной рекламы, которая выполняет первый этап конвейера рекомендаций объявлений. На этапе подбора огромный пул подходящих объявлений за миллисекунды сужается до небольшого набора перспективных кандидатов; затем на следующем, более ресурсоёмком этапе ранжирования оставшиеся варианты оцениваются детально.
До сих пор качество глубинного моделирования, характерное для этапа ранжирования, было слишком затратным, чтобы применять его при масштабах подбора. Опираясь на основу, заложенную при запуске Andromeda в 2024 году на суперчипе NVIDIA GH200 Grace Hopper, в этой публикации мы рассказываем, как совместное проектирование модели, системы и оборудования позволяет добиться качества, близкого к ранжированию, при масштабах этапа подбора.
Проблемы и возможности масштабирования подбора
Внедрение Andromeda в 2024 году предполагало переработку этапа подбора: от специализированного оборудования для ИИ с иерархической индексацией и GPU-операторами до специально созданной модели машинного обучения — всё было оптимизировано сквозным образом. Это позволило увеличить ёмкость модели на четыре порядка. С тех пор инструменты генеративного ИИ для создания рекламных материалов помогли рекламодателям быстро выпускать сотни миллионов новых объявлений, доведя пул рекламных кандидатов Meta до беспрецедентного масштаба.
Чтобы оценивать такой большой пул рекламных кандидатов с помощью более точной модели и при значительно более высокой пропускной способности системы, необходимы фундаментальные технологические прорывы в качестве модели, архитектуре системы и использовании оборудования — и все эти направления нужно развивать совместно.
Для повышения качества модели нужна новая архитектура
Подбор рекламы обеспечивает непропорционально высокую отдачу от небольшого повышения качества: даже незначительное улучшение модели подбора может существенно увеличить ценность для рекламодателей. Быстрое расширение пула рекламных кандидатов делает оптимизацию отдачи от вычислительных ресурсов оборудования всё более важной. Модели подбора Meta Andromeda 2024 года заложили эффективную основу благодаря глубокой нейросетевой архитектуре, оптимизированной для GPU. Однако, чтобы и дальше повышать качество подбора при устойчивых вычислительных затратах и нынешних масштабах, необходимо выйти за рамки этой парадигмы. Для этого требуется фундаментально изменить архитектуру и значительно расширить возможности модели без пропорционального роста затрат.
Новые узкие места системы на миллиардных масштабах
Система Meta Andromeda 2024 года обрабатывает десятки миллионов объявлений в секунду на одной карте GPU. Чтобы удовлетворить новые потребности бизнеса, системе необходимо обрабатывать несколько миллиардов объявлений в секунду на одной карте. При такой пропускной способности новым узким местом становится пропускная способность памяти, необходимая для передачи тензоров объявлений по иерархии памяти. На промежуточные тензоры между GPU-ядрами приходится трафик в несколько терабайт в секунду, а передача объявлений между локальными узлами CPU и удалёнными аппаратными ускорителями, на которых выполняются модели, насыщает сетевой канал. Для решения этой проблемы требуется новая совместно спроектированная система, объединяющая разрозненные распределённые задачи в единый конвейер GPU.
На пути к пределам возможностей оборудования
Когда подбор выполняется на GPU, ключевой вопрос оптимизации звучит так: «Насколько близко мы подошли к пределу возможностей оборудования и какой запас остаётся для дальнейшего роста модели?» Чтобы ответить на него, нужно довести каждый компонент конвейера подбора до предела возможностей оборудования текущего поколения. Именно эта задача стала стимулом для совместной работы с NVIDIA.
Каждая из этих проблем привела к соответствующему усовершенствованию.
Повышение эффективности подбора благодаря совместному проектированию модели и системы
Архитектура модели подбора нового поколения — смесь экспертов для подбора
В последней версии Meta Andromeda появились три взаимодополняющих архитектурных новшества, которые переносят в подбор вдохновлённый большими языковыми моделями (LLM) подход смеси экспертов (MoE) (см. рисунок 1). Благодаря этой выразительной и в то же время эффективной при инференсе архитектуре удалось выйти на новый рубеж Парето между качеством и эффективностью подбора: в типичной системе «подбор — затем ранжирование» качество модели приближается к уровню ранжирования, а вычисления с плавающей запятой (FLOP) во время инференса требуют примерно в 300 раз меньше операций, чем модель подбора Meta Andromeda 2024 года.
В части моделирования пользователей мы перешли от одной пользовательской башни к ансамблю специализированных пользовательских башен, выступающих в роли экспертов. Это позволяет учитывать разнообразные, меняющиеся со временем и зависящие от контекста интересы пользователей, объединяя широкий спектр высокоточных сигналов: последовательности взаимодействий с рекламой, представления когорт пользователей, семантические признаки, полученные с помощью LLM, и сигналы совместного взаимодействия на разных поверхностях.
В башне рекламных кандидатов мы используем стратегию совместного кодирования с учётом контекста показа в реальном времени, чтобы модели взаимодействия на следующих этапах получали контекстуализированные представления.
В надстройке слоя взаимодействия модель взаимодействия перешла от плотных нейронных сетей к сети маршрутизации на основе внимания и смеси экспертов, которая динамически направляет кандидатов к наиболее релевантным пользовательским экспертам и обеспечивает качество, близкое к уровню ранжирования, при значительно меньшем количестве операций с плавающей запятой.
Ключевая особенность новой архитектуры — её производительность совместно проектировалась с учётом модели выполнения на аппаратном уровне. Пропускная способность инференса модели превысила 10 миллиардов объявлений в секунду на одном GPU GH200. Такая эффективность позволяет и дальше наращивать ёмкость модели — за счёт более сложных взаимодействий признаков, дополнительных подсетей экспертов и более глубоких архитектур — без пропорционального увеличения затрат на GPU. Каждое очередное усовершенствование модели повышает ценность для рекламодателей.
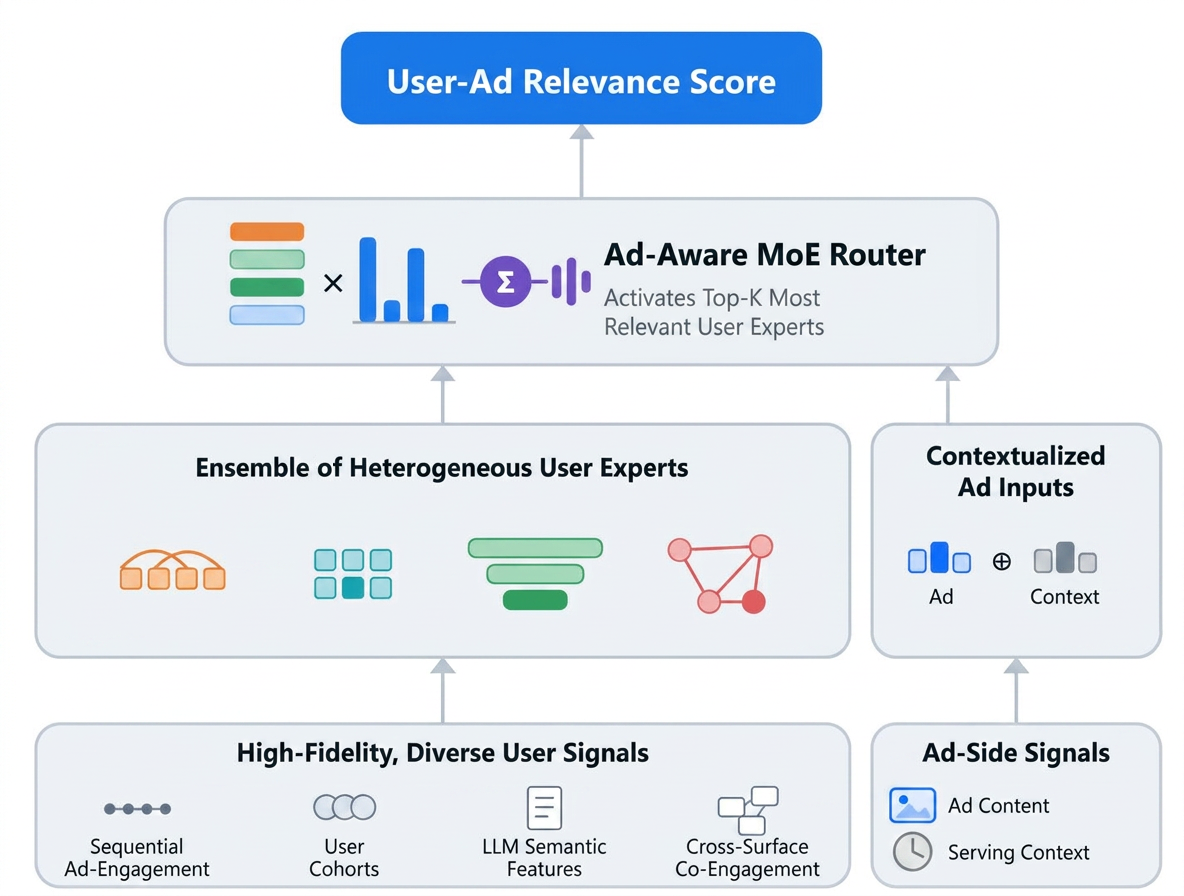 Рисунок 1. Архитектура смеси экспертов для подбора. Разнообразные высокоточные сигналы о пользователе поступают в ансамбль неоднородных пользовательских экспертов. Рекламный контент объединяется с контекстом показа в реальном времени, формируя контекстуализированный вход объявления, который направляет работу учитывающего рекламу маршрутизатора MoE. Он активирует только K наиболее релевантных экспертов, чтобы оценить релевантность пары «пользователь — объявление». В результате качество сопоставления соответствует уровню ранжирования при масштабах подбора — примерно в 300 раз меньше операций с плавающей запятой во время инференса, чем у Meta Andromeda 2024 года, и более 10 миллиардов объявлений в секунду на одном суперчипе Grace Hopper.
Совместное проектирование модели и системы для единого конвейера GPU
Meta Andromeda 2026 года выводит совместное проектирование модели и системы на новый уровень благодаря двум нововведениям: единому GPU-ядру, объединяющему работу модели и системы для каждого взаимодействия пользователя с объявлением, и стратегии размещения логики запросов пользователя и GPU-ядер обработки пар «пользователь — объявление» на одном GPU-сервере. Для этого создан высокооптимизированный полностью объединённый конвейер GPU, в котором выполняется весь сквозной рабочий процесс Meta Andromeda.
Объединённое ядро
В целом инференс Meta Andromeda для каждого взаимодействия пользователя с объявлением представляет собой компактную последовательность операций модели и системной логики: получение эмбеддингов, выполнение моделей взаимодействия пользователя с объявлением и расчёт оценки. Сокращение количества операций с плавающей запятой примерно в 300 раз благодаря архитектуре маршрутизации MoE для подбора создаёт необходимый запас ресурсов и упрощает полное объединение выполнения модели и системных задач в одно GPU-ядро. В отличие от запуска 2024 года, когда объединялись только операции внутри модели, теперь объединяются оба типа операций. В результате объединённое ядро обрабатывает более 10 миллиардов объявлений в секунду на одном GH200.
Это важно, поскольку задачи подбора в первую очередь ограничены пропускной способностью памяти. При обработке миллиардов объявлений в секунду даже небольшой промежуточный тензор для каждого объявления превращается в трафик объёмом несколько терабайт в секунду для памяти с высокой пропускной способностью (HBM). В конвейерах подбора с несколькими ядрами основным узким местом становится нагрузка на память от промежуточных тензоров, а не вычисления.
Объединённое ядро полностью устраняет это узкое место. Вместо запуска множества небольших GPU-ядер для операций модели и системы оно за один проход выполняет все вычисления для каждой пары «пользователь — объявление». Промежуточные результаты остаются в регистрах GPU и разделяемой памяти блоков потоков и не записываются в HBM. Это позволяет эффективно использовать пиковую пропускную способность памяти GPU, не расходуя её впустую на передачу избыточных промежуточных данных.
Стратегия совместного размещения
При изолированном измерении объединённое ядро для каждой пары «пользователь — объявление» обрабатывает несколько миллиардов объявлений в секунду на одном GPU. Однако операции для каждого запроса пользователя, такие как сопоставление с индексом (то есть применение правил таргетинга рекламодателей) и отбор K лучших вариантов, выполняются на отдельных локальных узлах CPU и обмениваются данными через сеть со службой подсчёта на объединённом GPU-ядре, размещённой на удалённых ускорителях. При пропускной способности в несколько миллиардов объявлений в секунду одного этого трафика достаточно, чтобы насытить сетевой канал. В результате узким местом становится пропускная способность сети, а не вычислительные ресурсы GPU.
Решение, основанное на совместном проектировании, состояло в том, чтобы привести архитектуру системы в соответствие с архитектурой модели: разместить сопоставление с индексом, подсчёт оценок и отбор K лучших вариантов на одном GPU. Вместо передачи больших списков кандидатов между узлами система отправляет на один GPU-сервер компактный пакет запроса — признаки пользователя и запрос таргетинга. Сервер локально выполняет весь конвейер подбора и возвращает только итоговые K лучших вариантов. Это сокращает сетевой трафик примерно в 100 раз и позволяет вновь перейти к режиму, ограниченному вычислительными возможностями GPU.
Перенести сопоставление с индексом на GPU непросто. При сопоставлении объявлений с индексом обрабатывается сложная логика таргетинга, заданная рекламодателями и охватывающая десятки категорий признаков; кроме того, необходимо поддерживать обновление индекса в реальном времени по мере создания, изменения и истечения срока действия объявлений в течение дня. Для этого пришлось переработать структуру индекса с учётом параллельного выполнения на GPU, сохранив при этом полную точность семантики таргетинга в рабочей среде.
Единый конвейер GPU для Meta Andromeda
Объединив два описанных выше нововведения, полностью совместно размещённый конвейер на одном GPU обрабатывает более миллиарда объявлений в секунду на одном GPU-сервере, оценивая каждое подходящее объявление в пуле кандидатов. Это новый рекорд пропускной способности для моделей этапа подбора рекламы; как будет рассказано в следующем разделе, потенциал для дальнейшего роста ещё значителен.
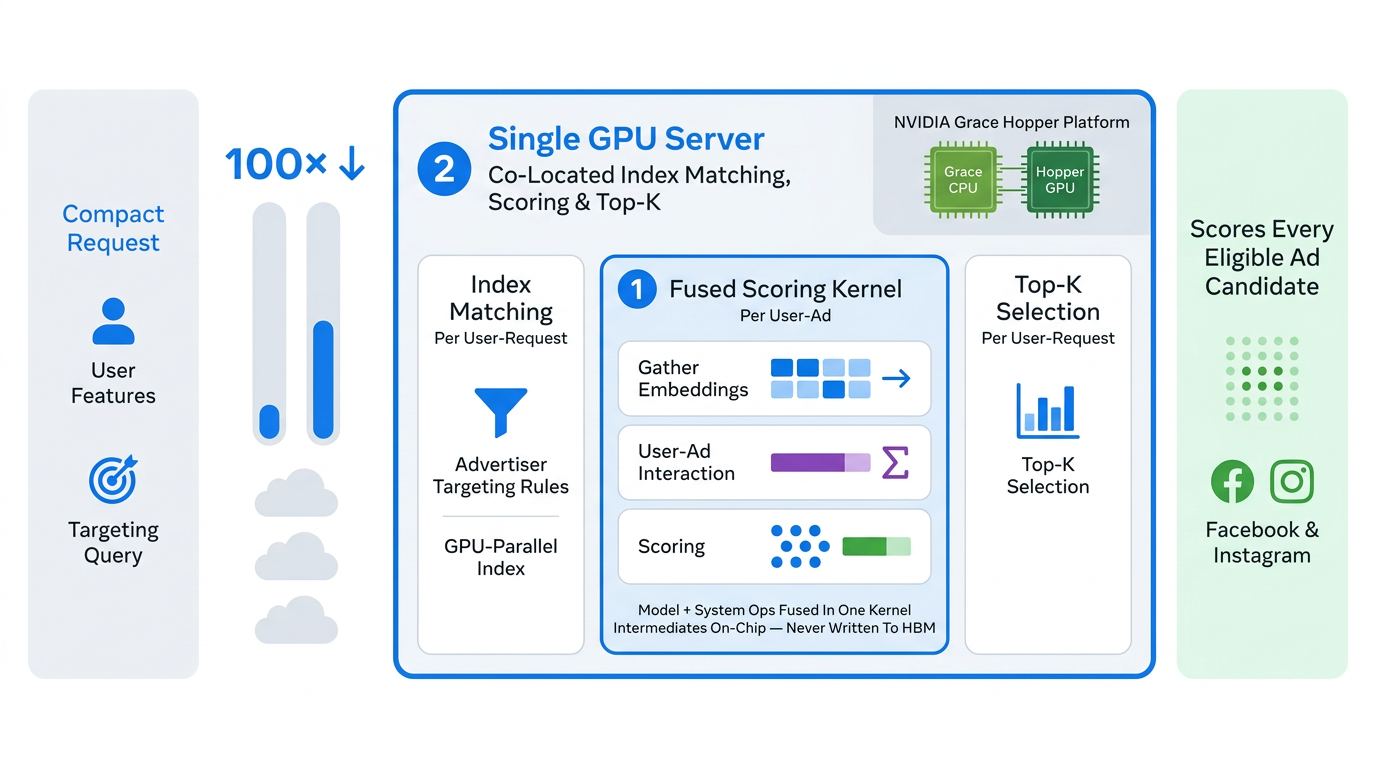 Рисунок 2. Архитектура единого объединённого конвейера GPU для Meta Andromeda. В этом конвейере сопоставление с индексом, объединённый подсчёт оценок и отбор K лучших вариантов выполняются на одном GPU-сервере. Объединённое ядро подсчёта за один проход на чипе выполняет все вычисления для каждой пары «пользователь — объявление» — от получения эмбеддингов до взаимодействия MoE и расчёта оценки. Промежуточные результаты остаются в регистрах и разделяемой памяти, что устраняет узкие места HBM. Благодаря совместному проектированию сетевой трафик сокращается примерно в 100 раз: передаются только компактные пакеты запросов. Конвейер обрабатывает более 1 миллиарда объявлений в секунду, оценивая каждое подходящее объявление на Facebook и Instagram.
Подбор на GPU: сотрудничество Meta и NVIDIA
Когда рабочий конвейер обрабатывает более миллиарда объявлений в секунду, возникает закономерный вопрос: насколько близко система подошла к пределу возможностей оборудования текущего поколения и какой запас остаётся для дальнейшего роста модели? В начале 2026 года Meta и NVIDIA начали совместную работу, чтобы ответить на этот вопрос: они систематически оптимизируют каждый компонент конвейера подбора, повышая пропускную способность до пределов возможностей оборудования. NVIDIA предоставила оптимизированные GPU-ядра, а Meta интегрировала их и провела сравнительное тестирование всего конвейера. Каждый компонент показал ускорение в 2–5 раз по сравнению с исходной версией.
Сеть взаимодействия (сеть маршрутизации MoE для подбора)
Оптимизированное ядро маршрутизации стало работать в 5,3 раза быстрее: его пропускная способность выросла с 2,4 миллиарда до более чем 10 миллиардов объявлений в секунду, достигнув примерно 85% пиковой пропускной способности HBM графического процессора. При такой пропускной способности время выполнения и задержка механизма маршрутизации не уступают показателям простого ядра подсчёта скалярного произведения на том же оборудовании, хотя модель значительно выразительнее. Это подтверждает эффективность совместного проектирования: дополнительная сложность модели практически ничего не стоит на оборудовании с тензорными ядрами. Квантование INT8 обеспечило дальнейшее увеличение пропускной способности — до 2 раз по сравнению с оптимизированными ядрами FP16 при точности, сопоставимой с 16-битной.
Сопоставление с индексом
Благодаря целевой оптимизации GPU-ядер пропускная способность сопоставления с индексом выросла более чем в 2 раза и превысила 100 миллиардов объявлений в секунду — на порядок больше, чем у сети подсчёта оценок. Такой запас позволяет повторно выполнять сопоставление с индексом в нескольких сценариях подбора, не создавая узкого места.
Сквозной конвейер GPU
Помимо оптимизации отдельных ядер, в ходе совместной работы был профилирован весь процесс подбора. Это позволило выявить, что значительную часть сквозной задержки составляет перемещение данных между компонентами конвейера, а не вычисления. Совместно спроектировав структуры данных для сопоставления с индексом и подсчёта оценок и устранив ненужные промежуточные операции, команда избавилась от этих накладных расходов. После применения всех оптимизаций пропускная способность всего конвейера на одном GPU-сервере в несколько раз превышает нынешний производственный показатель; ожидается дальнейший рост по мере внедрения дополнительных оптимизаций.
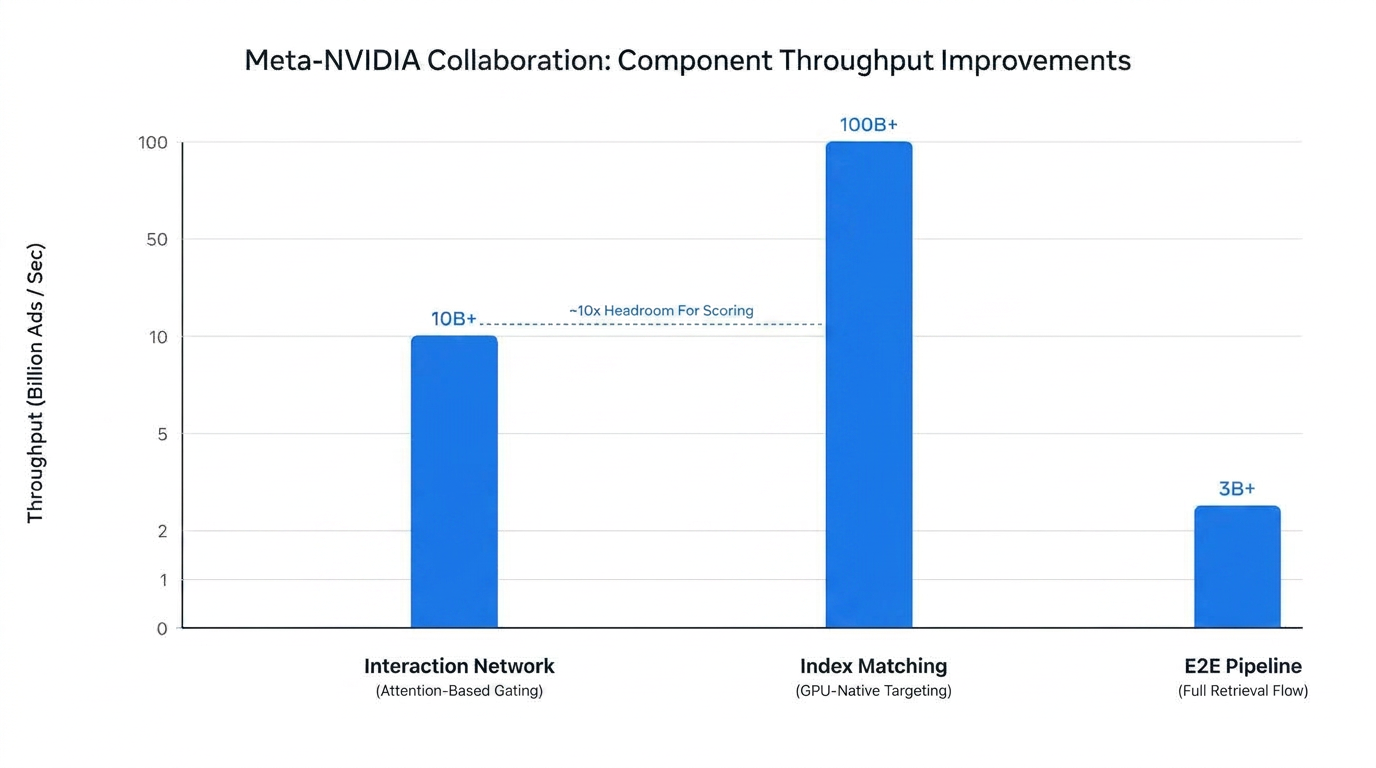 Рисунок 3. Оптимизированная пропускная способность в объявлениях в секунду для сети взаимодействия, сопоставления с индексом и сквозного конвейера.
Продолжение работы на платформах NVIDIA нового поколения
Опираясь на результаты для Hopper, описанные выше, мы расширяем работу по оптимизации и совместному проектированию на Grace Blackwell. Сейчас мы сосредоточены на оптимизации платформы, позволяющей задавать различные соотношения вычислительных ресурсов CPU и GPU. Как показывают наши предыдущие исследования, это важный фактор для задач типа Andromeda. Мы оцениваем, насколько производительность приложений в целом зависит от этих соотношений, используя CPU класса Grace и GPU класса Blackwell для соответствующих частей задачи.
В более широком смысле мы изучаем, как применить полученные результаты на платформах следующего поколения, где большая гибкость выполнения задач на CPU и GPU, распределения ресурсов и их взаимодействия позволит эффективнее использовать эти архитектурные усовершенствования в задачах типа Andromeda.
Эти результаты подтверждают, что совместно спроектированный конвейер подбора ещё не достиг предела своих возможностей. Квантование обеспечивает дальнейший рост пропускной способности подсчёта оценок, а скорость сопоставления с индексом на порядок превышает скорость сети подсчёта. Благодаря этому архитектура способна поддерживать значительно более сложные модели — более глубокие сети взаимодействия, разнообразные пространства признаков и дополнительные сценарии подбора — без пропорционального роста инфраструктуры.
Дальнейшее развитие подбора рекламы
Все описанные здесь достижения основаны на одном принципе: наибольший эффект даёт проектирование модели, системы и оборудования как единого комплекса, а не оптимизация каждого компонента по отдельности. Архитектура маршрутизации MoE для подбора обеспечивает выразительность, близкую к уровню ранжирования, без дополнительных затрат на обслуживание. Объединение всего конвейера подбора на одном GPU устраняет сетевые узкие места и ограничения по памяти. А приближение конвейера к пределу возможностей оборудования подтверждает, что значительный потенциал для дальнейшего роста сохраняется.
В дальнейшем принцип совместного проектирования, благодаря которому удалось добиться этих результатов, будет применяться и к архитектурам моделей и аппаратным платформам следующего поколения. Продемонстрированный запас ресурсов позволит продолжать масштабирование без пропорционального роста инфраструктуры.
Для пользователей продуктов Meta это означает, что им будет показываться более подходящая реклама при той же задержке. Для рекламодателей — более точное соответствие интересам клиентов и больше конверсий. Для Meta — рост бизнеса за счёт рекламодателей и снижение затрат, поскольку каждый GPU теперь оценивает больше объявлений в секунду. По мере дальнейшего увеличения числа подходящих объявлений благодаря автоматизации Advantage+ и инструментам генеративного ИИ для создания рекламных материалов архитектура Meta Andromeda, основанная на совместном проектировании, будет масштабироваться вместе с ним.
Благодарности
Мы хотели бы поблагодарить Gosh Arzumanyan, Habiya Beg, Andrew Bocking, Zain Brohi, Rohit Chandel, Claire Chen, Jason Chen, Wenlin Chen, Zhenyu Chen, Yuze Dai, Zhou Fang, Junjie Feng, Stephen Fitz, Chunli Fu, Yicong Fu, Xiaorui Gan, Sohan Gantala, Yingsheng Gao, Golnaz Ghasemiesfeh, Ishu Goyal, Wentian Guo, George Han, Yihan He, Jun Hu, Xuan Hu, Kun Huang, Qin Huang, Tianchen Ji, Crystal Jin, Tao Ju, Rajat Karnwal, Santanu Kolay, Michael Kwan, Ilia Lewis, Baiyu Li, Chao Li, Jim Li, Li Li, Lin Li, Liyuan Li, Mingda Li, Ted Li, Xiaotian Li, Yanyu Liang, Yue Liang, Irene Liu, Gaoxiang Liu, Jason Liu, Siqi Liu, Wei Liu, Xiao Liu, Yuheng Long, Yining Lu, Siyi Luo, Anuj Madan, Phalguna Mankar, Jiachen Mao, Yuji Mo, GP Musumeci, Guruswamy Namasivayam, Kexin Nie, Sandeep Pandey, Uladzimir Pashkevich, Clementine Plati, Heng Qiao, Hang Qu, Lei Qu, Anand Rajan, Jatin Sethi, Puneet Sharma, Ruchit Sharma, Yan Shi, Chang Shu, Sean Song, Alec Stashevsky, Matt Steiner, Zheng Sun, Nikhil Vinayak Supekar, Jim Tao, Chintan Thakkar, Tian Tong, Aleksandr Ulanov, Daksh Vasistha, Simha Venkataramaiah, Abhishek Verma, Ruud Vinke, Vidhoon Viswanathan, Sasha Vorontsov, Eric Walden, Dong Wang, Feng Wang, Haole Wang, Jeff Wang, Senhong Wang, Ye Wang, Di Wu, Haocheng Wu, Shawn Wu, Jimmy Xiang, Nan Xiao, Ruichao Xiao, Chao Xie, Yudi Xie, Fangzhou Xu, Nathan Yan, Tak Yan, Hang Yang, Song Yang, Yuhan Yang, Yavuz Yetim, Bowen Yu, Li Yu, Qifan Yuan, Xiaodong Yuan, Lin Zeng, Siqi (Cindy) Zeng, Caijie Zhang, Joanna Zhang, Min Zhang, Qing Zhang, Zhengkai Zhang, Fangyu Zou, а также всю команду v-team, благодаря которой Meta Andromeda добилась успеха.
