Как использовать доступные вычислительные мощности для ИИ-инференса, чтобы улучшить рекомендации рекламных объявлений
- Meta объединяет простаивающие серверные ресурсы в общий пул для дополнительного инференса рекламных рекомендаций.
- RMA оценивает больше объявлений-кандидатов, а SBM направляет больше запросов мощным моделям в зависимости от доступных ресурсов.
- При отзыве мощностей система сокращает дополнительную работу, защищая базовый трафик, его задержки и надёжность.
Почему это важно: Это помогает показывать людям более релевантную рекламу и повышает эффективность рекламы для рекламодателей без заказа дополнительных мощностей.
- В Meta мы создали систему, которая улучшает рекомендации рекламы, используя простаивающие вычислительные мощности нашего парка серверов для инференса.
- Два механизма эластичного масштабирования позволяют системе наращивать объём работы по рекомендациям рекламы за счёт доступных в данный момент вычислительных ресурсов, не ухудшая базовую производительность.
- В этой статье мы рассказываем, как разработали систему и теперь эксплуатируем её в масштабах Meta, а также как она приносит рекламодателям значительную пользу и повышает эффективность использования вычислительных мощностей.
Парки серверов для инференса сталкиваются с парадоксом мощностей: в целом их может не хватать, даже если отдельные ресурсы простаивают. В Meta мы создали систему, которая объединяет такие свободные ресурсы в общий пул доступных вычислительных мощностей и использует их для улучшения рекомендаций рекламы. Благодаря использованию простаивающих ресурсов система помогает показывать людям более релевантную рекламу и повышает эффективность рекламы для рекламодателей без необходимости заказывать дополнительные мощности.
Безопасно использовать такие доступные вычислительные мощности непросто. Они распределены между ресурсами, выделенными отдельным командам, регионами и типами ускорителей, и могут быть отозваны почти без предупреждения. Поэтому система инференса рекламы должна адаптировать нагрузку к изменению доступных мощностей, не перегружая выделенные ресурсы, обслуживающие базовую нагрузку.
Для решения этой задачи мы используем два взаимодополняющих механизма эластичного масштабирования. Ранжировать больше объявлений (RMA) — корректировать количество кандидатов, оцениваемых на этапах ранжирования. Использовать более эффективные модели (SBM) — корректировать долю запросов, направляемых более мощной модели.
Физическая и логическая изоляция защищает мощности, зарезервированные для базового обслуживания. Раздельные контуры обратной связи регулируют количество кандидатов для RMA и охват моделей для SBM, а отбрасывание нагрузки с учётом её ценности как на серверах, так и на клиентах позволяет системе плавно снижать производительность, когда вычислительные мощности внезапно отзываются. В совокупности эти механизмы позволяют наращивать и сокращать дополнительную работу вместе с доступными вычислительными мощностями, защищая задержки и надёжность.
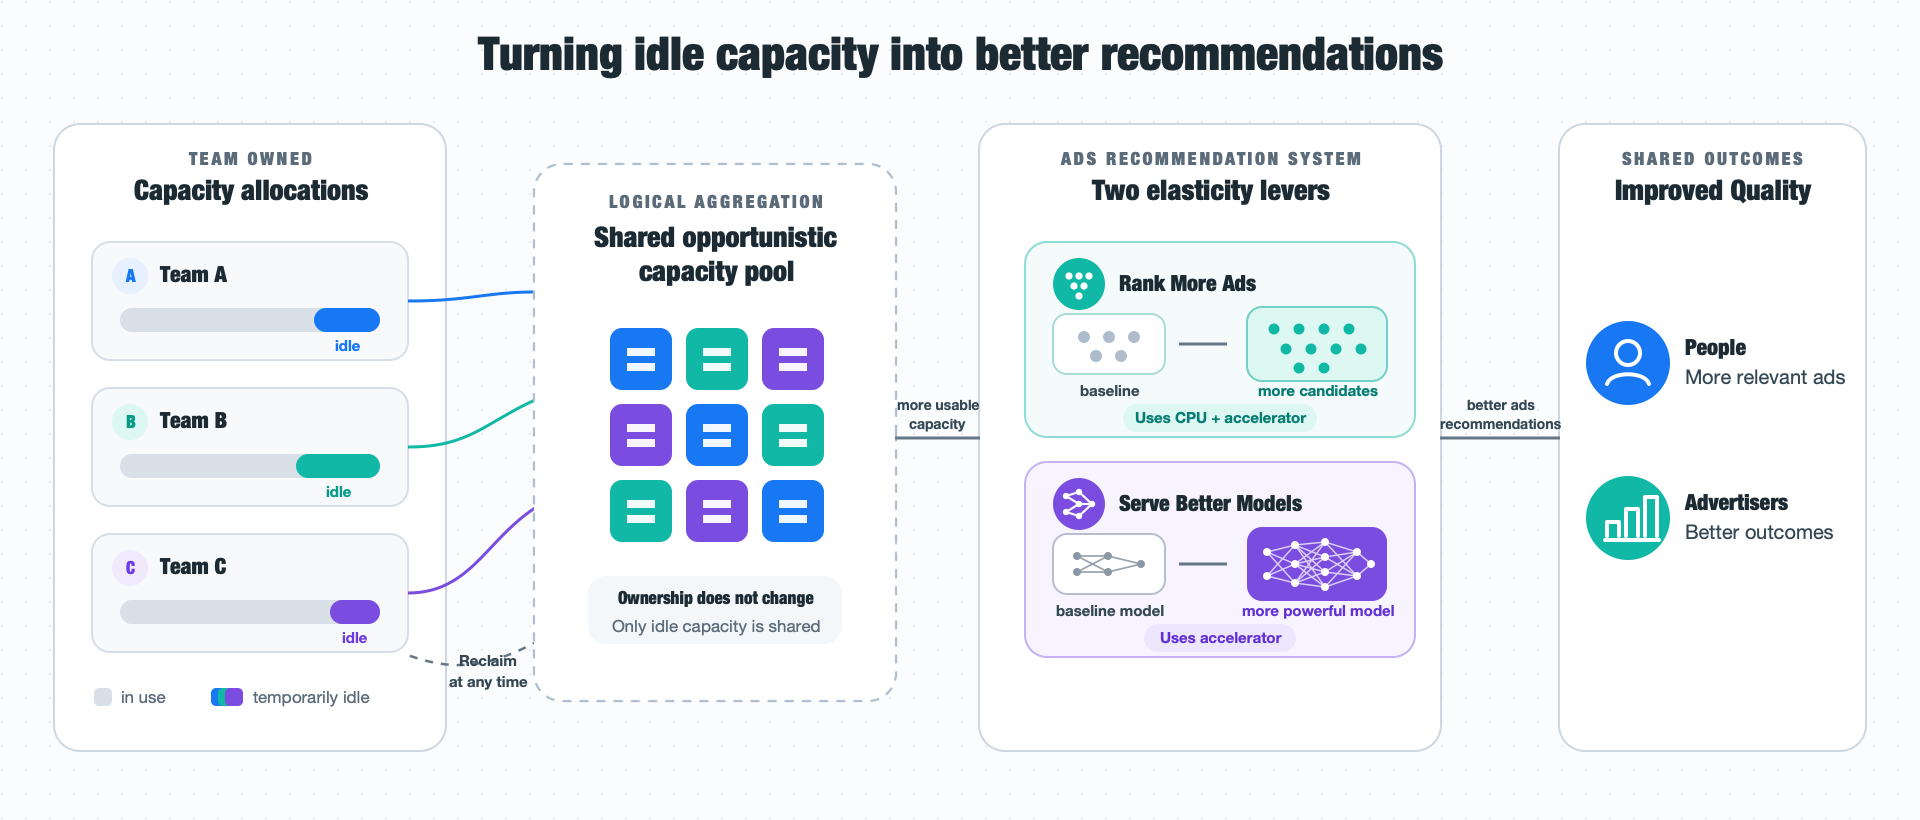
Парадокс мощностей для инференса: в целом их не хватает, но отдельные ресурсы простаивают
Парки серверов для инференса должны располагать достаточными мощностями, чтобы справляться со спросом при строгих требованиях к задержкам и надёжности. Однако спрос и доступные мощности редко идеально совпадают по времени, регионам, сочетаниям ресурсов и типам ускорителей. Поэтому даже при общей нехватке мощностей в отдельных частях парка серверов ресурсы могут простаивать. К распространённым причинам относятся:
- Несоответствие между мощностями для пиковых нагрузок и колебаниями спроса: Парки серверов для инференса должны быть рассчитаны на пиковый спрос, тогда как трафик меняется в течение дня и сезона. Поэтому мощности, необходимые в периоды пиковой нагрузки, могут временно простаивать при снижении спроса.
- Несоответствие между сроками разработки моделей и поставки мощностей: Мощности для инференса поступают в соответствии с графиками цепочки поставок, тогда как модели разрабатываются и запускаются по отдельному расписанию. Из-за этого возникает разрыв между моментом появления доступных мощностей и готовностью моделей их использовать.
- Несоответствие региональных соотношений ресурсов: Для рабочих нагрузок инференса нужны ускорители, а также вспомогательные ресурсы, например процессоры. Если эти ресурсы доступны не в требуемых пропорциях, одни могут простаивать, в то время как другие ограничивают возможности обслуживания запросов.
- Несоответствие типов ускорителей: В парках серверов для инференса могут использоваться ускорители разных производителей, поколений и архитектур. Рабочие нагрузки не всегда можно переносить между такими типами ускорителей, поэтому часть мощностей может оказаться невостребованной на оборудовании, которое не способно немедленно обслуживать имеющийся спрос.
Эти несоответствия приводят к общему для всей отрасли парадоксу мощностей для инференса: в целом их может не хватать, хотя отдельные ресурсы простаивают. В масштабах Meta такие временно свободные мощности в совокупности могут быть значительными и при безопасном использовании позволяют улучшить рекомендации рекламы.
От разрозненных резервов к общему пулу доступных вычислительных мощностей
В неоднородном парке серверов масштаба Meta периоды, когда мощности для инференса простаивают, неизбежны — даже при заблаговременном планировании, призванном свести к минимуму системные несоответствия. Однако эти мощности неразрывно связаны с меняющимися базовыми потребностями и поэтому сопряжены с особыми эксплуатационными ограничениями: их можно отозвать в любой момент, их доступность крайне нестабильна, а долгосрочные гарантии отсутствуют.
Чтобы эффективно использовать этот нестабильный ресурс, не ухудшая базовую производительность, рабочие нагрузки должны обладать определёнными структурными свойствами:
- Высокая эластичность рабочей нагрузки: Рабочая нагрузка способна быстро добавлять или убирать большой объём дополнительных задач по мере изменения доступных мощностей, не влияя на базовые показатели.
- Стабильное повышение качества в больших масштабах: Рабочая нагрузка способна существенно улучшать качество результатов во всём диапазоне мощностей, которые может предоставить общий пул. Благодаря этому свойству такая рабочая нагрузка часто уже использует значительный объём выделенных мощностей.
- Минимум зависимостей от других сервисов: Автономная рабочая нагрузка уменьшает количество вышестоящих и нижестоящих систем, которым приходится реагировать на нестабильность доступных мощностей.
Два взаимодополняющих механизма эластичного масштабирования
Опираясь на эти структурные свойства, мы определили два взаимодополняющих механизма, которые отвечают этим критериям, позволяют использовать простаивающие мощности и открывают значительные возможности для повышения ценности.
Ранжировать больше объявлений (RMA)
Для каждого запроса пользователя система рекомендаций рекламы должна менее чем за секунду выбрать небольшое число объявлений из миллионов кандидатов. Система использует последовательность этапов ранжирования, на каждом из которых всё более мощные модели машинного обучения оценивают всё меньшие наборы кандидатов. На последующих этапах оцениваются только кандидаты, занявшие верхние позиции на предыдущем этапе.
Когда доступны дополнительные вычислительные мощности, RMA увеличивает количество кандидатов, оцениваемых на этапах ранжирования. Оценка большего числа кандидатов повышает вероятность найти объявления, релевантные пользователю. Поскольку дополнительные кандидаты проходят как ресурсоёмкие для процессоров этапы обработки до инференса (например, извлечение кандидатов и обработку признаков), так и инференс на ускорителях, RMA, как правило, требует избытка и процессорных мощностей, и мощностей ускорителей.
Использовать более эффективные модели (SBM)
Для оценки рекламы можно использовать модели разной сложности. Более мощные модели способны повысить качество прогнозов, но применять их для каждого запроса за счёт выделенных мощностей неэффективно.
SBM меняет долю запросов, оцениваемых более мощными моделями, в зависимости от доступности мощностей ускорителей. Количество объявлений, поступающих на этапы ранжирования, остаётся неизменным, поэтому спрос на процессорные мощности на предыдущих этапах остаётся относительно стабильным. Благодаря этому SBM может использовать избыток мощностей одних только ускорителей, недоступный для RMA.
Компонент маршрутизации моделей SBM использует сигналы ценности запросов, чтобы в первую очередь направлять к более мощной модели запросы, для которых ожидается наибольшая польза от её применения.
Почему необходимы оба механизма
Эти два механизма используют разные сочетания ресурсов. RMA требует мощностей и процессоров, и ускорителей, тогда как SBM может использовать мощности ускорителей без существенного увеличения нагрузки на процессоры на предыдущих этапах. Вместе они позволяют использовать более широкий спектр доступных вычислительных мощностей, чем каждый из механизмов по отдельности.
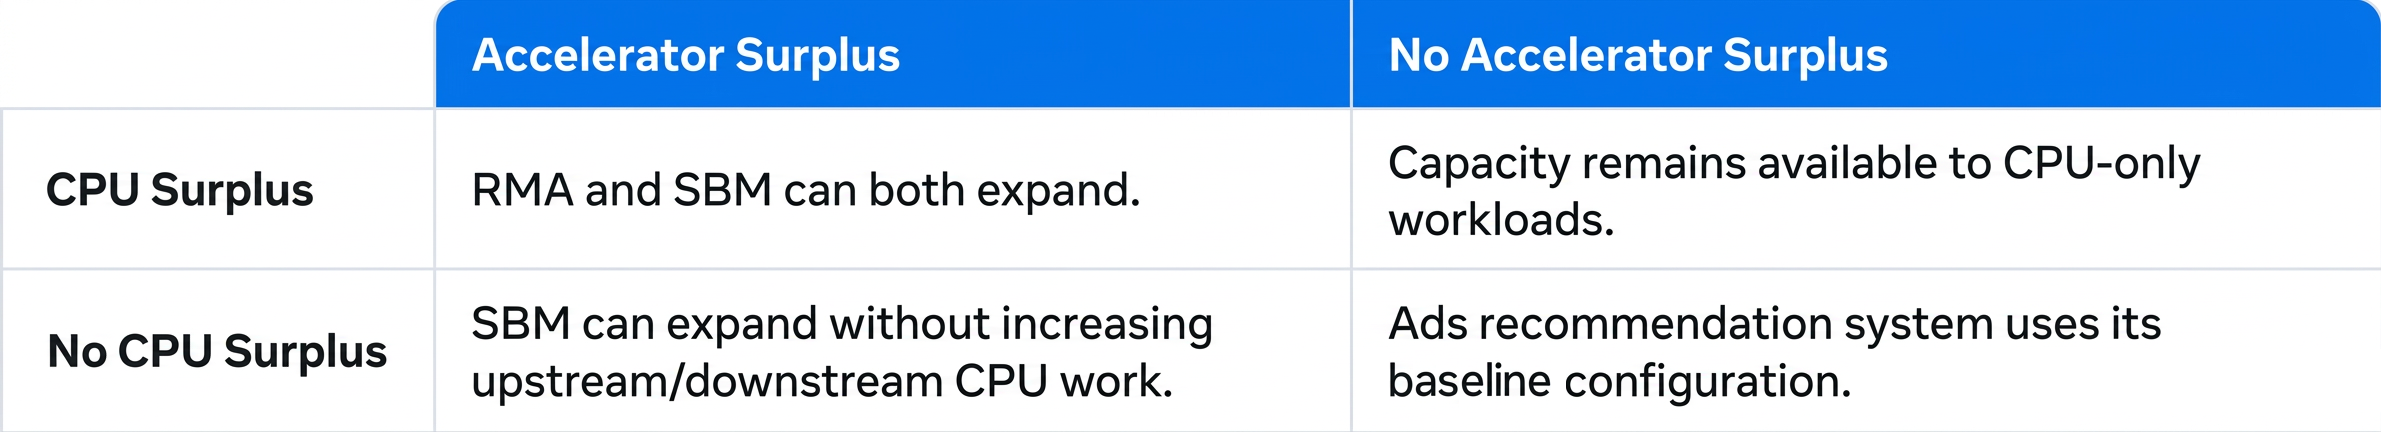
Вклад каждого механизма также меняется в зависимости от трафика, текущего охвата и доступного сочетания ресурсов. В конкретный момент следующая единица доступных вычислительных мощностей может помочь показывать более релевантную рекламу — за счёт ранжирования дополнительных кандидатов для показа более подходящих объявлений или направления большего числа запросов мощной модели для повышения точности прогнозов. Мы периодически корректируем распределение мощностей между RMA и SBM с учётом измеренных показателей эффективности и потребностей в ресурсах.
Безопасное использование доступных вычислительных мощностей для инференса рекламы
Доступные вычислительные мощности могут быть отозваны быстрее, чем контуры управления успеют отрегулировать нагрузку на крупном парке серверов. Поэтому в основу системы заложено следующее требование: потеря доступных мощностей может сократить объём дополнительной работы по ранжированию, но не должна приводить к перегрузке ресурсов, обслуживающих базовую нагрузку. Для этого мы используем изолированные цели маршрутизации, два контура обратной связи для разных рабочих нагрузок и быстрое локальное отбрасывание нагрузки.
Защита базового трафика за счёт физической и логической изоляции
Дополнительная работа не должна занимать мощности, зарезервированные для базового обслуживания. SBM и RMA обеспечивают это разделение разными способами.
В SBM изоляция физическая. Для базовых и более мощных моделей используются отдельные цели маршрутизации. Выделенные реплики рассчитаны на обслуживание запросов базовой моделью, а реплики, работающие на доступных вычислительных мощностях, обслуживают запросы, отобранные для более мощной модели. При сокращении доступных мощностей система уменьшает долю запросов, направляемых более мощной модели. Вместо неё эти запросы обрабатываются базовой моделью, мощности для которой уже предусмотрены.
В RMA изоляция логическая. Система рассчитывает, какой дополнительный объём работы по ранжированию кандидатов могут поддерживать реплики моделей, развёрнутые на доступных вычислительных мощностях, и на основе общих мощностей устанавливает глобальный лимит для RMA. Каждая реплика модели может получать как базовые, так и дополнительные задачи; физически разделять отдельные запросы не требуется. Базовый трафик защищён благодаря тому, что общий объём дополнительной работы ограничен уровнем, который могут поддерживать эти реплики.
При сокращении доступных вычислительных мощностей RMA снижает глобальную целевую величину количества кандидатов, а SBM уменьшает охват более мощной модели. В обоих случаях система убирает дополнительную работу, а не переносит её на мощности, зарезервированные для базового обслуживания. Это позволяет поддерживать показатели задержки и надёжности базового трафика в заданных пределах.
Регулирование количества кандидатов с помощью обратной связи по задержкам
В RMA используется замкнутый контур обратной связи, состоящий из центрального пропорционально-интегрально-дифференциального (ПИД) регулятора и средств управления на стороне клиента. Если упростить, регулятор использует наблюдаемую задержку на хвосте распределения, чтобы определить целевое количество объявлений, отправляемых на последующие этапы ранжирования, а клиенты применяют это значение к новым запросам. Если задержка ниже целевого уровня, регулятор увеличивает число ранжируемых объявлений. При росте задержки он сокращает это число. Таким образом, RMA использует сигнал задержки, на который влияет ситуация с доступными мощностями, чтобы при изменении условий определить устойчивое количество кандидатов.
Маршрутизация запросов с выбором модели с учётом ценности
В SBM используется аналогичный контур обратной связи с центральным управлением и маршрутизацией на стороне клиента. Центральный регулятор задаёт целевой охват более мощной модели, а клиентский маршрутизатор решает, какие подходящие запросы будут обработаны этой моделью, а какие продолжат проходить через базовую.
Маршрутизатор использует сигнал ценности запроса, чтобы распределять запросы по сегментам на основе прогнозируемой вероятности взаимодействия пользователя с объявлением. В процессе исследования и использования накопленных знаний периодически измеряется дополнительный эффект от применения более мощной модели в каждом сегменте и корректируется распределение запросов между двумя моделями. Это необходимо, поскольку дополнительная польза от более мощной модели не всегда соответствует абсолютной ценности запроса. Кроме того, в каждом сегменте сохраняется доля исследовательского трафика, чтобы система продолжала собирать наблюдения, необходимые для адаптации, а не закрепляла устаревшее решение о маршрутизации.
Контур калибровки помогает поддерживать фактическую долю трафика близкой к целевой по мере изменения его структуры в разных регионах и с течением времени. При сокращении мощностей центральный регулятор уменьшает целевой охват, а клиент направляет меньше запросов более мощной модели. Запросы, исключённые из дополнительного контура, продолжают обрабатываться базовой моделью.
Многоуровневое отбрасывание нагрузки с учётом ценности
Контуры обратной связи RMA и SBM непрерывно согласуют дополнительную работу с доступными мощностями, однако их центральные компоненты работают с периодичностью в несколько минут. Поэтому при внезапном отзыве мощностей они могут исчезнуть раньше, чем клиенты получат новые целевые значения. Для защиты обеих рабочих нагрузок система использует механизмы, учитывающие ценность работы и способные реагировать немедленно:
Отбрасывание нагрузки на стороне сервера: Если доступные вычислительные мощности сокращаются раньше, чем обновляется информация у клиентов, серверы немедленно убирают дополнительную работу с меньшей ценностью. В RMA они уменьшают число кандидатов, обрабатываемых в отдельных запросах; SBM применяет аналогичную политику отбрасывания с учётом ценности к запросам, направленным более мощной модели. Это позволяет быстро реагировать на изменения вблизи узкого места обслуживания.
Отбрасывание нагрузки на стороне клиента: Клиенты RMA и SBM используют последние целевые значения регулятора как ориентир, но также напрямую отслеживают состояние сервера. Если обнаруживается, что сервер перегружен, клиенты самостоятельно убирают дополнительную работу с меньшей ценностью: RMA запрашивает меньше дополнительных объявлений, а SBM направляет меньше запросов более мощной модели.
Оба механизма отбрасывания нагрузки реагируют за несколько миллисекунд, перекрывая интервал до согласования контуров «регулятор — клиент». И на стороне сервера, и на стороне клиента при выборе задач для удаления используются сигналы ценности, что сводит к минимуму негативный эффект в переходный период.
Текущая работа и дальнейшие планы
Повышение эластичности рабочих нагрузок
Мы стремимся продуктивнее использовать доступные вычислительные мощности, расширяя диапазон работы RMA и SBM и добавляя новые механизмы эластичного масштабирования. Для RMA это означает поддержку большего количества кандидатов на этапах ранжирования; для SBM — использование более мощных моделей, которые превращают дополнительные мощности ускорителей в более точные прогнозы. Мы также разрабатываем новые механизмы, например эластичность предварительных вычислений: работа выполняется до поступления запроса и поэтому в меньшей степени зависит от места и времени появления активного трафика.
Расширение пула доступных мощностей
Доступные вычислительные мощности распределены между регионами и типами ускорителей, и использовать их можно только при наличии совместимых моделей и вспомогательных ресурсов в том же месте. Мы расширяем возможности переноса моделей и инференса между регионами, чтобы эффективнее задействовать большую долю доступных мощностей.
Автоматизация распределения мощностей с учётом ценности
Вклад каждого механизма меняется в зависимости от трафика, охвата и доступного сочетания ресурсов. В конкретный момент следующая единица доступных вычислительных мощностей может помочь показывать более релевантную рекламу — за счёт ранжирования дополнительных кандидатов или направления большего числа запросов мощной модели. Мы разрабатываем систему на основе оптимизации, которая будет автоматически распределять мощности для ИИ-инференса между возможными механизмами эластичного масштабирования с учётом пользы для пользователей и рекламодателей. Цель — максимально повысить отдачу от мощностей с учётом, помимо прочего, региональных ограничений, совместимости оборудования и требований к тому, как долго должны оставаться доступными простаивающие ресурсы в каждом сценарии использования.
Благодарности
В этой работе приняли участие специалисты межфункциональной виртуальной команды Meta, внёсшие ключевой вклад:
David Amsallem, Mohit Bharti, Maddie Digne, Stephen Dimmick, Maomao Ding, Amit Dutta, Sebin George, Aashik Gowda, Atul Goyal, Mohak Goyal, Nelson Guo, Tiger Hao, Yaning Huang, Dianshi Li, Yang Li, Bai Liu, Bofeng Liu, Wei Liu, Yisi Liu, Daniel Molina Hurtado, Maciej Naruszewicz, Arka Pal, Annan Pan, Brian Park, Brian Peschka, Michael Shao, Bikash Sharma, Alexander Sun, Weiman Sun, Kaiyue Tao, Patrick Taylor, Kevin Tong, Ellie Wen, Chao Xie, Lu Yang, Sihan You, Hansen Zhang и Anthony Zhu
Мы также благодарим следующих руководителей за поддержку и помощь:
Neeraj Agrawal, Justin Charlap, Brian Ellis, Prabhakar Goyal, Hong Jiang, Shri Karandikar, Santanu Kolay, Uladzimir Pashkevich, Rob Schwartzberg, Eric Shan, Matt Steiner, Nathan Yan, Tak Yan, Caijie Zhang и Alex Zhong
